

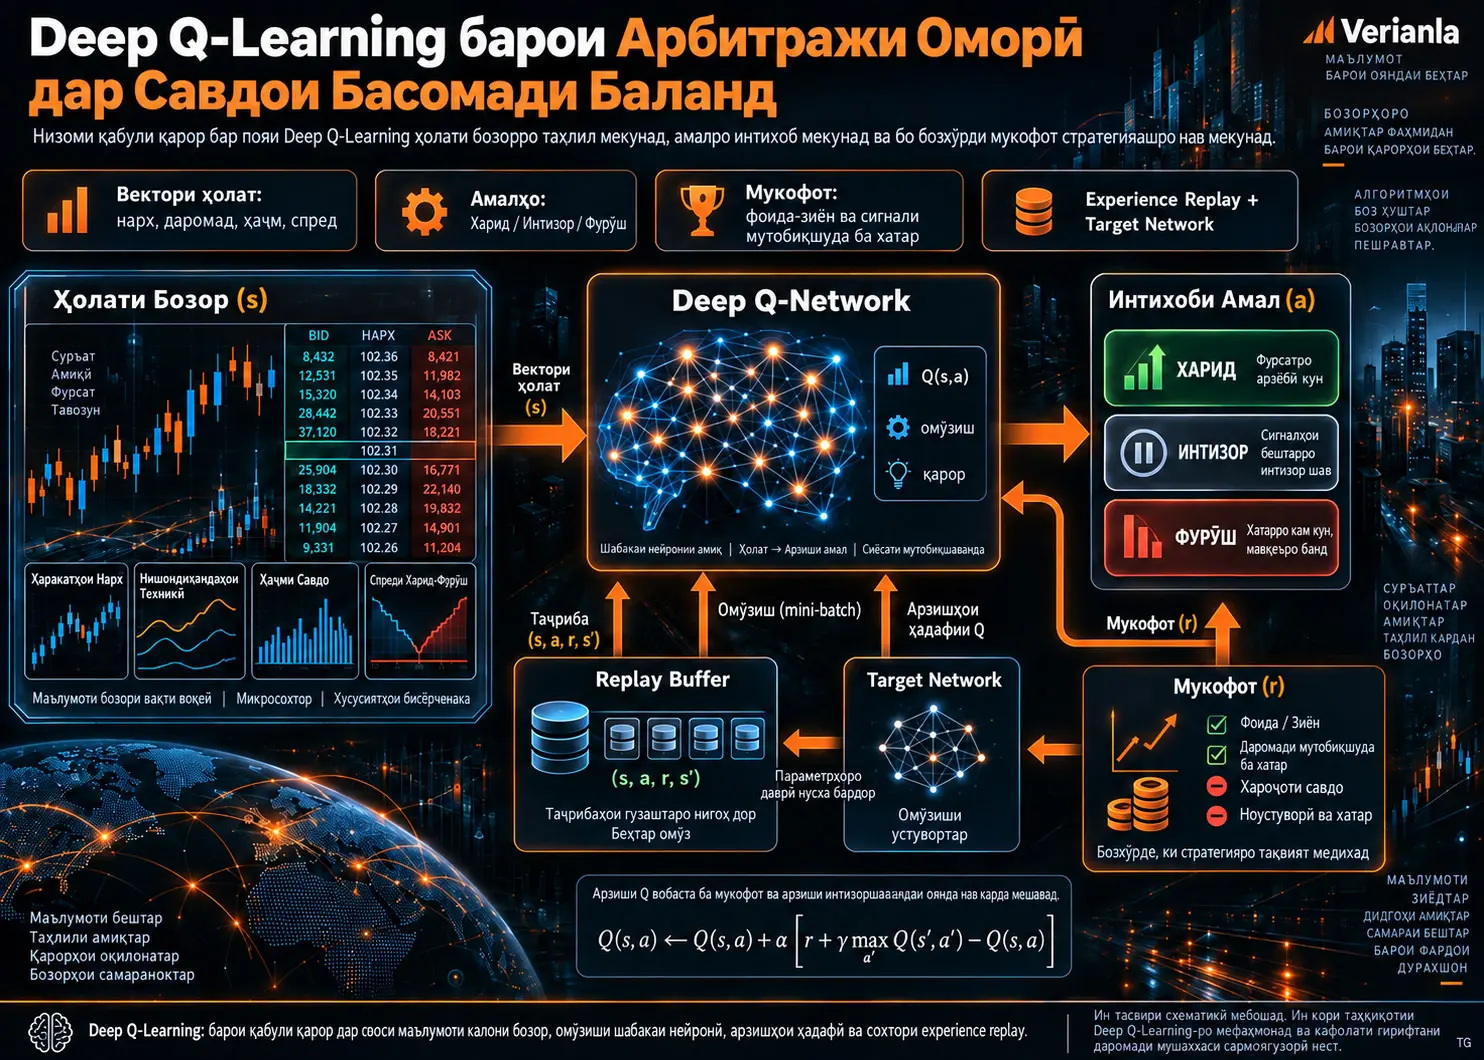
Deep Q-Learning равиши model-free барои омӯзиши қабули қарор аст, ки дар он агенти омӯзиши тақвиятӣ арзишҳои интизории дарозмуддати амалҳои гуногунро дар ҳолати муайяни бозор бо шабакаи нейронии амиқ ба таври тақрибӣ ҳисоб мекунад. Тадқиқоти баррасишуда шарҳ медиҳад, ки ин равишро барои арбитражи оморӣ дар савдои басомади баланд (High-Frequency Trading, HFT) чӣ гуна метавон тавассути навсозии Q-Learning, Q-функсияи асосёфта ба шабакаи нейронӣ, шабакаи ҳадафӣ, experience replay ва тарҳи ҳолат-амал-подош истифода бурд. Манбаъ иддао мекунад, ки Deep Q-Learning метавонад ба шароити тағйирёбандаи бозор мутобиқ шавад; аммо матни асосии PDF маълумоти муфассали backtest ё натиҷаҳои миқдории самаранокиро, ки ин иддаоро тасдиқ кунанд, пешниҳод намекунад.
Дар чаҳорчӯбаи пешниҳодшудаи HFT ҳолати бозор метавонад аз тағйироти охирини нарх, боздеҳҳо, нишондиҳандаҳои техникӣ, ҳаҷми савдо ва тағйирёбандаҳое мисли bid-ask spread иборат бошад. Агент вобаста ба ин ҳолат аз байни амалҳое чун харидан, нигоҳ доштани мавқеъ ё фурӯхтан интихоб мекунад. Фоида/зарари амалӣ ё самаранокии бо риск мутобиқшуда ба сигнали подош табдил дода мешавад; сипас Q-шабака аз таҷрибаҳои рухдода омӯхта, қарорҳои ояндаи худро нав мекунад.
Ҷиҳати аз ҳама омӯзандаи тадқиқот ин аст, ки масъалаи HFT на ҳамчун пешгӯии якдафъаинаи нарх, балки ҳамчун масъалаи қабули қарорҳои пайдарпай баррасӣ мешавад. Бо вуҷуди ин, аз ҷиҳати консептуалӣ мувофиқ будани як усул худ аз худ нишон намедиҳад, ки он дар бозори воқеӣ бартарии иқтисодӣ медиҳад. Дар манбаъ ба таври эмпирикӣ миқдорӣ нашудани омилҳои барои HFT муҳим, аз ҷумла таъхир, динамикаи дафтари фармоишҳо, ҳаққи муомила, slippage, таъсири бозор, хароҷоти ҳисоббарории вақти воқеӣ ва тағйироти режим, маҳдудияти муҳим мебошад.
Чаро савдои басомади баланд масъалаи қабули қарорҳои пайдарпай аст?
Системаҳои савдои басомади баланд танҳо ба саволи «нархи баъдӣ боло меравад ё поён?» ҷавоб намедиҳанд. Агенти савдо ҳолати ҷории бозорро мушоҳида мекунад, амалеро интихоб мекунад, гузариши бозор ба ҳолати баъдӣ ва натиҷаи молиявии муомиларо мебинад, сипас қарори нав мегирад. Бинобар ин, раванди савдо силсилаи қарорҳои бо ҳам пайвастро дар тӯли вақт ташкил медиҳад.
Ин сохтор ба таърифи асосии масъала дар омӯзиши тақвиятӣ мувофиқ аст. Агент аз муҳит ҳолати \(s\)-ро мушоҳида мекунад, амали \(a\)-ро иҷро мекунад, подоши \(r\)-ро мегирад ва ба ҳолати нави \(s'\) мегузарад. Ҳадафи омӯзиш таҳияи сиёсатест, ки на танҳо боздеҳи муомилаи ҷориро, балки подошҳои эҳтимолии ояндаро низ ба ҳисоб мегирад.
Deep Q-Learning чист?
Deep Q-Learning усули омӯзиши тақвиятӣ аст, ки ба ҷойи нигоҳ доштани функсияи арзиши ҳолат-амал дар Q-Learning-и классикӣ дар ҷадвали бузург, онро бо шабакаи нейронии амиқ ба таври тақрибӣ ҳисоб мекунад; ба ин васила дар фазоҳои калони ҳолат, ки аз вуруди бисёрченака монанди нарх, боздеҳ, ҳаҷм ва микросохтори бозор ташкил мешаванд, арзишҳои интизории амалҳои гуногунро метавон баҳогузорӣ кард.
Дар tabular Q-Learning-и классикӣ барои ҳар ҷуфти ҳолат-амал арзиши алоҳида нигоҳ дошта мешавад. Аммо вақте ки ҳолати бозори молиявӣ аз мушоҳидаҳои зиёди нарх, боздеҳҳо, миёнаҳои ҳаракаткунанда, нишондиҳандаҳои ноустуворӣ, ҳаҷм ва тағйирёбандаҳое мисли bid-ask spread иборат аст, шумораи ҳолатҳои имконпазир ниҳоят зиёд мешавад. Deep Q-Learning ин масъалаи миқёсро бо тақрибсозии функсия бар асоси шабакаи нейронӣ ҳал мекунад.
Навсозии Q-Learning
Дар манбаъ навсозии асосии Q-Learning чунин оварда шудааст:
\[ Q(s,a) \leftarrow Q(s,a) + \alpha \left[ r+\gamma\max_{a'}Q(s',a')-Q(s,a) \right] \]
Дар ин муодила \(Q(s,a)\), дар ҳолати \(s\), арзиши умумии интизории амали \(a\)-ро ифода мекунад. \(r\) подоши фаврии пас аз амал мушоҳидашуда аст. \(s'\) ҳолати навест, ки пас аз муомила ба вуҷуд меояд. \(\max_{a'}Q(s',a')\) баландтарин арзиши ояндаи тахминшударо дар байни амалҳои мавҷуд дар ҳолати нав нишон медиҳад.
\(\alpha\) суръати омӯзиш аст ва муайян мекунад, ки мушоҳидаи нав арзиши ҷории Q-ро то чӣ андоза тағйир медиҳад. \(\gamma\) коэффисиенти дисконт аст; ҳар қадар арзиш ба 1 наздик шавад, вазни подошҳои оянда бештар мешавад ва ҳар қадар ба 0 наздик шавад, подоши кӯтоҳмуддат бартарӣ меёбад.
Фарқи дохили қавси мураббаъ дар муодила хатои байни тахмини ҷории Q ва ҳадафест, ки аз подоши мушоҳидашуда ва тахмини оянда ташкил мешавад. Раванди омӯзиш ин хаторо истифода бурда, тахминҳои арзишро такроран ислоҳ мекунад.
Шабакаи нейронӣ арзиши Q-ро чӣ гуна тақриб мекунад?
Дар Deep Q-Learning арзишҳои Q дар ҷадвали иборат аз ҳуҷайраҳои алоҳида нигоҳ дошта намешаванд. Манбаъ равиши умумии зеринро пешниҳод мекунад:
\[ Q(s,a;\theta)=f(s;\theta) \]
\(\theta\) параметрҳои омӯхташавандаи шабакаи нейронӣ, \(s\) ҳолати вурудии ифодакунандаи бозор ва \(f\) табдили функсионалии иҷрошавандаи шабакаи нейрониро ифода мекунанд. Баромади шабака векторест аз арзишҳои тахминии Q барои амалҳои дастрас.
Масалан, агар фазои амалҳо ҳамчун харидан, интизор шудан ва фурӯхтан муайян шуда бошад, шабака метавонад дар ҳамон ҳолати бозор барои ин се амал се арзиши гуногунро тахмин кунад. Сиёсати қарор аз ин тахминҳо барои интихоби амал истифода мекунад.
Чаро шабакаи ҳадафӣ истифода мешавад?
Агар дар Deep Q-Learning шабакаи омӯхташаванда ҳам тахмини ҷорӣ ва ҳам ҳадафи омӯзиши худро пайваста дар як вақт тағйир диҳад, омӯзиш метавонад ноустувор шавад. Манбаъ барои коҳиш додани ин масъала истифодаи шабакаи алоҳидаи давра ба давра навшавандаро шарҳ медиҳад, ки target network ном дорад.
Функсияи талафот дар манбаъ чунин дода шудааст:
\[ L(\theta)= E\left[ \left( r+\gamma\max_{a'}Q(s',a';\theta^-) -Q(s,a;\theta) \right)^2 \right] \]
Дар ин ҷо \(\theta\) параметрҳои Q-шабакаи ҷорӣ ва \(\theta^-\) параметрҳои шабакаи ҳадафӣ мебошанд. \(Q(s,a;\theta)\) тахмини шабакаи ҷорӣ аст; \(r+\gamma\max Q(s',a';\theta^-)\) бошад ҳадафи омӯзишро ташкил медиҳад. Бо кам кардани арзиши интизории фарқи квадратӣ мақсад наздик кардани шабакаи ҷорӣ ба арзишҳои ҳадафии Q мебошад.
Он ки шабакаи ҳадафӣ дар ҳар қадам ҳамзамон бо шабакаи асосӣ тағйир дода намешавад, имкон медиҳад ҳадафи омӯзиш дар фосилаҳои кӯтоҳ устувортар бимонад. Манбаъ инро яке аз механизмҳои коҳишдиҳандаи хатари ларзиш ва инҳироф дар омӯзиши Q-Learning мешуморад.
Чаро Experience Replay истифода мешавад?
Experience replay ба ҷойи он ки агент мушоҳидаҳои пайдарпайи бозорро бевосита дар ҳамон тартиб омӯзад, таҷрибаҳои \((s,a,r,s')\)-ро дар replay buffer нигоҳ медорад ва ҳангоми омӯзиш аз ин хотира mini-batch-ҳои тасодуфӣ интихоб мекунад; ҳадаф коҳиш додани ҳамбастагии қавии байни намунаҳои пайдарпай ва истифодаи дубораи таҷрибаҳои гузашта аст.
Дар қаторҳои замонии молиявӣ мушоҳидаҳои пайдарпай аксаран ҳамбастагии баланд доранд. Омӯзонидани шабакаи нейронӣ танҳо бо чанд мушоҳидаи пайдарпайи охирин метавонад омӯзишро ба режими маҳдуди бозор аз ҳад вобаста гардонад. Replay buffer бо якҷо кардани намунаҳо аз давраҳои гуногун дар як гурӯҳи омӯзишӣ гуногунии намунаҳоро зиёд мекунад.
Манбаъ навсозии mini-batch-ро аз ҷиҳати консептуалӣ чунин ифода мекунад:
\[ \Delta\theta = E_{(s,a,r,s')\sim U(D)} \left[ \nabla_\theta \left( r+\gamma\max_{a'}Q(s',a';\theta^-) -Q(s,a;\theta) \right)^2 \right] \]
\(D\) replay buffer, \(U(D)\) намунагирии uniform аз ин хотира ва \(\Delta\theta\) тағйирёбии параметрҳои шабакаро ҳангоми омӯзиш ифода мекунанд.
Вектори ҳолат барои HFT
Таърифи ҳолати HFT, ки манбаъ пешниҳод мекунад, ба се гурӯҳи асосии иттилоот такя мекунад: ҳаракатҳои охирини нарх ва боздеҳҳо, нишондиҳандаҳои техникӣ ва тағйирёбандаҳои микросохтори бозор. Вектори умумии ҳолат чунин нишон дода мешавад:
\[ s=[p_1,p_2,\ldots,p_n,i_1,i_2,\ldots,i_m,v,b] \]
Дар ин ҷо \(p\) ҳаракатҳои нарх, \(i\) нишондиҳандаҳои техникӣ, \(v\) ҳаҷми савдо ва \(b\) bid-ask spread-ро ифода мекунад. Манбаъ миёнаҳои ҳаракаткунанда, Bollinger Bands ва Relative Strength Index (RSI)-ро ҳамчун намунаҳои нишондиҳандаҳои техникӣ зикр мекунад.
Ин ифода схемаи дақиқи маълумот нест. Мақола нишон намедиҳад, ки чанд таъхири нарх истифода мешавад, кадом нишондиҳандаҳо интихоб мешаванд, маълумот дар кадом ҳалнокии замонӣ намунагирӣ мешавад ё вурудҳо чӣ гуна нормализатсия мешаванд.
Фазои амалҳо
Манбаъ се амали асосиро муайян мекунад:
- Buy: бо интизори болоравии нарх дороӣ харидан.
- Hold: бе кушодани муомилаи нав мавқеи ҷориро нигоҳ доштан.
- Sell: мавқеъро кам ё пӯшидан.
Дар системаи воқеии HFT амалҳои муфассалтар, ба монанди навъи фармоиш, сатҳи нарх, миқдор, қарори бекоркунӣ ва ҷой дар навбат, метавонанд зарур бошанд. Аммо манбаъ ин сатҳи васеътари execution-ро модел намекунад.
Функсияи подош
Мақола фоида ё зарари муомиларо ҳамчун ҷузъи асосии подош баррасӣ мекунад ва таъкид менамояд, ки танҳо фоидаи хом метавонад сиёсатҳои рискпазирро ҳавасманд созад. Подоши бо риск мутобиқшуда аз ҷиҳати консептуалӣ чунин аст:
\[ r = \frac{\text{Beklenen Getiri}} {\text{Getirilerin Standart Sapması}} \]
Ин нисбат ба идеяи самаранокии бо риск мутобиқшудаи навъи Sharpe наздик аст. Аммо манбаъ муайян намекунад, ки дар таҷрибаи воқеии омӯзишӣ ин подош дар кадом равзанаи вақт, бо кадом фарзияи боздеҳи бехатар аз риск ё бо кадом усули миқёскунӣ ҳисоб шудааст.
Пайванд бо арбитражи оморӣ
Арбитражи оморӣ ба ошкор кардани инҳирофҳои муваққатии нисбӣ байни абзорҳои молиявӣ ё равандҳои нарх бо усулҳои оморӣ ва анҷом додани муомила бо интизори он ки ин инҳирофҳо ба ҳолати муқаррарӣ бармегарданд, асос меёбад. Аз дидгоҳи Deep Q-Learning агент ба ҷойи истифодаи танҳо ҳадди собити вуруд-баромад аз ҳолати бозор ва подошҳои гузашта омӯхта, сиёсати амалҳои худро мутобиқ мекунад.
Ин мутобиқшавӣ аз ҷиҳати назариявӣ метавонад бартарии вокуниш ба тағйироти режимро фароҳам оварад. Бо вуҷуди ин, non-stationary будани бозорҳои молиявӣ кафолат намедиҳад, ки арзишҳои Q-и дар гузашта омӯхташуда дар оянда низ эътибор доранд. Режимҳои нави бозор метавонанд бо таҷрибаҳои кӯҳнаи replay buffer мухолифат кунанд ва тақсимоти подош бо мурури вақт тағйир ёбад.
Усул ва Натиҷаҳои Таҳқиқот
Ҷузъҳои методологии дар манбаъ муайяншуда
| Ҷузъ | Нақши дар манбаъ муайяншуда | Ҷузъиёти татбиқ, ки дар манбаъ намерасад |
|---|---|---|
| Ҳолат \(s\) | Маълумоти бозор, аз ҷумла нарх, боздеҳ, нишондиҳандаи техникӣ, ҳаҷм ва bid-ask spread-ро ифода мекунад. | Ҳалнокии замонӣ, андозаи равзана, нормализатсия ва маҷмӯи дақиқи хусусиятҳо дода нашудаанд. |
| Амал \(a\) | Қарорҳои Buy, Hold ва Sell. | Миқдори фармоиш, фарқи фармоишҳои limit/market ва ҷузъиёти execution дода нашудаанд. |
| Подош \(r\) | Фоида/зарар ё боздеҳи бо риск мутобиқшуда. | Функсияи дақиқи подош ва параметрҳои дар татбиқи воқеӣ истифодашуда дода нашудаанд. |
| Q-Learning | Бо навсозии арзиш бар асоси Bellman подоши дарозмуддатро меомӯзад. | Барои \(\alpha\) ва \(\gamma\) арзишҳои воқеии таҷрибавӣ гузориш нашудаанд. |
| Q-network | Аз ҳолати бисёрченака арзишҳои Q-и амалҳоро тахмин мекунад. | Шумораи қабатҳо, шумораи нейронҳо, функсияҳои фаъолсозӣ ва optimizer дода нашудаанд. |
| Target network | Барои устувортар нигоҳ доштани ҳадафи омӯзиш тахмини алоҳидаи Q медиҳад. | Басомади навсозӣ шарҳ дода нашудааст. |
| Replay buffer | Таҷрибаҳои гузаштаро нигоҳ медорад ва омӯзиш бо mini-batch-ҳои тасодуфиро имкон медиҳад. | Ғунҷоиши buffer, batch size ва ҷузъиёти sampling гузориш нашудаанд. |
| Функсияи талафот | Фарқи квадратии байни тахмини ҷории Q ва Q-и ҳадафиро кам мекунад. | Давомнокии омӯзиш, меъёри convergence ва каҷҳои омӯзиш дода нашудаанд. |
Оё мақола исбот мекунад, ки Deep Q-Learning дар HFT фоидаовартар аст?
Не; гарчанде дар хулосаи манбаъ иддао мешавад, ки симулятсияҳо ва backtest-ҳо аз ҷиҳати мутобиқшавӣ, фоидаоварӣ ва боздеҳҳои бо риск мутобиқшуда натиҷаҳои мусбат додаанд, дар матни асосии мақола маҷмӯи маълумот, давраи backtest, benchmark, PnL, нисбати Sharpe, drawdown, хароҷоти муомила ё натиҷаҳои аҳаммияти оморӣ, ки барои мустақилона арзёбӣ кардани ин иддао имкон диҳанд, гузориш нашудаанд.
Ин тафовут дар тафсири тадқиқот аҳаммияти марказӣ дорад. Манбаъ шарҳ медиҳад, ки Deep Q-Learning чӣ гуна метавонад ба арбитражи омории HFT мутобиқ карда шавад ва бартариҳои эҳтимолии усулро баррасӣ мекунад. Аммо PDF-и мавҷуда далели эмпирикии бозтавлидшавандаеро пешниҳод намекунад, ки нишон диҳад усул дар маълумоти мушаххаси бозор benchmark-и муайянро аз ҷиҳати миқдорӣ бартарӣ додааст.
Тафовути далел байни хулоса ва матни асосӣ
Дар хулоса ибораи “extensive simulations and backtests” истифода шуда, гуфта мешавад, ки нишондиҳандаҳои фоидаоварӣ ва боздеҳҳои бо риск мутобиқшуда беҳтар шудаанд. Баръакс, дар матни асосии манбаъ бахши алоҳидаи маълумот, таҷриба, натиҷа ё backtest вуҷуд надорад. Қатори ададии боздеҳ, ҷадвали самаранокӣ ё муқоисаи модел пешниҳод нашудааст.
Аз ин рӯ, аз нуқтаи назари Verianla ифодаи илмии боэҳтиёт чунин аст: тадқиқот Deep Q-Learning-ро барои арбитражи омории HFT аз ҷиҳати консептуалӣ асоснок карда, меъмории қобили татбиқ пешниҳод мекунад; аммо сатҳи далеле, ки ин PDF пешниҳод мекунад, барои тасдиқи миқдории бартарии воқеии иқтисодии усул кофӣ нест.
Камбудиҳо аз ҷиҳати бозтавлидпазирӣ
- Бозори молиявӣ ё маҷмӯи дороиҳои истифодашуда нишон дода нашудааст.
- Манбаи маълумоти tick, trade ё limit-order-book дода нашудааст.
- Давраҳои Train, validation ва test гузориш нашудаанд.
- Протоколи арзёбии out-of-sample дода нашудааст.
- Меъмории Q-network нишон дода нашудааст.
- Learning rate, discount factor, batch size ва ғунҷоиши replay-buffer дода нашудаанд.
- Параметрҳои epsilon-greedy ё сиёсати дигари exploration нишон дода нашудаанд.
- Басомади навсозии target network дода нашудааст.
- Комиссияҳои муомила, хароҷоти bid-ask, slippage ва market impact модел нашудаанд.
- Latency ё хароҷоти инфрасохтори савдо гузориш нашудааст.
- Benchmark-ҳои муқоисавӣ дода нашудаанд.
- Sharpe ratio, maximum drawdown, turnover ё қатори PnL гузориш нашудааст.
Натиҷае, ки тадқиқот дастгирӣ мекунад
Манбаъ дастгирӣ мекунад, ки Deep Q-Learning барои бо шабакаи нейронӣ ифода кардани ҳолатҳои бисёрченакаи бозор, бо принсипи Q-Learning нав кардани арзишҳои амалҳо, тавассути replay buffer аз таҷрибаҳои гузашта дубора омӯхтан ва бо target network устувор кардани ҳадафи омӯзиш чаҳорчӯбаи мантиқии HFT пешниҳод мекунад.
Натиҷае, ки тадқиқот дастгирӣ намекунад
Манбаъ аз ҷиҳати миқдорӣ нишон намедиҳад, ки ин меъморӣ дар биржа, дороӣ, давраи савдо ё инфрасохтори вақти воқеии HFT-и мушаххас боздеҳи аз ҷиҳати оморӣ бартарӣ додааст, баъд аз хароҷоти муомила фоидаовар мондааст ё аз усулҳои классикии арбитражи оморӣ беҳтар будааст.
Ёддошт оид ба Манбаъ ва Усул
Тадқиқоти аслӣ: Harnessing Deep Q-Learning for Enhanced Statistical Arbitrage in High-Frequency Trading: A Comprehensive Exploration.
Муаллиф: Soumyadip Sarkar.
Манбаъ: arXiv:2311.10718v1, q-fin.TR.
Сана: 13 сентябри 2023.
Муайянкунандаи доимӣ: 10.48550/ARXIV.2311.10718.
Навъи манбаъ: arXiv preprint; дар манбаъ маълумот дар бораи нашри маҷалла ё конфронси аз баррасии ҳамтоён гузашта дода нашудааст.
Аффилиатсияи институтсионалӣ: Дар PDF-и манбаъ аффилиатсияи институтсионалии муаллиф нишон дода нашуда, танҳо суроғаи почтаи электронии тамос оварда шудааст.
Литсензия: Азбаски дар PDF-и баррасишуда ва сабтҳои библиографӣ литсензияи муайяни кушода тасдиқ нашудааст, матни Verianla ба ҷойи бознашри баёни манбаъ мафҳумҳои илмиро дар сохтори мустақили омӯзишӣ шарҳ медиҳад.
Дастрасии маълумот: Манбаъ маҷмӯи мушаххаси маълумот ё махзани маълумотро муайян намекунад.
Маблағгузорӣ ва бархӯрди манфиатҳо: Дар PDF изҳороти ошкор дар бораи маблағгузорӣ ё бархӯрди манфиатҳо вуҷуд надорад.
Маҳдудияти асосии методологӣ: Гарчанде дар манбаъ ҷузъҳои математикӣ ва консептуалии Deep Q-Learning шарҳ дода шудаанд, маълумот, гиперпараметрҳо, тартиби омӯзиш ва натиҷаҳои самаранокие, ки барои бозсозии татбиқи эмпирикӣ лозиманд, пешниҳод нашудаанд.
Ҳудуди тафсири молиявӣ: Ин муҳтавои Verianla пешниҳоди стратегияи савдо ё тавсияи сармоягузорӣ нест; он матни таълимии илмиест, ки сохтори методологӣ ва ҳудудҳои далели тадқиқоти манбаъро шарҳ медиҳад.
Шарҳ гузоред
Нишонии почтаи электронии шумо нашр намешавад. Майдонҳои ҳатмӣ бо * нишон дода шудаанд