

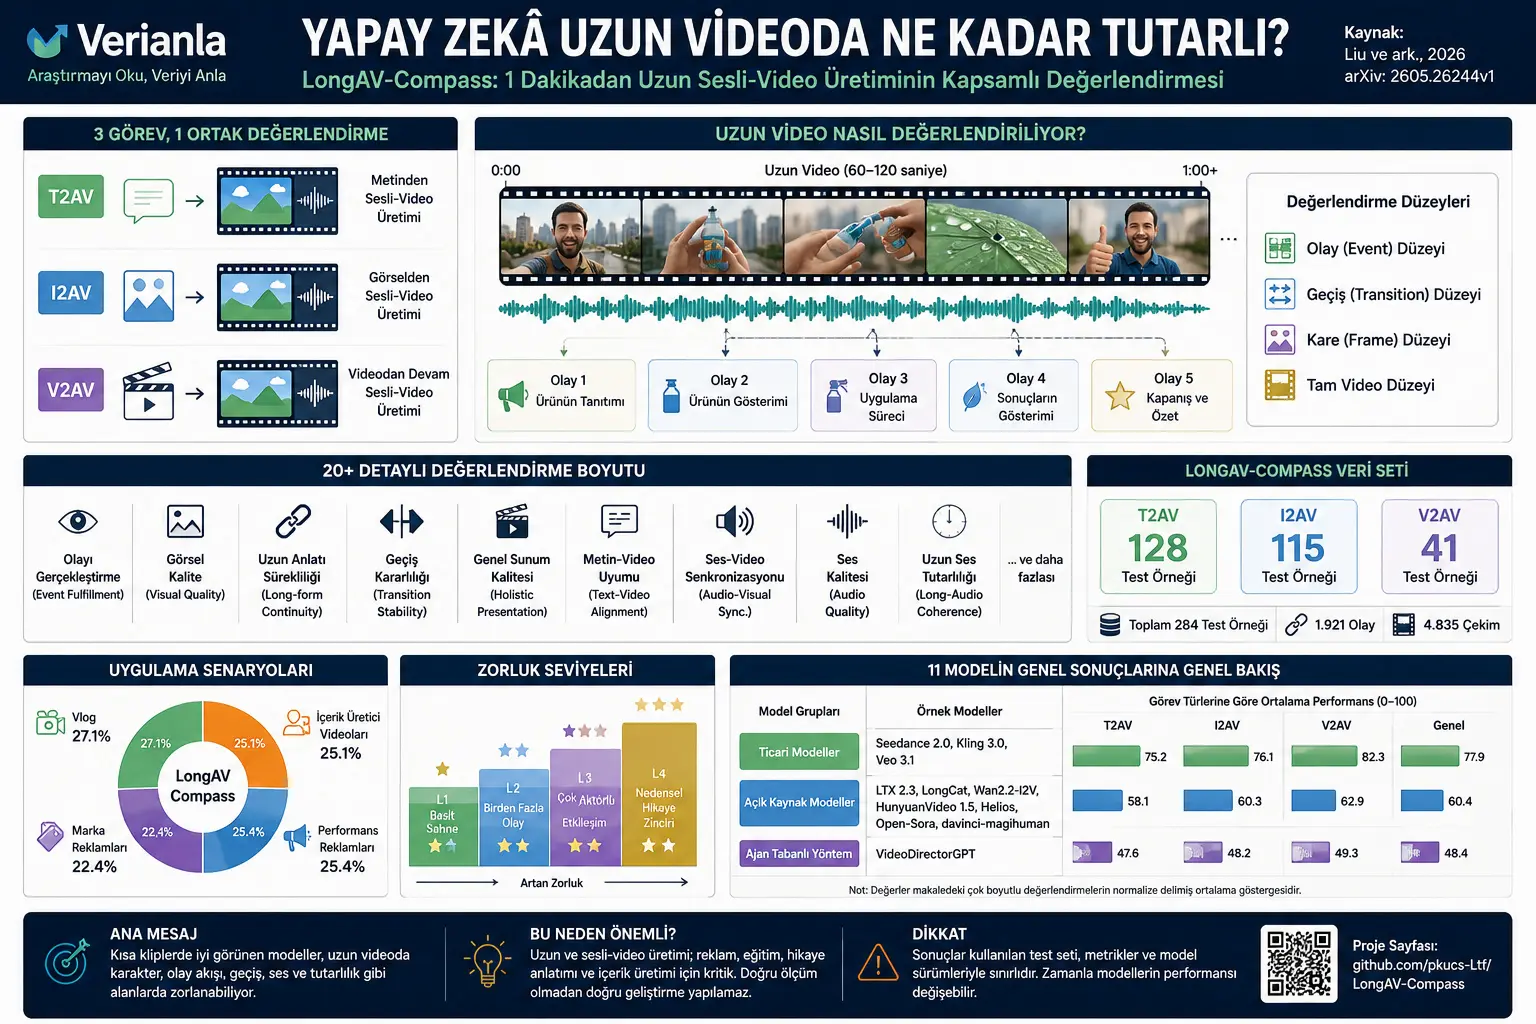
Yapay zekâ ile video üretimi hızla gelişiyor. Artık sadece birkaç saniyelik kısa klipler değil, bir dakikayı aşan videolar, reklamlar, vlog tarzı içerikler, ürün tanıtımları ve hikâye anlatımları da üretilebiliyor. Fakat önemli bir soru var: Bir model kısa bir sahneyi güzel üretebiliyor diye, uzun bir videoda aynı karakteri, aynı hikâye akışını, aynı ses uyumunu ve mantıklı geçişleri koruyabiliyor mu?
Tengfei Liu ve çalışma arkadaşları bu soruya cevap aramak için LongAV-Compass adlı bir değerlendirme sistemi öneriyor. Bu sistem, bir dakikadan uzun sesli-video üretimini üç farklı görev türünde inceliyor: metinden sesli video üretimi, görselden sesli video üretimi ve mevcut bir videodan devam videosu üretimi.
Çalışma, 284 test örneği üzerinden 11 farklı video üretim sistemini değerlendiriyor. Sonuçlar, güncel modellerin kısa kliplerde etkileyici görünse bile uzun süreli anlatı, karakter tutarlılığı, sahne geçişleri ve ses-video uyumu konusunda hâlâ zorlandığını gösteriyor.
Bugün birçok yapay zekâ modeli kısa videolar üretebiliyor. Birkaç saniyelik bir sahnede görsel kalite yüksek olabilir, hareketler etkileyici görünebilir ve metindeki ana fikir kabaca yakalanabilir.
Ama uzun video üretimi farklı bir problemdir. Bir dakikalık videoda modelin sadece güzel görüntü üretmesi yetmez. Şunları da koruması gerekir:
- Karakter veya ürün aynı kalmalı.
- Sahne geçişleri mantıklı olmalı.
- Olaylar sırasını kaybetmemeli.
- Ses, görüntüdeki hareketlerle uyumlu olmalı.
- Hikâye baştan sona tutarlı ilerlemeli.
- Ürün tanıtımı veya reklam gibi içeriklerde verilen vaatler ve gösterilen işlemler birbirini tamamlamalı.
Mevcut birçok benchmark, yani model değerlendirme testi, genellikle 5-10 saniyelik kısa videolara odaklanıyor. Bu testler kısa kliplerde görsel kaliteyi veya metinle uyumu ölçmek için yararlı olabilir. Ancak uzun videoda ortaya çıkan bozulmaları yakalamakta yetersiz kalabilir.
Bu yüzden araştırmacılar şu soruya odaklanıyor:
Yapay zekâ video modellerini, gerçekten uzun ve sesli-video üretimi yapabilecek şekilde nasıl daha doğru test edebiliriz?
Yöntem Ne Öneriyor?
Makale, LongAV-Compass adlı yeni bir benchmark öneriyor. Benchmark, yapay zekâ modellerinin uzun sesli-video üretimini daha ayrıntılı ve tanı koyucu şekilde ölçmeyi amaçlıyor.
LongAV-Compass üç ana görev türünü kapsıyor:
1. T2AV – Text-to-Audio-Video
Metinden sesli video üretimi. Model, verilen senaryo veya metin açıklamasından hem görüntü hem de ses içeren uzun video üretmeye çalışıyor.
2. I2AV – Image-to-Audio-Video
Görselden sesli video üretimi. Model, verilen bir referans görseli ve senaryoyu kullanarak uzun video oluşturuyor. Burada önemli soru şu: Görseldeki kişi, nesne, ürün veya sahne uzun video boyunca korunabiliyor mu?
3. V2AV – Video-to-Audio-Video
Videodan sesli video devamı üretimi. Model, kısa bir başlangıç videosunu alıyor ve bunu senaryoya uygun şekilde devam ettiriyor. Burada amaç, başlangıç videosundaki stil, karakter, sahne ve akışı bozmadan devam üretmek.
LongAV-Compass toplam 284 test örneği içeriyor:
- 128 metinden sesli video üretimi örneği
- 115 görselden sesli video üretimi örneği
- 41 videodan devam üretimi örneği
Bu örnekler yalnızca rastgele seçilmemiş. Araştırmacılar testleri farklı kullanım senaryolarına ve zorluk seviyelerine göre düzenliyor.
Kullanım senaryoları şunlar:
- Vlog
- İçerik üreticisi videoları
- Performans reklamları
- Marka reklamları
Zorluk seviyeleri ise L1’den L4’e kadar çıkıyor. Basit sahnelerden çok olaylı, çok aktörlü, nedensel akış isteyen daha zor anlatılara doğru ilerliyor.
Formüller Ne Anlatıyor?
Bu makalede okuyucuyu zorlayacak yoğun matematiksel formüller öne çıkmıyor. Çalışmanın asıl gücü, ölçüm sisteminin nasıl kurulduğunda.
Araştırmacılar tek bir “genel puan” vermek yerine, uzun video üretimini birçok parçaya ayırıyor. Çünkü bir model görsel olarak iyi olabilir ama ses-video uyumu zayıf olabilir. Başka bir model ürünün görüntüsünü koruyabilir ama hikâyeyi tamamlayamayabilir.
Ölçülen ana boyutlar şunlar:
Event Fulfillment – Olayı gerçekleştirme
Model, senaryoda istenen olayları gerçekten üretebildi mi? Örneğin “ürün yaprağa sıkılıyor” deniyorsa, videoda gerçekten bu olay görünüyor mu?
Visual Quality – Görsel kalite
Hareketler doğal mı? Nesneler bozuluyor mu? Görüntüde yapaylık, kırılma, şekil bozulması veya kalite kaybı var mı?
Long-form Continuity – Uzun anlatı sürekliliği
Video baştan sona tutarlı mı? Karakter, ürün, sahne ve olay akışı korunuyor mu?
Transition Stability – Geçiş kararlılığı
Sahneler arasında siyah kare, titreme, ani kopma, donma veya mantıksız sıçrama var mı?
Holistic Presentation – Genel sunum kalitesi
Video tamamlanmış bir iş gibi duruyor mu? İzlenebilir, düzenli ve amacına uygun mu?
Text-Video Alignment – Metin-video uyumu
Video, verilen açıklama ve senaryoyla ne kadar uyumlu?
Audio-Video Synchronization – Ses-video senkronizasyonu
Konuşma, efekt, müzik veya ortam sesi görüntüdeki olaylarla zaman olarak uyumlu mu?
Audio Quality – Ses kalitesi
Ses gerçekçi mi, sahneye uygun mu, rahatsız edici bozulmalar içeriyor mu?
Long-Audio Coherence – Uzun ses tutarlılığı
Ses bir dakika boyunca kopmadan, anlamsız tekrar etmeden, ani ses seviyesi değişimleri yapmadan devam ediyor mu?
Bu ölçüm sistemi bize şunu anlatıyor: Uzun video üretiminde başarı, yalnızca “görüntü güzel mi?” sorusuyla ölçülemez. Ses, olay sırası, anlatı, görsel tutarlılık ve sahne geçişleri birlikte değerlendirilmelidir.
Grafik / Tablo / Şema Varsa Ana Mesajı Ne?
Makaledeki görseller ve tablolar, LongAV-Compass’ın sıradan bir model sıralama tablosundan daha fazlasını hedeflediğini gösteriyor.
Makaledeki genel sistem şeması:
Sayfa 2’deki büyük şema, LongAV-Compass’ın videoyu tek parça halinde değil, farklı ayrıntı seviyelerinde değerlendirdiğini gösteriyor. Tam video, olay bazlı klipler, sahne geçişleri ve örnek kareler ayrı ayrı inceleniyor. Ana mesaj şu: Uzun video üretiminde hatalar bazen tek bir karede değil, olaylar arası geçişte veya videonun genel akışında ortaya çıkar.
Benchmark karşılaştırma tablosu:
Makaledeki karşılaştırma tablosu, önceki benchmarkların çoğunun kısa video veya tek görev türüne odaklandığını gösteriyor. LongAV-Compass ise metinden, görselden ve videodan sesli-video üretimini aynı çatı altında değerlendirmeye çalışıyor. Ayrıca ortalama video süresi bir dakikayı aşan üretimlere odaklanıyor.
Görev kapsamı tablosu:
LongAV-Compass’ın 284 örneği; 879 olay ve 2.115 çekim içeren T2AV bölümü, 807 olay ve 1.989 çekim içeren I2AV bölümü, 235 olay ve 731 çekim içeren V2AV bölümüyle yapılandırılıyor. Bu, testlerin sadece “tek komut, tek kısa video” mantığında olmadığını; olay zincirleri üzerinden kurulduğunu gösteriyor.
Senaryo ve zorluk dağılımı grafiği:
Makaledeki dairesel dağılım görseli, testlerin vlog, içerik üretici videoları, performans reklamları ve marka reklamları gibi farklı alanlara yayıldığını gösteriyor. Bu önemli, çünkü bir model eğlenceli vlog tarzında iyi çalışırken ürün tanıtımı veya reklam senaryosunda zorlanabilir.
Veri oluşturma şeması:
Makaledeki veri inşa süreci şeması, test örneklerinin hem gerçek videolardan hem de senaryo şablonlarından üretildiğini anlatıyor. Daha sonra bu örnekler insan kontrolü ve yapay zekâ destekli kalite değerlendirmesinden geçiriliyor. Ana mesaj şu: Benchmark yalnızca rastgele komutlardan oluşmuyor; olay yapısı, gerçekçilik ve değerlendirme değeri kontrol ediliyor.
Model sonuç tabloları:
T2AV, I2AV ve V2AV tabloları; Seedance 2.0, Kling 3.0, Veo 3.1 ve çeşitli açık kaynak modellerin farklı ölçütlerdeki performansını gösteriyor. Burada tek bir modelin her alanda mutlak üstün olduğunu söylemek zor. Örneğin bazı modeller metindeki olayları daha iyi yerine getirirken, bazıları ses kalitesi veya sahne geçişlerinde daha güçlü görünebiliyor.
İnsan uyumu grafiği:
Makaledeki insan değerlendirmesiyle otomatik skorların karşılaştırıldığı grafik, LongAV-Compass puanlarının insan tercihlerine yüksek oranda yakın olduğunu gösteriyor. Bu, benchmarkın yalnızca teknik ölçümlerden ibaret olmadığını; insan algısıyla da belli ölçüde uyumlu sonuç verdiğini düşündürüyor.
Deneyler Nasıl Yapılmış?
Araştırmacılar 11 farklı video üretim sistemini test ediyor. Bunlar üç gruba ayrılıyor:
- Kapalı / ticari modeller
- Açık kaynak modeller
- Ajan tabanlı yöntemler
Ticari modeller arasında Seedance 2.0, Kling 3.0 ve Veo 3.1 yer alıyor. Açık kaynak tarafta LTX 2.3, LongCat, Wan2.2-I2V-A14B, HunyuanVideo 1.5-I2V, Helios, Open-Sora ve davinci-magihuman gibi modeller değerlendiriliyor. Ayrıca VideoDirectorGPT ajan tabanlı bir örnek olarak dahil ediliyor.
Testlerde hedef video süresi en az 60 saniye olarak belirleniyor ve çoğu çıktı 60-120 saniye aralığında değerlendiriliyor.
Modeller, destekledikleri giriş türüne göre test ediliyor. Örneğin bazı modeller ses üretemiyorsa, bu modeller video metrikleriyle değerlendiriliyor ama ses metriklerinde “uygun değil” şeklinde ele alınıyor.
Değerlendirme sürecinde yalnızca tek bir puan kullanılmıyor. Her video olay bazında, geçiş bazında, tam video düzeyinde ve ses-video uyumu açısından ayrı ayrı inceleniyor. Böylece modelin nerede başarılı, nerede zayıf olduğu daha açık şekilde görülebiliyor.
Sonuçlar Ne Gösteriyor?
Sonuçlar, güncel uzun sesli-video üretim modellerinin tek bir puanla açıklanamayacak kadar farklı güçlü ve zayıf yönlere sahip olduğunu gösteriyor.
Metinden sesli video üretimi görevinde Kling 3.0 olayları yerine getirme ve uzun form sürekliliği açısından güçlü görünüyor. Seedance 2.0 ise görsel kalite, genel sunum ve ses ölçütlerinde öne çıkıyor.
Görselden sesli video üretimi görevinde Seedance 2.0 genel olarak güçlü performans sergiliyor. Kling 3.0 referans görselin ilk karede korunması açısından iyi sonuç veriyor. Ancak makalenin önemli bulgularından biri şu: Bir model referans görseldeki kişiyi veya nesneyi görüntü olarak korusa bile, uzun videoda olay akışını ve anlatı sürekliliğini korumakta zorlanabiliyor.
Videodan devam üretimi görevinde Seedance 2.0 açık şekilde öne çıkıyor. Özellikle başlangıç videosuna uyum, olay devamlılığı, görsel kalite ve ses kalitesi açısından güçlü sonuçlar veriyor. Veo 3.1 bazı olayları anlamlı şekilde sürdürebilse de, referans video sınırından sonra süreklilik ve geçiş kararlılığı tarafında daha zayıf sonuçlar gösterebiliyor.
Açık kaynak modellerin bazı ölçütlerde makul sonuçlar verdiği görülüyor; fakat uzun anlatı, olay sırası, ürün gösterimi, görsel bütünlük ve ses-video uyumu gibi alanlarda ticari modellerle aralarında hâlâ belirgin fark var.
Makalenin en dikkat çekici bulgularından biri, performans reklamları senaryosunun modeller için özellikle zor olması. Çünkü bu tür videolarda ürünün gösterilmesi, işlevinin anlatılması, kullanım sürecinin mantıklı ilerlemesi ve ikna edici bir akış oluşturulması gerekiyor. Modeller çoğu zaman ürünü gösterebilse bile, ürünün işlevini doğru sırayla anlatmakta veya nedensel akışı korumakta zorlanabiliyor.
Bu Neden Önemli?
Bu çalışma, yapay zekâ ile video üretiminin yalnızca “güzel görüntü üretme” meselesi olmadığını gösteriyor.
Kısa bir klipte etkileyici görünen bir model, uzun videoda şu sorunları yaşayabilir:
- Karakterin yüzü veya kıyafeti değişebilir.
- Ürün bir sahnede farklı, başka sahnede farklı görünebilir.
- Ses görüntüdeki olayla uyuşmayabilir.
- Hikâye başta vaat ettiği şeyi tamamlamayabilir.
- Sahne geçişlerinde kopukluk veya donma oluşabilir.
- Reklam videosunda ürünün işlevi yanlış veya eksik anlatılabilir.
Bu nedenle uzun video üreten yapay zekâ sistemlerini test etmek için daha ayrıntılı değerlendirme araçlarına ihtiyaç var. LongAV-Compass bu ihtiyaca cevap vermeye çalışıyor.
Verianla okuyucusu açısından ana mesaj şu: Bir yapay zekâ modelinin “video üretebiliyor” olması, onun uzun ve tutarlı bir sesli-video hikâyesi kurabildiği anlamına gelmez. Uzun video üretiminde asıl sınav; süreklilik, tutarlılık, ses uyumu ve olay akışını koruyabilmektir.
Dikkat Edilmesi Gereken Noktalar
Bu makale güçlü bir benchmark öneriyor; ancak bazı sınırlamalar var.
İlk olarak çalışma arXiv preprint olarak yayımlanmış görünüyor. Bu nedenle sonuçların hakemli yayın süreci ve bağımsız doğrulamalarla desteklenmesi önemlidir.
İkinci olarak değerlendirilen modellerin sürümleri zamanla değişebilir. Ticari yapay zekâ servisleri sık güncellendiği için bugün alınan sonuçlar ileride farklılaşabilir.
Üçüncü olarak otomatik değerlendirme sistemleri insan değerlendirmesine yaklaşsa da, insan yargısının tamamen yerine geçmez. Makalede insan uyumu çalışması yapılmış olsa da, bu pilot düzeydedir.
Dördüncü olarak bazı metrikler belirli görsel veya çok modlu temsil modellerine dayanıyor. Örneğin CLIP, DINO-v2, ArcFace ve ImageBind gibi araçlar yararlı sinyaller verse de, videonun estetik, anlatı ve ticari başarısını tümüyle ölçemez.
Beşinci olarak model sıralamaları, kullanılan test senaryolarına bağlıdır. Vlog, reklam, ürün tanıtımı veya hikâye videosu gibi farklı içerik türleri modelleri farklı şekilde zorlayabilir.
Sonuç
LongAV-Compass, yapay zekâ ile uzun sesli-video üretimini değerlendirmek için kapsamlı bir test sistemi öneriyor. Çalışma, metinden, görselden ve videodan uzun sesli-video üretimini aynı çatı altında ele almasıyla dikkat çekiyor.
Araştırmanın ana sonucu şu: Güncel video üretim modelleri kısa kliplerde etkileyici görünse de, bir dakikayı aşan içeriklerde karakter tutarlılığı, olay sırası, sahne geçişleri, ses-video senkronizasyonu ve anlatı bütünlüğü hâlâ ciddi bir sınav.
Bu benchmark, yalnızca modelleri sıralamak için değil, modellerin nerede başarısız olduğunu teşhis etmek için tasarlanmış. Bu da gelecekte daha güvenilir, daha tutarlı ve daha uzun yapay zekâ videoları üretmek isteyen araştırmacılar için önemli bir adım olabilir.
Verianla açısından bu makalenin ana mesajı net: Yapay zekâ video üretiminde asıl gelişme, yalnızca daha güzel kareler üretmek değil; uzun süre boyunca anlamı, sesi, karakteri ve hikâyeyi koruyabilmektir.
Kaynak ve Yöntem Notu
Bu içerik, Tengfei Liu, Yang Shi, Xuanyu Zhu ve çalışma arkadaşları tarafından hazırlanan “LongAV-Compass: Towards Unified Evaluation of Minute-Scale Audio-Visual Generation Across T2AV, I2AV, and V2AV” adlı akademik çalışmadan yararlanılarak Verianla editoryal formatında özgün olarak hazırlanmıştır.
Çalışma arXiv üzerinde 25 Mayıs 2026 tarihli preprint olarak görünmektedir. Bu yazı birebir çeviri değildir; makaledeki yöntem, tablolar, grafikler, deneyler ve sonuçlar sadeleştirilerek Türkçe okuyucu için yeniden anlatılmıştır. İçerik bilgilendirme ve eğitim amacı taşır. Yapay zekâ modeli seçimi, ticari video üretimi veya teknik sistem değerlendirmesi için tek başına karar rehberi olarak kullanılmamalıdır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir