

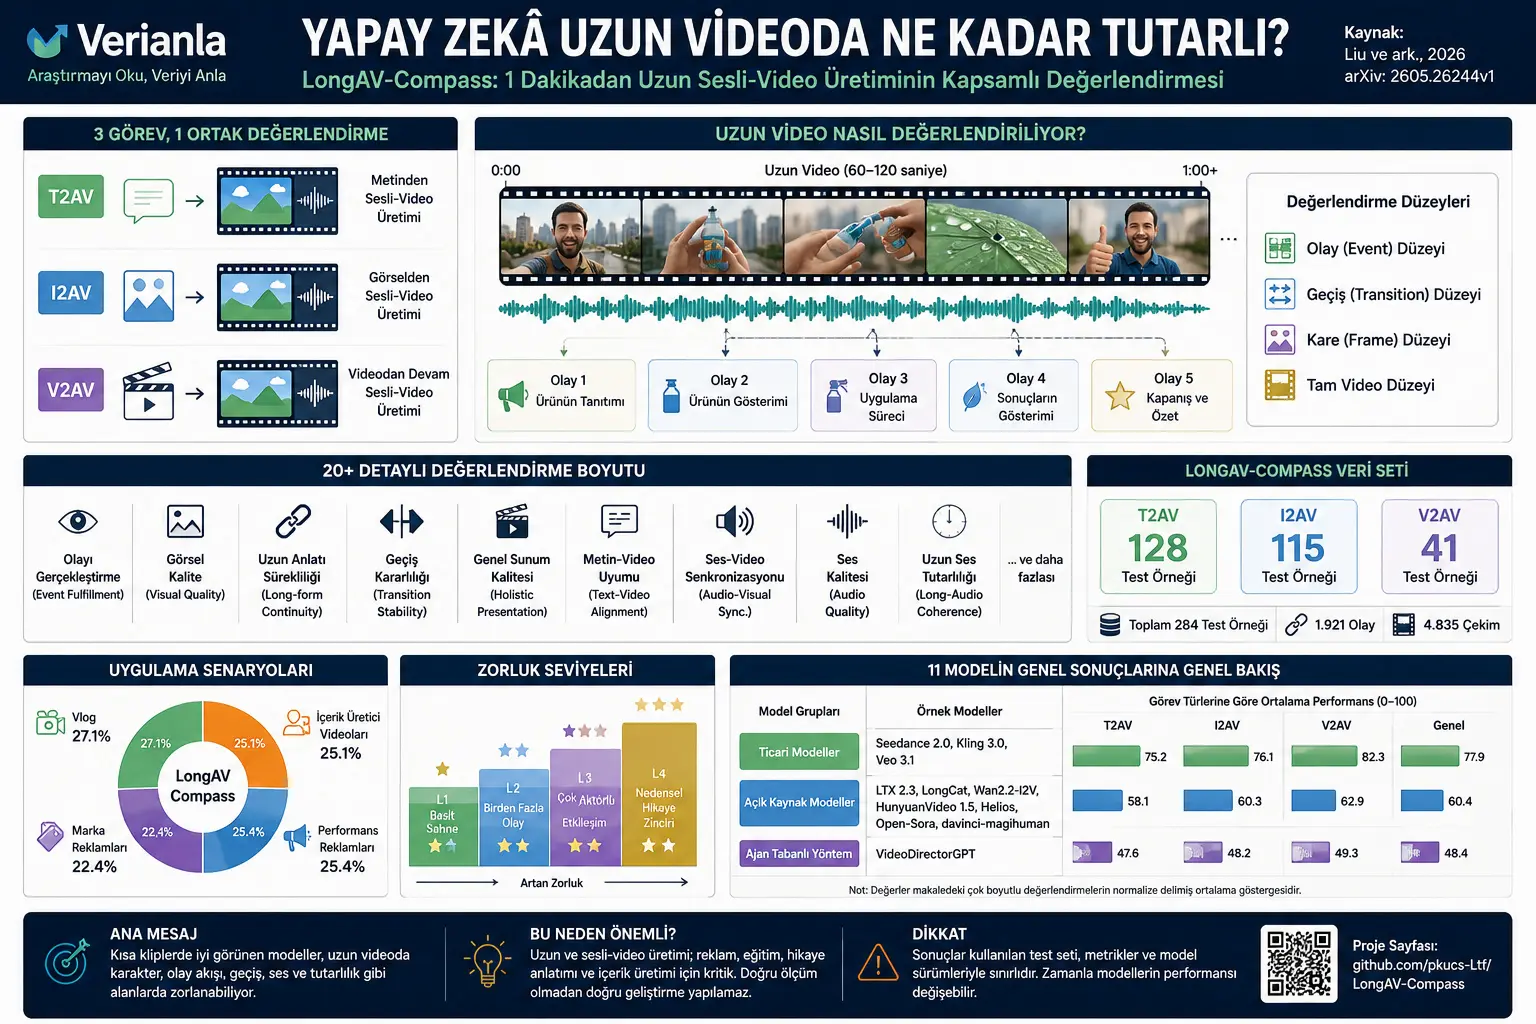
Sun’iy intellekt bilan video yaratish tez rivojlanmoqda. Endi nafaqat bir necha soniyalik qisqa kliplar, balki bir daqiqadan oshiq videolar, reklamalar, vlog uslubidagi kontent, mahsulot tanishtiruvlari va hikoya bayonlari ham yaratilishi mumkin. Ammo muhim savol bor: model qisqa sahnani yaxshi yaratishi uzun videoda xuddi shu personajni, xuddi shu hikoya oqimini, xuddi shu ovoz uyg‘unligini va mantiqiy o‘tishlarni saqlay olishini anglatadimi?
Tengfei Liu va hamkasblari bu savolga javob izlash uchun LongAV-Compass nomli baholash tizimini taklif qiladi. Bu tizim bir daqiqadan uzun ovozli-video yaratishni uch xil vazifa turida o‘rganadi: matndan ovozli video yaratish, tasvirdan ovozli video yaratish va mavjud videodan davom videosini yaratish.
Tadqiqot 284 sinov namunasi orqali 11 xil video yaratish tizimini baholaydi. Natijalar zamonaviy modellar qisqa kliplarda ta’sirli ko‘rinsa ham, uzoq muddatli hikoya, personaj izchilligi, sahna o‘tishlari va ovoz-video uyg‘unligi borasida hali qiynalayotganini ko‘rsatadi.
Bugun ko‘plab sun’iy intellekt modellari qisqa videolar yarata oladi. Bir necha soniyalik sahnada vizual sifat yuqori bo‘lishi, harakatlar ta’sirli ko‘rinishi va matndagi asosiy g‘oya taxminan ushlanishi mumkin.
Ammo uzun video yaratish boshqa muammodir. Bir daqiqalik videoda modelning faqat chiroyli tasvir yaratishi yetarli emas. Quyidagilarni ham saqlashi kerak:
- Personaj yoki mahsulot bir xil qolishi kerak.
- Sahna o‘tishlari mantiqiy bo‘lishi kerak.
- Hodisalar ketma-ketligini yo‘qotmasligi kerak.
- Ovoz tasvirdagi harakatlar bilan uyg‘un bo‘lishi kerak.
- Hikoya boshidan oxirigacha izchil rivojlanishi kerak.
- Mahsulot tanishtiruvi yoki reklama kabi kontentlarda berilgan va’dalar va ko‘rsatilgan jarayonlar bir-birini to‘ldirishi kerak.
Mavjud ko‘plab benchmarklar, ya’ni model baholash testlari, odatda 5-10 soniyalik qisqa videolarga e’tibor qaratadi. Bu testlar qisqa kliplarda vizual sifat yoki matn bilan uyg‘unlikni o‘lchash uchun foydali bo‘lishi mumkin. Ammo uzun videoda paydo bo‘ladigan buzilishlarni ushlashda yetarli bo‘lmasligi mumkin.
Shu sababli tadqiqotchilar quyidagi savolga e’tibor qaratadi:
Sun’iy intellekt video modellerini haqiqatan uzun va ovozli-video yaratish qobiliyati jihatidan qanday aniqroq sinab ko‘rishimiz mumkin?
Usul nima taklif qiladi?
Maqola LongAV-Compass nomli yangi benchmark taklif qiladi. Benchmark sun’iy intellekt modellerining uzun ovozli-video yaratishini batafsilroq va diagnostik tarzda o‘lchashni maqsad qiladi.
LongAV-Compass uch asosiy vazifa turini qamrab oladi:
1. T2AV – Text-to-Audio-Video
Matndan ovozli video yaratish. Model berilgan ssenariy yoki matn tavsifidan ham tasvir, ham ovozli uzun video yaratishga harakat qiladi.
2. I2AV – Image-to-Audio-Video
Tasvirdan ovozli video yaratish. Model berilgan referens tasvir va ssenariydan foydalanib uzun video yaratadi. Bu yerda muhim savol: tasvirdagi shaxs, obyekt, mahsulot yoki sahna uzun video davomida saqlanadimi?
3. V2AV – Video-to-Audio-Video
Videodan ovozli video davomini yaratish. Model qisqa boshlang‘ich videoni oladi va uni ssenariyga mos ravishda davom ettiradi. Bu yerda maqsad — boshlang‘ich videodagi uslub, personaj, sahna va oqimni buzmasdan davom yaratish.
LongAV-Compass jami 284 sinov namunasi o‘z ichiga oladi:
- 128 matndan ovozli video yaratish namunasi
- 115 tasvirdan ovozli video yaratish namunasi
- 41 videodan davom yaratish namunasi
Bu namunalar faqat tasodifiy tanlanmagan. Tadqiqotchilar testlarni turli foydalanish ssenariylari va qiyinlik darajalariga ko‘ra tartiblaydi.
Foydalanish ssenariylari quyidagilar:
- Vlog
- Kontent yaratuvchi videolari
- Performance reklamalar
- Brend reklamalari
Qiyinlik darajalari esa L1 dan L4 gacha ko‘tariladi. Oddiy sahnalardan ko‘p hodisali, ko‘p aktyorli, sabab-oqibat oqimini talab qiladigan murakkabroq hikoyalarga qarab rivojlanadi.
Formulalar nima haqida?
Bu maqolada o‘quvchini qiynaydigan zich matematik formulalar oldinga chiqmaydi. Tadqiqotning asosiy kuchi o‘lchov tizimining qanday qurilganidadir.
Tadqiqotchilar bitta «umumiy ball» berish o‘rniga, uzun video yaratishni ko‘plab qismlarga ajratadi. Chunki bir model vizual jihatdan yaxshi bo‘lishi mumkin, lekin ovoz-video uyg‘unligi zaif bo‘lishi mumkin. Boshqa model mahsulot tasvirini saqlashi mumkin, lekin hikoyani yakunlay olmasligi mumkin.
O‘lchanadigan asosiy o‘lchamlari quyidagilar:
Event Fulfillment – Hodisani amalga oshirish
Model ssenariyda so‘ralgan hodisalarni haqiqatan yaratadimi? Masalan, «mahsulot bargga sepilmoqda» deyilsa, videoda haqiqatan shu hodisa ko‘rinadimi?
Visual Quality – Vizual sifat
Harakatlar tabiiymi? Obyektlar buziladimi? Tasvirda sun’iylik, uzilish, shakl buzilishi yoki sifat yo‘qolishi bormi?
Long-form Continuity – Uzoq hikoya uzluksizligi
Video boshidan oxirigacha izchilmi? Personaj, mahsulot, sahna va hodisa oqimi saqlanadimi?
Transition Stability – O‘tish barqarorligi
Sahnalar orasida qora kadr, tebranish, to‘satdan uzilish, muzlash yoki mantiqsiz sakrash bormi?
Holistic Presentation – Umumiy taqdimot sifati
Video yakunlangan ishdek ko‘rinadimi? Tomosha qilinadigan, tartibli va maqsadiga mosmi?
Text-Video Alignment – Matn-video uyg‘unligi
Video berilgan tavsif va ssenariy bilan qanchalik uyg‘un?
Audio-Video Synchronization – Ovoz-video sinxronizatsiyasi
Nutq, effekt, musiqa yoki muhit ovozi tasvirdagi hodisalar bilan vaqt jihatidan uyg‘unmi?
Audio Quality – Ovoz sifati
Ovoz realistikmi, sahnaga mosmi, bezovta qiluvchi buzilishlar bormi?
Long-Audio Coherence – Uzoq ovoz izchilligi
Ovoz bir daqiqa davomida uzilmasdan, ma’nosiz takrorlanmasdan, to‘satdan ovoz balandligi o‘zgarmasdan davom etadimi?
Bu o‘lchov tizimi bizga shuni aytadi: uzun video yaratishda muvaffaqiyat faqat «tasvir chiroylimi?» savoli bilan o‘lchanmaydi. Ovoz, hodisa ketma-ketligi, hikoya, vizual izchillik va sahna o‘tishlari birgalikda baholanishi kerak.
Grafik / jadval / sxema bo‘lsa, asosiy xabar nima?
Maqoladagi tasvirlar va jadvallar LongAV-Compassning oddiy model tartiblash jadvalidan ko‘proq narsani maqsad qilganini ko‘rsatadi.
Maqoladagi umumiy tizim sxemasi:
2-sahifadagi katta sxema LongAV-Compassning videoni bitta bo‘lak sifatida emas, turli tafsilot darajalarida baholashini ko‘rsatadi. To‘liq video, hodisa asosidagi kliplar, sahna o‘tishlari va namunaviy kadrlar alohida o‘rganiladi. Asosiy xabar shuki: uzun video yaratishda xatolar ba’zan bitta kadrda emas, hodisalar orasidagi o‘tishda yoki videoning umumiy oqimida paydo bo‘ladi.
Benchmark taqqoslash jadvali:
Maqoladagi taqqoslash jadvali oldingi benchmarklarning ko‘pchiligi qisqa video yoki bitta vazifa turiga e’tibor qaratganini ko‘rsatadi. LongAV-Compass esa matndan, tasvirdan va videodan ovozli-video yaratishni bir xil tom ostida baholashga harakat qiladi. Shuningdek, o‘rtacha video davomiyligi bir daqiqadan oshiq ishlab chiqarishlarga e’tibor qaratadi.
Vazifa qamrovi jadvali:
LongAV-Compassning 284 namunasi; 879 hodisa va 2.115 suratni o‘z ichiga olgan T2AV bo‘limi, 807 hodisa va 1.989 suratni o‘z ichiga olgan I2AV bo‘limi, 235 hodisa va 731 suratni o‘z ichiga olgan V2AV bo‘limi bilan tuzilgan. Bu testlarning faqat «bitta buyruq, bitta qisqa video» mantiqida emas; hodisa zanjirlari orqali qurilganini ko‘rsatadi.
Ssenariy va qiyinlik taqsimoti grafigi:
Maqoladagi doirasimon taqsimot tasviri testlarning vlog, kontent yaratuvchi videolari, performance reklamalar va brend reklamalari kabi turli sohalarga tarqalganini ko‘rsatadi. Bu muhim, chunki bir model qiziqarli vlog uslubida yaxshi ishlashi, lekin mahsulot tanishtiruvi yoki reklama ssenariysida qiynalishi mumkin.
Ma’lumot yaratish sxemasi:
Maqoladagi ma’lumot qurish jarayoni sxemasi sinov namunalarining ham haqiqiy videolardan, ham ssenariy shablonlaridan yaratilganini tushuntiradi. Keyin bu namunalar inson nazorati va sun’iy intellekt yordamidagi sifat baholashidan o‘tkaziladi. Asosiy xabar shuki: Benchmark faqat tasodifiy buyruqlardan iborat emas; hodisa tuzilmasi, reallik va baholash qiymati nazorat qilinadi.
Model natijalari jadvallari:
T2AV, I2AV va V2AV jadvallari Seedance 2.0, Kling 3.0, Veo 3.1 va turli ochiq manbali modellerining turli mezonlardagi unumdorligini ko‘rsatadi. Bu yerda bitta modelning har sohada mutlaq ustun ekanini aytish qiyin. Masalan, ba’zi modeller matndagi hodisalarni yaxshiroq bajaradi, ba’zilari esa ovoz sifati yoki sahna o‘tishlarida kuchliroq ko‘rinishi mumkin.
Inson uyg‘unligi grafigi:
Maqoladagi inson baholashi bilan avtomatik ballarning taqqoslangan grafigi LongAV-Compass ballarining inson afzalliklariga yuqori darajada yaqin ekanini ko‘rsatadi. Bu benchmarkning faqat texnik o‘lchovlardan iborat emasligini; inson idroki bilan ham ma’lum darajada uyg‘un natija berishini o‘ylashga undaydi.
Tajribalar qanday o‘tkazilgan?
Tadqiqotchilar 11 xil video yaratish tizimini sinab ko‘radi. Ular uch guruhga bo‘linadi:
- Yopiq / tijorat modellari
- Ochiq manbali modeller
- Agent asosidagi usullar
Tijorat modellari orasida Seedance 2.0, Kling 3.0 va Veo 3.1 bor. Ochiq manba tomonda LTX 2.3, LongCat, Wan2.2-I2V-A14B, HunyuanVideo 1.5-I2V, Helios, Open-Sora va davinci-magihuman kabi modeller baholanadi. Shuningdek, VideoDirectorGPT agent asosidagi misol sifatida kiritiladi.
Testlarda maqsadli video davomiyligi kamida 60 soniya qilib belgilangan va ko‘pchilik chiqishlar 60-120 soniya oralig‘ida baholanadi.
Modeller qo‘llab-quvvatlaydigan kirish turiga qarab sinovdan o‘tkaziladi. Masalan, ba’zi modeller ovoz yarata olmasa, bu modeller video metrikalari bilan baholanadi, lekin ovoz metrikalarda «mos emas» deb ko‘riladi.
Baholash jarayonida faqat bitta ball ishlatilmaydi. Har bir video hodisa asosida, o‘tish asosida, to‘liq video darajasida va ovoz-video uyg‘unligi jihatidan alohida o‘rganiladi. Shunday qilib, modelning qayerda muvaffaqiyatli, qayerda zaif ekani aniqroq ko‘rinadi.
Natijalar nima ko‘rsatadi?
Natijalar zamonaviy uzun ovozli-video yaratish modellerining bitta ball bilan tushuntirib bo‘lmaydigan darajada turli kuchli va zaif tomonlarga ega ekanini ko‘rsatadi.
Matndan ovozli video yaratish vazifasida Kling 3.0 hodisalarni bajarish va uzoq shakl uzluksizligi jihatidan kuchli ko‘rinadi. Seedance 2.0 esa vizual sifat, umumiy taqdimot va ovoz mezonlarida ajralib turadi.
Tasvirdan ovozli video yaratish vazifasida Seedance 2.0 umumiy jihatdan kuchli unumdorlik ko‘rsatadi. Kling 3.0 referens tasvirning birinchi kadrda saqlanishi jihatidan yaxshi natija beradi. Ammo maqolaning muhim topilmalaridan biri shuki: bir model referens tasvirdagi shaxs yoki obyektni tasvir sifatida saqlasa ham, uzun videoda hodisa oqimi va hikoya uzluksizligini saqlashda qiynalishi mumkin.
Videodan davom yaratish vazifasida Seedance 2.0 aniq ajralib turadi. Ayniqsa boshlang‘ich videoga moslashish, hodisa davomiyligi, vizual sifat va ovoz sifati jihatidan kuchli natijalar beradi. Veo 3.1 ba’zi hodisalarni ma’noli tarzda davom ettira olsa ham, referens video chegarasidan keyin uzluksizlik va o‘tish barqarorligi tomonida zaifroq natijalar ko‘rsatishi mumkin.
Ochiq manbali modeller ba’zi mezonlarda oqilona natijalar berishi ko‘rinadi; biroq uzoq hikoya, hodisa ketma-ketligi, mahsulot namoyishi, vizual yaxlitlik va ovoz-video uyg‘unligi kabi sohalarda tijorat modellari bilan oralarida hali sezilarli farq bor.
Maqolaning eng e’tiborga loyiq topilmalaridan biri performance reklamalar ssenariysining modeller uchun ayniqsa qiyin ekanidir. Chunki bunday videolarda mahsulotning ko‘rsatilishi, funksiyasining tushuntirilishi, foydalanish jarayonining mantiqiy rivojlanishi va ishontiruvchi oqim yaratilishi kerak. Modeller ko‘pincha mahsulotni ko‘rsata olsa ham, uning funksiyasini to‘g‘ri ketma-ketlikda tushuntirishda yoki sabab-oqibat oqimini saqlashda qiynalishi mumkin.
Bu nima uchun muhim?
Ushbu tadqiqot sun’iy intellekt bilan video yaratishning faqat «chiroyli tasvir yaratish» masalasi emasligini ko‘rsatadi.
Qisqa klipda ta’sirli ko‘rinadigan model uzun videoda quyidagi muammolarni boshdan kechirishi mumkin:
- Personajning yuzi yoki kiyimi o‘zgarishi mumkin.
- Mahsulot bir sahnada boshqacha, boshqa sahnada boshqacha ko‘rinishi mumkin.
- Ovoz tasvirdagi hodisa bilan mos kelmasligi mumkin.
- Hikoya boshida va’da qilgan narsani yakunlamasligi mumkin.
- Sahna o‘tishlarida uzilish yoki muzlash paydo bo‘lishi mumkin.
- Reklama videosida mahsulot funksiyasi noto‘g‘ri yoki to‘liq emas tushuntirilishi mumkin.
Shu sababli uzun video yaratadigan sun’iy intellekt tizimlarini sinash uchun batafsilroq baholash vositalari kerak. LongAV-Compass bu ehtiyojga javob berishga harakat qiladi.
Verianla o‘quvchisi uchun asosiy xabar shuki: sun’iy intellekt modelining «video yarata olishi» uning uzun va izchil ovozli-video hikoyasini qura olishini anglatmaydi. Uzun video yaratishdagi asosiy sinov — uzluksizlik, izchillik, ovoz uyg‘unligi va hodisa oqimini saqlay olishdir.
E’tibor berish kerak bo‘lgan nuqtalar
Bu maqola kuchli benchmark taklif qiladi; ammo ba’zi cheklovlar bor.
Birinchidan, tadqiqot arXiv preprint sifatida nashr etilganga o‘xshaydi. Shu sababli natijalarning peer-review nashr jarayoni va mustaqil tasdiqlar bilan qo‘llab-quvvatlanishi muhim.
Ikkinchidan, baholanayotgan modeller versiyalari vaqt o‘tishi bilan o‘zgarishi mumkin. Tijorat sun’iy intellekt xizmatlari tez-tez yangilanadi, shuning uchun bugun olingan natijalar kelajakda farq qilishi mumkin.
Uchinchidan, avtomatik baholash tizimlari inson baholashiga yaqinlashsa ham, inson hukmini to‘liq o‘rnini bosmaydi. Maqolada inson uyg‘unligi tadqiqoti o‘tkazilgan bo‘lsa-da, bu pilot darajasida.
To‘rtinchidan, ba’zi metrikalar ma’lum vizual yoki multimodal ifoda modelleriga tayanadi. Masalan, CLIP, DINO-v2, ArcFace va ImageBind kabi vositalar foydali signallar bersa-da, videoning estetik, hikoya va tijorat muvaffaqiyatini to‘liq o‘lchay olmaydi.
Beshinchidan, model tartiblashlari ishlatilgan sinov ssenariylariga bog‘liq. Vlog, reklama, mahsulot tanishtiruvi yoki hikoya videosidek turli kontent turlari modellerni turlicha qiynashi mumkin.
Xulosa
LongAV-Compass sun’iy intellekt bilan uzun ovozli-video yaratishni baholash uchun keng qamrovli sinov tizimini taklif qiladi. Tadqiqot matndan, tasvirdan va videodan uzun ovozli-video yaratishni bir xil tom ostida ko‘rib chiqishi bilan ajralib turadi.
Tadqiqotning asosiy natijasi shuki: zamonaviy video yaratish modellari qisqa kliplarda ta’sirli ko‘rinsa ham, bir daqiqadan oshiq kontentlarda personaj izchilligi, hodisa ketma-ketligi, sahna o‘tishlari, ovoz-video sinxronizatsiyasi va hikoya yaxlitligi hali jiddiy sinovdir.
Bu benchmark faqat modellerni tartiblash uchun emas, modeller qayerda muvaffaqiyatsizlikka uchrayotganini tashxislash uchun mo‘ljallangan. Bu esa kelajakda ishonchliroq, izchilroq va uzunroq sun’iy intellekt videolari yaratishni istagan tadqiqotchilar uchun muhim qadam bo‘lishi mumkin.
Verianla nuqtai nazaridan ushbu maqolaning asosiy xabari aniq: sun’iy intellekt video yaratishdagi asosiy taraqqiyot faqat chiroyliroq kadrlar yaratish emas; uzoq vaqt davomida ma’no, ovoz, personaj va hikoyani saqlay olishdir.
Manba va usul eslatmasi
Bu kontent Tengfei Liu, Yang Shi, Xuanyu Zhu va hamkasblari tomonidan tayyorlangan “LongAV-Compass: Towards Unified Evaluation of Minute-Scale Audio-Visual Generation Across T2AV, I2AV, and V2AV” nomli akademik ishdan foydalanib, Verianla tahririy formatida mustaqil tayyorlangan.
Tadqiqot arXiv’da 25 May 2026 sanali preprint sifatida ko‘rinadi. Bu yozuv so‘zma-so‘z tarjima emas; maqoladagi usul, jadvallar, grafklar, tajribalar va natijalar soddalashtirilib, o‘zbek o‘quvchi uchun qayta bayon etilgan. Kontent ma’lumot va ta’lim maqsadida. Sun’iy intellekt modelini tanlash, tijorat video yaratish yoki texnik tizim baholash uchun yolg‘iz qaror qo‘llanmasi sifatida ishlatilmasligi kerak.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan