

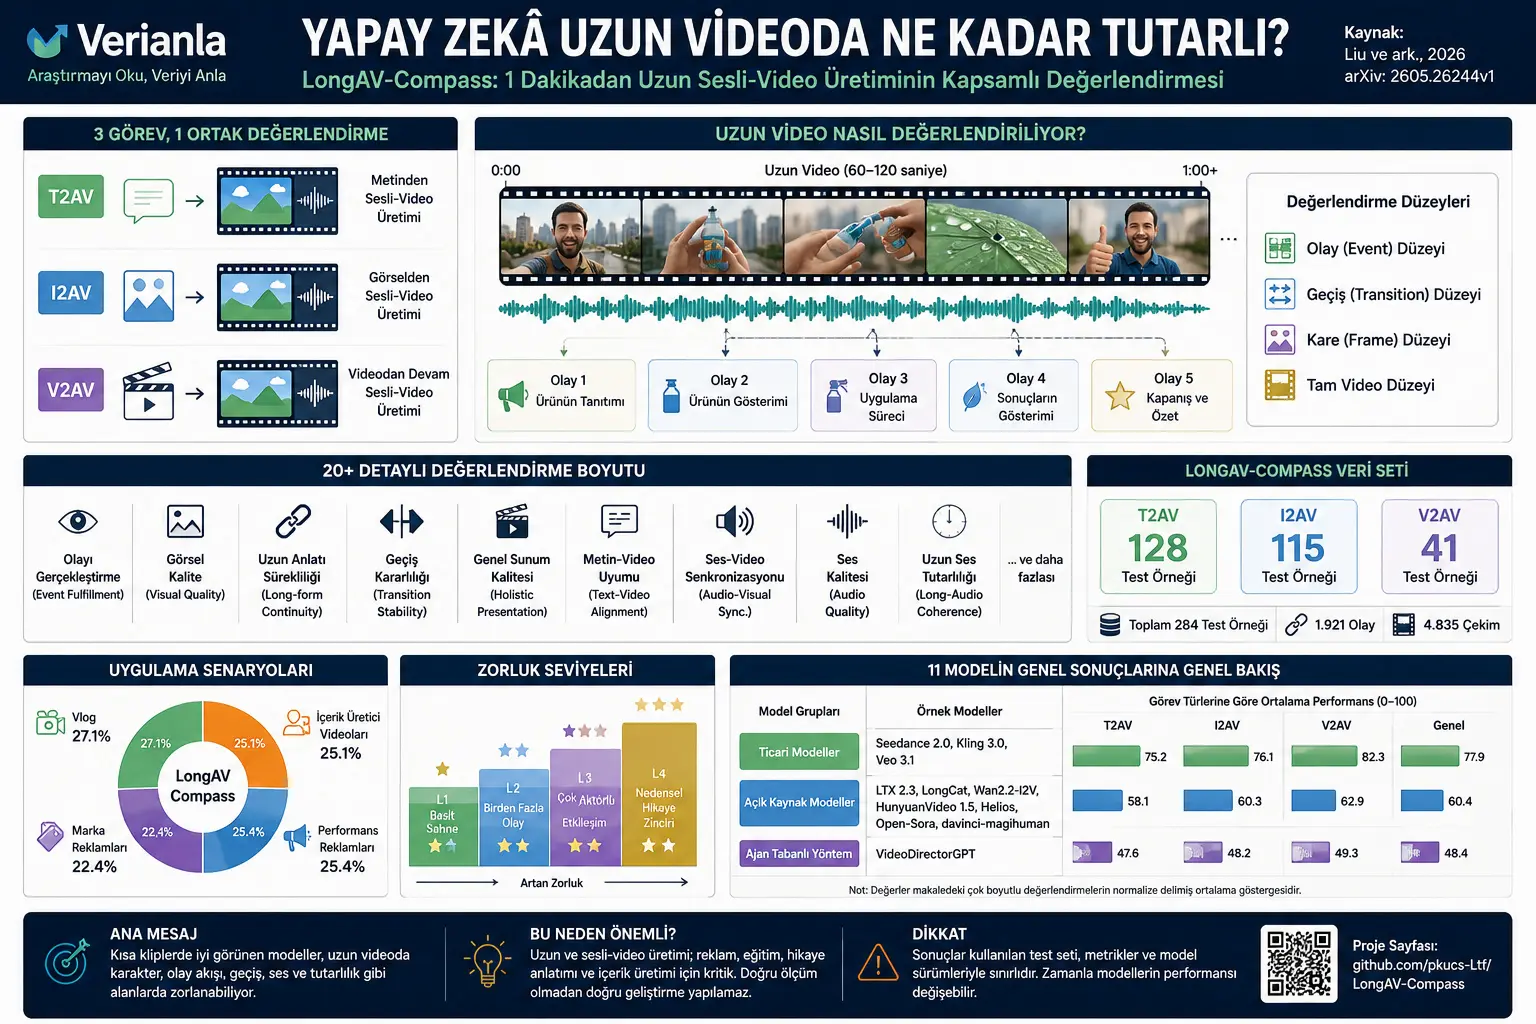
Uzalishaji wa video kwa akili bandia unaendelea haraka. Sasa si klipu fupi za sekunde chache tu, bali pia video zinazozidi dakika moja, matangazo, maudhui ya mtindo wa vlog, utambulisho wa bidhaa na usimulizi wa hadithi vinaweza kutengenezwa. Lakini kuna swali muhimu: ikiwa modeli inaweza kutengeneza tukio fupi vizuri, je inaweza kuhifadhi mhusika yule yule, mtiririko ule ule wa hadithi, uwiano ule ule wa sauti na mipito ya kimantiki katika video ndefu?
Tengfei Liu na wenzake wanatafuta jibu la swali hili kwa kupendekeza mfumo wa tathmini uitwao LongAV-Compass. Mfumo huu unachunguza uzalishaji wa video yenye sauti inayozidi dakika moja katika aina tatu za kazi: uzalishaji wa video yenye sauti kutoka maandishi, uzalishaji wa video yenye sauti kutoka picha, na uzalishaji wa mwendelezo kutoka video iliyopo.
Utafiti unatathmini mifumo 11 tofauti ya uzalishaji wa video kupitia mifano 284 ya majaribio. Matokeo yanaonyesha kuwa ingawa modeli za sasa zinaonekana za kuvutia katika klipu fupi, bado zinatatizika katika simulizi ya muda mrefu, uthabiti wa mhusika, mipito ya matukio na uwiano wa sauti-video.
Leo, modeli nyingi za akili bandia zinaweza kutengeneza video fupi. Katika tukio la sekunde chache, ubora wa kuona unaweza kuwa wa juu, mwendo unaweza kuonekana wa kuvutia, na wazo kuu katika maandishi linaweza kukamatwa kwa takriban.
Lakini uzalishaji wa video ndefu ni tatizo tofauti. Katika video ya dakika moja, haitoshi modeli itengeneze tu picha nzuri. Inahitaji pia kuhifadhi yafuatayo:
- Mhusika au bidhaa inapaswa kubaki sawa.
- Mipito ya matukio inapaswa kuwa ya kimantiki.
- Haipaswi kupoteza mpangilio wa matukio.
- Sauti inapaswa kuwa sawa na mwendo katika picha.
- Hadithi inapaswa kuendelea kwa uthabiti kutoka mwanzo hadi mwisho.
- Katika maudhui kama utambulisho wa bidhaa au tangazo, ahadi zilizotolewa na michakato iliyoonyeshwa inapaswa kukamilishana.
Benchmark nyingi zilizopo, yaani majaribio ya tathmini ya modeli, kwa kawaida huzingatia video fupi za sekunde 5-10. Majibio haya yanaweza kuwa muhimu kwa kupima ubora wa kuona au uwiano na maandishi katika klipu fupi. Hata hivyo, yanaweza kuwa hayatoshi kukamata uharibifu unaojitokeza katika video ndefu.
Kwa hiyo watafiti wanazingatia swali hili:
Tunawezaje kupima modeli za video za akili bandia kwa usahihi zaidi ili kuona kama zinaweza kweli kutengeneza video ndefu yenye sauti?
Mbinu inapendekeza nini?
Makala inapendekeza benchmark mpya iitwayo LongAV-Compass. Benchmark inalenga kupima uzalishaji wa video ndefu yenye sauti wa modeli za akili bandia kwa undani zaidi na kwa njia ya uchunguzi.
LongAV-Compass inajumuisha aina tatu kuu za kazi:
1. T2AV – Text-to-Audio-Video
Uzalishaji wa video yenye sauti kutoka maandishi. Modeli hujaribu kutengeneza video ndefu yenye picha na sauti kutoka kwa senario au maelezo ya maandishi yaliyotolewa.
2. I2AV – Image-to-Audio-Video
Uzalishaji wa video yenye sauti kutoka picha. Modeli hutengeneza video ndefu kwa kutumia picha ya rejeleo na senario. Swali muhimu hapa ni: je mtu, kitu, bidhaa au tukio katika picha linaweza kuhifadhiwa katika video yote ndefu?
3. V2AV – Video-to-Audio-Video
Uzalishaji wa mwendelezo wa video yenye sauti kutoka video. Modeli huchukua video fupi ya kuanzia na kuiendeleza kulingana na senario. Lengo hapa ni kutengeneza mwendelezo bila kuharibu mtindo, mhusika, tukio na mtiririko wa video ya kuanzia.
LongAV-Compass ina jumla ya mifano 284 ya majaribio:
- Mifano 128 ya uzalishaji wa video yenye sauti kutoka maandishi
- Mifano 115 ya uzalishaji wa video yenye sauti kutoka picha
- Mifano 41 ya uzalishaji wa mwendelezo kutoka video
Mifano hii haikuchaguliwa kwa nasibu tu. Watafiti hupanga majaribio kulingana na senario tofauti za matumizi na viwango vya ugumu.
Senariyo za matumizi ni hizi:
- Vlog
- Video za watengenezaji wa maudhui
- Matangazo ya performance
- Matangazo ya chapa
Viwango vya ugumu hupanda kutoka L1 hadi L4. Vinakwenda kutoka matukio rahisi hadi simulizi ngumu zaidi zenye matukio mengi, waigizaji wengi, na zinazohitaji mtiririko wa sababu-athari.
Fomula zinasema nini?
Katika makala hii, fomula nyingi za hisabati zenye ugumu hazijitokezi mbele. Nguvu kuu ya utafiti iko katika jinsi mfumo wa upimaji ulivyojengwa.
Badala ya kutoa “alama ya jumla” moja, watafiti hugawanya uzalishaji wa video ndefu katika sehemu nyingi. Kwa sababu modeli moja inaweza kuwa nzuri kwa kuona lakini dhaifu katika uwiano wa sauti-video. Modeli nyingine inaweza kuhifadhi picha ya bidhaa lakini ishindwe kukamilisha hadithi.
Vipimo kuu vinavyopimwa ni hivi:
Event Fulfillment – Utekelezaji wa tukio
Je, modeli inaweza kweli kutengeneza matukio yaliyoombwa katika senario? Kwa mfano, ikiwa inasemwa “bidhaa inanyunyiziwa kwenye jani”, je tukio hilo linaonekana kweli katika video?
Visual Quality – Ubora wa kuona
Je, mwendo ni wa asili? Je, vitu vinaharibika? Je, kuna uonekano bandia, kuvunjika, kuharibika kwa umbo au kupoteza ubora katika picha?
Long-form Continuity – Mwendelezo wa simulizi ndefu
Je, video ina uthabiti kutoka mwanzo hadi mwisho? Je, mhusika, bidhaa, tukio na mtiririko wa matukio vinahifadhiwa?
Transition Stability – Uthabiti wa mpito
Je, kati ya matukio kuna fremu nyeusi, kutetemeka, kuvunjika ghafla, kuganda au kuruka bila mantiki?
Holistic Presentation – Ubora wa uwasilishaji wa jumla
Je, video inaonekana kama kazi iliyokamilika? Je, inaweza kutazamwa, imewekwa vizuri na inafaa lengo lake?
Text-Video Alignment – Uwiano wa maandishi-video
Video inaendana kwa kiasi gani na maelezo na senario iliyotolewa?
Audio-Video Synchronization – Usawazishaji wa sauti-video
Je, usemi, athari, muziki au sauti za mazingira zinaendana kwa muda na matukio katika picha?
Audio Quality – Ubora wa sauti
Je, sauti ni ya kweli, inafaa tukio, na ina uharibifu unaosumbua?
Long-Audio Coherence – Uthabiti wa sauti ndefu
Je, sauti inaendelea kwa dakika moja bila kuvunjika, bila kurudia yasiyo na maana, na bila mabadiliko ghafla ya kiwango cha sauti?
Mfumo huu wa upimaji unatuambia hivi: mafanikio katika uzalishaji wa video ndefu hayawezi kupimwa kwa swali la “je picha ni nzuri?” tu. Sauti, mpangilio wa matukio, simulizi, uthabiti wa kuona na mipito ya matukio vinapaswa kutathminiwa pamoja.
Ikiwa kuna grafu / jedwali / mchoro, ujumbe kuu ni nini?
Picha na jedwali katika makala zinaonyesha kuwa LongAV-Compass inalenga zaidi ya jedwali la kawaida la kupanga modeli.
Mchoro wa jumla wa mfumo katika makala:
Mchoro mkubwa katika ukurasa wa 2 unaonyesha kuwa LongAV-Compass haitathmini video kama kipande kimoja, bali katika viwango tofauti vya undani. Video kamili, klipu za matukio, mipito ya matukio na fremu za mfano huchunguzwa kando. Ujumbe kuu ni huu: katika uzalishaji wa video ndefu, makosa wakati mwingine hayatokei katika fremu moja, bali katika mpito kati ya matukio au katika mtiririko wa jumla wa video.
Jedwali la ulinganisho wa benchmark:
Jedwali la ulinganisho katika makala linaonyesha kuwa benchmark nyingi za awali zililenga video fupi au aina moja ya kazi. LongAV-Compass, kwa upande wake, inajaribu kutathmini uzalishaji wa video yenye sauti kutoka maandishi, picha na video chini ya paa moja. Pia inazingatia uzalishaji ambao muda wa wastani wa video unazidi dakika moja.
Jedwali la wigo wa kazi:
Mifano 284 ya LongAV-Compass imeundwa kwa sehemu ya T2AV yenye matukio 879 na risasi 2.115, sehemu ya I2AV yenye matukio 807 na risasi 1.989, na sehemu ya V2AV yenye matukio 235 na risasi 731. Hii inaonyesha kuwa majaribio si ya mantiki ya “amri moja, video fupi moja” tu; yamejengwa kupitia minyororo ya matukio.
Grafu ya usambazaji wa senario na ugumu:
Picha ya usambazaji wa mviringo katika makala inaonyesha kuwa majaribio yameenea katika nyanja tofauti kama vlog, video za watengenezaji wa maudhui, matangazo ya performance na matangazo ya chapa. Hii ni muhimu, kwa sababu modeli inaweza kufanya vizuri katika mtindo wa vlog wa kuvutia lakini itatizika katika senario ya utambulisho wa bidhaa au tangazo.
Mchoro wa uundaji wa data:
Mchoro wa mchakato wa ujenzi wa data katika makala unaeleza kuwa mifano ya majaribio ilitengenezwa kutoka video halisi na pia kutoka templeti za senario. Kisha mifano hii inapitia udhibiti wa binadamu na tathmini ya ubora inayosaidiwa na akili bandia. Ujumbe kuu ni huu: Benchmark si amri za nasibu tu; muundo wa matukio, uhalisia na thamani ya tathmini hudhibitiwa.
Jedwali za matokeo ya modeli:
Jedwali za T2AV, I2AV na V2AV zinaonyesha utendaji wa Seedance 2.0, Kling 3.0, Veo 3.1 na modeli mbalimbali za chanzo wazi katika vigezo tofauti. Hapa ni vigumu kusema kuwa modeli moja ina ubora kamili katika kila nyanja. Kwa mfano, baadhi ya modeli hutekeleza matukio katika maandishi vizuri zaidi, wakati nyingine zinaonekana na nguvu zaidi katika ubora wa sauti au mipito ya matukio.
Grafu ya uwiano na binadamu:
Grafu inayolinganisha tathmini ya binadamu na alama za kiotomatiki katika makala inaonyesha kuwa alama za LongAV-Compass ziko karibu sana na mapendeleo ya binadamu. Hii inafanya mtu afikiri kuwa benchmark si vipimo vya kiufundi tu; inatoa pia matokeo yanayolingana kwa kiasi na mtazamo wa binadamu.
Majaribio yalifanywaje?
Watafiti wanajaribu mifumo 11 tofauti ya uzalishaji wa video. Zimegawanywa katika makundi matatu:
- Modeli zilizofungwa / za kibiashara
- Modeli za chanzo wazi
- Mbinu zinazotegemea mawakala
Miongoni mwa modeli za kibiashara kuna Seedance 2.0, Kling 3.0 na Veo 3.1. Upande wa chanzo wazi, modeli kama LTX 2.3, LongCat, Wan2.2-I2V-A14B, HunyuanVideo 1.5-I2V, Helios, Open-Sora na davinci-magihuman zinatathminiwa. Pia VideoDirectorGPT inajumuishwa kama mfano unaotegemea wakala.
Katika majaribio, muda lengwa wa video umewekwa kuwa angalau sekunde 60, na matokeo mengi yanatathminiwa katika kipindi cha sekunde 60-120.
Modeli hujaribiwa kulingana na aina ya pembejeo wanazounga mkono. Kwa mfano, ikiwa baadhi ya modeli haziwezi kutengeneza sauti, modeli hizi zinatathminiwa kwa vipimo vya video lakini katika vipimo vya sauti zinachukuliwa kama “hazifai”.
Katika mchakato wa tathmini, alama moja haitumiki peke yake. Kila video huchunguzwa kando kwa msingi wa tukio, mpito, kiwango cha video kamili, na uwiano wa sauti-video. Hivyo, inakuwa wazi zaidi mahali modeli inafanikiwa na mahali ilipo dhaifu.
Matokeo yanaonyesha nini?
Matokeo yanaonyesha kuwa modeli za sasa za uzalishaji wa video ndefu yenye sauti zina nguvu na udhaifu tofauti ambao hauwezi kuelezwa kwa alama moja.
Katika kazi ya uzalishaji wa video yenye sauti kutoka maandishi Kling 3.0 inaonekana yenye nguvu katika utekelezaji wa matukio na mwendelezo wa umbo refu. Seedance 2.0, kwa upande wake, inajitokeza katika ubora wa kuona, uwasilishaji wa jumla na vigezo vya sauti.
Katika kazi ya uzalishaji wa video yenye sauti kutoka picha Seedance 2.0 inaonyesha utendaji wenye nguvu kwa ujumla. Kling 3.0 inatoa matokeo mazuri katika kuhifadhi picha ya rejeleo katika fremu ya kwanza. Hata hivyo, moja ya matokeo muhimu ya makala ni hii: hata kama modeli inahifadhi mtu au kitu katika picha ya rejeleo kama picha, bado inaweza kutatizika kuhifadhi mtiririko wa matukio na mwendelezo wa simulizi katika video ndefu.
Katika kazi ya uzalishaji wa mwendelezo kutoka video Seedance 2.0 inajitokeza wazi. Haswa inatoa matokeo yenye nguvu katika kuendana na video ya kuanzia, mwendelezo wa matukio, ubora wa kuona na ubora wa sauti. Ingawa Veo 3.1 inaweza kuendeleza baadhi ya matukio kwa maana, inaweza kuonyesha matokeo dhaifu zaidi katika mwendelezo na uthabiti wa mpito baada ya mpaka wa video ya rejeleo.
Inaonekana kuwa modeli za chanzo wazi zinatoa matokeo yanayokubalika katika baadhi ya vigezo; hata hivyo, katika nyanja kama simulizi ndefu, mpangilio wa matukio, onyesho la bidhaa, ujumla wa kuona na uwiano wa sauti-video bado kuna tofauti dhahiri na modeli za kibiashara.
Moja ya matokeo yenye kuvutia zaidi ya makala ni kwamba senario ya matangazo ya performance ni ngumu hasa kwa modeli. Kwa sababu katika video kama hizi inahitajika kuonyesha bidhaa, kueleza kazi yake, kuendeleza mchakato wa matumizi kwa mantiki, na kuunda mtiririko wa kushawishi. Mara nyingi modeli zinaweza kuonyesha bidhaa, lakini zinatatizika kueleza kazi yake kwa mpangilio sahihi au kuhifadhi mtiririko wa sababu-athari.
Kwa nini hii ni muhimu?
Utafiti huu unaonyesha kuwa uzalishaji wa video kwa akili bandia si suala la “kutengeneza picha nzuri” tu.
Modeli inayoonekana ya kuvutia katika klipu fupi inaweza kukumbana na matatizo haya katika video ndefu:
- Uso au mavazi ya mhusika yanaweza kubadilika.
- Bidhaa inaweza kuonekana tofauti katika tukio moja na tofauti katika lingine.
- Sauti inaweza kutokubaliana na tukio katika picha.
- Hadithi inaweza kushindwa kukamilisha kile ilichoahidi mwanzoni.
- Kunaweza kutokea kuvunjika au kuganda katika mipito ya matukio.
- Katika video ya tangazo, kazi ya bidhaa inaweza kuelezwa vibaya au kwa upungufu.
Kwa hiyo, zana za tathmini za kina zaidi zinahitajika ili kujaribu mifumo ya akili bandia inayotengeneza video ndefu. LongAV-Compass inajaribu kujibu hitaji hili.
Kwa msomaji wa Verianla, ujumbe kuu ni huu: “kuweza kutengeneza video” kwa modeli ya akili bandia hakumaanishi kuwa inaweza kujenga hadithi ndefu na thabiti ya video yenye sauti. Mtihani kuu katika uzalishaji wa video ndefu ni kuhifadhi mwendelezo, uthabiti, uwiano wa sauti na mtiririko wa matukio.
Mambo yanayostahili kuzingatiwa
Makala hii inapendekeza benchmark yenye nguvu; hata hivyo, kuna baadhi ya vikwazo.
Kwanza, utafiti unaonekana kuchapishwa kama preprint ya arXiv. Kwa hiyo ni muhimu matokeo yaungwa mkono na mchakato wa uchapishaji wa peer-review na uthibitishaji huru.
Pili, matoleo ya modeli zinazotathminiwa yanaweza kubadilika kwa muda. Huduma za kibiashara za akili bandia husasishwa mara kwa mara, kwa hiyo matokeo yaliyopatikana leo yanaweza kutofautiana baadaye.
Tatu, ingawa mifumo ya tathmini ya kiotomatiki inaweza kukaribia tathmini ya binadamu, haichukui nafasi kamili ya hukumu ya binadamu. Ingawa utafiti wa uwiano na binadamu umefanywa katika makala, uko katika kiwango cha majaribio ya awali.
Nne, baadhi ya vipimo hutegemea modeli fulani za kuona au za uwakilishi wa moda nyingi. Kwa mfano, zana kama CLIP, DINO-v2, ArcFace na ImageBind, ingawa zinatoa ishara muhimu, haziwezi kupima kikamilifu mafanikio ya urembo, simulizi na biashara ya video.
Tano, upangaji wa modeli unategemea senario za majaribio zilizotumiwa. Aina tofauti za maudhui kama vlog, tangazo, utambulisho wa bidhaa au video ya hadithi zinaweza kufanya modeli zitatizike kwa njia tofauti.
Hitimisho
LongAV-Compass inapendekeza mfumo wa kina wa majaribio kwa kutathmini uzalishaji wa video ndefu yenye sauti kwa akili bandia. Utafiti unajitokeza kwa kuangalia uzalishaji wa video ndefu yenye sauti kutoka maandishi, picha na video chini ya paa moja.
Matokeo kuu ya utafiti ni haya: ingawa modeli za sasa za uzalishaji wa video zinaonekana za kuvutia katika klipu fupi, katika maudhui yanayozidi dakika moja uthabiti wa mhusika, mpangilio wa matukio, mipito ya matukio, usawazishaji wa sauti-video na ujumla wa simulizi bado ni mtihani mkubwa.
Benchmark hii haijusanifiwi kupanga modeli tu, bali pia kutambua mahali modeli zinashindwa. Hii inaweza kuwa hatua muhimu kwa watafiti wanaotaka siku zijazo kutengeneza video za akili bandia zenye kuaminika zaidi, uthabiti zaidi na urefu zaidi.
Kutoka kwa mtazamo wa Verianla, ujumbe kuu wa makala hii ni wazi: maendeleo ya kweli katika uzalishaji wa video kwa akili bandia si kutengeneza fremu nzuri zaidi tu; ni kuweza kuhifadhi maana, sauti, mhusika na hadithi kwa muda mrefu.
Kidokezo cha chanzo na mbinu
Maudhui haya yameandaliwa kwa uhuru katika muundo wa uhariri wa Verianla kwa kutumia kazi ya kitaaluma yenye jina “LongAV-Compass: Towards Unified Evaluation of Minute-Scale Audio-Visual Generation Across T2AV, I2AV, and V2AV” iliyoandaliwa na Tengfei Liu, Yang Shi, Xuanyu Zhu na wenzake.
Utafiti unaonekana kwenye arXiv kama preprint ya tarehe 25 Mei 2026. Andiko hili si tafsiri neno kwa neno; mbinu, jedwali, grafu, majaribio na matokeo katika makala yamerahisishwa na kuelezwa upya kwa msomaji wa Kiswahili. Maudhui yana lengo la kutoa taarifa na elimu. Hayapaswi kutumiwa kama mwongozo pekee wa uamuzi kwa kuchagua modeli ya akili bandia, uzalishaji wa video wa kibiashara, au tathmini ya mfumo wa kiufundi.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *