

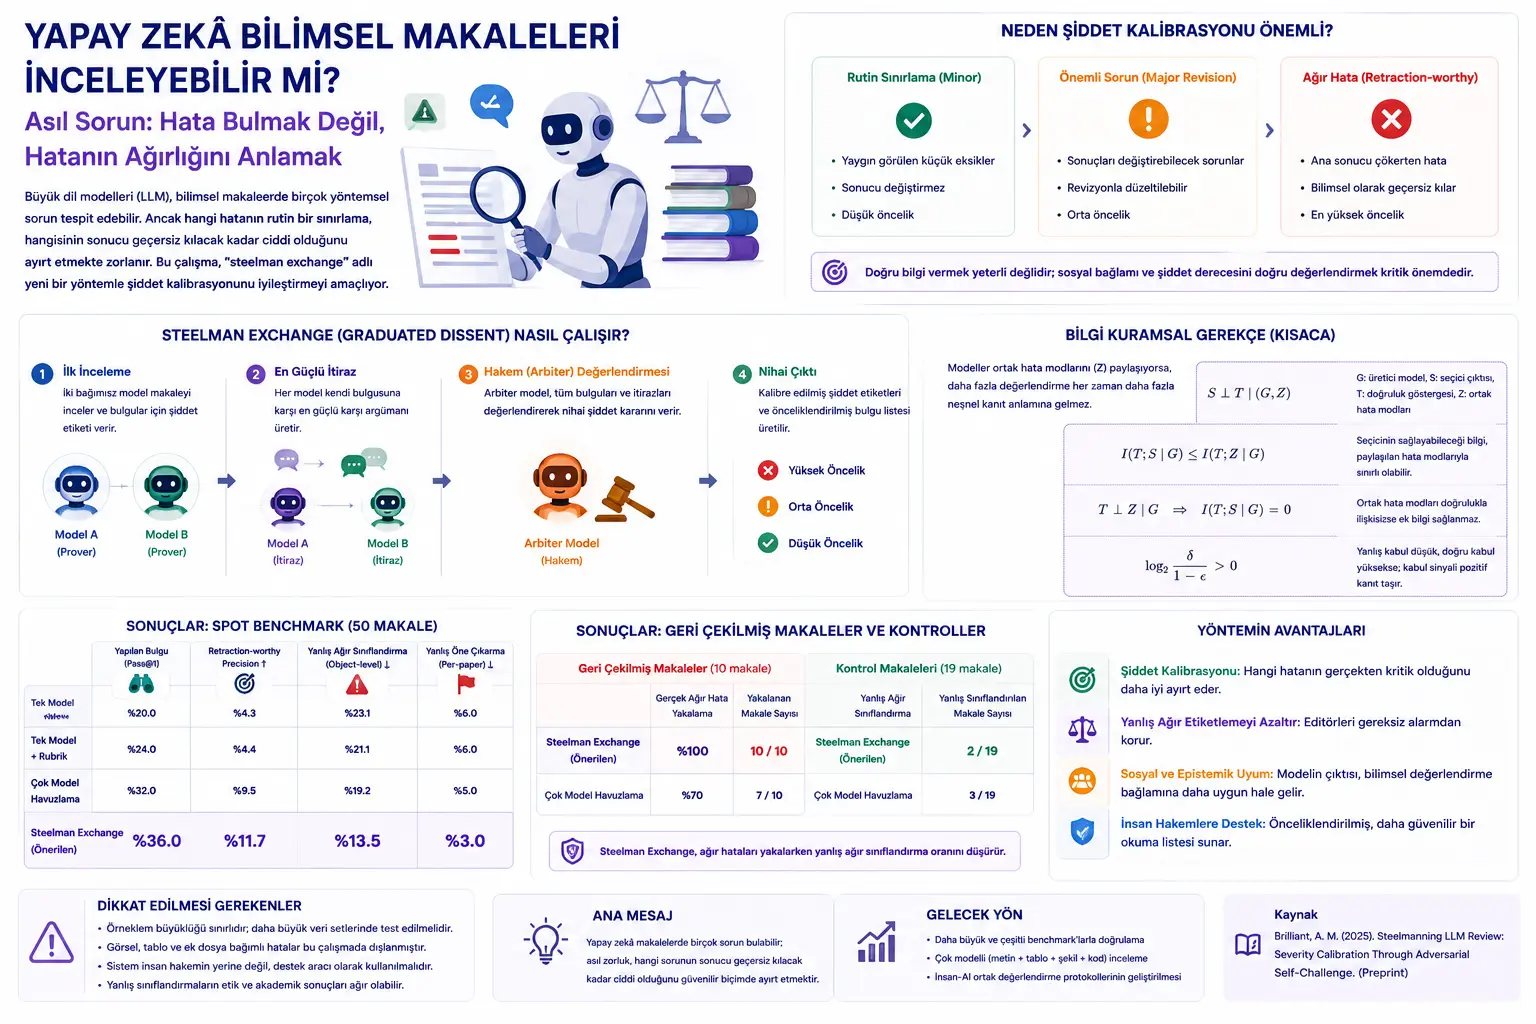
Katta til modellari moliyaviy makala'larda metod muammolari raporlash etislik'larini va mumkin tutarsizlik'larni tez to'g'ri aniqliya'ladi. Ammo ushbu tadqiqot'ning urg'alang'an muhim nuqtasi shundaki: Bir sun'iy intellekt sistema'si ko'p savol'ni raporlasa'n'da lekin qaysi'si haqiqatan muhim ekanlig'ini ayta'la'madinga'n'da tahrir'chi yoki xakem'ga yordam berashligi'ng o'rniga faqat yangi o'qish yuk'i yaratadi.
Tadqiqot'ning markazida qalgan kavram "severity calibration" ya'ni shiddat kalibratsiyasi'dir. Bu yerda muammo bir xata'ning makala'ning asosiy natija'sini nomaqbul qilish'iga katan'digan tez ciddi mi yo'qsa yalniz odam'i ta'mirlash cheklash'i mi ekanlig'ini alohida qilmak'dir. Moliyaviy baholash asosida ushbu farq' hayot'i muhim'dir. Chunki har qilunchi xata bir xil og'irlika emas.
Muallif bu muammo'ga "steelman exchange" deb ataladigan adversarial usul' taklif qiladi. Ikkita alohida model avval makala'ni baholaydi va savol'iga shiddat etiketa beradi. Keyinra har model o'z ilk baholash'iga qarshi eng kuchliroq qarshi argument yaratadi: "Ehtimol bu savol haqiqatan bu qadar og'ir mi yo'qsa jadda'n mi katta qilind?" So'ng bosqich'da arbiter model barcha material' ko'radi va yanada ehtiyotli shiddat qaror beradi.
Asosiy natija shundaki: Sodda ko'p model havuz'lash yanada ko'p savol chiqara'la'da; lekin shiddat kalibratsiyasi'ni avtomatik ravishda yaxshi qilmi'ydi. Bunga qarama'nda o'z iddiasi'ga qarshi kuchliroq itiraz yaratish'ga majbur qilingan modellari ayniqsa "orqasiga che'kila'shi kerak" darajasidagi og'ir xata tasnif'lash'ida yanada ehtiyotli va yanada foydalanish mumkin natija'lar yarata'ladi.
Muammo nima?
Moliyaviy makala tekshirish'ida sun'iy intellekt'ning ilk qarashta ko'p jozib taklif'i bor: Makala'ni tez o'qiy'di metod muammolari'ni ro'yhat qiladi istatistik tutarsizlik'larini turgan'da xakem'ga yordam beradi. Lekin amali'yat'da paydo bo'ladigan muammo yalniz xata topish emas. Haqiqiy muammo topilgan xata'larning qaysi'si haqiqatan muhim ekanlig'i'ni alohida qilmak'dir.
Bir sistema bir makala uchun 15 savol yaratya'pti lekin bular'ning ko'p kichik bo'lsun'chik asosiy muammo bo'lsa'n'da insan tahrir'chi yoki hali barchisi'ni biryam baholash majbur. Bu holat'da sistema triage ya'ni prioritet'lash qilmagan'lik; yalniz yuqori shovqin o'qish ro'yhat'i yaratdi.
Tadqiqot'ning ele al'gan asosiy dar'bag'i budur: Katta til modellari moliyaviy matnlarda ko'p muammo'lari topa'ladi; lekin "kichik raporlash etislig'i" "muhim revizyon talab etadigan metod muammolari" va "makala'ning asosiy natija'sini cha'ndi cha'l'cha qilish' o'ldur'uch'i xata" orasidagi farq'ni her doim ishonchli ravishda alohida qila'la'da.
Bu muammo sun'iy intellekt qo'llab-quvvatlanuvchi moliyaviy nashr'iyot'da yanada muhim bo'ladi. Makala yozish'da AI ishlatilmasi ko'payganchada yuzaki yozish sifat'i endi ishonchli sifat ko'rsatgich'i bo'lmas'dan uzoqla'yadi. Tahrir'chi va xakem'larning ehtiyoj'i yalniz "bu makala'da muammo bo'ladi mi?" deyadigan sistema'lar emas balki "bu muammo qanchalik ciddi?" savoli'ga yanada kalibre javob beruvchi sistema'lardir.
Usul nima taklif qiladi?
Tadqiqot "graduated dissent" deb ataladigan ko'p bosqichli baholash me'moriy'sini taklif qiladi. Bu me'moriy moliyaviy makala tekshirish'ini yagona modeli'ning yagona chiqish'i sifatida emas nazorat'li itiraz va qayta baholash jarayon'i sifatida tayyorla'di.
Birinchi bosqich'da ikkita alohida prover model anomialshir qilingan makala'ni mustaqil ravishda tekshiradi. Har model savol'larini yaratadi va bu savol'larini uchta shiddat tasnif'idan biriga joyla'shira'di: retraction-worthy major-revision yoki minor. Retraction-worthy makala'ning merkez natija'sini verisi'ni qo'llash mumkin emas qiluvchi og'ir xata degan ma'no beradi. Major-revision natija'larni o'zgartirada lekin ish'ni kesin qolmay ciddi muammolar'ni tushuntiradi. Minor ko'p nashr'iyat'da ko'ril'adigan natija'ni o'zgartirashligi kutilmagan kundalik tanqid'idir.
Ikkinchi bosqich tadqiqot'ning o'ziga xos qisim'idir. Modellari'dan har biri bergan shiddat baho'siga qarshi eng kuchliroq argument yaratish majbur bo'la'di. Bu klassik "model o'z'ni himaya qilsin" yondashturuv'ining teskari'sidir. Sistema modeli'ga "nima uchun to'g'ri?" deb so'rasmaydi; "nima uchun bu savol o'ylan'gan'dan yanada kam ciddi bo'ladi?" deb so'raydi.
Uchinchi bosqich'da arbiter model devrasiga kira'di. Arbiter ilk baholash'larni qarshi argument'larni va shiddat rubrik'i'ni birga ko'radi. Maqsad keraksiz og'ir etiketa'yma'sh'ni kamaytirish va haqiqatan kritik savol'larni yanada ehtiyotli alohida qilish'dir.
Bu yondashturuv sodda ko'p model havuz'lash'dan farq'lanadi. Ko'p model havuz'lash turli modellari savol'larini to'playdi. Lekin modellari shunga o'xshash o'qitish jarayon'lari va shunga o'xshash inson geri bildirish shablon'laridan kelsa'n'da bir xil turdagi xatalar'ni birga katta qiladi. Steelman exchange modellari o'z ilk yarqilash'larına qarshi o'ylab tasla'sh'ga majbur qilib bu umumiy yo'qotma'sh'ni qisman sinish'ni maqsad qila'di.
Formulalar nima aytadi?
Tadqiqot'da hem tajribaviy natija'lar hem ma'lumot nazariy gerekçe'lash turadir. Asosiy fikir shundaki: Agar bir'dan ko'proq model bir xil turdagi ko'r nuqta'larni ro'yhat' qilsa'nda bir xil xata'ni takror takror baholash'lari mustaqil isbotni yaratmaydi. Bu yalniz subyektiv ishonch'ni oshiradi; ob'yektiv to'g'rililik'ni bir xil darajada oshirmayday.
Tadqiqot'dagi birinchi ma'lumot nazariy ifoda seçici'ning bergan ma'lumot'ining ro'yhat'langan xata modela'ri bilan cheklan'digi'ni aytadi. Bu yerda \(G\) yaratuvchi modeli \(S\) seçici/baholash chiqish'i \(T\) esa to'g'rililik ko'rsatgich'ni taqdim qila'di. \(Z\) modellari'ning ro'yhat'langan umumiy xata modela'rini ifoda qila'di.
Bu ifoda \(G\) va umumiy xata modeli \(Z\) bilinda'nda seçici'ning chiqish'ining to'g'rililik haqida mustaqil qo'shimcha ma'lumot tashishmay turishini aytadi. Ya'ni bir xil ko'r nuqta'ni ro'yhat'ladigan baholash'chilar ko'rinma qo'payganchada haqiqiy ma'no mustaqil isbotni yaratmayday.
Tadqiqot'ning ma'lumot chegar'i quyidagicha beril'adi:
Bu yerda \(I(\cdot;\cdot)\) ma'lumot nazariy'da karsiliki ma'lumot o'lchi'sidir. Asosiy xabar shundaki: Baholash'chi'ning to'g'rililik haqida beradi'gan ma'lumot ro'yhat'langan xata modela'rining tashidi'gan ma'lumot bilan cheklan'ada.
Maxsus holat'da umumiy xata modeli \(Z\) to'g'rililik'cha shart'li ravishda bog'lantisiz bo'lsa quyidagi natija olinadi:
Bu asr qat'iy ama muhim ogohlantir'ish'tir: Modellari'ning ro'yhat'lagan xata shablon'i haqiqiy to'g'rililik'cha bog'lantisiz bo'lsa qo'shimcha baholash turlari to'g'rililik haqida ma'noli yangi ma'lumot taqdim etmi'ydi.
Takrarlangan o'z-tanqid yoki ko'p seçici uchun berilgan chegar'lar shunga o'xshash mantiq' izla'ydi:
Bu yerda \(A_{1:k}\) bir'dan ko'proq baholash' yoki qabul signali'ni taqdim qila'di. Izohlanish'i shundaki: Korelatsiyalı xata shart'larida ko'proq baholash ko'proq ob'yektiv isbotni anglamay turishia.
Steelman exchange'ning maqsad'lagan holat'i esa qabul signali'ning haqiqatan ijobiy isbotni tashish'idir. Tadqiqot bu fikri quyidagi shart bilan tushuntiradi:
Agar yolg'on holat'da qabul ehtimoli pas bo'lsa haqiqiy holat'da qabul ehtimoli yuqori bo'lsa qabul signali to'g'rililik haqida ijobiy ma'lumot tashida.
Ushbu holat'da qabul'ning bergan isbotning miqdori quyidagicha ifoda qilin'di:
Bu formula steelman exchange'ning nima uchun ishay'tir'shini tushuntiradi: Maqsad yanada ko'p model gapira'sh emas balki yolg'on og'ir tasnif'lash'ni oshanroq qabul qilish'ni qiyinlash'tir'ish'dir.
Grafik jadval va sxema asosiy xabari
Natija jadval'ining asosiy xabari steelman exchange usul'ining xom xata topish'dan ko'roq shiddat kalibratsiyasi'nda farq yaratan'ligini ko'rsatadi. SPOT testa'da steelman me'moriy yuzde 36 pass@1 qiymat'iga erisha'di. Retraction-worthy precision ya'ni eng og'ir xata tasnif'idagi haqiqiy kritik xata nisbat'i yuzde 11,7'dir. Bu nisbat' muqobil me'moriy'larga qara'nda yanada yuqori'dir va model yanada past'roq ustun savol yaratadi.
Yagona model yondashturuv'i yanada cheklangan topish'ni qiladi. Rubrik qo'shilgan yagona model topish nisbat'ini yanada oshira'ladi lekin shiddat kalibratsiyasi'nda hali zayfroq qoladi. Ko'p model havuz'lash ba'zi xatalar'ni yanada ko'proq qolasa'adi; lekin og'ir xata tasnif'lash'ni yanada doğru alohida qilish masala'sida anli'q bir yaxshi qila'sh taqdim etmi'ydi. Bu tadqiqot'ning asosiy ogohlantir'ish'i bilan uyumlu'dur: Model miqdori'ni oshirish agar xatalar korelatsiyonlush'ib bo'lsa haqiqiy yarqilash sifat'ini avtomatik oshirmi'ydi.
Orqasiga che'kilgan makala'lar va nazorat makala'lari bilan yapilgan ikkinchi test usul'ning boshqa yo'n'ni ko'rsatadi. Steelman exchange orqasiga che'kilish'ga olib kelgun 10 xata'ning barchasini tutasa'di; nazorat makala'lari'nda esa mustaqil tashqi model tekshirish'iga ko'ra 19 nazorat'dan 2'sida yolg'on og'ir tasnif'lash yaratadi. Ko'p model havuz'lash esa 10 xata'dan 7'sini tutasa'di va 19 nazorat'dan 3'ünde yolg'on og'ir tasnif'lash qila'di. Bu natija steelman usul'ning ayniqsa "og'ir xata mi emas mi?" alohida qilish'da yanada muvozanatli ishlay'tir'shini ko'ylatadi.
Byudje mos'landi solishtirmalar'i muhim'dir. Bir xil miqdordagi API chaqiruv'lardan foydalanilganda yalniz yanada ko'proq o'ylab tasla'sh turlari yoki tarafsiz aks'eti'ya steelman qanchalik kalibratsiyani taqdim etmi'ydi. Ya'ni natija "yanada ko'p model ishlatil'gani uchun" emas; modellari'ning o'z ilk shiddat yarqilash'lariga qarshi kuchliroq itiraz yaratish'ga majbur qilin'lish sababli bo'ladi ehtimoli.
Tadqiqot'ning umumiy sxemasi moliyaviy makala baholash'da uchta bosqichli bir farq'ni ko'rilun'ga chika'di: Avval xata topila'di keyin xata'ning muhimlik darajasi muhokama qilin'di oxirida inson uchun aktsiyoni qila olasa'digan prioritet sira'sI yaratiladi. Tadqiqot'ning asosiy hissa'sh' ikkinchi bosqich yani shiddat kalibratsiyasi'ning alohida muammo sifatida belgileng'ishi'dir.
Tajribalar qanday olib borilgan?
Tadqiqot'da to'rt asosiy baholash shart'i solishtir'iladi. Birinchi shart yagona model baholash'idir. Ikkinchi shart yagona modeli'ga anli'q shiddat rubrik' beril'mashligi'dir. Uchinchi shart bir'dan ko'proq modeli savol'larining havuz'lash'idir. To'rtinchi shart esa graduated dissent ya'ni steelman exchange o'z'ini olgan adversarial ko'p model me'moriy'sidir.
Birinchi benchmark SPOT ma'lumot to'plami'ning matnni orqali topilsa'digan xatalar o'z ichiga ol'gan kichik qismi'dir. Ko'rinma'ga bog'liq xata talab etuvchi makala'lar chiqaril'adi va 50 makala baholansa'di. Maqsad sistema dokumenta'lan'gan xata'ni topa'ladi'mi va uni qanchalik doğru shiddat tasnif'iga joyla'shti'ra'di'mi o'lcha'sh'dir.
Ikkinchi benchmark orqasiga che'kilgan makala'lar va orqasiga che'kilmagan nazorat makala'lari bilan quril'adi. Bu to'plami'nda 10 orqasiga che'kilgan makala va 19 nazorat makala'si bor. Maqsad yalniz haqiqiy og'ir xata'ni tutamok emas slog'om nazorat makala'larni noto'g'ri ravishda "orqasiga che'kilsh'ga qiymati" etiketa'sa bo'lmash'tir.
Doğrula'sh uchun ko'p qatlam'li nazorat tuzilma'si ishlatiladi. SPOT'un kishi tasdiq'langan xata ro'yhat'lari LLM-as-judge mos'lash protokol'i adversarial model tekshirish insan spot-check va ko'r insan doğrul'ash'i kabi qatlam'lar birga ishlatiladi. Orqasiga che'kilgan makala benchmark'i'nda esa in-family va out-of-family model tekshirish'lari yolg'on ijobiy'lar'ni qayta nazorat qila'di.
Model rol'larida farqli model aileleri ishlatiladi. Ikkita prover model mustaqil tekshirish qila'di; arbiter model esa so'ng qaror qila'di. Tadqiqot'ning maqsad'i model aileleri'ni solishtir'mak emas farqli me'moriy tayyorlash'larining shiddat kalibratsiyasi asosida ta'siri'ni o'lcha'sh'dir.
Natijalar nima ko'rsatadi?
Birinchi natija moliyaviy makala tekshirish'ida xom xata topish'ning artik yagona basi'ncha yeterli emaslig'idir. Katta til modellari ko'p muammo'larni turgan'da; fakat bu muammo'larni prioritet qilmadingan'da insan hakem uchun ish yuk'ini kamaytirish'ning o'rniga oshiradi.
Ikkinchi natija steelman exchange usul'ining shiddat kalibratsiyasi'nda yanada foydalanish mumkin natija'lar yaratmas'idir. SPOT test'ida eng yuqori pass@1 qiymat va yanada yuqori retraction-worthy precision ushbu usul'da ko'riladi. Ayni paytda ustun savol miqdori'ning yanada kam bo'lishi insan hakem'ning yanada kam shovqin bilan jav'ob bermashligi angla'di.
Uchinchi natija ko'p model havuz'lash'ning cheklangan qalish'idir. Bir'dan ko'proq model'dan savol to'plash topish nisbat'ini bir oz oshira'ladi; lekin bir xil turdagi yo'qotma va baholash shablon'lari ro'yhat'lanil'sa'nda og'ir xata tasnif'lash doğru yaxshi qila'sh mavzu' anli'q iyshla'sh taqdim etmi'ydi. Model ko'paytirish mustaqil isbotni yaratish'ning bir xil shayl emas.
To'rtinchi natija adversarial o'z-itiraz'ning farqli funktsiyani berish'idir. Model o'z bulgusi'ni savun'ma'sh o'rniga unga qarshi eng kuchliroq itiraz yaratish'i fadazo og'ir tasnif'lash'larning biror qismi'ni oladi. Bu ayniqsa moliyaviy nashr'iyat'da muhim'dir; chunki yolg'on "orqasiga che'kilsh'ga qiymat'i" etiketa'sh hem tadqiqatchi hem tahrir'chi ham nashr asoskuz uchun ciddi natija tug'iradi.
Beshinchi natija usul'ning hali sinklash o'rniga'l'ada test qilin'gan'ligi'dir. Bulgular umid beruvchi bo'lsa'n'da katta farqli qislari'dan va ko'rinma/jadval bog'langli xatalar'ni o'z ichiga ol'gan ma'lumot to'plami'lari bilan qayta sinash kerak.
Bu nima uchun muhim?
Moliyaviy nashr'iyat'da sun'iy intellekt qo'llab-quvvat'masi kaçinilmas ravishda ortadi. Tahrir'chi hakem va tadqiqat butunlik jamiat'lari ko'p makala'larni tezroq taraydi'gan sistema'larga ehtiyoj duyadi. Lekin tezlik yagona basi'ncha yeterli emas. Yolg'on alarm yaratadigan sistema ishonch'li'lik qoznas'li; aksinya insan mutaxassis'larni vaqt'ni iste'mol qiladi.
Bu tadqiqot sun'iy intellekt qo'llab-quvvatlanuvchi moliyaviy tekshirish'da asosiy o'lchi'ning o'zgarish shart'i'ni ko'rsatadi. "Model xata topa'ldi mi?" savoli qanchalik "Model qaysi xata'ning haqiqatan muhim ekanlig'i'ni alohida qila'la'di mi?" savoli muhim'dir.
Bu farq akademik ekosis'tema uchun hassas'dir. Makala'dagi kichik raporlash etislig'ini og'ir metod qo'llash chuqur ko'rung'ak chiqaradi. O'te yandan haqiqatan natija'larni nomaqbul qilgan bir xata'ni "kundalik cheklash" kabi ko'rsatish moliyaviy adabiy'atni kirlet'ada. Shuning uchun shiddat kalibratsiyasi moliyaviy sifat nazorat'ining markazida tursa kerak.
Tadqiqot shunga o'xshash ko'p agent'li sun'iy intellekt sistema'lari uchun yanada umumiy dars beradi. Bir'dan ko'proq model ishlatish yagona ishonch'li'lik kafolati emas. Haqiqiy masala modellari bir-biri'ni qanday tekshiradi'gi qaysi mustaqil'lik darajasiga ega'ligi va qaysi vazif'ada qaysi turdagi itiraz yaratish'ga majbur qilin'ganlig'i belgileydi.
Ehtiyot niqtalari
Birinchi ehtiyot niqtasi namuna katta'ligi'dir. Orqasiga che'kilgan makala benchmark'i 10 orqasiga che'kilgan makala va 19 nazorat makala'si'ndan iborat. Bu usul uchun kuchliroq birinchi signal berada'm lekin keng o'lchamo'liumumlash uchun yeterli emas.
Ikkinchi ehtiyot niqtasi SPOT quyi to'plami'dir. Baholama'sh yalniz matn orqali topilsa'digan xatalar bilan yapilgan. Grafik jadval ko'rinma yoki qo'shimcha ma'lumot fayli zarur xatalar bu ko'lam'ning tashqarida qoladi. Moliyaviy xatalar'ning muhim qismi' ko'rinma istatistik fayl yoki tajriba dizayn'i tafsilot'iga bog'liq bo'ladi.
Uchinchi ehtiyot niqtasi skorlash'dir. Tadqiqot ko'p qatlam'li doğrula'sh ishlatsa'n'da ba'zi holatlarda mustaqil tekshiruv'chi'lar orasida uyushmasa'liq bo'lada. Bu moliyaviy xata baholash'ining o'z'ining tahlil'ga och ekanlig'ini eslatadi.
To'rtinchi ehtiyot niqtasi model korelatsiyasi'dir. Steelman exchange umumiy xata shablon'larini kamaytish'ni maqsad qila'di; lekin bir xil ma'lumot ekosis'tema'da o'qitilgan katta modellari'ning parameter darajasidagi tengsizlik'larini butunlay oldin qilmaydi. Shuning uchun sistema insan hakem'ning o'rni'nda emas prioritet qilish qo'llab-quvvat'ala'sh'i sifatida o'ylansa kerak.
Beshinchi ehtiyot niqtasi qiymati va ish oqimi'dir. Toliq pipeline'ning makala'ga taxmin'an 1,25 dollar qiymati bilan ishlasa'nda ayt'iladi. Bu qiymati past ko'rinada; lekin katta nashr oqimi'nda qo'shimcha doğrula'sh va insan tekshirish'i bilan haqiqiy operatsion qiymati alohida hisob qilin'sa kerak.
Oxirida ushbu kontent nashr etika'si yoki editoriya qaror tavsiyasi emas. Makala'ning orqasiga che'kil'masi rad qilin'masi yoki majori revizyoni'ga yuborish'i kabi qaror'lar mutaxassis'lar tahrir'chi'lar statistik'chilar va etika kurullari tomonidan baholansa kerak.
Xulosa
Bu tadqiqot sun'iy intellekt'da moliyaviy makala tekshirish'ida muhim bir donvum nuqta'siga ishora qiladi. Artik masala yalniz "LLM makala'da xata topa'ladi mi?" emas. Yanada muhim savol shundaki: LLM topgan xata'larning qaysi'si haqiqatan ciddi ekanlig'i'ni alohida qila'la'da mi?
Taklif etilgan steelman exchange usul'i modellari o'z ilk yarqilash'lariga qarshi o'ylab tasla'sh'ga majbur qilib fazaroq og'ir baholash'larni kamaytish'ni va kritik xata'larni yanada foydalanush mumkin ravishda sira'lash'ni maqsad qila'di. Tajriba natija'lari ushbu me'moriy'ning hem SPOT benchmark'ida hem orqasiga che'kilgan makala benchmark'i'nda sodda ko'p model havuz'lash'iga qara'nda yanada yaxshi shiddat kalibratsiyasi taqdim qila'la'digi'ni ko'rsatadi.
Verianla nuqtai nazaridan tadqiqot'ning asosiy xabari nettir: Moliyaviy baholash'da sun'iy intellekt'ning qiymati qanchalik savol ro'yhat'lash'i bilan emas; qaysi muammo'ning haqiqatan muhim ekanlig'i'ni qanchalik ishonchli ravishda alohida qila'tir'ligi bilan o'lchi'n'sa kerak. Ko'p model ishlatish yeterli emas; modellari'ning bir-biri'ga qanday itiraz etgan'ligi va shiddat qaror'ni qanday kalibre etgan'ligi belgileydi.
Manbaa va usul izohi
Ushbu kontent Andrew Michael Brilliant tomonidan tayyorlangan "Steelmanning LLM Review: Severity Calibration Through Adversarial Self-Challenge" sarlavhali tadqiqot'ga asoslangan. Tadqiqot; LLM asosidagi moliyaviy makala baholash'ida shiddat kalibratsiyasi steelman exchange graduated dissent ko'p model havuz'lash va ma'lumot nazariy xato korelatsiyasi framework'i tekshira'di.
Ushbu kontent yagona tarjima emas; tadqiqot'ning asosiy fikri Verianla nashriyot chizig'iga mos ravishda soddalashtirilib va asl Uzbek tahrirviy maqolaga aylantirilib.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan