

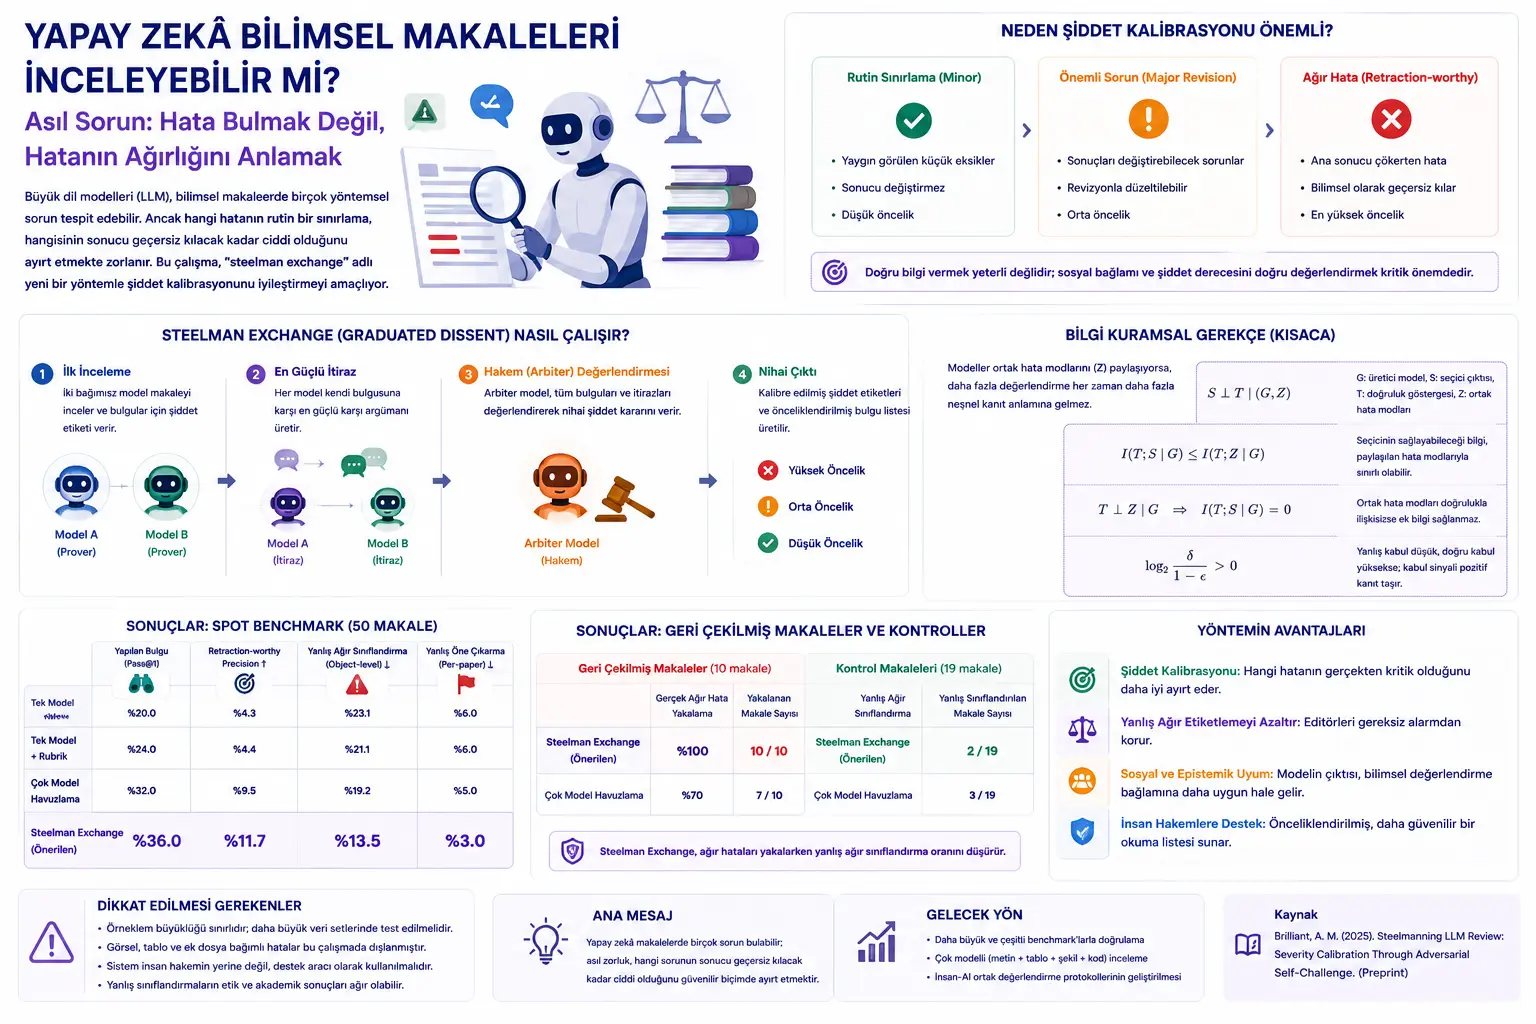
Büyük dil modelleri bilimsel makalelerde yöntemsel sorunları, eksik raporlamaları ve olası tutarsızlıkları giderek daha iyi tespit edebiliyor. Ancak bu çalışmanın vurguladığı kritik nokta şu: Bir yapay zekâ sistemi çok sayıda bulgu listeliyorsa ama hangisinin gerçekten önemli olduğunu söyleyemiyorsa, editöre veya hakeme yardım etmek yerine yalnızca yeni bir okuma yükü üretir.
Çalışmanın merkezindeki kavram “severity calibration”, yani şiddet kalibrasyonudur. Buradaki sorun, bir hatanın makalenin temel sonucunu geçersiz kılacak kadar ciddi mi, yoksa yalnızca rutin bir sınırlama mı olduğunu ayırt etmektir. Bilimsel değerlendirme açısından bu ayrım hayati önemdedir. Çünkü her kusur aynı ağırlıkta değildir.
Yazar, bu soruna “steelman exchange” adlı adversarial bir yöntem önerir. İki ayrı model önce makaleyi değerlendirir ve bulgulara şiddet etiketi verir. Ardından her model kendi ilk değerlendirmesine karşı en güçlü karşı argümanı üretir: “Acaba bu bulgu gerçekten bu kadar ağır mı, yoksa fazla mı büyütüldü?” Son aşamada bir arbiter model tüm materyali görür ve daha muhafazakâr bir şiddet kararı verir.
Ana sonuç şudur: Basit çok model havuzlama, daha fazla bulgu çıkarabilir; fakat şiddet kalibrasyonunu otomatik olarak iyileştirmez. Buna karşılık kendi iddiasına karşı güçlü itiraz üretmeye zorlanan modeller, özellikle “geri çekilmeye değer” düzeyde ağır hata sınıflandırmasında daha dikkatli ve daha kullanışlı sonuçlar üretebilir.
Problem Ne?
Bilimsel makale incelemesinde yapay zekânın ilk bakışta çok cazip bir vaadi vardır: Makaleyi hızla okuyabilir, yöntemsel sorunları listeleyebilir, istatistiksel tutarsızlıkları işaretleyebilir ve hakemlere yardımcı olabilir. Fakat pratikte ortaya çıkan sorun, yalnızca hata bulmak değildir. Asıl sorun, bulunan hataların hangisinin gerçekten önemli olduğunu ayırt etmektir.
Bir sistem bir makale için 15 bulgu üretiyor ama bunların çok küçük bir bölümü gerçekten kritikse, insan editör hâlâ bütün listeyi tek tek değerlendirmek zorunda kalır. Bu durumda sistem triage yani önceliklendirme yapmamış olur; yalnızca yüksek gürültülü bir okuma listesi oluşturur.
Çalışmanın ele aldığı temel darboğaz budur: Büyük dil modelleri bilimsel metinlerde birçok sorun bulabilir; ancak “küçük raporlama eksiği”, “önemli revizyon gerektiren metodolojik sorun” ve “makalenin ana sonucunu çökertecek ölümcül hata” arasındaki farkı her zaman güvenilir biçimde ayıramaz.
Bu sorun, yapay zekâ destekli bilimsel yayıncılıkta daha da önem kazanıyor. Makale yazımında AI kullanımı arttıkça yüzeysel yazım kalitesi artık güvenilir bir kalite göstergesi olmaktan uzaklaşabilir. Editörlerin ve hakemlerin ihtiyacı yalnızca “bu makalede sorun olabilir” diyen sistemler değil; “bu sorun ne kadar ciddi?” sorusuna daha kalibre yanıt veren sistemlerdir.
Yöntem Ne Öneriyor?
Çalışma, “graduated dissent” adı verilen çok aşamalı bir değerlendirme mimarisi önerir. Bu mimari, bilimsel makale incelemesini tek modelin tek seferlik çıktısı olarak değil, kontrollü bir itiraz ve yeniden değerlendirme süreci olarak tasarlar.
İlk aşamada iki ayrı prover model, anonimleştirilmiş makaleyi bağımsız biçimde inceler. Her model bulgularını üretir ve bu bulguları üç şiddet sınıfından birine yerleştirir: retraction-worthy, major-revision veya minor. Retraction-worthy, makalenin merkezî sonucunu veriyle desteklenemez hale getiren ağır hata anlamına gelir. Major-revision, sonuçları değiştirebilecek ama çalışmayı kesin olarak çökertmeyen ciddi sorunları anlatır. Minor ise birçok yayında görülebilecek, sonucu değiştirmesi beklenmeyen rutin eleştiridir.
İkinci aşama çalışmanın özgün kısmıdır. Modellerden her biri kendi verdiği şiddet puanına karşı en güçlü argümanı kurmak zorunda bırakılır. Bu, klasik “model kendini savunsun” yaklaşımının tersidir. Sistem modele “neden haklısın?” diye sormaz; “neden bu bulgu düşündüğünden daha az ciddi olabilir?” diye sorar.
Üçüncü aşamada arbiter model devreye girer. Arbiter, ilk değerlendirmeleri, karşı argümanları ve şiddet rubriğini birlikte görür. Amaç, gereksiz ağır etiketlemeyi azaltmak ve gerçekten kritik bulguları daha dikkatli ayırmaktır.
Bu yaklaşım, basit çok model havuzlamadan farklıdır. Çok model havuzlama, farklı modellerin bulgularını bir araya getirir. Ancak modeller benzer eğitim süreçlerinden ve benzer insan geri bildirimi kalıplarından geldiği için aynı tür hataları birlikte büyütebilir. Steelman exchange ise modelleri kendi ilk yargılarına karşı düşünmeye zorlayarak bu ortak yanlılığı kısmen kırmayı hedefler.
Formüller Ne Anlatıyor?
Çalışmada hem deneysel sonuçlar hem de bilgi kuramsal bir gerekçelendirme yer alır. Temel fikir şudur: Eğer birden fazla model aynı tür kör noktaları paylaşıyorsa, aynı hatayı tekrar tekrar değerlendirmeleri bağımsız kanıt üretmez. Bu yalnızca öznel güveni artırabilir; nesnel doğruluğu aynı ölçüde artırmayabilir.
Çalışmadaki ilk bilgi kuramsal ifade, seçicinin verdiği bilginin paylaşılan hata modlarıyla sınırlı olabileceğini anlatır. Burada \(G\) üretici modeli, \(S\) seçici/değerlendirici çıktısını, \(T\) ise doğruluk göstergesini temsil eder. \(Z\), modellerin paylaştığı ortak hata modlarını ifade eder.
Bu ifade, \(G\) ve ortak hata modu \(Z\) bilindiğinde, seçicinin çıktısının doğruluk hakkında bağımsız ek bilgi taşımayabileceğini anlatır. Yani aynı kör noktayı paylaşan değerlendiriciler, görünürde çoğalsa bile gerçek anlamda bağımsız kanıt üretmeyebilir.
Çalışmanın bilgi sınırı şu şekilde verilir:
Burada \(I(\cdot;\cdot)\), bilgi kuramındaki mutual information yani karşılıklı bilgi ölçüsüdür. Ana mesaj şudur: Değerlendiricinin doğruluk hakkında sağlayabileceği bilgi, paylaşılan hata modlarının taşıdığı bilgiyle sınırlı kalabilir.
Özel durumda, ortak hata modu \(Z\) doğrulukla koşullu olarak ilişkisizse şu sonuç elde edilir:
Bu, çok sert ama önemli bir uyarıdır: Eğer modellerin paylaştığı hata örüntüsü gerçek doğrulukla bağlantılı değilse, ek değerlendirme turları doğruluk hakkında anlamlı yeni bilgi sağlamaz.
Tekrarlanan öz-eleştiri veya çoklu seçici için verilen sınır da benzer mantığı izler:
Burada \(A_{1:k}\), birden fazla değerlendirme veya kabul sinyalini temsil eder. Yorum şudur: Korelasyonlu hata koşullarında daha çok değerlendirme, daha çok nesnel kanıt anlamına gelmeyebilir.
Steelman exchange’in hedeflediği durum ise kabul sinyalinin gerçekten pozitif kanıt taşımasıdır. Çalışmada bu fikir şu koşulla açıklanır:
Eğer yanlış durumda kabul olasılığı düşük, doğru durumda kabul olasılığı yüksekse, kabul sinyali doğruluk hakkında pozitif bilgi taşır.
Bu durumda kabulün sağladığı kanıt miktarı şu şekilde ifade edilir:
Bu formül, steelman exchange’in neden işe yarayabileceğini açıklar: Amaç daha çok model konuşturmak değil, yanlış ağır sınıflandırmaların kolayca kabul edilmesini zorlaştırmaktır.
Grafik, Tablo ve Şema Ana Mesajı
Sonuç tablosunun ana mesajı, steelman exchange yönteminin ham hata tespitinden çok şiddet kalibrasyonunda fark yarattığıdır. SPOT testinde steelman mimarisi yüzde 36 pass@1 değerine ulaşır. Retraction-worthy precision, yani en ağır hata sınıfında gerçek kritik hata oranı yüzde 11,7’dir. Bu oran alternatif mimarilere göre daha yüksektir ve model daha az üst seviye alarm üretir.
Tek model yaklaşımı daha sınırlı tespit yapar. Rubrik eklenen tek model tespit oranını artırır, fakat şiddet kalibrasyonunda hâlâ zayıf kalır. Çok model havuzlama ise bazı hataları daha fazla yakalayabilir; ancak ağır hata sınıfını daha doğru ayırma konusunda belirgin bir iyileşme sağlamaz. Bu, çalışmanın temel uyarısıyla uyumludur: Model sayısını artırmak, eğer hatalar korelasyonluysa, gerçek yargı kalitesini otomatik olarak artırmaz.
Geri çekilmiş makaleler ve kontrol makaleleriyle yapılan ikinci test, yöntemin başka bir yönünü gösterir. Steelman exchange, geri çekilmeye yol açan 10 hatanın tamamını yakalar; kontrol makalelerinde ise bağımsız dış model denetimine göre 19 kontrolden 2’sinde yanlış ağır sınıflandırma üretir. Çok model havuzlama ise 10 hatadan 7’sini yakalar ve 19 kontrolden 3’ünde yanlış ağır sınıflandırma yapar. Bu sonuç, steelman yönteminin özellikle “ağır hata mı, değil mi?” ayrımında daha dengeli çalışabileceğini düşündürür.
Bütçe eşleştirmeli karşılaştırmalar da önemlidir. Aynı sayıda API çağrısı kullanıldığında, yalnızca daha fazla düşünme turu veya tarafsız yansıtma yapmak steelman kadar kalibrasyon sağlamaz. Yani sonuç, “daha fazla model çalıştırıldığı için” değil; modellerin kendi ilk şiddet yargılarına karşı güçlü itiraz üretmeye zorlanması nedeniyle ortaya çıkıyor olabilir.
Çalışmanın genel şeması, bilimsel makale değerlendirmede üç aşamalı bir ayrımı görünür hale getirir: Önce hata bulunur, sonra hatanın önem derecesi tartışılır, en sonunda insan için aksiyon alınabilir bir öncelik sırası üretilir. Araştırmanın ana katkısı, ikinci aşamanın yani şiddet kalibrasyonunun ayrı bir problem olarak tanımlanmasıdır.
Deneyler Nasıl Yapılmış?
Çalışmada dört ana değerlendirme koşulu karşılaştırılır. İlk koşul tek model değerlendirmesidir. İkinci koşul, tek modele açık bir şiddet rubriği verilmesidir. Üçüncü koşul, birden fazla modelin bulgularının havuzlanmasıdır. Dördüncü koşul ise graduated dissent, yani steelman exchange içeren adversarial çok model mimarisidir.
İlk benchmark, SPOT veri setinin metin üzerinden tespit edilebilir hatalar içeren alt kümesidir. Görsele bağlı hata gerektiren makaleler dışarıda bırakılır ve 50 makale değerlendirilir. Burada amaç, sistemin belgelenmiş hatayı bulup bulmadığını ve onu ne kadar doğru şiddet sınıfına yerleştirdiğini ölçmektir.
İkinci benchmark, geri çekilmiş makaleler ve geri çekilmemiş kontrol makaleleriyle kurulur. Bu sette 10 geri çekilmiş makale ve 19 kontrol makalesi bulunur. Amaç yalnızca gerçek ağır hatayı yakalamak değil, sağlam kontrol makalelerini yanlış biçimde “geri çekilmeye değer” olarak etiketlememektir.
Doğrulama için çok katmanlı bir kontrol yapısı kullanılır. SPOT’un insan onaylı hata kayıtları, LLM-as-judge eşleştirme protokolü, adversarial model denetimleri, insan spot-check ve kör insan doğrulaması gibi katmanlar birlikte kullanılır. Geri çekilmiş makale benchmark’ında ise in-family ve out-of-family model denetimleriyle yanlış pozitifler yeniden kontrol edilir.
Model rollerinde farklı model aileleri kullanılır. İki prover model bağımsız inceleme yapar; arbiter model ise son kararı verir. Çalışmanın amacı model ailelerini karşılaştırmak değil, farklı mimari tasarımların şiddet kalibrasyonu üzerindeki etkisini ölçmektir.
Sonuçlar Ne Gösteriyor?
İlk sonuç, bilimsel makale incelemesinde ham hata bulmanın artık tek başına yeterli olmadığıdır. Büyük dil modelleri birçok sorun işaretleyebilir; fakat bu sorunları önceliklendiremediğinde insan hakem için iş yükünü azaltmak yerine artırabilir.
İkinci sonuç, steelman exchange yönteminin şiddet kalibrasyonunda daha kullanışlı sonuçlar üretmesidir. SPOT testinde en yüksek pass@1 değeri ve daha yüksek retraction-worthy precision bu yöntemde görülür. Aynı zamanda üst seviye alarm sayısının daha az olması, insan hakemin daha az gürültüyle karşılaşması anlamına gelir.
Üçüncü sonuç, çok model havuzlamanın sınırlı kalmasıdır. Birden fazla modelden bulgu toplamak tespit oranını biraz artırabilir; fakat aynı tür yanlılıklar ve değerlendirme kalıpları paylaşılıyorsa ağır hata sınıflandırması daha iyi hale gelmez. Model çoğaltmak, bağımsız kanıt üretmekle aynı şey değildir.
Dördüncü sonuç, adversarial öz-itirazın farklı bir işlev görmesidir. Model kendi bulgusunu savunmak yerine ona karşı en güçlü itirazı üretince, fazla ağır sınıflandırmaların bir kısmı elenir. Bu, özellikle bilimsel yayıncılıkta kritik önemdedir; çünkü yanlış “geri çekilmeye değer” etiketi hem araştırmacı hem editör hem de yayın ekosistemi için ciddi sonuçlar doğurabilir.
Beşinci sonuç, yöntemin henüz sınırlı örneklemle test edildiğidir. Bulgular umut verici olsa da daha büyük, farklı alanlardan ve görsel/tablo bağımlı hataları da içeren veri setleriyle yeniden denenmelidir.
Bu Neden Önemli?
Bilimsel yayıncılıkta yapay zekâ desteği kaçınılmaz biçimde artıyor. Editörler, hakemler ve araştırma bütünlüğü ekipleri, çok sayıda makaleyi daha hızlı tarayabilen sistemlere ihtiyaç duyabilir. Ancak hız tek başına yeterli değildir. Yanlış alarm üreten sistem, güvenilirlik kazandırmaz; aksine insan uzmanların zamanını tüketir.
Bu çalışma, yapay zekâ destekli bilimsel incelemede temel ölçütün değişmesi gerektiğini gösteriyor. “Model hata buldu mu?” sorusu kadar, hatta pratikte daha fazla, “Model hangi hatanın gerçekten kritik olduğunu ayırt edebildi mi?” sorusu önemlidir.
Bu ayrım akademik ekosistem için hassastır. Bir makaledeki küçük raporlama eksiğini ağır metodolojik çöküş gibi sunmak haksız zarar doğurabilir. Öte yandan gerçekten sonuçları geçersiz kılan bir hatayı “rutin sınırlama” gibi göstermek de bilimsel literatürü kirletebilir. Bu nedenle şiddet kalibrasyonu, bilimsel kalite kontrolünün merkezinde yer almalıdır.
Çalışma ayrıca çok ajanlı yapay zekâ sistemleri için daha genel bir ders verir. Birden fazla model kullanmak, tek başına güvenilirlik garantisi değildir. Asıl mesele, modellerin birbirini nasıl denetlediği, hangi bağımsızlık düzeyine sahip olduğu ve hangi görevde hangi tür itiraz üretmeye zorlandığıdır.
Dikkat Noktaları
İlk dikkat noktası, örneklem büyüklüğüdür. Geri çekilmiş makale benchmark’ı 10 geri çekilmiş makale ve 19 kontrol makalesinden oluşur. Bu, yöntem için güçlü bir ön sinyal verse de geniş ölçekli genelleme için yeterli değildir.
İkinci dikkat noktası, SPOT alt kümesidir. Değerlendirme yalnızca metin üzerinden tespit edilebilir hatalarla yapılmıştır. Grafik, tablo, görüntü veya ek veri dosyası gerektiren hatalar bu kapsamın dışında kalır. Bilimsel hataların önemli bir kısmı görsel, istatistiksel dosya veya deney tasarımı ayrıntısına bağlı olabilir.
Üçüncü dikkat noktası, skorlamadır. Çalışma çok katmanlı doğrulama kullansa da bazı durumlarda bağımsız denetçiler arasında uyuşmazlık görülebilir. Bu, bilimsel hata değerlendirmesinin kendisinin de yoruma açık olduğunu hatırlatır.
Dördüncü dikkat noktası, model korelasyonudur. Steelman exchange ortak hata kalıplarını azaltmayı hedefler; fakat aynı veri ekosisteminde eğitilmiş büyük modellerin parametre düzeyindeki benzerliklerini tamamen ortadan kaldırmaz. Bu nedenle sistem insan hakemin yerine değil, önceliklendirme desteği olarak düşünülmelidir.
Beşinci dikkat noktası, maliyet ve iş akışıdır. Tam pipeline’ın makale başına yaklaşık 1,25 dolar maliyetle çalıştığı belirtilir. Bu maliyet düşük görünebilir; fakat büyük yayın akışlarında, ek doğrulama ve insan denetimiyle birlikte gerçek operasyonel maliyet ayrıca hesaplanmalıdır.
Son olarak, bu içerik yayın etiği veya editoryal karar tavsiyesi değildir. Bir makalenin geri çekilmesi, reddedilmesi veya majör revizyona gönderilmesi gibi kararlar alan uzmanları, editörler, istatistikçiler ve etik kurullar tarafından değerlendirilmelidir.
Sonuç
Bu çalışma, yapay zekâ ile bilimsel makale incelemesinde önemli bir dönüm noktasına işaret ediyor. Artık mesele yalnızca “LLM makalede hata bulabilir mi?” değildir. Daha kritik soru şudur: LLM, bulduğu hataların hangisinin gerçekten ciddi olduğunu ayırt edebilir mi?
Önerilen steelman exchange yöntemi, modelleri kendi ilk yargılarına karşı düşünmeye zorlayarak fazla ağır değerlendirmeleri azaltmayı ve kritik hataları daha kullanışlı biçimde sıralamayı amaçlar. Deneysel bulgular, bu mimarinin hem SPOT benchmark’ında hem de geri çekilmiş makale benchmark’ında basit çok model havuzlamaya göre daha iyi şiddet kalibrasyonu sağlayabileceğini gösterir.
Verianla açısından çalışmanın ana mesajı nettir: Bilimsel değerlendirmede yapay zekânın değeri, kaç tane sorun listelediğiyle değil; hangi sorunun gerçekten önemli olduğunu ne kadar güvenilir biçimde ayırt ettiğiyle ölçülmelidir. Çok model kullanmak yetmez; modellerin birbirine nasıl itiraz ettiği ve şiddet kararını nasıl kalibre ettiği belirleyici hale gelir.
Kaynak ve Yöntem Notu
Bu içerik, Andrew Michael Brilliant tarafından hazırlanan “Steelmanning LLM Review: Severity Calibration Through Adversarial Self-Challenge” başlıklı çalışmaya dayalı olarak hazırlanmıştır. Çalışma; LLM tabanlı bilimsel makale değerlendirmesinde şiddet kalibrasyonu, steelman exchange, graduated dissent, çok model havuzlama ve bilgi kuramsal hata korelasyonu çerçevesini incelemektedir.
Bu içerik birebir çeviri değildir; çalışmanın ana fikri Verianla yayın çizgisine uygun biçimde sadeleştirilmiş ve özgün Türkçe editoryal makaleye dönüştürülmüştür.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir