

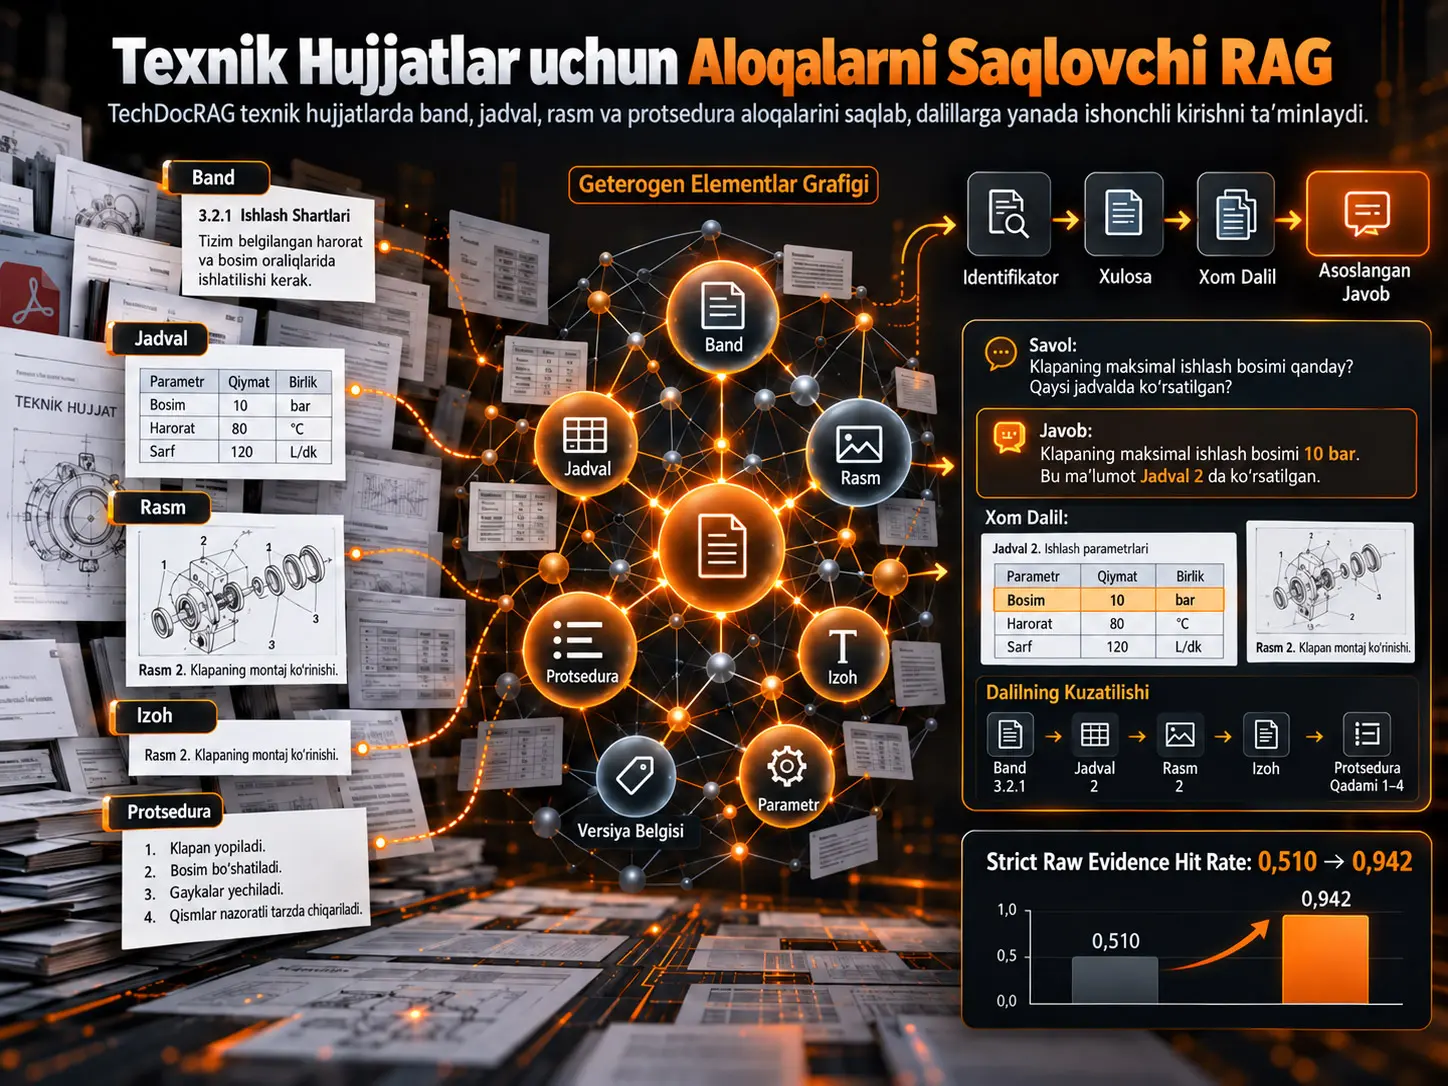
TechDocRAG texnik hujjatlarni mustaqil matn bo‘laklaridan iborat tekis to‘plam sifatida emas, balki bandlar, paragraflar, jadvallar, rasmlar, izohlar, bo‘limlar va protsedura qadamlari o‘rtasidagi aloqalarni saqlaydigan geterogen elementlar grafigi sifatida ifodalovchi retrieval-augmented generation (RAG) doirasidir. Tizim har bir hujjat elementini uchta moslashtirilgan ko‘rinish orqali indekslaydi: texnik identifikatorlar, semantik xulosa va xom dalil. So‘rov vaqtida avval texnik identifikatorlar orqali nomzod elementlar topiladi, keyin so‘rov niyatiga qarab bog‘liq elementlarga graf orqali kengayish amalga oshiriladi, semantik xulosalar qayta tartiblanadi va yakuniy bosqichda o‘zaro bog‘langan xom dalil obyektlari bir xil kontekst paketi ichida generativ modelga yuboriladi.
Tadqiqot TechDocRAG’ni MPMQA, DesignQA, MMLongBench-Doc va LongDocURL nomli to‘rtta benchmarkda, muvozanatlangan 7500 dan ortiq savol-javob juftligi bilan baholagan. Bir xil javob generatori va taqqoslanadigan kontekst budjetlari qo‘llangan tajribalarda TechDocRAG MPMQA’da 68,5, DesignQA’da 62,2, MMLongBench-Doc’da 58,4 va LongDocURL’da 55,2 ball olgan. To‘rtta benchmark bo‘yicha o‘rtacha natijada eng kuchli flat yondashuv bo‘lgan Hybrid Dense+BM25 ga nisbatan 20,3 ball, eng kuchli non-flat yondashuv bo‘lgan VisRAG ga nisbatan esa 9,3 ball yuqori natija qayd etilgan.
Dalilning kuzatiluvchanligi bo‘yicha farq yanada yaqqol. Exact identifier mosligidan foydalanadigan eng qat’iy Raw Evidence Hit Rate (REHR) baholashida Hybrid RAG 0,510 bo‘lganida TechDocRAG 0,942 ga yetgan. Ablatsiya tajribalari identifier-aware recall olib tashlanganda xom dalilga kirish, relation edge’lar olib tashlanganda dalil bog‘liqligi, raw bundling olib tashlanganda esa yaratilgan da’volarning xom dalil bilan qo‘llab-quvvatlanishi sezilarli darajada yomonlashishini ko‘rsatadi.
Shu bilan birga, tizim texnik hujjatlarni parsing qilish sifatiga bog‘liq. Ayniqsa band raqami, parametr nomi, rasm yoki jadval yorlig‘i kabi texnik identifikatorlarning jiddiy buzilishi birinchi retrieval bosqichini ishdan chiqaradi. Shu sabab natijalar “grafdan foydalanuvchi har qanday RAG yaxshiroq” degan ma’noda emas; texnik hujjatlarda to‘g‘ri dalilga yetib borish uchun hujjat ichidagi strukturaviy va havola aloqalarini saqlash muhim ekaniga doir eksperimental dalil sifatida talqin qilinishi kerak.
Texnik hujjat RAG’i nega oddiy matn RAG’idan farq qiladi?
Texnik spetsifikatsiyalar, foydalanish qo‘llanmalari, texnik xizmat hujjatlari va muhandislik standartlari odatda bitta uzluksiz bayon matni bo‘lmaydi. Bir talabning ta’rifi Bo‘lim 4.2 da, chegara qiymati Jadval 7 da, ulanish sxemasi Rasm 3 da, maxsus holat ogohlantirishi esa keyingi protsedura qadamida bo‘lishi mumkin.
Shuning uchun faqat semantik jihatdan o‘xshash paragrafni topish to‘g‘ri javobni yaratish uchun yetarli bo‘lmasligi mumkin. Tizim to‘g‘ri bandni topsa ham, band havola qilgan jadvalni, rasmni yoki qo‘shni protsedura qadamini olib kelolmasa dalil zanjiri to‘liq bo‘lmaydi.
TechDocRAG’ning asosiy muammosi aynan shu: tegishli matnni topish bilan javobni qo‘llab-quvvatlaydigan to‘liq va bog‘langan dalilni topish bir xil vazifa emas.
TechDocRAG Standart RAG’dan Qanday Farq Qiladi?
Standart chunk asosidagi RAG hujjatni ko‘pincha qat’iy uzunlikdagi yoki semantik matn bo‘laklariga ajratadi va ularni mustaqil retrieval birliklari sifatida qayta ishlaydi. TechDocRAG esa band, jadval, rasm, caption, protsedura qadami va versiya ma’lumoti kabi asl hujjat obyektlarini saqlaydi; ular o‘rtasidagi table_ref, figure_ref, caption_of, step_next, version_of va shunga o‘xshash aloqalarni graf qirralari sifatida saqlaydi. Shu tariqa retrieval faqat “qaysi kontent o‘xshash?” degan savolga emas, “bu dalil qaysi boshqa dalillar bilan birga o‘qilishi kerak?” degan savolga ham javob beradi.
Hujjat geterogen elementlar grafigiga aylantiriladi
Bir texnik hujjat \(d\), tadqiqotda quyidagi graf bilan ifodalanadi:
\[ G_d=(V_d,E_d) \]
Bu yerda \(V_d\) hujjatdagi element tugunlarini, \(E_d\) esa ushbu elementlar o‘rtasidagi aloqalarni ifodalaydi.
Har bir tugun:
\[ v=(\tau_v,r_v,k_v,s_v,m_v) \]
ko‘rinishida aniqlanadi.
- \(\tau_v\): Element turi; masalan, band, paragraf, jadval, rasm, caption yoki protsedura qadami.
- \(r_v\): Xom hujjat obyekti.
- \(k_v\): Texnik identifikatorlar va kalit so‘zlar.
- \(s_v\): Semantik xulosa.
- \(m_v\): Sahifa indeksi, bounding box, bo‘lim yo‘li, hujjat turi, versiya va normative label kabi metadata.
Bu tuzilma flat chunking paytida yo‘qolishi mumkin bo‘lgan hujjat identifikatsiyasini saqlaydi.
Graf qirralari qaysi aloqalarni ifodalaydi?
| Aloqa | Ma’nosi |
|---|---|
| contains | Bo‘lim yoki yuqori element quyi elementlarni o‘z ichiga olishi |
| precedes | Mahalliy o‘qish ketma-ketligida bir element boshqasidan oldin kelishi |
| same_section | Bir xil bo‘lim yoki kichik bo‘lim ichida joylashishi |
| step_next | Protsedura qadamlarining ketma-ket bog‘lanishi |
| clause_ref | Bir bandning boshqa bandga aniq havolasi |
| table_ref | Matndan jadvalga berilgan havola |
| figure_ref | Matndan rasmga berilgan havola |
| caption_of | Rasm yoki jadval bilan caption o‘rtasidagi bog‘lanish |
| same_identifier | Bir xil texnik identifikatorning turli elementlarda qayta ishlatilishi |
| version_of / supersedes | Hujjatning turli versiyalari o‘rtasidagi aloqa |
Retrieval maqsadi faqat “eng mos bo‘lak” emas
Tadqiqot retrieval muammosini bog‘langan dalil subgrafini topish muammosi sifatida ta’riflaydi:
\[ H_q^*=\arg\max_{H\subseteq G} \left[ Rel(q,H)+\lambda Conn(H)+\gamma Valid(q,H)-\mu Cost(H) \right] \]
Bu maqsad funksiyasida:
- \(Rel(q,H)\), so‘rov bilan dalil subgrafi o‘rtasidagi leksik va semantik moslikni;
- \(Conn(H)\), dalil tugunlarining bog‘langanligi va yaxlitligini;
- \(Valid(q,H)\), hujjat versiyasi yoki hujjat turi kabi metadata izchilligini;
- \(Cost(H)\), retrieval va kontekst yaratish xarajatini
ifodalaydi.
\(\lambda\), \(\gamma\) va \(\mu\) esa ushbu komponentlarning maqsad funksiyasidagi og‘irliklaridir. Matematik maqsad faqat eng o‘xshash tugunlarni yig‘ish emas, balki yetarlicha bog‘langan va metadata jihatidan haqiqiy dalil subgrafini yaratishdir.
Tanlangan subgraf keyin javob generatoriga uzatiladi:
\[ (y_q,\Pi_q)=f_\theta(q,H_q^*) \]
Bu yerda \(y_q\) yaratilgan javobni, \(\Pi_q\) esa yaratilgan da’volardan xom dalil tugunlariga boradigan provenance bog‘lanishlarini ifodalaydi.
Uchlik “Identifier–Summary–Raw” Tuzilmasi Nima Uchun Kerak?
TechDocRAG har bir hujjat elementini bir xil identifikatsiyaga bog‘langan uchta retrieval ko‘rinishida saqlaydi: identifier ko‘rinishi aniq texnik tayanchlarni topish, summary ko‘rinishi so‘rov bilan semantik moslikni baholash, raw evidence ko‘rinishi esa yakuniy javob haqiqatda tayanadigan asl matn, jadval, rasm yoki protsedurani generativ modelga uzatish uchun ishlatiladi. Bu ajratish semantik jihatdan foydali, ammo manbaga bevosita kuzatilmaydigan xulosalarning xom dalil o‘rnini egallashiga yo‘l qo‘ymaydi.
Identifier va xulosa qanday yaratiladi?
Har bir tugun uchun texnik identifier to‘plami va semantik xulosa:
\[ k_v=ExtractId(r_v,m_v), \qquad s_v=Summarize(r_v,N(v)) \]
ko‘rinishida aniqlanadi.
\(N(v)\) tugunning mahalliy aloqa qo‘shnichiligidir. Xulosa faqat elementning o‘z xom mazmunidan emas, balki uni anglashga yordam beradigan yaqin hujjat kontekstidan ham foydalanishi mumkin.
Har bir tugunning moslashtirilgan ifodasi:
\[ \phi(v)=\{k_v,s_v,r_v,m_v\} \]
ko‘rinishidadir.
Korpus darajasidagi ma’lumotlar bazasi esa:
\[ D=(I_{id},I_{sum},R,G) \]
ko‘rinishida aniqlanadi.
- \(I_{id}\): Texnik identifier indeksi.
- \(I_{sum}\): Semantik xulosa indeksi.
- \(R\): Xom dalil ombori.
- \(G\): Aloqa grafigi.
Identifier indeksi nega muhim?
Texnik hujjatlarda “Section 4.2”, “Table 7”, “parameter Z”, “error E105”, bir API buyrug‘i yoki versiya yorlig‘i semantik jihatdan oddiy so‘zga qaraganda ancha kuchli tayanch bo‘lishi mumkin.
Shuning uchun TechDocRAG birinchi retrieval qatlamida texnik identifikatorlarga maxsus og‘irlik beradi. Ablatsiya tajribasida identifier-aware recall olib tashlanganda REHR@10 qiymati to‘liq modeldagi 0,94 dan 0,65 gacha tushadi. Bu tizimning muhim ishlash manbalaridan biri to‘g‘ri texnik tayanchni erta bosqichda topish ekanini ko‘rsatadi.
So‘rov avval tahlil qilinadi
Har bir so‘rov uch komponentga ajratiladi:
\[ (k_q,e_q,z_q)=Analyze(q) \]
- \(k_q\): So‘rovdagi texnik identifier va kalit so‘zlar.
- \(e_q\): Semantik so‘rov ifodasi.
- \(z_q\): So‘rov niyati.
Manbada ishlatilgan niyat turlariga ta’rif/talab qidiruvi, protsedura yoki troubleshooting, matn-jadval mulohazasi, matn-rasm grounding, cross-reference yechimi va versiyaga sezgir so‘rovlar kiradi.
Har bir savol uchun bir xil retrieval siyosati ishlatilmaydi
| So‘rov turi | Ustuvor aloqalar | Maksimal hop | Asosiy maqsad |
|---|---|---|---|
| Ta’rif / talab | contains, same_identifier, clause_ref | 1-2 | Band yoki paragraf |
| Protsedura / troubleshooting | step_next, contains, same_section | 2 | Protsedura qadamlari |
| Matn-jadval | table_ref, caption_of, same_identifier | 2 | Jadval qatori / sarlavha yo‘li |
| Matn-rasm | figure_ref, caption_of, same_section | 2 | Rasm-caption juftligi |
| Cross-reference | clause_ref, table_ref, figure_ref | 2 | Havola berilgan element |
| Versiyaga sezgir so‘rov | version_of, supersedes, same_identifier | 1 | Faol reviziya tugunlari |
Bu siyosatning mantig‘i shunday: “Bir parametr nima?” savoli bilan “Sensor Y qanday qayta kalibrlanadi?” savoliga kerak bo‘ladigan hujjat aloqalari bir xil emas.
TechDocRAG So‘rovni Bosqichma-Bosqich Qanday Qayta Ishlaydi?
Onlayn retrieval zanjiri identifier-aware recall bilan boshlanadi, so‘rov niyatiga qarab grafni kengaytirish bilan davom etadi, kengaytirilgan nomzodlar semantik xulosa maydonida qayta tartiblanadi, tanlangan tugunlar xom dalil obyektlariga yechiladi va bog‘langan dalillar kontekst budjeti doirasida bitta paketga birlashtiriladi. Yakuniy javob faqat shu paket asosida yaratiladi va da’volar provenance bog‘lanishlari orqali xom dalilga ulanadi.
1. Identifier-aware recall
Birinchi nomzodlar to‘plami manbada quyidagicha aniqlanadi:
\[ C_{id}= TopK_{v\in V} \left[ \lambda_1 BM25(q,k_v) +\lambda_2 IdMatch(k_q,k_v) +\lambda_3 MetaMatch(q,m_v) \right] \]
BM25 leksik moslikni, IdMatch texnik identifier mosligini, MetaMatch esa so‘rov bilan metadata mosligini baholaydi.
2. Aloqa grafida kengaytirish
Birinchi nomzodlarning so‘rov niyatiga mos qo‘shnilari qo‘shiladi:
\[ C_{id}^{e}=C_{id}\cup Expand(C_{id},\Omega(z_q)) \]
\(\Omega(z_q)\) tegishli so‘rov niyati uchun qaysi aloqa turlari kuzatilishini belgilaydigan siyosatdir.
3. Summary-level reranking
Kengaytirilgan elementlar semantik xulosa maydonida qayta tartiblanadi:
\[ C_{sum}=TopL_{v\in C_{id}^{e}} \left[ \alpha \cos(e_q,e_v) +\beta RelScore(v,C_{id}) +\gamma TypePrior(z_q,\tau_v) \right] \]
Bu yerdagi asosiy g‘oya shuki, birinchi qatlam exact technical anchors uchun yuqori recall beradi; ikkinchi qatlam esa bu nomzodlarni so‘rovning haqiqiy semantik maqsadi bo‘yicha toraytiradi.
4. Xom dalilni paketlash
Qayta tartiblangan tugunlar xom dalilga aylantiriladi:
\[ C_{raw}=\bigcup_{v\in C_{sum}}Bundle(v) \]
Bir Bundle bitta matn bo‘lagidan ko‘proq narsani o‘z ichiga olishi mumkin. Masalan, bir band + u havola qilgan jadval; yoki rasm kesmasi + caption + rasmga havola qilgan paragraf bir xil dalil paketi ichida saqlanishi mumkin.
5. Kontekst budjeti
Xom dalillar kontekst budjeti \(B\) doirasida paketlanadi:
\[ E_q=Pack(C_{raw},B) \]
Tajriba protokolida kontekst budjeti 2048 matn tokeni va multimodal usullar uchun 10 vizual region sifatida normallashtirilgan.
6. Grounded generation va provenance
Yakuniy javob:
\[ (\hat{y}_q,\Pi_q)=g_\theta(q,E_q) \]
bilan yaratiladi.
Da’vo darajasidagi provenance esa:
\[ \Pi_q=\{(c_i,U_i)\}_{i=1}^{M}, \qquad U_i\subseteq C_{raw} \]
ko‘rinishida aniqlanadi. Bu yerda har bir \(c_i\) yaratilgan bir da’vo, \(U_i\) esa ushbu da’voni qo‘llab-quvvatlaydigan xom dalil obyektlaridir.
PDF’dagi Rasm 1 nimani tushuntiradi?
Manbadagi Rasm 1 arxitekturani ikki asosiy qismga ajratadi. Offline index construction tomonida texnik hujjatlar parse va canonicalize qilinadi, geterogen elementlar grafigi yaratiladi va identifier index, summary index, raw store hamda relation store o‘zaro moslashtiriladi. Online query-time tomonida foydalanuvchi so‘rovi tahlil qilinadi, identifier-aware recall bajariladi, aloqa kengayishi va summary reranking qo‘llanadi, xom dalil paketi yaratiladi va provenance ni o‘z ichiga olgan javob ishlab chiqiladi.
PDF’dagi Rasm 2 nima qo‘shadi?
Rasm 2 ayniqsa onlayn qaror oqimiga e’tibor qaratadi. So‘rovning identifier va niyat komponentlariga ajratilishi qaysi relation policy tanlanishini belgilashini, retrieval dan keyin bog‘langan qo‘shnilar olinishini va generativ modelga mustaqil fragmentlar o‘rniga bog‘langan xom dalil paketlari yuborilishini ko‘rsatadi.
Aloqalarni Saqlash Haqiqatan Ham Ishlashni Oshirdimi?
Manba tajribalarida TechDocRAG barcha to‘rtta benchmarkda taqqoslangan tizimlarga qaraganda yuqoriroq end-to-end ball bergan. Eng katta farq faqat oddiy band qidiruvlarida emas, balki protsedura, matn-jadval, cross-reference va versiyaga sezgir savollarda kuzatilgan. Bu naqsh tadqiqotning asosiy gipotezasiga mos: strukturaviy aloqalarning eng katta qiymati javob bir nechta bog‘langan hujjat obyektlariga tayanadigan so‘rovlarda namoyon bo‘ladi.
To‘rtta benchmark
- MPMQA: Mahsulot qo‘llanmalarida multimodal savol-javob; PM209 korpusi 209 qo‘llanma va 22.021 inson tomonidan belgilangan savol-javob juftligini o‘z ichiga oladi.
- DesignQA: Formula SAE qoidalari, CAD tasvirlari va muhandislik chizmalarida grounded tushunish.
- MMLongBench-Doc: 130 uzun PDF bo‘yicha 1062 ekspert belgilagan savol; hujjatning o‘rtacha uzunligi 49,4 sahifa.
- LongDocURL: 33.000 dan ortiq sahifani qamrab olgan 2325 savol-javob juftligi; tushunish, mulohaza yuritish va joylashuvni topish vazifalari.
Nazoratli baholash ushbu to‘rtta benchmarkdan tanlangan muvozanatlangan 7500 dan ortiq savol-javob juftligidan foydalangan.
Taqqoslangan RAG usullari
TechDocRAG Dense Chunk RAG, Hybrid Dense+BM25, Self-RAG, CRAG, RAPTOR, GraphRAG, LightRAG, HippoRAG 2 va VisRAG bilan taqqoslangan.
Adolatli taqqoslash uchun barcha usullarda imkon qadar bir xil javob generatoridan foydalanilgan: Gemini-3.1-Flash-Lite-Preview. Tashqi vebga kirish o‘chirib qo‘yilgan, CRAG corpus-only retrieval bilan cheklangan va kontekst budjetlari normallashtirilgan.
TechDocRAG amalga oshirish tafsilotlari
| Komponent | Konfiguratsiya |
|---|---|
| Hujjat parseri | Layout segmentation, figure-caption alignment va typed element extraction dan foydalanadigan OCR asosidagi multimodal parser |
| Identifier canonicalization | Band ID’lari, jadval/rasm yorliqlari, parametr nomlari va versiya yorliqlari uchun qoida asosidagi normallashtirish; so‘rov vaqtida fuzzy matching |
| Identifier index | Normallashtirilgan identifier, band raqami, yorliq va soha kalit so‘zlari ustida BM25 |
| Summary vector index | all-MiniLM-L6-v2 |
| Query analyzer | TinyLlama-1.1B-Chat-v1.0; batch size 16 |
| Answer generator | Gemini-3.1-Flash-Lite-Preview |
| Relation extraction | Aniq cross-reference parsing + layout heuristics |
| Retrieval | Top-10 identifier recall, 2-hop graph expansion, top-5 summary reranking |
| Context budget | 2048 matn tokeni + 10 visual region |
| Apparat | Single-GPU inference |
Tadqiqot Usuli va Natijalari
End-to-end natijalar
| Usul | MPMQA | DesignQA | MMLong | LongDoc |
|---|---|---|---|---|
| Dense Chunk RAG | 44,8 | 40,5 | 33,2 | 31,4 |
| Hybrid Dense+BM25 | 48,2 | 44,1 | 36,5 | 34,2 |
| Self-RAG | 51,8 | 47,5 | 39,8 | 37,5 |
| CRAG | 52,4 | 48,8 | 40,5 | 38,2 |
| RAPTOR | 50,5 | 46,2 | 41,4 | 38,8 |
| GraphRAG | 54,8 | 50,5 | 44,8 | 42,4 |
| LightRAG | 55,6 | 51,2 | 46,1 | 43,8 |
| HippoRAG 2 | 56,5 | 52,8 | 47,5 | 45,2 |
| VisRAG | 54,2 | 57,5 | 48,8 | 46,5 |
| TechDocRAG | 68,5 | 62,2 | 58,4 | 55,2 |
Manba to‘rtta benchmark o‘rtachasida Hybrid Dense+BM25 ga nisbatan 20,3 ball va VisRAG ga nisbatan 9,3 ball farqni qayd etadi. Bular benchmark ballarining mutlaq farqlaridir; foizdagi o‘zgarish emas.
Raw Evidence Hit Rate nega muhim?
Raw Evidence Hit Rate (REHR) tizim haqiqiy gold-standard xom dalil tugunlaridan kamida bittasini retrieval natijasi ichida ushlay olgan-olmaganini o‘lchaydi:
\[ REHR@K= \frac{1}{|Q|} \sum_{q\in Q} \mathbf{1} \left[ V_q^*\cap\hat{V}_q^{(K)}\neq\varnothing \right] \]
Exact identifier mosligini talab qiluvchi L0 darajasidagi natijalar quyidagicha:
| Usul | Strict REHR |
|---|---|
| Dense | 0,452 |
| Hybrid | 0,510 |
| TechDocRAG | 0,942 |
Mezon 1-hop, 2-hop, 3-hop va 4-hop qo‘shnichiligigacha yumshatilganda TechDocRAG REHR mos ravishda 0,965, 0,984, 0,992 va 1,000 qiymatlariga yetgan.
Grounding metrikalari
Tadqiqot klassik Recall@10 va Mean Reciprocal Rank bilan birga texnik hujjat aloqalarini baholash uchun maxsus metrikalarni ham belgilaydi.
Summary-to-Raw Trace Accuracy (SRTA) keltirilgan xulosa tugunini to‘g‘ri xom dalilgacha kuzatish mumkin yoki mumkin emasligini o‘lchaydi.
Evidence Connectivity Recall (ECR):
\[ ECR= \frac{1}{|Q|} \sum_{q\in Q} \frac{|\hat{E}_q\cap E_q^*|}{|E_q^*|} \]
orqali retrieval vaqtida zarur relation edge’larning qanchasi qayta topilganini o‘lchaydi.
Version Consistency Score (VCS) yaratilgan da’volarning so‘rovga tegishli to‘g‘ri hujjat versiyasiga tayanish ulushini baholaydi.
Procedure Order Accuracy (POA) protsedura savollarida qadamlarning to‘g‘ri tartibi saqlanganini o‘lchaydi.
Claim Support Rate (CSR) yaratilgan da’volarning kamida bitta xom dalil paketi tomonidan qo‘llab-quvvatlanish ulushini o‘lchaydi.
| Usul | Recall@10 | MRR | REHR@10 | SRTA | ECR | CSR |
|---|---|---|---|---|---|---|
| Hybrid Dense+BM25 | 45,8 | 0,31 | 0,510 | 0,485 | 0,425 | 0,512 |
| HippoRAG 2 | 58,5 | 0,45 | 0,721 | 0,685 | 0,652 | 0,704 |
| VisRAG | 54,2 | 0,40 | 0,654 | 0,611 | 0,582 | 0,625 |
| TechDocRAG | 69,2 | 0,56 | 0,942 | 0,914 | 0,852 | 0,942 |
So‘rov turiga ko‘ra ishlash
TechDocRAG’ning ustunligi oddiy clause yoki parameter so‘rovlarida nisbatan cheklangan, ammo hujjat aloqalarini saqlashni talab qiladigan so‘rovlarda ancha kattadir.
| So‘rov turi | Hybrid Chunk RAG | TechDocRAG |
|---|---|---|
| Clause | 52,1 | 65,8 |
| Parameter | 48,4 | 64,2 |
| Procedure | 35,2 | 62,1 |
| Text–Table | 31,4 | 60,5 |
| Text–Figure | 28,5 | 58,4 |
| Cross-Reference | 25,1 | 57,2 |
| Version | 22,4 | 54,1 |
| Macro Average | 34,7 | 60,3 |
Ablatsiya tajribalari nimani ko‘rsatadi?
| Variant | Main Score | REHR@10 | ECR | CSR | VCS | POA |
|---|---|---|---|---|---|---|
| To‘liq model | 62,5 | 0,94 | 0,85 | 0,82 | 0,78 | 0,75 |
| Relation edge yo‘q | 51,2 | 0,88 | 0,42 | 0,65 | 0,74 | 0,48 |
| Identifier recall yo‘q | 54,8 | 0,65 | 0,72 | 0,75 | 0,68 | 0,65 |
| Summary routing yo‘q | 56,4 | 0,91 | 0,81 | 0,78 | 0,72 | 0,70 |
| Raw bundling yo‘q | 58,2 | 0,92 | 0,83 | 0,45 | 0,75 | 0,72 |
| Intent-aware expansion yo‘q | 55,6 | 0,90 | 0,58 | 0,72 | 0,74 | 0,61 |
| Version metadata yo‘q | 59,4 | 0,93 | 0,84 | 0,81 | 0,32 | 0,74 |
Bu jadval tizim komponentlari turli funksiyalarga ega ekanini ko‘rsatadi. Relation edge’larni olib tashlash ECR’ni 0,85 dan 0,42 gacha tushiradi. Identifier recall olib tashlanishi REHR’ni 0,94 dan 0,65 gacha pasaytiradi. Raw bundling olib tashlanganda CSR 0,82 dan 0,45 gacha tushadi. Version metadata olib tashlanganda esa VCS 0,78 dan 0,32 gacha kamayadi.
Demak, tizimning yutug‘i bitta komponentdan kelmaydi; exact anchor topish, strukturaviy bog‘lanish, semantik qayta tartiblash, xom dalilni paketlash va versiya metadata’si turli xato turlarini nishonga oladi.
Ishlash kattaroq hisoblash budjeti hisobigami?
Manbadagi profiling buni yagona izoh sifatida qo‘llab-quvvatlamaydi.
| Usul | Offline indexing | Indeks hajmi | O‘rtacha so‘rov kechikishi | Peak GPU xotira |
|---|---|---|---|---|
| Dense Chunk RAG | 2,5 s | 2,0 MB | 5,2 ms | ~150 MB |
| Hybrid Dense+BM25 | 3,8 s | 3,5 MB | 7,8 ms | ~180 MB |
| HippoRAG 2 | 12,4 s | 8,2 MB | 45,6 ms | ~450 MB |
| TechDocRAG | 6,36 s | 2,28 MB | 8,3 ms | 314,4 MB |
TechDocRAG’ning offline indeks yaratishi Hybrid RAG’ga qaraganda qimmatroq, chunki graf va uchlik ifoda yaratiladi. Bunga qaramay, o‘rtacha query latency 8,3 ms bo‘lib, Hybrid’ning 7,8 ms qiymatiga yaqin va HippoRAG 2 ning 45,6 ms qiymatidan sezilarli darajada past.
Identifier buzilishiga chidamlilik
Tadqiqotning robustness tajribasida OCR ga o‘xshash buzilishlar band raqamlari, parametr nomlari va jadval/rasm yorliqlariga kiritilgan.
| Buzilish / yo‘qotish darajasi | REHR: identifier corruption | ECR: relation dropout |
|---|---|---|
| %0 | 1,0000 | 0,9875 |
| %5 | 1,0000 | 0,9825 |
| %10 | 1,0000 | 0,9725 |
| %20 | 0,0700 | 0,9525 |
| %30 | Hisobot berilmagan | 0,9310 |
Natija assimetrik. Relation edge’larning bir qismi yo‘qolishi tizim ishlashini bosqichma-bosqich pasaytiradi, texnik identifier’larning og‘ir buzilishi esa ancha keskin xatoga olib keladi. Bu natija tizim graf aloqalari bo‘yicha ma’lum darajada ortiqchalikka ega ekanini, biroq dastlabki retrieval tayanchi to‘g‘ri parse qilinishiga kuchli bog‘liq bo‘lib qolishini ko‘rsatadi.
Tadqiqotning cheklovlari
- TechDocRAG hujjat parseri sifatiga bog‘liq.
- Jadval extraction, caption alignment va clause numbering xatolari relation graph’ni buzishi mumkin.
- Aniq cross-reference’lar yashirin havolalarga qaraganda ishonchliroq qayta ishlanadi.
- Nostandart layout va inson uchun tushunarli, ammo mashina uchun yashirin formal belgilar muammo tug‘dirishi mumkin.
- Turli hujjat versiyalarida bir xil identifier turli shartlar bilan qayta ishlatilishi mumkin.
- Relation-aware grounding metrikalari qo‘lda dalil annotatsiyasini talab qiladi.
- Ishlash natijalari muayyan benchmarklar, retrieval konfiguratsiyalari va umumiy javob generatori ostida olingan.
- Manbaning asosiy natija jadvallarida takroriy tajriba variansiyasi, ishonch oralig‘i yoki klassik ahamiyatlilik testi berilmagan; shu sabab ball farqlari statistik ahamiyatlilik sifatida kengaytirilmasligi kerak.
Amaliy xatoni kamaytirish tavsiyalari
Mualliflar past sifatli OCR sahifalarini confidence-based filtering bilan belgilashni, muammoli hududlarni tanlab qayta parse qilishni va band ID’si, jadval yorlig‘i, rasm yorlig‘i hamda versiya tag’lari uchun rule-based tekshiruvdan foydalanishni tavsiya qiladilar.
Qimmatroq vision/OCR jarayonlarini barcha sahifalarga tatbiq etish o‘rniga, ularni ishonchi past hududlarga yo‘naltirish ham xarajat nuqtai nazaridan tavsiya qilinadi. Ishonch hali ham past bo‘lsa, tizim page-level yoki region-level retrieval’ga qaytishi va provenance’ni noaniq deb belgilashi mumkin.
Tadqiqot nima deydi?
Texnik hujjatlarda RAG muvaffaqiyatini faqat ko‘proq matn bo‘lagini retrieval qilish bilan izohlab bo‘lmaydi. Band havola qilgan jadval, rasm caption’i, protsedura qadamlarining tartibi yoki hujjatning to‘g‘ri versiyasi kabi aloqalarni saqlash answer grounding va evidence traceability bo‘yicha muhim ishlash yutug‘ini berishi mumkin.
Tadqiqot nima demaydi?
TechDocRAG barcha RAG vazifalarida mutlaq eng yaxshi usul ekani ko‘rsatilmagan. Natijalarni umumiy web QA, erkin shakldagi axborot qidiruvi yoki o‘zaro bog‘lanmagan matn to‘plamlariga to‘g‘ridan-to‘g‘ri umumlashtirib bo‘lmaydi. Shuningdek, tizim mukammal OCR yoki parsing muammosini hal qilmaydi; aksincha, og‘ir identifier buzilishida uning ishlashi keskin pasayishi bevosita tajriba bilan ko‘rsatilgan.
Manba va Usul Haqida Izoh
Asl tadqiqot: TechDocRAG: Relation-Preserving Retrieval-Augmented Generation (RAG) for Technical Documents
Mualliflar: Seungjoon Lee; Myungryul Choi.
Mas’ul muallif: Myungryul Choi.
Tashkilotlar: Department of EECI Engineering, Hanyang University; Division of Electrical Engineering, Hanyang University, Seoul, Republic of Korea.
Jurnal: AI.
Nashriyot: MDPI.
Bibliografik qayd: AI 2026, 7(5), 161.
DOI: 10.3390/ai7050161
Manba turi: Tadqiqot maqolasi.
Nashr jarayoni: Qabul qilindi 15 Mart 2026; qayta ko‘rib chiqildi 21 Aprel 2026; qabul qilindi 27 Aprel 2026; nashr etildi 6 May 2026.
Litsenziya: Creative Commons Attribution (CC BY).
Moliyalashtirish: Tadqiqot tashqi moliyalashtirish olmagan.
Ma’lumotlarning mavjudligi: MPMQA, DesignQA, MMLongBench-Doc va LongDocURL nomli ochiq benchmark ma’lumotlar to‘plamlaridan foydalanilgan. Yangi yirik ko‘lamli benchmark yaratilmagan. Hosila annotatsiyalar, promptlar va amalga oshirish tafsilotlarini birinchi muallifdan so‘rash mumkin.
Manfaatlar to‘qnashuvi: Mualliflar manfaatlar to‘qnashuvini bildirmagan.
Muallif hissalari: Seungjoon Lee konseptuallashtirish, metodologiya, dasturiy ta’minot, tekshirish, formal tahlil, tadqiqot, resurslar, ma’lumotlarni kuratsiya qilish, dastlabki qoralama va vizuallashtirishni bajargan. Seungjoon Lee va Myungryul Choi ko‘rib chiqish hamda tahrirlashni birgalikda amalga oshirgan; Myungryul Choi superviziya va loyiha boshqaruvi uchun mas’ul bo‘lgan.
Taqqoslash usuli: Flat retrieval, adaptive/corrective RAG, hierarchical RAG, graph RAG, memory-oriented RAG va multimodal retrieval usullari taqqoslangan. Imkon qadar bir xil javob generatori va ekvivalent dalil budjeti qo‘llangan. CRAG tashqi vebga kirishsiz corpus-only rejimida baholangan.
Asosiy metodologik cheklov: Hisobotda benchmark ballari bo‘yicha klassik statistik ahamiyatlilik testlari, confidence interval yoki run-to-run variansiya berilmagan. Shu sabab ishlash jadvallari tadqiqot protokoli doirasida kuzatilgan qiyosiy benchmark natijalari sifatida ko‘rib chiqilishi kerak.
Verianla kontent usuli: Ushbu o‘zbekcha matn manba maqolaning jumla-jumla tarjimasi emas. Muammo ta’rifi, geterogen elementlar grafigi, identifier-summary-raw arxitekturasi, matematik retrieval formulatsiyasi, query intent siyosatlari, benchmark tuzilmasi, evaluation metrikalari, ablatsiyalar, resurs xarajati, robustness tajribalari va metodologik cheklovlar saqlangan holda mustaqil o‘zbekcha ilmiy bayon yaratilgan. Manbada bo‘lmagan ishlash natijasi, statistika yoki tizim xususiyati qo‘shilmagan.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan