


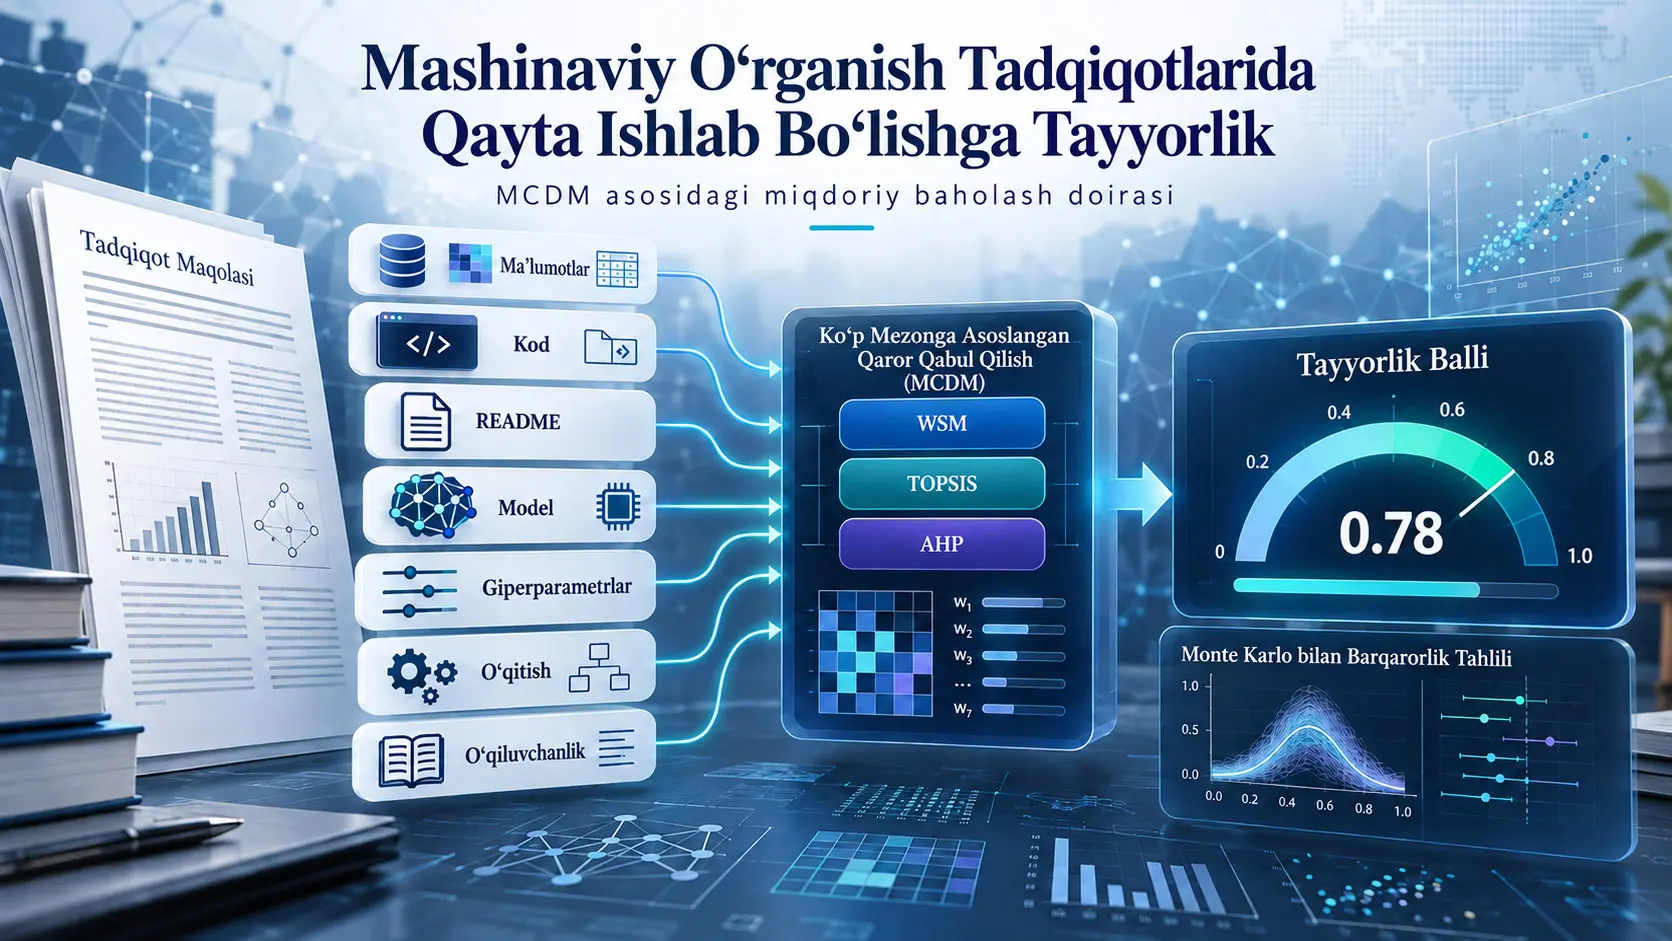
Ushbu tadqiqot mashinaviy o‘rganish bo‘yicha tadqiqot tajribalarini qayta ishga tushirmasdan, chop etilgan maqola va unga bog‘liq tadqiqot artefaktlarining R1 darajasidagi qayta ishlab bo‘lishga qanchalik tayyor ekanini miqdoriy o‘lchash uchun Ko‘p Mezonga Asoslangan Qaror Qabul Qilish (Multi-Criteria Decision Making, MCDM) asosidagi baholash doirasini taklif qiladi. R1 qayta ishlab bo‘lishga tayyorlik tadqiqotning ayni ma’lumotlar, kod, model va hisoblash muhiti yordamida ayni natijalarni qayta olishni qo‘llab-quvvatlaydigan ma’lumotlar, kod, o‘qitilgan model va metodologik izohlarni qay darajada taqdim etishini ifodalovchi baholash tushunchasidir. Doira yetti mezondan foydalanadi: ma’lumotlarning ochiqligi, kodning ochiqligi, README mavjudligi, o‘qitilgan modelning taqdim etilishi, giperparametrlarning bayon qilinishi, o‘qitish jarayonining bayon qilinishi va maqolaning o‘qiluvchanligi. Mezonlar ordinal rubrika bilan ballanadi, [0,1] oralig‘iga normallashtiriladi va Vaznli Yig‘indi Modeli (Weighted Sum Model, WSM) hamda Ideal Yechimga O‘xshashlik bo‘yicha Afzallikni Tartiblash Texnikasi (TOPSIS) yordamida bitta tayyorlik skoriga aylantiriladi.
Doirani ishlab chiqishda mavjud ikki qayta ishlab bo‘lish ma’lumotlar to‘plamidan foydalanilgan. Asosiy baholash uchun Olszewski va hammualliflarining tozalangan 215 maqolalik ma’lumotlar to‘plamidan chekli populyatsiya tuzatmasiga ega Cochran tanlash yondashuvi bilan 139 maqola tasodifiy tanlangan. Har bir maqola yetti mezon bo‘yicha tadqiqotchilar va ChatGPT tomonidan mustaqil baholangan; ikki bahoning o‘rtachasi yakuniy mezon balli sifatida ishlatilgan. Inson va model yordamidagi baholashlar o‘rtasidagi vaznli Cohen kappa o‘rtachasi \(\kappa=0.96\) deb xabar qilingan.
Teng mezon vaznlari ishlatilgan asosiy baholashda WSM va TOPSIS ayni ikkilik tasnif natijasini bergan. 0,5 qaror chegarasida doirani referens qayta ishlab bo‘lish yorlig‘i bilan taqqoslashda aniqlik 0,64, precision 0,40, sezgirlik 0,70 va F1 skori 0,51 bo‘lgan. Bu natijalar doira qayta ishlab bo‘ladigan maqolalarning muhim qismini aniqlay olishini, biroq “tayyor” ko‘rinadigan ayrim maqolalar amaliy qayta ishlab ko‘rishda muvaffaqiyatsiz bo‘lishi mumkinligini ham ko‘rsatadi.
Eng muhim talqin cheklovi: Olingan skor tadqiqot haqiqatda qayta ishlab chiqilganini isbotlovchi natija emas. Doira tajribalarni ishga tushirmaydi; maqola va bog‘liq artefaktlarda ko‘rinadigan tayyorgarlik darajasini o‘lchaydi. Yashirin bog‘liqliklar, ishlamaydigan skriptlar, apparat yoki dasturiy ta’minot nomuvofiqligi, deterministik bo‘lmagan GPU amallari yoki amalda olinmaydigan ma’lumotlar yuqori tayyorlik skoriga qaramay haqiqiy qayta ishlab olishni to‘sishi mumkin. Shuningdek, past tayyorlik skori tadqiqotning ilmiy sifati, yangiligi yoki ta’siri past ekanini anglatmaydi.
Mashinaviy o‘rganishda qayta ishlab bo‘lish nega alohida muammoga aylanmoqda?
Mashinaviy o‘rganish tadqiqotlarida e’lon qilingan natijani qayta olish faqat maqoladagi yakuniy aniqlik, F1 skori yoki yo‘qotish qiymatini bilishga bog‘liq emas. Tadqiqotchi qaysi ma’lumotlardan foydalangani, ma’lumotlarni qanday oldindan qayta ishlagani, o‘qitish va test ajratishlari qanday bajarilgani, model arxitekturasi tafsilotlari, giperparametrlar, tasodifiylik manbalari, dasturiy bog‘liqliklar va o‘qitish kodi haqiqatan ishga tushirilishi mumkinmi-yo‘qmi ham natijani belgilashi mumkin.
Manba tadqiqot qayta ishlab bo‘lmaydigan natijalar ilmiy jihatdan ikki asosiy muammo tug‘dirishini ta’kidlaydi. Birinchisi, e’lon qilingan da’volarni mustaqil tekshirishni qiyinlashtirishidir. Ikkinchisi esa keyingi tadqiqotlar tekshirilmagan asos ustiga qurilsa, vaqt va tadqiqot resurslari behuda sarflanishi mumkinligidir.
Mavjud yechim tashabbuslari orasida qayta ishlab bo‘lish tekshiruv ro‘yxatlari, nashr yo‘riqnomalari, ochiq ma’lumot va ochiq kod siyosatlari, kod repozitoriylari, konteynerlashtirish va tuzilmali hujjatlashtirish bor. Biroq ularning muhim qismi “bor/yo‘q” shaklidagi ikkilik yoki sifat baholarini beradi. Manba tadqiqot hal qilmoqchi bo‘lgan bo‘shliq bitta tadqiqot maqolasi uchun qisman moslikni ham hisobga oladigan, talqin qilinadigan va miqdoriy qayta ishlab bo‘lishga tayyorlik skori ishlab chiqish ehtiyojidir.
R1 darajasidagi qayta ishlab bo‘lishga tayyorlik nima?
R1 darajasidagi qayta ishlab bo‘lishga tayyorlik ishning ayni ma’lumotlar, ayni kod, ayni model va ayni hisoblash muhitidan foydalanib ayni natijalarni qayta olishni qo‘llab-quvvatlaydigan tadqiqot artefaktlari va metodologik izohlarni qay darajada taqdim etishini anglatadi; ushbu tadqiqot R1 tajribalarini amalda qayta ishga tushirish o‘rniga, qayta ishlab olishga ko‘rinadigan tayyorgarlikni maqola va bog‘langan artefaktlar orqali o‘lchaydi.
R1, R2 va R3 o‘rtasidagi farq
| Daraja | Asosiy mantiq | Nima saqlanadi? | Ushbu tadqiqot doirasidami? |
|---|---|---|---|
| R1 | Ayni natijalarni asl artefaktlar bilan qayta olish | Ayni ma’lumotlar, kod, model va hisoblash muhiti | Ha |
| R2 | Mustaqil amalga oshirish bilan qayta ishlab olish | Asl ma’lumotlar saqlanadi; amalga oshirish mustaqil bo‘lishi mumkin | Yo‘q |
| R3 | Boshqa ma’lumotlar va modellashtirish yondashuvlari bilan o‘xshash ilmiy natijaga erishish | Talqin yoki ilmiy natija darajasi | Yo‘q |
R1 tanlanishining asosiy sababi uning ob’ektiv tarzda nisbatan oson baholanishidir. R2 va R3 mustaqil amalga oshirishlar hamda muqobil ma’lumot yoki modellarni talab qilgani uchun ko‘pincha haqiqiy qayta ishlab ko‘rish tajribalarini o‘tkazishni talab qiladi. Manba doira esa maqola darajasida, tajribalarni qayta ishga tushirmasdan qo‘llash uchun mo‘ljallangan.
Qayta ishlab bo‘lmaslikning asosiy manbalari
Kod va hisoblash muhiti: Kod umuman bo‘lishilmasligi, faqat qisman bo‘lishilishi yoki bog‘liqlik versiyalari ko‘rsatilmasligi ayni amallarni qayta tiklashga to‘sqinlik qilishi mumkin.
Ma’lumotlarning ochiqligi: Xususiy, yopiq yoki faqat qisman taqdim etilgan ma’lumotlar to‘plamlari tajribani qayta o‘tkazishni bevosita cheklashi mumkin. Oldindan qayta ishlash bosqichlari bayon qilinmasligi yoki ma’lumot sizishi kabi metodologik muammolar ham asl natija bilan qayta ishlab olish o‘rtasidagi farqni oshirishi mumkin.
Tasodifiylik: Vaznlarni boshlang‘ichlash, namuna olish, mini-batch tartibi va shu kabi stoxastik komponentlar nazorat qilinmasa, ayni kod ham turli natijalar berishi mumkin. Bundan tashqari GPU amallari, parallellik va suzuvchi nuqta farqlari ayrim muhitlarda to‘liq deterministik ishlashga to‘sqinlik qilishi mumkin.
Hisobot berish: Faqat muvaffaqiyatli tajribalarni xabar qilish, ishlatilgan statistikalarni ochiq ko‘rsatmaslik, noaniqliklarni yashirish yoki o‘qitish tafsilotlarini yetarli bermaslik tadqiqotni qayta qurishni qiyinlashtirishi mumkin.
Nega tekshiruv ro‘yxati yolg‘iz o‘zi yetarli deb hisoblanmagan?
Ko‘plab tekshiruv ro‘yxatlarida “kod bormi?”, “ma’lumot mavjudmi?” yoki “giperparametrlar bayon qilinganmi?” kabi foydali savollar mavjud. Biroq ikkilik belgilash qisman moslikni yetarlicha ifodalamaydi. Masalan, umuman kod ulashmagan ish bilan kod ulashgan, ammo bir qismi yetishmaydigan ish ayni “yo‘q” toifasiga tushishi mumkin.
Shu sababli ushbu tadqiqot ordinal, ya’ni tartibli ballash mantiqidan foydalanadi. Natijada “umuman yo‘q”, “qisman bor” va “yetarlicha to‘liq” darajalari matematik ravishda farqlanishi mumkin.
MCDM bu baholashda nega ishlatiladi?
Ko‘p Mezonga Asoslangan Qaror Qabul Qilish (MCDM) ma’lumotlarning ochiqligi, kod, hujjatlashtirish, model artefakti va metodologik aniqlik kabi turli qayta ishlab bo‘lish ko‘rsatkichlarini umumiy shkala bo‘yicha keltirib, vaznlash orqali bitta talqin qilinadigan skor hosil qilish imkonini bergani uchun ishlatiladi; ayni tuzilma mezon vaznlarini baholash maqsadiga qarab o‘zgartirishga ham imkon beradi.
Doiraning yetti asosiy mezoni
| Mezon | Nima baholanadi? |
|---|---|
| Ma’lumotlarning ochiqligi | Maqolada ishlatilgan ma’lumotlar to‘plami ommaga ochiq, qisman, sezgir yoki so‘rov bo‘yicha olinadigan ekanligi. |
| Kodning ochiqligi | Tajribalarni qayta o‘tkazishga imkon beradigan kod mavjud va yetarlicha to‘liq ekanligi. |
| README mavjudligi | Muhit, bog‘liqliklar va ishga tushirish bosqichlarini tushuntiradigan foydalanish hujjatlari mavjudligi va yetarliligi. |
| O‘qitilgan modelning taqdim etilishi | Modelni qayta o‘qitmasdan ishlatishga imkon beradigan vaznlar yoki o‘qitilgan model artefaktlari mavjudligi. |
| Giperparametr bayoni | O‘qitishda ishlatilgan asosiy giperparametrlar qay darajada ko‘rsatilgani. |
| O‘qitish bayoni | Oldindan qayta ishlash, namuna olish, o‘qitish/test ajratilishi va o‘qitish jarayoni aniqlik darajasi. |
| Maqola o‘qiluvchanligi | Usul bayonining tuzilishi, izchilligi va tushunarliligi. |
Bu yetti mezon qanday tanlangan?
Mezonlarni ishlab chiqish uch bosqichda olib borilgan. Birinchi bosqichda qayta ishlab bo‘lish adabiyoti, mavjud tekshiruv ro‘yxatlari va ma’lum qayta ishlab bo‘lmaslik manbalari ko‘rib chiqilgan. Bu bosqich ma’lumotlar, kod, o‘qitilgan model va README kabi ishga tushiriladigan artefaktlar hamda o‘qitish jarayoni va giperparametr aniqligi kabi metodologik shaffoflik tarkiblarini qamrab olishni ta’minlagan.
Ikkinchi bosqichda mavjud ikki ma’lumotlar to‘plamida logistika regressiyasi, Random Forest va XGBoost yordamida qayta ishlab bo‘lish yorlig‘i bilan bog‘liq omillar tekshirilgan. Bu modellar mezonlarni avtomatik va qat’iy tanlaydigan “hakam” sifatida ishlatilmagan; nazariy tanlovni qo‘llab-quvvatlovchi empirik dalil bergan.
Uchinchi bosqichda nazariy va empirik dalillar birlashtirilib, maqola va bog‘liq artefaktlardan, tajribani ishga tushirmasdan baholash mumkin bo‘lgan ixcham yetti mezonli to‘plam yaratilgan.
Doira nimalarni qamrovdan tashqarida qoldiradi?
Yetti mezon keng qamrovli bo‘lsa-da, tugallangan ro‘yxat emas. Avtomatik testlar mavjudligi, dasturiy litsenziyalar izchilligi, data kartalari kabi tuzilmali ma’lumot hujjatlari, tasodifiylik nazorati, apparat/dastur determinizmi va baholash sizishi kabi omillar mustaqil mezon sifatida modelga kiritilmagan.
Bu omillarning ayrimlari o‘qitish bayoni yoki hujjatlashtirish sifati orqali bilvosita qamrab olinishi mumkin; biroq manba tadqiqot ularning to‘liq ifodalanganini da’vo qilmaydi.
Tadqiqot Usuli va Natijalari
Ishlatilgan ikki ma’lumot manbasi
| Ma’lumotlar to‘plami | Boshlang‘ich hajm | Qamrov | Ilmiy roli |
|---|---|---|---|
| Olszewski va boshq. | 745 maqola | 2013–2022, NDSS, IEEE S&P, CCS va USENIX; 19 qayta ishlab bo‘lish xususiyati va ikkilik maqola yorlig‘i | Asosiy tanlash va MCDM baholashining asosi |
| Raff | 255 maqola | Asosan NeurIPS va ICML; 1984–2017; 28 annotatsiya xususiyati | Ayniqsa tuzilma va o‘qiluvchanlik kabi omillar bilan empirik tekshiruvni boyitish |
Ma’lumotlarni tozalash
Olszewski ma’lumotlar to‘plamida yetishmaydigan va analitik jihatdan foydali bo‘lmagan yozuvlar olib tashlangan. Yetishmaydigan kategorik qiymatlar sun’iy to‘ldirilmagan; tegishli qatorlar o‘chirilib, 745 maqolalik ma’lumot 292 maqolaga tushgan. Sarlavha, muallif, nashr joyi identifikatorlari va havolalar kabi umumiy mezon bahosiga hissa qo‘shmaydigan maydonlar hamda keraksiz yoki faqat matnli o‘zgaruvchilar chiqarib tashlangan. Sakkiz qayta ishlab bo‘lish xususiyati saqlangan.
Keyin qayta ishlab bo‘lish yorlig‘i faqat “to‘liq qayta ishlab bo‘ladigan” va “qayta ishlab bo‘lmaydigan” deb belgilangan maqolalar bilan cheklangan va yakuniy tozalangan ma’lumotlar to‘plami 215 maqoladan iborat bo‘lgan.
Raff ma’lumotlar to‘plamida bitta yetishmaydigan qiymat tuzatilgan va juda siyrak xususiyat olib tashlangan. Nashr joyi va mavzuga xos o‘zgaruvchilar olib tashlangach, 20 xususiyat saqlangan. Kategorik o‘zgaruvchilar ikkilik ko‘rsatkichlarga aylantirilgan. Logistika regressiyasida sonli xususiyatlar koeffitsiyentlarni taqqoslash uchun min–max usulida [0,1] oralig‘iga masshtablangan, daraxt asosidagi modellarda esa sonli o‘zgaruvchilar masshtablanmagan.
Empirik mezon tekshiruvi
Ikki ma’lumotlar to‘plami alohida-alohida modellashtirilgan. Logistika regressiyasi talqin qilinadigan boshlang‘ich model, Random Forest va XGBoost esa chiziqli bo‘lmagan aloqalar hamda xususiyatlar o‘zaro ta’sirlarini tutish uchun ishlatilgan. Har ikki ma’lumotlar to‘plamida o‘qitish/test ajratilishi %80/%20 bo‘lgan.
Sinf nomutanosibligi Random Forest uchun muvozanatlangan sinf vaznlari, XGBoost uchun esa scale_pos_weight parametri bilan boshqarilgan.
Tenglama (1): XGBoost foyda asosidagi xususiyat ahamiyati
\[ \mathrm{Imp}(j) = \sum_{\text{j özelliğini kullanan bölünmeler}} \Delta L_{\mathrm{split}} \]
1. Formula nimani hisoblaydi? XGBoost qaror daraxtlarida muayyan \(j\) xususiyati ishlatilgan bo‘linishlarning model maqsad/yo‘qotish funksiyasida hosil qilgan jami yaxshilanishini hisoblaydi.
2. O‘zgaruvchilar nimalar? \(\mathrm{Imp}(j)\), \(j\) xususiyatining ahamiyati. \(\Delta L_{\mathrm{split}}\), shu xususiyatdan foydalangan aniq daraxt bo‘linishi maqsad funksiyasida bergan yo‘qotish kamayishidir.
3. Birliklar nimalar? Bu fizik o‘lchov emas. Xom qiymat XGBoost maqsad funksiyasidagi yaxshilanishga bog‘liq algoritmik ahamiyat kattaligidir. Tadqiqotda ahamiyat qiymatlari taqqoslash uchun keyin min–max normallashtirilgan.
4. Matematik roli nima? Ayni xususiyat bir nechta daraxt va bo‘linishda ishlatilishi mumkin. Formula ushbu xususiyat bergan barcha yo‘qotish kamayishlarini jamlaydi.
5. Algoritmik ma’nosi nima? Katta \(\mathrm{Imp}(j)\), model qayta ishlab bo‘lish sinfini ajratishda tegishli xususiyatni foydali deb topganini ko‘rsatadi.
6. Qaysi shartda amal qiladi? Bu ahamiyat XGBoost modeli qurgan daraxtlar, ma’lumotlar to‘plami va o‘qitish tartibiga bog‘liq; sababiy ta’sir emas.
7. Natija qanday talqin qilinishi kerak? Yuqori xususiyat ahamiyati tegishli omil nazariy jihatdan majburiy qayta ishlab bo‘lish sharti ekanini o‘zi isbotlamaydi. Manba tadqiqot bu qiymatlarni mezon tanlashning qat’iy chegarasi emas, nazariy tahlil bilan birga ishlatiladigan qo‘llab-quvvatlovchi dalil sifatida baholagan.
Tenglama (2): ikkilik xususiyatning o‘rtacha bashorat ta’siri
\[ \Delta_j = \frac{1}{N} \sum_{i=1}^{N} \left[ P\left( y=1 \mid x_j^{(i)}=1,\, x_{-j}^{(i)} \right) - P\left( y=1 \mid x_j^{(i)}=0,\, x_{-j}^{(i)} \right) \right] \]
1. Formula nimani hisoblaydi? Ikkilik xususiyat 0 dan 1 ga o‘zgartirilganda, boshqa barcha xususiyatlar o‘zgarmas saqlansa, modelning “qayta ishlab bo‘ladigan” sinf uchun bashorat ehtimoli o‘rtacha qanchaga o‘zgarishini hisoblaydi.
2. O‘zgaruvchilar nimalar? \(N\) maqolalar soni. \(y=1\) qayta ishlab bo‘ladigan sinfni ko‘rsatadi. \(x_j^{(i)}\), \(i\)-maqoladagi tekshirilayotgan \(j\) xususiyatidir. \(x_{-j}^{(i)}\), shu maqoladagi boshqa barcha xususiyatlardir.
3. Birliklar nimalar? \(\Delta_j\) ehtimol farqi shkalasida va fizik birligi yo‘q.
4. Matematik roli nima? Har bir maqola ikki marta baholanadi: tegishli xususiyat farazan 1 va 0 qilinadi. Ikki bashorat orasidagi farqlar barcha maqolalarda o‘rtachalanadi.
5. Algoritmik ma’nosi nima? Musbat \(\Delta_j\), xususiyat mavjudligi model bashoratida qayta ishlab bo‘ladigan sinf tomon siljish bilan bog‘liqligini; manfiy qiymat teskari yo‘nalishdagi bashorat o‘zgarishini ko‘rsatadi.
6. Qaysi shartlarda amal qiladi? Bu qiymat o‘qitilgan bashorat modelining xatti-harakatini tushuntiradi. Xususiyatlarning real dunyodagi sababiy ta’sirini isbotlamaydi.
7. Natija qanday talqin qilinishi kerak? Xususiyat ta’siri XGBoost muayyan ma’lumotlar to‘plamida o‘rgangan aloqani talqin qilish uchun ishlatilgan va mezon tanlash nazariy qayta ishlab bo‘lish bilimlari bilan birga bajarilgan.
Tanlangan ordinal rubrika
| Mezon | Daraja | Ma’nosi |
|---|---|---|
| Ma’lumotlarning ochiqligi | 0 | Ma’lumotlar to‘plami ommaga ochiq emas. |
| 1 | Ma’lumot sezgir deb belgilangan. | |
| 2 | Ma’lumot qisman ochiq yoki so‘rov bo‘yicha taqdim etiladi. | |
| 3 | Ma’lumot ommaga ochiq. | |
| Kodning ochiqligi | 0 | Kod ommaga ochiq emas. |
| 1 | Kod qisman mavjud yoki to‘liq qayta ishga tushirishga to‘sqinlik qiladigan kamchiliklar bor. | |
| 2 | Kod ommaga ochiq va yetarlicha to‘liq. | |
| README | 0 | README yoki foydalanish yo‘riqnomasi yo‘q. |
| 1 | README bor, ammo muhim qadamlar yoki bog‘liqliklar yetishmaydi. | |
| 2 | README ish oqimini bajarish uchun yetarlicha to‘liq. | |
| O‘qitilgan model | 0 | O‘qitilgan model artefakti taqdim etilmagan. |
| 1 | O‘qitilgan model artefakti taqdim etilgan. | |
| Giperparametrlar | 0 | Giperparametrlar bayon qilinmagan. |
| 1 | Qisman bayon qilingan. | |
| 2 | To‘liq bayon qilingan. | |
| O‘qitish bayoni | 0 | O‘qitish/oldindan qayta ishlash/ajratishlar bayon qilinmagan. |
| 1 | Qisman bayon qilingan. | |
| 2 | To‘liq bayon qilingan. | |
| Maqola o‘qiluvchanligi | 0 | Tuzilma noaniq va muhim usul qadamlarini kuzatish qiyin. |
| 1 | Umumiy tuzilma mantiqli, ammo noaniq yoki izchil bo‘lmagan qismlar mavjud. | |
| 2 | Yaxshi tashkil qilingan, aniq va usul bayoni izchil. |
Tenglama (3): ordinal ballni [0,1] oralig‘iga normallashtirish
\[ x_k = \frac{s_k}{L_k}, \qquad x_k\in[0,1] \]
1. Formula nimani hisoblaydi? Turli maksimal darajalarga ega mezon ballarini umumiy [0,1] shkalasiga o‘tkazadi.
2. O‘zgaruvchilar nimalar? \(s_k\), \(k\)-mezon uchun berilgan ordinal ball. \(L_k\), shu mezonning mumkin bo‘lgan eng yuqori ordinal darajasi. \(x_k\), normallashtirilgan mezon qiymati.
3. Birliklar nimalar? \(x_k\) o‘lchovsiz.
4. Matematik roli nima? Masalan, maksimal darajasi 3 bo‘lgan ma’lumot ochiqligi bilan maksimal darajasi 1 bo‘lgan o‘qitilgan model mezonini ayni sonli oraliqda taqqoslash imkonini beradi.
5. Algoritmik ma’nosi nima? \(x_k=0\), mezon eng past; \(x_k=1\), eng yuqori belgilangan tayyorlik darajasida ekanini ko‘rsatadi.
6. Faraz nima? Chiziqli normallashtirish qo‘shni ordinal darajalar orasidagi farqlar teng qadamlar deb faraz qiladi. Manba tadqiqot bu sodda va shaffofligini, biroq real foyda ortishi doim chiziqli bo‘lmasligi mumkinligini ochiq tan oladi.
7. Natija qanday talqin qilinishi kerak? Masalan \(s_k=2\) va \(L_k=3\) bo‘lsa:
\[ x_k=\frac{2}{3}\approx0.667 \]
Bu qiymat “haqiqatan 66,7% qayta ishlab bo‘ladi” degani emas; faqat tegishli mezonda maksimal ordinal darajaga nisbatan normallashtirilgan moslik darajasidir.
Namuna hajmi va annotatsiya
Tozalangan 215 maqolalik Olszewski ma’lumotlar to‘plamidan namuna olishda manba tadqiqot chekli populyatsiya tuzatmasiga ega Cochran yondashuvidan foydalangan. %95 ishonch darajasi, ehtiyotkor populyatsiya ulushi sifatida p=0,5 va %5 xatolik chegarasi qo‘llanganda namuna hajmi 139 maqola deb hisoblangan.
Manba maqola Cochran hisobining algebraik tenglamasini raqamlangan formula sifatida bermaydi. Shu sababli bu yerda manbada bo‘lmagan alohida Cochran tenglamasi qo‘shilmagan.
139 maqola yetti mezonning barchasi bo‘yicha tadqiqot mualliflari va ChatGPT tomonidan mustaqil ballangan.
Tenglama (4): ikki annotatsiyani birlashtirish
\[ S_{\mathrm{final}} = \frac{ A_{\mathrm{study}} + A_{\mathrm{ChatGPT}} }{2} \]
1. Formula nimani hisoblaydi? Tadqiqotchi annotatsiyasi bilan ChatGPT annotatsiyasining arifmetik o‘rtachasini olib, mezonning yakuniy ballini hosil qiladi.
2. O‘zgaruvchilar nimalar? \(A_{\mathrm{study}}\), tadqiqot jamoasining mezon balli; \(A_{\mathrm{ChatGPT}}\), model bergan mezon balli.
3. Birliklar nimalar? Qiymat tegishli mezonning ordinal ball shkalasida.
4. Matematik roli nima? Ikki baholovchi teng vazn bilan birlashtiriladi.
5. Algoritmik ma’nosi nima? Yakuniy ballning faqat inson yoki faqat LLM bahosiga bog‘lanib qolishiga yo‘l qo‘ymaydigan oddiy birlashtirish amali.
6. Shart nima? Ikki annotatsiya ayni mezon va ayni ordinal rubrika bo‘yicha bajarilishi kerak.
7. Natija qanday talqin qilinishi kerak? Ikki annotatsiya o‘rtasida juda yuqori umumiy moslik xabar qilingan: vaznli Cohen kappa o‘rtachasi \(\kappa=0.96\). Biroq o‘qiluvchanlik kabi nisbatan subyektiv mezonlarda moslik pastroq va tadqiqot faqat cheklangan annotatorlardan foydalangan.
MCDM skorini hisoblash
Normallashtirishdan so‘ng har bir mezon \(x_i\in[0,1]\) oralig‘ida bo‘ladi. Tadqiqot ikki alohida, talqin qilinadigan MCDM agregatsiya usulidan foydalanadi: WSM va TOPSIS.
WSM bilan TOPSIS o‘rtasidagi asosiy farq nima?
WSM mezon ballarini vaznli chiziqli yig‘indi sifatida birlashtiradi, TOPSIS esa har bir maqola mezon profilining barcha mezonlar eng yaxshi bo‘lgan ideal profilga va barcha mezonlar eng yomon bo‘lgan anti-ideal profilga masofasini o‘lchaydi; shu sababli ayni vaznlar ishlatilsa ham ikki usul kuchli va zaif mezon kombinatsiyalariga turlicha javob berishi mumkin.
Tenglama (5): Vaznli Yig‘indi Modeli — WSM
\[ S = \sum_{i=1}^{n}w_i x_i, \qquad \sum_{i=1}^{n}w_i=1 \]
1. Formula nimani hisoblaydi? Normallashtirilgan barcha mezonlarning vaznli o‘rtachasini olib, bitta qayta ishlab bo‘lishga tayyorlik skorini hosil qiladi.
2. O‘zgaruvchilar nimalar? \(x_i\), \(i\)-mezonning normallashtirilgan skori; \(w_i\), mezon vazni; \(n\), mezonlar soni. Ushbu tadqiqotda \(n=7\). \(S\), yakuniy WSM skoridir.
3. Birliklar nimalar? Barcha qiymatlar o‘lchovsiz va \(S\in[0,1]\) oralig‘ida.
4. Matematik roli nima? Har bir mezon o‘z ahamiyat vazniga ko‘paytiriladi va yetti hissa jamlanadi.
5. Algoritmik ma’nosi nima? Yuqori vaznli mezonlarda yaxshi natija yakuniy skorga ko‘proq hissa qo‘shadi.
6. Asosiy faraz nima? WSM mezonlar orasida additiv mustaqillikni faraz qiladi. Ya’ni bir mezondagi yaxshi natija boshqa mezondagi zaiflikni matematik ravishda qoplashi mumkin.
7. Natija qanday talqin qilinishi kerak? Manba tadqiqot bu faraz qayta ishlab bo‘lishning haqiqiy mantiqini to‘liq aks ettirmasligi mumkinligini bildiradi. Masalan kod yoki ma’lumot umuman yo‘q bo‘lsa, boshqa mezonlarning kuchli bo‘lishi haqiqiy qayta ishlab olishni mumkin qilmasligi mumkin. Demak WSM shaffof taxminiy skor beradi; mezonlar o‘rtasidagi majburiy bog‘liqliklarni to‘liq modellashtirmaydi.
Tenglama (6): TOPSIS ideal va anti-ideal profillari
\[ v_j^{+}=1, \qquad v_j^{-}=0 \]
1. Formula nimani belgilaydi? TOPSIS uchun har bir mezonning ideal va anti-ideal referens qiymatlarini belgilaydi.
2. O‘zgaruvchilar nimalar? \(v_j^{+}\), \(j\)-mezonning ideal qiymati; \(v_j^{-}\), anti-ideal qiymati.
3. Birliklar nimalar? Normallashtirilgan [0,1] shkalasidagi o‘lchovsiz qiymatlar.
4. Matematik roli nima? Barcha mezonlarda 1 olgan nazariy profil mukammal tayyorlik referensi, barcha mezonlarda 0 olgan profil esa eng yomon referensdir.
5. Algoritmik ma’nosi nima? Haqiqiy maqolaning skor profili shu ikki referensga nisbatan joylashtiriladi.
6. Shart nima? Barcha mezonlar “yuqori qiymat yaxshiroq” yo‘nalishida normallashtirilgan bo‘lishi kerak.
7. Natija qanday talqin qilinishi kerak? Ideal nuqta haqiqiy maqola bo‘lishi shart emas; taqqoslash maqsadida berilgan matematik referens.
Tenglama (7): ideal va anti-ideal profilga masofa
\[ D_i^{+} = \sqrt{ \sum_{j=1}^{n} w_j \left( v_{ij}-v_j^{+} \right)^2 } \]
\[ D_i^{-} = \sqrt{ \sum_{j=1}^{n} w_j \left( v_{ij}-v_j^{-} \right)^2 } \]
1. Formula nimani hisoblaydi? \(i\)-maqola mezon profilining ideal va anti-ideal profillarga vaznli Evklid masofasini hisoblaydi.
2. O‘zgaruvchilar nimalar? \(v_{ij}\), \(i\)-maqolaning \(j\)-mezondagi normallashtirilgan qiymati. \(w_j\), mezon vazni. \(v_j^{+}\) va \(v_j^{-}\) ideal hamda anti-ideal qiymatlar.
3. Birliklar nimalar? Normallashtirilgan mezon fazosidagi o‘lchovsiz masofalar.
4. Matematik roli nima? Har bir mezondagi referens farq kvadratga oshiriladi, vaznga ko‘paytiriladi va yig‘indining kvadrat ildizi olinadi.
5. Algoritmik ma’nosi nima? Kichik \(D_i^{+}\), maqola ideal profilga yaqinligini; katta \(D_i^{-}\), eng yomon profildan uzoqligini ko‘rsatadi.
6. Shart nima? Mezonlar ayni normallashtirilgan fazoda bo‘lishi va vaznlar qaror modelining ustuvorliklarini ifodalashi kerak.
7. Natija qanday talqin qilinishi kerak? Masofalardan biri yolg‘iz yetarli emas; TOPSIS ikkalasini Tenglama (8) orqali nisbiy yaqinlikka aylantiradi.
Tenglama (8): TOPSIS nisbiy yaqinlik skori
\[ C_i = \frac{D_i^{-}} {D_i^{+}+D_i^{-}} \]
1. Formula nimani hisoblaydi? \(i\)-maqolaning ideal profilga nisbiy yaqinligini hisoblaydi.
2. O‘zgaruvchilar nimalar? \(D_i^{+}\) ideal yechimga masofa, \(D_i^{-}\) anti-ideal yechimga masofa.
3. Birliklar nimalar? \(C_i\) o‘lchovsiz va \(0\leq C_i\leq1\) oralig‘ida.
4. Matematik roli nima? Anti-idealdan masofani ikki masofa yig‘indisiga nisbatlab bitta son hosil qiladi.
5. Algoritmik ma’nosi nima? \(C_i\) kattalashgan sari maqola ideal qayta ishlab bo‘lishga tayyorlik profiliga yaqinlashadi.
6. Shart nima? Masofalar ayni mezon fazosi va ayni vaznlar bilan hisoblanishi kerak.
7. Natija qanday talqin qilinishi kerak? \(C_i=0.8\) “ish 80% ehtimol bilan qayta ishlab bo‘ladi” degani emas. Skor berilgan yetti mezon va vazn tizimi ostida ideal profilga nisbiy yaqinlikni ko‘rsatadi.
Asosiy baholash: teng vaznlar
Asosiy baholashda yetti mezonning har biri teng vazn olgan. Shu tariqa natijalar muayyan qaror qabul qiluvchining subyektiv ustuvorliklari tomonidan boshqarilishining oldi olinib, rubrika va mezon tizimining asosiy xatti-harakati tekshirilgan.
WSM va TOPSIS skorlari [0,1] oralig‘ida. Manba tadqiqot 0 dan 1 gacha bo‘lgan qaror chegaralarini 0,1 qadam bilan qo‘lda ko‘rib chiqib, 0,5 chegarasi aniqlik, precision va sezgirlik o‘rtasida eng muvozanatli natijani berganini xabar qilgan.
Referens yorliqqa nisbatan natijalar
139 maqolalik namunada referens yorliq taqsimoti nomutanosib: 102 salbiy va 37 ijobiy maqola mavjud.
| Referens | 0 bashorati | 1 bashorati |
|---|---|---|
| 0 — qayta ishlab bo‘lmaydi yorlig‘i | 63 | 39 |
| 1 — qayta ishlab bo‘ladi yorlig‘i | 11 | 26 |
| Metrika | Qiymat |
|---|---|
| Aniqlik | 0,64 |
| Precision | 0,40 |
| Sezgirlik | 0,70 |
| F1 skori | 0,51 |
Sezgirlikning 0,70 bo‘lishi referens ma’lumotlar to‘plamida qayta ishlab bo‘ladigan deb belgilangan maqolalarning muhim qismi tayyorlik doirasi tomonidan ham aniqlanganini ko‘rsatadi. Precision 0,40 bo‘lishi esa “tayyor” deb tasniflangan maqolalarning muhim qismi referens yorliqda qayta ishlab bo‘lmaydigan ekanini ko‘rsatadi.
Manba bu farqni faqat doiraning muvaffaqiyatsizligi deb talqin qilmaydi. Doira kod, ma’lumot va izohlarning ko‘rinadigan tayyorgarligini baholaydi, referens yorliq esa amaliy qayta ishlab olish natijasini ifodalaydi. Ko‘rinmaydigan muhit muammosi yoki to‘liq bo‘lmagan amalga oshirish kabi to‘siq maqola qog‘ozda tayyor ko‘rinsa ham ishga tushirishda muvaffaqiyatsizlikka olib kelishi mumkin.
Oddiy artefakt qoidalari bilan taqqoslash
| Model | Precision | Sezgirlik | F1 |
|---|---|---|---|
| Faqat kod | 0,27 | 0,62 | 0,38 |
| Faqat ma’lumot | 0,33 | 0,73 | 0,45 |
| Kod YOKI ma’lumot | 0,30 | 0,86 | 0,45 |
| Kod VA ma’lumot | 0,30 | 0,49 | 0,37 |
| WSM/TOPSIS — teng vazn | 0,40 | 0,70 | 0,51 |
“Kod YOKI ma’lumot” qoidasi 0,86 bilan eng yuqori sezgirlikni bersa-da, past precision sababli ko‘plab noto‘g‘ri ijobiy hosil qiladi. Yetti mezonli MCDM yondashuvi eng yuqori F1 skoriga erishib, muvozanatliroq natija beradi.
AHP bilan uchta vaznlash ssenariysi
Manba tadqiqot Analitik Ierarxiya Jarayonini (Analytic Hierarchy Process, AHP) kontekstga qarab mezon vaznlarini chiqarishning amaliy usuli sifatida ko‘rsatgan. Mezonlar taqqoslashlari Saaty’ning 1–9 shkalasi bilan tuzilgan, taqqoslash matritsalari normallashtirilgan va izchillik Consistency Ratio (CR) bilan tekshirilgan.
Manba bu bo‘limda AHP uchun alohida raqamlangan tenglama bermaydi. Shu sababli bu yerda manbada bo‘lmagan AHP formulasi yaratilmagan.
| Mezon | S1: Teng | S2: Ma’lumot va Kod | S3: O‘qitish va O‘qiluvchanlik |
|---|---|---|---|
| Ma’lumotlarning ochiqligi | 0,143 | 0,241 | 0,107 |
| Kodning ochiqligi | 0,143 | 0,241 | 0,107 |
| README | 0,143 | 0,103 | 0,107 |
| O‘qitilgan model | 0,143 | 0,103 | 0,036 |
| Giperparametr bayoni | 0,143 | 0,103 | 0,143 |
| O‘qitish bayoni | 0,143 | 0,103 | 0,250 |
| Maqola o‘qiluvchanligi | 0,143 | 0,103 | 0,250 |
| Jami | 1,000 | 1,000 | 1,000 |
Uch ssenariyning barchasida \(\lambda_{\max}=7.0\) va \(CR=0.0\) xabar qilingan. Ishlatilgan vaznlar haqiqiy manfaatdor tomonlar guruhidan yig‘ilgan afzalliklar emas; turli qaror maqsadlari skorni qanday o‘zgartirishini ko‘rsatish uchun tuzilgan namuna ssenariylardir.
O‘nta namuna maqolada vazn o‘zgarishining ta’siri
| No | Maqola | WSM S1 | WSM S2 | WSM S3 | TOPSIS S1 | TOPSIS S2 | TOPSIS S3 |
|---|---|---|---|---|---|---|---|
| 1 | WTAGRAPH: Web Tracking and Advertising Detection using Graph Neural Networks | 0,286 | 0,207 | 0,446 | 0,277 | 0,210 | 0,490 |
| 2 | DeepSteal: Advanced Model Extractions Leveraging Efficient Weight Stealing in Memories | 0,429 | 0,448 | 0,500 | 0,370 | 0,442 | 0,484 |
| 3 | Model Stealing Attacks Against Inductive Graph Neural Networks | 0,452 | 0,420 | 0,589 | 0,375 | 0,385 | 0,570 |
| 4 | Phishpedia: A Hybrid Deep Learning Based Approach to Visually Identify Phishing Webpages | 0,643 | 0,603 | 0,643 | 0,649 | 0,575 | 0,627 |
| 5 | Cheetah: Lean and Fast Secure Two-Party Deep Neural Network Inference | 0,524 | 0,609 | 0,554 | 0,424 | 0,555 | 0,501 |
| 6 | DEEPCASE: Semi-Supervised Contextual Analysis of Security Events | 0,643 | 0,741 | 0,714 | 0,478 | 0,625 | 0,658 |
| 7 | Khaleesi: Breaker of Advertising and Tracking Request Chains | 0,595 | 0,592 | 0,750 | 0,447 | 0,498 | 0,712 |
| 8 | AI/ML for Network Security: The Emperor Has No Clothes | 0,786 | 0,845 | 0,679 | 0,782 | 0,837 | 0,622 |
| 9 | Improving Password Guessing via Representation Learning | 0,524 | 0,471 | 0,714 | 0,402 | 0,401 | 0,638 |
| 10 | Privacy Risks of Securing Machine Learning Models against Adversarial Examples | 0,595 | 0,661 | 0,696 | 0,431 | 0,549 | 0,611 |
Ma’lumot va kod vazni oshirilgan S2 ssenariysida artefakt ulashishi kuchli bo‘lgan 6, 8 va 10-raqamli maqolalarning WSM skorlari oshgan. Aksincha, 1-raqamli maqolaning WSM skori 0,286 dan 0,207 ga tushgan.
O‘qitish bayoni va o‘qiluvchanlik ustun qo‘yilgan S3 ssenariysida 1, 3, 6, 7 va 9-raqamli maqolalarning WSM skorlari S1 ga nisbatan oshgan. Shunday qilib, vaznlar faqat texnik tafsilot emas, baholash maqsadini bevosita ifodalovchi modellashtirish tanlovi ekani ko‘rinadi.
Monte Carlo sezgirlik va barqarorlik tahlili
AHP vaznlari kichik noaniqliklarga qanchalik sezgirligini tekshirish uchun har bir mezon vazni mustaqil ravishda boshlang‘ich qiymatining ±%20 atrofida o‘zgartirilgan, so‘ng barcha vaznlar yig‘indisi yana 1 bo‘lishi uchun normallashtirilgan.
Har bir ssenariy uchun 500 xil perturbatsiyalangan vazn vektori yaratilgan va har bir vektor bilan WSM ham, TOPSIS ham qayta hisoblangan. Natijalar o‘rtacha va 5–95-persentil oraliqlari bilan baholangan.
| Usul | S1 | S2 | S3 |
|---|---|---|---|
| WSM o‘rtacha variatsiya | 0,091 | 0,089 | 0,083 |
| TOPSIS o‘rtacha variatsiya | 0,114 | 0,116 | 0,127 |
WSM vazn o‘zgarishlariga TOPSISga qaraganda biroz pastroq variatsiya ko‘rsatgan. TOPSISning masofaga asoslangan tuzilishi mezon vaznlaridagi o‘zgarishlarga ko‘proq sezgir bo‘lishi mumkin. Shunga qaramay, har ikki usulda kuzatilgan o‘zgarish [0,1] umumiy skor oralig‘iga nisbatan cheklangan bo‘lib qolgan.
Maqola reytinglarining katta qismi perturbatsiyalar ostida saqlangan. Reytingdagi ancha sezilarli farqlar kichik tasodifiy vazn o‘zgarishlaridan ko‘ra, S1–S2–S3 orasida ataylab o‘zgartirilgan qaror ustuvorliklaridan kelib chiqqani ko‘rsatilgan.
Ilova A: logistika regressiyasi natijalari
| O‘zgaruvchi | Koeffitsiyent | Standart xato | z | p | %95 ishonch oralig‘i |
|---|---|---|---|---|---|
| Doimiy | −2,196 | 0,492 | −4,458 | 0,000 | [−3,161; −1,230] |
| O‘qitilgan modelning taqdim etilishi | 0,882 | 0,330 | 2,670 | 0,008 | [0,235; 1,529] |
| Ma’lumotlarning ochiqligi | 1,106 | 0,510 | 2,167 | 0,030 | [0,106; 2,105] |
Modelning pseudo \(R^2\) qiymati 0,054 va tushuntirish kuchi cheklangan. Bu tahlil bashorat muvaffaqiyatidan ko‘ra talqin qilinuvchanlik uchun ishlatilgan.
| O‘zgaruvchi | Koeffitsiyent | Standart xato | z | p | %95 ishonch oralig‘i |
|---|---|---|---|---|---|
| Doimiy | −1,611 | 0,489 | −3,294 | 0,001 | [−2,570; −0,653] |
| Maqola o‘qiluvchanligi | 2,764 | 0,367 | 7,531 | 0,000 | [2,045; 3,484] |
| Ishlatilgan algoritm qiyinligi | −0,963 | 0,360 | −2,676 | 0,007 | [−1,669; −0,258] |
| Giperparametrlarni ko‘rsatish | 1,183 | 0,402 | 2,942 | 0,003 | [0,395; 1,972] |
Raff ma’lumotlar to‘plamidagi logistika modeli uchun pseudo \(R^2=0.33\) xabar qilingan. O‘qiluvchanlik va giperparametrlarni ko‘rsatish qayta ishlab bo‘ladigan sinf bilan ijobiy; ishlatilgan algoritm qiyinligi esa salbiy bog‘liqlik ko‘rsatgan.
Ilova A: Random Forest va XGBoost tekshiruv samaradorligi
| Ma’lumotlar to‘plami | Model | Aniqlik | 1-sinf precision | 1-sinf sezgirlik | 1-sinf F1 |
|---|---|---|---|---|---|
| Olszewski | Random Forest | 0,65 | 0,40 | 0,50 | 0,44 |
| Olszewski | XGBoost | 0,70 | 0,46 | 0,50 | 0,48 |
| Raff | Random Forest | 0,86 | 0,88 | 0,91 | 0,89 |
| Raff | XGBoost | 0,88 | 0,88 | 0,94 | 0,91 |
Olszewski ma’lumotlar to‘plamida XGBoost Random Forestga nisbatan kichik yaxshilanish bergan, Raff ma’lumotlar to‘plamida esa har ikki daraxt asosidagi model kuchliroq natija ko‘rsatgan. Biroq bu modellarning asosiy vazifasi yakuniy qayta ishlab bo‘lish klassifikatorini yaratish emas, mezonlarni chiqarishni qo‘llab-quvvatlovchi omillarni aniqlashdir.
XGBoost xususiyat ahamiyatlari
| Xususiyat | Normallashtirilgan ahamiyat |
|---|---|
| README mavjudligi | 0,279 |
| Ma’lumotlarning ochiqligi | 0,269 |
| O‘qitilgan model mavjudligi | 0,140 |
| O‘qitish bayoni | 0,116 |
| Giperparametr ko‘rsatish | 0,103 |
| O‘qitish/test ajratilishini ko‘rsatish | 0,090 |
| Tajriba ochiqligi | 0,000 |
Olszewski ma’lumotlar to‘plamida README va ma’lumotlarning ochiqligi eng yuqori normallashtirilgan ahamiyatga ega. Xususiyat-ta’sir tahlilida READMEning qayta ishlab bo‘ladigan sinfga bashorat ta’siri +0,300, o‘qitilgan modelniki +0,190 va ma’lumotlar ochiqliginiki +0,108 deb topilgan.
Raff ma’lumotlar to‘plamida eng ustun xususiyat maqola o‘qiluvchanligi bo‘lgan va normallashtirilgan ahamiyati 0,288. Ma’lumotlarning ochiqligi 0,062; konseptuallashtirish rasmlari soni 0,056; giperparametr ko‘rsatish 0,051; jadval va rasm soni 0,048; kodning ochiqligi 0,043 qiymatga ega. O‘qiluvchanlikning qayta ishlab bo‘ladigan sinfga xususiyat-ta’sir qiymati +0,6198 deb xabar qilingan.
Tadqiqotning asosiy ilmiy xabari
Qayta ishlab bo‘lishni bitta “kod bormi?” savoliga qisqartirish yetarli emas. Haqiqiy qayta ishlab olish jarayoni ma’lumot, kod, o‘qitilgan model, ishga tushirish yo‘riqnomasi, giperparametrlar, o‘qitish tafsilotlari va usul bayonining birgalikda yetarli bo‘lishini talab qilishi mumkin. MCDM yondashuvi ushbu ko‘p o‘lchamli tuzilmani bitta son bilan umumlashtirishga urinadi.
Biroq bitta son har bir kontekst uchun mutlaq emas. Ma’lumot va kod ulashishni ustun qo‘yadigan artefakt baholash qo‘mitasi bilan sezgir ma’lumotlar keng tarqalgan sohada metodologik shaffoflikni ustun qo‘yadigan taqrizchi ayni mezon vaznlarini ishlatishi shart emas. AHP ssenariylarining maqsadi aynan shu kontekstual farqni ko‘rinadigan qilishdir.
Tadqiqot qo‘llab-quvvatlaydigan natijalar
Manba tadqiqot yetti mezonni ordinal tarzda ballab normallashtirish va WSM/TOPSIS bilan birlashtirish tadqiqot maqolasi darajasida qo‘llanadigan va talqin qilinadigan R1 tayyorlik skorini bera olishini ko‘rsatadi.
Asosiy skor referens yorliq bilan o‘rtacha darajada moslik ko‘rsatgan; bitta artefaktga asoslangan oddiy qoidalardan muvozanatliroq F1 samaradorligini bergan. Turli vazn ssenariylari skorlarni kutilgan yo‘nalishda o‘zgartirgan va ±%20 vazn perturbatsiyalari ostida natijalar butunlay beqaror bo‘lib qolmagani ko‘rsatilgan.
Tadqiqot qo‘llab-quvvatlamaydigan natijalar
Yuqori tayyorlik skori haqiqiy tajriba albatta muvaffaqiyatli qayta ishlab chiqilishini anglatmaydi. Doira kodni ishga tushirmagani sababli yashirin bog‘liqliklar, buzilgan amalga oshirish, apparat nomuvofiqligi yoki ochiqlik da’vosi bilan amaliy kirish o‘rtasidagi farqni bevosita tekshirmaydi.
Past tayyorlik skori ham tadqiqot ilmiy jihatdan yomon, ahamiyatsiz yoki noto‘g‘ri ekanini anglatmaydi. Tijoriy, strategik yoki maxfiylik sabablaridan artefaktlarini ulasha olmaydigan yuqori ta’sirli tadqiqotlar past tayyorlik skori olishi mumkin.
Doiraning 0–1 skori qayta ishlab bo‘lish ehtimoli emas va “0,8 ball olgan tadqiqot 80% ehtimol bilan qayta ishlab chiqiladi” deb talqin qilinmasligi kerak.
Cheklovlar
Ma’lumot qamrovi: Olszewski ma’lumotlar to‘plami asosan yuqori darajadagi xavfsizlik konferensiyalarini; Raff ma’lumotlar to‘plami esa katta qismda NeurIPS va ICML ishlarini qamrab oladi. Ushbu sohalardagi ulashish madaniyati mashinaviy o‘rganishning barcha kichik sohalarini ifodalamay qolishi mumkin.
Referens yorliq bilan skor o‘rtasidagi konseptual farq: Tayyorlik skori ko‘rinadigan izoh va artefaktlarni o‘lchaydi, referens yorliq esa haqiqiy qayta ishlab olish natijasiga asoslanishi mumkin. Shu sababli ikki tuzilmaning to‘liq mos kelishi nazariy jihatdan kutilmasligi kerak.
Annotatsiya cheklovi: Inson va ChatGPT annotatsiyalari o‘rtasida yuqori moslik topilganiga qaramay, baholash cheklangan sondagi annotatorlarga tayangan. Ayniqsa o‘qiluvchanlik yoki “qisman to‘liq” hujjatlashtirish kabi sohalarda subyektiv baholash og‘ishi saqlanib qolishi mumkin.
Ordinal rubrika va chiziqli normallashtirish: Tenglama (3) qo‘shni ordinal darajalarni teng masofali deb hisoblaydi. Holbuki ayrim mezonlarda “qisman”dan “to‘liq”ga o‘tishning amaliy foydasi “yo‘q”dan “qisman”ga o‘tishdan katta yoki kichik bo‘lishi mumkin.
Mezon bog‘liqliklari: WSMning kompensatsion additiv tuzilishi qayta ishlab bo‘lishning mantiqiy bog‘liqliklarini to‘liq ifodalamaydi. Kod yoki ma’lumot kabi kritik unsur nol bo‘lsa, ayrim holatlarda boshqa yuqori mezonlar bilan qoplanmasligi mumkin.
Doira qamrovi: Usul yakuniy qayta ishlab bo‘lish sertifikati emas, dastlabki skrining va qiyosiy baholash vositasidir.
Kelajak tadqiqot yo‘nalishlari
Manba tadqiqot kelajakda real ishga tushirish natijalarini o‘z ichiga olgan yangi ma’lumotlar to‘plamlarini yaratishni taklif qiladi. Konteyner ichida qayta ishga tushirish, bog‘liqlik yechimlarini tekshirish va artefakt yaxlitligini sinash kabi ma’lumotlar tayyorlik skori bilan haqiqiy qayta ishlab olish to‘siqlari o‘rtasidagi farqni bevosita o‘lchashga yordam berishi mumkin.
Mezon to‘plami tasodifiylik nazorati, ish muhiti ko‘rsatilishi va baholash sizishi tekshiruvlari kabi qo‘shimcha o‘lchamlar bilan kengaytirilishi mumkin. Ayni doira mezon va rubrikani o‘zgartirish orqali R2 va R3 kabi yuqoriroq qayta ishlab bo‘lish darajalariga ham moslashtirilishi mumkin.
Artefakt havolalari, README to‘liqligi va tuzilmali usul ma’lumotlarini qisman avtomatik chiqarish doirani katta ko‘lamli baholashga mos qilishi mumkin. Biroq subyektiv mezonlar uchun inson ishtirokidagi baholash va ko‘p annotatorli kelishuv ahamiyatini saqlab qoladi.
WSM va TOPSISdan tashqari LINMAP, PROMETHEE va VIKOR kabi turli MCDM oilalarini taqqoslash; annotatsiya va vazn noaniqligini bevosita skor oraliqlariga olib o‘tadigan usullarni ishlab chiqish; shuningdek asosiy mezonlarda minimal shart qo‘llaydigan kompensatsiyasiz baholash mexanizmlaridan foydalanish kelajak tadqiqot yo‘nalishlari qatoridadir.
Umumiy xulosa
Tadqiqot mashinaviy o‘rganish tadqiqotlaridagi qayta ishlab bo‘lish muammosini faqat “kod ulashilganmi?” degan bir o‘lchamli tekshiruvdan chiqarib, ko‘p mezonli qaror muammosi sifatida ko‘radi. Yetti aniq mezonni tartibli rubrika bilan ballash, umumiy shkalaga o‘tkazish va WSM yoki TOPSIS bilan birlashtirish maqolalar o‘rtasida taqqoslanadigan va qaror maqsadiga ko‘ra vaznlanadigan R1 tayyorlik skorini beradi.
Tadqiqotning eng muhim konseptual hissasi skor chegarasini ochiq saqlashidir: tayyorlik va haqiqiy qayta ishlab bo‘lish bog‘liq, ammo ayni tushuncha emas. Maqola barcha zarur izoh va artefaktlarni taqdim etishi mumkin, biroq ishga tushirish bosqichida ko‘rinmaydigan texnik muammolar sabab muvaffaqiyatsiz bo‘lishi mumkin. Aksincha, standart rubrikada ayrim ma’lumotlari yetishmayotgan ko‘ringan ish amalda qayta ishlab bo‘lishi mumkin.
Shu sababli taklif etilgan doiraning eng mos qo‘llanilishi ilmiy sifatni ballaydigan yakuniy reyting tizimi bo‘lish emas; tadqiqot shaffofligi va R1 qayta ishlab bo‘lishga tayyorgarligini tizimli ko‘rib chiqadigan, taqqoslashni yengillashtiradigan va batafsilroq qayta ishlab olish tekshiruviga qaysi ishlar tayyor ko‘rinishini ko‘rsata oladigan qo‘shimcha vosita bo‘lishdir.
Manba va Usul Haqida Izoh
Asl tadqiqot: A MCDM-Based Framework for Quantifying Reproducibility Readiness in Machine Learning Research.
Mualliflar: Paulina Leščinskaitė, Remigijus Paulavičius va Ernestas Filatovas.
Mas’ul muallif: Ernestas Filatovas.
Muassasa: Institute of Data Science and Digital Technologies, Faculty of Mathematics and Informatics, Vilnius University, Akademijos Str. 4, LT-08412 Vilnius, Lithuania.
Jurnal: Mathematics.
Nashriyot: MDPI, Basel, Switzerland.
Bibliografik qayd: Mathematics, 2026, Jild 14, Son 9, Maqola 1536.
DOI: 10.3390/math14091536
Qabul qilingan: 20 Mart 2026.
Tahrir: 23 Aprel 2026.
Qabul: 28 Aprel 2026.
Nashr: 1 May 2026.
Manba turi: Taqrizdan o‘tgan, ochiq kirishli asl tadqiqot maqolasi.
Litsenziya: Creative Commons Attribution (CC BY).
Asosiy usul: Nazariy qayta ishlab bo‘lish tahlili, mavjud ikki ma’lumotlar to‘plamida logistika regressiyasi/Random Forest/XGBoost asosidagi empirik mezon tekshiruvi, yetti mezonli ordinal rubrika, [0,1] normallashtirish, WSM va TOPSIS asosidagi MCDM agregatsiyasi, AHP asosidagi namuna vazn ssenariylari va Monte Carlo vazn sezgirlik tahlili.
Moliyalashtirish
Tadqiqot Litva Tadqiqot Kengashi tomonidan Litva Respublikasi Ta’lim, Fan va Sport Vazirligining “University Excellence Initiatives” dasturi doirasida qo‘llab-quvvatlangan. Manbada ko‘rsatilgan loyiha raqami S-A-UEI-23-11.
Ma’lumot va kod ochiqligi
Mualliflar to‘liq kod bazasi, ma’lumotlar to‘plamlari va ma’lumot/kod fayllarini tushuntiruvchi README hujjati ochiq taqdim etilganini bildiradi. Tadqiqotdagi usul va metrikalar Python 3.13.3 bilan amalga oshirilgan.
Manba kod va ma’lumot repozitoriyasi: GitHub — Quantifying reproducibility of ML papers using MCDM.
Manfaatlar to‘qnashuvi
Mualliflar manfaatlar to‘qnashuvi yo‘qligini bildiradi. Moliyalashtiruvchilarning tadqiqot dizayni, ma’lumot yig‘ish, tahlil, talqin, maqola yozish yoki nashr qarorida roli bo‘lmagani ko‘rsatilgan.
Muallif hissalari
- Konseptuallashtirish: P.L., R.P. va E.F.
- Metodologiya: P.L. va E.F.
- Dasturiy ta’minot: P.L.
- Tekshirish: P.L., R.P. va E.F.
- Formal tahlil: P.L., R.P. va E.F.
- Tadqiqot: P.L., R.P. va E.F.
- Ma’lumotlar kuratsiyasi: P.L.
- Dastlabki qoralama: P.L. va E.F.
- Ko‘rib chiqish va tahrirlash: R.P. va E.F.
- Vizualizatsiya: P.L.
- Nazorat: E.F.
- Loyiha boshqaruvi: R.P.
- Moliyalashtirishni olish: R.P.
Metodologik talqin cheklovi
Ushbu tadqiqot 139 mashinaviy o‘rganish maqolasining asl tajribalarini qayta ishga tushirgan ommaviy qayta ishlab ko‘rish tadqiqoti emas. Taklif qilingan skor ko‘rinadigan artefaktlar va hisobot ma’lumotlari orqali qayta ishlab bo‘lishga tayyorlikni baholaydi. Shu sababli skor va amaliy qayta ishlab olish muvaffaqiyati bir-birining o‘rnida ishlatilishi mumkin emas.
Shuningdek, ishlatilgan ikki manba ma’lumotlar to‘plamining soha qamrovi cheklangan; mezon vaznlari namuna ssenariylarda tadqiqotchilar tomonidan ko‘rsatish maqsadida tuzilgan va haqiqiy manfaatdor tomonlardan olingan afzalliklar emas. Mezonlar to‘plami tasodifiylik, baholash sizishi va hisoblash muhiti determinizmi kabi barcha mumkin bo‘lgan qayta ishlab bo‘lish muammolarini mustaqil mezonlar sifatida o‘z ichiga olmaydi.
Rasmiy nashr havolasi: https://doi.org/10.3390/math14091536
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan