


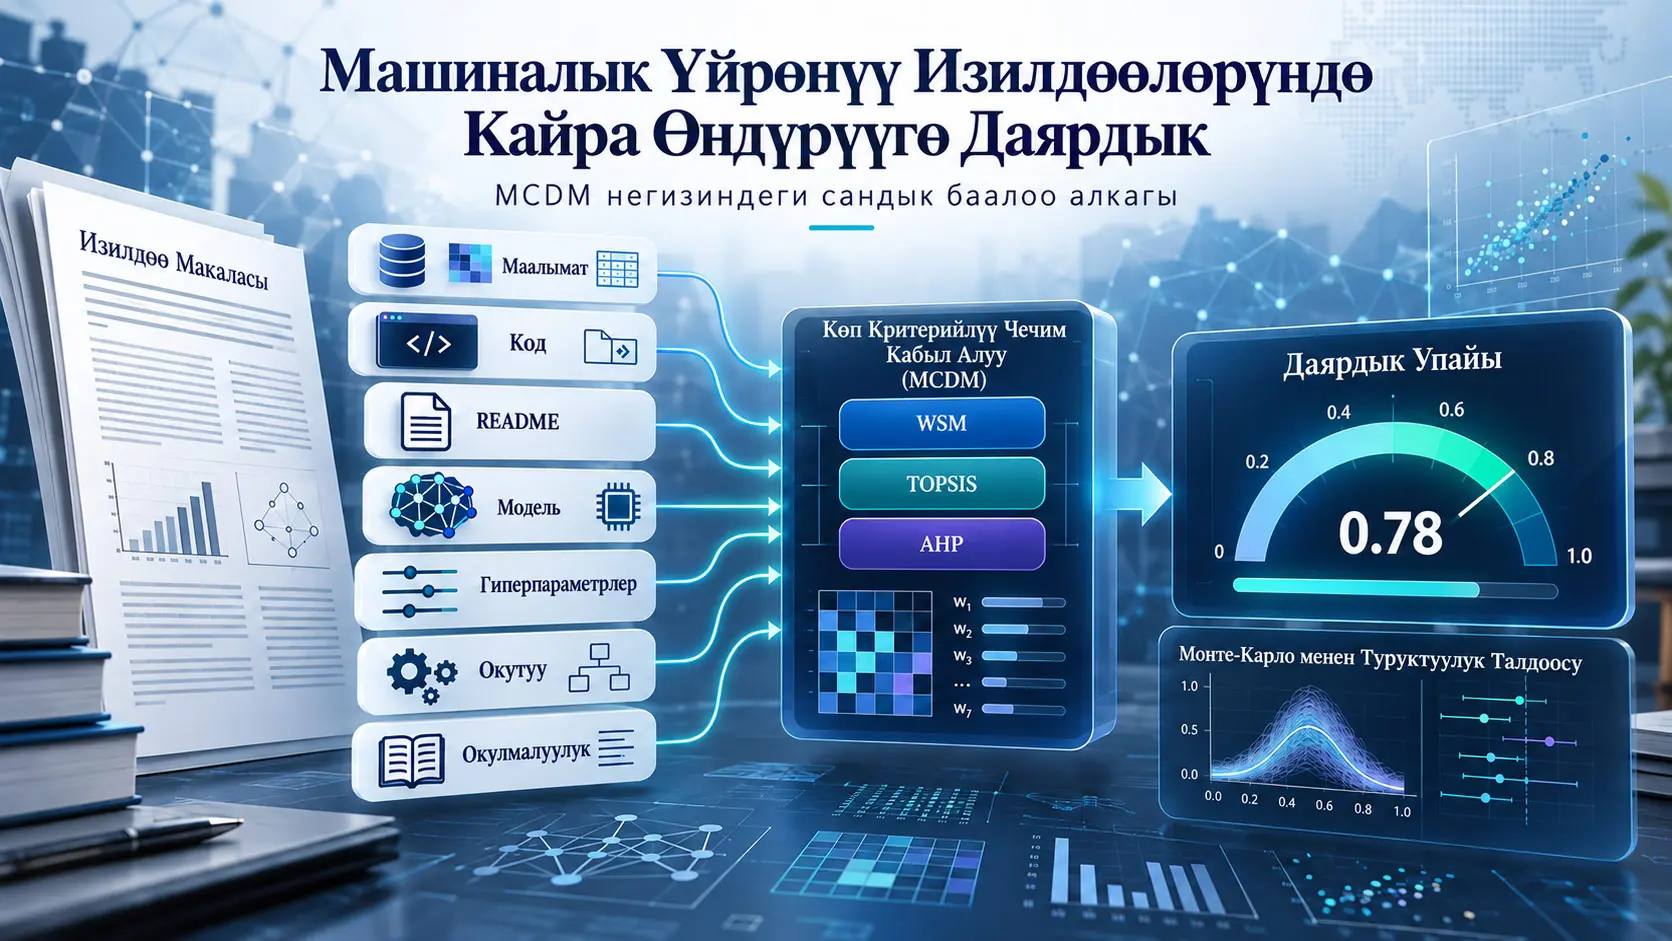
Бул изилдөө машиналык үйрөнүү боюнча изилдөөнүн эксперименттерин кайра иштетпестен, жарыяланган макаланын жана ага байланышкан изилдөө артефакттарынын R1 деңгээлиндеги кайра өндүрүүгө канчалык даяр экенин сандык түрдө өлчөө үчүн Көп Критерийлүү Чечим Кабыл Алуу (Multi-Criteria Decision Making, MCDM) негизиндеги баалоо алкагын сунуштайт. R1 кайра өндүрүүгө даярдык — изилдөө ошол эле маалыматтар, код, модель жана эсептөө чөйрөсү менен ошол эле натыйжаларды кайра алууну колдой турган маалыматтарды, кодду, үйрөтүлгөн моделди жана методологиялык түшүндүрмөлөрдү канчалык деңгээлде сунуштай турганын билдирген баалоо түшүнүгү. Алкак жети критерийди колдонот: маалыматтардын жеткиликтүүлүгү, коддун жеткиликтүүлүгү, READMEнин болушу, үйрөтүлгөн моделдин берилиши, гиперпараметрлердин түшүндүрүлүшү, үйрөтүү процессинин түшүндүрүлүшү жана макаланын окулушу. Критерийлер тартиптик рубрика менен бааланып, [0,1] аралыгына нормалдаштырылат жана Салмакталган Сумма Модели (Weighted Sum Model, WSM) менен Идеалдык Чечимге Окшоштук боюнча Артыкчылыкты Иреттөө Ыкмасы (TOPSIS) аркылуу бирдиктүү даярдык упайына айландырылат.
Алкакты иштеп чыгууда кайра өндүрүлүүчүлүк боюнча эки учурдагы маалымат топтому колдонулган. Негизги баалоо үчүн Olszewski жана авторлошторунун тазаланган 215 макалалык маалымат топтомунан чектелген популяция түзөтүүсү бар Cochran тандоо ыкмасы менен 139 макала кокус тандалган. Ар бир макала жети критерий боюнча изилдөөчүлөр жана ChatGPT тарабынан өз алдынча бааланган; эки баанын орточосу акыркы критерий упайы катары колдонулган. Адам жана модель колдогон баалоолордун ортосундагы салмакталган Cohen kappa орточо көрсөткүчү \(\kappa=0.96\) деп берилген.
Критерийлерге бирдей салмак берилген негизги баалоодо WSM жана TOPSIS бирдей бинардык классификация натыйжасын берген. 0,5 чечим босогосунда алкакты эталондук кайра өндүрүлүүчүлүк энбелгиси менен салыштырганда тактык 0,64, precision 0,40, сезгичтик 0,70 жана F1 упайы 0,51 болгон. Бул натыйжалар алкак кайра өндүрүлө ала турган макалалардын олуттуу бөлүгүн аныктай аларын, бирок “даяр” көрүнгөн айрым макалалар практикалык кайра өндүрүүдө ийгиликсиз болушу мүмкүн экенин да көрсөтөт.
Эң маанилүү чечмелөө чеги: Алынган упай изилдөө чындыгында кайра өндүрүлгөнүн далилдеген жыйынтык эмес. Алкак эксперименттерди иштетпейт; макалада жана ага байланышкан артефакттарда көрүнгөн даярдык деңгээлин өлчөйт. Жашыруун көз карандылыктар, иштебеген скрипттер, аппараттык же программалык шайкешсиздик, детерминисттик эмес GPU операциялары же практикада жеткиликсиз маалыматтар жогорку даярдык упайына карабастан чыныгы кайра өндүрүүгө тоскоол болушу мүмкүн. Ошондой эле төмөн даярдык упайы изилдөөнүн илимий сапаты, жаңычылдыгы же таасири төмөн дегенди билдирбейт.
Машиналык үйрөнүүдө кайра өндүрүлүүчүлүк эмне үчүн өзүнчө көйгөйгө айланууда?
Машиналык үйрөнүү изилдөөлөрүндө жарыяланган натыйжаны кайра алуу макаладагы акыркы тактык, F1 упайы же жоготуу маанисин билүүгө гана байланыштуу эмес. Изилдөөчү кайсы маалыматтарды колдонгону, аларды кантип алдын ала иштеткени, үйрөтүү жана тест бөлүнүштөрү кантип жасалганы, модель архитектурасынын деталдары, гиперпараметрлер, кокустуктун булактары, программалык көз карандылыктар жана үйрөтүү коду чындап иштетиле алабы же жокпу — мунун баары натыйжага таасир этиши мүмкүн.
Булак изилдөө кайра өндүрүлбөгөн натыйжалар илимий жактан эки негизги көйгөй жаратарын белгилейт. Биринчиси — жарыяланган дооматтарды көз карандысыз текшерүүнү татаалдаштырат. Экинчиси — кийинки изилдөөлөр текшерилбеген негизге курулса, убакыт жана изилдөө ресурстары текке кетиши мүмкүн.
Учурдагы чечим аракеттеринин арасында кайра өндүрүлүүчүлүк боюнча текшерүү тизмелери, жарыялоо көрсөтмөлөрү, ачык маалымат жана ачык код саясаттары, код репозиторийлери, контейнерлештирүү жана түзүмдөштүрүлгөн документтештирүү бар. Бирок алардын олуттуу бөлүгү “бар/жок” түрүндөгү бинардык же сапаттык баалоолорду берет. Булак изилдөө чечүүгө аракет кылган боштук — бир изилдөө макаласы үчүн жарым-жартылай шайкештикти да эсепке алган, чечмелене турган жана сандык кайра өндүрүүгө даярдык упайын чыгаруу зарылдыгы.
R1 деңгээлиндеги кайра өндүрүүгө даярдык деген эмне?
R1 деңгээлиндеги кайра өндүрүүгө даярдык — иш ошол эле маалыматтар, ошол эле код, ошол эле модель жана ошол эле эсептөө чөйрөсү менен ошол эле натыйжаларды кайра алууну колдой турган изилдөө артефакттарын жана методологиялык түшүндүрмөлөрдү канчалык деңгээлде камсыз кыларын билдирет; бул изилдөө R1 эксперименттерин иш жүзүндө кайра иштеткендин ордуна, кайра өндүрүүгө көрүнгөн даярдыкты макала жана ага байланышкан артефакттар аркылуу өлчөйт.
R1, R2 жана R3 ортосундагы айырма
| Деңгээл | Негизги логика | Эмне сакталат? | Бул изилдөөнүн чегиндеби? |
|---|---|---|---|
| R1 | Ошол эле натыйжаларды түпнуска артефакттар менен кайра алуу | Ошол эле маалыматтар, код, модель жана эсептөө чөйрөсү | Ооба |
| R2 | Көз карандысыз ишке ашыруу менен кайра өндүрүү | Түпнуска маалыматтар сакталат; ишке ашыруу көз карандысыз болушу мүмкүн | Жок |
| R3 | Башка маалыматтар жана моделдөө ыкмалары менен окшош илимий натыйжага жетүү | Чечмелөө же илимий натыйжа деңгээли | Жок |
R1 тандалышынын негизги себеби — аны объективдүү түрдө салыштырмалуу оңой баалоого болот. R2 жана R3 көз карандысыз ишке ашырууларды жана альтернативдүү маалыматтарды же моделдерди талап кылгандыктан, көп учурда чыныгы кайра өндүрүү эксперименттерин жүргүзүүнү талап кылат. Булак алкак болсо макала деңгээлинде, эксперименттерди кайра иштетпестен колдонууга арналган.
Кайра өндүрүлбөөнүн негизги булактары
Код жана эсептөө чөйрөсү: Код таптакыр бөлүшүлбөсө, жарым-жартылай гана берилсе же көз карандылыктардын версиялары көрсөтүлбөсө, ошол эле операцияларды кайра түзүүгө тоскоол болушу мүмкүн.
Маалыматтардын жеткиликтүүлүгү: Жеке, жабык же жарым-жартылай гана берилген маалымат топтомдору экспериментти кайра жүргүзүүнү түздөн-түз чектеши мүмкүн. Алдын ала иштетүү кадамдары түшүндүрүлбөсө же маалыматтын агып кетиши сыяктуу методологиялык көйгөйлөр болсо, түпнуска натыйжа менен кайра өндүрүүнүн ортосундагы айырма да чоңоюшу мүмкүн.
Кокустук: Салмактарды баштапкы инициализациялоо, тандоо, mini-batch тартиби жана башка стохастикалык компоненттер көзөмөлдөнбөсө, ошол эле код да ар башка натыйжа чыгарышы мүмкүн. Мындан тышкары GPU операциялары, параллелдүүлүк жана калкыма чекит айырмачылыктары айрым чөйрөлөрдө толук детерминисттик иштөөгө тоскоол болушу мүмкүн.
Отчеттуулук: Ийгиликтүү эксперименттерди гана билдирүү, колдонулган статистикаларды так көрсөтпөө, белгисиздиктерди жашыруу же үйрөтүү деталдарын жетишсиз берүү изилдөөнү кайра курууну кыйындатышы мүмкүн.
Эмне үчүн текшерүү тизмеси өз алдынча жетиштүү деп эсептелген эмес?
Көптөгөн текшерүү тизмелеринде “код барбы?”, “маалымат жеткиликтүүбү?” же “гиперпараметрлер түшүндүрүлгөнбү?” сыяктуу пайдалуу суроолор бар. Бирок бинардык белгилөө жарым-жартылай шайкештикти жетиштүү чагылдырбайт. Мисалы, кодду таптакыр бөлүшпөгөн иш менен кодду бөлүшүп, бирок бир бөлүгү жетишпеген иш бирдей “жок” категориясына түшүшү мүмкүн.
Ошондуктан бул изилдөө ordinal, башкача айтканда тартиптик баалоо логикасын колдонот. Мунун аркасында “такыр жок”, “жарым-жартылай бар” жана “жетиштүү толук” деңгээлдер математикалык түрдө айырмаланат.
MCDM бул баалоодо эмне үчүн колдонулат?
Көп Критерийлүү Чечим Кабыл Алуу (MCDM) маалыматтардын жеткиликтүүлүгү, код, документтештирүү, модель артефакты жана методологиялык ачыктык сыяктуу ар башка түрдөгү кайра өндүрүлүүчүлүк көрсөткүчтөрүн жалпы шкалага алып келип, салмактап, бирдиктүү жана чечмелене турган упай чыгарууга мүмкүнчүлүк бергендиктен колдонулат; ошол эле түзүлүш критерий салмактарын баалоо максатына жараша өзгөртүүгө да мүмкүндүк берет.
Алкактын жети негизги критерийи
| Критерий | Эмне бааланат? |
|---|---|
| Маалыматтардын жеткиликтүүлүгү | Макалада колдонулган маалымат топтому жалпыга ачыкпы, жарым-жартылайбы, сезимталбы же суроо-талап боюнча берилеби. |
| Коддун жеткиликтүүлүгү | Эксперименттерди кайра жүргүзүүгө мүмкүндүк бере турган код барбы жана жетиштүү толукпу. |
| READMEнин болушу | Чөйрөнү, көз карандылыктарды жана иштетүү кадамдарын түшүндүргөн колдонуу документтери барбы жана жетиштүүбү. |
| Үйрөтүлгөн моделдин берилиши | Моделди кайра үйрөтпөстөн колдонууга мүмкүндүк берген салмактар же үйрөтүлгөн модель артефакттары барбы. |
| Гиперпараметрлердин түшүндүрүлүшү | Үйрөтүүдө колдонулган негизги гиперпараметрлер канчалык деңгээлде көрсөтүлгөн. |
| Үйрөтүүнүн түшүндүрүлүшү | Алдын ала иштетүү, тандоо, үйрөтүү/тест бөлүнүшү жана үйрөтүү процедурасы канчалык ачык түшүндүрүлгөн. |
| Макаланын окулушу | Методду баяндоонун түзүлүшү, ырааттуулугу жана түшүнүктүүлүгү. |
Бул жети критерий кантип тандалган?
Критерийлерди иштеп чыгуу үч баскычта жүргүзүлгөн. Биринчи баскычта кайра өндүрүлүүчүлүк боюнча адабияттар, учурдагы текшерүү тизмелери жана белгилүү кайра өндүрүлбөө булактары каралган. Бул баскыч маалыматтар, код, үйрөтүлгөн модель жана README сыяктуу иштетилүүчү артефакттарды, ошондой эле үйрөтүү процесси жана гиперпараметрлердин ачыктыгы сыяктуу методологиялык тунуктук компоненттерин камтууну камсыз кылган.
Экинчи баскычта эки учурдагы маалымат топтомунда логистикалык регрессия, Random Forest жана XGBoost колдонулуп, кайра өндүрүлүүчүлүк энбелгиси менен байланышкан факторлор скринингден өткөрүлгөн. Бул моделдер критерийлерди автоматтык жана так тандаган “калыс” катары колдонулган эмес; теориялык тандоону колдогон эмпирикалык далил берген.
Үчүнчү баскычта теориялык жана эмпирикалык далилдер бириктирилип, экспериментти иштетпестен макаладан жана ага байланышкан артефакттардан баалоого боло турган компакттуу жети критерийлик топтом түзүлгөн.
Алкак эмнелерди камтыбайт?
Жети критерий кеңири болгону менен толук бүтүүчү тизме эмес. Автоматтык тесттердин болушу, программалык лицензиялардын шайкештиги, data card сыяктуу түзүмдөштүрүлгөн маалымат документтери, кокустукту көзөмөлдөө, аппараттык/программалык детерминизм жана баалоо агып кетүүсү сыяктуу факторлор өз алдынча критерий катары моделге киргизилген эмес.
Бул факторлордун айрымдары үйрөтүүнү түшүндүрүү же документтештирүүнүн сапаты аркылуу кыйыр түрдө камтылышы мүмкүн; бирок булак изилдөө алардын толук чагылдырылганын ырастабайт.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Колдонулган эки маалымат булагы
| Маалымат топтому | Баштапкы көлөм | Камтуу | Илимий ролу |
|---|---|---|---|
| Olszewski ж.б. | 745 макала | 2013–2022, NDSS, IEEE S&P, CCS жана USENIX; 19 кайра өндүрүлүүчүлүк өзгөчөлүгү жана бинардык макала энбелгиси | Негизги тандоонун жана MCDM баалоосунун негизи |
| Raff | 255 макала | Негизинен NeurIPS жана ICML; 1984–2017; 28 аннотация өзгөчөлүгү | Айрыкча түзүлүш жана окулушу сыяктуу факторлор менен эмпирикалык скринингди байытуу |
Маалыматтарды тазалоо
Olszewski маалымат топтомунда жетишпеген жана аналитикалык жактан пайдалуу эмес жазуулар алынып салынган. Жетишпеген категориялык маанилер жасалма толтурулган эмес; тиешелүү саптар өчүрүлүп, 745 макалалык маалымат 292 макалага азайган. Аталыш, автор, жарыялоо жайынын идентификаторлору жана шилтемелер сыяктуу жалпы критерий баалоого салым кошпогон талаалар, ошондой эле керексиз же таза тексттик өзгөрмөлөр чыгарылган. Сегиз кайра өндүрүлүүчүлүк өзгөчөлүгү сакталган.
Андан кийин кайра өндүрүлүүчүлүк энбелгиси “толук кайра өндүрүлө турган” жана “кайра өндүрүлбөй турган” деп белгиленген макалалар менен гана чектелип, акыркы тазаланган маалымат топтому 215 макаладан турган.
Raff маалымат топтомунда бир жетишпеген маани оңдолуп, өтө сейрек өзгөчөлүк чыгарылган. Жарыялоо жайына жана темага тиешелүү өзгөрмөлөр алынып салынгандан кийин 20 өзгөчөлүк сакталган. Категориялык өзгөрмөлөр бинардык көрсөткүчтөргө айландырылган. Логистикалык регрессияда сандык өзгөчөлүктөр коэффициенттерди салыштыруу үчүн min–max ыкмасы менен [0,1] аралыгына масштабдалган, ал эми дарак негизиндеги моделдерде сандык өзгөрмөлөр масштабдалбай колдонулган.
Эмпирикалык критерий скрининги
Эки маалымат топтому өз-өзүнчө моделдештирилген. Логистикалык регрессия чечмелене турган баштапкы модель, Random Forest жана XGBoost болсо сызыктуу эмес байланыштарды жана өзгөчөлүктөрдүн өз ара аракеттерин кармоо үчүн колдонулган. Эки маалымат топтомунда тең үйрөтүү/тест бөлүнүшү %80/%20 болгон.
Класстардын тең салмаксыздыгы Random Forest үчүн тең салмакталган класс салмактары, XGBoost үчүн болсо scale_pos_weight параметри аркылуу жөнгө салынган.
Теңдеме (1): XGBoost пайдага негизделген өзгөчөлүк маанилүүлүгү
\[ \mathrm{Imp}(j) = \sum_{\text{j özelliğini kullanan bölünmeler}} \Delta L_{\mathrm{split}} \]
1. Формула эмнени эсептейт? XGBoost чечим дарактарында белгилүү \(j\) өзгөчөлүгү колдонулган бөлүнүүлөрдүн модель максат/жоготуу функциясында жараткан жалпы жакшыртуусун эсептейт.
2. Өзгөрмөлөр кайсылар? \(\mathrm{Imp}(j)\) — \(j\) өзгөчөлүгүнүн маанилүүлүгү. \(\Delta L_{\mathrm{split}}\) — ошол өзгөчөлүктү колдонгон белгилүү дарак бөлүнүүсүнүн максат функциясында берген жоготуу азайышы.
3. Бирдиктери кандай? Бул физикалык өлчөм эмес. Чийки маани XGBoost максат функциясындагы жакшыртууга байланышкан алгоритмдик маанилүүлүк чоңдугу. Изилдөөдө маанилүүлүк маанилери салыштыруу үчүн кийин min–max нормалдаштырылган.
4. Математикалык ролу кандай? Бир эле өзгөчөлүк бир нече даракта жана бөлүнүүдө колдонулушу мүмкүн. Формула ушул өзгөчөлүк берген бардык жоготуу азайыштарын кошот.
5. Алгоритмдик мааниси кандай? Чоң \(\mathrm{Imp}(j)\) модель кайра өндүрүлүүчү классты айырмалоодо тиешелүү өзгөчөлүктү пайдалуу тапканын көрсөтөт.
6. Кайсы шартта жарактуу? Бул маанилүүлүк XGBoost модели курган дарактарга, маалымат топтомуна жана үйрөтүү тартибине көз каранды; себептик таасир эмес.
7. Натыйжа кантип чечмелениши керек? Жогорку өзгөчөлүк маанилүүлүгү тиешелүү фактор теориялык жактан сөзсүз кайра өндүрүлүүчүлүк шарты экенин өз алдынча далилдебейт. Булак изилдөө бул маанилерди критерий тандоонун так босогосу эмес, теориялык талдоо менен бирге колдонулган колдоочу далил катары баалаган.
Теңдеме (2): бинардык өзгөчөлүктүн орточо божомол таасири
\[ \Delta_j = \frac{1}{N} \sum_{i=1}^{N} \left[ P\left( y=1 \mid x_j^{(i)}=1,\, x_{-j}^{(i)} \right) - P\left( y=1 \mid x_j^{(i)}=0,\, x_{-j}^{(i)} \right) \right] \]
1. Формула эмнени эсептейт? Бинардык өзгөчөлүктү 0дөн 1ге өзгөрткөндө, калган бардык өзгөчөлүктөр бирдей кармалса, моделдин “кайра өндүрүлө турган” класс үчүн божомол ыктымалдыгы орточо канчалык өзгөрөрүн эсептейт.
2. Өзгөрмөлөр кайсылар? \(N\) — макалалардын саны. \(y=1\) кайра өндүрүлө турган классты көрсөтөт. \(x_j^{(i)}\) — \(i\)-макаладагы каралып жаткан \(j\) өзгөчөлүгү. \(x_{-j}^{(i)}\) — ошол макаладагы башка бардык өзгөчөлүктөр.
3. Бирдиктери кандай? \(\Delta_j\) ыктымалдык айырмасынын шкаласында жана физикалык бирдиги жок.
4. Математикалык ролу кандай? Ар бир макала эки жолу бааланат: тиешелүү өзгөчөлүк шарттуу түрдө 1 жана 0 кылынат. Эки божомолдун айырмасы бардык макалалар боюнча орточолонгон.
5. Алгоритмдик мааниси кандай? Оң \(\Delta_j\) өзгөчөлүктүн болушу моделдин божомолунда кайра өндүрүлө турган класс тарапка жылыш менен байланышканын; терс маани тескери багыттагы божомол өзгөрүшүн көрсөтөт.
6. Кайсы шарттарда жарактуу? Бул маани үйрөтүлгөн божомол моделинин жүрүм-турумун түшүндүрөт. Өзгөчөлүктөрдүн реалдуу дүйнөдөгү себептик таасирин далилдебейт.
7. Натыйжа кантип чечмелениши керек? Өзгөчөлүк таасири XGBoost белгилүү маалымат топтомунда үйрөнгөн байланышты чечмелөө үчүн колдонулган жана критерий тандоо теориялык кайра өндүрүлүүчүлүк билими менен бирге жүргүзүлгөн.
Тандалган тартиптик рубрика
| Критерий | Деңгээл | Мааниси |
|---|---|---|
| Маалыматтардын жеткиликтүүлүгү | 0 | Маалымат топтому жалпыга ачык эмес. |
| 1 | Маалымат сезимтал деп белгиленген. | |
| 2 | Маалымат жарым-жартылай жеткиликтүү же суроо-талап боюнча берилет. | |
| 3 | Маалымат жалпыга ачык. | |
| Коддун жеткиликтүүлүгү | 0 | Код жалпыга ачык эмес. |
| 1 | Код жарым-жартылай бар же толук кайра иштетүүгө тоскоол болгон кемчиликтерди камтыйт. | |
| 2 | Код жалпыга ачык жана жетиштүү толук. | |
| README | 0 | README же колдонуу нускамасы жок. |
| 1 | README бар, бирок маанилүү кадамдар же көз карандылыктар жетишпейт. | |
| 2 | README иш агымын аткарууга жетиштүү толук. | |
| Үйрөтүлгөн модель | 0 | Үйрөтүлгөн модель артефакты берилген эмес. |
| 1 | Үйрөтүлгөн модель артефакты берилген. | |
| Гиперпараметрлер | 0 | Гиперпараметрлер түшүндүрүлгөн эмес. |
| 1 | Жарым-жартылай түшүндүрүлгөн. | |
| 2 | Толук түшүндүрүлгөн. | |
| Үйрөтүүнү түшүндүрүү | 0 | Үйрөтүү/алдын ала иштетүү/бөлүнүштөр түшүндүрүлгөн эмес. |
| 1 | Жарым-жартылай түшүндүрүлгөн. | |
| 2 | Толук түшүндүрүлгөн. | |
| Макаланын окулушу | 0 | Түзүлүш бүдөмүк жана маанилүү метод кадамдарын ээрчүү кыйын. |
| 1 | Жалпы түзүлүш логикалуу, бирок бүдөмүк же ыраатсыз бөлүктөр бар. | |
| 2 | Жакшы уюштурулган, ачык жана метод баяны ырааттуу. |
Теңдеме (3): тартиптик упайды [0,1] аралыгына нормалдаштыруу
\[ x_k = \frac{s_k}{L_k}, \qquad x_k\in[0,1] \]
1. Формула эмнени эсептейт? Ар башка максималдуу деңгээлдери бар критерий упайларын жалпы [0,1] шкаласына айландырат.
2. Өзгөрмөлөр кайсылар? \(s_k\) — \(k\)-критерий үчүн берилген тартиптик упай. \(L_k\) — ошол критерийдин мүмкүн болгон эң жогорку тартиптик деңгээли. \(x_k\) — нормалдаштырылган критерий мааниси.
3. Бирдиктери кандай? \(x_k\) өлчөмсүз.
4. Математикалык ролу кандай? Мисалы, максималдуу деңгээли 3 болгон маалымат жеткиликтүүлүгү менен максималдуу деңгээли 1 болгон үйрөтүлгөн модель критерийин бирдей сандык аралыкта салыштырууга мүмкүндүк берет.
5. Алгоритмдик мааниси кандай? \(x_k=0\) критерий эң төмөн; \(x_k=1\) эң жогорку аныкталган даярдык деңгээлинде экенин көрсөтөт.
6. Божомол кандай? Сызыктуу нормалдаштыруу кошуна тартиптик деңгээлдердин айырмасын тең кадамдар деп эсептейт. Булак изилдөө мунун жөнөкөй жана ачык экенин, бирок чыныгы пайдалуулук өсүшү сөзсүз сызыктуу болбой турганын ачык кабыл алат.
7. Натыйжа кантип чечмелениши керек? Мисалы, \(s_k=2\) жана \(L_k=3\) болсо:
\[ x_k=\frac{2}{3}\approx0.667 \]
Бул “чыныгы кайра өндүрүлүүчүлүк 66,7%” дегенди билдирбейт; болгону тиешелүү критерийде максималдуу тартиптик деңгээлге салыштырмалуу нормалдаштырылган шайкештик даражасы.
Тандоо көлөмү жана аннотация
Тазаланган 215 макалалык Olszewski маалымат топтомунан үлгү алууда булак изилдөө чектелген популяция түзөтүүсү бар Cochran ыкмасын колдонгон. %95 ишеним деңгээли, сактык популяция үлүшү катары p=0,5 жана %5 ката чеги колдонулганда тандоо көлөмү 139 макала деп эсептелген.
Булак макала Cochran эсебинин алгебралык теңдемесин номерленген формула катары бербейт. Ошондуктан бул жерде булакта жок өзүнчө Cochran теңдемеси кошулган эмес.
139 макала жети критерийдин баары боюнча изилдөө авторлору жана ChatGPT тарабынан өз алдынча бааланган.
Теңдеме (4): эки аннотацияны бириктирүү
\[ S_{\mathrm{final}} = \frac{ A_{\mathrm{study}} + A_{\mathrm{ChatGPT}} }{2} \]
1. Формула эмнени эсептейт? Изилдөөчү аннотациясы менен ChatGPT аннотациясынын арифметикалык орточосун алып, критерийдин акыркы упайын түзөт.
2. Өзгөрмөлөр кайсылар? \(A_{\mathrm{study}}\) — изилдөө тобунун критерий упайы; \(A_{\mathrm{ChatGPT}}\) — модель берген критерий упайы.
3. Бирдиктери кандай? Маани тиешелүү критерийдин тартиптик упай шкаласында.
4. Математикалык ролу кандай? Эки баалоочу бирдей салмак менен бириктирилет.
5. Алгоритмдик мааниси кандай? Акыркы упайдын жалгыз адамга же жалгыз LLM баасына гана таянышын алдын алган жөнөкөй бириктирүү операциясы.
6. Шарт кандай? Эки аннотация тең бир критерий жана бир тартиптик рубрика боюнча жасалышы керек.
7. Натыйжа кантип чечмелениши керек? Эки аннотациянын ортосунда өтө жогорку жалпы шайкештик билдирилген: салмакталган Cohen kappa орточосу \(\kappa=0.96\). Бирок окулушу сыяктуу субъективдүү критерийлерде шайкештик салыштырмалуу төмөн жана изилдөө чектелген сандагы аннотациялоочуларды гана колдонгон.
MCDM упайын эсептөө
Нормалдаштыруудан кийин ар бир критерий \(x_i\in[0,1]\) аралыгында. Изилдөө эки өзүнчө, чечмелене турган MCDM топтоо ыкмасын колдонот: WSM жана TOPSIS.
WSM менен TOPSISтин негизги айырмасы эмнеде?
WSM критерий упайларын салмакталган сызыктуу сумма катары бириктирет, ал эми TOPSIS ар бир макаланын критерий профилинин бардык критерийлер эң жакшы болгон идеалдык профилге жана бардык критерийлер эң начар болгон анти-идеалдык профилге чейинки аралыкты өлчөйт; ошондуктан бирдей салмактар колдонулса да эки ыкма күчтүү жана алсыз критерий айкалыштарына ар башка жооп бериши мүмкүн.
Теңдеме (5): Салмакталган Сумма Модели — WSM
\[ S = \sum_{i=1}^{n}w_i x_i, \qquad \sum_{i=1}^{n}w_i=1 \]
1. Формула эмнени эсептейт? Нормалдаштырылган бардык критерийлердин салмакталган орточосун алып, бирдиктүү кайра өндүрүүгө даярдык упайын чыгарат.
2. Өзгөрмөлөр кайсылар? \(x_i\) — \(i\)-критерийдин нормалдаштырылган упайы; \(w_i\) — критерий салмагы; \(n\) — критерийлердин саны. Бул изилдөөдө \(n=7\). \(S\) — акыркы WSM упайы.
3. Бирдиктери кандай? Бардык маанилер өлчөмсүз жана \(S\in[0,1]\) аралыгында.
4. Математикалык ролу кандай? Ар бир критерий өзүнүн маанилүүлүк салмагына көбөйтүлүп, жети салым кошулат.
5. Алгоритмдик мааниси кандай? Жогорку салмактагы критерийлерде жакшы көрсөткүч акыркы упайга көбүрөөк салым кошот.
6. Негизги божомол кандай? WSM критерийлердин ортосунда кошумчалоочу көз карандысыздыкты божомолдойт. Башкача айтканда, бир критерийдеги жакшы көрсөткүч башка критерийдеги алсыздыкты математикалык түрдө компенсациялай алат.
7. Натыйжа кантип чечмелениши керек? Булак изилдөө бул божомол кайра өндүрүлүүчүлүктүн чыныгы логикасын толук чагылдырбай калышы мүмкүн экенин белгилейт. Мисалы, код же маалымат таптакыр жок болсо, башка критерийлердин күчтүү болушу чыныгы кайра өндүрүүнү мүмкүн кылбашы мүмкүн. Демек, WSM ачык болжолдуу упай берет; критерийлердин ортосундагы зарыл көз карандылыктарды толук моделдебейт.
Теңдеме (6): TOPSIS идеалдык жана анти-идеалдык профилдери
\[ v_j^{+}=1, \qquad v_j^{-}=0 \]
1. Формула эмнени аныктайт? TOPSIS үчүн ар бир критерийдин идеалдык жана анти-идеалдык эталон маанилерин аныктайт.
2. Өзгөрмөлөр кайсылар? \(v_j^{+}\) — \(j\)-критерийдин идеалдык мааниси; \(v_j^{-}\) — анти-идеалдык мааниси.
3. Бирдиктери кандай? Нормалдаштырылган [0,1] шкаласындагы өлчөмсүз маанилер.
4. Математикалык ролу кандай? Бардык критерийлерде 1 алган теориялык профиль кемчиликсиз даярдыктын эталону, ал эми бардык критерийлерде 0 алган профиль эң начар эталон.
5. Алгоритмдик мааниси кандай? Реалдуу макаланын упай профили ушул эки эталонго салыштырмалуу жайгаштырылат.
6. Шарт кандай? Бардык критерийлер “маани жогору болсо жакшы” багытында нормалдаштырылышы керек.
7. Натыйжа кантип чечмелениши керек? Идеалдык чекит сөзсүз реалдуу макала болушу шарт эмес; ал салыштыруу үчүн аныкталган математикалык эталон.
Теңдеме (7): идеалдык жана анти-идеалдык профилге аралык
\[ D_i^{+} = \sqrt{ \sum_{j=1}^{n} w_j \left( v_{ij}-v_j^{+} \right)^2 } \]
\[ D_i^{-} = \sqrt{ \sum_{j=1}^{n} w_j \left( v_{ij}-v_j^{-} \right)^2 } \]
1. Формула эмнени эсептейт? \(i\)-макаланын критерий профилинин идеалдык жана анти-идеалдык профилдерге салмакталган Евклид аралыкты эсептейт.
2. Өзгөрмөлөр кайсылар? \(v_{ij}\) — \(i\)-макаланын \(j\)-критерийдеги нормалдаштырылган мааниси. \(w_j\) — критерий салмагы. \(v_j^{+}\) жана \(v_j^{-}\) — идеалдык жана анти-идеалдык маанилер.
3. Бирдиктери кандай? Нормалдаштырылган критерий мейкиндигиндеги өлчөмсүз аралыктар.
4. Математикалык ролу кандай? Ар бир критерийдеги эталон айырмасы квадратка көтөрүлүп, салмакка көбөйтүлөт, сумманын квадраттык түбү алынат.
5. Алгоритмдик мааниси кандай? Кичине \(D_i^{+}\) макала идеалдык профилге жакын экенин; чоң \(D_i^{-}\) эң начар профилден алыс экенин көрсөтөт.
6. Шарт кандай? Критерийлер бир эле нормалдаштырылган мейкиндикте болушу жана салмактар чечим моделинин артыкчылыктарын чагылдырышы керек.
7. Натыйжа кантип чечмелениши керек? Аралыктардын бирөөсү өз алдынча жетишсиз; TOPSIS экөөнү Теңдеме (8) аркылуу салыштырмалуу жакындыкка айлантат.
Теңдеме (8): TOPSIS салыштырмалуу жакындык упайы
\[ C_i = \frac{D_i^{-}} {D_i^{+}+D_i^{-}} \]
1. Формула эмнени эсептейт? \(i\)-макаланын идеалдык профилге салыштырмалуу жакындыгын эсептейт.
2. Өзгөрмөлөр кайсылар? \(D_i^{+}\) — идеалдык чечимге аралык, \(D_i^{-}\) — анти-идеалдык чечимге аралык.
3. Бирдиктери кандай? \(C_i\) өлчөмсүз жана \(0\leq C_i\leq1\) аралыгында.
4. Математикалык ролу кандай? Анти-идеалдан аралыкты эки аралыктын суммасына бөлүп, бир сан чыгарат.
5. Алгоритмдик мааниси кандай? \(C_i\) чоңойгон сайын макала идеалдык кайра өндүрүүгө даярдык профилине жакыныраак болот.
6. Шарт кандай? Аралыктар бир эле критерий мейкиндигинде жана бирдей салмактар менен эсептелиши керек.
7. Натыйжа кантип чечмелениши керек? \(C_i=0.8\) “иш 80% ыктымалдык менен кайра өндүрүлөт” дегенди билдирбейт. Упай аныкталган жети критерий жана салмак системасы шартында идеалдык профилге салыштырмалуу жакындыкты көрсөтөт.
Негизги баалоо: бирдей салмактар
Негизги баалоодо жети критерийдин ар бирине бирдей салмак берилген. Муну менен натыйжалар белгилүү бир чечим кабыл алуучунун субъективдүү артыкчылыктары тарабынан башкарылбай, рубрика менен критерий системасынын базалык жүрүм-туруму изилденген.
WSM жана TOPSIS упайлары [0,1] аралыгында. Булак изилдөө 0 менен 1дин ортосундагы чечим босоголорун 0,1 кадам менен кол менен текшерип, 0,5 босогосу тактык, precision жана сезгичтик ортосунда эң тең салмактуу натыйжа бергенин билдирген.
Эталондук энбелгиге каршы натыйжалар
139 макалалык үлгүдө эталондук энбелги бөлүштүрүлүшү тең салмаксыз: 102 терс жана 37 оң макала бар.
| Эталон | 0 божомолу | 1 божомолу |
|---|---|---|
| 0 — кайра өндүрүлбөйт энбелгиси | 63 | 39 |
| 1 — кайра өндүрүлөт энбелгиси | 11 | 26 |
| Метрика | Маани |
|---|---|
| Тактык | 0,64 |
| Precision | 0,40 |
| Сезгичтик | 0,70 |
| F1 упайы | 0,51 |
Сезгичтиктин 0,70 болушу эталондук маалымат топтомунда кайра өндүрүлө турган деп белгиленген макалалардын олуттуу бөлүгү даярдык алкагы тарабынан да кармалганын көрсөтөт. Precision 0,40 болушу болсо “даяр” деп классификацияланган макалалардын олуттуу бөлүгү эталондук энбелгиде кайра өндүрүлбөй турганын көрсөтөт.
Булак бул айырманы алкактын ийгиликсиздиги катары гана чечмелебейт. Алкак коддун, маалыматтын жана түшүндүрмөлөрдүн көрүнгөн даярдыгын бааласа, эталондук энбелги практикалык кайра өндүрүү натыйжасын билдирет. Көрүнбөгөн чөйрө көйгөйү же толук эмес ишке ашыруу сыяктуу тоскоолдук макала кагаз жүзүндө даяр көрүнсө да иштетүүдө ийгиликсиздикке алып келиши мүмкүн.
Жөнөкөй артефакт эрежелери менен салыштыруу
| Модель | Precision | Сезгичтик | F1 |
|---|---|---|---|
| Код гана | 0,27 | 0,62 | 0,38 |
| Маалымат гана | 0,33 | 0,73 | 0,45 |
| Код ЖЕ маалымат | 0,30 | 0,86 | 0,45 |
| Код ЖАНА маалымат | 0,30 | 0,49 | 0,37 |
| WSM/TOPSIS — бирдей салмак | 0,40 | 0,70 | 0,51 |
“Код ЖЕ маалымат” эрежеси 0,86 менен эң жогорку сезгичтикти бергени менен, төмөн precision себебинен көп жалган оң натыйжа чыгарат. Жети критерийлүү MCDM ыкмасы эң жогорку F1 упайына жетип, тең салмактуу натыйжа берет.
AHP менен үч салмактоо сценарийи
Булак изилдөө Аналитикалык Иерархия Процессин (Analytic Hierarchy Process, AHP) контекстке жараша критерий салмагын чыгаруунун практикалык жолу катары көрсөткөн. Критерий салыштыруулары Saatyнин 1–9 шкаласы менен түзүлгөн, салыштыруу матрицалары нормалдаштырылган жана ырааттуулук Consistency Ratio (CR) менен текшерилген.
Булак бул бөлүмдө AHPнин өзүнчө номерленген теңдемесин бербейт. Ошондуктан бул жерде булакта жок AHP формуласы түзүлгөн эмес.
| Критерий | S1: Бирдей | S2: Маалымат жана Код | S3: Үйрөтүү жана Окулушу |
|---|---|---|---|
| Маалыматтардын жеткиликтүүлүгү | 0,143 | 0,241 | 0,107 |
| Коддун жеткиликтүүлүгү | 0,143 | 0,241 | 0,107 |
| README | 0,143 | 0,103 | 0,107 |
| Үйрөтүлгөн модель | 0,143 | 0,103 | 0,036 |
| Гиперпараметрлерди түшүндүрүү | 0,143 | 0,103 | 0,143 |
| Үйрөтүүнү түшүндүрүү | 0,143 | 0,103 | 0,250 |
| Макаланын окулушу | 0,143 | 0,103 | 0,250 |
| Жалпы | 1,000 | 1,000 | 1,000 |
Үч сценарийде тең \(\lambda_{\max}=7.0\) жана \(CR=0.0\) берилген. Колдонулган салмактар чыныгы кызыкдар тараптар тобунан алынган артыкчылыктар эмес; ар башка чечим максаттары упайды кантип өзгөртөрүн көрсөтүү үчүн түзүлгөн мисал сценарийлер.
Он мисал макалада салмак өзгөрүшүнүн таасири
| No | Макала | WSM S1 | WSM S2 | WSM S3 | TOPSIS S1 | TOPSIS S2 | TOPSIS S3 |
|---|---|---|---|---|---|---|---|
| 1 | WTAGRAPH: Web Tracking and Advertising Detection using Graph Neural Networks | 0,286 | 0,207 | 0,446 | 0,277 | 0,210 | 0,490 |
| 2 | DeepSteal: Advanced Model Extractions Leveraging Efficient Weight Stealing in Memories | 0,429 | 0,448 | 0,500 | 0,370 | 0,442 | 0,484 |
| 3 | Model Stealing Attacks Against Inductive Graph Neural Networks | 0,452 | 0,420 | 0,589 | 0,375 | 0,385 | 0,570 |
| 4 | Phishpedia: A Hybrid Deep Learning Based Approach to Visually Identify Phishing Webpages | 0,643 | 0,603 | 0,643 | 0,649 | 0,575 | 0,627 |
| 5 | Cheetah: Lean and Fast Secure Two-Party Deep Neural Network Inference | 0,524 | 0,609 | 0,554 | 0,424 | 0,555 | 0,501 |
| 6 | DEEPCASE: Semi-Supervised Contextual Analysis of Security Events | 0,643 | 0,741 | 0,714 | 0,478 | 0,625 | 0,658 |
| 7 | Khaleesi: Breaker of Advertising and Tracking Request Chains | 0,595 | 0,592 | 0,750 | 0,447 | 0,498 | 0,712 |
| 8 | AI/ML for Network Security: The Emperor Has No Clothes | 0,786 | 0,845 | 0,679 | 0,782 | 0,837 | 0,622 |
| 9 | Improving Password Guessing via Representation Learning | 0,524 | 0,471 | 0,714 | 0,402 | 0,401 | 0,638 |
| 10 | Privacy Risks of Securing Machine Learning Models against Adversarial Examples | 0,595 | 0,661 | 0,696 | 0,431 | 0,549 | 0,611 |
Маалымат менен коддун салмагы жогорулатылган S2 сценарийинде артефакт бөлүшүүсү күчтүү 6, 8 жана 10 номердүү макалалардын WSM упайлары жогорулаган. Тескерисинче, 1 номердүү макаланын WSM упайы 0,286дан 0,207ге төмөндөгөн.
Үйрөтүүнү түшүндүрүү жана окулушу артыкчылык алган S3 сценарийинде 1, 3, 6, 7 жана 9 номердүү макалалардын WSM упайлары S1ге салыштырмалуу өскөн. Демек, салмактар жөн гана техникалык деталь эмес, баалоонун максатын түздөн-түз чагылдырган моделдөө тандоосу экени көрүнөт.
Monte Carlo сезгичтик жана туруктуулук талдоосу
AHP салмактары кичине белгисиздиктерге канчалык сезгич экенин текшерүү үчүн ар бир критерий салмагы өз алдынча баштапкы маанинин ±%20 айланасында өзгөртүлгөн, андан кийин бардык салмактардын суммасы кайра 1 болушу үчүн нормалдаштырылган.
Ар бир сценарий үчүн 500 ар башка пертурбацияланган салмак вектору түзүлүп, ар бир вектор менен WSM жана TOPSIS упайлары кайра эсептелген. Натыйжалар орточо жана 5–95-процентил аралыктары менен бааланган.
| Ыкма | S1 | S2 | S3 |
|---|---|---|---|
| WSM орточо вариация | 0,091 | 0,089 | 0,083 |
| TOPSIS орточо вариация | 0,114 | 0,116 | 0,127 |
WSM салмак өзгөрүүлөрүнө TOPSISке караганда бир аз төмөн вариация көрсөткөн. TOPSISтин аралыкка негизделген түзүлүшү критерий салмактарындагы өзгөрүүлөргө көбүрөөк сезгич болушу мүмкүн. Бирок эки ыкмада тең байкалган өзгөрүү [0,1] жалпы упай аралыгына салыштырмалуу чектелүү болгон.
Макалалардын рейтингинин чоң бөлүгү пертурбациялар учурунда сакталган. Рейтингдеги олуттуураак айырмачылыктар кичине кокус салмак өзгөрүүлөрүнөн эмес, S1–S2–S3 арасында атайын өзгөртүлгөн чечим артыкчылыктарынан келип чыккан.
Кошумча A: логистикалык регрессия натыйжалары
| Өзгөрмө | Коэффициент | Стандарттык ката | z | p | %95 ишеним аралыгы |
|---|---|---|---|---|---|
| Туруктуу | −2,196 | 0,492 | −4,458 | 0,000 | [−3,161; −1,230] |
| Үйрөтүлгөн моделдин берилиши | 0,882 | 0,330 | 2,670 | 0,008 | [0,235; 1,529] |
| Маалыматтардын жеткиликтүүлүгү | 1,106 | 0,510 | 2,167 | 0,030 | [0,106; 2,105] |
Моделдин pseudo \(R^2\) мааниси 0,054 жана түшүндүрүү күчү чектелүү. Бул талдоо божомол ийгилигинен көбүрөөк чечмеленүү үчүн колдонулган.
| Өзгөрмө | Коэффициент | Стандарттык ката | z | p | %95 ишеним аралыгы |
|---|---|---|---|---|---|
| Туруктуу | −1,611 | 0,489 | −3,294 | 0,001 | [−2,570; −0,653] |
| Макаланын окулушу | 2,764 | 0,367 | 7,531 | 0,000 | [2,045; 3,484] |
| Колдонулган алгоритмдин татаалдыгы | −0,963 | 0,360 | −2,676 | 0,007 | [−1,669; −0,258] |
| Гиперпараметрлерди көрсөтүү | 1,183 | 0,402 | 2,942 | 0,003 | [0,395; 1,972] |
Raff маалымат топтомундагы логистикалык модель үчүн pseudo \(R^2=0.33\) берилген. Окулушу жана гиперпараметрлерди көрсөтүү кайра өндүрүлүүчү класс менен оң, ал эми колдонулган алгоритмдин татаалдыгы терс байланыш көрсөткөн.
Кошумча A: Random Forest жана XGBoost скрининг көрсөткүчтөрү
| Маалымат топтому | Модель | Тактык | 1-класс precision | 1-класс сезгичтик | 1-класс F1 |
|---|---|---|---|---|---|
| Olszewski | Random Forest | 0,65 | 0,40 | 0,50 | 0,44 |
| Olszewski | XGBoost | 0,70 | 0,46 | 0,50 | 0,48 |
| Raff | Random Forest | 0,86 | 0,88 | 0,91 | 0,89 |
| Raff | XGBoost | 0,88 | 0,88 | 0,94 | 0,91 |
Olszewski маалымат топтомунда XGBoost Random Forestка салыштырмалуу кичине жакшыруу берген, Raff маалымат топтомунда болсо эки дарак негизиндеги модель тең күчтүүрөөк натыйжа көрсөткөн. Бирок бул моделдердин негизги милдети акыркы кайра өндүрүлүүчүлүк классификаторун түзүү эмес, критерийлерди чыгарууну колдогон факторлорду аныктоо болгон.
XGBoost өзгөчөлүк маанилүүлүктөрү
| Өзгөчөлүк | Нормалдаштырылган маанилүүлүк |
|---|---|
| READMEнин болушу | 0,279 |
| Маалыматтардын жеткиликтүүлүгү | 0,269 |
| Үйрөтүлгөн моделдин болушу | 0,140 |
| Үйрөтүүнү түшүндүрүү | 0,116 |
| Гиперпараметрлерди көрсөтүү | 0,103 |
| Үйрөтүү/тест бөлүнүшүн көрсөтүү | 0,090 |
| Эксперименттин жеткиликтүүлүгү | 0,000 |
Olszewski маалымат топтомунда README жана маалыматтардын жеткиликтүүлүгү эң жогорку нормалдаштырылган маанилүүлүккө ээ. Өзгөчөлүк-таасир талдоосунда READMEнин кайра өндүрүлүүчү класска божомол таасири +0,300, үйрөтүлгөн моделдики +0,190 жана маалымат жеткиликтүүлүгүнүкү +0,108 болгон.
Raff маалымат топтомунда эң үстөм өзгөчөлүк макаланын окулушу болгон жана нормалдаштырылган маанилүүлүгү 0,288. Маалымат жеткиликтүүлүгү 0,062; концептуалдаштыруу сүрөттөрүнүн саны 0,056; гиперпараметрлерди көрсөтүү 0,051; таблица жана сүрөт саны 0,048; коддун жеткиликтүүлүгү 0,043 мааниге ээ. Окулушунун кайра өндүрүлүүчү класска өзгөчөлүк-таасир мааниси +0,6198 деп берилген.
Изилдөөнүн негизги илимий билдирүүсү
Кайра өндүрүлүүчүлүктү бир гана “код барбы?” суроосуна түшүрүү жетишсиз. Чыныгы кайра өндүрүү процесси маалыматтар, код, үйрөтүлгөн модель, иштетүү нускамасы, гиперпараметрлер, үйрөтүү деталдары жана метод баянынын чогуу жетиштүү болушун талап кылышы мүмкүн. MCDM ыкмасы ушул көп өлчөмдүү түзүлүштү бир санга жыйынтыктоого аракет кылат.
Бирок бир сан ар бир контекст үчүн абсолюттук эмес. Маалымат менен код бөлүшүүнү артык көргөн артефакт баалоо комитети менен сезимтал маалыматтар кеңири тараган тармакта методологиялык ачыктыкты артык көргөн рецензент бирдей критерий салмактарын колдонууга милдеттүү эмес. AHP сценарийлеринин максаты дал ушул контексттик айырманы көрүнүктүү кылуу.
Изилдөө колдогон жыйынтыктар
Булак изилдөө жети критерийди тартиптик түрдө баалап, нормалдаштырып жана WSM/TOPSIS менен бириктирүү изилдөө макаласы деңгээлинде колдонулуучу жана чечмелене турган R1 даярдык упайын бере аларын көрсөтөт.
Негизги упай эталондук энбелги менен орточо деңгээлде шайкештик көрсөткөн; бир артефактка негизделген жөнөкөй эрежелерге караганда тең салмактуураак F1 көрсөткүчүн берген. Ар башка салмак сценарийлери упайларды күтүлгөн багытта өзгөрткөн жана ±%20 салмак пертурбацияларында натыйжалар толугу менен туруксуз болуп калбаганы көрүнгөн.
Изилдөө колдобогон жыйынтыктар
Жогорку даярдык упайы чыныгы эксперимент сөзсүз ийгиликтүү кайра өндүрүлөт дегенди билдирбейт. Алкак кодду иштетпегендиктен жашыруун көз карандылыктарды, бузулган ишке ашырууну, аппараттык шайкешсиздикти же жеткиликтүүлүк дооматы менен практикалык жеткиликтүүлүктүн айырмасын түздөн-түз текшербейт.
Төмөн даярдык упайы да изилдөө илимий жактан начар, маанисиз же туура эмес дегенди билдирбейт. Коммерциялык, стратегиялык же купуялык себептеринен артефакттарын бөлүшө албаган таасирдүү изилдөөлөр төмөн даярдык упайын алышы мүмкүн.
Алкактын 0–1 упайы кайра өндүрүлүүчүлүк ыктымалдыгы эмес жана “0,8 упай алган изилдөө 80% ыктымалдык менен кайра өндүрүлөт” деп чечмеленбеши керек.
Чектөөлөр
Маалымат камтуусу: Olszewski маалымат топтому негизинен жогорку деңгээлдеги коопсуздук конференцияларын; Raff маалымат топтому болсо көбүнчө NeurIPS жана ICML иштерин камтыйт. Бул тармактардагы бөлүшүү маданияты машиналык үйрөнүүнүн бардык чакан тармактарын чагылдырбашы мүмкүн.
Эталондук энбелги менен упайдын концептуалдык айырмасы: Даярдык упайы көрүнгөн түшүндүрмөлөрдү жана артефакттарды өлчөйт, эталондук энбелги болсо чыныгы кайра өндүрүү натыйжасына негизделиши мүмкүн. Ошондуктан эки түзүлүш толук дал келет деп теориялык жактан күтүлбөшү керек.
Аннотация чектөөсү: Адам жана ChatGPT аннотацияларынын ортосунда жогорку шайкештик табылганына карабастан, баалоо чектелген сандагы аннотациялоочуларга таянган. Айрыкча окулушу же “жарым-жартылай толук” документтештирүү сыяктуу тармактарда субъективдүү баалоо кыйшайышы калышы мүмкүн.
Тартиптик рубрика жана сызыктуу нормалдаштыруу: Теңдеме (3) кошуна тартиптик деңгээлдерди бирдей аралыкта деп кабыл алат. Бирок айрым критерийлерде “жарым-жартылай” деңгээлден “толук” деңгээлге өтүүнүн практикалык пайдасы “жок”тон “жарым-жартылай”га өтүүдөн чоң же кичине болушу мүмкүн.
Критерийлердин көз карандылыгы: WSMнин компенсациялоочу кошумчалоочу түзүлүшү кайра өндүрүлүүчүлүктүн логикалык көз карандылыктарын толук чагылдырбайт. Код же маалымат сыяктуу критикалык элемент нөл болсо, айрым шарттарда башка жогорку критерийлер менен компенсацияланбай калышы мүмкүн.
Алкактын чеги: Ыкма акыркы кайра өндүрүлүүчүлүк сертификаты эмес, баштапкы скрининг жана салыштырмалуу баалоо куралы.
Келечектеги изилдөө багыттары
Булак изилдөө келечекте чыныгы иштетүү натыйжаларын камтыган жаңы маалымат топтомдорун түзүүнү сунуштайт. Контейнер ичинде кайра иштетүү, көз карандылыктарды чечүүнү текшерүү жана артефакт бүтүндүгүн сыноо сыяктуу маалыматтар даярдык упайы менен чыныгы кайра өндүрүү тоскоолдуктарынын айырмасын түздөн-түз өлчөөгө мүмкүндүк берет.
Критерий топтому кокустукту көзөмөлдөө, иштөө чөйрөсүн көрсөтүү жана баалоо агып кетүүсүн текшерүү сыяктуу кошумча өлчөмдөр менен кеңейтиле алат. Ошол эле алкак критерий менен рубриканы өзгөртүү аркылуу R2 жана R3 сыяктуу жогорку кайра өндүрүлүүчүлүк деңгээлдерине да ылайыкташтырылышы мүмкүн.
Артефакт шилтемелерин, README толуктугун жана түзүмдөштүрүлгөн метод маалыматтарын жарым-жартылай автоматтык чыгаруу алкакты чоң масштабдуу баалоого ылайык кылышы мүмкүн. Бирок субъективдүү критерийлер үчүн адам катышкан баалоо жана көп аннотациялоочунун макулдашуусу маанисин сактайт.
WSM жана TOPSISтен тышкары LINMAP, PROMETHEE жана VIKOR сыяктуу башка MCDM үй-бүлөлөрүн салыштыруу; аннотация жана салмак белгисиздигин түздөн-түз упай аралыктарына өткөргөн ыкмаларды иштеп чыгуу; ошондой эле негизги критерийлерде минималдуу шарт колдонгон компенсацияланбаган баалоо механизмдерин пайдалануу келечектеги изилдөө багыттарынын арасында.
Жалпы жыйынтык
Изилдөө машиналык үйрөнүү изилдөөлөрүндөгү кайра өндүрүлүүчүлүк көйгөйүн бир гана “код бөлүшүлдүбү?” деген бир өлчөмдүү текшерүүдөн чыгарып, көп критерийлүү чечим көйгөйү катары карайт. Жети ачык критерийди тартиптик рубрика менен баалоо, жалпы шкалага айландыруу жана WSM же TOPSIS менен бириктирүү макалаларды салыштырууга мүмкүн болгон жана чечим максатына жараша салмакталуучу R1 даярдык упайын берет.
Изилдөөнүн эң маанилүү концептуалдык салымы — упайдын чегин ачык калтыруу: даярдык жана чыныгы кайра өндүрүлүүчүлүк байланыштуу, бирок бир эле түшүнүк эмес. Макала керектүү бардык түшүндүрмөлөрдү жана артефакттарды сунушташы мүмкүн, бирок иштетүү баскычында көрүнбөгөн техникалык көйгөйлөрдөн улам ийгиликсиз болушу мүмкүн. Тескерисинче, стандарттык рубрикада айрым маалыматтары жетишпей көрүнгөн иш практикада кайра өндүрүлүшү мүмкүн.
Ошондуктан сунушталган алкактын эң ылайыктуу колдонулушу илимий сапатты баалаган акыркы рейтинг системасы болуу эмес; изилдөө ачыктыгын жана R1 кайра өндүрүүгө даярдыгын системалуу караган, салыштырууну жеңилдеткен жана деталдуу кайра өндүрүү текшерүүсүнө кайсы иштер даяр көрүнөрүн көрсөтө алган кошумча курал болуу.
Булак жана Ыкма Жөнүндө Эскертүү
Түпнуска изилдөө: A MCDM-Based Framework for Quantifying Reproducibility Readiness in Machine Learning Research.
Авторлор: Paulina Leščinskaitė, Remigijus Paulavičius жана Ernestas Filatovas.
Жооптуу автор: Ernestas Filatovas.
Мекеме: Institute of Data Science and Digital Technologies, Faculty of Mathematics and Informatics, Vilnius University, Akademijos Str. 4, LT-08412 Vilnius, Lithuania.
Журнал: Mathematics.
Басмакана: MDPI, Basel, Switzerland.
Библиографиялык жазуу: Mathematics, 2026, Том 14, Сан 9, Макала 1536.
DOI: 10.3390/math14091536
Келип түшкөн: 20 Март 2026.
Кайра кароо: 23 Апрель 2026.
Кабыл алынган: 28 Апрель 2026.
Жарыяланган: 1 Май 2026.
Булак түрү: Рецензияланган, ачык жеткиликтүү түпнуска изилдөө макаласы.
Лицензия: Creative Commons Attribution (CC BY).
Негизги ыкма: Теориялык кайра өндүрүлүүчүлүк талдоосу, эки учурдагы маалымат топтомунда логистикалык регрессия/Random Forest/XGBoost негизиндеги эмпирикалык критерий скрининги, жети критерийлүү тартиптик рубрика, [0,1] нормалдаштыруу, WSM жана TOPSIS негизиндеги MCDM топтоосу, AHP негизиндеги мисал салмак сценарийлери жана Monte Carlo салмак сезгичтик талдоосу.
Каржылоо
Изилдөө Литва Изилдөө Кеңеши тарабынан Литва Республикасынын Билим берүү, Илим жана Спорт министрлигинин “University Excellence Initiatives” программасынын алкагында колдоого алынган. Булакта көрсөтүлгөн долбоор номери S-A-UEI-23-11.
Маалымат жана код жеткиликтүүлүгү
Авторлор толук код базасы, маалымат топтомдору жана маалымат/код файлдарын түшүндүргөн README документи ачык берилгенин билдиришет. Изилдөөдөгү ыкма жана метрикалар Python 3.13.3 менен ишке ашырылган.
Булак код жана маалымат репозиторийи: GitHub — Quantifying reproducibility of ML papers using MCDM.
Кызыкчылыктардын кагылышы
Авторлор кызыкчылыктардын кагылышы жок экенин билдиришет. Каржылоочу тараптардын изилдөөнүн дизайнына, маалымат чогултууга, талдоого, чечмелөөгө, макала жазууга же жарыялоо чечимине катышпаганы көрсөтүлгөн.
Авторлордун салымы
- Концептуалдаштыруу: P.L., R.P. жана E.F.
- Методология: P.L. жана E.F.
- Программалык камсыздоо: P.L.
- Текшерүү: P.L., R.P. жана E.F.
- Формалдык талдоо: P.L., R.P. жана E.F.
- Изилдөө: P.L., R.P. жана E.F.
- Маалыматтарды курациялоо: P.L.
- Алгачкы долбоор: P.L. жана E.F.
- Кароо жана редакциялоо: R.P. жана E.F.
- Визуалдаштыруу: P.L.
- Көзөмөл: E.F.
- Долбоорду башкаруу: R.P.
- Каржылоону алуу: R.P.
Методологиялык чечмелөө чеги
Бул изилдөө 139 машиналык үйрөнүү макаласынын түпнуска эксперименттерин кайра жүргүзгөн массалык кайра өндүрүү изилдөөсү эмес. Сунушталган упай көрүнгөн артефакттар жана отчет маалыматтары аркылуу кайра өндүрүүгө даярдыкты баалайт. Ошондуктан упай менен практикалык кайра өндүрүү ийгилигин бири-биринин ордуна колдонууга болбойт.
Мындан тышкары, колдонулган эки булак маалымат топтомунун тармактык камтуусу чектелүү; критерий салмактары мисал сценарийлерде изилдөөчүлөр тарабынан көрсөтүү максатында түзүлгөн жана чыныгы кызыкдар тараптардан алынган артыкчылыктар эмес. Критерий топтому кокустук, баалоо агып кетүүсү жана эсептөө чөйрөсүнүн детерминизми сыяктуу бардык мүмкүн болгон кайра өндүрүлүүчүлүк көйгөйлөрүн өз алдынча критерий катары камтыбайт.
Расмий жарыя шилтемеси: https://doi.org/10.3390/math14091536
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген