

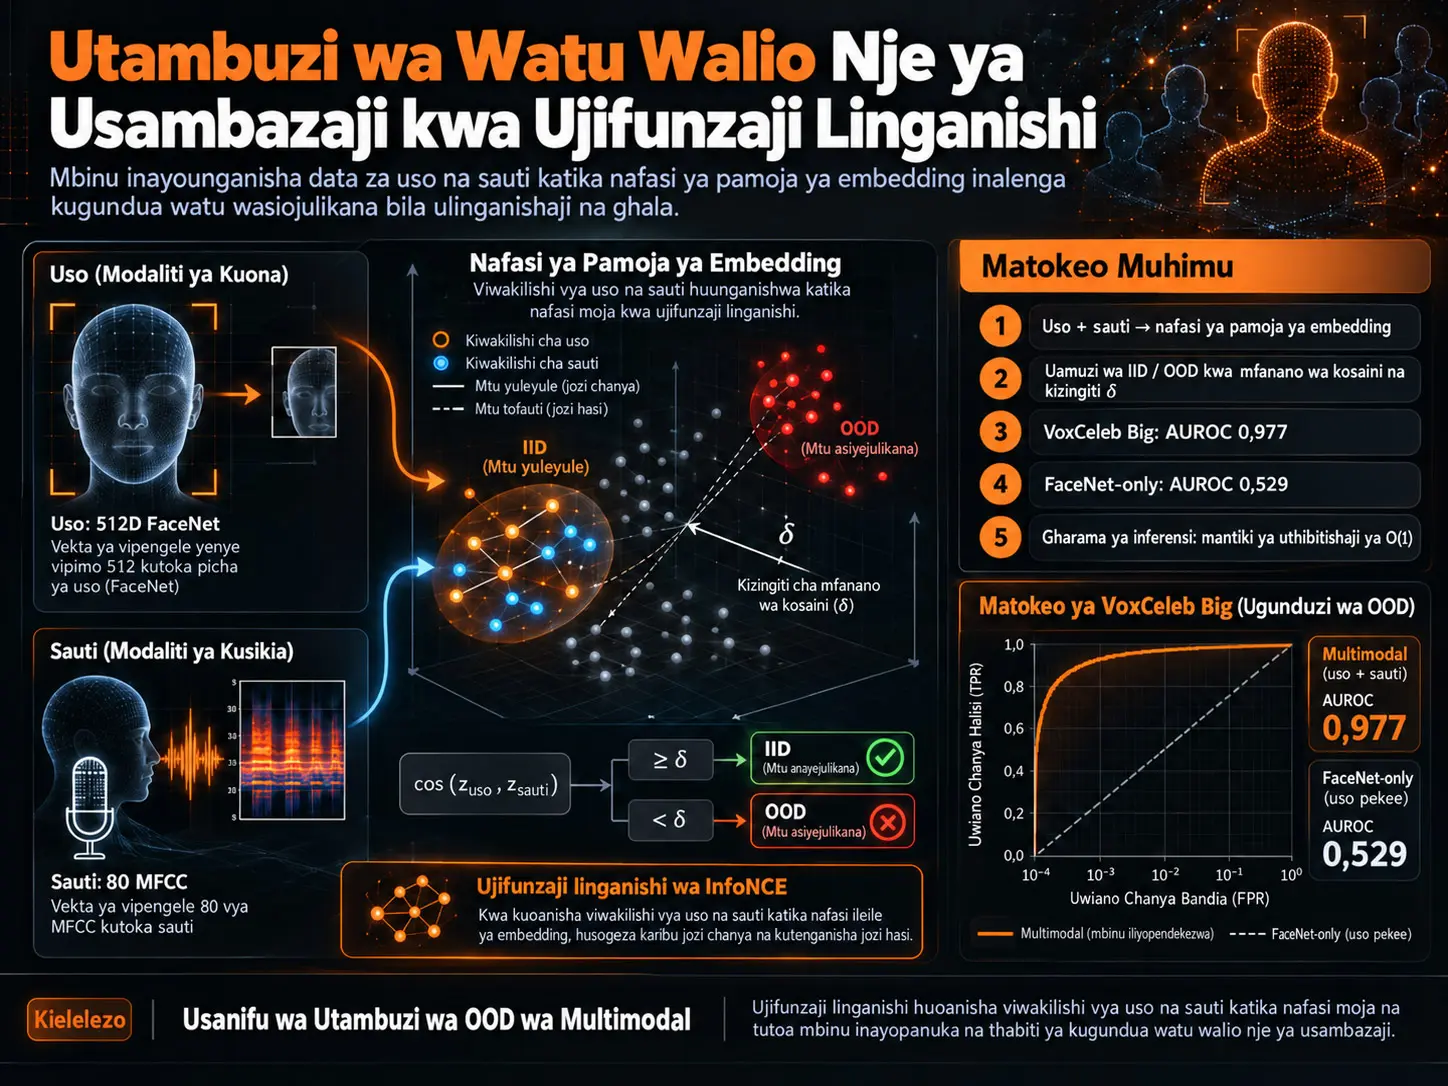
Mtu aliye nje ya usambazaji (out-of-distribution, OOD) ni mtu ambaye hajawahi kuonekana na ambaye yuko nje ya usambazaji wa utambulisho uliojifunzwa na mfumo wa utambuzi wa watu wakati wa mafunzo. Sampuli kama hiyo inapoingia katika mifumo ya kawaida ya utambuzi wa seti funge, modeli inaweza kumlazimisha mtu asiyejulikana kuingizwa katika mojawapo ya madarasa yaliyopo. Mbinu iliyotengenezwa na Sergio Garcia, Francisco Gomez-Donoso na Miguel Cazorla, badala ya kutatua tatizo hili kwa kutumia uso pekee au sauti pekee, hupima kiwango ambacho modaliti mbili za kibayometriki zinaendana.
Modeli hutoa vekta ya vipengele yenye vipimo 512 kutoka katika picha ya uso kupitia FaceNet, na vipengele 80 vya Mel-Frequency Cepstral Coefficient (MFCC) kutoka katika rekodi ya sauti. Matawi mawili tofauti ya mtandao wa neva huprojeta viwakilishi hivi katika nafasi ya pamoja ya embedding yenye vipimo 1200. Wakati wa mafunzo, upotevu linganishi unaotegemea InfoNCE husogeza karibu jozi za uso-sauti za mtu yuleyule huku ukitenganisha jozi za watu tofauti.
Wakati wa inferensi, mtu wa karibu zaidi hatafutwi ndani ya ghala la utambulisho. Badala yake, mfanano wa kosaini kati ya embedding ya uso na embedding ya sauti hupimwa. Ikiwa thamani iko chini ya kizingiti kilichowekwa cha \(\delta\), jozi huainishwa kama OOD; ikiwa iko juu ya kizingiti, huainishwa kuwa ndani ya usambazaji.
Katika majaribio yanayotegemea Custom, LombardGrid na VoxCeleb, mbinu hii imetoa matokeo thabiti zaidi kuliko ulinganisho wa FaceNet-only, hasa idadi ya utambulisho inapoongezeka. Katika jaribio la VoxCeleb Big, thamani ya AUROC ya mbinu ya multimodal ilikuwa 0,977, ilhali thamani ya ulinganisho wa FaceNet-only ilikuwa 0,529. Hata hivyo, matokeo si ulinganisho mpana wa state-of-the-art dhidi ya mbinu zote za utambuzi wa watu za multimodal, na uthibitishaji wa kimaadili na kiutendaji wa modeli kwa kiwango kikubwa katika ulimwengu halisi umeachwa kuwa kazi ya baadaye.
Tatizo la mtu aliye nje ya usambazaji ni nini?
Ikiwa mtandao wa neva umeundwa kuchagua tu miongoni mwa madarasa uliyoyaona wakati wa mafunzo, unaweza pia kuhusisha utambulisho ambao haujawahi kukutana nao na mojawapo ya madarasa yanayojulikana. Modeli kutoa uhakika wa juu huenda kusimaanishe kwamba mtu huyo ametambuliwa kweli.
Tatizo hili ni muhimu hasa katika mifumo ya utambuzi wa watu. Uwezo wa mfumo kusema “mtu huyu si mmoja wa watu niliowaona wakati wa mafunzo” ni uwezo tofauti na ule wa kufanya uainishaji sahihi pekee.
Makala yanashughulikia tatizo hili kwa kutumia pamoja modaliti mbili tofauti za kibayometriki: uso na sauti.
Uso na Sauti kwa Pamoja Huwezeshaje Ugunduzi wa OOD?
Dhana ya msingi ya mfumo uliopendekezwa ni kwamba viwakilishi vya uso na sauti vya mtu yuleyule vinaweza kuoanisha katika nafasi ya pamoja fiche baada ya mafunzo linganishi. Badala ya kujaribu “kupata utambulisho wa mtu ndani ya ghala”, modeli huuliza ikiwa uso na sauti zinaendana vya kutosha katika nafasi ya viwakilishi iliyojifunzwa ili kuwa za utambulisho uleule.
Upande wa uso: FaceNet
Picha za uso hazipelekwi moja kwa moja kwenye mtandao linganishi uliopendekezwa kama pikseli ghafi. Kwanza huchakatwa na FaceNet na embedding ya uso yenye vipimo 512 huundwa kwa kila picha.
Kiwakilishi hiki hutumiwa kusimba vipengele bainifu vya uso katika nafasi ya metriki iliyobanwa. Kisha vekta yenye vipimo 512 huhamishiwa kwenye tawi la uso la mtandao wa multimodal uliopendekezwa.
Upande wa sauti: MFCC
Mel-Frequency Cepstral Coefficients zimetumiwa kwa data ya sauti. Vipengele 80 vya MFCC vimetolewa kutoka katika kila kipande cha sauti.
Kabla ya utoaji wa MFCC, amplitudo ya sauti ilisawazishwa hadi thamani lengwa ya 0,03 kwa linear gain normalization. Waandishi wanabainisha wazi kuwa hii si RMS wala peak normalization. Lengo ni kupunguza ubadilifu usio wa lazima katika vipengele vya spektra unaosababishwa na tofauti za kiwango cha sauti katika rekodi.
Modaliti mbili hukutana katika nafasi ya pamoja
Matawi ya uso na sauti hutumia miundo inayofanana yenye tabaka nyingi. Mwishoni mwa kila tawi, kiwakilishi huprojetiwa katika nafasi ya pamoja ya embedding yenye vipimo 1200.
| Tawi | Ingizo | Tabaka za kati | Tokeo |
|---|---|---|---|
| Uso | 512D FaceNet embedding | 1024 → 512 → 256 | 1200D embedding |
| Sauti | Vipengele 80 vya MFCC | 1024 → 512 → 256 | 1200D embedding |
Kila bloku ya kati ina vipengele vya Linear, BatchNorm1d, ReLU na Dropout. Chanzo kimeripoti jumla ya vigezo 2.544.480 vinavyoweza kufunzwa kwa modeli.
Ujifunzaji Linganishi Unajifunza Nini Hapa?
Ujifunzaji linganishi unalenga kusogeza karibu jozi za uso-sauti za mtu yuleyule katika nafasi ya embedding huku ukitenganisha jozi za watu tofauti. Kwa namna hii, badala ya kukariri lebo ya darasa, mfumo hujaribu kujifunza ulinganifu wa utambulisho kati ya modaliti mbili tofauti.
Jozi chanya na hasi
Uso \(f_i\) na sauti \(a_i\) za mtu yuleyule huunda jozi chanya.
Uso \(f_i\) na sauti \(a_j\) za watu tofauti, wakati \(i \neq j\), huunda jozi hasi.
Chanzo kinaonyesha kuwa michanganyiko 1600 ya uoanishaji chanya inaweza kuundwa kwa mtu mmoja mwenye sampuli 40 za uso na sampuli 40 za sauti. Kwa mfano, katika hali ya watu 50, jumla ya jozi chanya 80.000 na jozi hasi zinazowezekana 3.920.000 hukokotolewa. Sehemu hii ni mfano wa kimetodolojia wa michanganyiko; haimaanishi kwamba seti zote za data zilizotumiwa kwa kweli zina watu 50.
Upotevu wa InfoNCE
Upotevu linganishi uliotumiwa katika mafunzo ni:
\[ L_{\text{contrastive}} = -\frac{1}{N} \sum_{i=1}^{N} \log \frac{ \exp(sim(z_{f_i},z_{a_i})/\tau) }{ \sum_{j=1}^{N} \exp(sim(z_{f_i},z_{a_j})/\tau) } \]
katika umbo hili.
Hapa \(z_f\) inawakilisha embedding ya uso, \(z_a\) embedding ya sauti, \(N\) ukubwa wa batch, na \(\tau\) kigezo cha halijoto.
Kipimo cha mfanano ni mfanano wa kosaini:
\[ sim(z_f,z_a) = \frac{z_f \cdot z_a} {\|z_f\|\|z_a\|} \]
Vigezo vya mafunzo vinajumuisha 50 epoch, batch size sawa na idadi ya madarasa, 0,0005 learning rate na thamani ya halijoto ya \(\tau=0,05\).
Mfumo Hufanyaje Uamuzi Kuhusu Mtu Asiyejulikana?
Wakati wa inferensi, embedding mbili za jozi ya uso-sauti huzalishwa na mfanano wa kosaini kati yake hukokotolewa. Katika chanzo, uamuzi wa OOD umefafanuliwa kama ifuatavyo:
\[ OOD(z_f,z_a)= \begin{cases} 1, & sim(z_f,z_a)<\delta \\ 0, & \text{aksi halde} \end{cases} \]
\(\delta\) ni kizingiti cha uamuzi.
Katika chanzo, kizingiti cha awali kiliundwa kwa njia ya kijaribio kwa kutumia nusu ya wastani wa mfanano wa jozi chanya katika mafunzo. Hata hivyo, waandishi hawawasilishi thamani hii kama kigezo thabiti cha modeli kilichoboreshwa. Katika majaribio, safu pana ya threshold ilichunguzwa, na unyeti wa mbinu katika sehemu tofauti za utendaji ukachambuliwa pia.
Jambo muhimu: “mtu ambaye hajaonekana” si lazima kila mara atoe mfanano wa chini
Hoja hii ni muhimu katika kuelewa mbinu. Modeli inaweza pia kuoanisha vizuri uso na sauti ya mtu ambaye haijawahi kumwona katika nafasi ya pamoja ya embedding.
Kwa hiyo, utaratibu wa OOD wa mfumo hautegemei swali “je, nimewahi kukariri utambulisho huu?”. Kinachopimwa ni cross-modal consistency kati ya uso na sauti.
Usambazaji wa mfanano kabla na baada ya mafunzo
Kielelezo 2 katika ukurasa wa 9 wa chanzo kinaonyesha kuwa kabla ya mafunzo linganishi, viwakilishi vya uso na sauti vilikusanyika karibu na sifuri katika seti zote za data. Kwa maneno mengine, vipengele vya uso vya FaceNet na vipengele vya sauti vya MFCC havijaoanishwa kiasili katika nafasi ileile ya viwianishi.
Katika Kielelezo 3 na Kielelezo 4 vya ukurasa huohuo, inaonekana kwamba baada ya mafunzo, mfanano wa kosaini wa jozi chanya za uso-sauti za LombardGrid ulikaribia 1 katika seti za mafunzo na majaribio. Mabadiliko haya ni kiashiria cha moja kwa moja cha kuona kwamba modeli linganishi imejifunza kiwakilishi cha pamoja kati ya modaliti mbili tofauti.
Mbinu na Matokeo ya Utafiti
Seti za data zilizotumiwa
Utafiti unatumia vyanzo vikuu vitatu vya data: seti ya data ya custom iliyoundwa na watafiti, VoxCeleb1 na Lombard Grid.
Seti ya data ya Custom
Seti maalumu ya data ina data za uso na sauti za watu 15 tofauti. Vyanzo vinajumuisha video kutoka majukwaa yanayopatikana kwa umma kama YouTube, pamoja na rekodi za wakati halisi za watu waliotoa ridhaa.
Kila mtu ana klipu za sauti 3-10, na urefu wa wastani wa sauti ni sekunde 4-8. Augmentation ilitumika kwa data ya mafunzo ili kufikia fremu 40 za uso na sampuli 40 za sauti kwa kila mtu. Fremu tatu za uso na sampuli tatu za sauti zilitengwa kwa kila mtu kwa ajili ya majaribio; ilihakikishwa kuwa rekodi za majaribio zilitoka katika vyanzo tofauti na rekodi zilizotumiwa katika mafunzo.
VoxCeleb1
VoxCeleb1 ni seti ya data ya wasemaji yenye kiwango kikubwa, iliyo na zaidi ya klipu 100.000 za sauti za jumla ya watu 1251. Rekodi hizo zina utofauti wa kelele za mandharinyuma, lafudhi na hali za maikrofoni.
Katika utafiti huu, video za majaribio zilitenganishwa na video za mafunzo. Kwa mafunzo, lengo la fremu 20 za uso na sampuli 20 za sauti kwa kila mtu liliwekwa, kisha zikafikishwa hadi sampuli 40 za uso na 40 za sauti baada ya augmentation.
Lombard Grid
Lombard Grid ina wasemaji 54 na zaidi ya klipu 1000 za sauti kwa kila mtu. Uwepo wa rekodi za video zilizosawazishwa na sauti huifanya ifae kwa uoanishaji wa uso-sauti.
Katika utafiti huu, nyuso 20 na sauti 20 zilichaguliwa kwa kila mtu kwa ajili ya mafunzo, na nyuso 5 na sauti 5 kutoka rekodi tofauti kwa ajili ya majaribio. Kwa sababu ya muundo wa data unaodhibitiwa, augmentation haikutumiwa.
Matokeo ya seti ya data ya Custom
Katika seti ya data ya Custom, mbinu ya multimodal na FaceNet-only baseline zote mbili zilitenganisha sampuli za IID na OOD kwa mafanikio ya juu. Katika uchanganuzi wa ROC:
| Mbinu | AUROC |
|---|---|
| Multimodal | 0,9928 |
| FaceNet-only | 0,9828 |
Tofauti si kubwa sana; hata hivyo, grafu za threshold zinaonyesha kuwa mbinu ya multimodal iliunda eneo thabiti zaidi kuhusiana na kizingiti cha uamuzi.
Matokeo ya LombardGrid
Katika seti ya data ya LombardGrid inayodhibitiwa, mbinu zote mbili zilifikia thamani ya AUROC=1. Kwa hiyo, haiwezi kusemwa kuwa mbinu ya multimodal ni bora kwa kutegemea mkunjo wa ROC pekee.
Tofauti inayosisitizwa na chanzo ni kwamba mbinu ya multimodal hudumisha utendaji wa juu wa IID/OOD katika safu pana zaidi ya threshold. Kwa maneno mengine, ingawa zinafikia kilele kilekile cha utendaji, unyeti wake kwa uteuzi wa kizingiti si sawa.
VoxCeleb Mini
Katika jaribio la VoxCeleb Mini, mfumo wa multimodal ulipata AUROC=0,974, huku mbinu ya FaceNet-only ikipata AUROC=0,971. Kwa upande wa ROC, mbinu hizo ziko karibu.
Hata hivyo, kadiri lengo la ugunduzi wa OOD lilivyoongezeka, mfumo wa multimodal ulibaki thabiti zaidi katika kuhifadhi usahihi wa IID.
| Ugunduzi wa OOD | IID ya Multimodal | FaceNet IID |
|---|---|---|
| %90,0 | %95,0 | %93,0 |
| %91,8 | %95,0 | %88,5 |
| %93,5 | %92,5 | %85,0 |
| %95,2 | %90,0 | %85,0 |
| %97,0 | %87,5 | %66,7 |
VoxCeleb Big: nini hutokea kiwango kinapoongezeka?
Tofauti iliyo wazi zaidi katika makala inaonekana katika jaribio la VoxCeleb Big.
Thamani ya AUROC ya mbinu ya multimodal ni 0,977, ilhali thamani ya ulinganisho wa FaceNet-only ni 0,529. Ya pili inawakilisha utendaji wa ROC ulio karibu na utenganishaji wa nasibu.
| Ugunduzi wa OOD | IID ya Multimodal | FaceNet IID |
|---|---|---|
| %90,0 | %94,6 | %18,7 |
| %91,8 | %94,3 | %17,8 |
| %93,5 | %93,8 | %16,8 |
| %95,2 | %92,7 | %14,7 |
| %97,0 | %86,2 | %11,7 |
Maelezo ya waandishi yanahusiana na namna mfumo wa FaceNet-only unavyofanya kazi. Baseline hii hulinganisha embedding ya hoja na ghala kubwa la utambulisho uliosajiliwa. Kadiri ghala linavyoongezeka, usambazaji wa mfanano kati ya madarasa huanza kuingiliana na kizingiti kinachotumiwa kutenganisha inayojulikana na isiyojulikana huwa dhaifu zaidi.
Mbinu ya multimodal, kwa upande mwingine, hupima ulinganifu wa uso na sauti zilizotolewa badala ya kufanya ulinganisho wa 1:N na utambulisho wote uliosajiliwa.
Uchangamano wa kihesabu
Chanzo kinaeleza kuwa wakati wa inferensi mbinu iliyopendekezwa inahitaji tu:
- embedding moja ya uso,
- embedding moja ya sauti,
- hesabu moja ya mfanano wa kosaini
vinahitajika, kwa mujibu wa chanzo.
Kwa hiyo, gharama ya uchakataji kwa kila uthibitishaji imeelezwa kuwa O(1), bila kutegemea ukubwa wa ghala. Kinyume chake, katika utambuzi wa kawaida wa watu unaotegemea ghala la 1:N, kiasi cha ukokotoaji huongezeka kulingana na ukubwa wa ghala kwa sababu hoja hulinganishwa na utambulisho wote uliosajiliwa.
Dai hili la uchangamano linahusu utaratibu wa uthibitishaji uliofafanuliwa na utafiti; halimaanishi kwamba kamera, uchakataji wa awali wa sauti, FaceNet feature extraction au ucheleweshaji wote wa maunzi katika mfumo halisi ni O(1) na wa muda usiobadilika.
Mapungufu muhimu ya utafiti
- Ulinganisho mkuu wa kimajaribio ulifanywa dhidi ya FaceNet-only unimodal baseline pekee.
- Ulinganisho kamili wa kimajaribio na mbinu nyingine za multimodal state-of-the-art haukufanywa.
- Multimodal fusion baseline mbadala, kama feature concatenation rahisi, hazikujumuishwa katika ulinganisho mkuu.
- Uchanganuzi wa kina wa ablation unaotenganisha kwa kiasi mchango huru wa kila modaliti bado haujafanywa.
- Kizingiti cha uamuzi wa OOD ni sehemu ya utendaji ya kijaribio; hakijawasilishwa kama kizingiti kimoja bora kwa matumizi yote.
- Seti ya data ya Custom ina watu 15 pekee.
- Uthibitishaji wa kiwango kikubwa zaidi katika hali za ulimwengu halisi umeachwa kuwa kazi ya baadaye.
- Tathmini ya kiwango kikubwa kuhusu maadili, faragha na matumizi katika mfumo halisi haijakamilika.
Kazi za baadaye
Waandishi wanapanga kujumuisha katika mfumo modaliti za ziada kama namna ya kutembea na data ya kina, kutumia uundaji modeli wa wakati, kuchunguza mbinu za ujifunzaji wa self-supervised na few-shot, na kupunguza mahitaji ya data.
Zaidi ya hayo, uthibitishaji mpana zaidi katika ulimwengu halisi, tathmini za kimaadili na majaribio ya kina zaidi ya ablation yanayopima mchango wa kila modaliti kwa matokeo ni miongoni mwa mada za utafiti wa baadaye.
Utafiti unasema nini?
Kuoanisha viwakilishi vya uso na sauti kwa njia linganishi katika nafasi ileile ya embedding kunaweza kuwezesha utenganishaji thabiti zaidi wa IID/OOD kupitia cross-modal consistency, hasa ghala la utambulisho linapoongezeka. Ushahidi wenye nguvu zaidi wa kimajaribio katika utafiti unatokana na matokeo ya VoxCeleb Big.
Utafiti hausemi nini?
Haiwezi kuhitimishwa kuwa mfumo hugundua bila makosa watu wote ambao hawajawahi kuonekana. Haijaonyeshwa kwamba mbinu hii ni bora kuliko mifumo yote ya kibayometriki ya multimodal. Utafiti huu peke yake pia hauthibitishi kwamba bayometriki ya uso-sauti iko tayari kutumika katika programu za usalama, ufuatiliaji au uthibitishaji wa utambulisho.
Dokezo la Chanzo na Mbinu
Utafiti asilia: Multimodal Recognition of Out-of-Distribution Individuals Using Contrastive Learning
Waandishi: Sergio Garcia; Francisco Gomez-Donoso; Miguel Cazorla.
Mwandishi wa mawasiliano: Miguel Cazorla.
Taasisi: University Institute for Computer Research, University of Alicante, Alicante, Spain.
Jarida: AI.
Mchapishaji: MDPI.
Rekodi ya bibliografia: AI 2026, 7, 162.
DOI: 10.3390/ai7050162
Aina ya makala: Akili bandia ya kimajaribio / utafiti wa utambuzi wa watu wa multimodal.
Mchakato wa uchapishaji: Ilipokelewa 31 Januari 2026; ikarekebishwa 6 Aprili 2026; ikakubaliwa 24 Aprili 2026; ikachapishwa 6 Mei 2026.
Leseni: Creative Commons Attribution (CC BY).
Ufadhili: Utafiti uliungwa mkono kupitia ruzuku ya PID2022-138453OB-I00 na MICIU/AEI/10.13039/501100011033 pamoja na “ERDF A way of making Europe”.
Maadili: Utafiti ulifanywa kwa mujibu wa Azimio la Helsinki na uliidhinishwa na University of Alicante Ethics Committee kwa msimbo wa itifaki UA-2023-07-31 mnamo Julai 2023.
Ridhaa yenye taarifa: Ridhaa yenye taarifa ilipatikana kutoka kwa watu waliojumuishwa katika utafiti.
Upatikanaji wa data: Imeripotiwa kuwa data ghafi inayounga mkono matokeo itatolewa na waandishi kwa ombi.
Mgongano wa maslahi: Waandishi hawaripoti mgongano wa maslahi.
Kiini cha mbinu: Embedding za uso zenye vipimo 512 zilizotolewa kutoka FaceNet na vipengele 80 vya sauti vya MFCC ziliprojetiwa katika nafasi ya pamoja ya embedding yenye vipimo 1200 kupitia matawi mawili tofauti ya mtandao wa neva. Kwa upotevu linganishi wa InfoNCE, jozi za uso-sauti za mtu yuleyule zilisogezwa karibu, huku jozi za watu tofauti zikitenganishwa. Uamuzi wa OOD ulifanywa kupitia threshold ya kijaribio kwa kutumia mfanano wa kosaini kati ya embedding za uso na sauti.
Kikomo kikuu cha tafsiri: Utafiti haufanyi ulinganisho mpana wa state-of-the-art multimodal baseline. Sehemu muhimu ya matokeo inategemea ulinganisho unaodhibitiwa na FaceNet-only baseline, huku ablation pana zaidi, upanuzi wa kiwango katika ulimwengu halisi na tathmini ya kimaadili zikiachwa kuwa kazi ya baadaye.
Mbinu ya maudhui ya Verianla: Matini hii ya Kiswahili si tafsiri ya sentensi kwa sentensi ya PDF chanzo. Masimulizi huru ya kisayansi kwa Kiswahili yameundwa kwa kuhifadhi seti za data, viwakilishi vya uso na sauti, usanifu wa mtandao, upotevu linganishi, utaratibu wa kizingiti cha OOD, itifaki ya mafunzo, matokeo ya ROC/AUROC, uchanganuzi wa kiwango, mbinu ya ukokotoaji, taarifa za kimaadili na mipaka ya kimetodolojia ya utafiti. Hakuna utendaji, idadi ya watu, matokeo ya kliniki/usalama au mafanikio ya utekelezaji yasiyopatikana katika chanzo yaliyoongezwa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *