

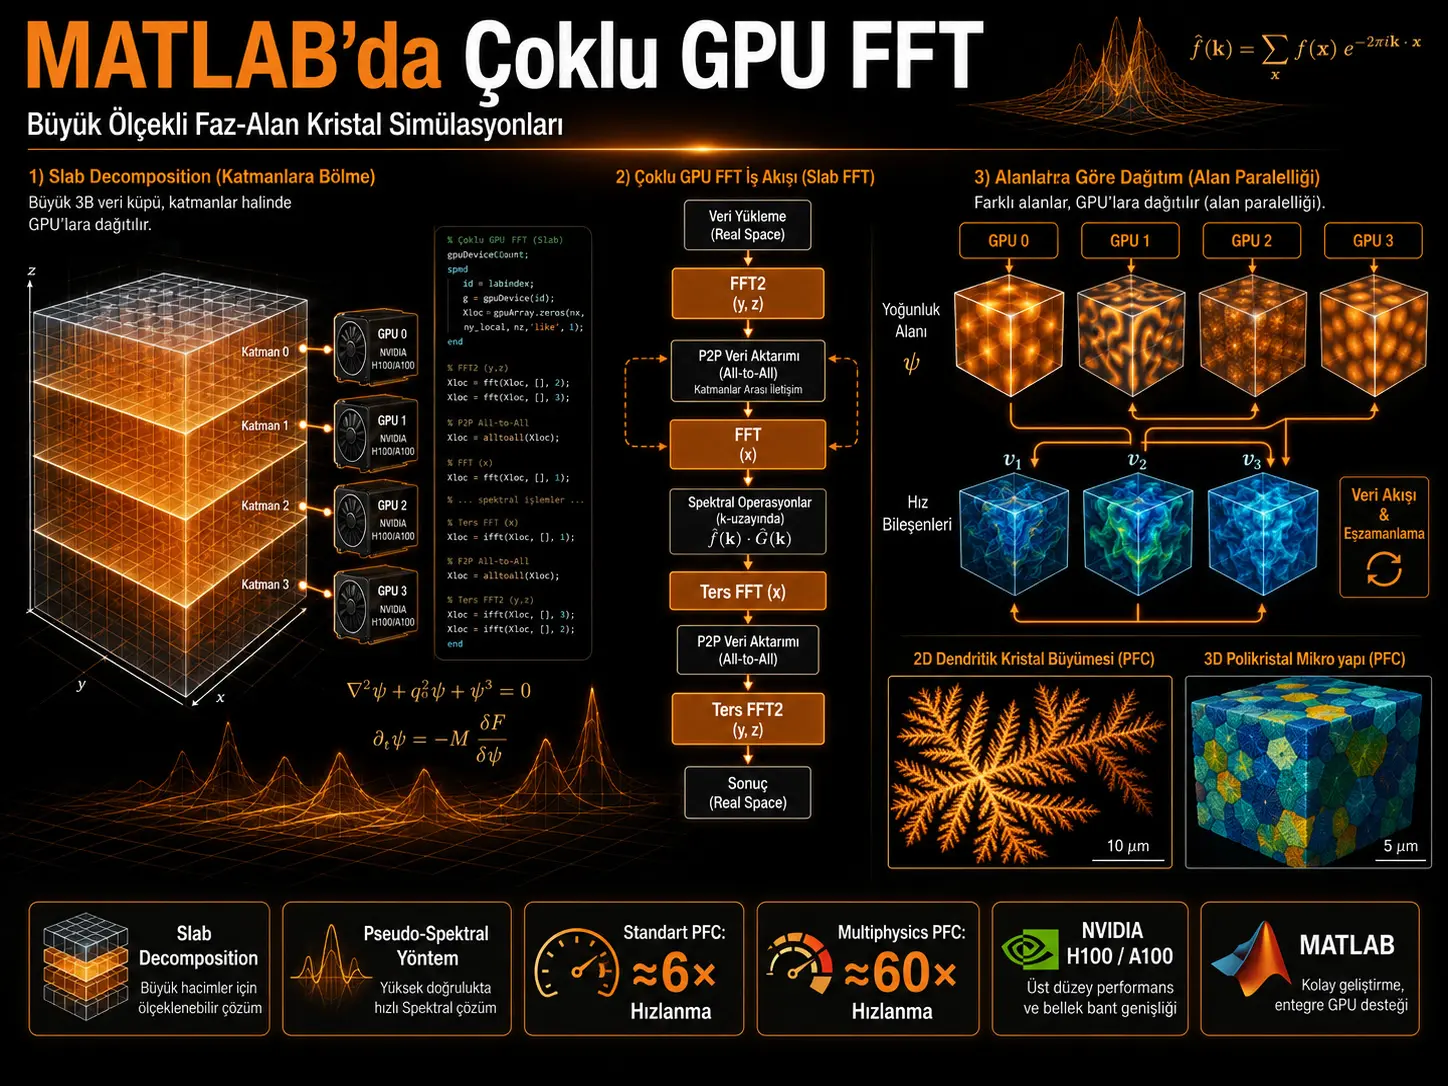
Ushbu tadqiqot MATLAB muhitida ikki va uch o‘lchamli tezkor Fourier almashtirishlarini (Fast Fourier Transform, FFT) bir nechta GPU'larga taqsimlash orqali bitta GPU xotirasi bilan cheklangan keng ko‘lamli pseudo-spectral simulyatsiyalarni ishga tushirishga qaratilgan ikkita o‘zaro to‘ldiruvchi parallellashtirish strategiyasini ishlab chiqadi. Birinchi yondashuvda bitta yirik uch o‘lchamli FFT, fazoviy maydonni slab decomposition usuli yordamida GPU'larga bo‘lish, har bir GPU'da mahalliy ikki o‘lchamli FFT qo‘llash, peer-to-peer ma'lumotlarni qayta taqsimlash va qolgan o‘q bo‘ylab bir o‘lchamli FFTni bajarish orqali hisoblanadi. Ikkinchi yondashuvda esa ko‘p maydonli (multiphysics) fizika modellaridagi turli o‘zgaruvchilar alohida GPU'larga biriktiriladi va har bir vaqt qadamida GPU'lar o‘rtasida sinxronlashtirilgan ma'lumotlar uzatilishi amalga oshiriladi.
Usullar Phase-Field Crystal (PFC) modellari ustida sinovdan o‘tkazildi. Standart uch o‘lchamli PFC simulyatsiyalarida 750³–1400³ oralig‘idagi muammolar uchun GPU hisoblashlari to‘rtta NVIDIA H100 yoki sakkizta NVIDIA A100 GPU bilan amalga oshirildi; 100 yadroli Intel Xeon Platinum 8470 CPU referansiga nisbatan qariyb olti barobargacha tezlashish qayd etildi. 1400³ massiv faqat to‘rtta H100 GPU xotirasiga sig‘di va manba 1(a)-rasmda ishlash vaqti CPU vaqtining taxminan 17% gacha qisqarganini ta'kidladi. To‘rtta fizik maydon to‘rtta H100 GPU'ga taqsimlangan hydrodynamic PFC yondashuvida esa, manba CPU ilovasiga nisbatan 60 barobargacha tezlashishni xabar qilmoqda.
Natijalarning eng muhim talqiniy chegarasi shundaki, qayd etilgan tezlashishlar muayyan HPC apparat ta'minoti, GPU xotirasi, GPU–GPU aloqa tuzilmasi, MATLAB ilovasi va PFC algoritmlari uchun o‘lchangan. Tadqiqot har bir FFT muammosida ko‘proq GPU tezroq bo‘lishini ko‘rsatmaydi; aksincha, kichik 750³ muammosida bitta H100 GPU eng yaxshi natijani bersa, qo‘shimcha GPU'larning aloqa xarajati unumdorlik ustunligini kamaytiradi. Shuning uchun tadqiqotning asosiy hissasi faqat ishlov berish tezligini oshirish emas, balki bitta GPU xotirasiga sig‘maydigan yuqori aniqlikdagi spectral muammolarni MATLAB ichida ishga tushirish imkoniyatini taqdim etishdir.
Nima uchun bitta GPU keng ko‘lamli FFT simulyatsiyalarida to‘siq (bottleneck) yaratadi?
Pseudo-spectral Fourier usullarida yuqori tartibli fazoviy hosilalar Fourier fazosida samarali tarzda hisoblanishi mumkin; biroq chiziqli bo‘lmagan qism fizik fazoda baholanganligi sababli, har bir vaqt qadamida to‘g‘ri va teskari FFT amallari qayta-qayta ishga tushiriladi. Massiv o‘lchamlari kattalashgani sari ham FFT hisoblash xarajati, ham GPU xotirasida saqlanishi kerak bo‘lgan ko‘p o‘lchamli ma'lumotlar hajmi keskin oshadi.
Phase-Field Crystal modellari ushbu muammoni yaqqol ko‘rsatadi. PFC yondashuvi kristal tartibini atom uzunligi shkalasida yechishga harakat qilar ekan, mikrostrukturaning ancha kattaroq fazoviy va diffuziyaviy vaqt shkalalaridagi rivojlanishini kuzatib boradi. Natijada bir tomondan yuqori fazoviy aniqlik, ikkinchi tomondan esa keng hisoblash maydoni talab qilinadi.
Bir nechta zichlik, tarkib, tezlik yoki harorat maydonini o‘z ichiga olgan multiphysics modellarida bir vaqtning o‘zida bir nechta yirik uch o‘lchamli maydonni saqlash talab etilganligi sababli, bitta GPU xotirasi yanada jiddiy cheklovga aylanadi.
Fourier pseudo-spectral usulining asosiy tenglamasi qanday?
Manba usulni tushuntirish uchun avvalo bir o‘lchamli umumiy evolyutsiya tenglamasidan foydalanadi:
\[ partial_t u=mathcal{L}u+mathcal{N}(u), qquad xin[0,2pi),;tgeq0 \]
Bu yerda (mathcal L) chiziqli differensial operatorni, (mathcal N(u)) esa (u) ning ko‘phad shaklidagi chiziqli bo‘lmagan qismini ifodalaydi.
Davriy maydonda yechim chekli Fourier qatori bilan taqriban:
\[ u(x,t)approx u_N(x,t) = sum_{k=-K}^{K} widehat{u}_k e^{ikx} \]
shaklida ifodalanadi va:
[ N=2K+1 ]
Fourier rejimidan (mode) foydalaniladi.
Teng oraliqli collocation nuqtalari:
\[ x_j=frac{2pi j}{N}, qquad j=0,ldots,N-1 \]
sifatida ta'riflanadi.
Differensial tenglama Fourier fazosida qanday o‘zgaradi?
Fourier almashtirishi qo‘llanilganda har bir Fourier rejimi uchun:
\[ partial_twidehat{u}_k = widehat{mathcal L}_kwidehat{u}_k+ widehat{[mathcal N(u)]}_k \]
shaklidagi oddiy differensial tenglama olinadi.
Fazoviy hosilalar Fourier fazosida oddiy ko‘paytmalarga aylanadi:
\[ widehat{[partial_x^n u]}_k = (ik)^nwidehat{u}_k. \]
Bu xususiyat yuqori tartibli PDE'larda alohida ahamiyatga ega. Ammo chiziqli bo‘lmagan (mathcal N(u)) hadi fizik fazoda nuqtaviy hisoblanganligi sababli, algoritm doimiy ravishda Fourier fazosi va fizik fazo o‘rtasida almashib turadi.
Bir vaqt qadamining asosiy oqimi quyidagicha:
- Maydon FFT orqali Fourier fazosiga aylantiriladi.
- Chiziqli bo‘lmagan had fizik fazoda hisoblanadi va qaytadan FFT yordamida o‘zgartiriladi.
- Fourier koeffitsiyentlarining vaqt bo‘yicha rivojlanishi hisoblanadi.
- Teskari FFT orqali yangi fizik maydon hosil qilinadi.
Keng ko‘lamli hisoblashlarda bu takroriy ko‘p o‘lchamli FFT'lar umumiy ishlash vaqtining asosiy qismlaridan biriga aylanadi.
Birinchi strategiya: Bitta 3B FFT qanday qilib bir nechta GPU'ga taqsimlanadi?
Tadqiqotning birinchi strategiyasi, bitta:
\[ N_ximes N_yimes N_z \]
o‘lchamli massivni (G) ta GPU'ga bo‘lish orqali bitta yuqori o‘lchamli FFT'ni ko‘p GPU ustida amalga oshirishdir.
Ma'lumotlar z yo‘nalishida slab decomposition usuli orqali bo‘linadi. Har bir GPU dastlab global massivning faqat o‘ziga tegishli slab qismini saqlaydi.
To‘g‘ri FFT uchta asosiy bosqichda bajariladi:
- Har bir GPU o‘zining mahalliy ma'lumotlar bo‘lagida dastlabki ikki o‘lcham bo‘ylab
fft2ni ishga tushiradi. - GPU'lar peer-to-peer aloqa yordamida ma'lumot bo‘laklarini qayta taqsimlaydi.
- Qayta tartiblangan ma'lumotlar ustida uchinchi o‘lcham bo‘ylab
fft(...,3)ishga tushiriladi.
Ushbu jarayon yakunida global Fourier almashtirishi tugallangan bo‘lsa-da, butun almashtirish bitta GPU'da joylashmaydi; har bir GPU Fourier fazosidagi natijaning ma'lum bir qismini o‘zida saqlaydi.
Nima uchun P2P aloqasi talab etiladi?
Mahalliy fft2 amallari faqat GPU ga tegishli slab ustidagi ikkita o‘qni o‘zgartira oladi. Uchinchi o‘qdagi FFT uchun bir xil almashtirish yo‘nalishiga oid ma'lumotlar elementlari tegishli GPU'da birlashtirilishi kerak.
Shu sababli, mahalliy FFT'lardan so‘ng ma'lumotlar GPU'lar o‘rtasida qayta tartiblanadi. Manba MATLAB ilovasida bu bosqichni spmd parallel sessiyasi va spmdCat asosidagi ma'lumotlarni birlashtirish jarayonlari orqali ko‘rsatadi.
Teskari FFT'da ketma-ketlik teskarisiga o‘zgaradi: uchinchi o‘lchamda ifft, P2P qayta taqsimlash va dastlabki ikki o‘lchamda ifft2.
Verianla Live: Bitta 3B FFT'ni ko‘p GPU ustida amalga oshirish
| Bosqich | Jarayon | MATLAB / GPU ekvivalenti |
|---|---|---|
| 1. Slab decomposition | 3B massiv z yo‘nalishida G ta GPU o‘rtasida bo‘linadi. | Har bir GPU global massivning faqat mahalliy slab'ini saqlaydi. |
| 2. Mahalliy 2B FFT | Har bir slab'ning dastlabki ikki o‘lchami mustaqil o‘zgartiriladi. | fft2 |
| 3. P2P orqali qayta taqsimlash | Uchinchi o‘qda FFT bajarilishi uchun ma'lumot bo‘laklari GPU'lar o‘rtasida qayta tartiblanadi. | spmd / spmdCat |
| 4. Qolgan 1B FFT | Uchinchi fazoviy o‘lcham Fourier fazosiga aylantiriladi. | fft(...,3) |
| 5. Spectral vaqt qadami | PFC maydonining Fourier koeffitsiyentlari semi-implicit usuli bilan yangilanadi. | Elementga asoslangan Fourier-space amali |
| 6. Teskari 1B FFT | Uchinchi o‘lchamda fizik fazoga qaytish boshlanadi. | ifft(...,3) |
| 7. Teskari P2P taqsimlash | Ma'lumotlar qaytadan mahalliy slab tartibiga keltiriladi. | spmdCat |
| 8. Teskari 2B FFT | Dastlabki ikki o‘lchamda fizik maydon qaytadan hosil qilinadi. | ifft2 |
Verianla Live: Jarayon manba tadqiqotning 1(a)-rasmi va Listing 1'dagi MATLAB ilovasiga asoslanadi. Ko‘rinib turgan jadval ilmiy source-of-truth sifatida saqlanadi.
Phase-Field Crystal modeli qanday fizik muammoni ifodalaydi?
PFC modeli kristal zichlik tartibining fazoviy va vaqtinchalik rivojlanishini yagona uzluksiz zichlik maydoni (psi(mathbf{x},t)) orqali ifodalaydi. Manba misol sifatida sirt-markazlashgan kubik (face-centered cubic, FCC) simmetriya uchun erkin energiya funksionalini:
\[ F[psi] = int_{Omega} left[ frac{psi}{2} (varepsilon+mathcal L)psi+ frac{psi^4}{4} ight]dmathbf r \]
ko‘rinishida beradi.
Bu yerda:
\[ mathcal L= (1+abla^2)^2 left(frac{4}{3}+abla^2ight)^2 \]
fazoviy korrelyatsiyalarni tavsiflovchi operator bo‘lib, (varepsilon) undercooling parametridir.
Klassik PFC dinamikasi:
\[ partial_tpsi = abla^2 frac{delta F[psi]}{deltapsi} = (varepsilon+mathcal L)abla^2psi+ abla^2psi^3 \]
bilan ifodalanadi.
(mathcal L) ichida ketma-ket Laplace operatorlari mavjudligi va tashqarida qo‘shimcha (abla^2) qo‘llanilishi sababli, PFC tenglamasi manbada o‘ninchi tartibli PDE sinfida ta'riflanadi.
MATLAB vaqt qadamini qanday yangilaydi?
Listing 1'da Fourier fazosidagi zichlik maydoni semi-implicit tarzda:
psiF = (psiF + dt*lap.*psi)./(1 - dt*lin);
shaklidagi elementga asoslangan yangilanish orqali siljitiladi.
Bu yerdagi asosiy hisoblash zanjirida:
psifizik zichlik maydonini,psiFFourier bilan o‘zgartirilgan zichlikni,lapdiskret Laplace operatorini,lindiskret chiziqli operatorni,dtvaqt qadamini
ifodalaydi.
Manbadagi listing'lar to‘liq dasturiy ta'minot paketining o‘zi emas, balki usulning ishlash mantig‘ini ko‘rsatuvchi implementation snippet'laridir. Kerakli boshlang‘ich o‘zgaruvchilar va ma'lumotlarni bo‘lish indekslarining to‘liq tavsiflari maqolaning kod blokida berilmagan; bajarilishi mumkin bo‘lgan to‘liq ilova alohida manba kodi omborida taqdim etilgan.
Dastlabki benchmark qanday apparat ta'minotlarida o‘tkazildi?
| Hisoblash manbasi | Manbada berilgan apparat ta'minoti | Benchmark roliga |
|---|---|---|
| GPU tizimi 1 | 4 × NVIDIA H100 SXM5, har bir GPU uchun 94 GiB HBM2e | Capella HPC klasteri |
| GPU tizimi 2 | 8 × NVIDIA A100 SXM4, har bir GPU uchun 40 GiB HBM2 | Alpha Centauri HPC klasteri |
| CPU referansi | Intel Xeon Platinum 8470, jami 100 yadro, 2,00 GHz | Barnard HPC klasteri |
Shu sababli qayd etilgan GPU/CPU tezlashishi nafaqat kodni parallellashtirishni, balki bir-biridan farq qiluvchi hisoblash arxitekturalarining samaradorligini ham o‘z ichiga oladi. Natijalarni bir xil apparat ta'minoti ustida faqat CPU/GPU rejimini o‘zgartiruvchi boshqariladigan mikrobenchmark sifatida talqin qilmaslik kerak.
750³ muammosida nima uchun ko‘proq GPU tezroq ishlamaydi?
Tadqiqotning 1(a)-rasmi muhim bir masshtablashuv chegarasini ko‘rsatadi: 750³ o‘lchamli muammo uchun H100 da eng yaxshi unumdorlik bitta GPU yordamida olinadi.
Muammo bitta GPU xotirasiga bemalol sig‘ganida, qo‘shimcha GPU'lar hisoblash yukini bo‘lishsa ham, P2P ma'lumotlar harakati va sinxronizatsiya xarajati yuzaga keladi. Kichik yoki o‘rta ko‘lamli muammolarda bu aloqa xarajati parallellashtirish yutug‘idan kattaroq bo‘lishi mumkin.
Shuning uchun tadqiqot natijasi “GPU sonini ko‘paytirgan sari FFT doimiy ravishda tezlashadi” degani emas. Ko‘p GPU'li yondashuvning ahamiyati muammo o‘lchami bitta GPU chegarasidan oshib ketishni boshlaganda aniq namoyon bo‘ladi.
1400³ muammosida nima sodir bo‘ladi?
Manbaga ko‘ra (1400^3) o‘lchamli massiv faqat to‘rtta H100 GPU foydalanilgandagina xotiraga sig‘a olgan.
1(a)-rasm izohida ushbu konfiguratsiyaning ishlash vaqti 100 yadroli CPU referansining taxminan:
[ 0.17 ]
barobari, ya'ni taxminan 17% i sifatida berilgan.
Bu nisbat taxminan olti barobarlik tezlashishga to‘g‘ri keladi va maqolada standart PFC uchun qayd etilgan “up to sixfold” natijasining asosini tashkil qiladi.
Biroq bu natijani barcha PFC o‘lchamlariga umumlashtirish noto‘g‘ri. Rasm ham ko‘rsatib turganidek, optimal GPU soni muammo kattaligiga va ishlatilgan GPU oilasiga qarab o‘zgaradi.
Ikkinchi strategiya nima uchun farq qiladi?
Ikkinchi strategiya bitta FFT'ni GPU'larga bo‘lish o‘rniga, multiphysics modelidagi turli fizik maydonlarni alohida GPU'larga taqsimlaydi.
Manba hydrodynamic PFC modelini misol qilib oladi. Zichlik maydoniga uch komponentli mezoskopik tezlik maydoni qo‘shiladi:
\[ mathbf v= (v_1,v_2,v_3). \]
Model:
\[ partial_tpsi = abla^2 left( frac{delta F[psi]}{deltapsi} ight) - mathbf vcdotablapsi \]
va:
\[ hopartial_tmathbf v = Gammaabla^2mathbf v - leftlangle psiabla frac{delta F[psi]}{deltapsi} ightangle \]
tenglamalari bilan tavsiflanadi.
To‘rtta GPU'ga qaysi maydonlar biriktiriladi?
Tadqiqotning 1(b)-rasmi va Listing 2'si taqsimotni ochiq ko‘rsatib turibdi:
| GPU | Asosiy fizik maydon |
|---|---|
| GPU 1 | Zichlik maydoni (psi) |
| GPU 2 | Tezlik komponenti (v_1) |
| GPU 3 | Tezlik komponenti (v_2) |
| GPU 4 | Tezlik komponenti (v_3) |
GPU 1 zichlik maydonini yangilagandan so‘ng yangi (psi) ni boshqa uchta GPU'ga yuboradi. GPU 2–4 o‘zlarining tezlik komponentlarini yangilaydi va natijalarni GPU 1 ga qaytarib yuboradi.
MATLAB kodida ushbu ma'lumotlar almashinuvi spmdSend va spmdReceive orqali amalga oshiriladi.
Gaussian convolution nima uchun Fourier usuliga mos keladi?
Hydrodynamic PFC modelidagi mahalliy o‘rtacha qiymat:
\[ langlecdotangle(mathbf r) = int_{Omega} frac{ (cdot)(mathbf r') }{ (2pi a_0^2)^{3/2} } exp left[ -frac{ (mathbf r-mathbf r')^2 }{ 2a_0^2 } ight] dmathbf r' \]
shaklidagi Gaussian convolution orqali ta'riflanadi.
Fourier almashtirishining convolution xususiyati tufayli ushbu integral Fourier fazosida ko‘paytmaga aylanadi. Shu tariqa, PFC'ning yuqori tartibli differensial operatorlarida bo‘lgani kabi convolution amali ham pseudo-spectral usulning hisoblash tuzilmasiga tabiiy ravishda moslashadi.
Multiphysics modelida 60 barobar tezlashish nimani anglatadi?
Manba to‘rtta NVIDIA H100 GPU ustida ishga tushirilgan hydrodynamic PFC solver uchun 100 yadroli CPU ilovasiga nisbatan 60 barobargacha tezlashishni ma'lum qilmoqda.
Bu qiymat standart PFC'dagi taxminan olti barobarlik tezlashish bilan to‘g‘ridan-to‘g‘ri bir xil parallellashtirish ssenariysi emas. Standart PFC benchmark'ida bitta katta FFT slab decomposition yordamida bir nechta GPU'ga yoyilsa, hydrodynamic PFC yondashuvida to‘rtta alohida fizik maydon to‘rtta GPU'ga taqsimlanadi.
Shu bois, 6× va 60× qiymatlari ikkita alohida ko‘p GPU'li strategiyaning turli muammo tuzilmalariga qo‘llanilishidan olingan.
Verianla Live: Ikkita ko‘p GPU strategiyasini taqqoslash
| Xususiyat | Bitta FFT'ni Ko‘p GPU'ga Bo‘lish | Multiphysics Maydonlarini GPU'larga Taqsimlash |
|---|---|---|
| Asosiy maqsad | Bitta yirik 3B FFT'ning bitta GPU xotirasidan oshib o‘ta olishi | Bir nechta yirik fizik maydonning bir vaqtning o‘zida ishlanishi |
| Parallellashtirish shakli | z yo‘nalishida slab decomposition + P2P redistribution | Har bir fizik maydon alohida GPU'da |
| Asosiy MATLAB aloqa tuzilmasi | spmd / spmdCat | spmdSend / spmdReceive |
| GPU tizimlari | 4× H100 yoki 8× A100 | 4× H100 |
| Manbada vaqti o‘lchangan muammo ko‘lami | 750³–1400³ | 1(b)-rasmda 750³–900³ |
| Eng yuqori qayd etilgan tezlashish | Taxminan 6× | Taxminan 60× |
| Qo‘shimcha manba tasviri | 2B dendritik qotish | 1400³ 3B polikristal yiriklashish namunasi |
Verianla Live: Ma'lumotlar tadqiqotning 1-rasm, 2-rasm va usul izohlariga asoslanadi. 1(b)-rasmdagi 900³ benchmark chegarasi va 2(b)-rasmdagi 1400³ reprezentativ hydrodynamic PFC namunasi manbada alohida berilganligi sababli, ular bu yerda birlashtirilmagan.
1(a)-rasm unumdorlik nuqtai nazaridan nima deydi?
11-sahifadagi 1(a)-rasmning yuqori paneli uch o‘lchamli massivning slab'larga ajratilishini, mahalliy fft2 hisoblarini, P2P ma'lumot almashinuvini va so‘nggi fft bosqichini ko‘rsatadi.
Quyi panelda ishlash vaqti 100 CPU yadrosidagi vaqtga normallashtirilgan. Eng muhim tendensiya quyidagilardir:
- 750³ kabi kichik muammoda bitta GPU eng samarali hisoblanadi.
- Muammo kattalashgani sari ko‘proq GPU xotirasi zarur bo‘lib qoladi.
- 1400³ massivi faqat to‘rtta H100 GPU bilan ishga tushirilishi mumkin bo‘ldi.
- Ushbu yirik konfiguratsiya CPU ishlash vaqtining taxminan 17% iga yetgan.
Shuning uchun rasm ham tezlashishni, ham xotira miqyosining (memory scaling) afzalligini ko‘rsatadi.
1(b)-rasm nima uchun kattaroq tezlashishni ko‘rsatadi?
1(b)-rasmda zichlik maydoni (psi) GPU 1 ga, tezlik komponentlari (v_1), (v_2) va (v_3) esa GPU 2–4 ga biriktirilgan. Shunday qilib, bir-biridan alohida yirik FFT ish yuklamalari bir vaqtning o‘zida turli qurilmalarda bajarilishi mumkin.
Manba grafigida to‘rtta H100 GPU dagi ishlash vaqti CPU referansining taxminan yuzdan bir necha qismi darajasida bo‘lib, eng yaxshi holatda qariyb 60× tezlashishga erishilgan.
Ushbu unumdorlik afzalligi bitta FFT'ning bo‘linishidan farq qiladi: turli maydonlarning tabiiy ravishda bir-biridan ajrala olishi ancha yuqori parallellikni ta'minlay oladi.
2B dendritik qotish namunasi qanchalik katta?
12-sahifadagi 2(a)-rasm triangular crystal symmetry ostidagi dendritik qotish namunasini ko‘rsatadi.
Hisoblash maydoni:
\[ 5imes10^4 imes 5imes10^4 \]
grid o‘lchamidadir. Manba, alyuminiy uchun 4 Å panjara doimiysi farazi bilan, bu taxminan:
\[ 2.5,muext{m}imes2.5,muext{m} \]
fizik maydonga to‘g‘ri kelishini ta'kidlaydi.
Rasmda zichlik maydoni (psi) va kattalashtirilgan hudud ko‘rsatilgan. Tasvirdagi oq chiziqlar fizik donacha chegaralari emas; manba massiv bitta grafik shaklida chizib bo‘lmaydigan darajada katta bo‘lganligi sababli, bular foydalanilgan vizuallashtirish bo‘laklarining chegaralarini ko‘rsatishini ochiq aytib o‘tgan.
3B polikristal namuna nimani ko‘rsatadi?
2(b)-rasm, FCC kristal tuzilishida hydrodynamic PFC bilan polikristal yiriklashishni ko‘rsatadi.
Vizuallashtirilgan o‘zgaruvchilar:
- zichlik maydoni (psi),
- tezlik komponenti (v_1),
- tezlik komponenti (v_2),
- tezlik komponenti (v_3)
sifatida berilgan.
Rasm izohida ishlatilgan grid:
[ 1400imes1400imes1400 ]
va fizik quti o‘lchami taxminan:
\[ 40,ext{nm}imes40,ext{nm}imes40,ext{nm} \]
ekanligi ko‘rsatilgan.
Ushbu qiymat 1(b)-rasmdagi vaqti o‘lchangan hydrodynamic benchmark'ning 900³ yuqori chegarasidan kattaroqdir. Manba 1400³ vizuallashtirishining benchmark grafigidagi tajriba bilan bir xil sharoitda ekanligini izohlamaydi; shuning uchun bu ikki natija bir xil benchmark nuqtasi sifatida baholanmasligi kerak.
Tadqiqot da'vo qilayotgan o‘ziga xoslik nimada?
Mualliflar yuqori unumdorli hisoblashda oldindan umumiy taqsimlangan ko‘p GPU'li FFT usullari mavjud bo‘lganligini tan olishadi. Tadqiqotning o‘ziga xoslik da'vosi shundan iboratki: manba MATLAB ichida ilovadan mustaqil umumiy multi-GPU FFT infratuzilmasi mavjud emasligini va taqdim etilgan yondashuv MATLAB'dagi ilk multi-GPU FFT implementatsiyasini tashkil qilishini ifoda etadi.
Bu, mualliflarning adabiyot va dasturiy ekotizimni baholashiga asoslangan o‘ziga xoslik da'vosidir. Tadqiqot barcha xususiy yoki chop etilmagan MATLAB kodlarini qamrab oluvchi mustaqil dasturiy ta'minot inventarizatsiyasini amalga oshirmaydi.
Qachon ko‘proq GPU foyda keltiradi?
Manba natijalariga ko‘ra, ko‘p GPU ayniqsa ikkita holatda mazmunli bo‘ladi:
- Bitta FFT massivi bitta GPU xotirasiga sig‘maganida.
- Multiphysics modelida bir nechta yirik fizik maydon bir vaqtning o‘zida yangilanganida.
Bunga qaramay, bitta GPU'ga bemalol sig‘adigan kichik muammolarda ma'lumotlar uzatilishi sababli qo‘shimcha GPU'lardan foydalanish sekinroq bo‘lishi mumkin.
Shu sababli GPU soni mustaqil unumdorlik parametri emas; muammo o‘lchami, GPU xotirasi, P2P o‘tkazuvchanlik qobiliyati, ish yuklamasining bo‘linuvchanligi va hisoblash/aloqa nisbati birgalikda baholanishi kerak.
O‘zbekiston nuqtai nazaridan nimani anglatadi?
Tadqiqot TU Dresden va NHR Center HPC infratuzilmasida amalga oshirilgan; O‘zbekistondagi biror HPC tizimi yoki tadqiqot markazida benchmark qilinmagan.
Ushbu usul MATLAB'ga asoslangan yuqori aniqlikdagi materiallarni modellashtirish, spectral PDE yechimlari yoki ko‘p maydonli fizika simulyatsiyalarini o‘tkazuvchi O‘zbekistondagi tadqiqot guruhlari nuqtai nazaridan metodologik jihatdan moslashtirilishi mumkin. Biroq tadqiqotdagi 6× yoki 60× qiymatlari turli xil GPU modellariga, PCIe/NVLink topologiyalariga, CPU tuzilmalariga yoki MATLAB versiyalariga to‘g‘ridan-to‘g‘ri o‘tkazilmasligi kerak.
Mahalliy tizimda haqiqiy unumdorlikni aniqlash uchun bir xil muammo o‘lchamlari bilan alohida strong-scaling, memory-scaling va GPU aloqa benchmark'lari o‘tkazilishi talab qilinadi.
Tadqiqot qo‘llab-quvvatlaydigan natijalar
- MATLAB ichida ko‘p GPU dan foydalanib ikki va uch o‘lchamli FFT ga asoslangan pseudo-spectral hisoblashlar amalga oshirildi.
- Bitta yirik 3B FFT slab decomposition va GPU–GPU ma'lumot aloqasidan foydalanib bir nechta GPU'ga taqsimlana oldi.
- 750³–1400³ PFC benchmark'larida taxminan olti barobargacha GPU/CPU tezlashishi qayd etildi.
- 1400³ standart PFC massivi manba apparatida faqat to‘rtta H100 GPU ustida xotiraga sig‘di.
- 1400³ H100 natijasi CPU referans vaqtining taxminan 17% i sifatida ma'lum qilindi.
- Kichik 750³ muammosida bitta H100 GPU, ko‘proq H100 GPU foydalanishidan ko‘ra yaxshiroq unumdorlik ko‘rsatdi.
- Hydrodynamic PFC da (psi,v_1,v_2,v_3) maydonlari to‘rtta GPU'ga alohida taqsimlana oldi.
- Ushbu ikkinchi strategiyada 100 yadroli CPU ilovasiga nisbatan 60 barobargacha tezlashish qayd etildi.
- Tadqiqot 2B dendritik qotish va 3B polikristal yiriklashish namunalari bilan usulning PFC simulyatsiyalariga qo‘llanilishini ko‘rsatdi.
- Manba kodi MIT litsenziyasi bilan dasturiy ta'minot omborida ulashildi.
Tadqiqot qo‘llab-quvvatlamaydigan yoki sinovdan o‘tkazmagan natijalar
- Ko‘proq GPU ning har bir muammoda tezroq ekanligi ko‘rsatilmagan.
- 6× va 60× tezlashishlar barcha GPU/CPU tizimlari uchun universal qiymatlar emas.
- Tadqiqot barcha MATLAB FFT ilovalari bir xil masshtablashuvga erishishini ko‘rsatmaydi.
- Tadqiqot H100 va A100 dan boshqa GPU'larda batafsil unumdorlik benchmark'ini taqdim etmaydi.
- GPU–GPU aloqa vaqti alohida komponent sifatida miqdoriy jihatdan bo‘linmagan.
- Strong-scaling va weak-scaling samaradorligi klassik HPC metrikalari bilan alohida jadvallar shaklida hisobot qilinmagan.
- GPU yechimi va CPU yechimi o‘rtasidagi sonli xato uchun alohida FFT aniqlik jadvali taqdim etilmagan.
- Qayd etilgan benchmark natijalari haqiqiy tajribaviy material mikrostrukturasi bilan miqdoriy tasdiqlash degani emas; bular PFC sonli simulyatsiyalari.
- Hydrodynamic PFC uchun 2(b)-rasmdagi 1400³ vizualining 1(b)-rasmdagi vaqti o‘lchangan benchmark'ning bir qismi ekanligi manba tomonidan ochiq aytilmagan.
- Tadqiqot GPU sonini ko‘paytirishning xarajat/energiya samaradorligini baholamaydi.
- Mualliflarning “MATLAB'dagi ilk multi-GPU FFT” ifodasi mustaqil va to‘liq global dasturiy ta'minot o‘rganishining natijasi sifatida tasdiqlanmagan.
Tadqiqot Usuli va Natijalari
Ikkita parallellashtirish strategiyasining texnik xulosasi
| Parametr | Strategiya 1 | Strategiya 2 |
|---|---|---|
| Muammo | Bitta yirik FFT | Multiphysics PFC |
| Parallellashtirish | Domain/slab decomposition | Field decomposition |
| Mahalliy hisoblash | 2B FFT + 1B FFT | Har bir GPU o‘z maydonining 3B FFT'larini bajaradi |
| Aloqa | P2P data redistribution | Vaqt qadami oxirida maydonlarning sinxronizatsiyasi |
| MATLAB tuzilmasi | spmd, spmdCat | spmd, spmdSend, spmdReceive |
| Asosiy afzallik | Bitta GPU xotirasidan oshib o‘tuvchi FFT | Bir nechta fizik maydonning bir vaqtda bajarilishi |
Standart PFC benchmark ko‘lami
| Ko‘rsatkich | Manba qiymati |
|---|---|
| Muammo o‘lchami oralig‘i | 750³–1400³ |
| Benchmark vaqti | 1-rasmda 1000 vaqt qadami |
| H100 tizimi | 4 × NVIDIA H100 SXM5, har bir GPU uchun 94 GiB HBM2e |
| A100 tizimi | 8 × NVIDIA A100 SXM4, har bir GPU uchun 40 GiB HBM2 |
| CPU referansi | 100 × Intel Xeon Platinum 8470 yadrosi, 2,00 GHz |
| Eng yuqori qayd etilgan tezlashish | Taxminan 6× |
| 1400³ xotira talabi | Manba tizimida faqat 4 ta H100 bilan ishga tushirilishi mumkin bo‘lgan |
| 1400³ nisbiy ishlash vaqti | CPU vaqtining taxminan 17% i |
Multiphysics benchmark ko‘lami
| Ko‘rsatkich | Manba qiymati |
|---|---|
| Model | 3B hydrodynamic PFC |
| Fizik maydonlar | ψ, v₁, v₂, v₃ |
| GPU soni | 4 × NVIDIA H100 |
| Har bir GPU uchun maydon | Bitta asosiy fizik maydon |
| 1(b)-rasm benchmark o‘lchamlari | 750³–900³ |
| Eng yuqori qayd etilgan tezlashish | CPU referansiga nisbatan taxminan 60× |
| 2(b)-rasmdagi alohida namuna gridi | 1400³ |
Nima uchun H100 va A100 natijalarini to‘g‘ridan-to‘g‘ri GPU soni orqali o‘qimaslik kerak?
H100 va A100 tizimlari faqat GPU soni jihatidan farq qilmaydi. Manbada H100 har bir GPU uchun 94 GiB HBM2e, A100 esa har bir GPU uchun 40 GiB HBM2 xotiradan foydalanadi. Shu sababli, aynan bir xil muammo uchun “to‘rtta GPU” yoki “sakkizta GPU” ifodasi o‘z-o‘zidan ekvivalent hisoblash resursini anglatmaydi.
1(a)-rasmda turli GPU oilalari har xil egri chiziqlar bilan ko‘rsatilgan. Natijalar GPU sonidan tashqari, GPU arxitekturasi, xotira sig‘imi va interconnect xususiyatlari bilan birgalikda talqin qilinishi kerak.
Hisoblash maydonining fizik miqyosi
| Namuna | Grid | Manbada berilgan fizik miqyos |
|---|---|---|
| 2B dendritik qotish | 50.000 × 50.000 | 2,5 µm × 2,5 µm; 4 Å Al panjara doimiysi farazi bilan |
| 3B polikristal yiriklashish | 1400 × 1400 × 1400 | 40 nm × 40 nm × 40 nm |
Ushbu namunalar PFC yondashuvining asosiy hisoblash qiyinchiligini namoyon etadi: fizik maydon mikrometr yoki o‘nlab nanometr darajasida bo‘lsa ham, kristal panjaraning atom darajasidagi tuzilishini yechish uchun milliardlab grid nuqtalari talab qilinishi mumkin.
2(a)-rasmdagi dendritik naqsh nimani isbotlaydi?
2(a)-rasm multi-GPU single-FFT ilovasining yirik ikki o‘lchamli PFC qotish muammosida ishlatilishi mumkinligini ko‘rsatadi. Rasm fizik materialda o‘lchangan dendritning tajriba tasviri emas.
Shu sababli, tasvirdan haqiqiy alyuminiy dendrit morfologiyasi miqdoriy jihatdan tasdiqlangani haqida xulosa chiqarib bo‘lmaydi. Manba misoldan ko‘p GPU'li hisoblashning yirik PFC maydonidagi qo‘llanilishini ko‘rsatish maqsadida foydalanadi.
2(b)-rasmda tezlik maydonlarining ko‘rsatilishining ma'nosi nima?
Hydrodynamic PFC faqatgina zichlik o‘zgaruvchisini emas, balki uch komponentli tezlik maydonini ham yechadi. 2(b)-rasmda (psi) bilan birgalikda (v_1), (v_2) va (v_3) ning alohida hajmli vizuallashtirishlari berilishi, ikkinchi GPU strategiyasidagi to‘rtta fizik maydon ajratilishining bevosita model o‘zgaruvchilariga mos kelishini ko‘rsatadi.
Boshqacha aytganda, to‘rtta GPU dan foydalanish faqat texnik jihatdan massivni to‘rt qismga bo‘lish degani emas; har bir GPU modeldagi ma'lum bir fizik maydonning hisoblash yuklamasini ko‘taradi.
Usulning kelajakdagi masshtablashuv maqsadi nima?
Mualliflar ikkinchi strategiya principal Fourier modes uchun complex amplitude'dan foydalanadigan coarse-grained PFC modellariga tabiiy ravishda kengayishi mumkinligini ta'kidlamoqdalar. Bu kabi modellar o‘nlab coupled complex-valued field larni o‘z ichiga olishi mumkin.
Manba ushbu tuzilmalarning field-level GPU parallelization uchun alohida mos kelishini kutmoqda; ammo tadqiqotda o‘nlab kompleks maydonlardan foydalanuvchi yangi benchmark taqdim etilmagan. Shuning uchun mazkur afzallik kelajakdagi foydalanish kutilmasi bo‘lib, mavjud sonli natija emas.
Unumdorlik natijalarining asosiy talqini
Tadqiqotning ikkala strategiyasidan olingan umumiy xulosa shuki, ko‘p GPU dan foydalanish faqatgina ko‘proq hisoblash birligini qo‘shish sifatida baholanmasligi kerak.
Bitta FFT strategiyasida aloqa xarajati tufayli kichik muammolarda bitta GPU tezroq bo‘lishi mumkin; yirik muammolarda esa ko‘p GPU birinchi navbatda xotira chegarasidan oshib, simulyatsiyani amalga oshirish imkonini beradi.
Multiphysics strategiyasida mustaqil fizik maydonlarning tabiiy ajralishi turli GPU'larning bir vaqtda ishlashiga ko‘proq imkoniyat yaratadi va manba benchmark'ida ancha yuqori tezlashishga erishadi.
Benchmark natijalarini umumlashtirishda qaysi o‘zgaruvchilar muhim?
- GPU modeli va har bir GPU uchun xotira sig‘imi,
- GPU'lar o‘rtasidagi aloqa topologiyasi va o‘tkazuvchanlik qobiliyati,
- Muammo o‘lchami,
- FFT o‘lchamlari,
- Har bir GPU dagi mahalliy hisoblash/aloqa nisbati,
- Fizik maydonlar soni,
- Vaqt integratsiyasi usuli,
- CPU referans arxitekturasi,
- MATLAB va parallel hisoblash muhitining ilovaviy tafsilotlari.
Tadqiqot ushbu omillarning barchasi uchun alohida sezgirlik tahlilini taqdim etmaydi. Shu sababli 6× va 60× qiymatlari qayd etilgan HPC konfiguratsiyalarining natijalari sifatida saqlanishi kerak.
Tadqiqotning kuchli tomonlari
- Faqat FFT mikrobenchmark'i o‘rniga, haqiqiy yuqori tartibli PDE foydalanish ssenariysi taqdim etilgan.
- Ham domain decomposition, ham field decomposition yondashuvi bir xil MATLAB doirasida ko‘rsatilgan.
- H100 va A100 ga asoslangan bir nechta GPU tizimlaridan foydalanilgan.
- CPU referansi ochiq apparat ma'lumotlari bilan berilgan.
- Bitta GPU xotirasiga sig‘maydigan muammo o‘lchamlari bevosita sinovdan o‘tkazilgan.
- MATLAB implementation snippet'lari ulashilgan.
- To‘liq manba kodi ombori va Zenodo yozuvi taqdim etilgan.
- 2B va 3B PFC foydalanish namunalari vizual tarzda ko‘rsatilgan.
Asosiy cheklovlar
- Hukmron natija metrikasi ishlash vaqtidir; alohida sonli aniqlik benchmark'i cheklangan.
- GPU–GPU aloqa xarajati alohida vaqt komponentlariga ajratilmagan.
- Energiya sarfi va unumdorlik/vatt o‘lchanmagan.
- Turli GPU ishlab chiqaruvchilari yoki turli NVIDIA avlodlari keng qamrovli sinovdan o‘tkazilmagan.
- Benchmark yagona PFC muammolari oilasi atrofida shakllantirilgan.
- Tadqiqot haqiqiy tajribaviy material mikrostrukturasi bilan miqdoriy model validatsiyasi maqsadini ko‘zlamagan.
- Manbada hydrodynamic PFC uchun 900³ benchmark chegarasi va 1400³ reprezentativ vizual o‘rtasida izohlanmagan o‘lcham farqi mavjud.
- Dasturiy ta'minot ro‘yxatlari usulni ko‘rsatadi, biroq ular o‘z holicha barcha boshlang‘ich va ishlash parametrlarini o‘z ichiga olgan mustaqil bajariladigan dasturlar emas.
Manba va Usul Bo‘yicha Izoh
To‘liq asl tadqiqot nomi: Multi-GPU fast Fourier transforms in MATLAB for large-scale phase-field crystal simulations
Bibliografik sarlavha izohi: Yuklangan PDF sarlavhasi yuqoridagi qavssiz shakldadir. arXiv metadata yozuvi sarlavhasi “Multi-GPU fast Fourier transforms in MATLAB (for large-scale phase-field crystal simulations)” shaklida bo‘lib, ikkinchi qismini qavs ichida ko‘rsatadi. Asl PDF sarlavhasi o‘zboshimchalik bilan o‘zgartirilmagan.
Mualliflar va asl ketma-ketlik: Maik Punke; Marco Salvalaglio.
Tashkilot: Institute of Scientific Computing, TU Dresden, 01062 Dresden, Germany.
Ikkinchi tashkilot: Dresden Center for Computational Materials Science, TU Dresden, 01062 Dresden, Germany; Marco Salvalaglio uchun manbada ikkinchi afiliyatsiya sifatida ko‘rsatilgan.
Ma'sul muallif: Yuklangan PDF da alohida “corresponding author” yorlig‘i mavjud emas. Har ikki muallifning ismida afiliyatsiya belgilari bor, elektron pochta/ma'sul muallif belgisi ochiq ko‘rsatilmagan.
Teng birinchi/teng hissa: Yuklangan versiyada teng hissa bayonoti mavjud emas.
Manba turi: MATLAB'ga asoslangan yuqori unumdorli hisoblash, ilmiy dasturiy ta'minot va sonli simulyatsiya tadqiqoti.
Nashr holati: Yuklangan tadqiqot arXiv da e'lon qilingan va taqrizdan o‘tgan alohida jurnal versiyasi tasdiqlanmagan preprintdir. Xulosalar ushbu nashr bosqichini hisobga olgan holda baholanishi kerak.
Platforma: arXiv.
arXiv identifikatori: 2603.26818v1 [cs.MS].
Asosiy toifa: Mathematical Software (cs.MS).
Qo‘shimcha toifalar: Materials Science (cond-mat.mtrl-sci) va Computational Physics (physics.comp-ph).
arXiv birinchi yuborilgan sana: 26-mart 2026-yil.
PDF dagi yozilgan sana: 31-mart 2026-yil.
arXiv DOI: 10.48550/arXiv.2603.26818.
Ilmiy usul: Fourier pseudo-spectral yechim; ko‘p GPU'li domain decomposition; slab decomposition; peer-to-peer ma'lumotlarni qayta taqsimlash; field-level multiphysics parallelization; semi-implicit va manba kod listing'larida ko‘rsatilgan implicit vaqt yangilanishlari.
Asosiy ilova: Ikki va uch o‘lchamli phase-field crystal simulyatsiyalari.
Benchmark GPU'lari: 4 × NVIDIA H100 SXM5 (94 GiB HBM2e/GPU) va 8 × NVIDIA A100 SXM4 (40 GiB HBM2/GPU).
CPU referansi: Intel Xeon Platinum 8470, jami 100 yadro, 2,00 GHz.
HPC infratuzilmasi: TU Dresden NHR Center qoshidagi Capella, Alpha Centauri va Barnard tizimlari.
Manba kodi ombori: https://github.com/mpunke/MATLABmultiGPUFFT/
Dasturiy ta'minot litsenziyasi: MIT License.
Zenodo DOI: 10.5281/zenodo.18670913.
Asosiy benchmark natijasi: Standart PFC uchun CPU referansiga nisbatan taxminan 6× gacha, hydrodynamic multiphysics PFC uchun taxminan 60× gacha tezlashish ma'lum qilingan.
Benchmark talqini: Bu qiymatlar ayni muammo ustida bir xil protsessor resurslarini solishtiruvchi sof algoritmik scaling koeffitsiyentlari emas. GPU va CPU tomonlari turli arxitekturalar va xotira tizimlariga ega.
Manba ichidagi ifoda izohi — CPU yadrosi: Tadqiqotning Summary qismi CPU ilovasini “hundreds of cores” ifodasi bilan ta'riflasa-da, batafsil benchmark izohi va 1-rasm ochiqchasiga 100 CPU yadrosini referans qilib oladi. Sonli taqqoslashlarda batafsil benchmark'dagi 100 yadro ma'lumotidan foydalanildi.
Manba ichidagi qamrov izohi — hydrodynamic PFC o‘lchami: 1(b)-rasm izohida benchmark'ning ko‘p GPU bilan 900³ muammo o‘lchamigacha yetgani ko‘rsatiladi. 2(b)-rasm esa hydrodynamic PFC uchun 1400³ grid dan foydalanuvchi alohida polikristal yiriklashish namunasini ko‘rsatadi. Manba ushbu ikki holatning ishlash sharoitlari o‘rtasidagi farqni izohlamagani uchun, 1400³ qiymat benchmark grafigining to‘g‘ridan-to‘g‘ri qo‘shimcha ma'lumot nuqtasi sifatida talqin qilinmadi.
Kod listing chegarasi: Listing 1 va Listing 2 algoritmning asosiy parallel ma'lumotlar oqimini ko‘rsatadi; boshlang‘ich massivlarning, ajratish indekslarining va barcha yordamchi o‘zgaruvchilarning to‘liq tavsiflarini o‘z ichiga olgan mustaqil to‘liq dastur emas. Bajarilishi mumkin bo‘lgan ilova uchun asosiy manba omboriga alohida murojaat qilish kerak.
O‘ziga xoslik da'vosi chegarasi: Mualliflar tadqiqotni MATLAB'dagi ilk multi-GPU FFT implementatsiyasi sifatida ta'riflaydilar. Bu ifoda manba mualliflarining mavjud adabiyot/dasturiy ta'minotni baholashiga asoslanadi va mustaqil keng qamrovli global dasturiy ta'minot inventari sifatida tasdiqlanmagan.
Moliyalashtirish: Tadqiqot Deutsche Forschungsgemeinschaft (DFG) tomonidan 447241406 va 493401063 loyiha raqamlari bilan qo‘llab-quvvatlangan.
Hisoblash resursi: Mualliflar TU Dresden NHR Center yuqori unumdorli hisoblash tizimlaridan foydalanganliklarini minnatdorchilik bo‘limida alohida qayd etishadi.
Manfaatlar to‘qnashuvi: Yuklangan matnda alohida competing-interest yoki conflict-of-interest bayonoti mavjud emas; bundan manfaatlar to‘qnashuvi yo‘q degan xulosa chiqarilmagan.
CRediT/muallif hissalari: Yuklangan versiyada alohida CRediT authorship contribution statement mavjud emas.
Ilmiy tasdiqlash chegarasi: Tadqiqotning asosiy tasdig‘i hisoblash unumdorligi va yirik muammo o‘lchamlarining ishga tushirilishi mumkinligidadir. Haqiqiy material tajribalari bilan mikrostruktura validatsiyasi, FFT sonli xato benchmark'i, energiya samaradorligi yoki keng qamrovli strong/weak scaling tahlili tadqiqotning asosiy baholash to‘plamida hisobot qilinmagan.
Ilmiy tarkib chegarasi: Ushbu Verianla maqolasidagi PFC tenglamalari, FFT algoritmlari, ko‘p GPU'li strategiyalar, apparat ma'lumotlari, benchmark natijalari va 1–2 rasmlarning talqinlari yuklangan tadqiqotga asoslanadi. Tashqi bibliografik tekshiruv faqat arXiv identifikatori, DOI, joriy nashr holati va dasturiy ta'minotni tarqatish yozuvini tasdiqlash maqsadida ishlatilgan; manbada mavjud bo‘lmagan yangi simulyatsiya natijasi qo‘shilmagan.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan