

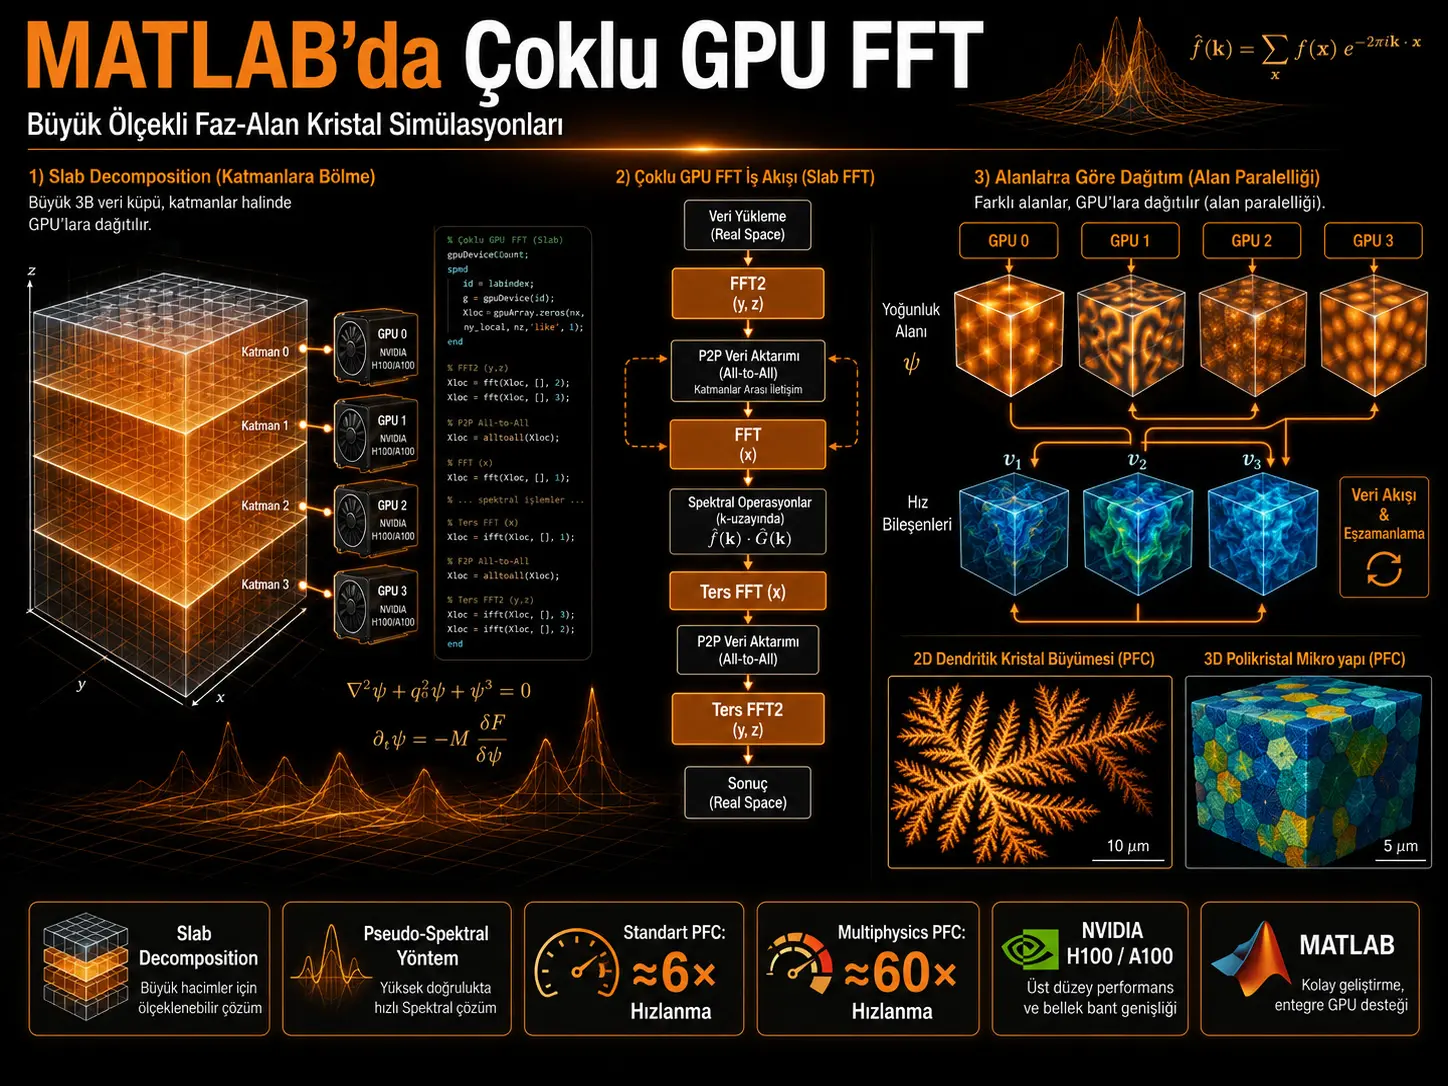
Бул изилдөө MATLAB чөйрөсүндө эки жана үч өлчөмдүү тез Фурье өзгөртүүлөрүн (Fast Fourier Transform, FFT) бир нече GPU'га бөлүштүрүү аркылуу, бир GPU эс тутуму менен чектелген ири масштабдуу псевдо-спектралдык симуляцияларды иштетүүгө багытталган эки кошумча параллелдештирүү стратегиясын иштеп чыгат. Биринчи ыкмада бир чоң үч өлчөмдүү FFT, мейкиндик талаасынын слаб декомпозициясы (slab decomposition) ыкмасы менен GPU'ларга бөлүнүшү, ар бир GPU'да жергиликтүү эки өлчөмдүү FFT колдонулушу, peer-to-peer берилиштерди кайра бөлүштүрүү жана калган огу боюнча бир өлчөмдүү FFT аткаруу аркылуу эсептелет. Экинчи ыкмада болсо көп талаалуу физикалык моделдердеги ар кандай өзгөрмөлөр өзүнчө GPU'ларга ыйгарылып, ар бир убакыт кадамында GPU'лар арасында синхрондоштурулган берилиштерди өткөрүп берүү жүргүзүлөт.
Методдор фазалык-талаа кристалл (Phase-Field Crystal, PFC) моделдеринде сыналган. Стандарттуу үч өлчөмдүү PFC симуляцияларында 750³–1400³ диапазонундагы көйгөйлөр үчүн GPU эсептөөлөрү төрт NVIDIA H100 же сегиз NVIDIA A100 GPU менен жүргүзүлгөн; 100 ядролуу Intel Xeon Platinum 8470 CPU эталонуна салыштырмалуу болжол менен алты эсеге чейин тездетүү катталган. 1400³ массив төрт H100 GPU'сунда гана эс тутумга баткан жана булак 1(a)-сүрөттө иштөө убактысы CPU убактысынын болжол менен 17%ына чейин кыскарганын белгилеген. Төрт физикалык талаа төрт H100 GPU'суна бөлүштүрүлгөн гидродинамикалык PFC ыкмасында болсо, булак CPU колдонмосуна салыштырмалуу 60 эсеге чейин тездетүүнү билдирет.
Жыйынтыктардын эң маанилүү чечмелөө чеги – билдирилген тездетүүлөрдүн белгилүү бир HPC жабдыктары, GPU эс тутуму, GPU–GPU байланыш түзүмү, MATLAB колдонмосу жана PFC алгоритмдери үчүн өлчөнгөндүгү. Изилдөө ар бир FFT көйгөйүндө көбүрөөк GPU колдонуу дайыма эле ылдамыраак болоорун көрсөтпөйт; тескерисинче, кичинекей 750³ көйгөйүндө бир H100 GPU эң жакшы натыйжа берсе, кошумча GPU'лардын байланыш баасы өндүрүмдүүлүктүн артыкчылыгын азайтат. Изилдөөнүн негизги салымы, ошондуктан, иштетүү ылдамдыгын жогорулатуу гана эмес, бир GPU эс тутумуна батпаган жогорку чечилиштеги спектралдык көйгөйлөрдүн MATLAB ичинде иштетилишин камсыз кылуу болуп саналат.
Эмне үчүн ири масштабдуу FFT симуляцияларында бир GPU бөгөт жаратат?
Псевдо-спектралдык Фурье ыкмаларында жогорку даражалуу мейкиндик туундулары Фурье мейкиндигинде натыйжалуу түрдө эсептелет; бирок сызыктуу эмес бөлүк физикалык мейкиндикте баалангандыктан, ар бир убакыт кадамында түз жана тескери FFT операциялары кайра-кайра иштетилет. Массивдердин өлчөмдөрү чоңойгон сайын FFT эсептөө баасы да, GPU эс тутумунда сакталышы керек болгон көп өлчөмдүү маалыматтын көлөмү да ылдам өсөт.
Фазалык-талаа кристалл моделдери бул көйгөйдү айкын кылат. PFC ыкмасы кристаллдык тартипти атомдук узундук масштабында чечүүгө аракет кылып жатканда микротүзүмдүн алда канча чоңураак мейкиндик жана диффузиялык убакыт масштабдарындагы өнүгүүсүн көзөмөлдөйт. Натыйжада бир жагынан жогорку мейкиндик чечилиш, экинчи жагынан кеңири эсептөө талаасы талап кылынат.
Бир нече тыгыздык, курам, ылдамдык же температура талааларын камтыган көп физикалык (multiphysics) моделдеринде бир эле учурда бир нече чоң үч өлчөмдүү талааны сактоо керек болгондуктан, бир GPU эс тутуму ого бетер критикалык чектөөгө айланат.
Фурье псевдо-спектралдык ыкмасынын негизги теңдемеси кайсы?
Булак ыкманы түшүндүрүү үчүн алгач бир өлчөмдүү жалпы өнүгүү теңдемесин колдонот:
\[ partial_t u=mathcal{L}u+mathcal{N}(u), qquad xin[0,2pi),;tgeq0 \]
Бул жерде (mathcal L) сызыктуу дифференциалдык операторду, ал эми (mathcal N(u)) болсо (u)'нун полином формасындагы сызыктуу эмес бөлүгүн билдирет.
Мезгилдүү талаадагы чечим чектүү Фурье сериясы менен болжолдуу түрдө:
\[ u(x,t)approx u_N(x,t) = sum_{k=-K}^{K} widehat{u}_k e^{ikx} \]
түрүндө туюнтулат жана:
[ N=2K+1 ]
Фурье режими (mode) колдонулат.
Бирдей аралыктагы коллакация чекиттери:
\[ x_j=frac{2pi j}{N}, qquad j=0,ldots,N-1 \]
катары аныкталган.
Дифференциалдык теңдеме Фурье мейкиндигинде кантип өзгөрөт?
Фурье өзгөртүүсү колдонулганда ар бир Фурье режими үчүн:
\[ partial_twidehat{u}_k = widehat{mathcal L}_kwidehat{u}_k+ widehat{[mathcal N(u)]}_k \]
формасындагы кадимки дифференциалдык теңдеме алынат.
Мейкиндик туундулары Фурье мейкиндигинде жөнөкөй көбөйтүүлөргө айланат:
\[ widehat{[partial_x^n u]}_k = (ik)^nwidehat{u}_k. \]
Бул өзгөчөлүк жогорку даражалуу PDE'лерде (жарым-жартылай дифференциалдык теңдемелерде) өзгөчө баалуу. Бирок сызыктуу эмес (mathcal N(u)) термини физикалык мейкиндикте чекиттик негизде эсептелгендиктен, алгоритм дайыма Фурье мейкиндиги менен физикалык мейкиндиктин ортосунда ары-бери өтүп турат.
Бир убакыт кадамынын негизги агымы төмөнкүдөй:
- Талаа FFT аркылуу Фурье мейкиндигине өзгөртүлөт.
- Сызыктуу эмес термин физикалык мейкиндикте эсептелип, кайрадан FFT аркылуу өзгөртүлөт.
- Фурье коэффициенттеринин убакыт боюнча өнүгүүсү эсептелет.
- Тескери FFT аркылуу жаңы физикалык талаа алынат.
Ири масштабдуу эсептөөлөрдө бул кайталанма көп өлчөмдүү FFT'лер жалпы иштөө убактысынын негизги компоненттеринин бирине айланат.
Биринчи стратегия: Бир чоң 3Ө FFT бир нече GPU'га кантип бөлүштүрүлөт?
Изилдөөнүн алгачкы стратегиясы, бирдиктүү:
\[ N_ximes N_yimes N_z \]
өлчөмдүү массивди (G) GPU'га бөлүү аркылуу бир жогорку өлчөмдүү FFT'нин көп GPU үстүндө аткарылышы болуп саналат.
Берилиштер z багытында слаб декомпозициясын (slab decomposition) колдонуу менен бөлүнөт. Ар бир GPU башында глобалдык массивдин өзүнүн жергиликтүү слабын гана сактайт.
Түз FFT үч негизги баскычта жүргүзүлөт:
- Ар бир GPU өзүнүн жергиликтүү маалымат бөлүгүндө алгачкы эки өлчөм боюнча
fft2иштетет. - GPU'лар peer-to-peer (теңден-теңге) байланыш аркылуу маалымат бөлүктөрүн кайра бөлүштүрөт.
- Кайрадан түзүлгөн маалымат үстүндө үчүнчү өлчөм боюнча
fft(...,3)иштетилет.
Бул процесстин аягында глобалдык Фурье өзгөртүүсү аяктаган болсо да, өзгөртүүнүн бардыгы бир GPU'да болбойт; ар бир GPU Фурье мейкиндигиндеги жыйынтыктын бир бөлүгүн алып жүрөт.
P2P байланышы эмне үчүн керек?
Жергиликтүү fft2 операциялары GPU ээ болгон слабдагы эки огу гана өзгөртө алат. Үчүнчү октогу FFT үчүн бирдей өзгөртүү багытына таандык маалымат элементтеринин тийиштүү GPU'да чогултулушу зарыл.
Ошондуктан жергиликтүү FFT'лерден кийин берилиштер GPU'лар арасында кайрадан түзүлөт. Булак MATLAB колдонмосунда бул баскычты spmd параллелдүү сессиясы жана spmdCat негизиндеги маалыматтарды бириктирүү процесстери менен көрсөтөт.
Тескери FFT'де тартип тескерисинче өзгөрөт: үчүнчү өлчөмдө ifft, P2P кайра бөлүштүрүү жана алгачкы эки өлчөмдө ifft2.
Verianla Live: Бир 3Ө FFT'нин көп GPU үстүндө иштетилиши
| Кадам | Процесс | MATLAB / GPU эквиваленти |
|---|---|---|
| 1. Слаб декомпозициясы | 3Ө массив z багытында G GPU арасында бөлүнөт. | Ар бир GPU глобалдык массивдин жергиликтүү слабын (slab) гана сактайт. |
| 2. Жергиликтүү 2Ө FFT | Ар бир слабдын алгачкы эки өлчөмү көз карандысыз өзгөртүлөт. | fft2 |
| 3. P2P кайра бөлүштүрүү | Үчүнчү окто FFT жасалышы үчүн маалымат бөлүктөрү GPU'лар арасында кайра түзүлөт. | spmd / spmdCat |
| 4. Калган 1Ө FFT | Үчүнчү мейкиндик өлчөмү Фурье мейкиндигине өзгөртүлөт. | fft(...,3) |
| 5. Спектралдык убакыт кадамы | PFC талаасынын Фурье коэффициенттери жарым-имплициттик (semi-implicit) ыкма менен жаңыртылат. | Элементке негизделген Fourier-space (Фурье-мейкиндиги) операциясы |
| 6. Тескери 1Ө FFT | Үчүнчү өлчөмдө физикалык мейкиндикке кайтуу башталат. | ifft(...,3) |
| 7. Тескери P2P бөлүштүрүү | Маалымат кайрадан жергиликтүү слаб тартибине келтирилет. | spmdCat |
| 8. Тескери 2Ө FFT | Алгачкы эки өлчөмдө физикалык талаа кайрадан алынат. | ifft2 |
Verianla Live: Процесс изилдөөнүн 1(a)-сүрөтүнө жана Listing 1'деги MATLAB колдонмосуна негизделген. Көрүнүп турган таблица илимий чындык булагы (source-of-truth) катары сакталат.
Phase-Field Crystal модели кайсы физикалык көйгөйдү билдирет?
PFC модели кристаллдык тыгыздык тартибинин мейкиндик жана убакыт боюнча өнүгүүсүн бирдиктүү үзгүлтүксүз тыгыздык талаасы (psi(mathbf{x},t)) аркылуу көрсөтөт. Булак, мисал катары гранга борборлошкон кубдук (face-centered cubic, FCC) симметрия үчүн эркин энергия функционалын:
\[ F[psi] = int_{Omega} left[ frac{psi}{2} (varepsilon+mathcal L)psi+ frac{psi^4}{4} ight]dmathbf r \]
түрүндө берет.
Бул жерде:
\[ mathcal L= (1+abla^2)^2 left(frac{4}{3}+abla^2ight)^2 \]
мейкиндик корреляцияларын аныктаган оператор болуп саналат жана (varepsilon) болсо ашыкча муздатуу (undercooling) параметри болуп эсептелет.
Классикалык PFC динамикасы:
\[ partial_tpsi = abla^2 frac{delta F[psi]}{deltapsi} = (varepsilon+mathcal L)abla^2psi+ abla^2psi^3 \]
менен туюнтулат.
(mathcal L) ичинде удаалаш Лаплас операторлорунун болушу жана сыртында кошумча (abla^2) колдонулушуна байланыштуу, PFC теңдемеси булакта онунчу даражадагы PDE классында аныкталган.
MATLAB убакыт кадамын кантип жаңыртат?
Listing 1'де Фурье мейкиндигиндеги тыгыздык талаасы жарым-имплициттик түрдө:
psiF = (psiF + dt*lap.*psi)./(1 - dt*lin);
формасындагы элементке негизделген жаңыртуу менен алдыга жылдырылат.
Бул жердеги негизги эсептөө чынжырында:
psiфизикалык тыгыздык талаасын,psiFФурье өзгөртүүсү жасалган тыгыздыкты,lapдискреттик Лаплас операторун,linдискреттик сызыктуу операторду,dtубакыт кадамын
билдирет.
Булак листингдери (listing) толук программалык топтомдун баары эмес, методдун иштөө логикасын көрсөткөн колдонмо үзүндүлөрү (implementation snippets) болуп саналат. Керектүү баштапкы өзгөрмөлөрдүн жана маалыматты бөлүү индекстеринин толук аныктамалары макаланын код блогунда берилбейт; аткарыла турган толук колдонмо өзүнчө баштапкы код репозиторийинде сунушталат.
Биринчи эталондук тестирлөө (benchmark) кайсы жабдыктарда жасалды?
| Эсептөө булагы | Булакта көрсөтүлгөн жабдык | Эталондук тестирлөөнүн ролу |
|---|---|---|
| GPU системасы 1 | 4 × NVIDIA H100 SXM5, ар бир GPU үчүн 94 GiB HBM2e | Capella HPC кластери |
| GPU системасы 2 | 8 × NVIDIA A100 SXM4, ар бир GPU үчүн 40 GiB HBM2 | Alpha Centauri HPC кластери |
| CPU эталону | Intel Xeon Platinum 8470, жалпы 100 ядро, 2,00 GHz | Barnard HPC кластери |
Ошондуктан билдирилген GPU/CPU тездетүүсү кодду параллелдештирүүнү гана эмес, бири-биринен айырмаланган эсептөө архитектураларынын өндүрүмдүүлүгүн да камтыйт. Жыйынтыктар ошол эле жабдык үстүндө CPU/GPU режимин гана өзгөрткөн көзөмөлдөнгөн микро-эталондук тестирлөө (mikrobenchmark) катары чечмеленбеши керек.
750³ көйгөйүндө эмне үчүн көбүрөөк GPU ылдамыраак эмес?
Изилдөөнүн 1(a)-сүрөтү маанилүү масштабдуулук чегин көрсөтөт: 750³ өлчөмүндөгү көйгөй үчүн H100 үстүндө эң жакшы өндүрүмдүүлүк бир GPU менен алынган.
Көйгөй бир GPU эс тутумуна кенен батканда, кошумча GPU'лар эсептөө жүгүн бөлүшсө да, P2P маалымат кыймылы жана синхрондоштуруу баасы пайда болот. Кичине же орто масштабдуу көйгөйдө бул байланыш баасы параллелдештирүү пайдасынан чоңураак болушу мүмкүн.
Ошондуктан изилдөөнүн жыйынтыгы “GPU санын көбөйткөн сайын FFT дайыма ылдамдайт” дегенди билдирбейт. Көп GPU ыкмасынын баалуулугу, көйгөйдүн өлчөмү бир GPU чегинен аша баштаганда айкын болот.
1400³ көйгөйүндө эмне болот?
Булакка ылайык, (1400^3) өлчөмүндөгү массив төрт H100 GPU колдонулганда гана эс тутумга бата алган.
1(a)-сүрөттүн түшүндүрмөсүндө бул конфигурациянын иштөө убактысы 100 ядролуу CPU эталонунун болжол менен:
[ 0.17 ]
эсеси, б.а. болжол менен 17%ы катары берилген.
Бул катыш болжол менен алты эселик тездетүүгө туура келет жана макаланын стандарттуу PFC үчүн билдирген “алты эсеге чейин” (up to sixfold) жыйынтыгынын негизин түзөт.
Бирок бул жыйынтыкты бардык PFC өлчөмдөрүнө жалпылоо туура эмес. Сүрөт ошол эле учурда көрсөткөндөй, оптималдуу GPU саны көйгөйдүн чоңдугуна жана колдонулган GPU үй-бүлөсүнө жараша өзгөрөт.
Экинчи стратегия эмнеси менен айырмаланат?
Экинчи стратегия бир FFT'ни GPU'ларга бөлүүнүн ордуна, көп физикалык (multiphysics) моделдеги ар кандай физикалык талааларды өзүнчө GPU'ларга бөлүштүрөт.
Булак гидродинамикалык PFC моделин мисалга алат. Тыгыздык талаасына үч компоненттүү мезоскопиялык ылдамдык талаасы кошулат:
\[ mathbf v= (v_1,v_2,v_3). \]
Модель:
\[ partial_tpsi = abla^2 left( frac{delta F[psi]}{deltapsi} ight) - mathbf vcdotablapsi \]
жана:
\[ hopartial_tmathbf v = Gammaabla^2mathbf v - leftlangle psiabla frac{delta F[psi]}{deltapsi} ightangle \]
теңдемелери менен аныкталат.
Төрт GPU'га кайсы талаалар ыйгарылат?
Изилдөөнүн 1(b)-сүрөтү жана Listing 2 бөлүштүрүүнү ачык түрдө көрсөтөт:
| GPU | Негизги физикалык талаа |
|---|---|
| GPU 1 | Тыгыздык талаасы (psi) |
| GPU 2 | Ылдамдык компоненти (v_1) |
| GPU 3 | Ылдамдык компоненти (v_2) |
| GPU 4 | Ылдамдык компоненти (v_3) |
GPU 1 тыгыздык талаасын жаңырткандан кийин жаңы (psi)'ни башка үч GPU'га жөнөтөт. GPU 2–4 өз ылдамдык компоненттерин жаңыртып, жыйынтыктарды кайра GPU 1'ге жөнөтүшөт.
MATLAB кодунда бул маалымат алмашуу spmdSend жана spmdReceive менен ишке ашырылат.
Гаусс конволюциясы эмне үчүн Фурье ыкмасына ылайыктуу?
Гидродинамикалык PFC моделиндеги жергиликтүү орточо маани:
\[ langlecdotangle(mathbf r) = int_{Omega} frac{ (cdot)(mathbf r') }{ (2pi a_0^2)^{3/2} } exp left[ -frac{ (mathbf r-mathbf r')^2 }{ 2a_0^2 } ight] dmathbf r' \]
формасындагы Гаусс конволюциясы (Gaussian convolution) менен аныкталат.
Фурье өзгөртүүсүнүн конволюциялык өзгөчөлүгү аркасында бул интеграл Фурье мейкиндигинде көбөйтүүгө айланат. Ошентип PFC'нин жогорку даражалуу дифференциалдык операторлорундагыдай эле конволюция операциясы да псевдо-спектралдык ыкманын эсептөө түзүмүнө табигый түрдө ыңгайлашат.
Көп физикалык (Multiphysics) моделде 60 эсе тездетүү эмнени түшүндүрөт?
Булак төрт NVIDIA H100 GPU үстүндө иштетилген гидродинамикалык PFC чечүүчүсү (solver) үчүн 100 ядролуу CPU колдонмосуна салыштырмалуу 60 эсеге чейин тездетүүнү билдирет.
Бул маани стандарттуу PFC'деги болжол менен алты эселик тездетүү менен түздөн-түз бирдей параллелдештирүү сценарийи эмес. Стандарттуу PFC эталондук тестирлөөсүндө бир чоң FFT слаб декомпозициясы аркылуу бир нече GPU'га жайылтылса, гидродинамикалык PFC ыкмасында төрт өзүнчө физикалык талаа төрт GPU'га бөлүштүрүлөт.
Ошондуктан 6× жана 60× маанилери эки башка көп GPU стратегиясынын ар кандай көйгөй түзүмдөрүнө колдонулушунан алынган.
Verianla Live: Эки көп GPU стратегиясын салыштыруу
| Өзгөчөлүк | Бир FFT'ни Көп GPU'га Бөлүү | Көп физикалык (Multiphysics) талааларды GPU'ларга бөлүштүрүү |
|---|---|---|
| Негизги максат | Бир чоң 3Ө FFT'нин бир GPU эс тутумунан аша алышы | Бир нече чоң физикалык талаанын бир убакта иштетилиши |
| Параллелдештирүү формасы | z багытында слаб декомпозициясы + P2P кайра бөлүштүрүү | Ар бир физикалык талаа өзүнчө GPU'да |
| Негизги MATLAB байланыш түзүмү | spmd / spmdCat | spmdSend / spmdReceive |
| GPU системалары | 4× H100 же 8× A100 | 4× H100 |
| Булакта белгиленген көйгөй чөйрөсү | 750³–1400³ | 1(b)-сүрөттө 750³–900³ |
| Катталган эң жогорку тездетүү | Болжол менен 6× | Болжол менен 60× |
| Кошумча булак визуалы | 2Ө дендриттик катуулануу | 1400³ 3Ө поликристаллдык ирилешүү мисалы |
Verianla Live: Маалыматтар изилдөөнүн 1-сүрөтүнө, 2-сүрөтүнө жана ыкманын түшүндүрмөлөрүнө негизделген. 1(b)-сүрөтүндөгү 900³ эталондук чеги менен 2(b)-сүрөтүндөгү 1400³ өкүлчүлүктүү гидродинамикалык PFC мисалы булакта өз-өзүнчө берилгендиктен, бул жерде бириктирилген эмес.
1(a)-сүрөтү өндүрүмдүүлүк боюнча эмне дейт?
11-беттеги 1(a)-сүрөтүнүн жогорку панели үч өлчөмдүү массивдин слабдарга бөлүнүшүн, жергиликтүү fft2 эсептөөлөрүн, P2P маалымат алмашууну жана акыркы fft баскычын көрсөтөт.
Төмөнкү панелде иштөө убактысы 100 CPU ядросундагы убакытка нормалдаштырылган. Эң маанилүү тенденция төмөнкүдөй:
- 750³ сыяктуу кичинекей көйгөйдө бир GPU эң натыйжалуу.
- Көйгөй чоңойгон сайын көбүрөөк GPU эс тутуму зарыл болуп калат.
- 1400³ массив төрт H100 GPU менен гана иштетиле алган.
- Бул чоң конфигурация CPU иштөө убактысынын болжол менен 17%ына жеткен.
Ошентип, сүрөт тездетүүнү да, эс тутумду масштабдоо артыкчылыгын да көрсөтөт.
Эмне үчүн 1(b)-сүрөтү чоңураак тездетүүнү көрсөтөт?
1(b)-сүрөттө тыгыздык талаасы (psi) GPU 1'ге, ылдамдык компоненттери (v_1), (v_2) жана (v_3) болсо GPU 2–4'кө ыйгарылган. Ошентип бири-биринен өзүнчө чоң FFT иш жүктөрү бир эле учурда ар кандай түзмөктөрдө аткарыла алат.
Булак графигинде төрт H100 GPU'луу иштөө убактысы CPU эталонунун болжол менен бир нече пайыздык деңгээлинде жана эң жакшы учурда болжол менен 60× тездетүү алынган.
Бул өндүрүмдүүлүк артыкчылыгы бир FFT'нин бөлүнүшүнөн айырмаланат: ар кандай талаалардын табигый түрдө бири-биринен ажыратылышы алда канча жогорку параллелдүүлүктү камсыз кыла алат.
2Ө дендриттик катуулануу мисалы канчалык чоң?
12-беттеги 2(a)-сүрөт үч бурчтуу кристаллдык симметрия (triangular crystal symmetry) астындагы дендриттик катуулануу мисалын көрсөтөт.
Эсептөө талаасы:
\[ 5imes10^4 imes 5imes10^4 \]
тор (grid) өлчөмүндө. Булак алюминий үчүн 4 Å тор константасы (lattice constant) болжолдонгондо, бул болжол менен:
\[ 2.5,muext{m}imes2.5,muext{m} \]
физикалык талаага туура келерин белгилейт.
Сүрөттө тыгыздык талаасы (psi) жана чоңойтулган аймак көрсөтүлгөн. Визуалдагы ак сызыктар физикалык бүртүкчө (grain) чектери эмес; булак массив бир графика катары чийүүгө өтө чоң болгондуктан, бул сызыктар колдонулган визуалдаштыруу бөлүктөрүнүн чектерин көрсөтөрүн ачык белгилейт.
3Ө поликристаллдык мисал эмнени көрсөтөт?
2(b)-сүрөт FCC кристаллдык түзүмүндө гидродинамикалык PFC менен поликристаллдык ирилешүүнү көрсөтөт.
Визуалдаштырылган өзгөрмөлөр:
- тыгыздык талаасы (psi),
- ылдамдык компоненти (v_1),
- ылдамдык компоненти (v_2),
- ылдамдык компоненти (v_3)
катары берилген.
Сүрөт түшүндүрмөсүндө колдонулган тор (grid):
[ 1400imes1400imes1400 ]
жана физикалык куту өлчөмү болжол менен:
\[ 40,ext{nm}imes40,ext{nm}imes40,ext{nm} \]
деп белгиленген.
Бул маани 1(b)-сүрөтүндөгү убакыт ченелген гидродинамикалык эталондук тестирлөөнүн 900³ жогорку чегинен чоң. Булак 1400³ визуалдаштыруусу эталондук графиктеги эксперимент менен бирдей шарттарда болгон-болбогонун түшүндүрбөйт; ошондуктан эки жыйынтык бирдей эталондук чекит катары бааланбашы керек.
Изилдөө ырастаган өзгөчөлүк эмнеде?
Авторлор жалпы бөлүштүрүлгөн көп GPU FFT ыкмалары жогорку өндүрүмдүү эсептөөлөрдө мурдатан эле болгонун моюнга алышат. Изилдөөнүн өзгөчөлүк (түпнускалык) ырастоосу булардан айырмаланат: булак MATLAB ичинде колдонмодон көз карандысыз жалпы multi-GPU FFT инфраструктурасынын жоктугун жана сунушталган ыкма MATLAB чөйрөсүндөгү алгачкы multi-GPU FFT имплементациясы экенин билдирет.
Бул авторлордун адабият жана программалык камсыздоо экосистемасын баалоосуна негизделген өзгөчөлүк ырастоосу болуп саналат. Изилдөө бардык жеке же жарыяланбаган MATLAB коддорун камтыган көз карандысыз программалык инвентаризацияны жүргүзбөйт.
Көбүрөөк GPU качан пайда алып келет?
Булактын жыйынтыктарына ылайык, көп GPU колдонуу өзгөчө эки учурда маанилүү болуп калат:
- Бир FFT массиви бир GPU эс тутумуна батпай калганда.
- Көп физикалык (Multiphysics) моделде бир нече чоң физикалык талаа бир убакта жаңыртылганда.
Буга карама-каршы, бир GPU'га кенен баткан кичинекей көйгөйлөрдө маалымат байланышына байланыштуу кошумча GPU колдонуу жайыраак болушу мүмкүн.
Ошентип GPU саны көз карандысыз өндүрүмдүүлүк параметри эмес; көйгөйдүн өлчөмү, GPU эс тутуму, P2P өткөрүү жөндөмдүүлүгү, иш жүгүнүн бөлүнүшү жана эсептөө/байланыш катышы бирге бааланышы керек.
Кыргызстан үчүн эмнени түшүндүрөт?
Изилдөө TU Dresden жана NHR Center HPC инфраструктурасында жүргүзүлгөн; Кыргызстандагы кандайдыр бир HPC системасында же изилдөө борборунда эталондук тестирлөө (benchmark) өткөрүлгөн эмес.
Бул ыкма MATLAB негизинде жогорку чечилиштеги материалдарды моделдөө, спектралдык PDE чечүү же көп талаалуу физикалык симуляцияларды жүргүзгөн Кыргызстандагы изилдөө топтору үчүн методологиялык жактан ылайыкташтырылышы мүмкүн. Бирок изилдөөдөгү 6× же 60× маанилери ар кандай GPU моделдерине, PCIe/NVLink топологияларына, CPU түзүмдөрүнө же MATLAB версияларына түздөн-түз колдонулбашы керек.
Жергиликтүү системада чыныгы өндүрүмдүүлүктү аныктоо үчүн, ошол эле көйгөй өлчөмдөрү менен өзүнчө strong-scaling, memory-scaling жана GPU байланыш эталондук тестирлөөлөрү жүргүзүлүшү зарыл.
Изилдөө колдогон жыйынтыктар
- MATLAB ичинде көп GPU колдонуу менен эки жана үч өлчөмдүү FFT негизиндеги псевдо-спектралдык эсептөөлөр ишке ашырылган.
- Бир чоң 3Ө FFT слаб декомпозициясы жана GPU–GPU маалымат байланышы колдонулуп бир нече GPU'га бөлүштүрүлгөн.
- 750³–1400³ PFC эталондук тестирлөөлөрүндө болжол менен алты эсеге чейин GPU/CPU тездетүүсү катталган.
- 1400³ стандарттуу PFC массиви баштапкы жабдыкта төрт гана H100 GPU үстүндө эс тутумга баткан.
- 1400³ H100 жыйынтыгы CPU эталондук убактысынын болжол менен 17%ы катары билдирилген.
- Кичинекей 750³ көйгөйүндө бир H100 GPU, көбүрөөк H100 GPU колдонууга караганда жакшыраак өндүрүмдүүлүк көрсөткөн.
- Гидродинамикалык PFC'де (psi,v_1,v_2,v_3) талаалары төрт GPU'га өзүнчө бөлүштүрүлгөн.
- Бул экинчи стратегияда 100 ядролуу CPU колдонмосуна салыштырмалуу 60 эсеге чейин тездетүү катталган.
- Изилдөө 2Ө дендриттик катуулануу жана 3Ө поликристаллдык ирилешүү мисалдары менен методдун PFC симуляцияларына колдонулушун көрсөткөн.
- Баштапкы код MIT лицензиясы менен программалык камсыздоо репозиторийинде бөлүшүлгөн.
Изилдөө колдобогон же сынабаган жыйынтыктар
- Көбүрөөк GPU'нун ар бир көйгөйдө ылдамыраак экени көрсөтүлбөйт.
- 6× жана 60× тездетүүлөр бардык GPU/CPU системалары үчүн универсалдуу маанилер эмес.
- Изилдөө бардык MATLAB FFT колдонмолору бирдей масштабдуулукка жетерин көрсөтпөйт.
- Изилдөө H100 жана A100 тышкаркы GPU'ларда кеңири өндүрүмдүүлүк эталонун сунуштабайт.
- GPU–GPU байланыш убактысы өзүнчө компонент катары сандык түрдө бөлүнгөн эмес.
- Strong-scaling жана weak-scaling натыйжалуулугу классикалык HPC метрикалары менен өзүнчө таблицалар түрүндө берилбеген.
- GPU чечими менен CPU чечими ортосундагы сандык ката үчүн өзүнчө FFT тактык таблицасы сунушталган эмес.
- Билдирилген эталондук жыйынтыктар реалдуу эксперименталдык материалдык микротүзүм менен сандык тастыктоо дегенди билдирбейт; булар PFC сандык симуляциялары болуп саналат.
- Гидродинамикалык PFC үчүн 2(b)-сүрөттөгү 1400³ визуалу 1(b)-сүрөттөгү убакыт эталонунун бир бөлүгү экендиги булакта ачык көрсөтүлгөн эмес.
- Изилдөө GPU санын көбөйтүүнүн баа/энергия натыйжалуулугун баалабайт.
- Авторлордун “MATLAB чөйрөсүндөгү алгачкы multi-GPU FFT” деген сөзү көз карандысыз жана толук глобалдык программалык камсыздоону текшерүүнүн жыйынтыгы катары тастыкталган эмес.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Эки параллелдештирүү стратегиясынын техникалык корутундусу
| Параметр | Стратегия 1 | Стратегия 2 |
|---|---|---|
| Көйгөй | Бир чоң FFT | Көп физикалык (Multiphysics) PFC |
| Параллелдештирүү | Domain/slab decomposition | Field decomposition |
| Жергиликтүү эсептөө | 2Ө FFT + 1Ө FFT | Ар бир GPU өз талаасынын 3Ө FFT'лерин иштетет |
| Байланыш | P2P берилиштерди кайра бөлүштүрүү (data redistribution) | Талаалардын убакыт кадамынын аягында синхрондоштурулушу |
| MATLAB түзүмү | spmd, spmdCat | spmd, spmdSend, spmdReceive |
| Негизги артыкчылык | Бир GPU эс тутумунан ашкан FFT | Бир нече физикалык талаанын бир убакта иштетилиши |
Стандарттуу PFC эталондук камтуусу
| Көрсөткүч | Булак мааниси |
|---|---|
| Көйгөй өлчөмү диапазону | 750³–1400³ |
| Эталондук тестирлөө убактысы | 1-сүрөттө 1000 убакыт кадамы |
| H100 системасы | 4 × NVIDIA H100 SXM5, 94 GiB HBM2e/GPU |
| A100 системасы | 8 × NVIDIA A100 SXM4, 40 GiB HBM2/GPU |
| CPU эталону | 100 × Intel Xeon Platinum 8470 ядросу, 2,00 GHz |
| Катталган максималдуу тездетүү | Болжол менен 6× |
| 1400³ эс тутум талабы | Булак системасында 4 H100 менен гана иштетилген |
| 1400³ салыштырмалуу иштөө убактысы | CPU убактысынын болжол менен 17%ы |
Multiphysics эталондук камтуусу
| Көрсөткүч | Булак мааниси |
|---|---|
| Модель | 3Ө гидродинамикалык PFC |
| Физикалык талаалар | ψ, v₁, v₂, v₃ |
| GPU саны | 4 × NVIDIA H100 |
| Бир GPU үчүн талаа | Бир негизги физикалык талаа |
| 1(b)-сүрөт эталондук өлчөмдөрү | 750³–900³ |
| Катталган максималдуу тездетүү | CPU эталонуна салыштырмалуу болжол менен 60× |
| 2(b)-сүрөт өзүнчө мисал тору | 1400³ |
Эмне үчүн H100 жана A100 жыйынтыктары түздөн-түз GPU саны менен окулбашы керек?
H100 жана A100 системалары GPU саны боюнча гана айырмаланбайт. Булакта H100 бир GPU үчүн 94 GiB HBM2e, ал эми A100 бир GPU үчүн 40 GiB HBM2 эс тутумун колдонот. Ошондуктан бир эле көйгөй үчүн “төрт GPU” же “сегиз GPU” деген сөз өзүнчө эле эквиваленттүү эсептөө булагын аныктай албайт.
1(a)-сүрөттө ар кандай GPU үй-бүлөлөрү ар кандай ийри сызыктар менен көрсөтүлгөн. Жыйынтыктар GPU саны менен бирге GPU архитектурасы, эс тутум сыйымдуулугу жана байланыш (interconnect) өзгөчөлүктөрү менен бирге чечмелениши керек.
Эсептөө талаасынын физикалык масштабы
| Мисал | Тор (Grid) | Булакта берилген физикалык масштаб |
|---|---|---|
| 2Ө дендриттик катуулануу | 50.000 × 50.000 | 2,5 µm × 2,5 µm; 4 Å Al тор константасы болжолдоосу менен |
| 3Ө поликристаллдык ирилешүү | 1400 × 1400 × 1400 | 40 nm × 40 nm × 40 nm |
Бул мисалдар PFC ыкмасынын негизги эсептөө кыйынчылыгын көрүнүктүү кылат: физикалык талаа микрометр же ондогон нанометр деңгээлинде болсо да, кристаллдык тордун атомдук масштабдагы түзүмүн чечүү үчүн миллиарддаган тор чекиттери талап кылынышы мүмкүн.
2(a)-сүрөттөгү дендриттик оюу эмнени далилдейт?
2(a)-сүрөт көп GPU (multi-GPU) single-FFT колдонмосунун чоң эки өлчөмдүү PFC катуулануу көйгөйүндө колдонулушу мүмкүн экенин көрсөтөт. Сүрөт методдордун физикалык материалда өлчөнгөн дендриттин эксперименталдык көрүнүшү эмес.
Ошондуктан визуалдан чыныгы алюминий дендрит морфологиясынын сандык түрдө тастыкталгандыгы жөнүндө жыйынтык чыгарууга болбойт. Булак мисалды көп GPU эсептөөнүн чоң PFC талаасындагы колдонулушун көрсөтүү максатында колдонот.
2(b)-сүрөттө ылдамдык талааларынын көрсөтүлүшүнүн мааниси эмнеде?
Гидродинамикалык PFC тыгыздык өзгөрмөсүн гана эмес, үч компоненттүү ылдамдык талаасын да чечет. 2(b)-сүрөттө (psi)'нин жанында (v_1), (v_2) жана (v_3)'түн өзүнчө көлөмдүү визуалдаштыруусунун берилиши, экинчи GPU стратегиясындагы төрт физикалык талаа бөлүнүшүнүн түздөн-түз моделдин өзгөрмөлөрүнө туура келерин көрсөтөт.
Башкача айтканда, төрт GPU колдонуу массивди техникалык жактан төрткө бөлүү гана эмес; ар бир GPU моделдин белгилүү бир физикалык талаасынын эсептөө жүгүн көтөрөт.
Методдун келечектеги масштабдоо максаты эмне?
Авторлор экинчи стратегиянын негизги Фурье режимдери (principal Fourier modes) үчүн комплекстүү амплитуданы колдонгон ири бүртүкчөлүү (coarse-grained) PFC моделдерине табигый түрдө кеңейе аларын белгилешет. Мындай моделдер ондогон байланышкан комплекстүү маанидеги талааны (coupled complex-valued field) камтышы мүмкүн.
Булак бул түзүмдөрдүн талаа деңгээлиндеги GPU параллелдештирүүсүнө (field-level GPU parallelization) өзгөчө ылайыктуу болушун күтөт; бирок изилдөөдө ондогон комплекстүү талааларды колдонгон жаңы эталондук тестирлөө сунушталган эмес. Ошондуктан бул артыкчылык келечектеги колдонуу күтүүсү болуп саналат, учурдагы сандык жыйынтык эмес.
Өндүрүмдүүлүк жыйынтыктарынын негизги чечмелениши
Изилдөөнүн эки стратегиясынан чыккан жалпы жыйынтык, көп GPU колдонуу көбүрөөк эсептөө бирдиктерин кошуу катары гана бааланбашы керек экендиги.
Бир FFT стратегиясында байланыш баасынан улам кичинекей көйгөйлөрдө бир GPU ылдамыраак болушу мүмкүн; чоң көйгөйлөрдө болсо көп GPU биринчи кезекте эс тутум чегинен ашып, симуляцияны мүмкүн кылат.
Көп физикалык (Multiphysics) стратегиясында көз карандысыз физикалык талаалардын табигый бөлүнүшү ар кандай GPU'лардын бир убакта иштешине көбүрөөк мүмкүнчүлүк берет жана булак эталондук тестирлөөсүндө алда канча жогорку тездетүүгө жетет.
Эталондук тестирлөө жыйынтыктарын жалпылоодо кайсы өзгөрмөлөр маанилүү?
- GPU модели жана бир GPU үчүн эс тутум сыйымдуулугу,
- GPU'лар ортосундагы байланыш топологиясы жана өткөрүү жөндөмдүүлүгү,
- Көйгөйдүн өлчөмү,
- FFT өлчөмдөрү,
- Бир GPU үчүн жергиликтүү эсептөө/байланыш катышы,
- Физикалык талаалардын саны,
- Убакыт интеграциялоо ыкмасы,
- CPU эталондук архитектурасы,
- MATLAB жана параллелдүү эсептөө чөйрөсүнүн колдонмо чоо-жайы.
Изилдөө бул факторлордун бардыгы үчүн өзүнчө сезгичтик анализин сунуштабайт. Ошондуктан 6× жана 60× маанилери билдирилген HPC конфигурацияларынын жыйынтыктары катары сакталышы керек.
Изилдөөнүн күчтүү жактары
- Жөн гана FFT микро-эталонунун (mikrobenchmark) ордуна чыныгы жогорку даражалуу PDE колдонуу сценарийи берилген.
- Domain decomposition (аймак бөлүү) жана field decomposition (талаа бөлүү) ыкмасы ошол эле MATLAB алкагында көрсөтүлгөн.
- H100 жана A100 негизиндеги бир нече GPU системасы колдонулган.
- CPU эталону ачык жабдык маалыматы менен берилген.
- Бир GPU эс тутумуна батпаган көйгөй өлчөмдөрү түздөн-түз сыналган.
- MATLAB колдонмо үзүндүлөрү (implementation snippets) бөлүшүлгөн.
- Толук баштапкы код репозиторийи жана Zenodo жазуусу берилген.
- 2Ө жана 3Ө PFC колдонуу мисалдары визуалдык түрдө сунушталган.
Негизги чектөөлөр
- Үстөмдүк кылуучу жыйынтык метрикасы - иштөө убактысы; өзүнчө сандык тактык эталондук тестирлөөсү чектелген.
- GPU–GPU байланыш баасы өзүнчө убакыт компоненттерине бөлүнгөн эмес.
- Энергия керектөө жана өндүрүмдүүлүк/ватт өлчөнгөн эмес.
- Ар кандай GPU өндүрүүчүлөрү же NVIDIA'нын ар кандай муундары кеңири текшерилген эмес.
- Эталондук тестирлөө бир гана PFC көйгөй үй-бүлөсүнүн айланасында түзүлгөн.
- Изилдөө чыныгы эксперименталдык материалдык микротүзүм менен сандык моделди валидациялоо максатын көздөбөйт.
- Булакта гидродинамикалык PFC үчүн 900³ эталондук чеги менен 1400³ өкүлчүлүктүү визуалдын ортосунда түшүндүрүлбөгөн өлчөм айырмасы бар.
- Программалык тизмелер (listing) ыкманы көрсөтөт, бирок алар өз алдынча бардык баштапкы жана иштөө параметрлерин камтыган көз карандысыз аткарылуучу (executable) программалар эмес.
Булак жана Ыкма Жөнүндө Эскертүү
Изилдөөнүн толук түпнуска аталышы: Multi-GPU fast Fourier transforms in MATLAB for large-scale phase-field crystal simulations
Библиографиялык аталыш эскертүүсү: Жүктөлгөн PDF аталышы жогорудагы кашаасыз формада. arXiv metadata жазуусунун аталышы “Multi-GPU fast Fourier transforms in MATLAB (for large-scale phase-field crystal simulations)” түрүндө, экинчи бөлүгүн кашаанын ичинде көрсөтөт. Түпнуска PDF аталышы тынч түрдө өзгөртүлгөн эмес.
Авторлор жана баштапкы ирети: Maik Punke; Marco Salvalaglio.
Мекеме: Institute of Scientific Computing, TU Dresden, 01062 Dresden, Germany.
Экинчи мекеме: Dresden Center for Computational Materials Science, TU Dresden, 01062 Dresden, Germany; Marco Salvalaglio үчүн булакта экинчи аффилиация катары көрсөтүлөт.
Жооптуу автор: Жүктөлгөн PDF'те өзүнчө “corresponding author” белгиси жок. Эки автордун тең атында аффилиация белгилери бар, электрондук почта/жооптуу-автор белгиси ачык көрсөтүлгөн эмес.
Бирдей биринчи/бирдей салым: Жүктөлгөн версияда бирдей салым (eş katkı) билдирүүсү жок.
Булак түрү: MATLAB негизиндеги жогорку өндүрүмдүү эсептөө, илимий программалык камсыздоо жана сандык симуляция изилдөөсү.
Жарыялоо абалы: Жүктөлгөн изилдөө arXiv үстүндө жарыяланган жана рецензиялоодон (peer-review) өткөн өзүнчө журнал версиясы тастыкталбаган препринт (preprint) болуп саналат. Жыйынтыктар бул жарыялоо баскычы эске алынуу менен бааланышы керек.
Платформа: arXiv.
arXiv идентификатору: 2603.26818v1 [cs.MS].
Негизги категория: Mathematical Software (cs.MS).
Кошумча категориялар: Materials Science (cond-mat.mtrl-sci) жана Computational Physics (physics.comp-ph).
arXiv алгачкы жөнөтүү датасы: 26 Март 2026.
PDF'те жазылган дата: 31 Март 2026.
arXiv DOI: 10.48550/arXiv.2603.26818.
Илимий ыкма: Фурье псевдо-спектралдык чечим; көп GPU domain decomposition; слаб декомпозициясы (slab decomposition); peer-to-peer берилиштерди кайра бөлүштүрүү; field-level multiphysics parallelization; жарым-имплициттик (semi-implicit) жана баштапкы код листингдеринде белгиленген имплициттик убакыт жаңыртуулары.
Негизги колдонмо: Эки жана үч өлчөмдүү фазалык-талаа кристалл (phase-field crystal) симуляциялары.
Эталондук (Benchmark) GPU'лар: 4 × NVIDIA H100 SXM5 (94 GiB HBM2e/GPU) жана 8 × NVIDIA A100 SXM4 (40 GiB HBM2/GPU).
CPU эталону: Intel Xeon Platinum 8470, жалпы 100 ядро, 2,00 GHz.
HPC инфраструктурасы: TU Dresden NHR Center курамындагы Capella, Alpha Centauri жана Barnard системалары.
Баштапкы код репозиторийи: https://github.com/mpunke/MATLABmultiGPUFFT/
Программалык камсыздоо лицензиясы: MIT License.
Zenodo DOI: 10.5281/zenodo.18670913.
Негизги эталондук жыйынтык: Стандарттуу PFC үчүн CPU эталонуна салыштырмалуу болжол менен 6×'ке чейин, гидродинамикалык multiphysics PFC үчүн болжол менен 60×'ке чейин тездетүү билдирилген.
Эталондук тестирлөөнү чечмелөө: Бул маанилер бир эле көйгөй үстүндө окшош процессор ресурстарын салыштырган таза алгоритмдик scaling (масштабдоо) коэффициенттери эмес. GPU жана CPU тараптары ар кандай архитектураларга жана эс тутум системаларына ээ.
Булак ичиндеги туюнтум эскертүүсү — CPU ядросу: Изилдөөнүн Summary бөлүмү CPU тиркемесин “hundreds of cores” туюнтуму менен сүрөттөсө да, деталдуу эталондук тестирлөө түшүндүрмөсү жана 1-сүрөт ачык түрдө 100 CPU ядросун эталон катары алат. Сандык салыштырууларда деталдуу эталондук тестирлөөдөгү 100 ядро маалыматы колдонулган.
Булак ичиндеги камтуу эскертүүсү — гидродинамикалык PFC өлчөмү: 1(b)-сүрөттүн түшүндүрмөсүндө эталондук тестирлөө көп GPU менен 900³ көйгөй өлчөмүнө чейин жеткендиги белгиленген. 2(b)-сүрөт болсо гидродинамикалык PFC үчүн 1400³ торду (grid) колдонгон өзүнчө поликристаллдык ирилешүү мисалын көрсөтөт. Булак бул эки абалдын иштөө шарттарынын ортосундагы айырманы түшүндүрбөгөндүктөн, 1400³ мааниси эталондук графиктин түздөн-түз кошумча маалымат чекити катары чечмеленген жок.
Код листингинин чеги: Listing 1 жана Listing 2 алгоритмдин негизги параллелдүү маалымат агымын көрсөтөт; баштапкы массивдердин, бөлүү индекстеринин жана бардык жардамчы өзгөрмөлөрдүн толук аныктамаларын камтыган көз карандысыз толук программа эмес. Аткарыла турган тиркеме үчүн баштапкы репозиторийге өзүнчө кайрылуу керек.
Өзгөчөлүк (түпнускалык) ырастоосунун чеги: Авторлор изилдөөнү MATLAB чөйрөсүндөгү алгачкы multi-GPU FFT имплементациясы катары сүрөттөшөт. Бул туюнтум булак авторлорунун учурдагы адабият/программалык камсыздоону баалоосуна негизделет жана көз карандысыз кеңири глобалдык программалык инвентаризация катары тастыкталган эмес.
Каржылоо: Изилдөө Deutsche Forschungsgemeinschaft (DFG) тарабынан 447241406 жана 493401063 долбоор номерлери менен колдоого алынган.
Эсептөө булагы: Авторлор TU Dresden NHR Center жогорку өндүрүмдүү эсептөө системаларын колдонуусун ыраазычылык бөлүмүндө өзүнчө белгилешет.
Кызыкчылыктардын кагылышы: Жүктөлгөн текстте өзүнчө competing-interest же conflict-of-interest билдирүүсү жок; мындан кызыкчылыктардын кагылышы жок деген жыйынтык чыгарылган эмес.
CRediT/автордук салымдар: Жүктөлгөн версияда өзүнчө CRediT authorship contribution statement жок.
Илимий тастыктоо чеги: Изилдөөнүн негизги тастыктоосу - эсептөө өндүрүмдүүлүгү жана чоң көйгөй өлчөмдөрүнүн иштетилүү мүмкүнчүлүгү. Чыныгы материалдык эксперименттер менен микротүзүмдү валидациялоо, FFT сандык ката эталондук тестирлөөсү, энергия натыйжалуулугу же кеңири strong/weak scaling анализи изилдөөнүн негизги баалоо топтомунда билдирилген эмес.
Илимий мазмун чеги: Бул Verianla макаласындагы PFC теңдемелери, FFT алгоритмдери, көп GPU стратегиялары, жабдык маалыматтары, эталондук жыйынтыктар жана 1–2-сүрөттөрдүн чечмелеништери жүктөлгөн изилдөөгө негизделет. Тышкы библиографиялык көзөмөл arXiv идентификаторун, DOI, учурдагы жарыялоо абалын жана программалык камсыздоону бөлүштүрүү жазуусун тастыктоо максатында гана колдонулган; булакта жок болгон жаңы симуляция жыйынтыгы кошулган эмес.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген