

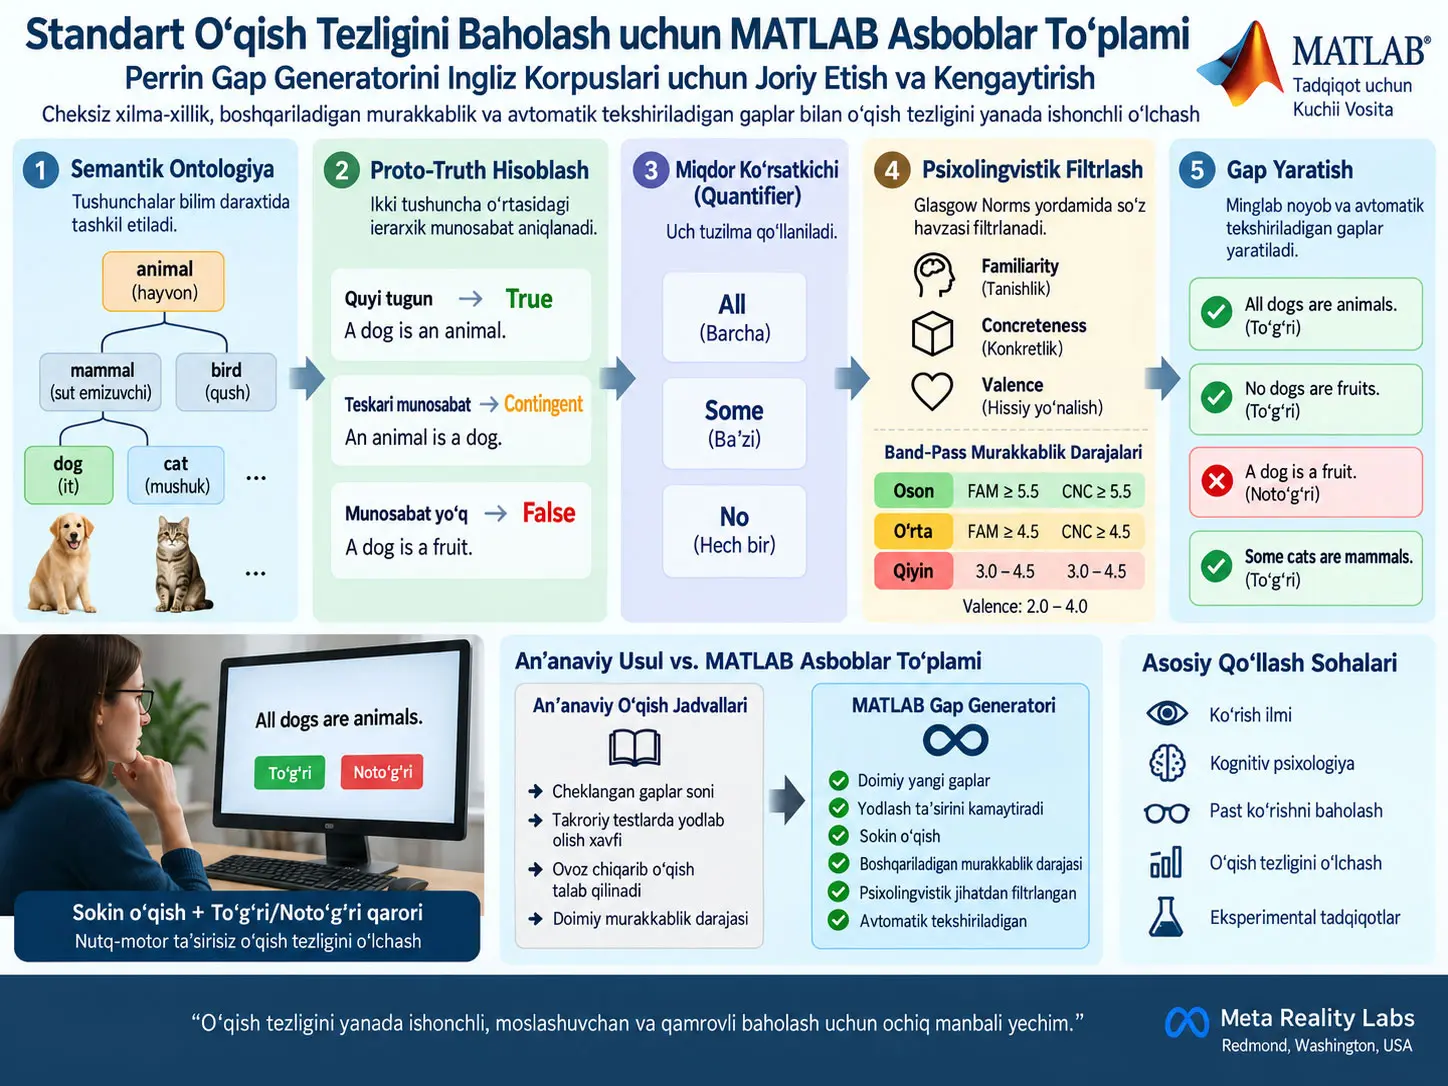
Proto-truth, ushbu tadqiqotda gapda ishlatiladigan ikki tushuncha o‘rtasidagi semantik munosabatni, tushunchalarning ontologiya daraxtidagi o‘rinlariga qarab tabiiy tilga aylantirishdan oldin “to‘g‘ri”, “shartli” yoki “noto‘g‘ri” deb tasniflashdir. Daniel P. Spiegel va Romain Bachy ishlab chiqqan MATLAB asboblar to‘plami ushbu mantiqdan foydalanib o‘qish tezligini o‘lchash uchun minglab noyob va avtomatik tekshiriladigan gaplarni yaratadi.
Tadqiqotning boshlang‘ich nuqtasi shuki, MNREAD kabi standart o‘qish jadvallari takroriy testlarda gaplar soni cheklanganligi sabab yodlab qolish ta’sirini keltirib chiqarishi, ovoz chiqarib o‘qish usullari esa vizual axborotni qayta ishlash tezligiga nutq-motor jarayonlarini aralashtirishi mumkin. Asboblar to‘plami bu muammolarni kamaytirish uchun jim o‘qish va True/False qaroriga asoslangan o‘lchash paradigmasini qo‘llab-quvvatlaydi.
Tizim Perrin, Paillé va Baccino’ning 2014-yildagi semantik ontologiya yondashuvini ingliz tiliga moslashtiradi. Bundan tashqari, Glasgow Norms yordamida so‘z havzasi familiarity, concreteness va valence o‘zgaruvchilari bo‘yicha filtrlab olinadi; ingliz tiliga xos sanalmaydigan otlar, tartibsiz ko‘pliklar, omonimlar va real dunyo bilimidan kelib chiqadigan toifalararo noaniqliklar uchun qo‘shimcha xavfsizlik mexanizmlari qo‘llanadi.
Asboblar to‘plamining yana bir muhim yangiligi faqat minimal chegaradan foydalanadigan filtrlash o‘rniga yuqori va quyi chegaralarni belgilovchi band-pass psixolingvistik filtrlashdir. Shu tufayli oson, o‘rta va qiyin gap guruhlarini yaratish mumkin bo‘ladi va tizim faqat maksimal o‘qish tezligini o‘lchashda emas, balki boshqariladigan kognitiv yuk tajribalarida ham qo‘llanishi mumkin.
Nega yangi o‘qish tezligini o‘lchash vositasi kerak?
O‘qish tezligi ko‘rish fani, klinik oftalmologiya va eksperimental psixologiyada muhim samaradorlik ko‘rsatkichidir.
Biroq klassik bosma o‘qish jadvallarida ikkita asosiy muammo mavjud.
- Gaplar sonining cheklanganligi takroriy testlarda yodlash ta’siriga olib kelishi mumkin.
- Ovoz chiqarib o‘qish vizual o‘qish tezligidan tashqari nutq va motor rejalashtirish jarayonlarini ham o‘lchaydi.
Shu sababli o‘lchangan natija faqat vizual yoki kognitiv o‘qish qobiliyatini ifodalamasligi mumkin.
Ushbu MATLAB Asboblar To‘plami An’anaviy O‘qish Jadvallaridan Qanday Farq Qiladi?
Asboblar to‘plami qat’iy gaplar ro‘yxatidan foydalanish o‘rniga semantik ontologiya va mantiqiy qoidalar orqali uzluksiz yangi gaplar yaratadi; shuningdek, to‘g‘ri/noto‘g‘ri qaroriga asoslangan jim o‘qish paradigmasi bilan nutq-motor samaradorligining o‘lchovga aralashishini kamaytirishni maqsad qiladi.
Crossland yondashuvidan Perrin yondashuviga
Crossland, Legge va Dakin 2008-yilda miqdorlagich, obyekt va xususiyatlarni tasodifiy birlashtirib avtomatik gap yaratish yondashuvini ishlab chiqqan edi.
Bu tizim ko‘p sonli gaplar yaratishda afzallikka ega bo‘lsa-da, ayrim kombinatsiyalar semantik jihatdan noaniq bo‘lishi mumkin edi.
Perrin, Paillé va Baccino 2014-yilda bu muammoni semantik ontologiya yordamida hal qilishga urindi. Tushunchalar daraxt tuzilmasiga joylashtirildi va ular orasidagi munosabat tizim tomonidan bevosita ontologik o‘rindan chiqarildi.
Ontologiya bilim xaritasi sifatida qanday ishlaydi?
Tizim tushunchalarni quyidagicha ildizli daraxtda ifodalaydi:
\[ O=(N,E,r) \]
Bu yerda:
- \(N\), tugunlarni,
- \(E\), tugunlar orasidagi bog‘lanishlarni,
- \(r\), ildiz tugunni
ifodalaydi.
Tugunlar ikki asosiy guruhga bo‘linadi:
- Classes: animal, fruit, tool kabi keng toifalar,
- Entities: dog, apple, hammer kabi aniq obyektlar.
Masalan, “dog” tuguni “mammal” tugunining, “mammal” esa “animal” tugunining ostida bo‘lsa, tizim dog bilan animal o‘rtasidagi taksonomik munosabatni avtomatik biladi.
Proto-Truth Qanday Hisoblanadi?
Proto-truth ikki tushunchaning ontologiya daraxtidagi ierarxik munosabatiga ko‘ra aniqlanadi: birinchi tushuncha ikkinchi tushunchaning quyi tuguni bo‘lsa True, munosabat teskari yo‘nalishda bo‘lsa Contingent, bevosita avlod munosabati bo‘lmasa False deb tasniflanadi.
Uch proto-truth holati
| Holat | Munosabat | Misol |
|---|---|---|
| True | \(e_1\), \(e_2\) ning quyi tugunidir | A dog is an animal |
| Contingent | Munosabat teskari yo‘nalishda | An animal is a dog |
| False | Bevosita avlod munosabati yo‘q | A dog is a fruit |
Quantifier ishlatilishi
Tizim gap yaratishda uchta miqdorlagichdan foydalanadi:
- All
- Some
- No
Proto-truth qiymati keyin quantifier bilan birga baholanib yakuniy True/False gap qiymati hosil qilinadi.
Masalan, proto-false bo‘lgan dog–fruit juftligi “No” bilan birlashtirilganda “No dogs are fruits” ko‘rinishida to‘g‘ri ifoda hosil qilishi mumkin.
Nega ayrim mantiqan to‘g‘ri gaplar taqiqlanadi?
Tadqiqot ayniqsa “Some + Proto-True” kombinatsiyasini taqiqlaydi.
Masalan:
Some dogs are animals.
Mantiqan to‘g‘ri; biroq pragmatik jihatdan ayrim itlar hayvon emas degan taassurot uyg‘otishi mumkin.
Bunday Gricean implicature ta’sirlari o‘quvchida keraksiz chalkashlik tug‘dirmasligi uchun kombinatsiya butunlay chiqarib tashlanadi.
Yaroqli kombinatsiyalar True va False gaplar ehtimolini aynan 0,5 darajada saqlash uchun ham vaznlanadi.
Tizim Nega True va False Gaplarni %50–%50 Hosil Qiladi?
Muvozanatli True/False taqsimoti ishtirokchining javob strategiyasini bitta toifaga og‘dirishini oldini olish va o‘qish vazifasining qaror tuzilmasini muvozanatda saqlash uchun ishlatiladi; manbada yaroqli gap kombinatsiyalari bu taqsimotni aynan 0,5 ehtimolda saqlaydigan tarzda vaznlangan.
Glasgow Norms bilan psixolingvistik filtrlash
Inglizcha so‘z havzasi 5.554 so‘zdan iborat Glasgow Norms ma’lumotlar to‘plami orqali filtrlab olinadi.
Uch asosiy o‘lchov qo‘llanadi:
| O‘zgaruvchi | Ma’no | Standart chegara |
|---|---|---|
| Familiarity (FAM) | So‘zning o‘quvchiga tanishligi | ≥ 4,5 / 7 |
| Concreteness (CNC) | Tushunchaning konkretlik darajasi | ≥ 4,5 |
| Valence (VAL) | Hissiy ijobiy/salbiy yo‘nalish | ≥ 4,0 |
Familiarity nega nazorat qilinadi?
Tanishlik o‘qish tezligiga kam uchraydigan so‘zni xotiradan chaqirish jarayonining ta’sirini kamaytirish uchun qo‘llanadi.
Yuqori familiarity qiymatiga ega so‘zlar odatda ko‘proq uchraydi va tezroq qayta ishlanadi.
Concreteness nega muhim?
Paivio’ning Dual Coding Theory yondashuviga ko‘ra konkret tushunchalar ham verbal, ham tasviriy tizimlarni faollashtirishi mumkin.
Shu sababli konkret so‘zlar odatda abstrakt so‘zlarga qaraganda tezroq qayta ishlanishi mumkin.
Valence nega filtrlab olinadi?
Salbiy mazmun diqqatni kuchliroq jalb qilishi va qayta ishlash vaqtini o‘zgartirishi mumkin.
Standart o‘lchovda bu hissiy ta’sirni kamaytirish uchun neytral yoki ijobiy so‘zlar afzal ko‘riladi.
Band-Pass Psixolingvistik Filtrlash Nima?
Band-pass filtrlash faqat minimal familiarity, concreteness yoki valence chegarasini belgilash o‘rniga quyi va yuqori chegaralarni belgilab muayyan psixolingvistik qiyinchilik oralig‘ini ajratib olishdir; shu tariqa oson so‘zlarning butun taqsimotga hukmron bo‘lishiga yo‘l qo‘yilmaydi va boshqariladigan qiyinchilik darajalari yaratiladi.
Uch standart qiyinchilik darajasi
| Daraja | Familiarity | Concreteness | Valence |
|---|---|---|---|
| Easy | \([5.5,\infty)\) | \([5.5,\infty)\) | Standart |
| Medium | \([4.5,\infty)\) | \([4.5,\infty)\) | Standart |
| Hard | \([3.0,4.5]\) | \([3.0,4.5]\) | \([2.0,4.0]\) |
Medium sozlamasi Perrin va hamkasblarining asl mezonlariga mos keladi.
Hard rejimi esa kamroq tanish, ko‘proq abstrakt va pastroq valence qiymatli so‘zlarni maxsus tanlab kognitiv yuk hosil qilishni maqsad qiladi.
Omonimlarni chiqarib tashlash
“Bank” yoki “arm” kabi bir nechta aniq ma’noga ega so‘zlar semantik noaniqlik tug‘dirishi mumkinligi sabab faol so‘z havzasidan chiqariladi.
Glasgow Norms ichida qavs bilan ma’no farqlanishi ko‘rsatilgan yozuvlar avtomatik ravishda chiqarib tashlanadi.
Ingliz tili uchun tuzilmaviy o‘zgarishlar
Amaldagi ontologiya 97 entity va 23 class dan foydalanadi.
Ingliz tiliga moslashtirishda ayrim muhim morfologik muammolarni hal qilish talab etilgan.
Sanalmaydigan otlarni chiqarish
Gap shablonlari ko‘plikdagi otlardan foydalangani uchun mass noun xususiyatidagi so‘zlar muammo tug‘dirgan.
Manba quyidagi misollarni faol havzadan chiqaradi:
- beef,
- pork,
- bacon,
- ham,
- rice,
- wheat,
- oats,
- milk,
- butter,
- honey,
- corn.
Shuningdek, “scissors” birlik shakli bo‘lmagan plurale tantum ot bo‘lgani uchun chiqarilgan.
Sinf nomlarini o‘zgartirish
“Clothing” sinfi garment, “furniture” sinfi esa furnishing deb o‘zgartirilgan.
Maqsad ko‘plik gap shablonlarida grammatik jihatdan tabiiy ifodalarni yaratishdir.
Tartibsiz ko‘pliklar
Asboblar to‘plami 38 yozuvdan iborat irregular plural lookup table dan foydalanadi.
Bu tuzilma:
- aircraft,
- watercraft,
- bus → buses
kabi standart regex qoidalari muammo tug‘dirishi mumkin bo‘lgan shakllarni xavfsiz qayta ishlaydi.
Animal–Food Toifalararo Noaniqligi Nega Maxsus Filtrlanadi?
Ontologiya daraxtida animal va food turli shoxlarda bo‘lgani uchun tizim, masalan, chicken–food juftligini False deb tasniflashi mumkin; ammo real dunyoda tovuq ayni paytda oziq-ovqat hamdir. Shu sababli asboblar to‘plami ontologik jihatdan noto‘g‘ri, lekin real dunyoda to‘g‘ri bo‘lishi mumkin bo‘lgan hayvon–oziq-ovqat juftliklarini maxsus shoxlararo filtr bilan chiqarib tashlaydi.
Cross-branch ambiguity muammosi
Ontologik tuzilma toifalarni bir-biridan ajratganda real dunyo tushunchalari ba’zan bir nechta funksiyani bajarishi mumkin.
Masalan, “animal” va “food” turli shoxlardir; biroq ayrim hayvonlar oziq-ovqat sifatida iste’mol qilinishi mumkin.
Bu holatda:
Some frogs are foods.
yoki
A chicken is not a food.
kabi gaplar ontologik mantiqqa ko‘ra ma’lum qiymat olsa-da, real dunyo nuqtai nazaridan bahsli bo‘lib qoladi.
isAmbiguousCrossBranch filtri bu juftliklarni avtomatik chiqarib tashlab, False gaplar haqiqiy semantik ajralishga asoslanishini ta’minlaydi.
Semantik masofani manipulyatsiya qilish
Asboblar to‘plami faqat gaplar yaratmaydi, balki ontologiya daraxtidagi tugunlar orasidagi qirralar sonidan foydalanib semantik masofani ham boshqara oladi.
Bu xususiyat kognitiv qiyinchilik yaratish uchun ishlatilishi mumkin.
Semantik interferensiya
Bir-biriga yaqin, ammo turli qardosh toifalardan False gaplar yaratilishi mumkin:
A dog is a cat.
Dog va cat bir xil yuqori toifa ostida bo‘lgani uchun tekshirish dog–fruit kabi uzoq juftliklarga nisbatan ko‘proq semantik interferensiya keltirib chiqarishi mumkin.
Taksonomik aniqlik
True gaplarda ham masofa o‘zgartirilishi mumkin.
A dog is an animal.
kengroq toifa bilimidan foydalansa:
A dog is a mammal.
yanada aniq taksonomik bilimni talab qiladi.
Ushbu Asboblar To‘plami Faqat Maksimal O‘qish Tezligini O‘lchay Oladimi?
Yo‘q. Band-pass filtrlash va semantik masofani boshqarish tufayli tizim kam uchraydigan so‘zlarni qayta ishlash, abstrakt tilni qayta ishlash, hissiy interferensiya va semantik ziddiyat kabi muayyan kognitiv jarayonlarni qiyinlashtiradigan eksperimental “stress test” gaplarini ham yarata oladi.
Kengaytirilgan eksperimental foydalanish
Manba uchta misol beradi:
- Familiarity pasaytirilib, kam uchraydigan so‘zlar bilan lexical retrieval yuki oshirilishi mumkin.
- Concreteness pasaytirilib, abstrakt so‘zlar bilan verbal qayta ishlash sinovdan o‘tkazilishi mumkin.
- Valence teskari filtrlanib, salbiy so‘zlar bilan affective interference o‘rganilishi mumkin.
Tadqiqot Usuli va Natijalari
Metodologik tuzilma
Tadqiqot yangi klinik tajribadan ko‘ra ko‘proq dasturiy ta’minot va usul ishlab chiqish maqolasidir.
Asosiy tarkibiy qismlar:
- Semantik ontologiyani qurish,
- proto-truth ni hisoblash,
- quantifier asosidagi True/False mapping,
- Glasgow Norms filtrlashi,
- Ingliz morfologiyasi va ko‘plik qoidalari,
- cross-branch ambiguity filtering,
- band-pass difficulty control,
- semantic distance manipulation.
Asl usulning validatsiyasi
Manba Perrin va hamkasblarining 2014-yilda fransuz korpusida o‘tkazgan validatsiyasini bayon qiladi.
Asl tadqiqot:
- \(N=41\) ishtirokchidan foydalangan,
- True/False jim o‘qish vazifasi bilan an’anaviy oral MNREAD o‘rtasida
- \(r=0.836\), \(p<0.001\)
darajasida kuchli korrelyatsiya qayd etgan.
Shuningdek, True/False tekshirish usuli ovoz chiqarib o‘qish bilan statistik jihatdan teng natijalar bergani bildiriladi.
Inglizcha MATLAB Versiyasi Psixometrik Jihatdan Validatsiya Qilinganmi?
Hali yo‘q. Fransuzcha asl Perrin usuli avval validatsiya qilingan bo‘lsa-da, ushbu maqolada taqdim etilgan inglizcha MATLAB implementatsiyasi English MNREAD yoki IReST kabi o‘rnashgan ingliz testlari bilan formal psixometrik validatsiyani hali yakunlamagan.
Bu farq nega muhim?
Fransuzcha usulning muvaffaqiyatli bo‘lishi uning ingliz tiliga ko‘chirilishi avtomatik ravishda ayni psixometrik xususiyatlarga ega ekanini isbotlamaydi.
Tillar o‘rtasida:
- so‘z chastotasi,
- morfologiya,
- psixolingvistik normalar,
- o‘qish xulqi
farq qilishi mumkin.
Shu sababli mualliflar asboblar to‘plamini yakunlangan ochiq manbali dastur sifatida taqdim etadi, inglizcha formal validatsiyani esa ilmiy hamjamiyat amalga oshirishini kutadi.
Tadqiqot qo‘llab-quvvatlaydigan xulosalar
- Semantik ontologiyadan foydalanib avtomatik True/False gaplar yaratish mumkin.
- Ingliz morfologiyasi va so‘z sinflari uchun maxsus moslashtirishlar talab qilinadi.
- Band-pass filtrlash boshqariladigan psixolingvistik qiyinchilik diapazonlarini yaratishi mumkin.
- Cross-branch ambiguity filtering real dunyo bilimlari bilan ontologiya ziddiyatlarini kamaytirishi mumkin.
- Semantik masofadan kognitiv qiyinchilikni manipulyatsiya qilish uchun foydalanish mumkin.
- Asboblar to‘plami takroriy tajribalarda amalda cheksiz xilma-xillik taqdim etishni maqsad qiladi.
Tadqiqot qo‘llab-quvvatlamaydigan xulosalar
- Inglizcha asboblar to‘plami hali klinik oltin standart ekani ko‘rsatilmagan.
- English MNREAD yoki IReST bilan formal validatsiya yakunlanmagan.
- Fransuzcha N=41 validatsiya natijasi bevosita inglizcha implementatsiya natijasi emas.
- Hard rejimi muayyan klinik buzilishni diagnostik ajrata olishi ko‘rsatilmagan.
- Band-pass filtrlar klinik chegara qiymatlari ekani da’vo qilinmaydi.
Ushbu Asboblar To‘plamining Eng Katta Ilmiy Afzalligi Nima?
Eng katta afzalligi semantik jihatdan nazorat qilingan va to‘g‘ri/noto‘g‘ri qiymati avtomatik ma’lum bo‘lgan ko‘plab noyob gaplarni yaratish bilan birga so‘z qiyinligi, semantik masofa va hissiy xususiyatlarni parametrik boshqara olishidir; bu orqali takroriy testlarda yodlash ta’sirini kamaytirishi va turli kognitiv yuk sharoitlarini yaratishi mumkin.
Metodologik cheklovlar
Birinchi cheklov inglizcha implementatsiyaning hali formal psixometrik validatsiyasi yo‘qligidir.
Ikkinchidan, mavjud ontologiya 97 entity va 23 class bilan cheklangan; shu sababli “cheksiz” variatsiya kombinatorik ma’noda keng bo‘lsa-da, konseptual olam mutlaqo cheksiz emas.
Uchinchidan, semantic distance ning kognitiv qiyinchilik bilan qanchalik chiziqli bog‘liqligi ushbu tadqiqotda empirik o‘lchanmagan.
To‘rtinchidan, Hard preset dagi past valence va past concreteness kombinatsiyalari turli ishtirokchi guruhlarida bir xil kognitiv yuk hosil qilishi tasdiqlanmagan.
Manba va Usul Haqida Izoh
Asl sarlavha:A MATLAB Toolbox for Standardized Reading Speed Assessment: Implementing and Extending the Perrin Sentence Generator for English Corpora
Mualliflar: Daniel P. Spiegel, Romain Bachy.
Muassasa: Meta Reality Labs, 9805 Willows Rd, Redmond, WA 98052, USA.
arXiv: 2606.06297v1 [cs.HC].
Sana: 4 iyun 2026.
Manba turi: Ochiq manbali MATLAB dasturi va usul ishlab chiqish maqolasi.
Asosiy ma’lumot manbai: Glasgow Norms, 5.554 so‘z; CC BY 4.0.
Asosiy usul: Ildizli semantik ontologiya, proto-truth tasnifi, quantifier asosidagi truth mapping, psycholinguistic band-pass filtering, ingliz morfologik xavfsizlik tekshiruvlari va semantic-distance manipulation.
Validatsiya holati: Perrin va hamkasblarining fransuzcha asl yondashuvi N=41 bilan validatsiya qilingan va jim True/False vazifasi bilan oral MNREAD o‘rtasida \(r=0.836,\ p<0.001\) korrelyatsiya qayd etgan. Ushbu maqoladagi inglizcha MATLAB implementatsiyasi esa English MNREAD yoki IReST bilan formal psixometrik validatsiyani hali kutmoqda.
Litsenziya izohi: Asboblar to‘plamida ishlatilgan Glasgow Norms uchinchi tomon ma’lumotlar to‘plami bo‘lib, CC BY 4.0 litsenziyasi bilan taqdim etiladi; qayta tarqatishda asl litsenziya va mualliflik huquqi ma’lumotlari saqlanishi kerak.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan