

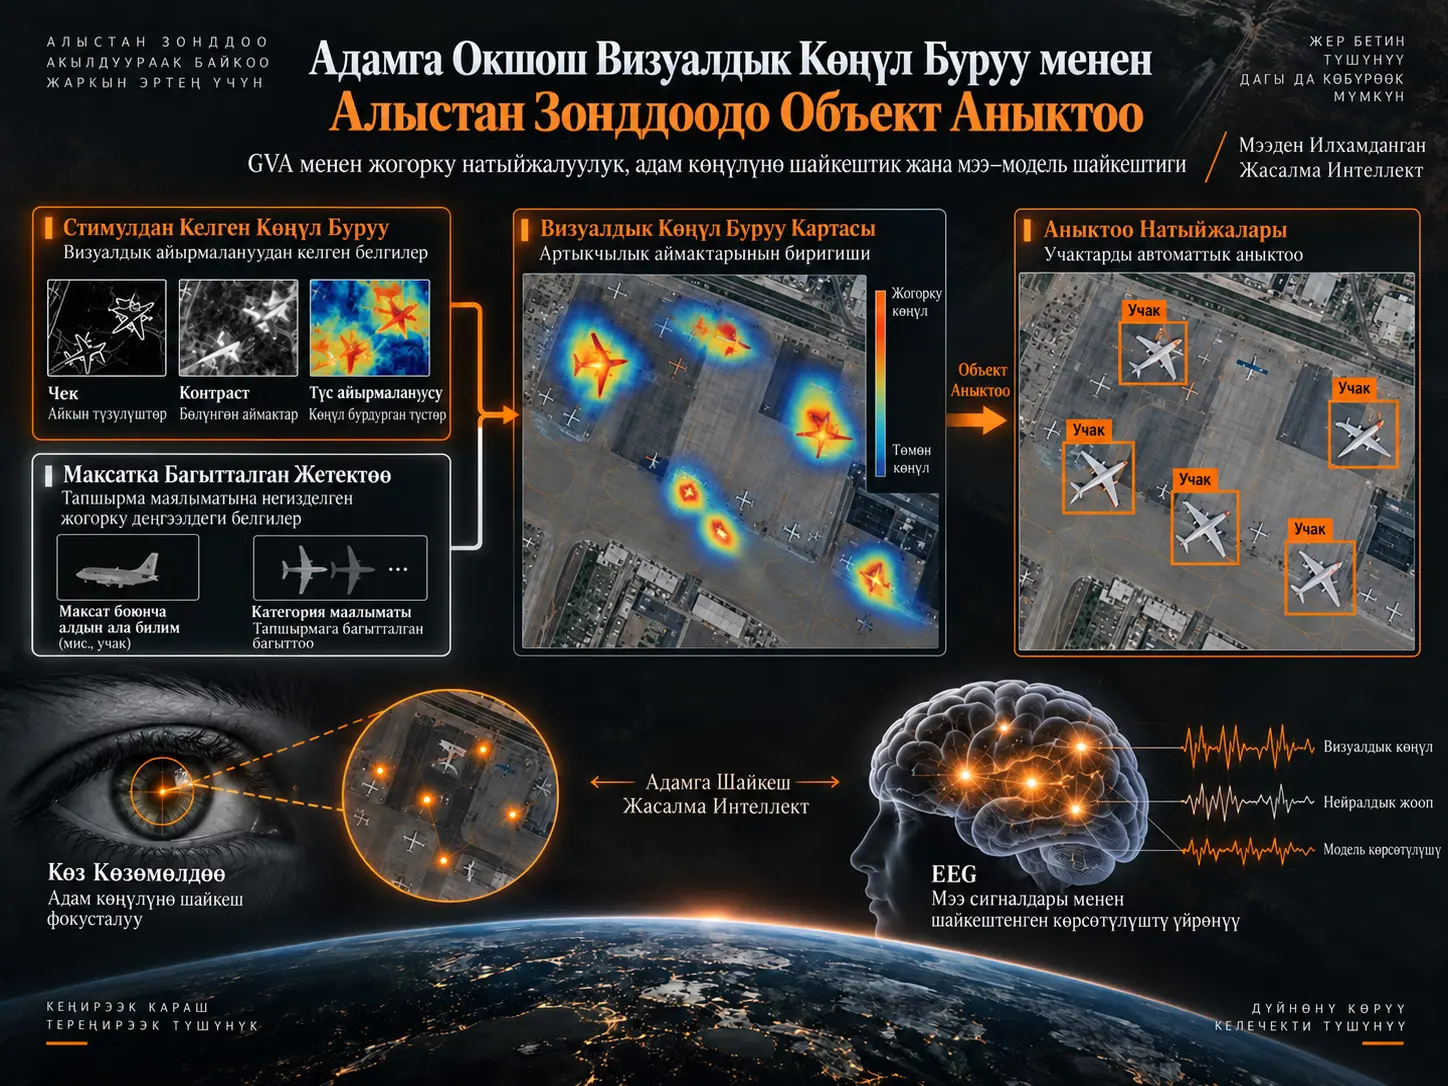
Guided-Search Visual Attention (GVA) — адамдын визуалдык издөөсүндөгү стимулдан келип чыккан визуалдык көрүнүктүүлүк менен тапшырма максатына багытталган көңүл бурууну бирге моделдеп, алыстан зонддоо объекттерин аныктоо тармактарындагы өзгөчөлүктөрдү иштетүү процессин жөнгө салган мээден шыктанган көңүл буруу алкагы. Изилдөө GVAны Faster R-CNN, RetinaNet, YOLOv5s, YOLOv8n жана CenterNet болуп беш башка объект аныктоо архитектурасына киргизип, натыйжалуулукту DIOR маалымат топтомунда, адам менен жүрүм-турумдук шайкештикти бир убактагы көз кыймылын көзөмөлдөө маалыматтары аркылуу жана мээ–модель өкүлчүлүк шайкештигин EEG негизиндеги representational similarity analysis аркылуу баалаган. Учак категориясында бардык архитектуралар AP50 көрсөткүчүнүн өсүшүн көрсөткөн жана эң чоң абсолюттук өсүш YOLOv5 үчүн +0,260 болгон. GVA көңүл буруу картасынын адамдын фиксация бөлүштүрүлүшү менен Pearson корреляциясы 0,740ка жеткен; EEG–модель RSA анализинде эң көрүнүктүү шайкештик өсүштөрү эрте визуалдык коддоо менен байланышкан оксипиталдык аймакта жана top-down көңүл бурууну көзөмөлдөө менен байланышкан фронталдык аймакта билдирилген. Ошентсе да, изилдөө азырынча рецензиядан өтө элек preprint болуп саналат жана мээ менен шайкештик колдонулган EEG/RSA өлчөө алкагынын чегинде гана чечмелениши керек.
Азыркы алыстан зонддоо моделдеринде attention механизмдери кеңири колдонулат; бирок бул механизмдердин көпчүлүгү адамдын визуалдык көңүл буруусун туураш үчүн эмес, түздөн-түз тапшырманын натыйжалуулугун оптималдаштыруу үчүн үйрөнүлөт. Ошондуктан модель көңүл бурган аймактар менен кесипкөй адам байкоочулар сүрөттөн издеген аймактар айырмаланышы мүмкүн.
Макаланын баштапкы чекити — дал ушул айырма. Изилдөөчүлөр модель көңүлүн түздөн-түз адамдын фиксация карталарына дал келтирүүнүн ордуна, адамдын визуалдык издөөсүнүн негизинде жаткан guided search механизмин эсептөө модулуна айландырууну сунушташат. Муну менен адамдын жүрүм-турумунун жыйынтыгын гана көчүрбөстөн, көңүл буруунун бөлүштүрүлүшүн жаратуучу эки негизги процесс моделденүүгө аракет кылынат.
Биринчи процесс — stimulus-driven saliency, башкача айтканда сүрөттөгү четтер, түс айырмасы жана жергиликтүү өзгөчөлүк сыяктуу төмөн деңгээлдеги белгилердин көңүлдү өзүнөн-өзү тартуусу. Экинчи процесс — target-directed guidance, башкача айтканда байкоочунун “учак издеп жатам” сыяктуу тапшырма максаты көңүлдү бутага окшош аймактарга багыттайт. GVA бул эки картаны бириктирип, визуалдык жактан көңүл бурдурган жана тапшырма үчүн маанилүү аймактарды алдыга чыгарат.
Адамга Окшош Визуалдык Көңүл Буруу Алыстан Зонддоодо Объект Аныктоо Үчүн Эмне Үчүн Маанилүү?
Адамга окшош визуалдык көңүл буруу моделдин сүрөттөгү статистикалык жактан күчтүү белгилерге гана эмес, адамдар бута издегенде артыкчылык берген визуалдык жана тапшырмага тиешелүү аймактарга да багытталышын максат кылат. Алыстан зонддоо сүрөттөрүндө буталар кичине, сейрек жана жыш фондун ичинде болушу мүмкүн болгондуктан, мындай көңүл буруу механизми жалган оң натыйжаларды азайтып, өткөрүп жиберилген буталарды азайтып жана модель чечимдерин адамдын визуалдык издөө стратегиялары менен салыштырууну жеңилдете алат.
Алыстан зонддоо сүрөттөрүндө аэропорттун учуп-конуу тилкелери, кургактык беттери, суу аймактары, имараттар же башка жыш текстуралар бута болбосо да күчтүү визуалдык белгилерди жаратышы мүмкүн. Салттуу detector мындай аймактарда жогорку activation түзүп, керексиз bounding box-тарды жаратышы мүмкүн.
Ал эми адам байкоочу сүрөттөгү бардык жогорку контрасттуу аймактарга бирдей мамиле кылбайт. Ал сүрөттүн өзүнөн келип чыккан визуалдык көрүнүктүүлүктү издеп жаткан объект тууралуу алдын ала билими менен бириктирет. Guided search theory адамдын визуалдык издөөсүн дал ушул эки маалымат агымынын биригиши катары түшүндүрөт.
Guided Search Theory GVA Моделине Кантип Айландырылат?
GVA guided search theoryдеги эки негизги көңүл буруу булагын өзүнчө эсептөө жолдору катары ишке ашырат: bottom-up жолу сүрөттөгү чет жана түс өзгөчөлүгү сыяктуу тапшырмадан көз каранды эмес визуалдык белгилерди чыгарат, ал эми top-down жолу бута классы тууралуу үйрөнүлгөн визуалдык алдын ала маалыматтан бута ыктымалдуулук картасын түзөт. Эки карта пиксел деңгээлинде көбөйтүлүп, жалпы артыкчылык картасы түзүлөт жана көрүнүктүү да, тапшырмага тиешелүү да болгон аймактар гана күчтүү көңүл бурууга ээ болот.
Bottom-up: Стимулдан келип чыккан көрүнүктүүлүк жолу
Stimulus-driven saliency жолу бута эмне экенин билбестен, сүрөттүн өзүнүн визуалдык белгилерине карап көңүл буруу картасын түзөт. Булак бул иштетүү чынжырын толук түшүндүрүүгө боло турган классикалык сүрөт иштетүү кадамдары менен курат.
Адегенде сүрөт mean-shift filtering менен иштетилип, CIE-Lab түс мейкиндигине өткөрүлөт. Андан кийин үч масштабдуу Gaussian pyramid колдонулат:
- 1× баштапкы чечилиш,
- 0,5× масштаб,
- 0,25× масштаб.
Ар бир масштабда 3×3 Sobel оператору менен чет белгилери чыгарылат. Мындан тышкары, ар бир пикселдин айланасына салыштырмалуу түсү канчалык сейрек же адаттан тыш экенин өлчөгөн color-rarity картасы эсептелет.
Bottom-up attention map булакта төмөнкүдөй аныкталат:
\[ M_{bu}(x,y)= \mathcal{N} \left[ \sum_{s=1}^{3} w_s \left( E_s(x,y)+C_s(x,y) \right) \right] \]
Бул жерде \(E_s\) — s масштабындагы чет белгилер картасы; \(C_s\) — түс сейректиги картасы; \(w_s\) — масштаб салмагы; ал эми \(\mathcal{N}\) — min-max нормалдаштыруу.
Top-down: Бутага багытталган жетектөө жолу
Экинчи жол тапшырмага мүнөздүү бута маалыматын attention mapке алып келет. Изилдөөдө учак буталарынын Lab түс белгилерин үйрөнүү үчүн кол менен белгиленген 500 учак үлгүсүндө Random Forest классификатору окутулган.
Random Forest:
- 10 дарак,
- максималдуу тереңдик 5
колдонот жана ар бир пиксел үчүн бута ыктымалдыгын чыгарат. Бул карта 5×5 Gaussian kernel жана \(\sigma=2\) менен жумшартылат.
Top-down guidance map:
\[ M_{td}(x,y)= \mathcal{N} \left[ G_{\sigma=2} * RF(Lab(x,y)) \right] \]
түрүндө берилет.
Бул жердеги Random Forest detectorдун train/test бөлүктөрүнөн көз каранды эмес кошумча сүрөт бөлүктөрүндө окутулуп, маалыматтын чыгып кетишинин алдын ала тургандай түзүлгөн.
Эки көңүл буруу жолу кантип бириктирилет?
Bottom-up жана top-down attention карталары element-wise multiplication аркылуу бириктирилет. Ошентип, физикалык жактан көңүл бурдурган, бирок бутага тиешеси жок аймактарды жана бутага окшош, бирок визуалдык далили алсыз аймактарды басаңдатуу максат кылынат.
Бириктирилген карта marker-controlled watershed алгоритми менен талапкер аймактарга бөлүнөт. Булакта талапкерлер төмөнкү шарттар менен чыпкаланары айтылат:
- аянт: 50–8000 пиксел,
- тараптар катышы: 0,2–5.
Жарактуу аймак борборлоруна \(\sigma=10\) пиксел болгон эки өлчөмдүү Gaussian өзөктөрү жайгаштырылып, акыркы адамга окшош attention map түзүлөт:
\[ A_{GVA}(x,y)= \mathcal{N} \left[ \sum_{k=1}^{K} \mathcal{G} \left( (x,y);c_k,\sigma=10 \right) \right] \]
Бул жерде \(K\) жарактуу талапкер аймактардын санын, \(c_k\) болсо алардын борборлорун билдирет.
GVA Чындап Параметрсиз Көңүл Буруу Модулубу?
GVAны detector тармагына киргизүү жаңы үйрөнүлүүчү терең тармак параметрлерин кошпойт жана bottom-up saliency жолу детерминисттик сүрөт иштетүү операцияларынан турат; бирок top-down guidance жолу 500 белгиленген үлгүдө окутулган Random Forest колдонот. Ошондуктан булактагы “parameter-free” деген сөз GVAнын бүт эсептөө чынжырында эч кандай үйрөнүлгөн бөлүк жок дегенди эмес, detector архитектурасына жаңы оптималдаштырылуучу нейрон тармак параметрлери кошулбай турганын билдирет деп этият чечмелениши керек.
Бул айырма методологиялык жактан маанилүү. Булак detectorдун classification жана regression бутактары өзгөртүлбөгөнүн, GVA native loss функцияларын сактарын жана detector окутуусуна жаңы learnable layer кошулбасын белгилейт.
Бирок target-directed attention map түзүү үчүн колдонулган Random Forest алдын ала окутулат. Демек, GVAнын top-down компоненти бута классына байланыштуу үйрөнүлгөн маалыматты алып жүрөт.
GVA беш башка detectorго кантип киргизилет?
| Архитектура | Detector түрү | GVA киргизүү ыкмасы |
|---|---|---|
| Faster R-CNN | Эки баскычтуу | Watershed аркылуу алынган GVA candidate box-тары классикалык жыш anchor-лардын ордуна колдонулат; аймактагы орточо attention score proposal confidence катары бааланат. |
| RetinaNet | Бир баскычтуу, anchor-based | GVA талапкерлери алдын ала аныкталган multi-scale anchor grid-дердин ордуна колдонулат. |
| YOLOv5s | Бир баскычтуу, anchor-based | GVA binary mask өзгөчөлүк карталарынын өлчөмүнө масштабдалат; gradient backpropagation жана чыгуу аймактары адамга окшош attention аймактары менен чектелет. |
| YOLOv8n | Бир баскычтуу | GVA mask feature-map масштабына ылайыкташтырылып, feature allocation жана prediction аймактарын модуляциялайт. |
| CenterNet | Anchor-free | Кайра масштабдалган GVA mask center-point heatmap божомолдорун модуляциялайт. |
Изилдөөнүн маанилүү дизайн чечими — GVAны detector backbone менен Feature Pyramid Network (FPN) ортосуна жайгаштырып, негизги detector архитектурасын мүмкүн болушунча өзгөртпөө.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
EEGET-RSOD көз кыймылын көзөмөлдөө жана EEG маалымат топтому
Адам жүрүм-туруму жана мээ өкүлчүлүгү үчүн benchmark катары EEGET-RSOD маалымат топтому колдонулган. Топтомдо DIORдон алынган 1.000 даана 800×800 пиксел оптикалык алыстан зонддоо сүрөтү бар.
Изилдөөгө 38 катышуучу киргизилген жана булак бардык катышуучулар жазуу жүзүндө informed consent бергенин билдирет. Этикалык уруксат Beijing Normal University Ethics Committee тарабынан 20221024111 номери менен берилген.
| Өлчөө | Жабдык / параметр |
|---|---|
| Көз кыймылын көзөмөлдөө | SMI RED250, 250 Hz |
| EEG | NE Enobio, 32 канал, 500 Hz, 10–20 жайгашуусу |
| Синхрондоштуруу | <2 ms trigger катасы |
| Стимул узактыгы | 3000 ms |
| Бош экран | 500 ms |
Фиксациялар I-DT алгоритми менен чыгарылып, топтук fixation heatmap-тер \(\sigma=8\) Gaussian kernel менен түзүлгөн.
EEG алдын ала иштетүү
EEG сигналдарына:
- 0,5–45 Hz чыпкалоо,
- mastoid re-referencing,
- ICA менен artefact тазалоо,
- −200–0 ms baseline correction
колдонулган.
Төрт функционалдык аймак ар башка убакыт терезелери менен аныкталган:
| Мээ аймагы | Убакыт терезеси |
|---|---|
| Оксипиталдык | 0–300 ms |
| Темпоралдык | 100–400 ms |
| Фронталдык | 200–500 ms |
| Париеталдык | 300–600 ms |
Whole-brain Representational Similarity Matrices болсо 0–600 ms терезесинде түзүлгөн.
Detector окутуу тартиби
Detector эксперименттеринин негизги бөлүгү DIOR учак кичи топтомунда жүргүзүлгөн.
| Параметр | Маани |
|---|---|
| Train / validation / test | 7 : 2 : 1 |
| Framework | PyTorch |
| GPU | RTX 4090 |
| Batch size | 16 |
| Киргизүү чечилиши | 800×800 |
| Epoch | 300 |
| Backbone башталышы | ImageNet pre-trained |
| Checkpoint тандоо | Эң жогорку AP50 |
GVA Объект Аныктоо Натыйжалуулугун Канчага Жогорулатты?
DIOR учак тестинде GVA кошулганда беш detectorдун баарында AP50 жогорулаган; архитектуралар арасындагы эң чоң абсолюттук өсүш YOLOv5те 0,680ден 0,940ка көтөрүлүп, +0,260 болгон. Баштапкы натыйжалуулугу начарыраак моделдер чоңураак пайда алган, ал эми баштапкы натыйжалуулугу жогору RetinaNet жана YOLOv8де өсүштөр азыраак болгон.
| Модель | Baseline Precision | Baseline Recall | Baseline AP50 | GVA Precision | GVA Recall | GVA AP50 | AP50 айырмасы |
|---|---|---|---|---|---|---|---|
| Faster R-CNN | 0,915 | 0,442 | 0,600 | 0,786 | 0,739 | 0,760 | +0,160 |
| YOLOv5 | 0,717 | 0,647 | 0,680 | 0,979 | 0,907 | 0,940 | +0,260 |
| CenterNet | 0,841 | 0,775 | 0,810 | 0,901 | 0,852 | 0,880 | +0,070 |
| RetinaNet | 0,982 | 0,874 | 0,920 | 0,991 | 0,918 | 0,950 | +0,030 |
| YOLOv8 | 0,982 | 0,932 | 0,920 | 0,974 | 0,938 | 0,960 | +0,040 |
Faster R-CNNде baseline model абдан жогорку precisionга карабастан болгону 0,442 recall көрсөткөн. GVAдан кийин recall 0,739га көтөрүлүп, precision 0,786га түшкөн, бирок AP50 жалпысынан 0,600дөн 0,760ка жогорулаган.
YOLOv5те precision да, recall да бир убакта жогорулап, бул модель эң чоң жалпы detector пайдасын алган.
Күчтүү моделдер эмне үчүн азыраак пайда алышат?
Булактын түшүндүрмөсү боюнча, баштапкы натыйжалуулугу төмөн моделдерде фонду басаңдатуу жана precision–recall тең салмагын жакшыртуу үчүн көбүрөөк мүмкүнчүлүк бар. RetinaNet жана YOLOv8 сыяктуу күчтүү baseline моделдерде буга чейин эле өнүккөн feature fusion жана attention жүрүм-туруму бар болгондуктан, GVA бул моделдерде көбүрөөк майда жөндөө эффектисин берет.
GVA Ар Түрдүү Алыстан Зонддоо Буталарына Жалпылана Алдыбы?
YOLOv5те жүргүзүлгөн төрт класстуу экспериментте GVA учак, кеме, сактоо цистернасы жана көпүрө категорияларынын баарында AP50 өсүшүн камсыз кылган; орточо AP50 0,666дан 0,855ке көтөрүлгөн. Бирок пайда өлчөмү бута геометриясына жараша олуттуу айырмаланган, эң чоң өсүш сактоо цистерналарында, эң кичине өсүш көпүрөлөрдө болгон.
| Категория | Baseline AP50 | GVA AP50 | Абсолюттук айырма |
|---|---|---|---|
| Учак | 0,680 | 0,942 | +0,262 |
| Кеме | 0,914 | 0,958 | +0,044 |
| Сактоо цистернасы | 0,493 | 0,918 | +0,425 |
| Көпүрө | 0,576 | 0,603 | +0,027 |
| Орточо | 0,666 | 0,855 | +0,189 |
Булак компакттуу жана туруктуу геометриялуу буталарда чет жана color-rarity механизми натыйжалуураак экенин, ал эми узун сызыктуу түзүлүштөр болгон көпүрөлөр азыркы saliency дизайнына азыраак туура келерин сунуштайт.
Учак үчүн негизги беш-модель экспериментинде AP50 0,940 деп, ал эми категориялар аралык экспериментте 0,942 деп берилген. Булар ар башка эксперименттик таблицалардагы маанилер жана аларды мажбурлап бирдей кылууга болбойт.
GVA Адамдын Көз Кыймылдары Менен Канча Шайкеш?
Адамдын fixation heatmap-тери менен салыштырууда GVA үчүн CC=0,740, NSS=2,600 жана KL=0,898 билдирилген; бул маанилер модель attention адамдын кароо бөлүштүрүлүшүнө baseline detectorлорго караганда жакыныраак экенин көрсөтөт. Бирок колдонулган метрикалар көңүл буруунун ар башка касиеттерин өлчөйт жана бирдиктүү “адамга окшоштук пайызы” катары бириктирилбеши керек.
Көңүл буруу шайкештик метрикалары
| Метрика | Эмнени өлчөйт? | Жакшы багыт |
|---|---|---|
| CC | Attention карталарынын жалпы мейкиндиктик корреляциясы | Жогору |
| SSIM | Мейкиндиктик/структуралык окшоштук | Жогору |
| NSS | Model saliencyнин адам фиксация чекиттеринде топтолушу | Жогору |
| KL divergence | Эки көңүл буруу ыктымалдык бөлүштүрүлүшүнүн айырмасы | Төмөн |
GVA абляциясы эмнени көрсөттү?
Булак төрт системаны салыштырат:
- Itti saliency baseline,
- stimulus-driven saliency гана,
- target-directed guidance гана,
- толук Guided-Search Visual Attention.
| Ыкма | CC | SSIM | NSS | KL |
|---|---|---|---|---|
| Itti | 0,388 | 0,357 | 0,920 | 1,562 |
| Stimulus-driven | 0,505 | 0,613 | 2,598 | 2,090 |
| Target-directed | 0,511 | 0,565 | 2,017 | 1,826 |
| Full GVA | 0,740 | 0,581 | 2,600 | 0,898 |
Бул таблица эки жолдуу дизайн өзгөчө CC жана KL жагынан күчтүү толуктоочулукту берерин көрсөтөт. GVA эң жогорку CC жана NSS, эң төмөн KL маанисин берет.
Булак ичиндеги карама-каршылык: ошол эле бөлүмдүн тексти толук GVA бир жолдуу ыкмаларды “бардык метрикаларда” ашып өттү десе да, 4-сүрөттө stimulus-driven жолдун SSIM мааниси 0,613, толук GVAniki 0,581. Демек SSIM боюнча 4-сүрөт бул сүйлөмдү колдобойт.
Мээ–Модель Шайкештиги Кантип Өлчөндү?
Мээ–модель шайкештиги detectorдун FPN катмарларындагы P3, P4 жана P5 белгилеринен түзүлгөн Representational Similarity Matrices менен fixation-locked EEG сигналдарынан түзүлгөн RSMдердин Spearman корреляциясы аркылуу өлчөнгөн. Бул ыкма модель “мээ сыяктуу ойлойт” дегенди түздөн-түз көрсөтпөйт; ар башка стимулдардын ортосундагы өкүлчүлүк мамилелер адам EEGсиндеги өкүлчүлүк геометриясына канчалык окшош экенин текшерет.
Model RSMдерин түзүү
Target жана background аймактары ROI-Align менен P3, P4 жана P5 feature map-терден кесилип, pooled жана normalize кылынган. Ар бир стимул жуптарынын ортосундагы cosine dissimilarity колдонулуп model RSMдери түзүлгөн.
EEG RSMдерин түзүү
EEG epoch-тор көз фиксация белгилерине ылайык target жана background болуп бөлүнгөн. Төрт кортикалдык аймактагы ERP сигналдары model feature тартибине ылайык келген feature векторлоруна айландырылып, Fisher-Z transform колдонулган жана катышуучулар арасында орточолонгон.
Model менен EEG RSM ортосундагы байланыш Spearman rank correlation менен өлчөнүп, статистикалык маанилүүлүк 5.000 permutation тести жана FDR correction аркылуу бааланган.
P3, P4 жана P5 катмарларында эмне болду?
Baseline detectorлордо мээ–модель корреляциялары төмөн жана тартипсиз; Spearman's r болжол менен 0,006–0,024 аралыгында.
GVAдан кийин шайкештик бардык архитектураларда жогорулап, жалпысынан P3төн P5ке карай күчөгөн катмардык градиент пайда болгон.
Булактын P3–P5 боюнча билдирген максималдуу RSA өсүштөрү:
| Модель | Максималдуу RSA өсүшү | Орточо RSA өсүшү |
|---|---|---|
| Faster R-CNN | 133% | 108% |
| YOLOv5 | 50% | 73% |
| RetinaNet | 14% | 13% |
| CenterNet | 40% | 78% |
| YOLOv8 | 4% | 31% |
Бул пайыздык өсүштөр төмөн баштапкы корреляцияларга салыштырмалуу салыштырмалуу өсүш экенин унутпоо керек; абсолюттук RSA маанилери кичине бойдон калат.
GVA Кайсы Мээ Аймактары Менен Көбүрөөк Шайкеш Келди?
Аймактык RSA анализинде эң чоң орточо өсүш оксипиталдык кортексте Δρ=0,012, экинчи чоң өсүш фронталдык кортексте Δρ=0,008 деп билдирилген. Париеталдык Δρ=0,001 жана темпоралдык Δρ=0,003 өсүштөрү азыраак болуп, булакта көбүнчө статистикалык маанилүү эмес экени айтылат.
Булак бул бөлүштүрүүнү GVA архитектурасынын эки жолу менен байланыштырат:
- Оксипиталдык өсүш: чет жана түс контрасты сыяктуу эрте визуалдык белгилерди bottom-up saliency жолу менен иштетүү,
- Фронталдык өсүш: бутага багытталган top-down көңүл буруу көзөмөлүн task-guidance жолу менен моделдөө.
Бул түшүндүрмө механисттик гипотеза. EEGнин мейкиндиктик чечилиши, булактын өзү да чектөө катары белгилегендей, майда масштабдагы кортикалдык механизмдер тууралуу тыянак чыгарууга мүмкүндүк бербейт.
Катмар иерархиясы менен адамдын визуалдык иерархиясы бир эле нерсеби?
Булак GVAдан кийин P3төн P5ке өсүп жаткан RSAны адамдын визуалдык системасынын иерархиялык иштетүү тартиби менен шайкеш көрүнүш катары чечмелейт. Бирок P3/P4/P5 detector белгилери конкреттүү кортикалдык иштетүү баскычтарына бирден-бир анатомиялык эквивалент экени көрсөтүлгөн эмес.
Туура билдирүү — model feature иерархиясындагы өкүлчүлүк шайкештигинин терең катмарларга карай өсүшү колдонулган EEG/RSA алкагынын ичинде адамдын визуалдык иштетүү иерархиясына көбүрөөк шайкеш келген көрүнүштү түзөт.
Статистикалык баалоо
Көз кыймылын көзөмөлдөө attention метрикалары үчүн one-way ANOVA, FDR-adjusted Tukey HSD жана 1.000 bootstrap үлгүсү колдонулган.
Neural RSA үчүн 5.000 permutation тести колдонулуп, \(\alpha=0,05\) деңгээлинде FDR correction жүргүзүлгөн.
Булак негизги visual alignment салыштырууларында FDR-corrected \(p<0,001\) деп билдирет.
Изилдөө колдогон жыйынтыктар
- GVA guided search theoryдеги bottom-up жана top-down көңүл буруу механизмдерин бириктирген эки жолдуу attention алкагы.
- DIOR учак тестинде GVA сыналган беш detectorдун баарында AP50ни жогорулаткан.
- Архитектуралар арасындагы эң чоң учак AP50 өсүшү YOLOv5 үчүн +0,260.
- YOLOv5тин төрт категориялуу жалпылоо экспериментинде орточо AP50 0,666дан 0,855ке көтөрүлгөн.
- GVA attention map адам fixation бөлүштүрүлүшү менен CC=0,740 маанисине жеткен.
- Full GVA 4-сүрөттө CC, NSS жана KL боюнча бир жолдуу варианттардан алдыда.
- EEG–model RSA маанилери GVAдан кийин сыналган архитектураларда жогорулаган.
- Эң көрүнүктүү аймактык RSA өсүштөрү оксипиталдык жана фронталдык аймактарда билдирилген.
- GVAны detectorго киргизүү native classification/regression branch-терин жана loss функцияларын өзгөртпөйт.
Изилдөө колдобогон жыйынтыктар
- GVA колдонгон detectorлор адам мээси менен бирдей эсептөөнү аткарары көрсөтүлгөн эмес.
- CC=0,740 маанисин жалпы мааниде “модель адам мээсине %74 окшош” деп чечмелөөгө болбойт.
- EEG RSA корреляциясы клиникалык же биологиялык эквиваленттүүлүктүн далили эмес.
- Когнитивдик alignment маалыматтары учактан башка бута категорияларында азырынча тастыкталган эмес.
- GVA SAR же hyperspectral сүрөттөрдө ошол эле натыйжалуулукту берери көрсөтүлгөн эмес.
- GVA бардык алыстан зонддоо detectorлорунда бирдей AP50 өсүшүн берет деп далилденген эмес.
- “Parameter-free” деген сөз top-down Random Forest такыр окутулган эмес дегенди билдирбейт.
- 4-сүрөт full GVA SSIM боюнча stimulus-driven жолдон жогору экенин көрсөтпөйт.
- Preprint жыйынтыктары рецензияланган акыркы далил катары каралбашы керек.
Изилдөөнүн чектөөлөрү
Булак үч негизги чектөөнү ачык көрсөтөт.
- Когнитивдик маалымат чектөөсү: көз кыймылын көзөмөлдөө жана EEG alignment баалоосу учак буталары үчүн гана бар. Башка категорияларда detector натыйжалуулугу текшерилген, бирок тиешелүү адам cognitive benchmark азырынча жок.
- Модалдуулук чектөөсү: изилдөө оптикалык remote sensing сүрөттөрүндө гана жүргүзүлгөн; SAR жана hyperspectral сүрөттөр сыналган эмес.
- EEG мейкиндиктик чечилиши: EEG neural mechanism анализин макроскопиялык функционалдык мээ аймактары менен чектейт.
Келечектеги изилдөө багыттары
Авторлор bottom-up saliency механизмин ар башка сенсор модалдуулуктарына ылайыкташтырууга болорун сунушташат. SAR үчүн polarimetric signatures, hyperspectral сүрөттөр үчүн spectral band белгилери түс маалыматынын ордуна колдонулушу мүмкүн болгон талапкер өкүлчүлүктөр.
Белгиленген үлгүлөр аз болгон чоң аймактык байкоо колдонмолорунда top-down priorду unsupervised же self-supervised ыкмалар менен үйрөнүү да келечектеги изилдөө багыты катары көрсөтүлөт.
Изилдөө ошондой эле GVA киргизилиши detectorго жаңы trainable neural-network параметрлерин кошпогондуктан lightweight жана edge-processing архитектуралары үчүн потенциалга ээ деп сунуштайт; бирок чыныгы edge түзмөгүндө кеңири latency же энергия керектөө эксперименти билдирилген эмес.
Булак жана Ыкма Жөнүндө Эскертүү
Түпнуска аталышы: Embedding human-like visual attention for brain-aligned and high-performance remote sensing object detection
Авторлор: Bing He, Tong Qin, Dajun Xing, Ying Qu, Qiaosong Hei, Chunfeng Gao, Zheng Gong, Qiao Wang, Weihua Dong
Булак түрү: Preprint изилдөө макаласы.
SSRN каттоо номери: 7346288.
SSRNге жүктөлгөн: 24 август 2026.
Рецензия статусу: Булак ачык түрдө “This preprint research paper has not been peer reviewed” деген билдирүүнү камтыйт.
Негизги ыкма: Guided-Search Visual Attention (GVA).
Теориялык негиз: Guided search theory; stimulus-driven saliency жана target-directed guidance жолдорун priority map түзүү үчүн бириктирүү.
Detectorлор: Faster R-CNN, RetinaNet, YOLOv5s, YOLOv8n жана CenterNet.
Негизги объект аныктоо маалымат топтому: DIOR.
Когнитивдик benchmark: EEGET-RSOD; 1.000 даана 800×800 remote sensing сүрөтү жана 38 катышуучунун бир убактагы көз кыймылын көзөмөлдөө–EEG маалыматтары.
Этикалык уруксат: Beijing Normal University Ethics Committee, No. 20221024111.
Eye tracker: SMI RED250, 250 Hz.
EEG: NE Enobio, 32 канал, 500 Hz, 10–20 жайгашуусу.
Visual alignment метрикалары: Pearson correlation coefficient (CC), structural similarity index (SSIM), normalized scanpath saliency (NSS), Kullback–Leibler divergence (KL).
Neural alignment ыкмасы: Representational Similarity Analysis (RSA), model P3/P4/P5 FPN белгилери жана fixation-locked EEG RSMдери.
Data availability: Булак EEGET-RSOD маалымат топтомун Figshare платформасында 10.6084/m9.figshare.26943565 DOI менен көрсөтөт.
Code availability: Булак анализ коду GitHubдагы “Bing-1997/Human-like_visual_attention_embedding_framework” репозиторийинде бар экенин билдирет.
Булак ичиндеги маанилүү нюанс: GVA detectorго жаңы үйрөнүлүүчү neural-network параметрлерин кошпойт; бирок target-directed жолу 500 белгиленген үлгүдө окутулган Random Forest колдонот.
Булак ичиндеги маанилүү карама-каршылык: 4-сүрөттө full GVA SSIM=0,581, stimulus-driven saliency SSIM=0,613; ошондуктан ошол эле бөлүмдөгү “full GVA all metrics'te üstündür” сүйлөмү SSIM боюнча сүрөт менен шайкеш келбейт.
Негизги чечмелөө чеги: “Brain-aligned” жыйынтыгы EEG/RSA жана eye-tracking метрикаларында өлчөнгөн өкүлчүлүк/көңүл буруу окшоштугун билдирет; бул түздөн-түз биологиялык механизм эквиваленттүүлүгүн же мээнин эсептөө процессин көчүрүүнү билдирбейт.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген