

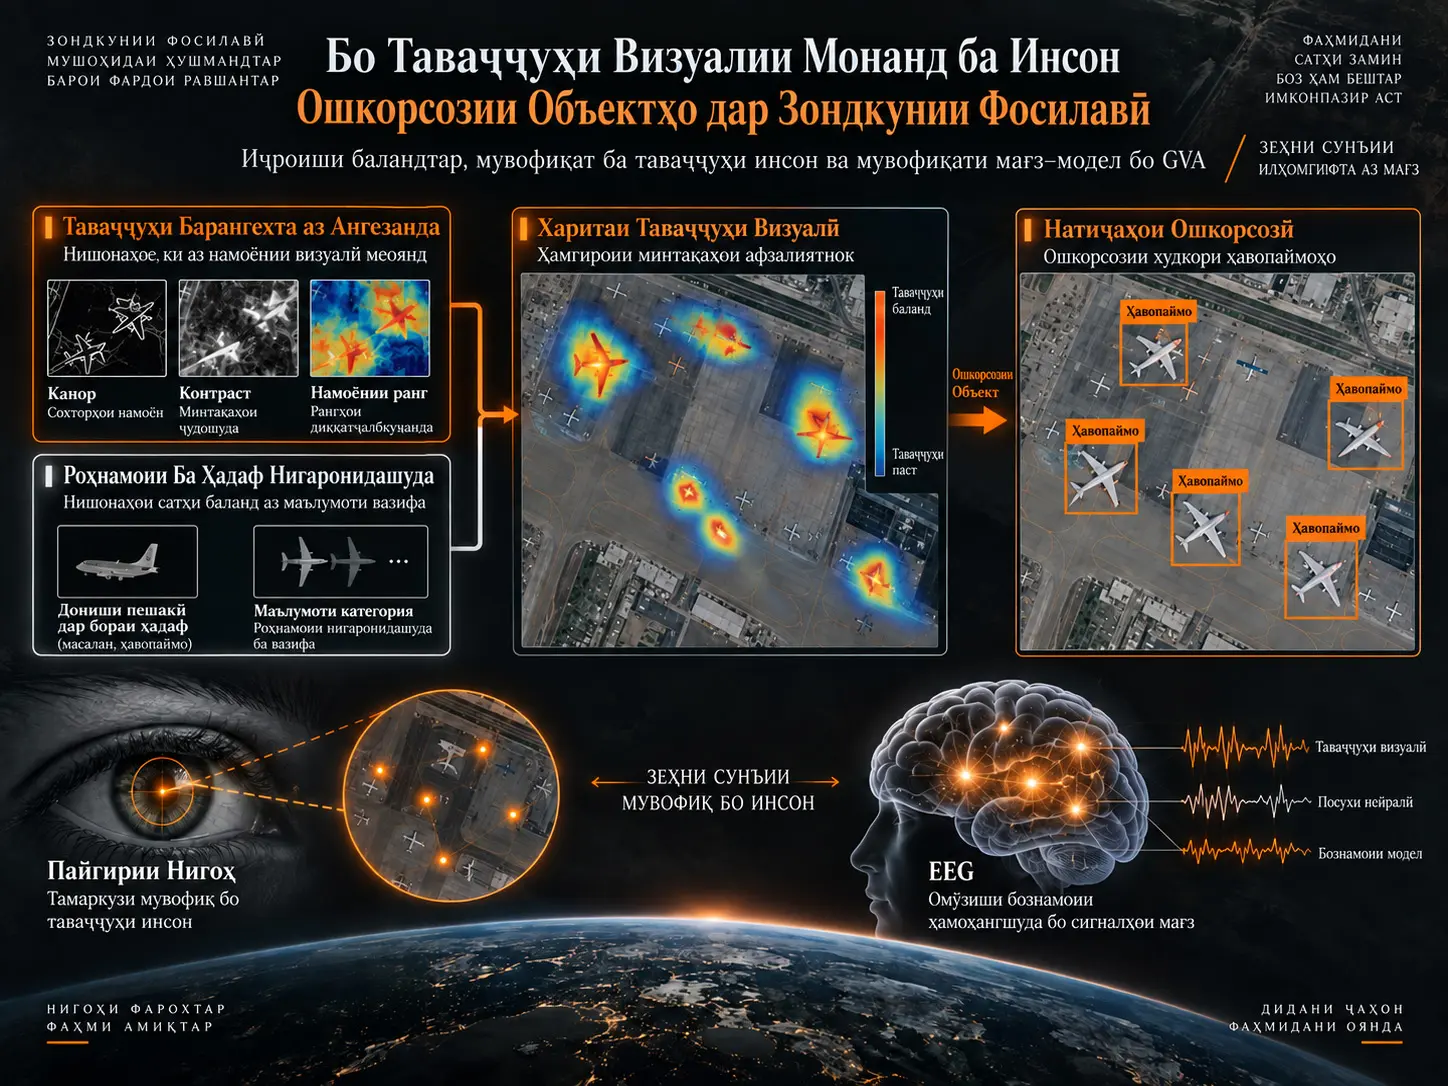
Guided-Search Visual Attention (GVA) як чаҳорчӯбаи таваҷҷуҳи илҳомгирифта аз мағз мебошад, ки раванди коркарди хусусиятҳоро дар шабакаҳои ошкорсозии объектҳои зондкунии фосилавӣ тавассути моделсозии ҳамзамони намоёнии визуалии бармеангехта аз ангезанда ва роҳнамоии таваҷҷуҳи ҳадафманд дар ҷустуҷӯи визуалии инсон танзим мекунад. Таҳқиқот GVA-ро ба панҷ меъмории гуногуни ошкорсозии объект — Faster R-CNN, RetinaNet, YOLOv5s, YOLOv8n ва CenterNet — ворид карда, иҷроишро дар маҷмӯаи додаҳои DIOR, мувофиқати рафторӣ бо инсонро бо додаҳои ҳамзамони пайгирии чашм ва мувофиқати намояндагии мағз–моделро бо representational similarity analysis-и асосёфта ба EEG арзёбӣ кардааст. Дар категорияи ҳавопаймо ҳамаи меъмориҳо афзоиши AP50 нишон доданд ва бузургтарин афзоиши мутлақ барои YOLOv5 +0,260 буд. Коррелятсияи Pearson байни харитаи таваҷҷуҳи GVA ва тақсимоти fixation-и инсон ба 0,740 расид; дар таҳлили EEG–model RSA афзоишҳои равшантарини мувофиқат дар минтақаи оксипиталӣ, ки бо рамзгузории барвақти визуалӣ алоқаманд аст, ва дар минтақаи фронталӣ, ки бо назорати таваҷҷуҳи top-down алоқаманд аст, гузориш шуданд. Бо вуҷуди ин, таҳқиқот ҳанӯз preprint-и аз баррасии ҳамтоён нагузашта мебошад ва мувофиқати мағз бояд танҳо дар доираи чаҳорчӯбаи ченкунии EEG/RSA-и истифодашуда тафсир карда шавад.
Дар моделҳои муосири зондкунии фосилавӣ механизмҳои attention ба таври васеъ истифода мешаванд; аммо қисми зиёди ин механизмҳо на барои тақлид кардани таваҷҷуҳи визуалии инсон, балки барои мустақиман беҳина кардани иҷроиши вазифа омӯхта мешаванд. Аз ин рӯ, минтақаҳое, ки модел ба онҳо таваҷҷуҳ мекунад, метавонанд аз минтақаҳое, ки нозирони касбии инсон дар тасвир меҷӯянд, фарқ кунанд.
Нуқтаи оғози мақола ҳамин фарқият аст. Ба ҷойи мустақиман мутобиқ кардани таваҷҷуҳи модел ба харитаҳои fixation-и инсон, муҳаққиқон пешниҳод мекунанд, ки механизми guided search, ки дар асоси ҷустуҷӯи визуалии инсон қарор дорад, ба модули ҳисоббарорӣ табдил дода шавад. Ҳамин тавр, ба ҷойи танҳо нусхабардорӣ кардани натиҷаи рафтори инсон, ду раванди асосие, ки тақсимоти таваҷҷуҳро ба вуҷуд меоранд, моделсозӣ мешаванд.
Раванди аввал stimulus-driven saliency мебошад, яъне хусусиятҳои сатҳи пасти тасвир, аз қабили канорҳо, фарқи ранг ва ғайриодӣ будани маҳаллӣ, таваҷҷуҳро худ аз худ ҷалб мекунанд. Раванди дуюм target-directed guidance мебошад, яъне ҳадафи вазифаи нозир, масалан “ман ҳавопаймо меҷӯям”, таваҷҷуҳро ба минтақаҳои шабеҳи ҳадаф равона мекунад. GVA ин ду харитаро муттаҳид карда, минтақаҳоеро, ки ҳам аз ҷиҳати визуалӣ ҷолиб ва ҳам аз нигоҳи вазифа муҳиманд, бартарӣ медиҳад.
Чаро Таваҷҷуҳи Визуалии Монанд ба Инсон дар Ошкорсозии Объектҳои Зондкунии Фосилавӣ Муҳим аст?
Таваҷҷуҳи визуалии монанд ба инсон ҳадаф дорад, ки модел на танҳо ба хусусиятҳои аз ҷиҳати оморӣ қавии тасвир, балки ба минтақаҳои визуалӣ ва марбут ба вазифа, ки инсон ҳангоми ҷустуҷӯи ҳадаф ба онҳо афзалият медиҳад, тамаркуз кунад. Азбаски дар тасвирҳои зондкунии фосилавӣ ҳадафҳо метавонанд хурд, пароканда ва дар заминаи зич ҷойгир бошанд, чунин механизми таваҷҷуҳ метавонад натиҷаҳои мусбати бардурӯғро кам кунад, ҳадафҳои аз дастрафтаро коҳиш диҳад ва муқоисаи қарорҳои моделро бо стратегияҳои ҷустуҷӯи визуалии инсон осонтар созад.
Дар тасвирҳои зондкунии фосилавӣ хатҳои парвозу нишасти фурудгоҳ, сатҳҳои замин, минтақаҳои обӣ, биноҳо ё дигар текстураҳои зич метавонанд, ҳарчанд ҳадаф набошанд, хусусиятҳои қавии визуалӣ ба вуҷуд оранд. Detector-и анъанавӣ метавонад дар ин минтақаҳо activation-и баланд тавлид карда, bounding box-ҳои нолозим созад.
Нозири инсон бошад, ба ҳамаи минтақаҳои контрасти баланд дар тасвир яксон муносибат намекунад. Ӯ намоёнии визуалии аз худи тасвир бармеомадаро бо дониши пешакӣ дар бораи объекти мавриди ҷустуҷӯ муттаҳид мекунад. Guided search theory ҷустуҷӯи визуалии инсонро маҳз ҳамчун муттаҳидшавии ин ду ҷараёни иттилоотӣ консептуалӣ мекунад.
Guided Search Theory Чӣ Гуна ба Модели GVA Табдил Дода Мешавад?
GVA ду манбаи асосии таваҷҷуҳро дар guided search theory ҳамчун ду роҳи ҷудогонаи ҳисоббарорӣ амалӣ мекунад: роҳи bottom-up хусусиятҳои визуалии мустақил аз вазифа, ба монанди канорҳо ва ғайриодӣ будани рангро аз тасвир мебарорад, дар ҳоле ки роҳи top-down аз дониши визуалии омӯхташуда дар бораи синфи ҳадаф харитаи эҳтимолияти ҳадаф месозад. Ин ду харита дар сатҳи пиксел зарб мешаванд, то харитаи умумии афзалият ба вуҷуд ояд ва танҳо минтақаҳое, ки ҳам намоён ва ҳам ба вазифа марбутанд, таваҷҷуҳи қавӣ мегиранд.
Bottom-up: Роҳи намоёнии бармеангехта аз ангезанда
Роҳи stimulus-driven saliency бидуни донистани он ки ҳадаф чист, аз рӯи хусусиятҳои визуалии худи тасвир харитаи таваҷҷуҳ месозад. Манбаъ ин занҷири коркардро бо қадамҳои классикии пурра шарҳшавандаи коркарди тасвир месозад.
Аввал тасвир бо mean-shift filtering коркард ва ба фазои ранги CIE-Lab табдил дода мешавад. Сипас Gaussian pyramid-и се-миқёс истифода мешавад:
- 1× ҳалли аслӣ,
- 0,5× миқёс,
- 0,25× миқёс.
Дар ҳар миқёс хусусиятҳои канорӣ бо 3×3 Sobel operator бароварда мешаванд. Илова бар ин, харитаи color-rarity ҳисоб карда мешавад, ки чен мекунад ҳар пиксел нисбат ба муҳити атроф то чӣ андоза ранги нодир ё ғайриодӣ дорад.
Bottom-up attention map дар манбаъ чунин таъриф мешавад:
\[ M_{bu}(x,y)= \mathcal{N} \left[ \sum_{s=1}^{3} w_s \left( E_s(x,y)+C_s(x,y) \right) \right] \]
Дар ин ҷо \(E_s\) харитаи хусусиятҳои канорӣ дар миқёси s, \(C_s\) харитаи нодирии ранг, \(w_s\) вазни миқёс ва \(\mathcal{N}\) min-max normalization-ро ифода мекунад.
Top-down: Роҳи роҳнамоии ҳадафманд
Роҳи дуюм иттилои махсуси ҳадафро ба attention map меорад. Дар таҳқиқот барои омӯзиши имзоҳои ранги Lab-и ҳадафҳои ҳавопаймо Random Forest classifier дар 500 намунаи ҳавопаймои дастӣ нишонгузоришуда омӯзонида шудааст.
Random Forest:
- 10 дарахт,
- умқи максималӣ 5
истифода мекунад ва барои ҳар пиксел эҳтимолияти ҳадафро тавлид мекунад. Ин харита бо 5×5 Gaussian kernel ва \(\sigma=2\) ҳамвор карда мешавад.
Top-down guidance map:
\[ M_{td}(x,y)= \mathcal{N} \left[ G_{\sigma=2} * RF(Lab(x,y)) \right] \]
ба ин шакл ифода мешавад.
Random Forest-и ин ҷо бо пораҳои ёрирасони тасвир, ки аз қисмҳои train/test-и detector мустақиланд, омӯзонида шудааст, то аз ихроҷи додаҳо пешгирӣ шавад.
Ин ду роҳи таваҷҷуҳ чӣ гуна муттаҳид мешаванд?
Харитаҳои bottom-up ва top-down attention бо element-wise multiplication муттаҳид мешаванд. Ҳамин тавр, мақсад пахш кардани минтақаҳое мебошад, ки танҳо аз ҷиҳати физикӣ ҷолиб, вале ба ҳадаф бетааллуқанд, инчунин минтақаҳое, ки ба ҳадаф шабеҳанд, аммо далели визуалии заиф доранд.
Харитаи муттаҳидшуда бо marker-controlled watershed algorithm ба минтақаҳои номзад тақсим мешавад. Манбаъ мегӯяд, ки номзадҳо бо шартҳои зерин филтр карда мешаванд:
- масоҳат: 50–8000 пиксел,
- таносуби тарафҳо: 0,2–5.
Дар марказҳои минтақаҳои дуруст kernel-ҳои дуандозаи Gaussian бо \(\sigma=10\) пиксел ҷойгир карда мешаванд, то attention map-и ниҳоии монанд ба инсон сохта шавад:
\[ A_{GVA}(x,y)= \mathcal{N} \left[ \sum_{k=1}^{K} \mathcal{G} \left( (x,y);c_k,\sigma=10 \right) \right] \]
Дар ин ҷо \(K\) шумораи минтақаҳои дурусти номзад ва \(c_k\) марказҳои ин минтақаҳоро ифода мекунад.
Оё GVA Дар Ҳақиқат Модули Таваҷҷуҳи Бепараметр аст?
Ворид кардани GVA ба шабакаи detector параметрҳои нави омӯзишшавандаи шабакаи амиқ илова намекунад ва роҳи bottom-up saliency аз амалиётҳои детерминистии коркарди тасвир иборат аст; аммо роҳи top-down guidance аз Random Forest-и дар 500 намунаи нишонгузоришуда омӯзондашуда истифода мебарад. Аз ин рӯ, истилоҳи “parameter-free” дар манбаъ набояд чунин фаҳмида шавад, ки дар тамоми занҷири ҳисоббарории GVA ягон ҷузъи омӯзишшуда вуҷуд надорад; балки маънояш он аст, ки ба меъмории detector параметрҳои нави оптимизатсияшавандаи neural network илова намешаванд.
Ин фарқ аз ҷиҳати методологӣ муҳим аст. Манбаъ мегӯяд, ки шохаҳои classification ва regression-и detector тағйир дода нашудаанд, GVA native loss functions-ро нигоҳ медорад ва ба омӯзиши detector learnable layer-и нав илова намекунад.
Бо вуҷуди ин, Random Forest, ки барои сохтани target-directed attention map истифода мешавад, пешакӣ омӯзонида мешавад. Пас, ҷузъи top-down-и GVA иттилои омӯхташуда дар бораи синфи ҳадафро дар бар мегирад.
GVA ба панҷ detector-и гуногун чӣ гуна ворид карда мешавад?
| Меъморӣ | Навъи detector | Равиши ворид кардани GVA |
|---|---|---|
| Faster R-CNN | Думарҳилаӣ | GVA candidate box-ҳое, ки бо Watershed ҳосил мешаванд, ба ҷойи anchor-ҳои зичи классикӣ истифода мешаванд; миёнаи attention score дар минтақа ҳамчун proposal confidence арзёбӣ мешавад. |
| RetinaNet | Якмарҳилаӣ, anchor-based | Номзадҳои GVA ба ҷойи multi-scale anchor grid-ҳои пешакӣ муайяншуда истифода мешаванд. |
| YOLOv5s | Якмарҳилаӣ, anchor-based | GVA binary mask ба андозаи feature map мутобиқ карда мешавад; gradient backpropagation ва минтақаҳои баромад бо минтақаҳои attention-и монанд ба инсон маҳдуд карда мешаванд. |
| YOLOv8n | Якмарҳилаӣ | GVA mask ба миқёси feature-map мутобиқ шуда, feature allocation ва минтақаҳои prediction-ро модул мекунад. |
| CenterNet | Anchor-free | GVA mask-и аз нав миқёсшуда center-point heatmap prediction-ҳоро модул мекунад. |
Қарори муҳими тарроҳии таҳқиқот ҷойгир кардани GVA байни detector backbone ва Feature Pyramid Network (FPN) мебошад, то меъмории асосии detector то ҳадди имкон камтар тағйир ёбад.
Усул ва Натиҷаҳои Таҳқиқот
Маҷмӯаи додаҳои EEGET-RSOD барои пайгирии чашм ва EEG
Маҷмӯаи додаҳои EEGET-RSOD ҳамчун benchmark барои рафтори инсон ва намояндагии мағз истифода шудааст. Ин маҷмӯа 1.000 тасвири оптикии зондкунии фосилавии 800×800 пикселиро аз DIOR дар бар мегирад.
Ба таҳқиқот 38 иштирокчӣ дохил шуданд ва манбаъ мегӯяд, ки ҳамаи онҳо informed consent-и хаттӣ додаанд. Тасдиқи ахлоқӣ аз ҷониби Beijing Normal University Ethics Committee бо рақами 20221024111 дода шудааст.
| Ченак | Таҷҳизот / параметр |
|---|---|
| Пайгирии чашм | SMI RED250, 250 Hz |
| EEG | NE Enobio, 32 канал, 500 Hz, ҷойгиршавии 10–20 |
| Ҳамоҳангсозӣ | <2 ms trigger error |
| Давомнокии ангезанда | 3000 ms |
| Экрани холӣ | 500 ms |
Fixation-ҳо бо I-DT algorithm бароварда шуданд ва group fixation heatmap-ҳо бо \(\sigma=8\) Gaussian kernel сохта шуданд.
Пешкоркарди EEG
Ба сигналҳои EEG:
- филтркунии 0,5–45 Hz,
- mastoid re-referencing,
- тозакунии artefact бо ICA,
- −200–0 ms baseline correction
татбиқ шудааст.
Чор минтақаи функсионалӣ бо равзанаҳои гуногуни вақт муайян шуданд:
| Минтақаи мағз | Равзанаи вақт |
|---|---|
| Оксипиталӣ | 0–300 ms |
| Темпоралӣ | 100–400 ms |
| Фронталӣ | 200–500 ms |
| Париеталӣ | 300–600 ms |
Whole-brain Representational Similarity Matrices бошад дар равзанаи 0–600 ms сохта шуданд.
Тартиби омӯзиши detector
Қисми асосии таҷрибаҳои detector дар зермаҷмӯаи ҳавопаймоии DIOR иҷро шудааст.
| Параметр | Қимат |
|---|---|
| Train / validation / test | 7 : 2 : 1 |
| Framework | PyTorch |
| GPU | RTX 4090 |
| Batch size | 16 |
| Ҳалли вуруд | 800×800 |
| Epoch | 300 |
| Оғози backbone | ImageNet pre-trained |
| Интихоби checkpoint | Баландтарин AP50 |
GVA Иҷроиши Ошкорсозии Объектро То Чӣ Андоза Афзоиш Дод?
Дар санҷиши ҳавопаймои DIOR, илова кардани GVA AP50-ро дар ҳамаи панҷ detector зиёд кард; бузургтарин афзоиши мутлақи байни меъмориҳо дар YOLOv5 буд, ки аз 0,680 то 0,940 боло рафта, +0,260 шуд. Моделҳои дорои иҷроиши ибтидоии заифтар фоидаи бештар гирифтанд, дар ҳоле ки афзоишҳо дар RetinaNet ва YOLOv8, ки аллакай иҷроиши баланд доштанд, хурдтар буданд.
| Модел | Baseline Precision | Baseline Recall | Baseline AP50 | GVA Precision | GVA Recall | GVA AP50 | Фарқи AP50 |
|---|---|---|---|---|---|---|---|
| Faster R-CNN | 0,915 | 0,442 | 0,600 | 0,786 | 0,739 | 0,760 | +0,160 |
| YOLOv5 | 0,717 | 0,647 | 0,680 | 0,979 | 0,907 | 0,940 | +0,260 |
| CenterNet | 0,841 | 0,775 | 0,810 | 0,901 | 0,852 | 0,880 | +0,070 |
| RetinaNet | 0,982 | 0,874 | 0,920 | 0,991 | 0,918 | 0,950 | +0,030 |
| YOLOv8 | 0,982 | 0,932 | 0,920 | 0,974 | 0,938 | 0,960 | +0,040 |
Барои Faster R-CNN, baseline model бо вуҷуди precision-и хеле баланд танҳо recall-и 0,442 нишон дод. Пас аз GVA, recall то 0,739 боло рафт, precision то 0,786 поён шуд, вале AP50 дар маҷмӯъ аз 0,600 то 0,760 афзоиш ёфт.
Дар YOLOv5 ҳам precision ва ҳам recall ҳамзамон афзоиш ёфтанд ва ин модел бузургтарин фоидаи умумии detector-ро ба даст овард.
Чаро моделҳои қавӣ камтар фоида мегиранд?
Тафсири манбаъ ин аст, ки моделҳои дорои иҷроиши ибтидоии пасттар барои беҳбуд дар пахш кардани замина ва тавозуни precision–recall имконияти бештар доранд. Азбаски baseline-ҳои қавӣ ба монанди RetinaNet ва YOLOv8 аллакай feature fusion ва рафтори attention-и пешрафта доранд, GVA дар ин моделҳо бештар ҳамчун таъсири танзими нозук амал мекунад.
Оё GVA Ба Ҳадафҳои Гуногуни Зондкунии Фосилавӣ Умумӣ Шуда Тавонист?
Дар таҷрибаи чорсинфаи YOLOv5, GVA дар ҳамаи категорияҳои ҳавопаймо, киштӣ, зарфи нигоҳдорӣ ва пул афзоиши AP50 дод; миёнаи AP50 аз 0,666 то 0,855 боло рафт. Аммо андозаи фоида вобаста ба геометрияи ҳадаф хеле фарқ мекард: бузургтарин афзоиш дар зарфҳои нигоҳдорӣ ва хурдтарин дар пулҳо буд.
| Категория | Baseline AP50 | GVA AP50 | Фарқи мутлақ |
|---|---|---|---|
| Ҳавопаймо | 0,680 | 0,942 | +0,262 |
| Киштӣ | 0,914 | 0,958 | +0,044 |
| Зарфи нигоҳдорӣ | 0,493 | 0,918 | +0,425 |
| Пул | 0,576 | 0,603 | +0,027 |
| Миёна | 0,666 | 0,855 | +0,189 |
Манбаъ пешниҳод мекунад, ки механизми канор ва color-rarity барои ҳадафҳои дорои геометрияи паймон ва мунтазам самараноктар аст, дар ҳоле ки пулҳо, ки сохторҳои дарози хаттӣ мебошанд, бо тарҳи ҳозираи saliency камтар мутобиқанд.
Барои ҳавопаймо AP50 дар таҷрибаи асосии панҷ-модел 0,940 ва дар таҷрибаи байни категорияҳо 0,942 гузориш шудааст. Инҳо қиматҳои ҷадвалҳои гуногуни таҷрибавӣ мебошанд ва набояд маҷбуран ба як қимат баробар карда шаванд.
GVA Бо Ҳаракатҳои Чашми Инсон То Чӣ Андоза Мувофиқ аст?
Дар муқоиса бо human fixation heatmap-ҳо барои GVA CC=0,740, NSS=2,600 ва KL=0,898 гузориш шудааст; ин қиматҳо нишон медиҳанд, ки attention-и модел нисбат ба baseline detector-ҳо ба тақсимоти нигоҳҳои инсон наздиктар аст. Бо вуҷуди ин, метрикаҳои истифодашуда ҷанбаҳои гуногуни таваҷҷуҳро чен мекунанд ва набояд ба як “фоизи монандӣ ба инсон” муттаҳид карда шаванд.
Метрикаҳои мувофиқати таваҷҷуҳ
| Метрика | Чиро чен мекунад? | Самти беҳтар |
|---|---|---|
| CC | Коррелятсияи умумии фазоӣ байни attention map-ҳо | Баланд |
| SSIM | Монандии фазоӣ/сохторӣ | Баланд |
| NSS | Тамаркузи model saliency дар нуқтаҳои fixation-и инсон | Баланд |
| KL divergence | Фарқи байни ду тақсимоти эҳтимолияти таваҷҷуҳ | Паст |
Аблясияи GVA чӣ нишон дод?
Манбаъ чор системаро муқоиса мекунад:
- Itti saliency baseline,
- танҳо stimulus-driven saliency,
- танҳо target-directed guidance,
- Guided-Search Visual Attention-и пурра.
| Усул | CC | SSIM | NSS | KL |
|---|---|---|---|---|
| Itti | 0,388 | 0,357 | 0,920 | 1,562 |
| Stimulus-driven | 0,505 | 0,613 | 2,598 | 2,090 |
| Target-directed | 0,511 | 0,565 | 2,017 | 1,826 |
| Full GVA | 0,740 | 0,581 | 2,600 | 0,898 |
Ин ҷадвал нишон медиҳад, ки тарҳи ду-роҳа махсусан барои CC ва KL пуррагии қавӣ медиҳад. GVA баландтарин CC ва NSS ва пасттарин KL-ро медиҳад.
Номувофиқати дохили манбаъ: ҳарчанд матни ҳамон бахш мегӯяд, ки full GVA аз усулҳои як-роҳа “дар ҳамаи метрикаҳо” бартар аст, дар Figure 4 SSIM-и stimulus-driven 0,613 ва SSIM-и full GVA 0,581 мебошад. Аз ин рӯ, барои SSIM Figure 4 ин ҷумлаи матнро дастгирӣ намекунад.
Мувофиқати Мағз–Модел Чӣ Гуна Чен Карда Шуд?
Мувофиқати мағз–модел тавассути Spearman correlation байни Representational Similarity Matrices-и аз хусусиятҳои P3, P4 ва P5 дар қабатҳои FPN-и detector сохташуда ва RSM-ҳои аз fixation-locked EEG signals сохташуда чен карда шуд. Ин усул мустақиман нишон намедиҳад, ки модел “мисли мағз фикр мекунад”; балки месанҷад, ки муносибатҳои намояндагӣ байни ангезандаҳои гуногун то чӣ андоза ба геометрияи намояндагӣ дар EEG-и инсон монанданд.
Сохтани model RSM-ҳо
Target ва background regions бо ROI-Align аз P3, P4 ва P5 feature map-ҳо бурида, pooled ва normalize карда шуданд. Model RSM-ҳо бо истифода аз cosine dissimilarity байни ҳар ҷуфти ангезанда сохта шуданд.
Сохтани EEG RSM-ҳо
EEG epoch-ҳо аз рӯи нишонҳои fixation-и чашм ба target ва background ҷудо шуданд. ERP signals дар чор минтақаи кортикалӣ ба feature vectors-и мувофиқ ба тартиби model feature табдил дода шуданд, Fisher-Z transform татбиқ шуд ва байни иштирокчиён миёна гирифта шуд.
Муносибати байни модел ва EEG RSM бо Spearman rank correlation чен карда шуд; аҳаммияти оморӣ бо 5.000 permutation test ва FDR correction арзёбӣ гардид.
Миёни қабатҳои P3, P4 ва P5 чӣ рӯй дод?
Дар baseline detector-ҳо коррелятсияҳои мағз–модел паст ва номунтазам буданд; Spearman's r тақрибан дар доираи 0,006–0,024 буд.
Пас аз GVA мувофиқат дар ҳамаи меъмориҳо афзоиш ёфт ва дар маҷмӯъ градиенти қабатӣ, ки аз P3 то P5 қавитар мешавад, пайдо гардид.
Афзоишҳои максималии RSA, ки манбаъ барои P3–P5 гузориш кардааст:
| Модел | Афзоиши максималии RSA | Афзоиши миёнаи RSA |
|---|---|---|
| Faster R-CNN | 133% | 108% |
| YOLOv5 | 50% | 73% |
| RetinaNet | 14% | 13% |
| CenterNet | 40% | 78% |
| YOLOv8 | 4% | 31% |
Бояд дар хотир дошт, ки ин афзоишҳои фоизӣ нисбат ба коррелятсияҳои ибтидоии паст афзоишҳои нисбӣ мебошанд; қиматҳои мутлақи RSA ҳанӯз хурд мемонанд.
GVA Бо Кадом Минтақаҳои Мағз Бештар Мувофиқ Шуд?
Дар таҳлили минтақавии RSA, бузургтарин афзоиши миёна дар кортекси оксипиталӣ Δρ=0,012 ва дуюмин афзоиши калон дар кортекси фронталӣ Δρ=0,008 гузориш шудааст. Афзоишҳои пареталӣ Δρ=0,001 ва темпоралӣ Δρ=0,003 хурдтар буданд ва манбаъ мегӯяд, ки аксаран аз ҷиҳати оморӣ аҳаммиятнок набуданд.
Манбаъ ин тақсимотро бо ду роҳи меъмории GVA алоқаманд мекунад:
- Афзоиши оксипиталӣ: коркарди хусусиятҳои барвақти визуалӣ, аз қабили канор ва контрасти ранг, тавассути роҳи bottom-up saliency,
- Афзоиши фронталӣ: моделсозии назорати top-down attention-и ҳадафманд тавассути роҳи task-guidance.
Ин тафсир гипотезаи механистӣ мебошад. Ҳалли фазоии EEG, тавре ки худи манбаъ низ ҳамчун маҳдудият зикр мекунад, барои баровардани хулосаҳои нозуки механизми кортикалӣ имкон намедиҳад.
Оё иерархияи қабатҳо ва иерархияи визуалии инсон як чизанд?
Манбаъ афзоиши RSA аз P3 то P5 пас аз GVA-ро ҳамчун намунае тафсир мекунад, ки бо тартиби иерархии коркарди системаи визуалии инсон мувофиқ аст. Аммо нишон дода нашудааст, ки хусусиятҳои P3/P4/P5-и detector бо марҳилаҳои мушаххаси коркарди кортикалӣ аз ҷиҳати анатомӣ як ба як баробар бошанд.
Ифодаи дуруст ин аст, ки афзоиши мувофиқати намояндагӣ ба самти қабатҳои амиқтар дар model feature hierarchy дар доираи чаҳорчӯбаи EEG/RSA-и истифодашуда намунаеро ба вуҷуд меорад, ки ба иерархияи коркарди визуалии инсон бештар мувофиқ аст.
Арзёбии оморӣ
Барои eye-tracking attention metrics one-way ANOVA, FDR-adjusted Tukey HSD ва 1.000 bootstrap sample истифода шудаанд.
Барои Neural RSA 5.000 permutation test истифода шуда, дар сатҳи \(\alpha=0,05\) FDR correction анҷом дода шудааст.
Манбаъ дар муқоисаҳои асосии visual alignment FDR-corrected \(p<0,001\)-ро гузориш мекунад.
Натиҷаҳои дастгиришавандаи таҳқиқот
- GVA чаҳорчӯбаи attention-и ду-роҳа аст, ки механизмҳои bottom-up ва top-down-и guided search theory-ро муттаҳид мекунад.
- Дар санҷиши ҳавопаймои DIOR, GVA AP50-ро дар ҳамаи панҷ detector-и санҷидашуда зиёд кард.
- Бузургтарин афзоиши AP50-и ҳавопаймо байни меъмориҳо барои YOLOv5 +0,260 буд.
- Дар таҷрибаи умумисозии чор категорияи YOLOv5, миёнаи AP50 аз 0,666 то 0,855 боло рафт.
- GVA attention map бо тақсимоти human fixation ба CC=0,740 расид.
- Дар Figure 4, Full GVA дар CC, NSS ва KL аз роҳҳои якка пештар аст.
- Қиматҳои EEG–model RSA пас аз GVA дар меъмориҳои санҷидашуда афзоиш ёфтанд.
- Афзоишҳои барҷастатарини RSA-и минтақавӣ дар минтақаҳои оксипиталӣ ва фронталӣ гузориш шуданд.
- Ворид кардани GVA ба detector native classification/regression branches ва loss functions-ро тағйир намедиҳад.
Натиҷаҳои дастгиринашавандаи таҳқиқот
- Нишон дода нашудааст, ки detector-ҳои бо GVA истифодашаванда ҳамон ҳисоберо иҷро мекунанд, ки мағзи инсон анҷом медиҳад.
- Қимати CC=0,740-ро наметавон ба маънои умумӣ ҳамчун “модел %74 ба мағзи инсон монанд аст” тафсир кард.
- EEG RSA correlation далели ҳамарзии клиникӣ ё биологӣ нест.
- Cognitive alignment data ҳанӯз барои категорияҳои ҳадаф ғайр аз ҳавопаймо тасдиқ нашудааст.
- Нишон дода нашудааст, ки GVA дар SAR ё hyperspectral images ҳамон иҷроишро медиҳад.
- Исбот нашудааст, ки GVA дар ҳамаи detector-ҳои зондкунии фосилавӣ ҳамон афзоиши AP50-ро таъмин мекунад.
- Ибораи “parameter-free” маънои онро надорад, ки top-down Random Forest тамоман омӯзонида нашудааст.
- Figure 4 нишон намедиҳад, ки full GVA дар SSIM аз stimulus-driven роҳ бартар аст.
- Натиҷаҳои preprint набояд ҳамчун далели ниҳоии баррасишудаи ҳамтоён арзёбӣ шаванд.
Маҳдудиятҳои таҳқиқот
Манбаъ се маҳдудияти асосиро ошкоро баён мекунад.
- Маҳдудияти додаҳои когнитивӣ: арзёбии eye-tracking ва EEG alignment танҳо барои ҳадафҳои ҳавопаймо дастрас аст. Гарчанде иҷроиши detector дар категорияҳои дигар санҷида шудааст, human cognitive benchmark-и мувофиқ ҳоло вуҷуд надорад.
- Маҳдудияти modality: таҳқиқот танҳо дар optical remote sensing images анҷом дода шудааст; SAR ва hyperspectral images санҷида нашудаанд.
- Ҳалли фазоии EEG: EEG таҳлили neural mechanism-ро ба минтақаҳои функсионалии макроскопии мағз маҳдуд мекунад.
Самтҳои таҳқиқоти оянда
Муаллифон пешниҳод мекунанд, ки bottom-up saliency mechanism метавонад ба sensor modality-ҳои гуногун мутобиқ карда шавад. Барои SAR polarimetric signatures ва барои hyperspectral images spectral band features метавонанд ҳамчун намояндаҳои ҷойгузини иттилои ранг истифода шаванд.
Дар барномаҳои мушоҳидаи минтақаҳои калон, ки намунаҳои нишонгузоришуда каманд, омӯзиши top-down prior бо unsupervised ё self-supervised methods низ ҳамчун самти таҳқиқоти оянда зикр шудааст.
Таҳқиқот ҳамчунин пешниҳод мекунад, ки азбаски ворид кардани GVA ба detector trainable neural-network parameters-и нав илова намекунад, он барои lightweight ва edge-processing architectures потенсиал дорад; аммо дар дастгоҳи воқеии edge таҷрибаи муфассали latency ё истеъмоли энергия гузориш нашудааст.
Ёддошт оид ба Манбаъ ва Усул
Унвони аслӣ: Embedding human-like visual attention for brain-aligned and high-performance remote sensing object detection
Муаллифон: Bing He, Tong Qin, Dajun Xing, Ying Qu, Qiaosong Hei, Chunfeng Gao, Zheng Gong, Qiao Wang, Weihua Dong
Навъи манбаъ: Мақолаи таҳқиқотии preprint.
Рақами сабти SSRN: 7346288.
Боргузорӣ ба SSRN: 24 августи 2026.
Ҳолати peer review: Манбаъ ба таври ошкоро ибораи “This preprint research paper has not been peer reviewed”-ро дар бар мегирад.
Усули асосӣ: Guided-Search Visual Attention (GVA).
Асоси назариявӣ: Guided search theory; муттаҳид кардани роҳҳои stimulus-driven saliency ва target-directed guidance барои сохтани priority map.
Detector-ҳо: Faster R-CNN, RetinaNet, YOLOv5s, YOLOv8n ва CenterNet.
Маҷмӯаи асосии додаҳои ошкорсозии объект: DIOR.
Cognitive benchmark: EEGET-RSOD; 1.000 тасвири 800×800 remote sensing ва додаҳои ҳамзамони eye-tracking–EEG аз 38 иштирокчӣ.
Тасдиқи ахлоқӣ: Beijing Normal University Ethics Committee, No. 20221024111.
Eye tracker: SMI RED250, 250 Hz.
EEG: NE Enobio, 32 канал, 500 Hz, ҷойгиршавии 10–20.
Visual alignment metrics: Pearson correlation coefficient (CC), structural similarity index (SSIM), normalized scanpath saliency (NSS), Kullback–Leibler divergence (KL).
Neural alignment method: Representational Similarity Analysis (RSA), model P3/P4/P5 FPN features ва fixation-locked EEG RSMs.
Data availability: Манбаъ маҷмӯаи додаҳои EEGET-RSOD-ро дар Figshare бо DOI 10.6084/m9.figshare.26943565 нишон медиҳад.
Code availability: Манбаъ мегӯяд, ки code-и таҳлил дар repository-и GitHub бо номи “Bing-1997/Human-like_visual_attention_embedding_framework” мавҷуд аст.
Нюанси муҳими дохили манбаъ: GVA ба detector trainable neural-network parameters-и нав илова намекунад; аммо роҳи target-directed аз Random Forest-и дар 500 намунаи нишонгузоришуда омӯзондашуда истифода мебарад.
Номувофиқати муҳими дохили манбаъ: дар Figure 4 full GVA SSIM=0,581 ва stimulus-driven saliency SSIM=0,613 аст; бинобар ин, ҷумлаи ҳамон бахш “full GVA all metrics'te üstündür” аз нигоҳи SSIM бо шакл мувофиқ нест.
Ҳадди асосии тафсир: Натиҷаи “Brain-aligned” маънои монандии намояндагӣ/таваҷҷуҳи ченшуда бо EEG/RSA ва eye-tracking metrics-ро дорад; он маънои ҳамарзии мустақими механизми биологӣ ё нусхабардории раванди ҳисоббарории мағзро надорад.
Шарҳ гузоред
Нишонии почтаи электронии шумо нашр намешавад. Майдонҳои ҳатмӣ бо * нишон дода шудаанд