

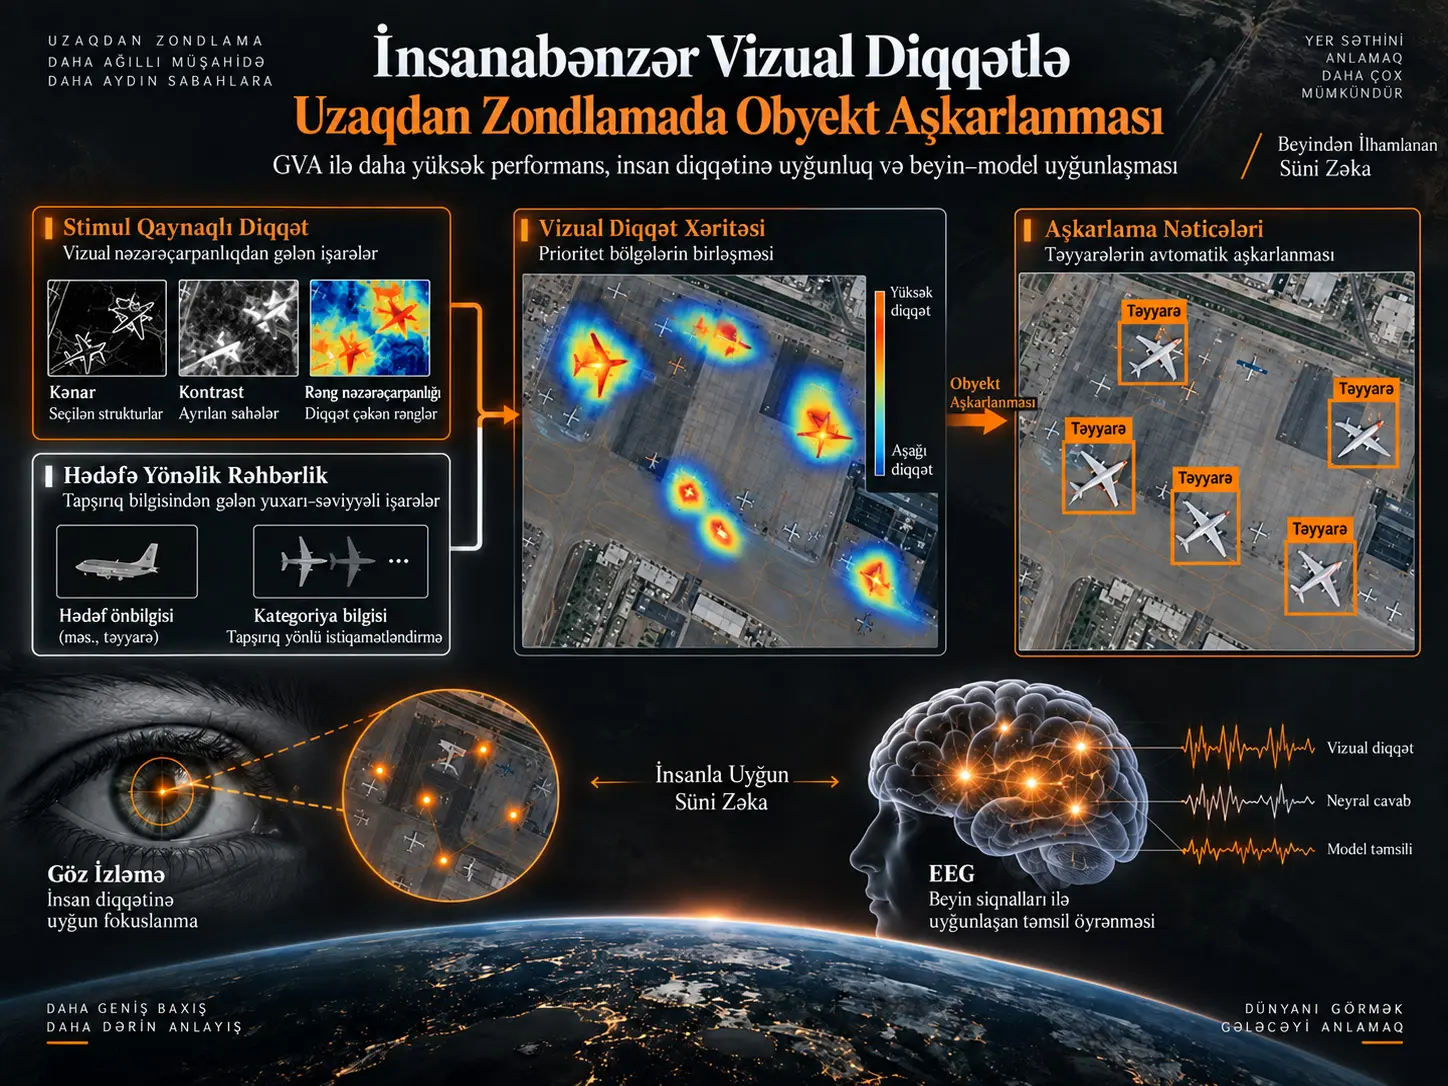
Guided-Search Visual Attention (GVA), insanın vizual axtarışında stimuldan qaynaqlanan vizual nəzərəçarpanlıq ilə tapşırıq hədəfli diqqət yönləndirməsini birlikdə modelləşdirərək uzaqdan zondlama obyekt aşkarlama şəbəkələrinin xüsusiyyət emalı prosesini tənzimləyən beyindən ilhamlanan diqqət çərçivəsidir. Tədqiqat GVA-nı Faster R-CNN, RetinaNet, YOLOv5s, YOLOv8n və CenterNet olmaqla beş müxtəlif obyekt aşkarlama arxitekturasına yerləşdirmiş; performansı DIOR verilənlər dəstində, insanla davranış uyğunluğunu eyni vaxtlı göz izləmə məlumatları ilə və beyin–model təmsil uyğunluğunu EEG əsaslı representational similarity analysis ilə qiymətləndirmişdir. Təyyarə kateqoriyasında bütün arxitekturalar AP50 artımı göstərmiş və ən böyük mütləq artım YOLOv5 üçün +0,260 olmuşdur. GVA diqqət xəritəsinin insan fiksasiya paylanmaları ilə Pearson korrelyasiyası 0,740-a çatmış; EEG–model RSA analizində ən nəzərəçarpan uyğunlaşma artımları erkən vizual kodlaşdırma ilə əlaqəli oksipital bölgədə və top-down diqqət nəzarəti ilə əlaqəli frontal bölgədə bildirilmişdir. Bununla belə, tədqiqat hələ rəyçi qiymətləndirməsindən keçməmiş preprintdir və beyin uyğunlaşması yalnız istifadə olunan EEG/RSA ölçmə çərçivəsi daxilində şərh edilməlidir.
Müasir uzaqdan zondlama modellərində attention mexanizmləri geniş istifadə olunur; lakin bu mexanizmlərin böyük hissəsi insan vizual diqqətini təqlid etmək üçün deyil, birbaşa tapşırıq performansını optimallaşdırmaq üçün öyrənilir. Buna görə də modelin diqqət yetirdiyi bölgələrlə peşəkar insan müşahidəçilərin görüntüdə axtardığı bölgələr bir-birindən fərqlənə bilər.
Məqalənin başlanğıc nöqtəsi bu fərqdir. Tədqiqatçılar model diqqətini birbaşa insan fiksasiya xəritələrinə uyğunlaşdırmaq əvəzinə insan vizual axtarışının altında yatan guided search mexanizmini hesablama moduluna çevirməyi təklif edirlər. Beləliklə, insan davranışının yalnız nəticəsini kopyalamaq əvəzinə diqqət paylanmasına səbəb olan iki əsas proses modelləşdirilməyə çalışılır.
Birinci proses stimulus-driven saliency, yəni görüntünün kənar, rəng fərqi və lokal qeyri-adilik kimi aşağı səviyyəli xüsusiyyətlərinin diqqəti öz-özünə cəlb etməsidir. İkinci proses target-directed guidance, yəni müşahidəçinin “təyyarə axtarıram” kimi tapşırıq hədəfinin diqqəti hədəfə bənzəyən bölgələrə yönəltməsidir. GVA bu iki xəritəni birləşdirərək həm vizual baxımdan diqqətçəkən, həm də tapşırıq baxımından mənalı bölgələri ön plana çıxarır.
İnsanabənzər Vizual Diqqət Uzaqdan Zondlama Obyekt Aşkarlanmasında Niyə Vacibdir?
İnsanabənzər vizual diqqət modelin görüntüdə yalnız statistik cəhətdən güclü xüsusiyyətlərə deyil, insanların hədəf axtararkən prioritet verdiyi vizual və tapşırıqla əlaqəli bölgələrə yönəlməsini məqsəd qoyur. Uzaqdan zondlama görüntülərində hədəflərin kiçik, seyrək və sıx fon daxilində yerləşə bilməsi səbəbindən belə bir diqqət mexanizmi yalnış müsbətləri azalda, qaçırılan hədəfləri azalda və model qərarlarının insan vizual axtarış strategiyaları ilə daha asan müqayisə edilməsini təmin edə bilər.
Uzaqdan zondlama görüntülərində hava limanı uçuş-enmə zolaqları, quru səthləri, su sahələri, binalar və ya digər sıx teksturalar hədəf olmasa da güclü vizual xüsusiyyətlər yarada bilər. Ənənəvi detector bu bölgələrdə yüksək aktivasiya yaradaraq lazımsız bounding box-lar yarada bilər.
İnsan müşahidəçi isə görüntüdəki bütün yüksək kontrastlı bölgələrə eyni cür yanaşmır. Görüntünün özündən gələn vizual nəzərəçarpanlığı axtardığı obyekt barədə ön biliklə birləşdirir. Guided search theory insan vizual axtarışını məhz bu iki informasiya axınının birləşməsi kimi konseptuallaşdırır.
Guided Search Theory GVA Modelinə Necə Çevrilir?
GVA, guided search theory-dəki iki əsas diqqət mənbəyini ayrı hesablama yolları kimi tətbiq edir: bottom-up yol görüntünün kənar və rəng qeyri-adiliyi kimi tapşırıqdan asılı olmayan vizual xüsusiyyətlərini çıxararkən, top-down yol hədəf sinfi barədə öyrənilmiş vizual ön bilikdən hədəf ehtimal xəritəsi yaradır. İki xəritə piksel səviyyəsində vurularaq ortaq prioritet xəritəsi yaradılır və yalnız həm nəzərəçarpan, həm də tapşırıqla əlaqəli bölgələr güclü diqqət qazanır.
Bottom-up: Stimuldan qaynaqlanan nəzərəçarpanlıq yolu
Stimulus-driven saliency yolu hədəfin nə olduğunu bilmədən görüntünün öz vizual xüsusiyyətlərinə əsasən diqqət xəritəsi yaradır. Mənbə bu emal xəttini tam izah edilə bilən klassik görüntü emalı addımları ilə qurur.
Əvvəlcə görüntü mean-shift filtering ilə işlənir və CIE-Lab rəng fəzasına çevrilir. Ardınca üç miqyaslı Gaussian pyramid istifadə olunur:
- 1× orijinal təsvir ölçüsü,
- 0,5× miqyas,
- 0,25× miqyas.
Hər miqyasda 3×3 Sobel operatoru ilə kənar xüsusiyyətləri çıxarılır. Bundan əlavə, hər pikselin ətrafına nisbətən nə qədər nadir və ya qeyri-adi rəng daşıdığını ölçən color-rarity xəritəsi hesablanır.
Bottom-up attention map mənbədə belə müəyyən edilir:
\[ M_{bu}(x,y)= \mathcal{N} \left[ \sum_{s=1}^{3} w_s \left( E_s(x,y)+C_s(x,y) \right) \right] \]
Burada \(E_s\), s miqyasındakı kənar xüsusiyyət xəritəsini; \(C_s\), rəng nadirliyi xəritəsini; \(w_s\), miqyas çəkisini və \(\mathcal{N}\) min-max normallaşdırmasını ifadə edir.
Top-down: Hədəfə yönəlmiş istiqamətləndirmə yolu
İkinci yol tapşırığa xas hədəf məlumatını attention map-ə daşıyır. Tədqiqatda təyyarə hədəflərinin Lab rəng imzalarını öyrənmək üçün 500 əl ilə etiketlənmiş təyyarə nümunəsi üzərində Random Forest təsnifatçısı öyrədilmişdir.
Random Forest:
- 10 ağac,
- maksimum dərinlik 5
istifadə edir və hər piksel üçün hədəf ehtimalı yaradır. Bu xəritə 5×5 Gaussian kernel və \(\sigma=2\) ilə hamarlanır.
Top-down guidance map:
\[ M_{td}(x,y)= \mathcal{N} \left[ G_{\sigma=2} * RF(Lab(x,y)) \right] \]
şəklində ifadə olunur.
Buradakı Random Forest, detector-un təlim/test bölmələrindən müstəqil köməkçi görüntü yamaları ilə öyrədilərək məlumat sızmasının qarşısını alacaq şəkildə qurulmuşdur.
İki diqqət yolu necə birləşir?
Bottom-up və top-down attention xəritələri element-wise multiplication ilə birləşdirilir. Beləliklə, yalnız fiziki olaraq diqqətçəkən, lakin hədəflə əlaqəsiz sahələrin və yalnız hədəfə bənzəyən, lakin vizual dəlili zəif olan sahələrin basdırılması məqsəd qoyulur.
Birləşmiş xəritə marker-controlled watershed alqoritmi ilə namizəd bölgələrə bölünür. Mənbədə namizədlərin bu şərtlərlə filtr olunduğu bildirilir:
- sahə: 50–8000 piksel,
- eni-hündürlüyə nisbət: 0,2–5.
Etibarlı bölgə mərkəzlərinə \(\sigma=10\) piksel olan ikiölçülü Gaussian nüvələr yerləşdirilərək son insanabənzər attention map yaradılır:
\[ A_{GVA}(x,y)= \mathcal{N} \left[ \sum_{k=1}^{K} \mathcal{G} \left( (x,y);c_k,\sigma=10 \right) \right] \]
Burada \(K\) etibarlı namizəd bölgələrin sayını, \(c_k\) isə bu bölgələrin mərkəzlərini ifadə edir.
GVA Həqiqətən Parametrsiz Diqqət Moduludurmu?
GVA-nın detector şəbəkəsinə yerləşdirilməsi yeni öyrənilə bilən dərin şəbəkə parametrləri əlavə etmir və bottom-up saliency yolu deterministik görüntü emalı əməliyyatlarından ibarətdir; lakin top-down istiqamətləndirmə yolu 500 etiketli nümunə üzərində öyrədilmiş Random Forest istifadə edir. Buna görə mənbədəki “parameter-free” ifadəsi GVA-nın bütün hesablama zəncirində heç bir öyrənilmiş komponent olmadığı mənasında deyil, detector arxitekturasına yeni optimallaşdırılan sinir şəbəkəsi parametrləri əlavə edilməməsi mənasında ehtiyatla şərh edilməlidir.
Bu fərq metodoloji baxımdan vacibdir. Mənbə detector-un təsnifat və regression qollarının dəyişdirilmədiyini, GVA-nın native loss funksiyalarını qoruduğunu və detector təliminə yeni learnable layer əlavə etmədiyini bildirir.
Lakin hədəfə yönəlmiş attention map-in yaradılması üçün istifadə edilən Random Forest əvvəlcədən öyrədilir. Buna görə GVA-nın top-down komponenti hədəf sinfinə dair öyrənilmiş məlumat daşıyır.
GVA beş müxtəlif detector-a necə yerləşdirilir?
| Arxitektura | Detector növü | GVA yerləşdirmə yanaşması |
|---|---|---|
| Faster R-CNN | İki mərhələli | Watershed ilə alınan GVA candidate box-ları klassik sıx anchor-ların yerinə istifadə olunur; bölgədəki orta attention skoru proposal confidence kimi qiymətləndirilir. |
| RetinaNet | Bir mərhələli, anchor-based | GVA namizədləri əvvəlcədən təyin olunmuş multi-scale anchor grid-lərin yerinə istifadə olunur. |
| YOLOv5s | Bir mərhələli, anchor-based | GVA binary mask xüsusiyyət xəritələrinin ölçüsünə miqyaslanır; gradient backpropagation və çıxış bölgələri insanabənzər attention sahələri ilə məhdudlaşdırılır. |
| YOLOv8n | Bir mərhələli | GVA maskası feature-map miqyasına uyğunlaşdırılaraq feature allocation və prediction sahələrini modulyasiya edir. |
| CenterNet | Anchor-free | Yenidən miqyaslanmış GVA maskası center-point heatmap proqnozlarını modulyasiya edir. |
Tədqiqatın vacib dizayn qərarı GVA-nı detector backbone ilə Feature Pyramid Network (FPN) arasına yerləşdirərək əsas detector arxitekturasını mümkün qədər dəyişməməkdir.
Tədqiqatın Metodu və Nəticələri
EEGET-RSOD göz izləmə və EEG verilənlər dəsti
İnsan davranışı və beyin təmsili üçün benchmark olaraq EEGET-RSOD verilənlər dəsti istifadə edilmişdir. Verilənlər dəstində DIOR-dan alınmış 1.000 ədəd 800×800 piksel optik uzaqdan zondlama görüntüsü mövcuddur.
Tədqiqata 38 iştirakçı daxil edilmiş və mənbə bütün iştirakçıların yazılı informed consent verdiyini bildirir. Etik təsdiq Beijing Normal University Ethics Committee tərəfindən 20221024111 nömrəsi ilə verilmişdir.
| Ölçmə | Avadanlıq / parametr |
|---|---|
| Göz izləmə | SMI RED250, 250 Hz |
| EEG | NE Enobio, 32 kanal, 500 Hz, 10–20 yerləşim |
| Sinxronizasiya | <2 ms trigger xətası |
| Stimul müddəti | 3000 ms |
| Boş ekran | 500 ms |
Fiksasiyalar I-DT alqoritmi ilə çıxarılmış və qrup fixation heatmap-ləri \(\sigma=8\) Gaussian kernel ilə yaradılmışdır.
EEG ön emalı
EEG siqnallarına:
- 0,5–45 Hz filtrləmə,
- mastoid re-referencing,
- ICA ilə artefakt təmizləmə,
- −200–0 ms baseline correction
tətbiq olunmuşdur.
Dörd funksional bölgə müxtəlif zaman pəncərələri ilə müəyyən edilmişdir:
| Beyin bölgəsi | Zaman pəncərəsi |
|---|---|
| Oksipital | 0–300 ms |
| Temporal | 100–400 ms |
| Frontal | 200–500 ms |
| Parietal | 300–600 ms |
Whole-brain Representational Similarity Matrices isə 0–600 ms pəncərəsində yaradılmışdır.
Detector təlim quruluşu
Detector təcrübələrinin əsas hissəsi DIOR təyyarə alt dəstində aparılmışdır.
| Parametr | Dəyər |
|---|---|
| Train / validation / test | 7 : 2 : 1 |
| Framework | PyTorch |
| GPU | RTX 4090 |
| Batch size | 16 |
| Giriş təsvir ölçüsü | 800×800 |
| Epoch | 300 |
| Backbone başlanğıcı | ImageNet pre-trained |
| Checkpoint seçimi | Ən yüksək AP50 |
GVA Obyekt Aşkarlama Performansını Nə Qədər Artırdı?
DIOR təyyarə testində GVA-nın əlavə edilməsi beş detector-un hamısında AP50-ni artırmışdır; arxitekturalar arasında ən böyük mütləq artım YOLOv5-də 0,680-dən 0,940-a yüksələrək +0,260 olmuşdur. Başlanğıc performansı daha zəif modellər daha böyük qazanc əldə etmiş, başlanğıc performansı artıq yüksək olan RetinaNet və YOLOv8-də artımlar daha kiçik olmuşdur.
| Model | Baseline Precision | Baseline Recall | Baseline AP50 | GVA Precision | GVA Recall | GVA AP50 | AP50 fərqi |
|---|---|---|---|---|---|---|---|
| Faster R-CNN | 0,915 | 0,442 | 0,600 | 0,786 | 0,739 | 0,760 | +0,160 |
| YOLOv5 | 0,717 | 0,647 | 0,680 | 0,979 | 0,907 | 0,940 | +0,260 |
| CenterNet | 0,841 | 0,775 | 0,810 | 0,901 | 0,852 | 0,880 | +0,070 |
| RetinaNet | 0,982 | 0,874 | 0,920 | 0,991 | 0,918 | 0,950 | +0,030 |
| YOLOv8 | 0,982 | 0,932 | 0,920 | 0,974 | 0,938 | 0,960 | +0,040 |
Faster R-CNN-də baseline model çox yüksək precision-a baxmayaraq yalnız 0,442 recall göstərir. GVA-dan sonra recall 0,739-a yüksələrkən precision 0,786-ya enmiş, lakin AP50 ümumilikdə 0,600-dən 0,760-a yüksəlmişdir.
YOLOv5-də həm precision, həm recall eyni vaxtda yüksəlmiş və bu model ən böyük ümumi detector qazancını əldə etmişdir.
Güclü modellər niyə daha az qazanır?
Mənbənin şərhinə görə, aşağı başlanğıc performansına malik modellərdə fonun basdırılması və precision–recall tarazlığı baxımından daha çox təkmilləşdirmə sahəsi var. RetinaNet və YOLOv8 kimi güclü baseline-lar artıq inkişaf etmiş feature fusion və attention davranışına malik olduğundan GVA bu modellərdə daha çox incə tənzimləmə effekti göstərir.
GVA Müxtəlif Uzaqdan Zondlama Hədəflərinə Ümumiləşdirilə Bildimi?
YOLOv5 üzərində aparılan dörd sinifli təcrübədə GVA təyyarə, gəmi, saxlama çəni və körpü kateqoriyalarının hamısında AP50 artımı təmin etmişdir; orta AP50 0,666-dan 0,855-ə yüksəlmişdir. Lakin qazancın böyüklüyü hədəf geometriyasına görə xeyli dəyişmiş, ən böyük artım saxlama çənlərində, ən kiçik artım isə körpülərdə görülmüşdür.
| Kateqoriya | Baseline AP50 | GVA AP50 | Mütləq fərq |
|---|---|---|---|
| Təyyarə | 0,680 | 0,942 | +0,262 |
| Gəmi | 0,914 | 0,958 | +0,044 |
| Saxlama çəni | 0,493 | 0,918 | +0,425 |
| Körpü | 0,576 | 0,603 | +0,027 |
| Orta | 0,666 | 0,855 | +0,189 |
Mənbə yığcam və müntəzəm həndəsəyə malik hədəflərdə kənar və color-rarity mexanizminin daha təsirli olduğunu, uzun xətti strukturlar olan körpülərin mövcud saliency dizaynı ilə daha az uyğun gəldiyini irəli sürür.
Təyyarə üçün əsas beş-model təcrübəsində AP50 0,940, kateqoriyalararası təcrübədə isə 0,942 kimi bildirilmişdir. Bunlar müxtəlif təcrübə cədvəllərində verilən dəyərlərdir və süni şəkildə bir dəyərə bərabərləşdirilməməlidir.
GVA İnsan Göz Hərəkətləri ilə Nə Qədər Uyğundur?
İnsan fixation heatmap-ləri ilə müqayisədə GVA üçün CC=0,740, NSS=2,600 və KL=0,898 bildirilmişdir; bu dəyərlər model attention-ının insan baxış paylanmasına baseline detector-lardan daha yaxın olduğunu göstərir. Bununla belə, istifadə olunan metriklər diqqətin müxtəlif xüsusiyyətlərini ölçür və vahid “insana bənzərlik faizi” kimi birləşdirilməməlidir.
Diqqət uyğunlaşması metrikləri
| Metrik | Nə ölçür? | Daha yaxşı istiqamət |
|---|---|---|
| CC | Attention xəritələri arasındakı ümumi məkan korrelyasiyası | Yüksək |
| SSIM | Məkan/struktur oxşarlığı | Yüksək |
| NSS | Model saliency-sinin insan fiksasiya nöqtələrində cəmlənməsi | Yüksək |
| KL divergence | İki diqqət ehtimal paylanması arasındakı fərq | Aşağı |
GVA ablasiyası nə göstərdi?
Mənbə dörd sistemi müqayisə edir:
- Itti saliency baseline,
- yalnız stimulus-driven saliency,
- yalnız target-directed guidance,
- tam Guided-Search Visual Attention.
| Metod | CC | SSIM | NSS | KL |
|---|---|---|---|---|
| Itti | 0,388 | 0,357 | 0,920 | 1,562 |
| Stimulus-driven | 0,505 | 0,613 | 2,598 | 2,090 |
| Target-directed | 0,511 | 0,565 | 2,017 | 1,826 |
| Full GVA | 0,740 | 0,581 | 2,600 | 0,898 |
Bu cədvəl iki-yollu dizaynın xüsusilə CC və KL baxımından güclü tamamlayıcılıq verdiyini göstərir. GVA ən yüksək CC və NSS ilə ən aşağı KL dəyərini verir.
Mənbədaxili uyğunsuzluq: eyni bölmənin mətni tam GVA-nın “bütün metriklərdə” tək-yollu metodları keçdiyini desə də, Şəkil 4-də stimulus-driven yolun SSIM dəyəri 0,613, tam GVA-nınkı 0,581-dir. Buna görə SSIM baxımından Şəkil 4 bu cümləni dəstəkləmir.
Beyin–Model Uyğunlaşması Necə Ölçüldü?
Beyin–model uyğunlaşması detector-un FPN qatlarındakı P3, P4 və P5 xüsusiyyətlərindən yaradılan Representational Similarity Matrices ilə fixation-locked EEG siqnallarından yaradılan RSM-lərin Spearman korrelyasiyası üzərindən ölçülmüşdür. Bu metod modelin “beyin kimi düşündüyünü” birbaşa göstərmir; müxtəlif stimullar arasındakı təmsil münasibətlərinin insan EEG-sindəki təmsil həndəsəsinə nə qədər bənzədiyini yoxlayır.
Model RSM-lərinin yaradılması
Target və background bölgələri ROI-Align ilə P3, P4 və P5 feature map-lərindən kəsilmiş, pooled və normalize edilmişdir. Hər stimul cütü arasındakı cosine dissimilarity istifadə edilərək model RSM-ləri yaradılmışdır.
EEG RSM-lərinin yaradılması
EEG epoch-ları göz fiksasiya etiketlərinə görə target və background olaraq ayrılmışdır. Dörd kortikal bölgədəki ERP siqnalları model feature sırasına uyğunlaşdırılan feature vektorlarına çevrilmiş, Fisher-Z transform tətbiq edilmiş və iştirakçılar arasında ortalanmışdır.
Model ilə EEG RSM arasındakı əlaqə Spearman rank correlation ilə ölçülmüş; statistik əhəmiyyətlilik 5.000 permutation testi və FDR correction ilə qiymətləndirilmişdir.
P3, P4 və P5 qatları arasında nə baş verdi?
Baseline detector-larda beyin–model korrelyasiyaları aşağı və nizamsızdır; Spearman's r təxminən 0,006–0,024 aralığındadır.
GVA-dan sonra uyğunlaşma bütün arxitekturalarda artmış və ümumilikdə P3-dən P5-ə doğru güclənən qat qradiyenti yaranmışdır.
Mənbənin P3–P5 üzrə bildirdiyi maksimum RSA artımları:
| Model | Maksimum RSA artımı | Orta RSA artımı |
|---|---|---|
| Faster R-CNN | 133% | 108% |
| YOLOv5 | 50% | 73% |
| RetinaNet | 14% | 13% |
| CenterNet | 40% | 78% |
| YOLOv8 | 4% | 31% |
Bu faiz artımlarının aşağı başlanğıc korrelyasiyalarına nisbətən nisbi artımlar olduğu unudulmamalıdır; mütləq RSA dəyərləri kiçik qalır.
GVA Hansı Beyin Bölgələri ilə Daha Çox Uyğunlaşdı?
Regional RSA analizində ən böyük orta artım oksipital korteksdə Δρ=0,012, ikinci böyük artım frontal korteksdə Δρ=0,008 kimi bildirilmişdir. Parietal Δρ=0,001 və temporal Δρ=0,003 artımları daha kiçikdir və mənbədə çox vaxt statistik əhəmiyyətli olmadığı qeyd olunur.
Mənbə bu paylanmanı GVA arxitekturasının iki yolu ilə əlaqələndirir:
- Oksipital artım: kənar və rəng kontrastı kimi erkən vizual xüsusiyyətlərin bottom-up saliency yolu ilə işlənməsi,
- Frontal artım: hədəfə yönəlmiş top-down diqqət nəzarətinin task-guidance yolu ilə modelləşdirilməsi.
Bu şərh mexanistik hipotezdir. EEG-nin məkan həlli, mənbənin özünün də məhdudiyyət kimi bildirdiyi kimi, incə miqyaslı kortikal mexanizm nəticələri çıxarmağa imkan vermir.
Qat iyerarxiyası ilə insan vizual iyerarxiyası eyni şeydirmi?
Mənbə GVA-dan sonra P3-dən P5-ə artan RSA-nı insan vizual sisteminin iyerarxik emal nizamı ilə uyğun bir nümunə kimi şərh edir. Bununla belə, P3/P4/P5 detector xüsusiyyətlərinin konkret kortikal emal mərhələləri ilə birbaşa anatomik ekvivalent olduğu göstərilməmişdir.
Düzgün ifadə budur ki, model feature iyerarxiyasındakı təmsil uyğunluğunun dərin qatlara doğru artması istifadə olunan EEG/RSA çərçivəsində insan vizual emal iyerarxiyası ilə daha uyğun bir nümunə yaradır.
Statistik qiymətləndirmə
Göz izləmə attention metrikləri üçün one-way ANOVA, FDR-adjusted Tukey HSD və 1.000 bootstrap nümunəsi istifadə edilmişdir.
Neural RSA üçün 5.000 permutation testi tətbiq edilmiş və \(\alpha=0,05\) səviyyəsində FDR correction aparılmışdır.
Mənbə əsas visual alignment müqayisələrində FDR-corrected \(p<0,001\) bildirir.
Tədqiqatın dəstəklədiyi nəticələr
- GVA, guided search theory-dəki bottom-up və top-down diqqət mexanizmlərini birləşdirən iki-yollu attention çərçivəsidir.
- DIOR təyyarə testində GVA sınaqdan keçirilən beş detector-un hamısında AP50-ni artırmışdır.
- Arxitekturalar arasında ən böyük təyyarə AP50 artımı YOLOv5 üçün +0,260-dır.
- YOLOv5-in dörd kateqoriyalı ümumiləşdirmə təcrübəsində orta AP50 0,666-dan 0,855-ə yüksəlmişdir.
- GVA attention map-i insan fixation paylanması ilə CC=0,740 dəyərinə çatmışdır.
- Full GVA, Şəkil 4-də CC, NSS və KL baxımından tək yolları qabaqlayır.
- EEG–model RSA dəyərləri GVA-dan sonra sınaqdan keçirilən arxitekturalarda artmışdır.
- Ən nəzərəçarpan regional RSA artımları oksipital və frontal bölgələrdə bildirilmişdir.
- GVA-nın detector-a yerləşdirilməsi native classification/regression branch-ləri və loss funksiyalarını dəyişdirmir.
Tədqiqatın dəstəkləmədiyi nəticələr
- GVA istifadə edən detector-ların insan beyni ilə eyni hesablamanı apardığı göstərilməmişdir.
- CC=0,740 dəyəri ümumi mənada “model %74 insan beyninə bənzəyir” kimi şərh edilə bilməz.
- EEG RSA korrelyasiyası klinik və ya bioloji ekvivalentlik sübutu deyil.
- Koqnitiv alignment məlumatları təyyarədən başqa hədəf kateqoriyalarında hələ təsdiqlənməmişdir.
- GVA-nın SAR və ya hyperspectral görüntülərdə eyni performansı verəcəyi göstərilməmişdir.
- GVA-nın bütün uzaqdan zondlama detector-larında eyni AP50 artımını təmin edəcəyi sübut olunmamışdır.
- “Parameter-free” ifadəsi top-down Random Forest-ın heç bir təlim görmədiyi mənasına gəlmir.
- Şəkil 4, full GVA-nın SSIM-də stimulus-driven yolu keçdiyini göstərmir.
- Preprint nəticələri rəyçidən keçmiş yekun sübut kimi qiymətləndirilməməlidir.
Tədqiqatın məhdudiyyətləri
Mənbə üç əsas məhdudiyyəti açıq şəkildə bildirir.
- Koqnitiv məlumat məhdudiyyəti: göz izləmə və EEG alignment qiymətləndirilməsi yalnız təyyarə hədəfləri üçün mövcuddur. Digər kateqoriyalarda detector performansı yoxlansa da uyğun insan cognitive benchmark hələ yoxdur.
- Modal məhdudiyyəti: tədqiqat yalnız optik remote sensing görüntülərində aparılmışdır; SAR və hyperspectral görüntülər sınaqdan keçirilməmişdir.
- EEG məkan həlli: EEG neural mechanism analizini makroskopik funksional beyin bölgələri ilə məhdudlaşdırır.
Gələcək tədqiqat sahələri
Müəlliflər bottom-up saliency mexanizminin müxtəlif sensor modallarına uyğunlaşdırıla biləcəyini təklif edirlər. SAR üçün polarimetric signatures, hyperspectral görüntülər üçün spectral band xüsusiyyətləri rəng məlumatının yerinə istifadə oluna biləcək namizəd təmsillərdir.
Etiketli nümunənin az olduğu geniş ərazi müşahidə tətbiqlərində top-down prior-ın unsupervised və ya self-supervised metodlarla öyrənilməsi də gələcək tədqiqat istiqaməti kimi göstərilir.
Tədqiqat həmçinin GVA yerləşdirilməsinin detector-a yeni trainable neural-network parametrləri əlavə etmədiyi üçün lightweight və edge-processing arxitekturaları üçün potensial daşıdığını irəli sürür; lakin real edge cihazında ətraflı latency və ya enerji istehlakı təcrübəsi bildirilməmişdir.
Mənbə və Metod Qeydi
Orijinal başlıq: Embedding human-like visual attention for brain-aligned and high-performance remote sensing object detection
Müəlliflər: Bing He, Tong Qin, Dajun Xing, Ying Qu, Qiaosong Hei, Chunfeng Gao, Zheng Gong, Qiao Wang, Weihua Dong
Mənbə növü: Preprint tədqiqat məqaləsi.
SSRN qeydiyyat nömrəsi: 7346288.
SSRN-ə yüklənmə: 24 avqust 2026.
Rəyçi qiymətləndirməsi statusu: Mənbə açıq şəkildə “This preprint research paper has not been peer reviewed” ifadəsini daşıyır.
Əsas metod: Guided-Search Visual Attention (GVA).
Nəzəri əsas: Guided search theory; stimulus-driven saliency və target-directed guidance yollarının priority map yaratmaq üçün birləşdirilməsi.
Detector-lar: Faster R-CNN, RetinaNet, YOLOv5s, YOLOv8n və CenterNet.
Əsas obyekt aşkarlama verilənlər dəsti: DIOR.
Koqnitiv benchmark: EEGET-RSOD; 1.000 ədəd 800×800 remote sensing görüntüsü və 38 iştirakçının eyni vaxtlı göz izləmə–EEG məlumatları.
Etik təsdiq: Beijing Normal University Ethics Committee, No. 20221024111.
Eye tracker: SMI RED250, 250 Hz.
EEG: NE Enobio, 32 kanal, 500 Hz, 10–20 yerləşim.
Visual alignment metrikləri: Pearson correlation coefficient (CC), structural similarity index (SSIM), normalized scanpath saliency (NSS), Kullback–Leibler divergence (KL).
Neural alignment metodu: Representational Similarity Analysis (RSA), model P3/P4/P5 FPN xüsusiyyətləri və fixation-locked EEG RSM-ləri.
Data availability: EEGET-RSOD verilənlər dəsti Figshare üzərində 10.6084/m9.figshare.26943565 DOI-si ilə mənbədə göstərilmişdir.
Code availability: Mənbə analiz kodunun GitHub-da “Bing-1997/Human-like_visual_attention_embedding_framework” deposunda olduğunu bildirir.
Mənbədaxili vacib nüans: GVA detector-a yeni öyrənilə bilən neural-network parametrləri əlavə etmir; bununla belə target-directed yol 500 etiketli nümunə üzərində öyrədilən Random Forest istifadə edir.
Mənbədaxili vacib uyğunsuzluq: Şəkil 4-də full GVA SSIM=0,581, stimulus-driven saliency SSIM=0,613-dür; buna görə eyni bölmədəki “full GVA all metrics'te üstündür” cümləsi SSIM baxımından şəkillə uyğun gəlmir.
Əsas şərh sərhədi: “Brain-aligned” nəticəsi EEG/RSA və eye-tracking metriklərində ölçülən təmsil/diqqət oxşarlığı deməkdir; birbaşa bioloji mexanizm ekvivalentliyi və ya beynin hesablama prosesinin kopyalanması demək deyil.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib