

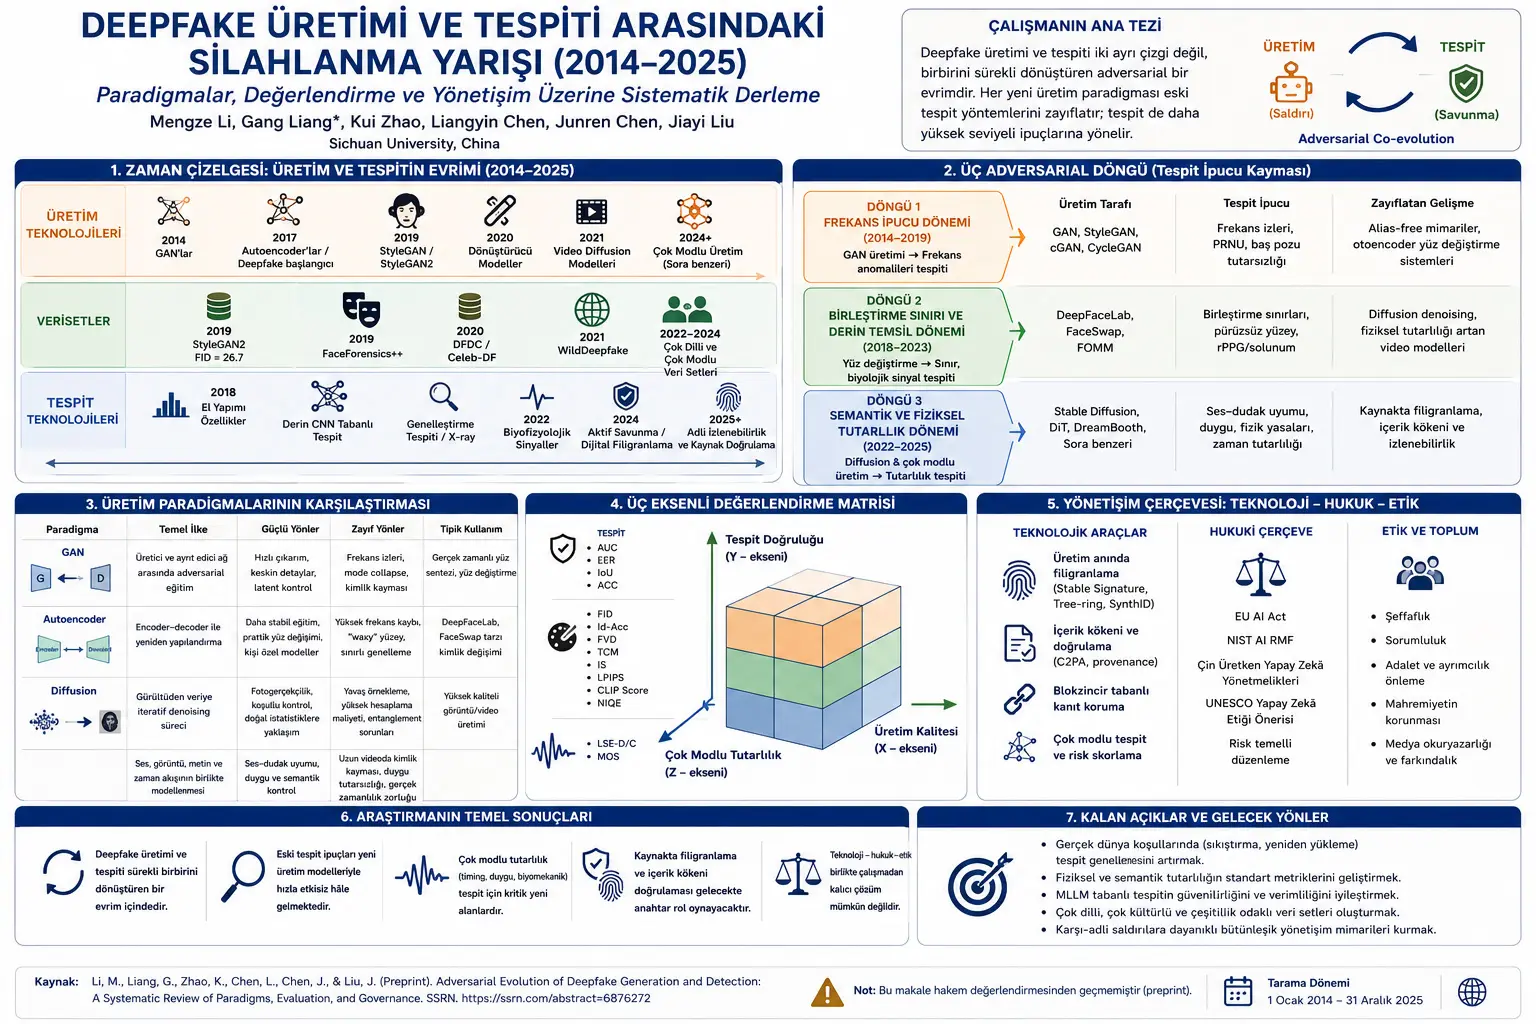
Deepfake texnologiyasi chuqur neyron tarmoqlar yordamida tasvir, video, ovoz yoki ularning uyg‘unligini go‘yoki haqiqiydek yaratish yoki o‘zgartirish jarayonidir. Bir qarashda bu mavzu faqat soxta yuz videolari yoki ijtimoiy tarmoqlarda tarqaladigan manipulyatsiyalangan kontent kabi ko‘rinishi mumkin. Biroq tadqiqot deepfake texnologiyasi endi shaxsiy maxfiylik buzilishidan ancha kengroq xavf maydoniga chiqqanini ta’kidlaydi. Soxta siyosiy nutqlar, ovoz klonlash orqali moliyaviy firibgarlik, jamoatchilik ishonchining yemirilishi, milliy xavfsizlikka xavf, media tekshiruvi muammosi va raqamli dalillarning ishonchliligi bu sohaning bevosita oqibatlari orasidadir.
Maqolaning chiqish nuqtasi deepfake yaratish sifati bilan deepfake aniqlash tizimlarining umumlashtirish qobiliyati o‘rtasidagi tizimli nomutanosiblikdir. Yaratuvchi modellar tobora realroq, boshqariluvchanroq va ko‘proq modalli bo‘lib borar ekan, aniqlash tizimlari ko‘pincha oldingi ma’lumotlar to‘plamlarida o‘rganilgan izlarga tayanib qoladi. Tadqiqotda keltirilgan Deepfake-Eval-2024 natijalari bu bo‘shliqni aniq ko‘rsatadi: oldingi ma’lumotlar to‘plamlarida o‘qitilgan zamonaviy aniqlash tizimlari 2024 yilda ijtimoiy tarmoqlardan yig‘ilgan real muhitdagi deepfake kontentlarda baholanganda AUC qiymatlarida taxminan 50% pasayish ko‘rsatgan. Pasayishning eng kattasi diffusion asosidagi namunalarda kuzatilgani eski aniqlash belgilarining yangi yaratish modellariga qarshi nega zaiflashayotganini yaqqol ko‘rsatadi.
Bu yerda muhim tushuncha AUC, ya’ni Area Under the ROC Curve ko‘rsatkichidir. AUC aniqlash modelining haqiqiy va soxta namunalarni turli qaror chegaralarida ajrata olish qobiliyatini o‘lchaydi. Oddiyroq aytganda, modelning “haqiqiymi yoki soxtami?” degan farqlashda qanchalik ishonchli tartiblash qila olishini ko‘rsatadi. AUC ning pasayishi model oldingi muhitda o‘rgangan izlar yangi muhitda endi avvalgidek ishlamayotganini anglatadi. Tadqiqot ko‘rsatgan muammo aynan shu: laboratoriya ma’lumotlar to‘plamida yuqori ko‘ringan natija ijtimoiy tarmoqlardagi siqilgan, qirqilgan, qayta yuklangan, turli yaratish modellarida tayyorlangan kontentlarda bir xil darajada saqlanib qolmaydi.
Maqola mavjud sharhlarning ko‘pchiligi yaratish va aniqlashni parallel, ammo alohida yo‘nalishlar sifatida talqin qilishini qayd etadi. Aslida esa mualliflar fikricha, sohaning asosiy dinamikasi siklikdir. Aniqlash tizimi bir izni topadi; yaratuvchi model bu izni kamaytiradi; aniqlash tizimi esa undan ham yuqoriroq darajadagi yangi izga o‘tadi. Shu sababli tadqiqot taklif qilgan asosiy ramka adversarial evolution, ya’ni hujumkor va himoyaviy tomon bir-birini uzluksiz qayta shakllantiradigan evolyutsiyadir.
Tadqiqotning eng muhim tushunchalaridan biri cue drift, ya’ni aniqlash ishorasining siljishidir. Deepfake aniqlashda “cue” soxta kontentni ushlashga yordam beradigan iz yoki belgi degani. Bu iz ba’zan chastota sohasidagi sun’iy naqsh, ba’zan yuz chetidagi qo‘shilish chizig‘i, ba’zan qon oqimi signalidagi buzilish, ba’zan ovoz bilan lab harakati orasidagi nomuvofiqlik, ba’zan esa videodagi fizik harakatning real dunyoga mos kelmasligi bo‘lishi mumkin. “Cue drift” esa yaratish modellarining rivojlanishi bilan bu izlarning o‘rnining almashib borishidir. Aniqlash tizimi bir davrning iziga haddan tashqari suyanib qolsa, yangi avlod yaratuvchi model o‘sha izni yo‘qotganda himoya zaiflashadi.
Tadqiqot 2014–2025 davrini uch asosiy aniqlash ishorasi sikliga ajratadi. Birinchi sikl frequency-cue era, ya’ni chastota ishoralari davridir. Bu davr taxminan 2014–2019 oralig‘ini qamrab oladi va ayniqsa GAN asosidagi yaratish bilan bog‘liq. GAN modellar tasvir yaratishda muayyan upsampling jarayonlaridan foydalanadi. Bu jarayonlar tabiiy kamera bilan olingan tasvirlarda uchramaydigan chastota izlarini hosil qilishi mumkin. O‘sha davrda aniqlash tizimlari tasvirning chastota maydoniga qarab soxta kontentni topishga urinadi.
Bu davrda muhim texnik izlardan biri transposed convolution amallarining hosil qilgan davriy naqshlaridir. Tadqiqotda GAN tasvirlarida taxminan (±0.25, ±0.25) chastota hududlarida energiya to‘planishi kabi belgilar qayd etiladi. Bu belgilar oddiy tasvirlardagi kamera va sensor manbali tabiiy andozalardan farq qiladi. Kundalik o‘xshatish bilan aytganda, haqiqiy matoda to‘qish tabiiy notekisliklarni olib yuradi, mashinada chiqarilgan soxta naqsh esa takrorlanuvchi mikroskopik chiziqlar qoldiradi. Chastotaga asoslangan aniqlash tizimlari tasvirning yuzasiga emas, ana shu ko‘rinmas naqshlarga qaraydi.
Tadqiqotda chastota tahliliga oid asosiy amal quyidagi munosabat orqali tushuntiriladi:
\[ P(r)=\frac{1}{2\pi}\int_{0}^{2\pi}|F(r\cos\theta,r\sin\theta)|\,d\theta \]
Bu formulada F(u,v) tasvirning chastota maydonidagi tasvirini bildiradi. r chastota maydonidagi radiusni; θ esa burchak yo‘nalishini ko‘rsatadi. P(r) turli yo‘nalishlardagi chastota energiyasining o‘rtachasini olib, bir o‘lchamli radial energiya profilini hosil qiladi. Formulaning ma’nosi shuki: tasvirning qaysi chastota hududlarida tabiiy bo‘lmagan energiya yig‘ilishi borligi o‘lchanadi. GAN asosidagi soxta tasvirlarda muayyan chastota hududlarida sun’iy cho‘qqilar paydo bo‘lsa, bu aniqlash uchun ishlatilishi mumkin.
Ammo bu ilk siklning ham chegarasi bor. GAN arxitekturalari rivojlanib, ayniqsa StyleGAN3 kabi alias-free yondashuvlar bu chastota izlarini kamaytira boshlaydi. Bundan tashqari, yuz almashtirish tizimlari noldan yangi yuz yaratish o‘rniga, bir yuzni boshqa videoga ko‘chirib qo‘yishga yo‘nalganda, soxtalik izi chastota sohasidan yuzning qo‘shilish chegaralari va vaqt ichidagi biologik tutarlilikka siljiydi.
Ikkinchi sikl blending-boundary and deep-representation era, ya’ni qo‘shilish chegarasi va chuqur tasvirlanish davridir. Bu davr taxminan 2018–2023 oralig‘ida yaqqol ko‘rinadi. DeepFaceLab, FaceSwap va First Order Motion Model kabi autoencoder yoki yuz reenactment tizimlari shu kontekstda muhimdir. Bu tizimlar ko‘pincha bir insonning identifikatsiyasini boshqa yuz harakati yoki maqsad videoga ustma-ust qo‘yadi. Bu jarayonda yuz hududi maqsad kadrga kompozitsiya qilingani uchun yuz atrofida yoki teksturasida chegara, maskalash, rang nomuvofiqligi, silliqlash va biokimyoviy buzilish kabi izlar qolishi mumkin.
Autoencoder asosidagi yuz almashtirish tizimlari odatda shared encoder–independent decoder tamoyili bilan ishlaydi. Umumiy encoder yuzning poza, ifoda va yoritish kabi identifikatsiyaga tegishli bo‘lmagan strukturaviy xususiyatlarini ajratadi; turli decoderlar esa manba va maqsad identifikatsiyalariga oid yuz teksturasini qayta yaratadi. Tadqiqotdagi 7-rasm ushbu mexanizmni sxematik ko‘rsatadi. Bu yondashuv GAN o‘qitishidagi ayrim beqarorliklarni kamaytiradi va yuz almashtirishni amaliy qiladi. Biroq piksel darajasidagi qayta qurish yo‘qotishi yuz teksturasining yuqori chastotali tafsilotlarini yumshatishi mumkin. Tadqiqotda bu “waxy”, ya’ni mumdek silliq ko‘rinish sifatida talqin qilinadi.
Bu davrning aniqlash usullari soxta yuzning maqsad kadrga yopishtirilgan chegaralarini topishga urinadi. Face X-ray va Self-Blended Images kabi usullar yuz almashtirish jarayonining qoldirgan qo‘shilish chegarasini bevosita modellashtirishga harakat qiladi. Shuningdek, FakeCatcher kabi yondashuvlar yuz terisidagi juda kichik rang o‘zgarishlaridan yurak urishi bilan bog‘liq remote photoplethysmography, ya’ni uzaktan fotopletizmografiya/rPPG signalini ajratib olishga urinadi. Haqiqiy inson yuzida qon oqimi va teri rangi vaqt o‘tishi bilan biologik ritmga ega bo‘ladi; soxta videoda bu ritm ko‘pincha to‘liq saqlanmaydi.
Uchinchi sikl semantic and physical-consistency era, ya’ni semantik va fizik muvofiqlik davridir. Bu davr 2022–2025 oralig‘ida diffusion modellari, katta video yaratish tizimlari va ko‘p modalli yaratish yondashuvlari bilan bog‘liq. Stable Diffusion, DiT, DreamBooth va Sora kabi tizimlar tasvir va video yaratishda ancha yuqori realizm, shartli boshqaruv va fizik ko‘rinishdagi muvofiqlikni taqdim etadi. Bu bosqichda chastota izlari, oddiy qo‘shilish chegaralari yoki yakka piksel anomaliyalari aniqlash uchun yetarli bo‘lmasligi mumkin.
Diffusion modellari asosan shovqindan ma’lumotga tomon boruvchi denoising jarayonidan foydalanadi. Model avval ma’lumotga bosqichma-bosqich shovqin qo‘shish jarayonini o‘rganadi, so‘ng bu jarayonni teskari yo‘nalishda bajarib, shovqindan mazmunli tasvir yoki video hosil qiladi. Tadqiqotda diffusion modellarining ehtimollik asoslari quyidagi ELBO munosabati bilan beriladi:
\[ \mathbb{E}[-\log p_{\theta}(x_0)] \leq \mathbb{E}_{q}\left[-\log p(x_T)-\sum_{t\geq 1}\log\frac{p_{\theta}(x_{t-1}|x_t)}{q(x_t|x_{t-1})}\right] \]
Bu formulada x0 haqiqiy/ma’lumot namunasi, xT esa shovqinli yakuniy holat, q(xt|xt-1) oldinga yo‘nalgan shovqin qo‘shish jarayoni, pθ(xt-1|xt) esa modelning teskari yo‘nalishda shovqinni kamaytirib ma’lumotga yaqinlashish jarayonini bildiradi. θ model parametrlarini ko‘rsatadi. Texnik jihatdan bu ifoda model haqiqiy ma’lumot taqsimotini bevosita hisoblamasdan, uni pastki chegara orqali o‘rganishga intilishini anglatadi.
Amaliy o‘qitishda bu murakkab maqsad Ho va hamkorlari ko‘rsatganidek shovqin bashorat qilish yo‘qotishiga qisqartirilishi mumkin. Tadqiqotda berilgan soddalashtirilgan loss formulasi quyidagicha:
\[ L_{simple}(\theta)=\mathbb{E}_{t,x_0,\epsilon}\left[\left\|\epsilon-\epsilon_{\theta}\left(\sqrt{\bar{\alpha}_t}x_0+\sqrt{1-\bar{\alpha}_t}\epsilon,t\right)\right\|^2\right] \]
Bu formulada ε ma’lumotga qo‘shilgan haqiqiy shovqinni; εθ model bashorat qilgan shovqinni; t vaqt/shovqin bosqichini; \bar{α}t esa shovqin jadvalini belgilovchi koeffitsientni bildiradi. Formulaning kundalik ma’nosi shuki: model “bu tasvirga qanday shovqin qo‘shilgan edi?” degan savolni o‘rganadi. Agar bu savolga yetarlicha yaxshi javob bera olsa, teskari yo‘nalishda borib shovqindan realistik tasvir yaratishi mumkin.
Diffusion modellarining aniqlash nuqtayi nazaridan eng qiyin tomoni — ularning yaratish jarayoni tabiiy tasvir statistikalariga juda yaqinlashib borishidir. GAN davridagi chastota maydonida ko‘rinadigan sun’iy cho‘qqilar diffusion chiqishlarida ancha zaif bo‘lishi mumkin. Video yaratishda ham Sora kabi modellar fazoviy-vaqtinchalik bo‘linish va DiT arxitekturalari orqali harakat, yorug‘lik, fizik ta’sir va uzoq masofali bog‘lanishlarni yaxshiroq modellashtira oladi. Bu aniqlashni piksel darajasidan yuqoriroq darajaga olib chiqadi: video fizik qonunlarga mos keladimi? Ovoz bilan lab harakati haqiqatan ham mos keladimi? Nutqdagi hissiyot ohangi yuz ifodasi bilan tutashadimi? Soya, yorug‘lik manbasi va harakat yo‘nalishi bir xil fizik dunyoga tegishlimi?
Maqola ko‘p modalli deepfake sohasini alohida kritik chegara sifatida ko‘rib chiqadi. Dastlabki davrlarda soxtalik ko‘proq yuz tasviri bilan cheklangan edi. Keyin lab harakati va ovoz moslashtirish tizimlari rivojlandi. Wav2Lip kabi tizimlar nutq ovoziga mos lab harakati yaratishda juda kuchli bo‘ldi. Keyinroq NeRF asosidagi va diffusion asosidagi gapiruvchi bosh modellari yuz ifodasi, og‘iz harakati, ovoz ohangi va identifikatsiya muvofiqligini birgalikda yaratishga kirishdi. Bugun va yaqin kelajakdagi xavf faqat soxta video emas; balki soxta ovoz, soxta yuz, soxta tana tili, soxta hissiyot va kontekstga mos soxta nutq ssenariysining birgalikda yaratilishidir.
Shu sababli tadqiqot ko‘p modalli soxtalikni uch darajada muhokama qiladi: temporal synchronisation, ya’ni vaqt uyg‘unligi; emotional consistency, ya’ni hissiy muvofiqlik; biomechanical consistency, ya’ni biomexanik muvofiqlik. Haqiqiy nutqda lab harakati, ovoz boshlanishi, nafas ritmi, yuz mushaklari, ko‘z harakati, ohang va hissiy intensivlik bir-biridan mustaqil emas. Soxta kontent juda real ko‘rinsa ham, shu qatlamlarning birida kichik nomuvofiqliklar qolishi mumkin.
Masalan, ovoz bilan lab harakati orasida 40–60 millisekunddan oshadigan siljishlar inson idrokida tabiiy bo‘lmagan hissiyot uyg‘otishi mumkin. Xuddi shuningdek, bir kishining yuzi kulayotgan bo‘lib ko‘rinsa-yu, ovoz ohangi yig‘i yoki qo‘rquv kayfiyatini olib yursa, hissiy nomuvofiqlik paydo bo‘ladi. Turli tillardagi lab yopilishlari va talaffuz shakllari ham muhimdir. Tadqiqotda xitoy va ingliz tillari kabi tillarda fonema–vazema munosabatlari deepfake aniqlashda ishora bo‘lishi mumkinligi aytiladi. Bu aniqlash tizimlari faqat kompyuter ko‘rish emas, balki til, fonetika, tana harakati va inson biologiyasi haqidagi bilimlarni ham qo‘llashi kerakligini anglatadi.
Tadqiqot metod qismida ushbu sharh tasodifiy tanlangan manbalardan iborat emasligi ko‘rsatiladi. Tadqiqotchilar PRISMA ga moslashtirilgan protokoldan foydalangan. IEEE Xplore, ACM Digital Library, Web of Science va arXiv tekshirilgan. Qidiruv atamalari uch guruhga bo‘lingan: yaratish atamalari, aniqlash atamalari va modalitet atamalari. Yaratish tomonida deepfake, face forgery, face swap, talking head, diffusion model, GAN va autoencoder; aniqlash tomonida detection, forensics, authentication va anti-spoofing; modalitet tomonida image, video, audio va multimodal kabi atamalar ishlatilgan.
PRISMA oqimi tadqiqotning 2-rasmida ko‘rsatiladi. Dastlabki qidiruvda 1.486 ta yozuv topilgan. 312 ta takror olib tashlangach, 1.174 ta yozuv sarlavha va annotatsiya darajasida ko‘rib chiqilgan. 627 ta yozuv mavzudan tashqari bo‘lgani uchun chiqarib tashlangan. Qolgan 547 ta to‘liq matn muvofiqlik bo‘yicha baholangan va 211 ta ish sifatli sintezga kiritilgan. Bu 211 ishning 83 tasi yaratish usullari, 75 tasi aniqlash usullari, 31 tasi ma’lumot to‘plamlari va baholash, 22 tasi esa boshqaruv, axloq va siyosatga ajratilgan. Bu raqamlar tadqiqot faqat texnik modellarni emas, balki ma’lumotlar to‘plami va boshqaruv o‘lchovini ham qamrab olganini ko‘rsatadi.
Tadqiqot meta-tahlil qilmaganini alohida ta’kidlaydi. Buning sababi — kiritilgan ishlarning ma’lumotlar to‘plamlari, baholash protokollari, siqish darajalari, yuzni qirqish usullari, namuna olish tezligi va hisobot berish shakllari bo‘yicha juda xilma-xil bo‘lishidir. Ya’ni tadqiqotchilar yagona umumiy ta’sir kattaligini hisoblashga urinmagan. Buning o‘rniga ular tematik sintez qilgan va har bir siklda uch narsaga qaragan: qaysi yaratish texnikalari ustun, bu texnikalar qaysi izlarni qoldiradi yoki qaysi eski izlarni bostiradi, aniqlash usullari bu izlarni qanday operatsionlashtiradi.
Tadqiqotning yaratish texnologiyalarini taqqoslash qismi ham muhimdir. GAN, autoencoder va diffusion modellari bir-birini to‘liq almashtiradigan avlodlar emas; ular ko‘pincha parallel ishlaydi. GAN lar tez chiqarish va keskin vizual tafsilotlarda afzal bo‘lishi mumkin, ammo chastota izlari va o‘qitishdagi beqarorlik kabi muammolarni olib yuradi. Autoencoder tizimlari yuz almashtirishda barqarorroq va amaliyroq bo‘lsa-da, yuz teksturasida silliqlash va yuqori chastotali tafsilot yo‘qotishiga olib kelishi mumkin. Diffusion modellari yuqori realizm va shartli boshqaruvni taqdim etadi, biroq iterativ namuna olish sababli sekinroq va hisoblash jihatdan qimmatroq bo‘lishi mumkin. Ko‘p modalli tizimlar esa ovoz, tasvir, matn va vaqt uyg‘unligini birgalikda nishonga oladi; ammo uzoq videolarda identifikatsiya siljishi, hissiy nomuvofiqlik va real vaqt yaratish muammolari hanuz dolzarbdir.
Maqolaning baholash metrikalari bo‘limi deepfake tadqiqotlarida bitta muvaffaqiyat soni yetarli emasligini ko‘rsatadi. Aniqlash tomonida AUC, EER, IoU va ACC kabi o‘lchovlar ishlatiladi. Yaratish sifati tomonida FID, Id-Acc, FVD, TCM, IS, LPIPS, CLIP Score va NIQE mavjud. Ko‘p modalli uyg‘unlik tomonida LSE-D/C va MOS ajralib turadi. Tadqiqot taklif qilgan uch o‘qli matritsa bu metrikalarni yagona ramkada birlashtiradi.
EER, ya’ni Equal Error Rate, noto‘g‘ri qabul va noto‘g‘ri rad etish ko‘rsatkichlari tenglashadigan chegarani bildiradi. U sud va biometrik kontekstda muhim, chunki soxta kontentni haqiqiy deb qabul qilish bilan haqiqiy kontentni soxta deb o‘ylash turli, lekin jiddiy xavflar tug‘diradi. IoU, ya’ni Intersection over Union, soxta deb taxmin qilingan hudud bilan haqiqiy belgilangan soxta hudud qanchalik mos kelishini o‘lchaydi. Bu faqat “video soxta” demasdan, “soxtalik tasvirning qaysi qismida?” degan savolga javob beradi.
Yaratish sifati metrikalarida FID yaratilgan tasvirlarning real tasvir taqsimotiga qanchalik o‘xshashligini o‘lchaydi. Id-Acc yuz almashtirish kabi vazifalarda maqsad identifikatsiyasi saqlangan-saqlanmaganiga qaraydi. FVD FID ning video uchun moslashgan shakli sifatida qaraladi va vaqt ichidagi uyg‘unlikni ham hisobga oladi. TCM kadrlar orasidagi optik oqim nomuvofiqliklarini ushlab, flicker yoki titrash kabi muammolarni o‘lchaydi. Ko‘p modalli tomonda LSE-D/C lab harakati bilan nutq ovozi uyg‘unligini; MOS esa inson baholovchilari sezadigan realizm darajasini ifodalaydi.
Tadqiqotning ma’lumot to‘plamlari bo‘limi ham deepfake sohasi qanday kengayganini ko‘rsatadi. Dastlab UADFV va DF-TIMIT kabi kichik video ma’lumotlar to‘plamlari ishlatilgan. Keyinroq FaceForensics++, Celeb-DF, DFDC va WildDeepfake kabi kattaroq va murakkabroq ma’lumot to‘plamlari paydo bo‘lgan. Tasvir tomonida CelebA-HQ, FFHQ, PGGAN/StyleGAN to‘plamlari va Fake2M kabi diffusion davri ma’lumotlari ko‘ringan. Ko‘p modalli tomonda FakeAVCeleb, KoDF, LAV-DF, MADD, Codecfake va DDL kabi to‘plamlar ovoz–video deepfake, ko‘p tilli ovoz soxtaligi, lokal manipulyatsiya va nozik etiketlash ehtiyojlariga javob berishga uringan.
Bu ma’lumot to‘plamlarining har biri turli muammoni ko‘rinadigan qiladi. FaceForensics++ standart taqqoslash uchun kuchli, ammo yangi avlod juda real forgeries uchun cheklangan bo‘lishi mumkin. Celeb-DF yanada nafis soxtalikni sinaydi. DFDC sanoat miqyosidagi murakkab va realistik taqsimotni beradi. WildDeepfake internetda tarqaladigan gibrid kontentlarning qiyinligini aks ettiradi. LAV-DF videoning faqat qisqa bir qismi manipulyatsiya qilingan holatlarni baholashga xizmat qiladi. MADD va KoDF esa inglizcha markazli to‘plamlardan chiqib, ko‘p tilli va madaniyatlararo muammolarni kun tartibiga olib chiqadi.
Boshqaruv bo‘limi tadqiqotning texnik sharhdan tashqaridagi eng muhim qismidir. Mualliflar fikricha, deepfake bilan kurashish faqat yaxshiroq detektor yaratish bilan hal bo‘lmaydi. Chunki soxta kontent tarqalganidan keyin uni aniqlash ko‘pincha kechikkan himoyadir. Shu sababli tadqiqot generation-time watermarking, ya’ni yaratish vaqtida suv belgisi qo‘yish; content provenance, ya’ni kontent manbasi va ishlov berish tarixini tekshirish; blockchain-based evidence preservation, ya’ni blokcheyn asosidagi dalilni saqlash; va risk-tiered regulation, ya’ni xavf darajasiga asoslangan tartibga solish kabi vositalarni birgalikda ko‘rib chiqishni taklif qiladi.
Bu nuqtada Stable Signature, Tree-ring Watermarks va SynthID kabi usullar misol tariqasida keltiriladi. Stable Signature latent diffusion decoder ichiga o‘rganiladigan watermark qatlamini joylashtiradi. Tree-ring Watermarks boshlang‘ich shovqinning Fourier makoniga ko‘rinmas, ammo ajratib olinadigan belgi kodlaydi. SynthID esa yaratish jarayoniga statistik barmoq izi joylashtirib, inson ko‘zi sezmaydigan, lekin tekshiruvchi tizim o‘qiy oladigan signal hosil qilishga urinadi. Bu yondashuvlar soxta kontent tarqalgach uni ushlash o‘rniga, yaratish manbasida iz qoldirishni maqsad qiladi.
C2PA kabi kontent kelib chiqishi standartlari ham shu doirada muhimdir. Agar foto yoki videoning qaysi qurilma bilan olingani, qaysi dastur bilan ishlangani, ustida qanday o‘zgarishlar qilingani va zanjir qayerda uzilgani kriptografik tarzda tekshirilsa, aniqlash faqat “algoritm buni soxta deb topdi” darajasida qolmaydi. Kontentning hayot aylanishi bo‘ylab dalillar zanjiri qurilishi mumkin. Bu ayniqsa jurnalistika, huquq, sug‘urta, xavfsizlik, sud jarayonlari va ommaviy kommunikatsiya uchun muhimdir.
Tadqiqot texnologiya–huquq–axloq ramkasini EU AI Act, NIST AI Risk Management Framework, Xitoyning generativ sun’iy intellekt choralarі va UNESCO ning sun’iy intellekt axloqi tavsiyalari bilan bog‘laydi. Texnik vositalar tartibga soluvchi majburiyatlarni amaliy qiladi; tartibga soluvchi ramkalar esa texnik standartlarga yo‘nalish beradi; jamiyatning media savodxonligi bu signallarni odamlar tomonidan to‘g‘ri talqin qilishga yordam beradi. Demak, faqat watermark qo‘yish yetmaydi; odamlar va institutlar bu watermark nimani anglatishini, qaysi holatda ishonchli ekanini va qachon yetarli bo‘lmasligini ham bilishi kerak.
Tadqiqotning tarixiy ahamiyati deepfake tarixini oddiy “GAN keldi, autoencoder keldi, diffusion keldi” ketma-ketligidan chiqarib, aniqlash ishoralarining siljishi orqali qayta talqin qilishidadir. Bu adabiyotni dinamikroq tushunishga yordam beradi. Chunki sohani haqiqatan o‘zgartirayotgan narsa faqat yangi model arxitekturalari emas, balki eski himoya ishoralarining qulashі va yangi himoya qatlamlariga o‘tishdir.
Bugungi kun uchun ahamiyati ijtimoiy tarmoqlarda, moliya sektorida, siyosiy kommunikatsiyada va raqamli identifikatsiyani tekshirishda deepfake xavfining tez sur’atlarda o‘sishidir. Bir kompaniya rahbarining ovozi klonlanishi mumkin, bir siyosatchining soxta videosi inqiroz paytida tarqalishi mumkin, bir odamning shaxsiy tasviri to‘qib chiqarilishi mumkin, bir yangilik manbasining ishonchliligi yemirilishi mumkin. Aniqlash tizimlari faqat laboratoriya yutug‘i bilan emas, balki real dunyo taqsimotida, siqilgan va qayta yuklangan kontentlarda, turli tillarda, turli yuz guruhlarida va yangi yaratish modellarida sinovdan o‘tkazilishi kerak.
Kelajak nuqtayi nazaridan tadqiqot aniqlashning asta-sekin post-hoc klassifikatsiyadan manbada tekshirishga o‘tishini taxmin qiladi. Ya’ni kelajakda asosiy himoya faqat “bu video soxtami?” savoliga javob beradigan detektorlar bo‘lmasligi mumkin. Buning o‘rniga kontent yaratilgan zahoti watermarklanadi, kelib chiqish ma’lumoti kriptografik tarzda bog‘lanadi, platformalar buni tasdiqlaydi, shubhali kontentlar ko‘p modalli tizimlar bilan tekshiriladi va kerak bo‘lsa sud dalillari zanjiri tuziladi. Bu taxmin tadqiqotning eng strategik xabarlaridan biridir.
Tadqiqotning kuchli tomoni yaratish, aniqlash, ma’lumotlar to‘plami, metrikalar va boshqaruvni yagona ramkada birlashtirishidir. U faqat texnik model ro‘yxati bermaydi; har bir yaratish paradigmasi qaysi aniqlash ishorasini zaiflashtirishini va himoya qanday yangi ishoralarga ko‘chishini tushuntiradi. Shuningdek, rasmlar va jadvallar bu dalilni qo‘llab-quvvatlaydi: 1-rasm yaratish va aniqlash evolyutsiyasini vaqt chizig‘i bilan ko‘rsatadi; 2-rasm PRISMA tanlov jarayonini tushuntiradi; 2-jadval uch siklda qaysi yaratish yo‘li qaysi izlarni qoldirishini va qaysi aniqlash usullari bunga javob berishini jamlaydi; 8-jadval baholash matritsasini, 9-jadval esa texnik va boshqaruv javoblarini birlashtiradi.
Cheklovlari ham ehtiyotkorlik bilan qayd etilishi kerak. Tadqiqot hakamlik bahosidan o‘tmagan preprintdir. U yangi eksperimental natija bermaydi; mavjud adabiyotni sintez qiladi. Meta-analitik ta’sir kattaligini hisoblamaydi, chunki ma’lumotlar to‘plamlari va protokollar juda heterogen. Ayrim ishlash ko‘rsatkichlari original nashrlarning o‘z protokollaridan olingan bo‘lib, turli tadqiqotlar orasida mutlaq taqqoslash har doim ham xavfsiz emas. Bundan tashqari, MLLM asosidagi aniqlash kabi yo‘nalishlarda dalillar hali erta bosqichda; tadqiqot ham bu tizimlar hozircha real vaqt moderatsiya uchun maxsus detektorlarning o‘rnini bosadigan darajada yetuk emasligini ehtiyotkorlik bilan ta’kidlaydi.
Tadqiqot aytayotgani shuki: deepfake yaratish va aniqlash birgalikda evolyutsiya qiladi; har bir yangi yaratish paradigmasi eski aniqlash izlarini zaiflashtiradi, aniqlash usullari esa yuqoriroq semantik, fizik, ko‘p modalli va manbada tekshirish yo‘nalishlariga o‘tadi. Tadqiqot aytmayotgani esa shuki: har bir deepfake albatta aniqlanadi, watermark barcha muammoni hal qiladi, MLLM tizimlari bugundan ishonchli detektor hisoblanadi yoki bitta metrik deepfake xavfsizligini o‘lchash uchun yetarlidir. Aksincha, tadqiqot sohaning ko‘p qatlamli, dinamik va doim yangilanib turadigan himoya arxitekturasini talab qilishini ta’kidlaydi.
Tadqiqot usuli va natijalari
Bu ish tajribaviy model yaratish tadqiqoti emas, sistematik sharh xarakteridagi adabiyot sintezidir. Tadqiqotchilar deepfake yaratish, aniqlash, ma’lumotlar to‘plamlari, baholash metrikalari va boshqaruv adabiyotini 2014–2025 oralig‘ida ko‘rib chiqib, natijalarni “adversarial evolution” ramkasida qayta tartiblagan.
Tadqiqotda qo‘llangan manba qidirish usuli:
| Usul elementi | Tadqiqotdagi yondashuv | Ma’nosi |
| Qamrov davri | 2014-yil 1-yanvar — 2025-yil 31-dekabr. | GAN paydo bo‘lishidan diffusion va katta video yaratish modellari davrigacha kuzatilgan. |
| Ma’lumot bazalari | IEEE Xplore, ACM Digital Library, Web of Science, arXiv. | Ham hakamli nashrlar, ham sohada ta’sirli yuqori iqtibosli preprintlar tekshirilgan. |
| Qidiruv guruhlari | Yaratish, aniqlash va modalitet atamalari. | Deepfake yaratish, sud-tahliliy aniqlash, tasvir, video, audio va ko‘p modallik birgalikda qamrab olingan. |
| Tanlash yondashuvi | PRISMA ga moslashtirilgan sistematik tanlov protokoli. | Adabiyot tanlovining kuzatiladigan va takrorlanadigan bo‘lishi maqsad qilingan. |
| Sintez usuli | Mavzuli tahlil. | Ishlar yaratish paradigmasi, aniqlash paradigmasi va nashr yiliga ko‘ra tasniflangan. |
PRISMA tanlov jarayoni:
| Bosqich | Soni | Tushuntirish |
| Dastlab topilgan yozuv | 1.486 | IEEE Xplore, ACM Digital Library, Web of Science va arXiv orqali olingan. |
| Takror yozuvlar chiqarib tashlandi | 312 | Ma’lumot bazalari orasidagi kesishmalar tozalangan. |
| Sarlavha/annotatsiya ko‘rigi | 1.174 | Qolgan yozuvlar mavzu muvofiqligi bo‘yicha baholangan. |
| Mavzudan tashqari chiqarilgan yozuvlar | 627 | Umumiy generativ modellashtirish yoki deepfake bo‘lmagan sud tahlili ishlar olib tashlangan. |
| To‘liq matn bahosi | 547 | Muvofiqlik mezonlariga ko‘ra to‘liq matnlar ko‘rib chiqilgan. |
| Sifatli sintezga kiritilgan ish | 211 | 83 yaratish, 75 aniqlash, 31 ma’lumot to‘plami/baholash, 22 boshqaruv/axloq/siyosat ishidir. |
Ishlar tasniflangan asosiy o‘qlar:
- Yaratish paradigmasi: GAN asosidagi usullar, autoencoder asosidagi usullar, diffusion asosidagi usullar, ko‘p modalli/gibrid usullar.
- Aniqlash paradigmasi: fizik artefaktlar, chuqur tasvirlanishlar, mustahkamlikni oshiruvchi mexanizmlar, ko‘p modalli muvofiqlik tekshiruvlari, faol himoya usullari.
- Vaqt o‘qi: ishlar uchta ustma-ust adversarial siklga bog‘langan.
Uchta adversarial aniqlash sikli:
| Sikl | Davr | Yaratish tomoni | Aniqlash ishorasi | Siklni zaiflashtirgan rivojlanish |
| Chastota ishoralari davri | 2014–2019 | GAN, StyleGAN, cGAN, CycleGAN kabi modellar. | Chastota anomaliyalari, checkerboard izlari, PRNU nomuvofiqligi, bosh pozasi muvofiqsizligi. | Alias-free arxitekturalar va autoencoder yuz almashtirish tizimlari bu izlarni zaiflashtirgan. |
| Qo‘shilish chegarasi va chuqur tasvirlanish davri | 2018–2023 | DeepFaceLab, FaceSwap, FOMM kabi yuz almashtirish/reenactment tizimlari. | Yuz qo‘shilish chegaralari, silliq yuz teksturasi, rPPG va nafas kabi biokimyoviy buzilishlar. | Diffusion denoising jarayonlari va fizik muvofiqligi yuqori video modellar bu izlarni kamaytirgan. |
| Semantik va fizik muvofiqlik davri | 2022–2025 | Stable Diffusion, DiT, DreamBooth, Sora kabi tizimlar. | Diffusion qayta qurish xatosi, ovoz–tasvir biomexanik nomuvofiqligi, fizik qonun buzilishlari, manbani tekshirish. | Keyingi himoya markazi manbada watermark va provenance tekshiruvi bo‘lishi kutilmoqda. |
Deepfake yaratish paradigmalarini taqqoslash:
| Paradigma | Asosiy tamoyil | Kuchli tomoni | Zaif tomoni | Tipik qo‘llanish |
| GAN | Yaratuvchi va ajratuvchi tarmoq o‘rtasidagi adversarial taqsimot moslashtirish. | Tez chiqarish, keskin tafsilotlar, latent fazoni boshqarish. | Chastota izlari, mode collapse, video kadrlarida identifikatsiya siljishi. | Real vaqt yuz sintezi va yuz almashtirish. |
| Autoencoder | Encoder–decoder qayta qurish. | Barqarorroq o‘qitish, yuz almashtirishning amaliyligi, shaxsga mos pipeline. | Yuqori chastotali tafsilot yo‘qotilishi, mumdek silliq yuzasi, cheklangan umumlashuv. | DeepFaceLab va FaceSwap turidagi identifikatsiya almashinuvi. |
| Diffusion | Shovqindan ma’lumotga tomon iterativ denoising. | Fotorealizm, matn/tasvir shartli boshqaruvi, tabiiy tasvir statistikalariga yaqinlashish. | Sekin namuna olish, yuqori hisoblash xarajati, identifikatsiya–xususiyat entanglement muammosi. | Yuqori sifatli tasvir/video yaratish va shaxsiylashtirilgan sintez. |
| Ko‘p modalli tizimlar | Ovoz, tasvir, matn va vaqt oqimini birgalikda uyg‘unlashtirish. | Gapiruvchi raqamli inson, ovoz–lab sinxroni, hissiy va semantik boshqaruv. | Uzoq videoda identifikatsiya siljishi, hissiy nomuvofiqlik, real vaqt va xavfsizlik qiyinchiligi. | Raqamli inson, dublaj tuzatish, gapiruvchi avatar, ijtimoiy muhandislik xavfi. |
Diffusion modelida tadqiqotda keltirilgan asosiy o‘qitish munosabatlari:
\[ \mathbb{E}[-\log p_{\theta}(x_0)] \leq \mathbb{E}_{q}\left[-\log p(x_T)-\sum_{t\geq 1}\log\frac{p_{\theta}(x_{t-1}|x_t)}{q(x_t|x_{t-1})}\right] \]
Bu formula diffusion modelining ehtimollik o‘qitish ramkasini ko‘rsatadi. Model ma’lumot taqsimotining ehtimolini bevosita hisoblash o‘rniga, teskari denoising jarayonini o‘rganib ma’lumotga yaqinlashadi. Bu yerda x0 toza ma’lumot namunasi, xT to‘liq shovqinli namuna, q oldinga shovqinlash jarayoni, pθ o‘rganilgan teskari jarayon va θ model parametrlaridir.
\[ L_{simple}(\theta)=\mathbb{E}_{t,x_0,\epsilon}\left[\left\|\epsilon-\epsilon_{\theta}\left(\sqrt{\bar{\alpha}_t}x_0+\sqrt{1-\bar{\alpha}_t}\epsilon,t\right)\right\|^2\right] \]
Bu formula diffusion modelining amalda shovqin bashorati bilan o‘qitilishini ko‘rsatadi. ε haqiqiy shovqinni, εθ model bashorat qilgan shovqinni, \bar{α}t shovqin jadvali koeffitsientini, t esa denoising bosqichini ifodalaydi. Modelning vazifasi shovqinli ma’lumotdagi shovqinni to‘g‘ri bashorat qilib, teskari yo‘nalishda realistik namuna yaratishdir.
Chastotaga asoslangan aniqlashda ishlatilgan asosiy munosabat:
\[ P(r)=\frac{1}{2\pi}\int_{0}^{2\pi}|F(r\cos\theta,r\sin\theta)|\,d\theta \]
Bu formula tasvirning chastota maydonidagi radial energiya profilini chiqaradi. F tasvirning chastota tasvirini, r radius/chastota darajasini, θ burchak yo‘nalishini, P(r) esa yo‘nalishlardan mustaqil o‘rtacha chastota energiyasini ifodalaydi. GAN tasvirlarida muayyan chastota cho‘qqilari tabiiy tasvirlardan farq qilishi mumkinligi uchun bu profil soxtalikni aniqlashda ishlatiladi.
Tadqiqot taklif qilgan uch o‘qli baholash matritsasi:
| O‘q | Metrikalar | Nimani o‘lchaydi? |
| Aniqlash samaradorligi | AUC, EER, IoU, ACC. | Tizimning haqiqiy va soxta kontentni ajratish hamda soxta hududni lokalizatsiya qilish qobiliyatini o‘lchaydi. |
| Yaratish sifati | FID, Id-Acc, FVD, TCM, IS, LPIPS, CLIP Score, NIQE. | Yaratilgan kontentning realizmi, identifikatsiya saqlanishi, video tutarliligi va matn bilan mosligini o‘lchaydi. |
| Ko‘p modalli muvofiqlik | LSE-D/C, MOS. | Ovoz–lab sinxroni, inson idrokidagi realizm va ko‘p modalli uyg‘unlikni o‘lchaydi. |
Asosiy ma’lumot to‘plami oilalari:
| Ma’lumot to‘plami guruhi | Misollar | Tadqiqotdagi roli |
| Tasvir ma’lumot to‘plamlari | CelebA-HQ, FFHQ, PGGAN/StyleGAN to‘plamlari, iFakeFaceDB, Fake2M. | Statik yuz yaratish, GAN fingerprint, diffusion tasvir aniqlash va soxta tasvir sifati uchun ishlatiladi. |
| Video ma’lumot to‘plamlari | UADFV, DF-TIMIT, FaceForensics++, Celeb-DF, DFDC, WildDeepfake, FFIW-10K, DFDC-Medical. | Yuz almashtirish, ijtimoiy tarmoq sharoitlari, siqish, real muhit taqsimoti va sohaga xos soxtalik uchun ishlatiladi. |
| Ko‘p modalli ma’lumot to‘plamlari | FakeAVCeleb, KoDF, LAV-DF, MADD, Codecfake, DDL. | Ovoz–video deepfake, ko‘p tilli ovoz soxtaligi, lokal manipulyatsiya va nozik darajadagi etiketlash uchun ishlatiladi. |
Sharh aniqlagan asosiy texnik natijalar:
- Deepfake yaratish va aniqlash sohasi bir-biridan mustaqil ikki chiziq emas, balki o‘zaro evolyutsiyalanuvchi hujum–himoya tizimidir.
- GAN davridagi chastota izlari alias-free arxitekturalar va yangi yaratish usullari bilan kamroq ishonchli bo‘lib qolgan.
- Autoencoder va yuz almashtirish tizimlari yuz qo‘shilish chegaralari va biokimyoviy signal buzilishlari kabi yangi aniqlash ishoralarini keltirib chiqargan.
- Diffusion modellari tabiiy tasvir statistikalariga ko‘proq yaqinlashgani uchun chastota va piksel asosidagi detektorlarning kuchini kamaytirgan.
- Ko‘p modalli deepfake aniqlash uchun faqat tasvir emas; ovoz, lab harakati, hissiyot, prosodiya, nafas, biomexanik harakat va semantik kontekst birgalikda baholanishi kerak.
- MLLM asosidagi aniqlash tizimlari tushuntirish bera oladi; ammo hozircha real vaqt moderatsiya va yuqori ishonchlilik uchun yetarlicha yetuk emas.
- Manbada watermark va provenance tekshiruvi kelajakda post-hoc aniqlash usullarini to‘ldiradigan asosiy himoya chizig‘i bo‘lishi mumkin.
Tadqiqotning boshqaruv bo‘yicha tavsiyalari:
| Muammo | Texnik javob | Boshqaruv javobi |
| Detektorlarning yangi ma’lumot maydonlarida muvaffaqiyatsizligi | Causal reasoning, domain adaptation, self-blended training, doimiy yangilanadigan benchmarklar. | Platforma va tartibga soluvchilar uchun davriy baholash va hayotiy sikl risk boshqaruvi. |
| Ko‘p modalli soxtalikning kengayishi | Ovoz–tasvir sinxroni, hissiy muvofiqlik, biomexanik va fizik nazorat. | Ko‘p modalli etiketlash standartlari va platforma mas’uliyati. |
| Faqat “soxta/haqiqiy” qarorining yetarli emasligi | Nozik darajadagi lokalizatsiya, model fingerprint, manba atributiyasi. | Sud dalillari zanjiri, blokcheyn asosidagi yozuv va kriptografik kontent kelib chiqishi. |
| Turli til va madaniyatlarda adolatsiz aniqlash samaradorligi | Ko‘p tilli, ko‘p madaniyatli va turli yuz taqsimotlarini qamrab olgan ma’lumotlar to‘plamlari. | Adolat, diskriminatsiya va global standart uyg‘unligi yo‘naltirilgan audit. |
| Soxta kontent tarqalgach uni ushlash qiyinligi | Stable Signature, Tree-ring Watermarks, SynthID, C2PA provenance. | Yaratish vaqtida belgilash, manbani tekshirish va xavfga asoslangan tartibga solish. |
Tadqiqotning ochiq cheklovlari:
- Tadqiqot hakamlik bahosidan o‘tmagan preprintdir.
- Yangi eksperimental model yoki yangi ma’lumotlar to‘plami yaratmaydi.
- Meta-tahlil o‘tkazilmagan; chunki adabiyotdagi ma’lumot to‘plami, protokol va hisobot usullari juda heterogendir.
- Keltirilgan samaradorlik qiymatlari original ishlarning o‘z sharoitlariga bog‘liq; mutlaq taqqoslashda ehtiyot bo‘lish kerak.
- MLLM asosidagi aniqlash hali kichik va kuratorlangan kichik to‘plamlarda baholangan bo‘lishi mumkin; real dunyo miqyosidagi taqqoslashlar yetishmaydi.
- Fizik va semantik muvofiqlik uchun standartlashgan metrikalar hali yetarlicha pishmagan.
- Watermark va provenance yechimlari kuchli bo‘lsa ham, qarshi-sudiy o‘chirish, qayta kodlash va platformalararo moslik muammolari saqlanib qolmoqda.
Umumiy xulosa: Tadqiqotga ko‘ra deepfake bilan kurashish bitta detektor yoki bitta qonun bilan hal bo‘ladigan muammo emas. Yaratish modellari, aniqlash tizimlari, ma’lumot to‘plamlari, baholash metrikalari, watermark/provenance standartlari, platforma mas’uliyati, huquq va jamoatchilik xabardorligi birgalikda rivojlanishi kerak. Deepfake sohasidagi haqiqiy himoya tasvirdagi yakka xato izlarini ushlashdan, kontentning yaratilishidan tarqalishigacha va sudiy tekshiruvigacha cho‘zilgan yaxlit ishonch arxitekturasiga qarab siljimoqda.
Manba va usul izohi
Ushbu maqola Mengze Li, Gang Liang, Kui Zhao, Liangyin Chen, Junren Chen va Jiayi Liu tomonidan tayyorlangan “Adversarial Evolution of Deepfake Generation and Detection: A Systematic Review of Paradigms, Evaluation, and Governance” nomli ishga asoslanib tayyorlangan.
Manba matn deepfake yaratish va aniqlash adabiyotini 2014–2025 oralig‘ida sistematik tarzda ko‘rib chiqqan bir preprint sistematik sharh maqolasi hisoblanadi. Matnda aniq “This preprint research paper has not been peer reviewed” jumlasi borligi uchun ish hakamlikdan o‘tmagan deb baholanishi kerak. Shu sababli natijalar hakamli jurnalda yakunlangan qat’iy xulosalar sifatida emas, balki keng qamrovli, ammo baholashga ochiq adabiyot sintezi sifatida o‘qilishi lozim.
Tayyorlash jarayonida ishning asosiy tushunchalari, uchta adversarial sikl modeli, GAN–autoencoder–diffusion yaratish yo‘nalishlari, ko‘p modalli deepfake rivoji, aniqlash usullari, diffusion formulalari, chastota tahlili formulasi, ma’lumotlar to‘plami va metrika taqqoslari, uch o‘qli baholash matritsasi, texnologiya–huquq–axloq boshqaruv ramkasi, manbada watermark va C2PA provenance takliflari saqlab qolindi. PDF da bo‘lmagan yangi eksperimental natija, aniq muvaffaqiyat kafolati, barcha deepfake lar ishonchli aniqlanishi mumkinligi haqidagi da’vo yoki yagona metrik yetarli degan fikr qo‘shilmadi.
Tadqiqot ayniqsa shunday jihatdan ehtiyotkor o‘qilishi kerak: deepfake aniqlash sohasidagi e’lon qilingan muvaffaqiyat darajalari ko‘pincha ma’lumotlar to‘plamiga, siqish darajasiga, yuzni qirqish usuliga, o‘qitish/sinov ajratilishiga, yaratish modeliga va real dunyo taqsimotiga bog‘liq. Shuning uchun bir detektorning ma’lum benchmarkda yuqori natija ko‘rsatishi ijtimoiy tarmoqlarda aylanayotgan har bir yangi avlod deepfake kontentini ham xuddi shunday ushlaydi degani emas.
Tadqiqotning eng qimmatli hissasi deepfake mavzusini faqat “soxta kontent qanday aniqlanadi?” darajasida emas, balki yaratish–aniqlash–baholash–boshqaruv zanjiri sifatida ko‘rib chiqishidadir. Bu zanjir kelajakda ishonchli raqamli media ekotizimini qurish uchun texnik detektorlar bilan birga manbani tekshirish, kontent kelib chiqishi ma’lumoti, huquqiy majburiyatlar, axloqiy standartlar va jamoatchilik xabardorligi ham zarurligini ko‘rsatadi.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan