

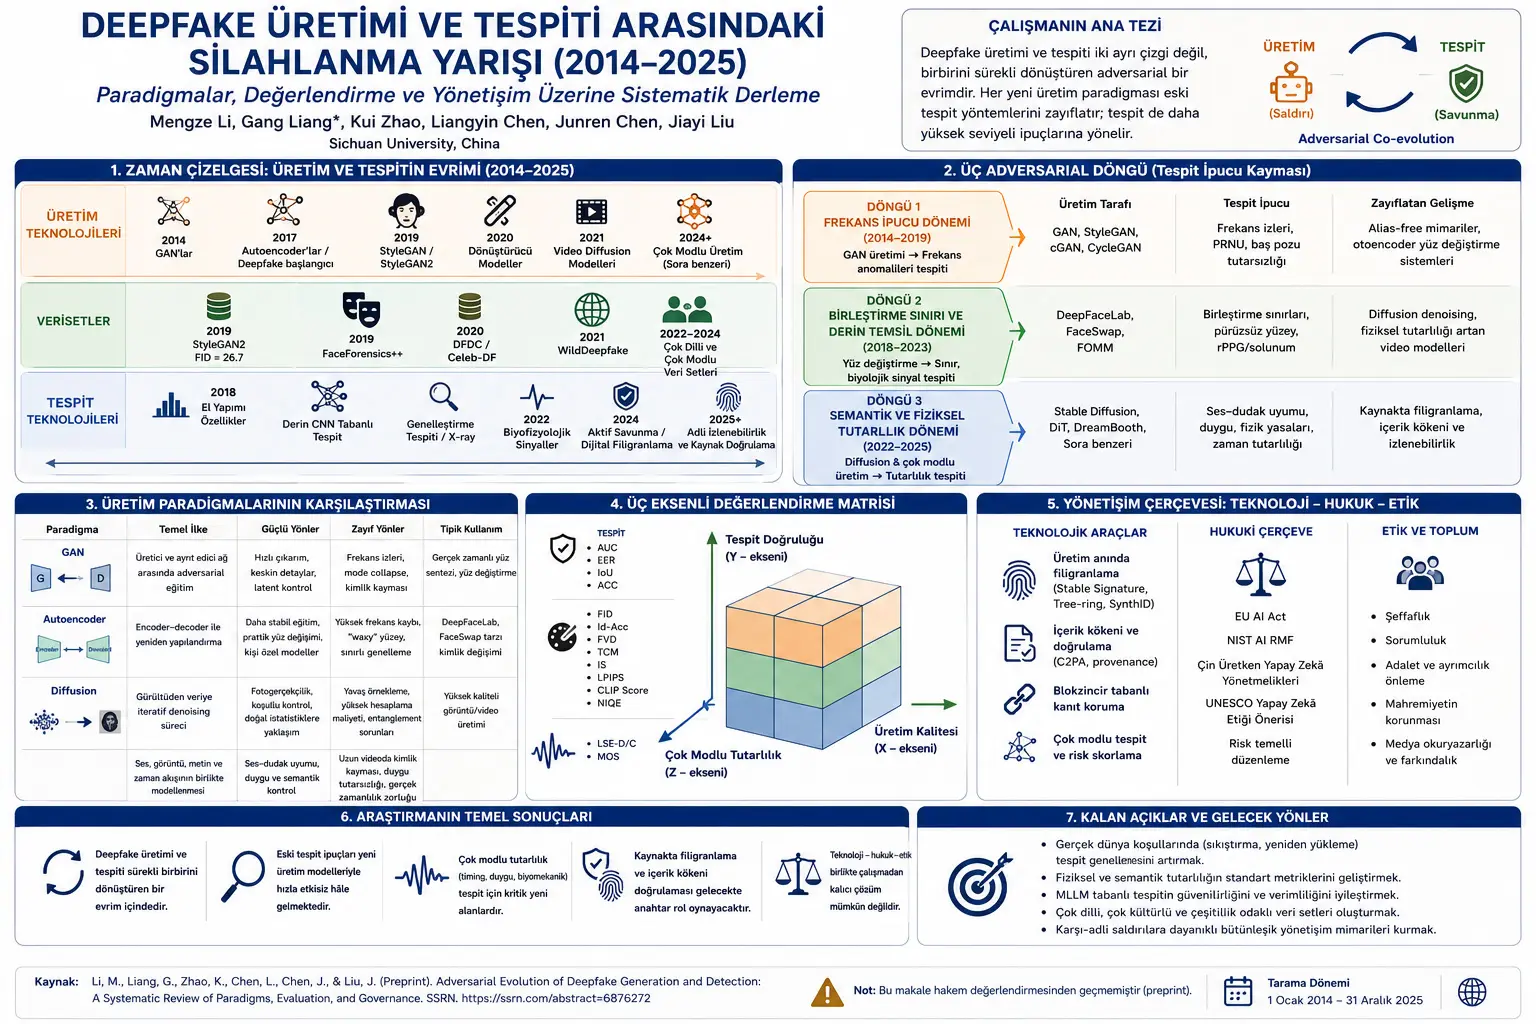
Deepfake texnologiyası dərin neyron şəbəkələrindən istifadə etməklə görüntü, video, səs və ya bunların birləşməsini gerçəkmiş kimi yaratmaq və ya dəyişdirmək prosesidir. İlk baxışda bu mövzu yalnız saxta üz videoları və ya sosial mediada yayılan manipulyasiya edilmiş məzmun kimi görünə bilər. Lakin tədqiqat deepfake texnologiyasının artıq şəxsi məxfiliyin pozulmasından çox daha geniş risk sahəsinə keçdiyini vurğulayır. Saxta siyasi çıxışlar, səs klonlaması vasitəsilə maliyyə fırıldaqları, ictimai etimadın zədələnməsi, milli təhlükəsizlik riski, medianın doğrulanması problemi və rəqəmsal sübutların etibarlılığı bu sahənin birbaşa təsirləri arasındadır.
Məqalənin çıxış nöqtəsi deepfake istehsal keyfiyyəti ilə deepfake aşkarlama sistemlərinin ümumiləşdirmə qabiliyyəti arasındakı struktur balanssızlıqdır. İstehsalçı modellər getdikcə daha realistik, daha idarəolunan və daha çoxmodallı hala gəldikcə, aşkarlama sistemləri çox vaxt əvvəlki verilənlər dəstlərində öyrənilmiş izlərdən asılı qalır. Tədqiqatda verilən Deepfake-Eval-2024 nəticəsi bu boşluğu konkretləşdirir: Əvvəlki verilənlər dəstlərində öyrədilmiş müasir aşkarlama sistemləri 2024-cü ildə sosial mediadan toplanmış real mühit deepfake məzmunlarında qiymətləndirildikdə AUC göstəricilərində təxminən %50 azalma nümayiş etdirir. Ən böyük azalmanın diffusion əsaslı nümunələrdə görülməsi köhnə aşkarlama ipuclarının yeni istehsal modellərinə qarşı niyə zəiflədiyini aydın göstərir.
Burada mühüm anlayış AUC, yəni Area Under the ROC Curve göstəricisidir. AUC aşkarlama modelinin real və saxta nümunələri fərqli qərar hədlərində ayırd etmə qabiliyyətini ölçür. Sadə dillə desək, modelin “realdır, yoxsa saxtadır?” fərqində nə qədər etibarlı sıralama etdiyinə baxır. AUC-nin azalması modelin əvvəlki mühitdə öyrəndiyi ipuclarının yeni mühitdə əvvəlki qədər faydalı olmadığını bildirir. Tədqiqatın vurğuladığı problem də məhz budur: Laboratoriya verilənlər dəstində yüksək görünən uğur sosial mediada sıxılmış, kəsilmiş, yenidən yüklənmiş və müxtəlif istehsal modelləri ilə yaradılmış məzmunlarda eyni səviyyədə qorunmur.
Məqalə mövcud icmalların çoxunun istehsal və aşkarlamanı paralel, lakin ayrı xətlər kimi izah etdiyini bildirir. Halbuki müəlliflərə görə sahənin əsas dinamikası dövri xarakter daşıyır. Aşkarlama sistemi bir iz tapır; istehsalçı model bu izi azaldır; aşkarlama sistemi daha yüksək səviyyəli bir izə keçir. Buna görə tədqiqatın təklif etdiyi əsas çərçivə adversarial evolution, yəni hücum və müdafiə tərəflərinin bir-birini davamlı şəkildə yenidən formalaşdırdığı təkamüldür.
Tədqiqatın ən mühüm anlayışlarından biri cue drift, yəni aşkarlama ipucunun sürüşməsidir. Deepfake aşkarlanmasında “cue” saxta məzmunu tutmağa kömək edən iz və ya əlamətdir. Bu iz bəzən tezlik sahəsində süni naxış, bəzən üz kənarındakı birləşmə sərhədi, bəzən qan axını siqnalındakı pozuntu, bəzən səs ilə dodaq hərəkəti arasındakı uyğunsuzluq, bəzən də videodakı fiziki hərəkətin real dünyaya uyğun gəlməməsi ola bilər. “Cue drift” isə istehsal modelləri inkişaf etdikcə bu izlərin yer dəyişməsidir. Aşkarlama sistemi müəyyən dövrün izinə həddindən artıq güvənsə, yeni nəsil istehsal modeli həmin izi aradan qaldırdıqda müdafiə zəifləyir.
Tədqiqat 2014–2025 dövrünü üç əsas aşkarlama ipucu dövrünə ayırır. Birinci dövr frequency-cue era, yəni tezlik ipucu dövrüdür. Bu mərhələ təxminən 2014–2019 aralığını əhatə edir və xüsusilə GAN əsaslı istehsalla əlaqəlidir. GAN modelləri görüntü yaradarkən müəyyən upsampling əməliyyatlarından istifadə edir. Bu əməliyyatlar təbii kamerayla çəkilmiş görüntülərdə olmayan tezlik izləri yarada bilər. Aşkarlama sistemləri həmin dövrdə görüntünün tezlik sahəsinə baxaraq saxta məzmunları tutmağa çalışırdı.
Bu dövrdə mühüm texniki izlərdən biri transposed convolution əməliyyatlarının yaratdığı periodik naxışlardır. Tədqiqatda GAN görüntülərində təxminən (±0.25, ±0.25) tezlik bölgələrində enerji sıxlaşması kimi izlərdən bəhs edilir. Bu izlər normal görüntülərdə kamera və sensor mənşəli təbii nümunələrdən fərqlənir. Gündəlik bir bənzətmə ilə, həqiqi parçadakı toxuma təbii nizamsızlıqlar daşıdığı halda, maşından çıxan saxta naxışın təkrarlanan mikroskopik xətlər buraxmasına bənzədilə bilər. Tezlik əsaslı aşkarlama sistemləri görüntünün səthinə deyil, bu görünməyən naxışlarına baxır.
Tədqiqatda tezlik analizi ilə bağlı əsas əməliyyat aşağıdakı əlaqə ilə izah olunur:
\[ P(r)=\frac{1}{2\pi}\int_{0}^{2\pi}|F(r\cos\theta,r\sin\theta)|\,d\theta \]
Bu formulda F(u,v) görüntünün tezlik sahəsindəki təmsilidir. r tezlik sahəsində radiusu, θ isə bucaq istiqamətini göstərir. P(r) müxtəlif istiqamətlərdəki tezlik enerjisinin ortalamasını götürərək birölçülü radial enerji profili yaradır. Formulun mənası budur: Görüntünün hansı tezlik bölgələrində qeyri-təbii enerji yığılması daşıdığı ölçülür. GAN əsaslı saxta görüntülərdə müəyyən tezlik bölgələrində süni piklər yaranırsa, bundan aşkarlama üçün istifadə edilə bilər.
Lakin bu ilk dövrün də sərhədi vardır. GAN arxitekturaları inkişaf etdikcə, xüsusilə StyleGAN3 kimi alias-free yanaşmalar bu tezlik izlərini azaltmağa başlayır. Bundan əlavə, üz dəyişdirmə sistemləri yalnız sıfırdan üz yaratmaq əvəzinə bir üzü başqa videonun üzərinə yerləşdirməyə yönəlir. Beləliklə, saxtakarlığın izi tezlik sahəsindən üzün birləşdirildiyi sərhədlərə və zaman içindəki bioloji uyğunluğa keçir.
İkinci dövr blending-boundary and deep-representation era, yəni birləşdirmə sərhədi və dərin təmsil dövrüdür. Bu dövr təxminən 2018–2023 aralığında ön plana çıxır. DeepFaceLab, FaceSwap və First Order Motion Model kimi autoencoder və ya üz reenactment sistemləri bu kontekstdə mühümdür. Bu sistemlər çox vaxt bir şəxsin kimliyini başqa üz hərəkəti və ya hədəf video üzərinə yerləşdirir. Bu əməliyyatda üz bölgəsi hədəf kadra kompozit edildiyi üçün üzün ətrafında və ya teksturasında sərhəd, maskalama, rəng uyğunsuzluğu, hamarlaşdırma və biofizioloji pozuntu kimi izlər qala bilər.
Autoencoder əsaslı üz dəyişdirmə sistemləri adətən shared encoder–independent decoder məntiqi ilə işləyir. Ortaq encoder üzün poza, ifadə və işıqlandırma kimi kimlikdən kənar struktur xüsusiyyətlərini çıxarır; fərqli decoder-lər isə mənbə və hədəf kimliklərə aid üz teksturasını yenidən yaradır. Tədqiqatdakı Şəkil 7 bu mexanizmi sxematik göstərir. Bu yanaşma GAN təlimində bəzi qeyri-sabitlikləri azaldır və üz dəyişdirməni praktikləşdirir. Lakin piksel səviyyəli rekonstruksiya itkisi üz teksturasının yüksək tezlikli detallarını yumşalda bilər. Bu isə tədqiqatda “waxy”, yəni mumabənzər hamar görünüş kimi qiymətləndirilir.
Bu dövrün aşkarlama üsulları saxta üzün hədəf kadra yapışdırıldığı sərhədləri tapmağa çalışır. Face X-ray və Self-Blended Images kimi üsullar üz dəyişdirmə prosesinin buraxdığı qarışma sərhədini birbaşa modelləşdirməyə çalışır. Bundan əlavə, FakeCatcher kimi yanaşmalar üz dərisindəki çox kiçik rəng dəyişikliklərindən ürək döyüntüsü ilə əlaqəli remote photoplethysmography, yəni uzaqdan fotopletismoqrafiya/rPPG siqnallarını çıxarmağa çalışır. Həqiqi insan üzündə qan axını və dəri rəngi zaman ərzində bioloji ritm daşıyır; saxta videoda isə bu ritm çox vaxt düzgün qorunmur.
Üçüncü dövr semantic and physical-consistency era, yəni semantik və fiziki tutarlılıq dövrüdür. Bu mərhələ 2022–2025 aralığında diffusion modelləri, iri video istehsal sistemləri və çoxmodallı istehsal yanaşmaları ilə əlaqəlidir. Stable Diffusion, DiT, DreamBooth və Sora kimi sistemlər görüntü və video istehsalında daha yüksək realizm, şərtli nəzarət və fiziki görünüş tutarlılığı təqdim edir. Bu mərhələdə tezlik izləri, sadə birləşmə sərhədləri və ya tək piksel anomaliyaları aşkarlama üçün kifayət etməyə bilər.
Diffusion modelləri əsasən səs-küydən verilənə doğru irəliləyən denoising prosesindən istifadə edir. Model əvvəlcə verilənə addım-addım səs-küy əlavə etmə prosesini öyrənir, sonra bu prosesi tərsinə çevirərək səs-küydən mənalı görüntü və ya video yaradır. Tədqiqatda diffusion modellərinin ehtimal əsaslı təməli aşağıdakı ELBO əlaqəsi ilə verilir:
\[ \mathbb{E}[-\log p_{\theta}(x_0)] \leq \mathbb{E}_{q}\left[-\log p(x_T)-\sum_{t\geq 1}\log\frac{p_{\theta}(x_{t-1}|x_t)}{q(x_t|x_{t-1})}\right] \]
Bu formulda x0 real/verilən nümunəsini, xT səs-küylü son vəziyyəti, q(xt|xt-1) irəli istiqamətdə səs-küy əlavə etmə prosesini, pθ(xt-1|xt) isə modelin əks istiqamətdə səs-küyü aradan qaldıraraq verilənə yaxınlaşma prosesini ifadə edir. θ model parametrlərini göstərir. Bu ifadə texniki olaraq modelin həqiqi verilən paylanmasını birbaşa hesablamaq əvəzinə, onu aşağı sərhəd üzərindən öyrənməyə çalışdığını göstərir.
Praktik təlimdə bu mürəkkəb məqsəd Ho və həmkarlarının göstərdiyi kimi səs-küy proqnozlaşdırma itkisinə endirilə bilər. Tədqiqatda verilən sadələşdirilmiş loss formulu belədir:
\[ L_{simple}(\theta)=\mathbb{E}_{t,x_0,\epsilon}\left[\left\|\epsilon-\epsilon_{\theta}\left(\sqrt{\bar{\alpha}_t}x_0+\sqrt{1-\bar{\alpha}_t}\epsilon,t\right)\right\|^2\right] \]
Bu formulda ε verilənə əlavə edilən həqiqi səs-küyü, εθ modelin proqnozlaşdırdığı səs-küyü, t zaman/səs-küy addımını, \bar{α}t səs-küy cədvəlini müəyyən edən əmsalı, x0 isə başlanğıcdakı təmiz verilən nümunəsini göstərir. Formulun gündəlik mənası budur: Model “bu görüntüyə hansı səs-küy əlavə edilmişdi?” sualını öyrənir. Bu suala kifayət qədər yaxşı cavab verdikdə əks istiqamətdə gedərək səs-küydən realistik görüntü yarada bilir.
Diffusion modellərinin aşkarlama baxımından ən çətin tərəfi istehsal prosesinin təbii görüntü statistikalarına çox yaxınlaşa bilməsidir. GAN dövründə tezlik sahəsində görünən süni piklər diffusion çıxışlarında daha zəif ola bilər. Video istehsalında Sora kimi modellər də məkan-zaman parçalaması və DiT arxitekturaları ilə hərəkəti, işığı, fiziki qarşılıqlı təsiri və uzunməsafəli asılılıqları daha yaxşı modelləşdirə bilər. Bu, aşkarlamanı piksel səviyyəsindən daha yüksək səviyyəyə qaldırır: Video fizika qanunlarına uyğundurmu? Səs ilə dodaq hərəkəti həqiqətən uyğun gəlirmi? Danışıqda emosional ton üz ifadəsi ilə tutarlıdırmı? Kölgə, işıq mənbəyi və hərəkət istiqaməti eyni fiziki dünyaya aiddirmi?
Məqalə çoxmodallı deepfake sahəsini ayrıca kritik hədd kimi qiymətləndirir. İlk dövrlərdə saxtakarlıq daha çox üz görüntüsü ilə məhdudlaşırdı. Sonra dodaq hərəkəti və səs uyğunlaşdırma sistemləri inkişaf etdi. Wav2Lip kimi sistemlər danışıq səsinə uyğun dodaq hərəkəti yaratmaqda çox gücləndi. Daha sonra NeRF əsaslı və diffusion əsaslı danışan baş modelləri üz ifadəsini, ağız hərəkətini, səs tonunu və kimlik tutarlılığını birlikdə yaratmağa başladı. Bu gün və yaxın gələcəkdə risk yalnız saxta video deyil; saxta səs, saxta üz, saxta bədən dili, saxta emosiya və kontekstə uyğun saxta danışıq ssenarisinin birlikdə yaradılmasıdır.
Buna görə tədqiqat çoxmodallı saxtakarlığı üç səviyyədə müzakirə edir: temporal synchronisation, yəni zaman sinxronluğu; emotional consistency, yəni emosional tutarlılıq; biomechanical consistency, yəni biomexaniki tutarlılıq. Həqiqi danışıqda dodaq hərəkəti, səsin başlanğıcı, nəfəs ritmi, üz əzələləri, göz hərəkəti, intonasiya və emosional intensivlik bir-birindən müstəqil deyil. Saxta məzmun çox realistik görünsə belə, bu qatların birində kiçik uyğunsuzluqlar buraxa bilər.
Məsələn, səs ilə dodaq hərəkəti arasında 40–60 millisaniyəni aşan gecikmələr insan qavrayışında qeyri-təbii hiss yarada bilər. Eyni şəkildə şəxsin üzü gülür kimi görünərkən səs tonu ağlama və ya qorxu daşıyırsa, emosional uyğunsuzluq yaranır. Müxtəlif dillərdə dodağın bağlanması və tələffüz formaları da əhəmiyyətlidir. Tədqiqatda Çin və İngilis dilləri kimi dillərdə fonem–viseme əlaqələrinin deepfake aşkarlanmasında ipucu ola biləcəyi göstərilir. Bu, aşkarlama sistemlərinin yalnız görüntü emalından deyil, dil, fonetika, bədən hərəkəti və insan biologiyası biliklərindən də istifadə etməli olduğunu bildirir.
Tədqiqatın metod bölməsi bu icmalın təsadüfi seçilmiş mənbələrdən ibarət olmadığını göstərir. Tədqiqatçılar PRISMA-ya uyğunlaşdırılmış protokoldan istifadə etmişdir. IEEE Xplore, ACM Digital Library, Web of Science və arXiv axtarılmışdır. Axtarış terminləri üç qrupda qurulmuşdur: istehsal terminləri, aşkarlama terminləri və modallıq terminləri. İstehsal tərəfində deepfake, face forgery, face swap, talking head, diffusion model, GAN və autoencoder; aşkarlama tərəfində detection, forensics, authentication və anti-spoofing; modallıq tərəfində image, video, audio və multimodal kimi terminlərdən istifadə olunmuşdur.
PRISMA axını tədqiqatın Şəkil 2-sində göstərilir. İlk axtarışda 1.486 qeyd tapılmışdır. 312 təkrar çıxarıldıqdan sonra 1.174 qeyd başlıq və xülasə səviyyəsində nəzərdən keçirilmişdir. 627 qeyd mövzudan kənar olduğu üçün çıxarılmışdır. Qalan 547 tam mətn uyğunluq baxımından qiymətləndirilmiş və 211 tədqiqat keyfiyyət sintezinə daxil edilmişdir. Bu 211 tədqiqatın 83-ü istehsal üsulları, 75-i aşkarlama üsulları, 31-i verilənlər dəstləri və qiymətləndirmə, 22-si isə idarəetmə, etika və siyasət üzrə təsnif edilmişdir. Bu rəqəmlər tədqiqatın yalnız texniki modelləri deyil, verilənlər dəsti və idarəetmə ölçüsünü də əhatə etdiyini göstərir.
Tədqiqat meta-analiz aparmadığını xüsusi olaraq bildirir. Səbəb daxil edilən tədqiqatların verilənlər dəstləri, qiymətləndirmə protokolları, sıxılma səviyyələri, üz kəsmə üsulları, nümunələmə sürətləri və hesabat formaları baxımından heterogen olmasıdır. Yəni tədqiqatçılar vahid ortaq effekt ölçüsü hesablamağa çalışmamışdır. Bunun əvəzinə tematik sintez aparmış və hər dövrdə üç suala baxmışdır: hansı istehsal texnikaları dominantdır, bu texnikalar hansı izləri buraxır və ya hansı köhnə izləri zəiflədir, aşkarlama üsulları bu izləri necə əməliyyatlaşdırır.
Tədqiqatın istehsal texnologiyalarının müqayisəsi də mühümdür. GAN, autoencoder və diffusion modelləri ardıcıl şəkildə bir-birini tam əvəz edən nəsillər deyil; əksər dövrlərdə paralel işləyiblər. GAN-lar sürətli inference və kəskin vizual detallarda üstün ola bilər, lakin tezlik izləri və təlim qeyri-sabitliyi kimi problemlər daşıyır. Autoencoder sistemləri daha stabil və praktik üz dəyişdirmə təmin edir, lakin üz teksturasında hamarlaşma və yüksək tezlikli detal itkisi yarada bilər. Diffusion modelləri yüksək realizm və şərtli nəzarət təqdim edir, lakin iterativ nümunələmə səbəbindən daha yavaş və hesablama baxımından daha bahalı ola bilər. Çoxmodallı sistemlər isə səs, görüntü, mətn və zaman tutarlılığını birlikdə hədəfləyir; lakin uzun videolarda kimlik sürüşməsi, emosional uyğunsuzluq və real vaxt istehsalı çətinlikləri hələ də əhəmiyyətlidir.
Məqalənin qiymətləndirmə metrikləri bölməsi deepfake tədqiqatlarında tək uğur rəqəminin kifayət etmədiyini göstərir. Aşkarlama tərəfində AUC, EER, IoU və ACC kimi ölçülər istifadə olunur. İstehsal keyfiyyəti tərəfində FID, Id-Acc, FVD, TCM, IS, LPIPS, CLIP Score və NIQE kimi metriklər yer alır. Çoxmodallı tutarlılıq tərəfində LSE-D/C və MOS önə çıxır. Tədqiqatın təklif etdiyi üçoxlu matrisa bu metrikləri vahid çərçivədə birləşdirir.
EER, yəni Equal Error Rate, yanlış qəbul və yanlış rədd göstəricilərinin bərabərləşdiyi həddi göstərir. Məhkəmə və biometrik kontekstlərdə əhəmiyyətlidir; çünki saxta məzmunu real qəbul etmək ilə real məzmunu saxta hesab etmək fərqli, lakin ciddi risklər daşıyır. IoU, yəni Intersection over Union, saxta olduğu düşünülən sahə ilə həqiqi etiketli saxta sahənin nə qədər üst-üstə düşdüyünü ölçür. Bu, yalnız “video saxtadır” deməkdən əlavə “saxtakarlıq görüntünün hansı hissəsindədir?” sualına cavab vermək üçün zəruridir.
İstehsal keyfiyyəti metriklərində FID yaradılmış görüntülərin real görüntü paylanmasına nə qədər bənzədiyini ölçür. Id-Acc üz dəyişdirmə kimi tətbiqlərdə hədəf kimliyin qorunub-qorunmadığına baxır. FVD FID-in video qarşılığı kimi düşünülə bilər və zaman tutarlılığını nəzərə alır. TCM kadrlar arasındakı optik axın uyğunsuzluqlarını tutaraq flicker və ya titrəmə kimi problemləri ölçür. Çoxmodallı tərəfdə LSE-D/C dodaq hərəkəti ilə danışıq səsi arasındakı uyğunluğu, MOS isə insan qiymətləndiricilərinin qavradığı realizm balını ifadə edir.
Tədqiqatın verilənlər dəstləri bölməsi də deepfake sahəsinin necə genişləndiyini göstərir. İlk dövrlərdə UADFV və DF-TIMIT kimi kiçik video verilənlər dəstlərindən istifadə olunurdu. Sonra FaceForensics++, Celeb-DF, DFDC və WildDeepfake kimi daha iri və çətin verilənlər dəstləri yarandı. Görüntü tərəfində CelebA-HQ, FFHQ, PGGAN/StyleGAN dəstləri və Fake2M kimi diffusion dövrü verilənlər dəstləri önə çıxır. Çoxmodallı tərəfdə FakeAVCeleb, KoDF, LAV-DF, MADD, Codecfake və DDL kimi verilənlər dəstləri səs–video, çoxdilli danışıq, lokal manipulyasiya və incə etiketləmə kimi ehtiyaclara cavab verməyə çalışır.
Bu verilənlər dəstlərinin hər biri fərqli problemi görünən edir. FaceForensics++ standart müqayisə üçün güclüdür, lakin yeni nəsil yüksək realistik saxtakarlıqlar üçün məhdud qala bilər. Celeb-DF daha incə saxtakarlıqları sınaqdan keçirir. DFDC sənaye miqyasında mürəkkəb və realistik paylanma təqdim edir. WildDeepfake internetdə dolaşan heterogen məzmunun çətinliyini əks etdirir. LAV-DF videonun yalnız qısa bir hissəsinin manipulyasiya edildiyi ssenariləri qiymətləndirməyə imkan verir. MADD və KoDF İngilis dili mərkəzli verilənlər dəstlərindən kənara çıxaraq çoxdilli və mədəniyyətlərarası problemləri gündəmə gətirir.
İdarəetmə bölməsi tədqiqatın texniki icmalı aşan ən mühüm tərəflərindən biridir. Müəlliflərə görə deepfake ilə mübarizə yalnız daha yaxşı detektor yaratmaqla həll edilə bilməz. Çünki saxta məzmun yayıldıqdan sonra onu aşkar etmək çox vaxt gecikmiş müdafiədir. Buna görə tədqiqat generation-time watermarking, yəni istehsal zamanı filigran yerləşdirmə; content provenance, yəni məzmunun mənbəyini və emal tarixçəsini doğrulama; blockchain-based evidence preservation, yəni blokçeyn əsaslı sübut mühafizəsi; və risk-tiered regulation, yəni risk səviyyəli tənzimləmə kimi vasitələrin birlikdə düşünülməsini təklif edir.
Bu kontekstdə Stable Signature, Tree-ring Watermarks və SynthID kimi üsullar nümunə göstərilir. Stable Signature latent diffusion decoder daxilində öyrənilə bilən watermark qatı yerləşdirir. Tree-ring Watermarks başlanğıc səs-küyün Fourier məkanına görünməyən, lakin çıxarıla bilən işarə kodlayır. SynthID isə istehsal prosesinə statistik barmaq izi yerləşdirərək insan gözünün fərq etmədiyi, lakin doğrulama sisteminin oxuya bildiyi siqnallar yaratmağa çalışır. Bu yanaşmalar saxta məzmun yayıldıqdan sonra onu tutmağa çalışmaq əvəzinə istehsal mənbəyində iz buraxmağı hədəfləyir.
C2PA kimi məzmun mənşə standartları da bu çərçivədə əhəmiyyətlidir. Foto və ya videonun hansı cihazla çəkildiyi, hansı proqramla emal edildiyi, üzərində hansı dəyişikliklərin aparıldığı və zəncirin harada pozulduğu kriptoqrafik şəkildə doğrulana bilsə, aşkarlama yalnız “alqoritm bunu saxta hesab etdi” səviyyəsində qalmaz. Məzmunun bütün həyat dövrü boyunca sübut zənciri qurula bilər. Bu xüsusilə jurnalistika, hüquq, sığorta, təhlükəsizlik, məhkəmə prosesləri və ictimai kommunikasiya üçün əhəmiyyətlidir.
Tədqiqat texnologiya–hüquq–etika çərçivəsini EU AI Act, NIST AI Risk Management Framework, Çinin generativ süni intellekt tədbirləri və UNESCO-nun süni intellekt etikası tövsiyələri ilə əlaqələndirir. Texniki vasitələr tənzimləyici öhdəlikləri tətbiq edilə bilən hala gətirir; tənzimləyici çərçivələr texniki standartlara istiqamət verir; cəmiyyətin media savadlılığı isə bu siqnalların insanlar tərəfindən düzgün şərh olunmasını təmin edir. Yəni yalnız filigran yerləşdirmək kifayət deyil; insanlar və qurumlar bu filigranın nə demək olduğunu, hansı halda etibarlı olduğunu və nə zaman kifayət etməyə biləcəyini də bilməlidirlər.
Tədqiqatın tarixi baxımdan əhəmiyyəti deepfake tarixini sadə “GAN gəldi, autoencoder gəldi, diffusion gəldi” ardıcıllığından çıxarıb aşkarlama ipuclarının sürüşməsi üzərindən yenidən şərh etməsidir. Bu, ədəbiyyatı daha dinamik anlamağa imkan verir. Çünki sahəni həqiqətən dəyişdirən yalnız yeni model arxitekturaları deyil, köhnə müdafiə ipuclarının çökməsi və yeni müdafiə səviyyələrinə keçilməsidir.
Bu gün baxımından əhəmiyyəti sosial mediada, maliyyə sektorunda, siyasi kommunikasiyada və rəqəmsal kimlik doğrulamada deepfake riskinin sürətlə artmasıdır. Şirkət rəhbərinin səsi klonlana bilər, siyasətçinin saxta videosu böhran zamanı yayıla bilər, şəxsin məxfi görüntüsü uydurula bilər, xəbər mənbəyinin etibarlılığı sarsıla bilər. Aşkarlama sistemləri yalnız laboratoriya uğuru ilə deyil, real dünya paylanmasında, sıxılmış və yenidən yüklənmiş məzmunlarda, fərqli dillərdə, fərqli üz qruplarında və yeni istehsal modellərində sınaqdan keçirilməlidir.
Gələcək baxımından tədqiqat aşkarlamanın getdikcə post-hoc təsnifatdan mənbədə doğrulamaya keçəcəyini proqnozlaşdırır. Yəni gələcəkdə əsas müdafiə yalnız “bu video saxtadırmı?” sualına baxan detektorlar olmaya bilər. Bunun əvəzinə məzmun yaradıldığı anda filigranlanacaq, mənşə məlumatı kriptoqrafik bağlanacaq, platformalar bunu doğrulayacaq, şübhəli məzmunlar çoxmodallı aşkarlama sistemləri ilə araşdırılacaq və lazım olduqda məhkəmə sübut zənciri qurulacaq. Bu proqnoz tədqiqatın ən strateji mesajlarından biridir.
Tədqiqatın güclü tərəfi istehsal, aşkarlama, verilənlər dəsti, metrik və idarəetməni vahid çərçivədə birləşdirməsidir. Yalnız texniki model siyahısı təqdim etmir; hər istehsal paradiqmasının hansı aşkarlama ipucunu zəiflətdiyini və müdafiənin yeni ipuclarına necə keçdiyini izah edir. Bundan əlavə, şəkillər və cədvəllər bu arqumenti dəstəkləyir: Şəkil 1 istehsal və aşkarlamanın təkamülünü zaman xəttində göstərir; Şəkil 2 PRISMA seçim prosesini izah edir; Cədvəl 2 üç dövrdə hansı istehsal marşrutunun hansı izləri buraxdığını və hansı aşkarlama üsullarının buna cavab verdiyini xülasə edir; Cədvəl 8 qiymətləndirmə matrisini, Cədvəl 9 isə texniki və idarəetmə cavablarını birləşdirir.
Məhdudiyyətlər də diqqətlə qeyd olunmalıdır. Tədqiqat resenziyadan keçməmiş preprintdir. Yeni eksperimental nəticə yaratmır; mövcud ədəbiyyatı sintez edir. Meta-analitik effekt ölçüsü hesablamır, çünki verilənlər dəstləri və protokollar çox heterogendir. Bəzi performans göstəriciləri orijinal nəşrlərin öz protokollarından götürülür və fərqli tədqiqatlar arasında mütləq müqayisə aparmaq həmişə təhlükəsiz deyil. Bundan əlavə, MLLM əsaslı aşkarlama kimi sahələrdə sübut hələ ilkin mərhələdədir; tədqiqat da ehtiyatlı davranaraq bu sistemlərin hələ real vaxt moderasiyası üçün xüsusi detektorların yerini alacaq yetkinlikdə olmadığını bildirir.
Tədqiqatın dediyi budur: Deepfake istehsalı və aşkarlanması birlikdə təkamül edir; hər yeni istehsal paradiqması köhnə aşkarlama ipuclarını zəiflədir, aşkarlama üsulları isə daha yüksək səviyyəli semantik, fiziki, çoxmodallı və mənbədə doğrulama üsullarına yönəlir. Tədqiqatın demədiyi isə budur: Hər deepfake mütləq aşkarlana bilər, watermark bütün problemi həll edir, MLLM sistemləri bu gündən etibarlı detektor kimi istifadə oluna bilər və ya tək bir metrik deepfake təhlükəsizliyini ölçməyə kifayətdir. Əksinə, tədqiqat sahənin çoxqatlı, dinamik və davamlı yenilənən müdafiə arxitekturası tələb etdiyini vurğulayır.
Tədqiqatın Metodu və Nəticələri
Bu tədqiqat eksperimental model inkişaf etdirmə işi deyil, sistematik icmal xarakterli ədəbiyyat sintezidir. Tədqiqatçılar deepfake istehsalı, aşkarlanması, verilənlər dəstləri, qiymətləndirmə metrikləri və idarəetmə ədəbiyyatını 2014–2025 aralığında araşdırmış və nəticələri “adversarial evolution” çərçivəsində yenidən təşkil etmişdir.
Tədqiqatın mənbə axtarış üsulu:
| Metod Ünsürü | Tədqiqatda İstifadə Olunan Yanaşma | Mənası |
| Axtarış dövrü | 1 yanvar 2014 – 31 dekabr 2025. | GAN-ın yaranmasından diffusion və iri video istehsal modellərinə qədər sahə izlənmişdir. |
| Verilənlər bazaları | IEEE Xplore, ACM Digital Library, Web of Science, arXiv. | Həm resenziyalı nəşrlər, həm də sahədə təsirli yüksək istinadlı preprintlər araşdırılmışdır. |
| Axtarış qrupları | İstehsal, aşkarlama və modallıq terminləri. | Deepfake istehsalı, məhkəmə-tibbi aşkarlama, görüntü, video, səs və çoxmodallı məzmun birlikdə əhatə olunmuşdur. |
| Seçim yanaşması | PRISMA-ya uyğunlaşdırılmış sistematik seçim protokolu. | Ədəbiyyat seçiminin izlənə bilən və təkrarlana bilən olması hədəflənmişdir. |
| Sintez üsulu | Tematik təhlil. | Tədqiqatlar istehsal paradiqması, aşkarlama paradiqması və nəşr ilinə görə təsnif edilmişdir. |
PRISMA seçim prosesi:
| Mərhələ | Sayı | İzah |
| İlk tapılan qeyd | 1.486 | IEEE Xplore, ACM Digital Library, Web of Science və arXiv üzərindən əldə edilmişdir. |
| Çıxarılan təkrar qeyd | 312 | Verilənlər bazaları arasındakı üst-üstə düşmələr təmizlənmişdir. |
| Başlıq/xülasə yoxlanışı | 1.174 | Qalan qeydlər mövzu uyğunluğu baxımından qiymətləndirilmişdir. |
| Mövzudan kənar çıxarılan qeyd | 627 | Ümumi generativ modelləşdirmə və ya deepfake xarici məhkəmə-tibbi analiz işləri çıxarılmışdır. |
| Tam mətn qiymətləndirilməsi | 547 | Uyğunluq meyarlarına görə tam mətnlər araşdırılmışdır. |
| Keyfiyyət sintezinə daxil edilən tədqiqat | 211 | 83 istehsal, 75 aşkarlama, 31 verilənlər dəsti/metrik, 22 idarəetmə/etika/siyasət işidir. |
Tədqiqatların təsnif edildiyi əsas oxlar:
- İstehsal paradiqması: GAN əsaslı üsullar, autoencoder əsaslı üsullar, diffusion əsaslı üsullar, çoxmodallı/hibrid üsullar.
- Aşkarlama paradiqması: fiziki artefaktlar, dərin təmsillər, dayanıqlılığı artıran mexanizmlər, çoxmodallı tutarlılıq yoxlamaları, aktiv müdafiə üsulları.
- Zaman oxu: tədqiqatlar üç üst-üstə düşən adversarial dövrə bağlanmışdır.
Üç adversarial aşkarlama dövrü:
| Dövr | Müddət | İstehsal Tərəfi | Aşkarlama İpucu | Dövrü Zəiflədən İnkişaf |
| Tezlik ipucu dövrü | 2014–2019 | GAN, StyleGAN, cGAN, CycleGAN kimi modellər. | Tezlik anomaliyaları, checkerboard izləri, PRNU uyğunsuzluğu, baş pozası uyğunsuzluğu. | Alias-free arxitekturalar və autoencoder üz dəyişdirmə sistemləri bu izləri zəiflətmişdir. |
| Birləşdirmə sərhədi və dərin təmsil dövrü | 2018–2023 | DeepFaceLab, FaceSwap, FOMM kimi üz dəyişdirmə/reenactment sistemləri. | Üz qarışım sərhədləri, hamar üz teksturası, rPPG və tənəffüs kimi biofizioloji pozuntular. | Diffusion denoising prosesləri və fiziki tutarlılığı artan video modelləri bu izləri azaltmışdır. |
| Semantik və fiziki tutarlılıq dövrü | 2022–2025 | Stable Diffusion, DiT, DreamBooth, Sora kimi sistemlər. | Diffusion rekonstruksiya xətası, səs–görüntü biomexaniki uyğunsuzluğu, fizika qanunu pozuntuları, mənbə doğrulaması. | Növbəti müdafiə istiqamətinin mənbədə watermark və provenance doğrulaması olacağı proqnozlaşdırılır. |
Deepfake istehsal paradiqmalarının müqayisəsi:
| Paradiqma | Əsas Prinsip | Güclü Tərəf | Zəif Tərəf | Tipik İstifadə |
| GAN | İstehsalçı və ayırd edici şəbəkə arasında adversarial paylanma uyğunlaşdırması. | Sürətli inference, kəskin detallar, latent məkan manipulyasiyası. | Tezlik izləri, mode collapse, video kadrlarında kimlik sürüşməsi. | Real vaxt üz sintezi və üz dəyişdirmə. |
| Autoencoder | Encoder–decoder rekonstruksiyası. | Daha stabil təlim, üz dəyişdirmə praktikliyi, şəxsə xüsusi pipeline. | Yüksək tezlikli detal itkisi, mumabənzər hamar səth, məhdud ümumiləşdirmə. | DeepFaceLab və FaceSwap tipli kimlik dəyişdirmə. |
| Diffusion | Səs-küydən verilənə doğru iterativ denoising. | Fotorealizm, mətn/görüntü şərtli nəzarət, təbii görüntü statistikalarına yaxınlaşma. | Yavaş nümunələmə, yüksək hesablama xərci, kimlik–xüsusiyyət entanglement problemi. | Yüksək keyfiyyətli görüntü/video istehsalı və fərdiləşdirilmiş sintez. |
| Çoxmodallı sistemlər | Səs, görüntü, mətn və zaman axınının birlikdə uyğunlaşdırılması. | Danışan rəqəmsal insan, səs–dodaq sinxronizasiyası, emosiya və semantik nəzarət. | Uzun videoda kimlik sürüşməsi, emosiya uyğunsuzluğu, real vaxtlıq və təhlükəsizlik çətinliyi. | Rəqəmsal insan, dublyaj düzəlişi, danışan avatar, sosial mühəndislik riski. |
Diffusion modelində tədqiqatda verilən əsas təlim əlaqələri:
\[ \mathbb{E}[-\log p_{\theta}(x_0)] \leq \mathbb{E}_{q}\left[-\log p(x_T)-\sum_{t\geq 1}\log\frac{p_{\theta}(x_{t-1}|x_t)}{q(x_t|x_{t-1})}\right] \]
Bu formul diffusion modelinin ehtimal əsaslı təlim çərçivəsini göstərir. Model birbaşa verilən paylanmasının ehtimalını hesablamaq əvəzinə, əks denoising prosesini öyrənərək verilənə yaxınlaşır. Burada x0 təmiz verilən nümunəsi, xT tam səs-küylü nümunə, q irəli səs-küyləmə prosesi, pθ öyrənilən əks proses və θ model parametrləridir.
\[ L_{simple}(\theta)=\mathbb{E}_{t,x_0,\epsilon}\left[\left\|\epsilon-\epsilon_{\theta}\left(\sqrt{\bar{\alpha}_t}x_0+\sqrt{1-\bar{\alpha}_t}\epsilon,t\right)\right\|^2\right] \]
Bu formul diffusion modelinin praktikada səs-küy proqnozlaşdırması ilə öyrədilə bildiyini göstərir. ε həqiqi səs-küyü, εθ modelin proqnozlaşdırdığı səs-küyü, \bar{α}t səs-küy cədvəli əmsalını, t isə denoising addımını ifadə edir. Modelin vəzifəsi səs-küylü veriləndəki səs-küyü düzgün proqnozlaşdıraraq əks istiqamətdə realistik nümunə yaratmaqdır.
Tezlik əsaslı aşkarlamada istifadə olunan əsas əlaqə:
\[ P(r)=\frac{1}{2\pi}\int_{0}^{2\pi}|F(r\cos\theta,r\sin\theta)|\,d\theta \]
Bu formul görüntünün tezlik sahəsində radial enerji profilini çıxarır. F görüntünün tezlik təmsilini, r radius/tezlik səviyyəsini, θ bucaq istiqamətini, P(r) isə istiqamətlərdən asılı olmayan orta tezlik enerjisini ifadə edir. GAN görüntülərində müəyyən tezlik pikləri təbii görüntülərdən fərqlənə bildiyi üçün bu profil saxtakarlıq aşkarlanmasında istifadə edilə bilər.
Tədqiqatın təklif etdiyi üçoxlu qiymətləndirmə matrisi:
| Ox | Metriklər | Nəyi Ölçür? |
| Aşkarlama performansı | AUC, EER, IoU, ACC. | Sistemin real və saxta məzmunu ayırma və saxta bölgəni lokallaşdırma uğurunu ölçür. |
| İstehsal keyfiyyəti | FID, Id-Acc, FVD, TCM, IS, LPIPS, CLIP Score, NIQE. | Yaradılmış məzmunun realizmini, kimlik qorunmasını, video tutarlılığını və mətnlə uyğunluğunu ölçür. |
| Çoxmodallı tutarlılıq | LSE-D/C, MOS. | Səs–dodaq sinxronizasiyasını, insan qavrayışındakı realizmi və çoxmodallı uyğunluğu ölçür. |
Əsas verilənlər dəsti ailələri:
| Verilənlər Dəsti Qrupu | Nümunələr | Tədqiqatdakı Rolu |
| Görüntü verilənlər dəstləri | CelebA-HQ, FFHQ, PGGAN/StyleGAN dəstləri, iFakeFaceDB, Fake2M. | Statik üz istehsalı, GAN fingerprint, diffusion görüntü aşkarlanması və saxta görüntü keyfiyyəti üçün istifadə olunur. |
| Video verilənlər dəstləri | UADFV, DF-TIMIT, FaceForensics++, Celeb-DF, DFDC, WildDeepfake, FFIW-10K, DFDC-Medical. | Üz dəyişdirmə, sosial media şərtləri, sıxılma, real mühit paylanması və sahəyə xüsusi saxtakarlıq üçün istifadə olunur. |
| Çoxmodallı verilənlər dəstləri | FakeAVCeleb, KoDF, LAV-DF, MADD, Codecfake, DDL. | Səs–video deepfake, çoxdilli səs saxtakarlığı, lokal manipulyasiya və incə səviyyəli etiketləmə üçün istifadə olunur. |
İcmalın müəyyən etdiyi əsas texniki nəticələr:
- Deepfake istehsal və aşkarlama sahələri bir-birindən müstəqil iki xətt deyil, qarşılıqlı təkamül edən hücum–müdafiə sistemidir.
- GAN dövründəki tezlik izləri alias-free arxitekturalar və yeni istehsal üsulları ilə daha az etibarlı hala gəlmişdir.
- Autoencoder və üz dəyişdirmə sistemləri üz birləşmə sərhədləri və biofizioloji siqnal pozuntuları kimi yeni aşkarlama ipucları yaradıb.
- Diffusion modelləri təbii görüntü statistikalarına daha çox yaxınlaşdığı üçün tezlik və piksel əsaslı detektorların gücünü azaldıb.
- Çoxmodallı deepfake aşkarlanması üçün yalnız görüntü deyil, səs, dodaq hərəkəti, emosiya, prosodiya, nəfəs, biomexaniki hərəkət və semantik kontekst birlikdə qiymətləndirilməlidir.
- MLLM əsaslı aşkarlama sistemləri izah yarada bilər, lakin hələ real vaxt moderasiyası və yüksək etibarlılıq üçün kifayət qədər yetkin deyil.
- Mənbədə watermark və provenance doğrulaması gələcəkdə post-hoc aşkarlama üsullarını tamamlayan əsas müdafiə xətti ola bilər.
Tədqiqatın idarəetmə təklifləri:
| Problem | Texniki Cavab | İdarəetmə Cavabı |
| Detektorların yeni verilən sahələrində uğursuz olması | Causal reasoning, domain adaptation, self-blended training, davamlı yenilənən benchmarklar. | Platforma və tənzimləyicilərə dövri qiymətləndirmə və həyat dövrü risk idarəetməsi. |
| Çoxmodallı saxtakarlığın yayılması | Səs–görüntü sinxronizasiyası, emosional tutarlılıq, biomexaniki və fiziki yoxlama. | Çoxmodallı etiketləmə standartları və platforma məsuliyyətləri. |
| Yalnız “saxta/real” qərarının kifayət etməməsi | İncə səviyyəli lokallaşdırma, model fingerprint, mənbə atribusiyası. | Məhkəmə sübut zənciri, blokçeyn əsaslı qeyd və kriptoqrafik məzmun mənşəyi. |
| Fərqli dil və mədəniyyətlərdə ədalətsiz aşkarlama performansı | Çoxdilli, çoxmədəniyyətli və müxtəlif üz paylanmalarını əhatə edən verilənlər dəstləri. | Ədalət, diskriminasiya və qlobal standart uyğunluğu yönümlü audit. |
| Saxta məzmun yayıldıqdan sonra onu tutmağın çətin olması | Stable Signature, Tree-ring Watermarks, SynthID, C2PA provenance. | İstehsal anında etiketləmə, mənbə doğrulaması və risk əsaslı tənzimləmə. |
Tədqiqatın açıq məhdudiyyətləri:
- Tədqiqat resenziyadan keçməmiş preprintdir.
- Yeni eksperimental model və ya yeni verilənlər dəsti yaratmır.
- Meta-analiz aparılmayıb; çünki ədəbiyyatda verilənlər dəsti, protokol və hesabat formaları çox heterogendir.
- Verilən performans göstəriciləri orijinal nəşrlərin öz şərtlərinə bağlıdır; mütləq müqayisə apararkən ehtiyatlı olmaq lazımdır.
- MLLM əsaslı aşkarlama hələ kiçik və seçilmiş alt dəstlərdə qiymətləndirilmiş ola bilər; real dünya miqyaslı müqayisələr çatışmır.
- Fiziki və semantik tutarlılıq üçün standartlaşdırılmış metriklər hələ kifayət qədər yetkin deyil.
- Watermark və provenance həlləri güclü olsa da, qarşı-adli silmə, yenidən kodlama və platformalararası uyğunluq problemləri davam edir.
Ümumi nəticə: Tədqiqata görə deepfake ilə mübarizə tək bir detektor və ya tək bir qanunla həll edilə biləcək problem deyil. İstehsal modelləri, aşkarlama sistemləri, verilənlər dəstləri, qiymətləndirmə metrikləri, watermark/provenance standartları, platforma məsuliyyətləri, hüquq və ictimai məlumatlılıq birlikdə inkişaf etməlidir. Deepfake sahəsində real müdafiə görüntüdəki ayrı-ayrı xəta izlərini tutmaqdan, məzmunun yaradılmasından yayılmasına və məhkəmə-tibbi doğrulanmasına qədər uzanan bütöv etimad arxitekturasına doğru keçir.
Mənbə və Metod Qeydi
Bu məqalə Mengze Li, Gang Liang, Kui Zhao, Liangyin Chen, Junren Chen və Jiayi Liu tərəfindən hazırlanmış “Adversarial Evolution of Deepfake Generation and Detection: A Systematic Review of Paradigms, Evaluation, and Governance” başlıqlı tədqiqata əsaslanaraq hazırlanmışdır.
Mənbə mətn deepfake istehsalı və aşkarlanması ədəbiyyatını 2014–2025 aralığında sistematik şəkildə araşdıran preprint sistematik icmal məqaləsi xarakterlidir. Mətndə açıq şəkildə “This preprint research paper has not been peer reviewed” ifadəsi olduğuna görə tədqiqat resenziyadan keçməmişdir. Buna görə nəticələr resenziyalı jurnalda qəti şəkildə təsdiqlənmiş yekun nəticələr kimi deyil, geniş, lakin qiymətləndirməyə açıq ədəbiyyat sintezi kimi oxunmalıdır.
Tədqiqatın metodu PRISMA-ya uyğunlaşdırılmış sistematik ədəbiyyat axtarışına əsaslanır. IEEE Xplore, ACM Digital Library, Web of Science və arXiv verilənlər bazaları araşdırılmış; 1.486 qeyddən 211 tədqiqat keyfiyyət sintezinə daxil edilmişdir. Bu tədqiqatlar istehsal üsulları, aşkarlama üsulları, verilənlər dəstləri/qiymətləndirmə və idarəetmə/etika/siyasət başlıqları altında təsnif edilmişdir.
Bu məzmun hazırlanarkən tədqiqatın əsas anlayışları, üç adversarial dövr modeli, GAN–autoencoder–diffusion istehsal xətləri, çoxmodallı deepfake inkişafı, aşkarlama üsulları, diffusion formulları, tezlik analizi formulu, verilənlər dəsti və metrik müqayisələri, üçoxlu qiymətləndirmə matrisi, texnologiya–hüquq–etika idarəetmə çərçivəsi, mənbədə watermark və C2PA provenance təklifləri qorunmuşdur. PDF-də olmayan yeni eksperimental nəticə, qəti uğur zəmanəti, bütün deepfake-lərin etibarlı şəkildə aşkarlana biləcəyi iddiası və ya təkbaşına hüquqi/texniki həll təklifi əlavə edilməmişdir.
Tədqiqat xüsusilə bu baxımdan diqqətlə oxunmalıdır: Deepfake aşkarlama sahəsində yayımlanan uğur göstəriciləri çox vaxt verilənlər dəstinə, sıxılma səviyyəsinə, üz kəsmə üsuluna, təlim/test ayrımına, istehsal modelinə və real dünya paylanmasına bağlıdır. Buna görə detektorun müəyyən benchmarkda yüksək uğur göstərməsi sosial mediada dolaşan hər yeni nəsil deepfake məzmununu eyni uğurla tutacağı demək deyil.
Tədqiqatın ən dəyərli töhfəsi deepfake mövzusunu yalnız “saxta məzmun necə aşkarlanır?” səviyyəsində deyil, istehsal–aşkarlama–qiymətləndirmə–idarəetmə zənciri kimi nəzərdən keçirməsidir. Bu zəncir gələcəkdə etibarlı rəqəmsal media ekosistemi qurmaq üçün texniki detektorlar qədər mənbə doğrulaması, məzmun mənşə məlumatı, hüquqi öhdəliklər, etik standartlar və ictimai məlumatlılığın da zəruri olduğunu göstərir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib