

Deepfake teknolojisi, derin sinir ağları kullanarak görüntü, video, ses veya bunların birleşimini gerçekmiş gibi üretme veya değiştirme sürecidir. İlk bakışta bu konu yalnızca sahte yüz videoları veya sosyal medyada dolaşan manipüle edilmiş içerikler gibi görülebilir. Ancak çalışma, deepfake teknolojisinin artık kişisel mahremiyet ihlalinden çok daha geniş bir risk alanına taşındığını vurgular. Sahte siyasi konuşmalar, ses klonlama yoluyla finansal dolandırıcılık, kamu güveninin zedelenmesi, ulusal güvenlik riski, medya doğrulama sorunu ve dijital kanıt güvenilirliği bu alanın doğrudan etkileri arasındadır.
Makalenin çıkış noktası, deepfake üretim kalitesi ile deepfake tespit sistemlerinin genelleme yeteneği arasındaki yapısal dengesizliktir. Üretici modeller giderek daha gerçekçi, daha kontrol edilebilir ve daha çok modlu hâle gelirken, tespit sistemleri çoğu zaman önceki veri setlerinde öğrenilmiş izlere bağımlı kalmaktadır. Çalışmada aktarılan Deepfake-Eval-2024 bulgusu bu boşluğu somutlaştırır: Önceki veri setlerinde eğitilmiş modern tespit sistemleri, 2024 yılında sosyal medyadan toplanmış gerçek ortam deepfake içeriklerinde değerlendirildiğinde AUC değerlerinde yaklaşık %50 düşüş göstermektedir. En büyük düşüşün diffusion tabanlı örneklerde görülmesi, eski tespit ipuçlarının yeni üretim modellerine karşı neden zayıfladığını açıkça gösterir.
Burada önemli kavram AUC yani Area Under the ROC Curve değeridir. AUC, bir tespit modelinin gerçek ve sahte örnekleri farklı karar eşiklerinde ayırt etme kapasitesini ölçer. Basitçe, modelin “gerçek mi, sahte mi?” ayrımında ne kadar güvenilir sıralama yaptığına bakar. AUC’nin düşmesi, modelin önceki ortamda öğrendiği ipuçlarının yeni ortamda eskisi kadar işe yaramadığı anlamına gelir. Çalışmanın vurguladığı sorun tam olarak budur: Laboratuvar veri setinde yüksek görünen başarı, sosyal medyadaki sıkıştırılmış, kırpılmış, yeniden yüklenmiş, farklı üretim modelleriyle oluşturulmuş içeriklerde aynı ölçüde korunmamaktadır.
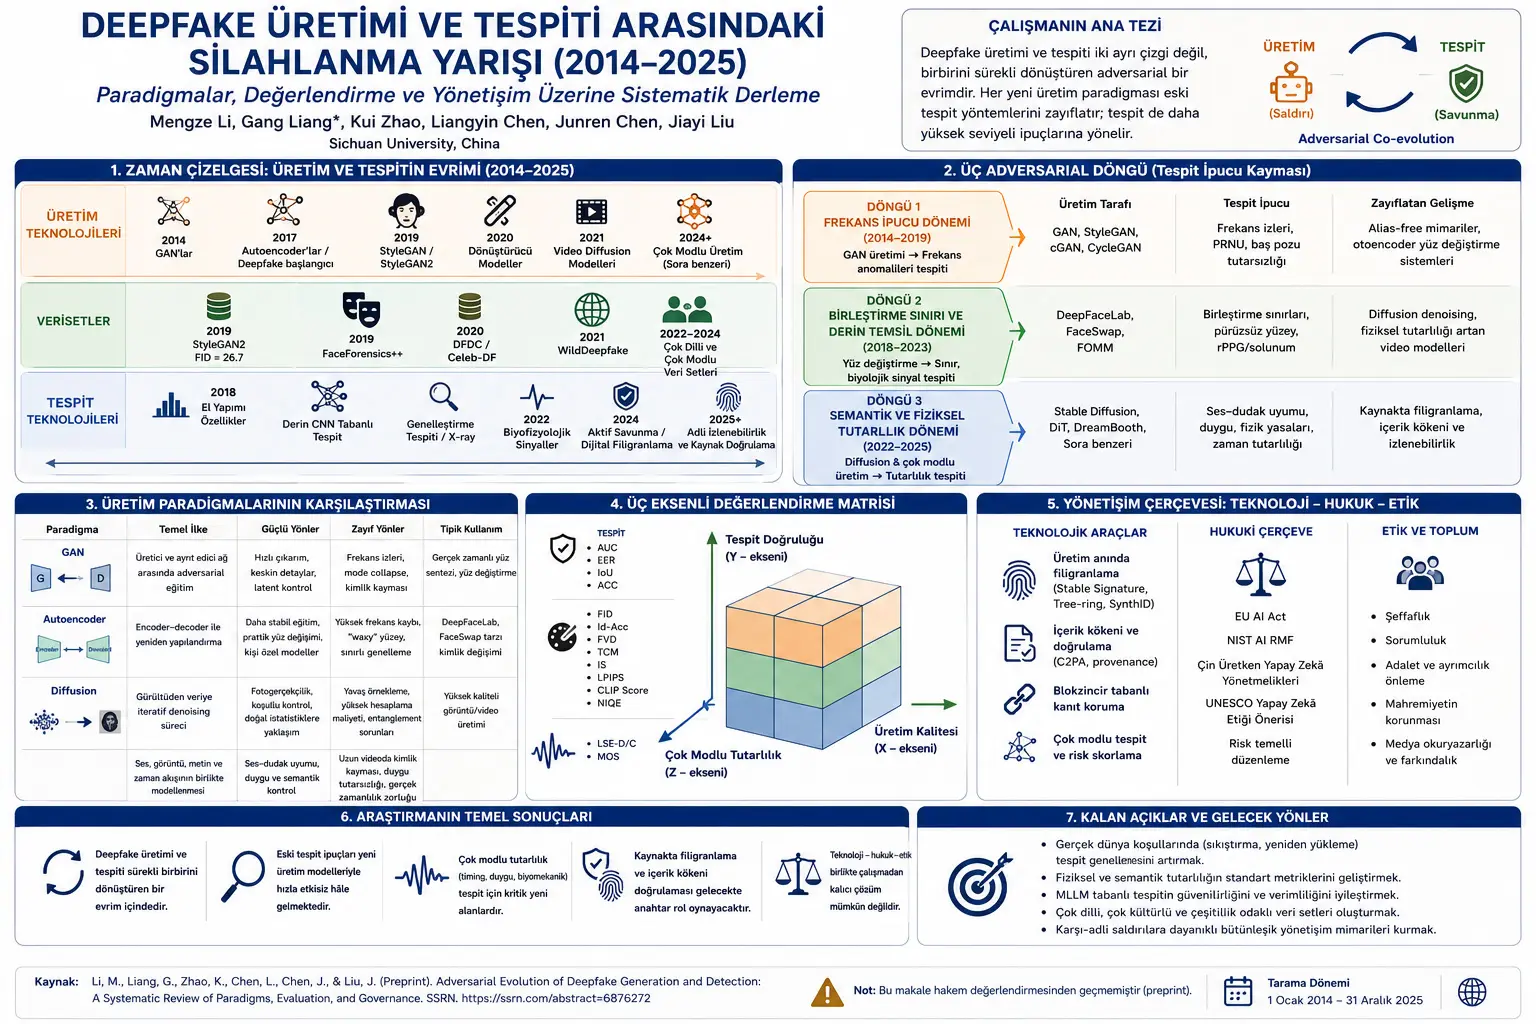
Makale, mevcut derlemelerin çoğunun üretim ve tespiti paralel ama ayrı çizgiler gibi anlattığını belirtir. Oysa yazarlara göre alanın asıl dinamiği döngüseldir. Tespit sistemi bir iz bulur; üretici model bu izi azaltır; tespit sistemi daha yüksek seviyeli bir ize geçer. Bu yüzden çalışmanın önerdiği ana çerçeve adversarial evolution, yani saldırgan ve savunmacı tarafın birbirini sürekli yeniden şekillendirdiği evrimdir.
Çalışmanın en önemli kavramlarından biri cue drift, yani tespit ipucu kaymasıdır. Deepfake tespitinde “cue”, sahte içeriği yakalamaya yarayan iz veya işarettir. Bu iz bazen frekans alanındaki yapay bir desen, bazen yüzün kenarındaki birleştirme sınırı, bazen kan akışı sinyalindeki bozulma, bazen ses ile dudak hareketi arasındaki uyumsuzluk, bazen de videodaki fiziksel hareketin gerçek dünyaya uymaması olabilir. “Cue drift” ise üretim modelleri geliştikçe bu izlerin yer değiştirmesidir. Tespit sistemi bir dönemin izine fazla güvenirse, yeni nesil üretim modeli o izi ortadan kaldırdığında savunma zayıflar.
Çalışma 2014–2025 dönemini üç ana tespit ipucu döngüsüne ayırır. Birinci döngü frequency-cue era, yani frekans ipucu dönemidir. Bu dönem yaklaşık 2014–2019 aralığını kapsar ve özellikle GAN tabanlı üretimle ilişkilidir. GAN modelleri, görüntü üretirken belirli upsampling işlemleri kullanır. Bu işlemler, doğal kamerayla çekilmiş görüntülerde bulunmayan frekans izleri oluşturabilir. Tespit sistemleri bu dönemde görüntünün frekans alanına bakarak sahte içerikleri yakalamaya çalışır.
Bu dönemde önemli teknik izlerden biri, transposed convolution işlemlerinin oluşturduğu periyodik desenlerdir. Çalışmada GAN görüntülerinde yaklaşık (±0.25, ±0.25) frekans bölgelerinde enerji yoğunlaşması gibi izlerden bahsedilir. Bu izler, normal görüntülerdeki kamera ve sensör kaynaklı doğal örüntülerden farklıdır. Gündelik bir benzetmeyle, gerçek bir kumaşta dokuma doğal düzensizlikler taşırken, makineden çıkan sahte bir desenin tekrarlayan mikroskobik çizgiler bırakması gibi düşünülebilir. Frekans tabanlı tespit sistemleri, görüntünün yüzeyine değil bu görünmeyen desenlerine bakar.
Çalışmada frekans analiziyle ilgili temel işlem şu ilişki üzerinden açıklanır:
\[ P(r)=\frac{1}{2\pi}\int_{0}^{2\pi}|F(r\cos\theta,r\sin\theta)|\,d\theta \]
Bu formülde F(u,v), görüntünün frekans alanındaki temsilidir. r, frekans alanındaki yarıçapı; θ, açısal yönü gösterir. P(r), farklı yönlerdeki frekans enerjisinin ortalamasını alarak tek boyutlu bir radyal enerji profili üretir. Formülün anlamı şudur: Görüntünün hangi frekans bölgelerinde doğal olmayan enerji yığılması taşıdığı ölçülür. GAN tabanlı sahte görüntülerde belirli frekans bölgelerinde yapay tepe noktaları oluşuyorsa, bu tespit için kullanılabilir.
Ancak bu ilk döngünün de bir sınırı vardır. GAN mimarileri geliştikçe, özellikle StyleGAN3 gibi alias-free yaklaşımlar, bu frekans izlerini azaltmaya başlar. Ayrıca yüz değiştirme sistemleri yalnızca sıfırdan yüz üretmek yerine, bir yüzü başka bir videonun üzerine yerleştirmeye yönelir. Böylece sahteciliğin izi frekans alanından yüzün birleştirildiği sınırlara ve zaman içindeki biyolojik tutarlılığa kayar.
İkinci döngü blending-boundary and deep-representation era, yani birleştirme sınırı ve derin temsil dönemidir. Bu dönem yaklaşık 2018–2023 aralığında öne çıkar. DeepFaceLab, FaceSwap ve First Order Motion Model gibi autoencoder veya yüz reenactment sistemleri bu bağlamda önemlidir. Bu sistemler çoğu zaman bir kişinin kimliğini başka bir yüz hareketi veya hedef video üzerine bindirir. Bu işlemde yüz bölgesi hedef kareye kompoze edildiği için, yüzün çevresinde veya dokusunda sınır, maskeleme, renk uyumsuzluğu, pürüzsüzleşme ve biyofizyolojik bozulma gibi izler kalabilir.
Autoencoder tabanlı yüz değiştirme sistemleri genellikle shared encoder–independent decoder mantığıyla çalışır. Ortak bir encoder yüzün poz, ifade ve aydınlatma gibi kimlik dışı yapısal özelliklerini çıkarır; farklı decoder’lar ise kaynak ve hedef kimliklere ait yüz dokusunu yeniden üretir. Çalışmadaki Şekil 7 bu mekanizmayı şematik olarak gösterir. Bu yaklaşım GAN eğitimindeki bazı kararsızlıkları azaltır ve yüz değiştirmeyi pratikleştirir. Ancak piksel düzeyinde yeniden yapılandırma kaybı, yüz dokusunun yüksek frekans ayrıntılarını yumuşatabilir. Bu da çalışmada “waxy” yani balmumu gibi pürüzsüz görünüm olarak ele alınır.
Bu dönemin tespit yöntemleri, sahte yüzün hedef kareye yapıştırıldığı sınırları bulmaya çalışır. Face X-ray ve Self-Blended Images gibi yöntemler, yüz değiştirme sürecinin bıraktığı karışım sınırını doğrudan modellemeye çalışır. Ayrıca FakeCatcher gibi yaklaşımlar, yüz derisindeki çok küçük renk değişimlerinden kalp atımıyla ilişkili remote photoplethysmography yani uzaktan fotopletismografi/rPPG sinyallerini çıkarmaya çalışır. Gerçek insan yüzünde kan akışı ve cilt rengi zaman içinde biyolojik bir ritim taşır; sahte videoda bu ritim çoğu zaman düzgün korunmaz.
Üçüncü döngü semantic and physical-consistency era, yani semantik ve fiziksel tutarlılık dönemidir. Bu dönem 2022–2025 aralığında diffusion modelleri, büyük video üretim sistemleri ve çok modlu üretim yaklaşımlarıyla ilişkilidir. Stable Diffusion, DiT, DreamBooth ve Sora gibi sistemler, görüntü ve video üretiminde çok daha yüksek gerçekçilik, koşullu kontrol ve fiziksel görünüm tutarlılığı sunar. Bu noktada frekans izleri, basit birleştirme sınırları veya tekil piksel anomalileri tespit için yeterli olmayabilir.
Diffusion modelleri, temel olarak gürültüden veriye doğru ilerleyen bir denoising süreci kullanır. Model önce veriye adım adım gürültü ekleme sürecini öğrenir, sonra bu süreci tersine çevirerek gürültüden anlamlı görüntü veya video üretir. Çalışmada diffusion modellerinin olasılıksal temeli şu ELBO ilişkisiyle verilir:
\[ \mathbb{E}[-\log p_{\theta}(x_0)] \leq \mathbb{E}_{q}\left[-\log p(x_T)-\sum_{t\geq 1}\log\frac{p_{\theta}(x_{t-1}|x_t)}{q(x_t|x_{t-1})}\right] \]
Bu formülde x0 gerçek/veri örneğini, xT gürültülü son durumu, q(xt|xt-1) ileri yönde gürültü ekleme sürecini, pθ(xt-1|xt) ise modelin ters yönde gürültüyü kaldırarak veriye yaklaşma sürecini ifade eder. θ, model parametrelerini gösterir. Bu ifade teknik olarak, modelin gerçek veri dağılımını doğrudan hesaplamak yerine, onu alt sınır üzerinden öğrenmeye çalıştığını anlatır.
Pratik eğitimde bu karmaşık amaç, Ho ve arkadaşlarının gösterdiği şekilde gürültü tahmini kaybına indirgenebilir. Çalışmada verilen basitleştirilmiş loss formülü şöyledir:
\[ L_{simple}(\theta)=\mathbb{E}_{t,x_0,\epsilon}\left[\left\|\epsilon-\epsilon_{\theta}\left(\sqrt{\bar{\alpha}_t}x_0+\sqrt{1-\bar{\alpha}_t}\epsilon,t\right)\right\|^2\right] \]
Bu formülde ε, veriye eklenen gerçek gürültüyü; εθ, modelin tahmin ettiği gürültüyü; t, zaman/gürültü adımını; \bar{α}t, gürültü takvimini belirleyen katsayıyı; x0, başlangıçtaki temiz veri örneğini gösterir. Formülün gündelik anlamı şudur: Model, “bu görüntüye hangi gürültü eklenmişti?” sorusunu öğrenir. Bu soruya yeterince iyi cevap verdiğinde, ters yönde giderek gürültüden gerçekçi görüntü üretebilir.
Diffusion modellerinin tespit açısından en zorlayıcı tarafı, üretim sürecinin doğal görüntü istatistiklerine çok yaklaşabilmesidir. GAN döneminde frekans alanında görülen yapay tepe noktaları diffusion çıktılarında daha zayıf olabilir. Video üretiminde de Sora benzeri modeller, uzamsal-zamansal parçalama ve DiT mimarileriyle hareket, ışık, fiziksel etkileşim ve uzun menzilli bağımlılıkları daha iyi modelleyebilir. Bu, tespiti piksel düzeyinden daha yüksek düzeye taşır: Bir video fizik kurallarına uyuyor mu? Ses ile dudak hareketi gerçekten eşleşiyor mu? Konuşmadaki duygu tonu yüz ifadesiyle tutarlı mı? Gölge, ışık kaynağı ve hareket yönü aynı fiziksel dünyaya ait mi?
Makale çok modlu deepfake alanını ayrı bir kritik eşik olarak ele alır. İlk dönemlerde sahtecilik daha çok yüz görüntüsüyle sınırlıydı. Sonra dudak hareketi ve ses eşleştirme sistemleri gelişti. Wav2Lip gibi sistemler, konuşma sesine uygun dudak hareketi üretmede çok güçlü hâle geldi. Daha sonra NeRF tabanlı ve diffusion tabanlı konuşan kafa modelleri, yüz ifadesi, ağız hareketi, ses tonu ve kimlik tutarlılığını birlikte üretmeye başladı. Bugün ve yakın gelecekte risk yalnızca sahte video değil; sahte ses, sahte yüz, sahte beden dili, sahte duygu ve bağlama uygun sahte konuşma senaryosunun birlikte üretilmesidir.
Bu nedenle çalışma, çok modlu sahteciliği üç düzeyde tartışır: temporal synchronisation, yani zamanlama uyumu; emotional consistency, yani duygu tutarlılığı; biomechanical consistency, yani biyomekanik tutarlılık. Gerçek konuşmada dudak hareketi, sesin başlangıcı, nefes ritmi, yüz kasları, göz hareketi, tonlama ve duygusal yoğunluk birbirinden bağımsız değildir. Sahte içerik çok gerçekçi görünse bile bu katmanlardan birinde küçük uyumsuzluklar bırakabilir.
Örneğin ses ile dudak hareketi arasında 40–60 milisaniyeyi aşan kaymalar insan algısında doğal olmayan bir his yaratabilir. Benzer şekilde bir kişinin yüzü gülüyormuş gibi görünürken ses tonu ağlama veya korku taşıyorsa, duygusal tutarsızlık ortaya çıkar. Farklı dillerdeki dudak kapanmaları ve sesletim biçimleri de önemlidir. Çalışmada Çince ve İngilizce gibi dillerde fonem–viseme ilişkilerinin deepfake tespitinde ipucu olabileceği belirtilir. Bu, tespit sistemlerinin yalnızca görüntü işleme değil, dil, fonetik, beden hareketi ve insan biyolojisi bilgisini de kullanması gerektiği anlamına gelir.
Çalışmanın yöntem bölümü, bu derlemenin rastgele seçilmiş kaynaklardan oluşmadığını gösterir. Araştırmacılar PRISMA’ya uyarlanmış bir protokol kullanmıştır. IEEE Xplore, ACM Digital Library, Web of Science ve arXiv taranmıştır. Arama terimleri üç grupta kurulmuştur: üretim terimleri, tespit terimleri ve modalite terimleri. Üretim tarafında deepfake, face forgery, face swap, talking head, diffusion model, GAN ve autoencoder; tespit tarafında detection, forensics, authentication ve anti-spoofing; modalite tarafında image, video, audio ve multimodal gibi terimler kullanılmıştır.
PRISMA akışı çalışmanın Şekil 2’sinde gösterilir. İlk aramada 1.486 kayıt bulunmuştur. 312 tekrar çıkarıldıktan sonra 1.174 kayıt başlık ve özet düzeyinde taranmıştır. 627 kayıt konu dışı olduğu için elenmiştir. Kalan 547 tam metin uygunluk açısından değerlendirilmiş ve 211 çalışma nitel senteze alınmıştır. Bu 211 çalışmanın 83’ü üretim yöntemleri, 75’i tespit yöntemleri, 31’i veri setleri ve değerlendirme, 22’si ise yönetişim, etik ve politika üzerine sınıflandırılmıştır. Bu sayılar, çalışmanın yalnızca teknik modelleri değil, veri seti ve yönetişim boyutunu da kapsadığını gösterir.
Çalışma meta-analiz yapmadığını özellikle belirtir. Bunun nedeni, included çalışmaların veri setleri, değerlendirme protokolleri, sıkıştırma düzeyleri, yüz kırpma yöntemleri, örnekleme oranları ve raporlama biçimleri açısından heterojen olmasıdır. Yani araştırmacılar tek bir ortak etki büyüklüğü hesaplamaya çalışmamıştır. Bunun yerine tematik sentez yapmış ve her döngüde üç şeye bakmıştır: hangi üretim teknikleri baskındır, bu teknikler hangi izleri bırakır veya hangi eski izleri bastırır, tespit yöntemleri bu izleri nasıl operasyonelleştirir.
Çalışmanın üretim teknolojileri karşılaştırması da önemlidir. GAN, autoencoder ve diffusion modelleri aynı sırayla birbirini tamamen değiştiren nesiller değildir; çoğu dönemde paralel çalışmışlardır. GAN’lar hızlı çıkarım ve keskin görsel ayrıntılarda avantajlı olabilir, ancak frekans izleri ve eğitim kararsızlığı gibi sorunlar taşır. Autoencoder sistemleri daha stabil ve pratik yüz değiştirme sağlar, ancak yüz dokusunda pürüzsüzleşme ve yüksek frekans ayrıntısı kaybı yaratabilir. Diffusion modelleri yüksek gerçekçilik ve koşullu kontrol sunar, ancak iteratif örnekleme nedeniyle daha yavaş ve hesaplama maliyeti yüksek olabilir. Çok modlu sistemler ise ses, görüntü, metin ve zaman tutarlılığını birlikte hedefler; fakat uzun videolarda kimlik kayması, duygu tutarsızlığı ve gerçek zamanlı üretim zorlukları hâlâ önemlidir.
Makalenin değerlendirme metrikleri bölümü, deepfake araştırmalarında tek bir başarı sayısının yeterli olmadığını gösterir. Tespit tarafında AUC, EER, IoU ve ACC gibi ölçütler kullanılır. Üretim kalitesi tarafında FID, Id-Acc, FVD, TCM, IS, LPIPS, CLIP Score ve NIQE gibi metrikler yer alır. Çok modlu tutarlılık tarafında LSE-D/C ve MOS öne çıkar. Çalışmanın önerdiği üç eksenli matris, bu metrikleri tek bir çerçevede toplar.
EER, yani Equal Error Rate, yanlış kabul ve yanlış ret oranlarının eşitlendiği eşiği gösterir. Adli ve biyometrik bağlamlarda önemlidir; çünkü sahte içeriği gerçek kabul etmek ile gerçek içeriği sahte sanmak farklı ama ciddi riskler taşır. IoU, yani Intersection over Union, sahte olduğu düşünülen bölge ile gerçek etiketli sahte bölgenin ne kadar örtüştüğünü ölçer. Bu, yalnızca “video sahte” demekten öte, “sahtecilik görüntünün hangi bölgesinde?” sorusunu yanıtlamak için gereklidir.
Üretim kalitesi metriklerinde FID, üretilen görüntülerin gerçek görüntü dağılımına ne kadar benzediğini ölçer. Id-Acc, yüz değiştirme gibi uygulamalarda hedef kimliğin korunup korunmadığına bakar. FVD, FID’nin video karşılığı gibi düşünülebilir ve zaman içi tutarlılığı hesaba katar. TCM, kareler arasındaki optik akış tutarsızlıklarını yakalayarak flicker veya titreşim gibi sorunları ölçer. Çok modlu tarafta LSE-D/C, dudak hareketi ile konuşma sesi arasındaki uyumu; MOS ise insan değerlendiricilerin algıladığı gerçekçilik puanını ifade eder.
Çalışmanın veri setleri bölümü de deepfake alanının nasıl genişlediğini gösterir. İlk dönemlerde UADFV ve DF-TIMIT gibi küçük video veri setleri kullanılmıştır. Daha sonra FaceForensics++, Celeb-DF, DFDC ve WildDeepfake gibi daha büyük ve zorlayıcı veri setleri ortaya çıkmıştır. Görüntü tarafında CelebA-HQ, FFHQ, PGGAN/StyleGAN setleri ve Fake2M gibi diffusion dönemi veri setleri öne çıkar. Çok modlu tarafta FakeAVCeleb, KoDF, LAV-DF, MADD, Codecfake ve DDL gibi veri setleri ses–video, çok dilli konuşma, yerel manipülasyon ve ince etiketleme gibi ihtiyaçlara cevap vermeye çalışır.
Bu veri setlerinin her biri farklı bir problemi görünür kılar. FaceForensics++ standart karşılaştırma için güçlüdür, ancak yeni nesil çok gerçekçi forgeries için sınırlı kalabilir. Celeb-DF daha rafine sahteciliği test eder. DFDC, endüstriyel ölçekte karmaşık ve gerçekçi dağılım sunar. WildDeepfake, internette dolaşan heterojen içeriklerin zorluğunu yansıtır. LAV-DF, videonun yalnızca kısa bir parçasının manipüle edildiği senaryoları değerlendirmeye yarar. MADD ve KoDF, İngilizce merkezli veri setlerinin dışına çıkarak çok dilli ve kültürler arası sorunları gündeme getirir.
Yönetişim bölümü çalışmanın teknik derlemeyi aşan en önemli tarafıdır. Yazarlara göre deepfake ile mücadele yalnızca daha iyi dedektör üretmekle çözülemez. Çünkü sahte içerik yayıldıktan sonra tespit etmek çoğu zaman geç kalmış bir savunmadır. Bu nedenle çalışma, generation-time watermarking, yani üretim anında filigran yerleştirme; content provenance, yani içeriğin kaynağını ve işleme geçmişini doğrulama; blockchain-based evidence preservation, yani blokzincir tabanlı kanıt koruma; ve risk-tiered regulation, yani risk temelli düzenleme gibi araçların birlikte düşünülmesini önerir.
Bu noktada Stable Signature, Tree-ring Watermarks ve SynthID gibi yöntemler örneklenir. Stable Signature, latent diffusion decoder içine öğrenilebilir bir watermark katmanı yerleştirir. Tree-ring Watermarks, başlangıç gürültüsünün Fourier uzayına görünmez ama çıkarılabilir bir işaret kodlar. SynthID ise üretim sürecine istatistiksel parmak izi yerleştirerek insan gözünün fark etmediği ancak doğrulayıcı sistemin okuyabildiği sinyaller üretmeye çalışır. Bu yaklaşımlar, sahte içerik yayıldıktan sonra onu yakalamaya çalışmak yerine, üretim kaynağında iz bırakmayı amaçlar.
C2PA gibi içerik kökeni standartları da bu çerçevede önemlidir. Bir fotoğrafın veya videonun hangi cihazla yakalandığı, hangi yazılımla işlendiği, üzerinde hangi değişikliklerin yapıldığı ve zincirin nerede kırıldığı kriptografik olarak doğrulanabilirse, tespit yalnızca “algoritma bunu sahte sandı” düzeyinde kalmaz. İçeriğin yaşam döngüsü boyunca kanıt zinciri kurulabilir. Bu özellikle gazetecilik, hukuk, sigorta, güvenlik, adli süreçler ve kamu iletişimi açısından önemlidir.
Çalışma, teknoloji–hukuk–etik çerçevesini EU AI Act, NIST AI Risk Management Framework, Çin’in üretken yapay zekâ önlemleri ve UNESCO’nun yapay zekâ etiği önerileriyle ilişkilendirir. Teknik araçlar düzenleyici yükümlülükleri uygulanabilir hâle getirir; düzenleyici çerçeveler teknik standartlara yön verir; toplumun medya okuryazarlığı ise bu sinyallerin insanlar tarafından doğru yorumlanmasını sağlar. Yani yalnızca filigran koymak yetmez; insanlar ve kurumlar bu filigranın ne anlama geldiğini, hangi durumda güvenilir olduğunu ve ne zaman eksik kalabileceğini de bilmelidir.
Çalışmanın geçmiş açısından önemi, deepfake tarihini basit “GAN geldi, autoencoder geldi, diffusion geldi” sıralamasından çıkarıp tespit ipuçlarının kayması üzerinden yeniden yorumlamasıdır. Bu, literatürü daha dinamik anlamayı sağlar. Çünkü alanı gerçekten değiştiren şey sadece yeni model mimarileri değil, eski savunma ipuçlarının çökmesi ve yeni savunma düzeylerine geçilmesidir.
Bugün açısından önemi, sosyal medyada, finans sektöründe, politik iletişimde ve dijital kimlik doğrulamada deepfake riskinin hızla büyümesidir. Bir şirket yöneticisinin sesi klonlanabilir, bir siyasetçinin sahte videosu kriz anında yayılabilir, bir kişinin mahrem görüntüsü uydurulabilir, bir haber kaynağının güvenilirliği sarsılabilir. Tespit sistemleri yalnızca laboratuvar başarısıyla değil, gerçek dünya dağılımında, sıkıştırılmış ve yeniden yüklenmiş içeriklerde, farklı dillerde, farklı yüz gruplarında ve yeni üretim modellerinde test edilmelidir.
Gelecek açısından çalışma, tespitin giderek post-hoc sınıflandırmadan kaynakta doğrulamaya kayacağını öngörür. Yani gelecekte ana savunma yalnızca “bu video sahte mi?” sorusuna bakan dedektörler olmayabilir. Bunun yerine içerik üretildiği anda filigranlanacak, köken bilgisi kriptografik olarak bağlanacak, platformlar bunu doğrulayacak, şüpheli içerikler çok modlu tespit sistemleriyle incelenecek ve gerektiğinde adli kanıt zinciri kurulacaktır. Bu öngörü çalışmanın en stratejik mesajlarından biridir.
Çalışmanın güçlü yönü, üretim, tespit, veri seti, metrik ve yönetişimi tek çerçevede birleştirmesidir. Yalnızca teknik model listesi sunmaz; her üretim paradigmasının hangi tespit ipucunu zayıflattığını ve savunmanın nasıl yeni ipuçlarına göç ettiğini anlatır. Ayrıca görseller ve tablolar bu argümanı destekler: Şekil 1 üretim ve tespit evrimini zaman çizgisiyle gösterir; Şekil 2 PRISMA seçim sürecini açıklar; Tablo 2 üç döngüde hangi üretim rotasının hangi izleri bıraktığını ve hangi tespit yöntemlerinin buna cevap verdiğini özetler; Tablo 8 değerlendirme matrisini, Tablo 9 ise teknik ve yönetişim cevaplarını birleştirir.
Sınırlılıkları da dikkatle belirtilmelidir. Çalışma hakem değerlendirmesinden geçmemiş bir preprinttir. Yeni deneysel sonuç üretmez; mevcut literatürü sentezler. Meta-analitik etki büyüklüğü hesaplamaz; çünkü veri setleri ve protokoller çok heterojendir. Bazı performans değerleri, orijinal yayınların kendi protokollerinden aktarılır ve farklı çalışmalar arasında mutlak karşılaştırma yapmak her zaman güvenli değildir. Ayrıca MLLM tabanlı tespit gibi alanlarda kanıt henüz erken aşamadadır; çalışma da bu konuda temkinli davranarak bu sistemlerin henüz gerçek zamanlı moderasyon için özel dedektörlerin yerine geçecek olgunlukta olmadığını belirtir.
Çalışmanın söylediği şey şudur: Deepfake üretimi ve tespiti birlikte evrilmektedir; her yeni üretim paradigması eski tespit ipuçlarını zayıflatmakta, tespit yöntemleri daha yüksek seviyeli semantik, fiziksel, çok modlu ve kaynakta doğrulama yöntemlerine yönelmektedir. Çalışmanın söylemediği şey ise şudur: Her deepfake kesin olarak tespit edilebilir, watermark tüm sorunu çözer, MLLM sistemleri bugünden güvenilir dedektör olarak kullanılabilir veya tek bir metrik deepfake güvenliğini ölçmeye yeter. Tam tersine çalışma, alanın çok katmanlı, dinamik ve sürekli güncellenmesi gereken bir savunma mimarisi gerektirdiğini vurgular.
Çalışmanın Yöntemi ve Bulguları
Bu çalışma, deneysel model geliştirme çalışması değil, sistematik derleme niteliğinde bir literatür sentezidir. Araştırmacılar, deepfake üretimi, tespiti, veri setleri, değerlendirme metrikleri ve yönetişim literatürünü 2014–2025 aralığında taramış ve bulguları “adversarial evolution” çerçevesinde yeniden düzenlemiştir.
Çalışmanın kaynak tarama yöntemi:
| Yöntem Unsuru | Çalışmada Kullanılan Yaklaşım | Anlamı |
| Tarama dönemi | 1 Ocak 2014 – 31 Aralık 2025. | GAN’ın ortaya çıkışından diffusion ve büyük video üretim modellerine kadar alan izlenmiştir. |
| Veri tabanları | IEEE Xplore, ACM Digital Library, Web of Science, arXiv. | Hem hakemli yayınlar hem de alanda etkili yüksek atıflı preprintler taranmıştır. |
| Arama grupları | Üretim, tespit ve modalite terimleri. | Deepfake üretimi, adli tespit, görüntü, video, ses ve çok modlu içerik birlikte kapsanmıştır. |
| Seçim yaklaşımı | PRISMA’ya uyarlanmış sistematik seçim protokolü. | Literatür seçiminin izlenebilir ve tekrarlanabilir olması hedeflenmiştir. |
| Sentez yöntemi | Tematik analiz. | Çalışmalar üretim paradigması, tespit paradigması ve yayın yılına göre sınıflandırılmıştır. |
PRISMA seçim süreci:
| Aşama | Sayı | Açıklama |
| İlk bulunan kayıt | 1.486 | IEEE Xplore, ACM Digital Library, Web of Science ve arXiv üzerinden elde edilmiştir. |
| Çıkarılan tekrar kayıt | 312 | Veri tabanları arasındaki örtüşmeler temizlenmiştir. |
| Başlık/özet taraması | 1.174 | Kalan kayıtlar konu uygunluğu bakımından değerlendirilmiştir. |
| Konu dışı elenen kayıt | 627 | Genel üretici modelleme veya deepfake dışı adli analiz çalışmaları çıkarılmıştır. |
| Tam metin değerlendirmesi | 547 | Uygunluk kriterlerine göre tam metinler incelenmiştir. |
| Nitel senteze dahil edilen çalışma | 211 | 83 üretim, 75 tespit, 31 veri seti/metrik, 22 yönetişim/etik/politika çalışmasıdır. |
Çalışmaların sınıflandırıldığı ana eksenler:
- Üretim paradigması: GAN tabanlı yöntemler, autoencoder tabanlı yöntemler, diffusion tabanlı yöntemler, çok modlu/hybrid yöntemler.
- Tespit paradigması: fiziksel artefaktlar, derin temsiller, robustluk artırıcı mekanizmalar, çok modlu tutarlılık kontrolleri, aktif savunma yöntemleri.
- Zaman ekseni: çalışmalar üç örtüşen adversarial döngüye bağlanmıştır.
Üç adversarial tespit döngüsü:
| Döngü | Dönem | Üretim Tarafı | Tespit İpucu | Döngüyü Zayıflatan Gelişme |
| Frekans ipucu dönemi | 2014–2019 | GAN, StyleGAN, cGAN, CycleGAN gibi modeller. | Frekans anomalileri, checkerboard izleri, PRNU uyumsuzluğu, baş pozu tutarsızlığı. | Alias-free mimariler ve autoencoder yüz değiştirme sistemleri bu izleri zayıflatmıştır. |
| Birleştirme sınırı ve derin temsil dönemi | 2018–2023 | DeepFaceLab, FaceSwap, FOMM gibi yüz değiştirme/reenactment sistemleri. | Yüz karışım sınırları, pürüzsüz yüz dokusu, rPPG ve solunum gibi biyofizyolojik bozulmalar. | Diffusion denoising süreçleri ve fiziksel tutarlılığı artan video modelleri bu izleri azaltmıştır. |
| Semantik ve fiziksel tutarlılık dönemi | 2022–2025 | Stable Diffusion, DiT, DreamBooth, Sora benzeri sistemler. | Diffusion yeniden yapılandırma hatası, ses–görüntü biyomekanik uyumsuzluğu, fizik yasası ihlalleri, kaynak doğrulama. | Bir sonraki savunma odağının kaynakta watermark ve provenance doğrulaması olacağı öngörülmektedir. |
Deepfake üretim paradigmalarının karşılaştırması:
| Paradigma | Temel İlke | Güçlü Yön | Zayıf Yön | Tipik Kullanım |
| GAN | Üretici ve ayırt edici ağ arasında adversarial dağılım eşleştirme. | Hızlı çıkarım, keskin detaylar, latent uzay manipülasyonu. | Frekans izleri, mode collapse, video karelerinde kimlik kayması. | Gerçek zamanlı yüz sentezi ve yüz değiştirme. |
| Autoencoder | Encoder–decoder yeniden yapılandırma. | Daha stabil eğitim, yüz değiştirme pratikliği, kişiye özel pipeline. | Yüksek frekans ayrıntısı kaybı, balmumu gibi pürüzsüz yüzey, sınırlı genelleme. | DeepFaceLab ve FaceSwap tarzı kimlik değişimi. |
| Diffusion | Gürültüden veriye doğru iteratif denoising. | Fotogerçekçilik, metin/görüntü koşullu kontrol, doğal görüntü istatistiklerine yaklaşma. | Yavaş örnekleme, yüksek hesaplama maliyeti, kimlik–özellik entanglement sorunu. | Yüksek kaliteli görüntü/video üretimi ve kişiselleştirilmiş sentez. |
| Çok modlu sistemler | Ses, görüntü, metin ve zaman akışının birlikte hizalanması. | Konuşan dijital insan, ses–dudak senkronizasyonu, duygu ve semantik kontrol. | Uzun videoda kimlik kayması, duygu tutarsızlığı, gerçek zamanlılık ve güvenlik zorluğu. | Dijital insan, dublaj düzeltme, konuşan avatar, sosyal mühendislik riski. |
Diffusion modelinde çalışmada verilen temel eğitim ilişkileri:
\[ \mathbb{E}[-\log p_{\theta}(x_0)] \leq \mathbb{E}_{q}\left[-\log p(x_T)-\sum_{t\geq 1}\log\frac{p_{\theta}(x_{t-1}|x_t)}{q(x_t|x_{t-1})}\right] \]
Bu formül diffusion modelinin olasılıksal eğitim çerçevesini gösterir. Model, doğrudan veri dağılımının olasılığını hesaplamak yerine, ters denoising sürecini öğrenerek veriye yaklaşır. Burada x0 temiz veri örneği, xT tamamen gürültülü örnek, q ileri gürültüleme süreci, pθ öğrenilen ters süreç ve θ model parametreleridir.
\[ L_{simple}(\theta)=\mathbb{E}_{t,x_0,\epsilon}\left[\left\|\epsilon-\epsilon_{\theta}\left(\sqrt{\bar{\alpha}_t}x_0+\sqrt{1-\bar{\alpha}_t}\epsilon,t\right)\right\|^2\right] \]
Bu formül, diffusion modelinin pratikte gürültü tahminiyle eğitilebildiğini gösterir. ε gerçek gürültüyü, εθ modelin tahmin ettiği gürültüyü, \bar{α}t gürültü takvim katsayısını, t ise denoising adımını ifade eder. Modelin görevi, gürültülü verideki gürültüyü doğru tahmin ederek ters yönde gerçekçi örnek üretmektir.
Frekans tabanlı tespitte kullanılan temel ilişki:
\[ P(r)=\frac{1}{2\pi}\int_{0}^{2\pi}|F(r\cos\theta,r\sin\theta)|\,d\theta \]
Bu formül görüntünün frekans alanındaki radyal enerji profilini çıkarır. F görüntünün frekans temsilini, r yarıçap/frekans düzeyini, θ açısal yönü, P(r) ise yönlerden bağımsız ortalama frekans enerjisini ifade eder. GAN görüntülerinde belirli frekans tepe noktaları doğal görüntülerden farklılık gösterebildiği için, bu profil sahtecilik tespitinde kullanılabilir.
Çalışmanın önerdiği üç eksenli değerlendirme matrisi:
| Eksen | Metrikler | Ne Ölçer? |
| Tespit performansı | AUC, EER, IoU, ACC. | Bir sistemin gerçek ve sahte içeriği ayırma ve sahte bölgeyi yerelleştirme başarısını ölçer. |
| Üretim kalitesi | FID, Id-Acc, FVD, TCM, IS, LPIPS, CLIP Score, NIQE. | Üretilen içeriğin gerçekçiliğini, kimlik korumasını, video tutarlılığını ve metinle uyumunu ölçer. |
| Çok modlu tutarlılık | LSE-D/C, MOS. | Ses–dudak senkronizasyonu, insan algısındaki gerçekçilik ve çok modlu uyumu ölçer. |
Başlıca veri seti aileleri:
| Veri Seti Grubu | Örnekler | Çalışmadaki Rolü |
| Görüntü veri setleri | CelebA-HQ, FFHQ, PGGAN/StyleGAN setleri, iFakeFaceDB, Fake2M. | Statik yüz üretimi, GAN fingerprint, diffusion görüntü tespiti ve sahte görüntü kalitesi için kullanılır. |
| Video veri setleri | UADFV, DF-TIMIT, FaceForensics++, Celeb-DF, DFDC, WildDeepfake, FFIW-10K, DFDC-Medical. | Yüz değiştirme, sosyal medya koşulları, sıkıştırma, gerçek ortam dağılımı ve alan-özel sahtecilik için kullanılır. |
| Çok modlu veri setleri | FakeAVCeleb, KoDF, LAV-DF, MADD, Codecfake, DDL. | Ses–video deepfake, çok dilli ses sahteciliği, yerel manipülasyon ve ince düzey etiketleme için kullanılır. |
Derlemenin tespit ettiği temel teknik bulgular:
- Deepfake üretim ve tespit alanı, birbirinden bağımsız iki çizgi değil, karşılıklı evrilen bir saldırı–savunma sistemidir.
- GAN dönemindeki frekans izleri, alias-free mimariler ve yeni üretim yöntemleriyle daha az güvenilir hâle gelmiştir.
- Autoencoder ve yüz değiştirme sistemleri, yüz birleştirme sınırları ve biyofizyolojik sinyal bozulmaları gibi yeni tespit ipuçları doğurmuştur.
- Diffusion modelleri, doğal görüntü istatistiklerine daha çok yaklaştığı için frekans ve piksel tabanlı dedektörlerin gücünü azaltmıştır.
- Çok modlu deepfake tespiti için yalnızca görüntü değil; ses, dudak hareketi, duygu, prosodi, nefes, biyomekanik hareket ve semantik bağlam birlikte değerlendirilmelidir.
- MLLM tabanlı tespit sistemleri açıklama üretebilir; ancak henüz gerçek zamanlı moderasyon ve yüksek güvenilirlik için yeterince olgun değildir.
- Kaynakta watermark ve provenance doğrulaması, gelecekte post-hoc tespit yöntemlerini tamamlayan ana savunma hattı olabilir.
Çalışmanın yönetişim önerileri:
| Sorun | Teknik Cevap | Yönetişim Cevabı |
| Dedektörlerin yeni veri alanlarında başarısız olması | Causal reasoning, domain adaptation, self-blended training, sürekli güncellenen benchmarklar. | Platform ve düzenleyiciler için periyodik değerlendirme ve yaşam döngüsü risk yönetimi. |
| Çok modlu sahteciliğin yaygınlaşması | Ses–görüntü senkronizasyonu, duygu tutarlılığı, biyomekanik ve fiziksel kontrol. | Çok modlu etiketleme standartları ve platform sorumlulukları. |
| Yalnızca “sahte/gerçek” kararının yetersiz kalması | İnce düzey yerelleştirme, model fingerprint, kaynak atfı. | Adli kanıt zinciri, blokzincir tabanlı kayıt ve kriptografik içerik kökeni. |
| Farklı dil ve kültürlerde adaletsiz tespit performansı | Çok dilli, çok kültürlü ve farklı yüz dağılımlarını kapsayan veri setleri. | Adalet, ayrımcılık ve küresel standart uyumu odaklı denetim. |
| Sahte içeriğin yayıldıktan sonra yakalanmasının zor olması | Stable Signature, Tree-ring Watermarks, SynthID, C2PA provenance. | Üretim anında etiketleme, kaynak doğrulama ve risk temelli düzenleme. |
Çalışmanın açık sınırlılıkları:
- Çalışma hakem değerlendirmesinden geçmemiş bir preprinttir.
- Yeni deneysel model veya yeni veri seti üretmemektedir.
- Meta-analiz yapılmamıştır; çünkü literatürde veri seti, protokol ve raporlama biçimleri oldukça heterojendir.
- Aktarılan performans değerleri orijinal yayınların kendi koşullarına bağlıdır; mutlak karşılaştırma yapılırken dikkatli olunmalıdır.
- MLLM tabanlı tespit henüz küçük ve küratörlü alt kümelerde değerlendirilmiş olabilir; gerçek dünya ölçekli karşılaştırmalar eksiktir.
- Fiziksel ve semantik tutarlılık için standartlaşmış metrikler henüz yeterince olgun değildir.
- Watermark ve provenance çözümleri güçlü olsa da karşı-adli silme, yeniden kodlama ve platformlar arası uyumluluk sorunları devam etmektedir.
Genel sonuç: Çalışmaya göre deepfake ile mücadele, tek bir dedektör veya tek bir yasa ile çözülebilecek bir problem değildir. Üretim modelleri, tespit sistemleri, veri setleri, değerlendirme metrikleri, watermark/provenance standartları, platform sorumlulukları, hukuk ve kamu farkındalığı birlikte gelişmelidir. Deepfake alanındaki gerçek savunma, görüntüdeki tekil hata izlerini yakalamaktan, içeriğin üretiminden yayılmasına ve adli doğrulanmasına kadar uzanan bütüncül bir güven mimarisine doğru kaymaktadır.
Kaynak ve Yöntem Notu
Bu makale, Mengze Li, Gang Liang, Kui Zhao, Liangyin Chen, Junren Chen ve Jiayi Liu tarafından hazırlanan “Adversarial Evolution of Deepfake Generation and Detection: A Systematic Review of Paradigms, Evaluation, and Governance” başlıklı çalışmaya dayanarak hazırlanmıştır.
Kaynak metin, deepfake üretimi ve tespiti literatürünü 2014–2025 aralığında sistematik olarak inceleyen bir preprint sistematik derleme makalesi niteliğindedir. Metinde açıkça “This preprint research paper has not been peer reviewed” ifadesi bulunduğu için çalışma hakem değerlendirmesinden geçmemiştir. Bu nedenle sonuçlar, hakemli dergide kesinleşmiş nihai bulgular gibi değil, kapsamlı fakat değerlendirmeye açık bir literatür sentezi olarak okunmalıdır.
Çalışmanın yöntemi, PRISMA’ya uyarlanmış sistematik literatür taramasına dayanmaktadır. IEEE Xplore, ACM Digital Library, Web of Science ve arXiv veri tabanları taranmış; 1.486 kayıttan 211 çalışma nitel senteze dahil edilmiştir. Bu çalışmalar üretim yöntemleri, tespit yöntemleri, veri setleri/değerlendirme ve yönetişim/etik/politika başlıklarında sınıflandırılmıştır.
Bu içerik hazırlanırken çalışmanın ana kavramları, üç adversarial döngü modeli, GAN–autoencoder–diffusion üretim hatları, çok modlu deepfake gelişimi, tespit yöntemleri, diffusion formülleri, frekans analizi formülü, veri seti ve metrik karşılaştırmaları, üç eksenli değerlendirme matrisi, teknoloji–hukuk–etik yönetişim çerçevesi, kaynakta watermark ve C2PA provenance önerileri korunmuştur. PDF’de olmayan yeni deneysel sonuç, kesin başarı garantisi, tüm deepfake’lerin güvenilir şekilde tespit edilebileceği iddiası veya tek başına hukuki/teknik çözüm önerisi eklenmemiştir.
Çalışma özellikle şu açıdan dikkatli okunmalıdır: Deepfake tespiti alanında yayınlanan başarı oranları çoğu zaman veri setine, sıkıştırma düzeyine, yüz kırpma yöntemine, eğitim/test ayrımına, üretim modeline ve gerçek dünya dağılımına bağlıdır. Bu nedenle bir dedektörün belirli benchmarkta yüksek başarı göstermesi, sosyal medyada dolaşan her yeni nesil deepfake içeriğini aynı başarıyla yakalayacağı anlamına gelmez.
Çalışmanın en değerli katkısı, deepfake konusunu yalnızca “sahte içerik nasıl tespit edilir?” düzeyinde değil, üretim–tespit–değerlendirme–yönetişim zinciri olarak ele almasıdır. Bu zincir, gelecekte güvenilir dijital medya ekosistemi kurmak için teknik dedektörler kadar kaynak doğrulama, içerik köken bilgisi, yasal yükümlülükler, etik standartlar ve kamu farkındalığının da gerekli olduğunu göstermektedir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir