

Ilk baholash
Bu maqola moliyaviy yangilik sarlavhalaridan bozor kayfiyati ishlab chiqarishga urinadigan gibrid tizim haqida tayyorlangan. Ko‘rib chiqilgan tadqiqot Hybrid News Sentiment Engine: Real-Time Market Analysis via Adaptive Ensemble Learning on News–Price Pairs nomini olgan va arXivda preprint sifatida e’lon qilingan.
Tadqiqotning asosiy da’vosi shundan iborat: moliyaviy yangilik kayfiyati tahlili faqat “ijobiy” yoki “salbiy” so‘zlarni sanash bilan cheklanib qolmasligi kerak. Bir yangilik sarlavhasi haqiqatan ham bozorga ta’sir qildimi yoki yo‘qmi? Tizim shu savolga javob berish uchun yangilik sarlavhalarini bir vaqtning o‘zidagi narx ko‘rinishlari bilan moslaydi va keyin bashorat signallarini yuz bergan narx harakatlari bilan solishtirib, o‘zini yangilab boradi.
Bu ish ayniqsa qiziqarli, chunki u GPU yoki katta til modeli majburiyatisiz, CPUda ishlaydigan yengil bozor kayfiyati motorini taklif qiladi. Biroq natijalar bevosita oldi-sotdi signali yoki investitsion tavsiya sifatida o‘qilmasligi kerak. Tizim yangilik va narx harakati o‘rtasida korrelyatsiya topishga urinadi, ammo yangilikning narx harakatiga haqiqatan sabab bo‘lganini qat’iy isbotlamaydi.
Yangi akademik tadqiqot moliyaviy yangilik sarlavhalarini real vaqt narx harakatlari bilan moslashtirib ishlaydigan gibrid bozor kayfiyati motorini taklif qiladi. Tizim moliyaviy so‘zlik, TF-IDFga asoslangan adaptiv yangilik klasterlash va yuz bergan narx reaksiyasiga qarab og‘irliklarni yangilovchi ensemble tuzilmasini birlashtiradi. Eng e’tiborli tomoni — u GPU yoki qimmat katta til modeli chaqirig‘isiz CPUda ishlay olishi va bozor rejimi o‘zgarganda o‘zini qayta kalibrlashi mumkinligidir.
Muammo nima?
Moliyaviy bozorlar har kuni yangilik sarlavhalari, kompaniya bayonotlari, markaziy bank xabarlari, iqtisodiy ma’lumotlar va ijtimoiy media oqimlari bilan to‘yinadi. Bozor ishtirokchilari bu yangiliklarni talqin qiladi va narxlar ko‘pincha shu talqinga qarab harakatlanadi. Ammo bir xabarning bozorda qanday aks etganini o‘lchash oson emas.
Klassik kayfiyat tahlillari odatda matnni ijobiy, salbiy yoki neytral tarzda tasniflaydi. Masalan, “o‘sish”, “ralli”, “foyda” kabi so‘zlar ijobiy; “pasayish”, “bankrotlik”, “retsessiya” kabi so‘zlar salbiy deb qaraladi. Ammo moliyaviy bozorlarda kontekst juda muhim. “Foiz stavkasi oshishi” ayrim davrlarda salbiy ko‘rinishi mumkin, boshqa davrda esa iqtisodiyotning kuchliligiga ishora sifatida talqin qilinishi mumkin.
Katta til modellari bu kontekstni yaxshiroq ushlashi mumkin. Ammo GPT darajasidagi modellar xarajati, kechikishi va ishlab chiqarish muhitidagi APIga bog‘liqligi jiddiy muammo tug‘diradi. Shuningdek, oldindan o‘qitilgan modellar bozor hikoyalari o‘zgarganda eskirib qolishi mumkin. Mazkur ishning boshlang‘ich nuqtasi ham shu: arzonroq, tezroq, narx reaksiyasiga qarab o‘zini yangilay oladigan yangilik kayfiyati tizimi qurish mumkinmi?
Taklif etilgan usul nima?
Tadqiqotda taklif qilingan tizim uchta asosiy signalni birlashtiradi.
Birinchi signal moliyaviy soha uchun tuzilgan so‘zlikka asoslanadi. Bu qism yangilik sarlavhasidagi ijobiy, salbiy, noaniqlik va huquqiy xavf uyg‘otuvchi so‘zlarni sanaydi. U klassik so‘zga asoslangan usullarga o‘xshaydi, ammo moliyaviy matnga xos atamalar bilan kengaytirilgan.
Ikkinchi signal ishning eng original tomonidir. Tizim yangilik sarlavhalarini TF-IDF usuli bilan vektorlarga aylantiradi va o‘xshash sarlavhalarni klasterlaydi. Keyin har bir yangilik klasterining o‘tmishda o‘rtacha qanday narx reaksiyasi bilan bog‘langanini kuzatadi. Masalan, “foiz pasayishi kutilishi”, “neft ta’minoti xavfi” yoki “texnologiya aksiyalarida o‘sish” kabi o‘xshash sarlavhalar vaqt o‘tishi bilan bir semantik hududga to‘planishi mumkin. Agar bu klasterning narx reaksiyasi o‘zgarsa, tizimning kayfiyat talqini ham o‘zgaradi.
Uchinchi signal ixtiyoriy katta til modeli skoridir. Tadqiqotda LLM signali arxitekturaga qo‘shilgan, biroq xarajat sababli u odatda o‘chiq bo‘ladi. Asosiy tuzilma moliyaviy so‘zlik va statistik klaster o‘rganuvchi yordamida CPUda ishlay oladigan qilib loyihalangan.
Oxirgi bosqichda bu signallar ensemble, ya’ni birlashgan skorga aylantiriladi. Tizim ma’lum oraliqlarda oldin hosil qilingan kayfiyat skorlarini yuz bergan narx harakatlari bilan solishtiradi. Qaysi signal so‘nggi davrda yaxshiroq ishlagan bo‘lsa, uning og‘irligi oshiriladi. Shu tarzda tizim faqat matnning tilshunoslik ma’nosiga emas, balki bozorning o‘sha matnga bergan real javobiga ham moslashishga urinadi.
Formulalar nimani anglatadi?
Tadqiqotdagi formulalar yangilik sarlavhasidan kayfiyat skori ishlab chiqarish jarayonining qanday qurilganini ko‘rsatadi. Ular uch asosiy guruhga bo‘linadi: so‘zga asoslangan skor, TF-IDF klasterlash va narx reaksiyasiga qarab ensemble kalibrlash.
1. Moliyaviy so‘z skori
Birinchi formula yangilik sarlavhasidagi ijobiy va salbiy moliyaviy so‘zlarni sanab, so‘zlik skori hosil qiladi:
Bu yerda \(P\) — ijobiy so‘zlar soni, \(N\) — salbiy so‘zlar soni, \(U\) — noaniqlik bildiruvchi so‘zlar soni, \(C\) — huquqiy yoki da’vo xavfini uyg‘otuvchi so‘zlar soni. \(|T|\) esa sarlavhadagi jami token, ya’ni so‘z/bo‘laklar sonini bildiradi.
Formulada salbiy so‘zlar \(1.2\) koeffitsiyenti bilan kuchliroq jazolanadi. Buning sababi shuki, moliyaviy bozorlarda yomon xabarlar ko‘pincha teng darajadagi yaxshi xabarlarga qaraganda kuchliroq narx ta’siri keltirib chiqaradi. Natija \(-1\) va \(+1\) oralig‘iga siqib qo‘yiladi. Shu bilan skor juda qisqa yoki keskin xabarlarda nazoratsiz oshib ketmaydi.
2. So‘zlik skorining ishonchliligi
Tizim faqat skor ishlab chiqishi yetarli emas; ushbu skorga qanchalik ishonish mumkinligi ham hisoblanadi:
Bu formula sarlavhada moliyaviy so‘zlikka mos keluvchi so‘zlar soni ortgan sayin ishonchni oshiradi. Agar yangilik sarlavhasi moliyaviy terminlar jihatidan zaif bo‘lsa, so‘zlik skori ham past ishonch bilan ensemblega kiradi.
3. TF-IDF: Sarlavhalarni sonli vektorga aylantirish
Tizim yangilik sarlavhalarini faqat so‘zlar ro‘yxati sifatida emas, balki sonli vektorlar sifatida ham ko‘radi. Buning uchun TF-IDF ishlatiladi:
Bu yerda \(TF_i(t)\) — \(t\) terminining tegishli sarlavhada qanchalik tez-tez uchrashini ko‘rsatadi. \(IDF(t)\) esa shu so‘z butun sarlavhalar orasida qanchalik ajratuvchi ekanini o‘lchaydi. Juda ko‘p ishlatiladigan umumiy so‘zlar pastroq vazn oladi, aniqroq va ajratuvchi so‘zlar esa yuqoriroq vazn oladi.
Sarlavhaning vektor ko‘rinishi quyidagicha hosil qilinadi:
Bu yerda \(V\) — tizim tanlagan so‘z boyligini ifodalaydi. Tadqiqotda eng ajratuvchi 2000 ta terminlardan iborat lug‘at ishlatilgani aytiladi.
4. O‘xshash yangiliklarni klasterga joylash
Tizim yangi yangilik sarlavhasini avval shakllangan yangilik klasterlari bilan solishtirish uchun kosinus o‘xshashligidan foydalanadi:
Bu yerda \(v_i\) — yangi yangilik sarlavhasining TF-IDF vektori. \(\mu_j\) esa \(C_j\) klasterining markaz vektori. O‘xshashlik ma’lum chegaradan o‘tsa, yangilik eng yaqin klasterga qo‘shiladi. Tadqiqotda bu chegara \(\theta=0.35\) sifatida berilgan.
Klaster markazi esa shu klasterga tegishli vektorlarning o‘rtachasi bilan ifodalanadi:
Bu tuzilma tufayli tizim butun ma’lumotni boshidan o‘qitmasdan, yangi yangiliklarni mavjud klasterlarga qo‘shib borishi mumkin. Agar yangilik mavjud klasterlarga yetarlicha o‘xshamasa, yangi klaster yaratiladi.
5. Klasterlarning narx reaksiyasini o‘rganishi
Har bir yangilik klasteri o‘tmishda o‘sha klasterga kirgan yangiliklarning o‘rtacha narx reaksiyasini saqlab boradi:
Bu yerda \(ES_j\) — tegishli yangilik klasterining S&P 500 fyucherslari tomonidagi o‘rtacha narx reaksiyasini, \(NQ_j\) esa Nasdaq fyucherslari tomonidagi o‘rtacha narx reaksiyasini bildiradi. Tadqiqotda tizim turli aktiv sinflari uchun bir nechta narx maydonlarini kuzatishi mumkinligi aytiladi.
6. Statistik kayfiyat skori
Yangi yangilik sarlavhasi bir klasterga mos tushsa, o‘sha klasterning o‘tmishdagi narx reaksiyasi statistik kayfiyat skori sifatida ishlatiladi:
Bu formula yangilik eng yaxshi mos tushgan klasterning o‘tmishdagi o‘rtacha ES reaksiyasini \(-1\) va \(+1\) oralig‘iga aylantiradi. Agar yangilik hech bir klasterga yetarlicha o‘xshamasa, statistik skor neytral deb olinadi.
7. Klaster sifati: Sharpega o‘xshash o‘lchov
Tadqiqotda har bir klasterning ishonchliligini o‘lchash uchun Sharpega o‘xshash sifat metrikasi ham qo‘llanadi:
Bu formula klasterning o‘rtacha narx reaksiyasini shu reaksiyalarning tebranishiga bo‘ladi. Agar klaster doimiy ravishda bir xil yo‘nalishda narx reaksiyasi bersa, uning qiymati yanada mazmunli bo‘ladi. Shovqinli klasterlar esa ensemble ichida kamroq ahamiyat oladi yoki siqib chiqariladi.
8. Ensemble skori: Uch signalni birlashtirish
Tizimning yakuniy kayfiyat skori turli signallarning og‘irlikli birlashmasidir:
Bu yerda \(s_{lex}\) — so‘zga asoslangan skor, \(s_{stat}\) — statistik klaster skori, \(s_{llm}\) — ixtiyoriy katta til modeli skori. \(w\) qiymatlar signal og‘irliklari, \(c\) qiymatlar esa har bir signalning ishonch koeffitsiyentidir.
Bu tuzilma tizimni faqat bitta usulga bog‘lab qo‘ymaydi. Ba’zi davrlarda so‘zlik signali yaxshiroq ishlashi mumkin, boshqa paytda statistik klaster signali ko‘proq ma’no kasb etishi mumkin.
9. Yuz bergan narx reaksiyasi bilan kalibrlash
Tizim yangilikdan keyin yuz bergan narx harakatini hisoblab, signallarni tekshiradi:
Bu yerda \(ES_{snapshot}\) — yangilik kelgan paytdagi ES narxi, \(ES_{current}\) — kalibrlash vaqtida kuzatilgan ES narxi. Bu qiymat yangilikdan keyin bozor qaysi yo‘nalishda harakatlanganini taxminan ko‘rsatadi.
10. Og‘irliklarning o‘zini yangilashi
Har bir signalning so‘nggi davrda yuz bergan narx harakati bilan qanchalik mos kelgani Spearman korrelyatsiyasi bilan o‘lchanadi. So‘ng og‘irliklar yangilanadi:
Bu yerda \(\rho_k\) — tegishli signalning yuz bergan narx harakati bilan korrelyatsiyasini bildiradi. Formulada \(0.05\) bazaviy qiymat sifatida ishlatilishi hech bir signal tizimdan butunlay chiqarib yuborilmasligini ta’minlaydi. Shu bilan model xilma-xillik ulushini saqlab qoladi.
11. Signal-shovqin nisbati
Tadqiqotda ensemble skori yuz bergan harakatlarni qanchalik tushuntirishini jamlovchi sodda signal-shovqin o‘lchovi ham beriladi:
Bu qiymat ensemble skorining yuz bergan narx harakatidagi dispersiyaning qanchalik qismini tushuntira olishi haqida taxminiy tasavvur beradi.
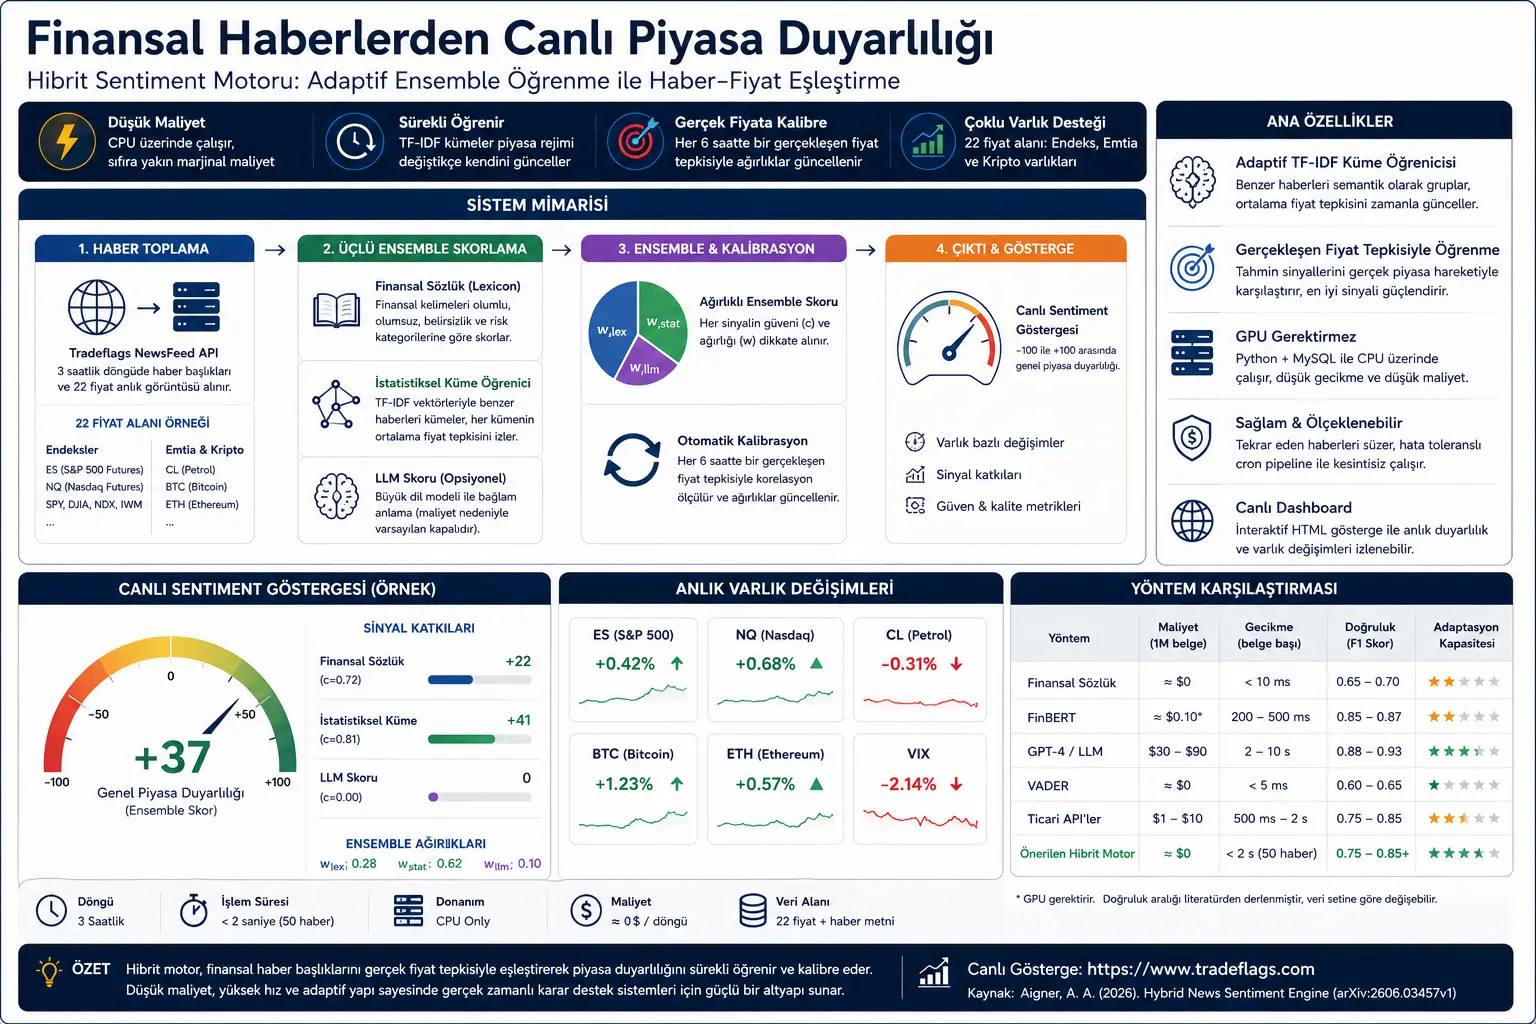
Grafik, jadval va sxemaning asosiy mazmuni
Tadqiqotdagi arxitektura sxemasi tizimni uch bosqichli ma’lumot oqimi sifatida ko‘rsatadi: yangilikni qabul qil, skorla, so‘ng yuz bergan narx reaksiyasiga qarab kalibrlа. Bu tuzilma klassik kayfiyat tahlilidan farq qiladi. Chunki tizim faqat yangilikning “til ohangi”ni emas, balki yangilikdan keyin bozor nima qilganini ham kuzatadi.
Jonli indikator sxemasi foydalanuvchi ko‘radigan chiqishni soddalashtiradi. Asosiy indikator umumiy bozor kayfiyatini \(-100\) dan \(+100\) gacha ko‘rsatadi. Shuningdek, so‘zlik skori, statistik klaster skori va LLM skori alohida beriladi. ES, Nasdaq, neft va Bitcoin kabi aktivlarning joriy foiz o‘zgarishlari ham indikatorga qo‘shiladi.
Taqqoslash jadvalining asosiy xabari esa xarajat, kechikish va moslashuvchanlik o‘rtasidagi farqdir. Tadqiqotga ko‘ra, FinBERT va LLM asosidagi yondashuvlar kuchliroq til tushunish imkoniyatiga ega bo‘lishi mumkin, ammo ular GPU, API xarajati yoki yuqoriroq kechikish talab qiladi. Taklif etilgan tizim esa yengilroq, arzonroq va bozor reaksiyasiga qarab o‘zini yangilay oladigan muqobil sifatida taqdim etiladi.
Tajribalar qanday o‘tkazilgan?
Tizim Tradeflags NewsFeed API orqali kelgan yangilik sarlavhalari va bir vaqtning o‘zida qayd etilgan narx snapshotlaridan foydalanadi. Har bir yangilik elementida sarlavha, manba, tavsif, havola va chop etilgan vaqt kabi matn maydonlari bilan birga ES, NQ, SPY, DJIA, IWM, neft, Bitcoin va Ethereum kabi aktivlarning narx va foiz o‘zgarish maydonlari mavjud.
Ma’lumot oqimi uch soatlik sikllar bilan ishlaydigan tarzda loyihalangan. Birinchi bosqichda yangiliklar olinadi va takroriy sarlavhalar ajratib tashlanadi. Ikkinchi bosqichda yangiliklar so‘zlik, statistik klaster va ixtiyoriy LLM usuli bilan skorlanadi. Uchinchi bosqichda tizim ma’lum oraliqlarda o‘tmishdagi skorlarni yuz bergan narx harakatlari bilan solishtiradi va ensemble og‘irliklarini yangilaydi.
Tadqiqotda ishlatilgan dasturiy stack juda yengil. Python, MySQL va bir nechta asosiy paketlar bilan ishlaydi. Chuqur o‘rganish kutubxonasi, GPU yoki katta model yuklab olish majburiyati yo‘q. Bu tizimni kichik serverlarda ham ishlatish mumkinligini anglatadi.
Natijalar nimani ko‘rsatadi?
Tadqiqot natijalari tizimning uchta asosiy ustunligini ko‘rsatadi: past xarajat, tez ishlash va moslashuvchanlik.
Tizim 50 ta yangilikdan iborat to‘plamni ikki soniyadan kam vaqt ichida qayta ishlashga mo‘ljallangan. So‘zlik asosidagi skorlagich sarlavha boshiga millisekunddan kam vaqt sarflaydi. TF-IDF vektorlash va klaster qidiruvi ham CPUda past kechikish bilan yakunlanadi.
Tadqiqot GPT-4 kabi katta til modeli asosidagi usullar yuqoriroq aniqlik potensialiga ega bo‘lishi mumkinligini tan oladi. Biroq bu usullarning xarajat va kechikish bo‘yicha ishlab chiqarish muhitida har doim mos kelmasligini ta’kidlaydi. Taklif etilgan tizimning maqsadi eng kuchli til modelini yengish emas, balki real vaqtli va past xarajatli bozor kayfiyati infratuzilmasini qurishdir.
Eng muhim hissa adaptiv TF-IDF klaster o‘rganuvchisidir. Tizim o‘xshash yangilik sarlavhalarini bir semantik hududda to‘playdi va shu hududlarning o‘rtacha narx reaksiyasini vaqt o‘tishi bilan yangilab boradi. Bozor rejimi o‘zgarganda, masalan “foiz oshishi” kabi iboraning narx ta’siri boshqacha bo‘lib qolsa, klasterning o‘rtacha narx reaksiyasi ham asta-sekin o‘zgaradi.
Nega bu muhim?
Moliyaviy yangilik tahlili shunchaki matn tasniflash muammosi emas. Bozor nuqtayi nazaridan asosiy savol shuki: bu xabar haqiqatan ham narxlardagi harakat bilan bog‘liqmi?
Ushbu tadqiqot moliyaviy kayfiyat tahlilini bozor voqealari bilan bog‘lashga urinishi sababli muhimdir. Agar sarlavha til jihatidan ijobiy ko‘rinsa-yu, ammo bozor reaksiyasi bo‘lmasa, bu signal savdo nuqtai nazaridan zaif bo‘lishi mumkin. Aksincha, til jihatidan neytral ko‘ringan ayrim sarlavhalar muayyan bozor sharoitlarida kuchli narx reaksiyasi keltirib chiqarishi mumkin.
Bu yondashuv ayniqsa yangilikka asoslangan qaror qabul qilish tizimlari, bozor panellari, moliyaviy ma’lumot platformalari va past xarajatli tahlil vositalari uchun foydalidir. Katta modellarning narxi baland bo‘lgan muhitlarda yengil, ammo o‘zini kalibrlay oladigan statistik tizimlar amaliy muqobil bo‘lishi mumkin.
E’tibor berish kerak bo‘lgan jihatlar
Tadqiqot preprint hisoblanadi. Shuning uchun natijalar mustaqil tekshiruv va kengroq ma’lumot to‘plamlari bilan qo‘llab-quvvatlanishi kerak.
Tizim yangilik bilan narx harakati o‘rtasida korrelyatsiyani topadi, ammo sababiyatni isbotlamaydi. Narx harakati yangilik tufayli bo‘lgan bo‘lishi mumkin, biroq ayni vaqt oralig‘ida boshqa bozor hodisasi ham ta’sir qilgan bo‘lishi ehtimoldan xoli emas.
Yuz bergan narx reaksiyasini o‘lchash taxminiy usulga asoslangan. Tadqiqotda bu holat aniq cheklov sifatida qayd etiladi. Aniqroq natijalar uchun 1 daqiqa, 5 daqiqa yoki 15 daqiqalik oldinga qarab nozik tick ma’lumotlari kerak bo‘ladi.
Statistik klaster o‘rganuvchisi sovuq boshlanish muammosiga duch keladi. Yetarli miqdorda yangilik to‘planmaguncha klaster markazlari va o‘rtacha narx reaksiyalari ishonchli bo‘lmasligi mumkin.
Tizim hozirgi ko‘rinishda inglizcha moliyaviy yangiliklar uchun mo‘ljallangan. O‘zbekcha yangiliklarda shunga o‘xshash natija olish uchun o‘zbekcha moliyaviy so‘zlik, o‘zbekcha tokenlash va alohida kalibrlash kerak bo‘ladi.
Bu maqola investitsion tavsiya emas. Yangilik kayfiyati skorlarining o‘zi savdo qarori qabul qilish uchun yetarli emas.
Xulosa
Ushbu tadqiqot moliyaviy yangilik kayfiyati tahlilida qimmat va og‘ir modellar tashqarisida ham qo‘llash mumkin bo‘lgan yo‘llar borligini ko‘rsatadi. Taklif etilgan tizim moliyaviy so‘zlikni, adaptiv TF-IDF klaster o‘rganishni va yuz bergan narx reaksiyasiga qarab ensemble kalibrlashni birlashtiradi.
Eng e’tiborga molik g‘oya shundaki, kayfiyat tahlili faqat matnning til ma’nosi bilan cheklanib qolmasligi kerak. Tizim yangilik sarlavhalarini bozorning real javobi bilan moslashtirib, “bu turdagi yangiliklar o‘tmishda qanday narxlangan edi?” degan savolga javob izlaydi.
Verianla nuqtayi nazaridan ushbu ishning asosiy xabari shuki: moliyaviy sun’iy intellekt har doim ulkan modellar va qimmat infratuzilma talab qilishi shart emas. To‘g‘ri loyihalangan yengil statistik usullar, ayniqsa jonli ma’lumot oqimida va past xarajatli tizimlarda kuchli qaror-qo‘llab-quvvatlash qatlamini yaratishi mumkin.
Manba va usul izohi
Bu mazmun Hybrid News Sentiment Engine: Real-Time Market Analysis via Adaptive Ensemble Learning on News–Price Pairs nomli akademik PDF asosida tayyorlangan. Matn so‘zma-so‘z tarjima emas. Ishning maqsadi, usuli, asosiy formulalari, tizim arxitekturasi, natijalari va cheklovlari Verianla o‘quvchilari uchun soddalashtirilgan, original va tahririy o‘zbek tilida qayta bayon qilingan.
Formulalar tadqiqotdagi asosiy matematik tuzilmaga sodiq qolgan holda MathJaxga mos LaTeX formatida berilgan. Matn investitsion tavsiya, oldi-sotdi tavsiyasi yoki jonli savdo tizimi taklifi emas.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan