

1. Kichwa
Makala haya yametayarishwa kuhusu mfumo mseto unaojaribu kuzalisha hisia za soko kutoka kwa vichwa vya habari za kifedha. Utafiti uliochunguzwa una kichwa Hybrid News Sentiment Engine: Real-Time Market Analysis via Adaptive Ensemble Learning on News–Price Pairs na umechapishwa kama uchapishaji wa awali kwenye arXiv.
Madai ya kimsingi ya utafiti ni haya: Uchambuzi wa hisia za habari za kifedha haupaswi kuishia tu katika kuhesabu maneno "chanya" au "hasi". Je, kichwa cha habari kilileta athari kwenye soko au la? Ili kujibu swali hili, mfumo hulinganisha vichwa vya habari na picha za bei kwa wakati mmoja kisha husasisha yenyewe kwa kulinganisha ishara za utabiri na mienendo halisi ya bei iliyotokea.
Utafiti huu unavutia sana kwa sababu unapendekeza injini nyepesi zaidi ya hisia za soko inayofanya kazi kwenye CPU, bila kuhitaji modeli kubwa ya lugha au GPU. Hata hivyo, matokeo hayapaswi kusomwa moja kwa moja kama ishara ya kununua/kuuza au ushauri wa uwekezaji. Mfumo hujaribu kunasa uwiano kati ya habari na mwendo wa bei; lakini hauthibitishi kwa hakika kwamba habari ndiyo iliyosababisha mwendo wa bei.
Utafiti mpya wa kitaaluma unapendekeza injini mseto ya hisia za soko inayoambatana na vichwa vya habari za kifedha kwa kulinganisha na mienendo ya bei katika muda halisi. Mfumo huu unachanganya kamusi ya maneno ya kifedha, upangaji wa habari unaobadilika unaotegemea TF-IDF, na muundo wa mkusanyiko unaosasisha uzani kulingana na mwitikio halisi wa bei. Sehemu inayovutia zaidi ni kwamba inaweza kufanya kazi kwenye CPU bila kuhitaji GPU au miito ghali ya modeli kubwa ya lugha, na inaweza kujirekebisha wakati mfumo wa soko unabadilika.
2. Muhtasari mfupi
Masoko ya kifedha hulishwa kila siku na vichwa vya habari, taarifa za kampuni, ujumbe wa benki kuu, data za kiuchumi, na mitandao ya kijamii. Washiriki wa soko hutafsiri habari hizi na bei mara nyingi husonga kulingana na tafsiri hizi. Hata hivyo, si rahisi kupima jinsi habari zinavyopokelewa kikweli katika soko.
Uchambuzi wa kawaida wa hisia kwa kawaida huainisha maandishi kama chanya, hasi, au upande wowote. Kwa mfano, maneno kama "ukuaji", "kasi", "faida" ni chanya; maneno kama "kushuka", "kufilisika", "kuzorota kwa uchumi" yanachukuliwa kuwa hasi. Lakini katika masoko ya kifedha, muktadha ni muhimu sana. "Ongezeko la riba" linaweza kuonekana kuwa hasi katika vipindi fulani, huku likifasiriwa kama ishara ya uchumi imara katika kipindi kingine.
Miundo mikubwa ya lugha inaweza kunasa muktadha huu vizuri zaidi. Hata hivyo, gharama, ucheleweshaji, na utegemezi wa API katika mazingira ya uzalishaji ya miundo ya darasa la GPT huleta tatizo kubwa. Pia, miundo iliyofunzwa mapema inaweza kupitwa na wakati masimulizi ya soko yanapobadilika. Hapa ndipo utafiti huu unapoanzia: Je, inawezekana kujenga mfumo wa hisia za habari ulio wa bei nafuu, wa haraka zaidi, na unaoweza kujisasisha kulingana na mwitikio wa bei?
3. Maelezo ya kina
Mfumo uliopendekezwa katika utafiti huu unachanganya ishara kuu tatu.
Ishara ya kwanza inategemea kamusi ya maneno iliyoandaliwa kwa uwanja wa kifedha. Sehemu hii inahesabu maneno chanya, hasi, yanayoashiria kutokuwa na uhakika na hatari za kisheria kwenye kichwa cha habari. Inafanana na mbinu za kawaida zinazotegemea maneno; lakini imepanuliwa na istilahi maalum kwa maandishi ya kifedha.
Ishara ya pili ni sehemu ya kipekee zaidi ya utafiti. Mfumo hubadilisha vichwa vya habari kuwa vekta kwa kutumia mbinu ya TF-IDF na kuziweka pamoja zile zinazofanana. Kisha hufuatilia jinsi kila kundi la habari lilivyolingana na mwitikio wa wastani wa bei hapo awali. Kwa mfano, vichwa vya habari vinavyofanana kama "matarajio ya kushuka kwa riba", "hatari ya usambazaji wa mafuta" au "kupanda kwa hisa za teknolojia" vinaweza kukusanywa katika ujirani mmoja wa kisemantiki kadiri muda unavyopita. Ikiwa mwitikio wa bei wa kundi hili utabadilika, tafsiri ya hisia ya mfumo pia hubadilika.
Ishara ya tatu ni alama ya hiari ya modeli kubwa ya lugha. Katika utafiti, ishara ya LLM inasaidiwa katika usanifu; lakini imezimwa kwa chaguomsingi kwa sababu ya gharama. Muundo halisi umeundwa kufanya kazi kwenye CPU na kamusi ya kifedha na mjifunzaji wa kundi wa takwimu.
Katika hatua ya mwisho, ishara hizi huwa ensemble yaani alama iliyojumuishwa. Kwa vipindi maalum, mfumo hulinganisha alama za hisia zilizozalishwa hapo awali na mienendo halisi ya bei. Ishara yoyote iliyofanya kazi vyema katika kipindi cha hivi karibuni, uzito wake huongezwa. Hivyo, mfumo hujaribu kuendana si tu na maana ya kilugha ya maandishi, bali pia na mwitikio wa kweli wa soko kwa maandishi hayo.
4. Mbinu na matokeo ya utafiti
Fomula katika utafiti zinaonyesha jinsi mchakato wa kuzalisha alama ya hisia kutoka kwa kichwa cha habari umeundwa. Fomula zinaweza kugawanywa katika makundi makuu matatu: alama kulingana na maneno, upangaji wa TF-IDF, na urekebishaji wa mkusanyiko kulingana na mwitikio wa bei.
1. Alama ya neno la kifedha
Fomula ya kwanza huzalisha alama ya kamusi kwa kuhesabu maneno chanya na hasi ya kifedha katika kichwa cha habari:
Hapa \(P\) inawakilisha idadi ya maneno chanya; \(N\), idadi ya maneno hasi; \(U\), idadi ya maneno yanayoonyesha kutokuwa na uhakika; \(C\), idadi ya maneno yanayoashiria hatari ya kisheria au madai. \(|T|\) ni jumla ya ishara, yaani, idadi ya maneno/vipande kwenye kichwa cha habari.
Kwenye fomula, maneno hasi yanaadhibiwa zaidi kwa kizio cha \(1.2\). Hii ni kwa sababu, katika masoko ya kifedha, habari mbaya mara nyingi zinaweza kuunda athari yenye nguvu zaidi ya bei kuliko habari njema sawa. Matokeo yanabanwa kati ya \(-1\) na \(+1\). Hivyo alama haikui bila kudhibitiwa katika habari fupi sana au zilizopitiliza.
2. Imani ya alama ya kamusi
Haitoshi kwa mfumo kuzalisha alama pekee; inakokotoa pia kiasi cha kuaminika kwa alama hii:
Fomula hii inahakikisha kwamba uaminifu unaongezeka kadiri idadi ya maneno yanayolingana na kamusi ya kifedha inavyoongezeka kwenye kichwa cha habari. Ikiwa kichwa cha habari ni dhaifu kwa upande wa istilahi za kifedha, alama ya kamusi huingia kwenye mkusanyiko kwa uaminifu mdogo.
3. TF-IDF: Kubadilisha vichwa vya habari kuwa vekta za nambari
Mfumo huchukulia vichwa vya habari sio tu kama orodha ya maneno, bali pia kama vekta za nambari. TF-IDF hutumika kwa hili:
Hapa \(TF_i(t)\) inaonyesha mara ngapi neno \(t\) linatokea kwenye kichwa husika. \(IDF(t)\) hupima jinsi neno hilo lilivyo la kipekee kati ya vichwa vyote. Maneno ya jumla yanayotokea mara kwa mara hupata uzito mdogo, huku maneno maalum na ya kipekee yakipata uzito mkubwa zaidi.
Muwakilisho wa vekta wa kichwa cha habari huundwa kama ifuatavyo:
Hapa \(V\) inawakilisha msamiati uliochaguliwa na mfumo. Inasemekana katika utafiti kuwa kamusi iliyojumuisha maneno 2000 ya kwanza ya kipekee zaidi ilitumika.
4. Kuweka habari zinazofanana kwenye kundi
Mfumo hutumia ufanano wa kosini (cosine similarity) kulinganisha kichwa kipya cha habari na makundi ya habari yaliyoundwa awali:
Hapa \(v_i\) ni vekta ya TF-IDF ya kichwa kipya cha habari. \(\mu_j\) ni vekta ya kati ya kundi \(C_j\). Iwapo thamani ya ufanano inazidi kikomo fulani, habari huongezwa kwenye kundi la karibu zaidi. Katika utafiti, kikomo hiki kimetolewa kama \(\theta=0.35\).
Katikati ya kundi huwakilishwa na wastani wa vekta zilizomo kwenye kundi hilo:
Kupitia muundo huu, mfumo unaweza kuongeza habari mpya kwenye makundi yaliyopo bila kutoa mafunzo kwa data zote tangu mwanzo. Ikiwa habari haifanani vya kutosha na makundi yaliyopo, kundi jipya huundwa.
5. Makundi kujifunza mwitikio wa bei
Kila kundi la habari huhifadhi mwitikio wa wastani wa bei wa habari zilizoingia kwenye kundi hilo hapo awali:
Hapa \(ES_j\) inawakilisha mwitikio wa wastani wa bei kwenye upande wa miamala ya hatima ya S&P 500 kwa kundi husika la habari; \(NQ_j\) inawakilisha mwitikio wa wastani wa bei kwa upande wa miamala ya hatima ya Nasdaq. Katika utafiti, imeelezwa kuwa mfumo unaweza kufuatilia maeneo mengi ya bei kwa madarasa tofauti ya mali.
6. Alama ya hisia ya takwimu
Ikiwa kichwa kipya cha habari kinalingana na kundi, mwitikio wa bei wa zamani wa kundi hilo hutumika kama alama ya hisia ya takwimu:
Fomula hii inabadilisha mwitikio wa wastani wa ES wa zamani wa kundi ambalo habari ililingana vizuri zaidi kuwa katika masafa ya \(-1\) na \(+1\). Ikiwa habari haifanani vya kutosha na kundi lolote, alama ya takwimu inachukuliwa kuwa ya upande wowote.
7. Ubora wa kundi: Kipimo kama cha Sharpe
Katika utafiti, kipimo cha ubora kama cha Sharpe pia kinatumika kupima uaminifu wa kila kundi:
Fomula hii inagawanya mwitikio wa wastani wa bei ya kundi kwa uthabiti wa miitikio hiyo. Ikiwa kundi linazalisha mwitikio wa bei kila mara kwa mwelekeo uleule, thamani yake inakuwa na maana zaidi. Makundi yenye kelele hupata umuhimu mdogo ndani ya mkusanyiko au hupunguzwa.
8. Alama ya mkusanyiko: Kuchanganya ishara tatu
Alama ya mwisho ya hisia ya mfumo ni mchanganyiko wenye uzito wa ishara tofauti:
Hapa \(s_{lex}\) inawakilisha alama kulingana na maneno; \(s_{stat}\), alama ya kundi la takwimu; \(s_{llm}\), alama ya hiari ya modeli kubwa ya lugha. Thamani za \(w\) ni uzani wa ishara, na thamani za \(c\) ni kizio cha uaminifu wa kila ishara.
Kupitia muundo huu, mfumo haukosi kutegemea mbinu moja pekee. Katika baadhi ya vipindi, ishara ya kamusi inaweza kufanya kazi vizuri zaidi, na katika vipindi vingine, ishara ya kundi la takwimu inaweza kuwa na maana zaidi.
9. Urekebishaji na mwitikio halisi wa bei
Mfumo huchunguza ishara kwa kukokotoa mwendo wa bei uliotokea baada ya habari kufika:
Hapa \(ES_{snapshot}\) inawakilisha bei ya ES wakati habari zilipofika; \(ES_{current}\) inawakilisha bei ya ES wakati wa urekebishaji. Thamani hii inatoa uchunguzi wa makadirio ya uelekeo gani soko lilisonga baada ya habari.
10. Kujisasisha kwa uzani
Jinsi kila ishara inavyoendana na mwendo wa bei wa hivi majuzi hukokotolewa kwa uwiano wa Spearman. Kisha uzani husasishwa:
Hapa \(\rho_k\) inawakilisha uwiano wa ishara husika na mwendo halisi wa bei. Matumizi ya thamani ya msingi ya \(0.05\) kwenye fomula yanahakikisha kuwa hakuna ishara inayoachwa nje ya mfumo kabisa. Hivyo mtindo huhifadhi kiasi chake cha utofauti.
11. Uwiano wa ishara-kelele
Katika utafiti, kipimo rahisi cha ishara-kelele pia kinatolewa, kinachofupisha jinsi alama ya mkusanyiko inavyofafanua mienendo iliyotokea:
Thamani hii inatoa wazo la makadirio ya kiasi gani cha utofauti katika mwendo halisi wa bei alama ya mkusanyiko inaweza kueleza.
5. Maelezo ya chanzo na mbinu
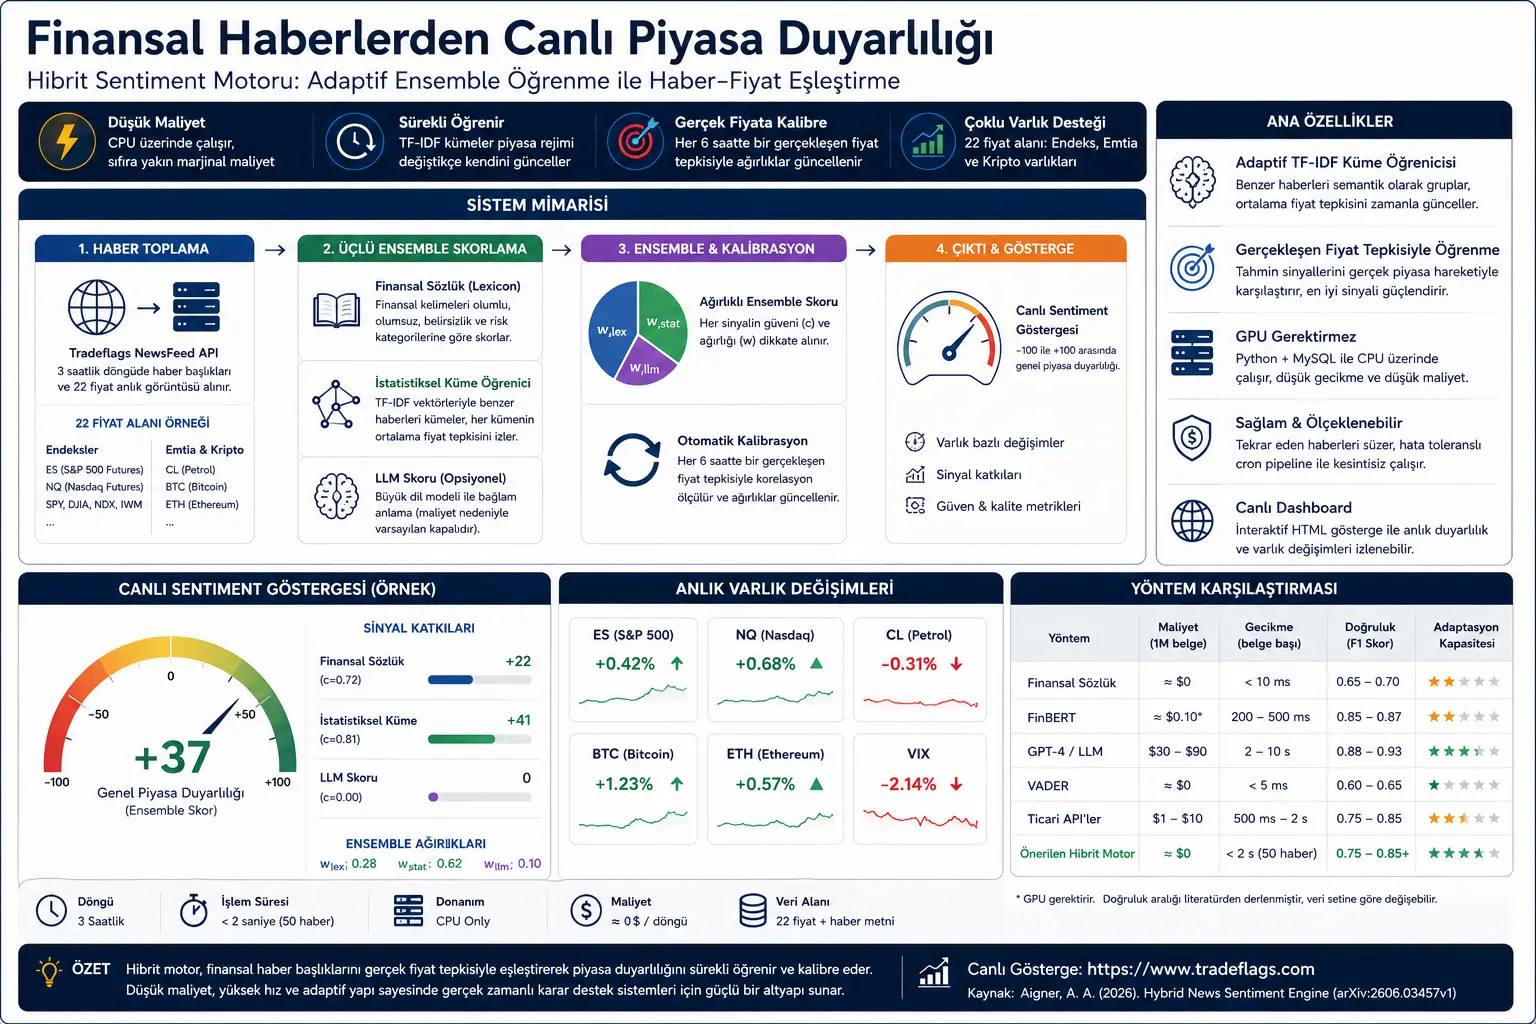
Mchoro wa usanifu katika utafiti unaelezea mfumo kama bomba la data lenye hatua tatu: ingiza habari, ipe alama, kisha irekebishe kulingana na mwitikio halisi wa bei. Muundo huu ni tofauti na uchambuzi wa kawaida wa hisia. Hii ni kwa sababu mfumo haufuatilii tu "sauti ya kilugha" ya habari, bali pia kile ambacho soko hufanya baada ya habari.
Mchoro wa kiashiria cha moja kwa moja hurahisisha matokeo ambayo mtumiaji ataona. Katika kiashiria kikuu, hisia za jumla za soko zinaonyeshwa kati ya \(-100\) na \(+100\). Zaidi ya hayo, alama kulingana na maneno, alama ya kundi la takwimu, na alama ya LLM zinawasilishwa kando. Mabadiliko ya papo hapo ya asilimia ya mali kama ES, Nasdaq, mafuta na Bitcoin pia yanaongezwa kwenye kiashiria.
Ujumbe mkuu wa jedwali la ulinganisho ni tofauti kati ya gharama, ucheleweshaji, na uwezo wa kubadilika. Kulingana na utafiti, FinBERT na mbinu zinazotegemea LLM zinaweza kuwa na uwezo mkubwa wa kuelewa lugha; lakini zinaweza kuhitaji GPU, gharama ya API, au ucheleweshaji mkubwa zaidi. Mfumo uliopendekezwa, kwa upande mwingine, umewekwa kama mbadala mwepesi zaidi, wa bei nafuu zaidi, na unaoweza kujisasisha kulingana na mwitikio wa soko.
6. Lebo za meta
Mfumo unatumia vichwa vya habari kutoka Tradeflags NewsFeed API na picha za bei zilizorekodiwa kwa wakati mmoja. Katika kila kipengee cha habari, pamoja na sehemu za maandishi kama vile kichwa, chanzo, maelezo, kiungo, na wakati wa uchapishaji; kuna sehemu za bei na mabadiliko ya asilimia ya mali kama vile ES, NQ, SPY, DJIA, IWM, mafuta, Bitcoin, na Ethereum.
Bomba la data limeundwa kufanya kazi katika mizunguko ya saa tatu. Katika hatua ya kwanza, habari zinapokelewa na vichwa vinavyojirudia vinaondolewa. Katika hatua ya pili, habari zinapewa alama kwa kutumia kamusi ya maneno, kundi la takwimu, na mbinu ya hiari ya LLM. Katika hatua ya tatu, mfumo hulinganisha mara kwa mara alama za awali na mienendo halisi ya bei na husasisha uzani wa mkusanyiko.
Kundi la programu zinazotumika katika utafiti ni jepesi kiasi. Inafanya kazi na Python, MySQL, na vifurushi vichache vya msingi. Hakuna maktaba ya kujifunza kwa kina, GPU, au wajibu wa kupakua modeli kubwa. Hii hufanya mfumo kuweza kufanya kazi kwenye seva ndogo.
Matokeo Yanaonyesha Nini?
Matokeo ya utafiti yanaangazia faida tatu za kimsingi za mfumo uliopendekezwa: gharama nafuu, uendeshaji wa haraka, na uwezo wa kubadilika.
Mfumo umeundwa kufanya kazi chini ya sekunde mbili katika mchakato wa makundi wa habari 50. Mtoaji alama wa maneno hufanya kazi kwa chini ya milisekunde kwa kila kichwa cha habari. Uwekwaji vekta wa TF-IDF na utafutaji wa kundi pia hukamilishwa kwa ucheleweshaji mdogo kwenye CPU.
Utafiti unakubali kwamba mbinu zinazotegemea modeli kubwa ya lugha kama GPT-4 zinaweza kuwa na uwezo mkubwa wa usahihi. Hata hivyo, unasisitiza kwamba mbinu hizi huenda zisiwe zinafaa kila wakati katika mazingira ya uzalishaji kwa upande wa gharama na ucheleweshaji. Lengo la mfumo uliopendekezwa si tu kushinda modeli yenye nguvu zaidi ya lugha, bali kuunda miundombinu ya hisia za soko kwa muda halisi na kwa gharama nafuu.
Mchango muhimu zaidi ni mjifunzaji wa kundi la TF-IDF linalobadilika. Mfumo hukusanya vichwa vya habari vinavyofanana katika ujirani mmoja wa kisemantiki na kusasisha mwitikio wa wastani wa bei wa mijirani hiyo kadiri muda unavyopita. Mfumo wa soko unapobadilika, kwa mfano, ikiwa athari ya bei ya usemi kama "ongezeko la riba" inatofautiana, mwitikio wa wastani wa bei wa kundi pia hubadilika hatua kwa hatua.
Kwa Nini Hii Ni Muhimu?
Uchambuzi wa habari za kifedha si tatizo tu la uainishaji wa maandishi. Kwa mtazamo wa soko, swali kuu na muhimu ni hili: Je, habari hii ina uhusiano wa kweli na mwendo kwenye bei?
Utafiti huu ni muhimu kwa sababu unajaribu kuunganisha uchambuzi wa hisia za kifedha na uhalisia wa soko. Hata kama kichwa cha habari kinaonekana chanya kilugha, ikiwa soko halikuitikia, ishara hii inaweza kuwa dhaifu kwa upande wa miamala. Kinyume chake, baadhi ya vichwa vya habari vinavyoonekana kutokuwa na upande wowote kilugha vinaweza kuzaa mwitikio mzito wa bei katika hali fulani za soko.
Mbinu hii inathaminiwa hasa kwa mifumo ya usaidizi wa uamuzi inayotegemea habari, paneli za soko, majukwaa ya data za kifedha, na zana za uchambuzi za gharama nafuu. Katika mazingira ambayo miundo mikubwa ni ghali, mifumo ya kitakwimu iliyo nyepesi lakini yenye uwezo wa kujirekebisha inaweza kutoa mbadala wa kivitendo.
Mambo ya Kuzingatia
Utafiti huu uko katika hali ya uchapishaji wa awali. Kwa hivyo, matokeo yanahitaji uthibitisho wa kujitegemea na kuungwa mkono na seti pana zaidi za data.
Mfumo unanasa uwiano kati ya habari na mwendo wa bei; lakini hauthibitishi visababishi. Mwendo wa bei huenda umesababishwa na habari, lakini tukio jingine la soko linaweza pia kuwa na athari katika kipindi hicho cha wakati.
Kipimo cha mwendo halisi wa bei kilifanywa kwa mbinu ya makadirio. Katika utafiti, hili linaelezwa wazi kuwa kizuizi. Kwa matokeo sahihi zaidi, data nyeti ya mbele (tick data) ya dakika 1, dakika 5, au dakika 15 inahitajika.
Mjifunzaji wa kundi la takwimu hukumbwa na tatizo la kuanza kwa baridi (cold start problem). Kabla idadi ya kutosha ya habari haijakusanywa, vituo vya kundi na miitikio ya wastani ya bei huenda isiaminike.
Katika hali yake ya sasa, mfumo umeundwa kwa habari za kifedha za Kiingereza. Ili kutarajia utendaji sawa katika habari za Kituruki, kamusi ya kifedha ya Kituruki, utambulisho (tokenization) wa Kituruki, na urekebishaji tofauti vinahitajika.
Makala haya sio ushauri wa uwekezaji. Alama za hisia za habari peke yake hazitoshi kufanya uamuzi wa muamala.
Hitimisho
Utafiti huu unaonyesha kwamba kuna njia mbadala zinazowezekana za uchambuzi wa hisia za habari za kifedha kando na miundo ghali na nzito. Mfumo uliopendekezwa unaunganisha kamusi ya maneno ya kifedha, ujifunzaji unaobadilika wa kundi la TF-IDF, na urekebishaji wa mkusanyiko kulingana na mwitikio halisi wa bei.
Wazo linalovutia zaidi ni kwamba uchambuzi wa hisia haukomei kwenye maana ya kilugha pekee ya maandishi. Mfumo hutafuta jibu kwa swali "habari za aina hii zilipangiwaje bei siku za nyuma?" kwa kulinganisha vichwa vya habari na mwitikio halisi wa soko.
Kwa upande wa Verianla, ujumbe mkuu wa utafiti huu ni huu: Akili bandia ya kifedha si lazima ihitaji miundo mikubwa na miundombinu ya gharama kubwa kila wakati. Mbinu za kitakwimu nyepesi zilizoundwa ipasavyo zinaweza kuunda tabaka dhabiti la kusaidia maamuzi, hasa katika mtiririko wa data moja kwa moja na mifumo ya gharama nafuu.
Dokezo la Chanzo na Mbinu
Maudhui haya yalitayarishwa kwa kukagua PDF ya kitaaluma yenye kichwa Hybrid News Sentiment Engine: Real-Time Market Analysis via Adaptive Ensemble Learning on News–Price Pairs. Maandishi haya si tafsiri ya neno kwa neno. Madhumuni ya utafiti, mbinu, fomula za kimsingi, usanifu wa mfumo, matokeo, na vikwazo vimesimuliwa upya kwa Kituruki kilichorahisishwa, asilia na cha uhariri kwa wasomaji wa Verianla.
Fomula zimetolewa katika muundo wa LaTeX unaoendana na MathJax, zikifuata muundo wa kimsingi wa kihisabati katika utafiti. Makala haya si ushauri wa uwekezaji, pendekezo la kununua na kuuza, au pendekezo la mfumo wa miamala wa moja kwa moja.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *