

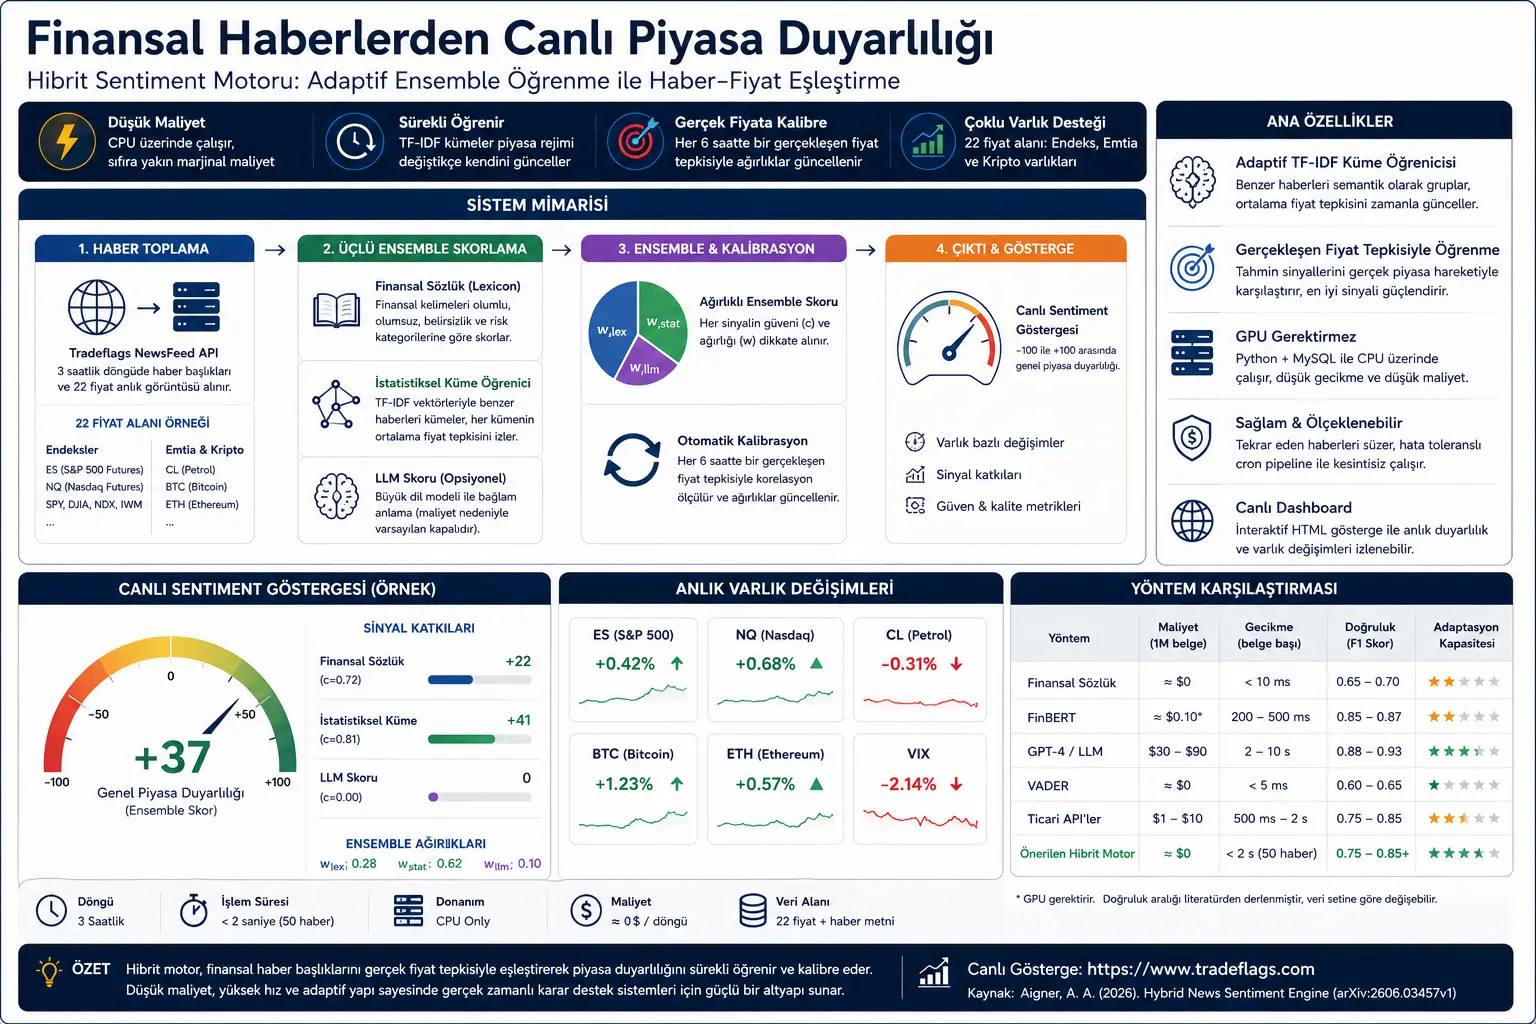
Алдын ала баалоо
Бул макала финансылык жаңылыктардын аталыштарынан рыноктун маанайын өндүрүүгө аракет кылган гибриддик система боюнча даярдалган. Каралып жаткан изилдөө Hybrid News Sentiment Engine: Real-Time Market Analysis via Adaptive Ensemble Learning on News–Price Pairs деп аталат жана arXivде алдын ала басып чыгаруу катары жарыяланган.
Изилдөөнүн негизги ырастоосу төмөнкүдөй: Финансылык жаңылыктардын маанайын талдоо "оң" же "терс" сөздөрдү саноо менен гана чектелбеши керек. Жаңылыктын аталышы чындап эле рынокко таасир эттиби же жокпу? Бул суроого жооп берүү үчүн, система жаңылыктардын аталыштарын бир эле учурдагы баа көрүнүштөрү менен шайкеш келтирет, андан кийин болжолдоо сигналдарын ишке ашкан баа кыймылдары менен салыштырып, өзүн жаңыртат.
Бул изилдөө өзгөчө кызыктуу, анткени ал чоң тил моделине же GPUга муктаж болбостон CPUда иштеген жеңилирээк рыноктук маанай кыймылдаткычын сунуштайт. Бирок жыйынтыктарды түздөн-түз сатып алуу-сатуу сигналы же инвестициялык кеңеш катары окубоо керек. Система жаңылыктар менен баанын кыймылынын ортосундагы корреляцияны кармоого аракет кылат; бирок жаңылык чындап эле баанын өзгөрүшүнө себеп болгонун так далилдей албайт.
Жаңы академиялык изилдөө финансылык жаңылыктардын аталыштарын реалдуу убакыттагы баалардын өзгөрүүсү менен айкалыштырып иштеген гибриддик рыноктук сезим кыймылдаткычын сунуштайт. Система каржылык сөздүктү, TF-IDF негизиндеги адаптивдүү жаңылыктарды топтоону жана ишке ашкан баа реакциясына жараша салмагын жаңырткан ансамбль түзүмүн бириктирет. Эң көрүнүктүү жагы - GPU же кымбат чоң тил моделинин чакыруусун талап кылбастан CPUда иштей алышы жана рыноктук режим өзгөргөн сайын өзүн кайра калибрлөөсү.
Көйгөй эмнеде?
Финансы рыноктору күн сайын жаңылыктардын аталыштары, компаниялардын билдирүүлөрү, борбордук банктардын билдирүүлөрү, экономикалык маалыматтар жана социалдык тармактардын агымдары менен азыктанат. Рыноктун катышуучулары бул жаңылыктарды чечмелейт жана баалар көбүнчө ушул чечмелөөлөргө жараша өзгөрөт. Бирок жаңылыктын рынокто кандайча кабыл алынганын өлчөө оңой эмес.
Классикалык маанай талдоолору көбүнчө текстти оң, терс же бейтарап деп бөлүштүрөт. Мисалы, "өсүү", "ралли", "пайда" сыяктуу сөздөр оң; "төмөндөө", "банкрот", "рецессия" сыяктуу сөздөр терс катары кабыл алынат. Бирок финансы рынокторунда контекст абдан маанилүү. "Пайыздык чендин жогорулашы" кээ бир мезгилдерде терс кабыл алынса, башка мезгилде экономиканын күчтүү экендигинин белгиси катары чечмелениши мүмкүн.
Чоң тил моделдери бул контекстти жакшыраак кармай алат. Бирок GPT классындагы моделдердин баасы, кечигүүсү жана өндүрүш чөйрөсүндөгү API көз карандылыгы олуттуу көйгөй жаратат. Андан тышкары, алдын ала үйрөтүлгөн моделдер рыноктук баяндар өзгөргөндө эскирип калышы мүмкүн. Бул изилдөөнүн башталыш чекити да ушул: Арзаныраак, тезирээк, баа реакциясына жараша өзүн жаңырта алган жаңылыктардын маанай системасын курууга болобу?
Метод эмнени сунуштайт?
Изилдөөдө сунушталган система үч негизги сигналды бириктирет.
Биринчи сигнал финансы тармагы үчүн даярдалган каржылык сөздүккө негизделет. Бул бөлүм жаңылыктын аталышындагы оң, терс, белгисиздикти жана укуктук тобокелдикти туудурган сөздөрдү санайт. Бул классикалык сөзгө негизделген методдорго окшош; бирок финансылык текстке тиешелүү терминдер менен кеңейтилген.
Экинчи сигнал изилдөөнүн эң өзгөчө тарабы. Система жаңылыктардын аталыштарын TF-IDF ыкмасы менен векторлорго айлантып, окшош аталыштарды топтойт. Андан кийин ар бир жаңылыктар тобу өткөндө орточо эсеп менен кандай баа реакциясына дал келгенин көзөмөлдөйт. Мисалы, "пайыздык чендин төмөндөшүн күтүү", "мунай сунушунун тобокелдиги" же "технологиялык акциялардын өсүшү" сыяктуу окшош аталыштар убакыттын өтүшү менен ошол эле семантикалык аймакка топтолушу мүмкүн. Эгерде бул топтун баа реакциясы өзгөрсө, системанын маанайын чечмелөөсү да өзгөрөт.
Үчүнчү сигнал - милдеттүү эмес чоң тил моделинин баллы. Изилдөөдө LLM сигналы архитектурада колдоого алынат; бирок баасына байланыштуу демейки боюнча өчүрүлгөн. Негизги түзүм каржылык сөздүк жана статистикалык кластер үйрөнүүчүсү менен CPUда иштей тургандай иштелип чыккан.
Акыркы этапта бул сигналдар ансамбль, башкача айтканда бирдиктүү балл болуп бириктирилет. Система белгилүү бир аралыкта мурда өндүрүлгөн маанай баллдарын ишке ашкан баа кыймылдары менен салыштырат. Акыркы мезгилде кайсы сигнал жакшыраак иштесе, анын салмагы көбөйтүлөт. Ошентип, система тексттин лингвистикалык маанисине гана эмес, ошондой эле рыноктун ал текстке болгон чыныгы реакциясына да ыңгайлашууга аракет кылат.
Формулалар эмнени түшүндүрөт?
Изилдөөдөгү формулалар жаңылыктын аталышынан маанай баллын өндүрүү процесси кандайча түзүлгөнүн көрсөтөт. Формулаларды үч негизги топко бөлүүгө болот: сөзгө негизделген балл, TF-IDF топтоо жана баа реакциясына жараша ансамблди калибрлөө.
1. Финансылык сөз баллы
Биринчи формула жаңылыктын аталышындагы оң жана терс финансылык сөздөрдү санап, сөздүк баллын өндүрөт:
Бул жерде \(P\), оң сөздөрдүн санын; \(N\), терс сөздөрдүн санын; \(U\), белгисиздикти билдирген сөздөрдүн санын; \(C\), укуктук же соттук тобокелдикти туудурган сөздөрдүн санын көрсөтөт. \(|T|\), аталыштагы жалпы токендердин, б.а. сөздөрдүн/бөлүктөрдүн саны.
Формулада терс сөздөр \(1.2\) коэффициенти менен катуураак жазаланат. Мунун себеби, финансы рынокторунда жаман жаңылыктар көп учурда эквиваленттүү жакшы жаңылыктарга караганда күчтүүрөөк баа таасирин жаратышы мүмкүн. Жыйынтык \(-1\) менен \(+1\) аралыгына кысылат. Ошентип, балл өтө кыска же өтө чектен чыккан жаңылыктарда көзөмөлсүз өспөйт.
2. Сөздүк баллынын ишеними
Системанын балл өндүрүүсү гана жетиштүү эмес; бул баллга канчалык ишенүүгө боло тургандыгы да эсептелет:
Бул формула аталышта финансылык сөздүк менен дал келген сөздөрдүн саны көбөйгөн сайын ишенимдин жогорулашын камсыздайт. Эгерде жаңылыктын аталышы каржылык терминдерге бай болбосо, сөздүк баллы да төмөн ишеним менен ансамблге кирет.
3. TF-IDF: Аталыштарды сандык векторго айландыруу
Система жаңылыктардын аталыштарын сөздөрдүн тизмеси катары гана эмес, сандык векторлор катары да карайт. Бул үчүн TF-IDF колдонулат:
Бул жерде \(TF_i(t)\), \(t\) термининин тиешелүү аталышта канчалык көп кездешээрин көрсөтөт. \(IDF(t)\) болсо ал сөздүн бардык аталыштардын ичинде канчалык айырмалоочу экендигин өлчөйт. Өтө көп кездешкен жалпы сөздөр төмөн салмакка ээ болсо, өзгөчө жана айырмалоочу сөздөр жогорураак салмакка ээ болот.
Аталыштын вектордук көрүнүшү төмөнкүдөй түзүлөт:
Бул жерде \(V\), система тандаган сөз байлыгын билдирет. Изилдөөдө эң айырмалоочу алгачкы 2000 терминден турган сөздүк колдонулгандыгы белгиленет.
4. Окшош жаңылыктарды топко жайгаштыруу
Система жаңы жаңылыктын аталышын мурда түзүлгөн жаңылыктар топтору менен салыштыруу үчүн косинус окшоштугун колдонот:
Бул жерде \(v_i\), жаңы жаңылык аталышынын TF-IDF вектору. \(\mu_j\), \(C_j\) тобунун борбордук вектору. Окшоштук мааниси белгилүү бир босого маанисинен ашса, жаңылык эң жакын топко кошулат. Изилдөөдө бул босого \(\theta=0.35\) катары берилген.
Топтун борбору болсо ошол топко таандык векторлордун орточо мааниси менен көрсөтүлөт:
Бул түзүм аркылуу система бардык маалыматтарды башынан үйрөтпөстөн жаңы жаңылыктарды учурдагы топторго кошо алат. Эгерде жаңылык учурдагы топторго жетишерлик окшош болбосо, жаңы топ түзүлөт.
5. Топтордун баа реакциясын үйрөнүүсү
Ар бир жаңылык тобу өткөндө ал топко кирген жаңылыктардын орточо баа реакциясын сактап турат:
Бул жерде \(ES_j\), тиешелүү жаңылык тобунун S&P 500 фьючерстик транзакция тарабындагы орточо баа реакциясын; \(NQ_j\) болсо Nasdaq фьючерстик транзакция тарабындагы орточо баа реакциясын билдирет. Изилдөөдө системанын ар кандай актив класстары үчүн көптөгөн баа аймактарын көзөмөлдөй алаары белгиленет.
6. Статистикалык маанай баллы
Эгер жаңы жаңылыктын аталышы бир топ менен дал келсе, ал топтун өткөндөгү баа реакциясы статистикалык маанай баллы катары колдонулат:
Бул формула жаңылыктын эң жакшы дал келген тобунун өткөндөгү орточо ES реакциясын \(-1\) менен \(+1\) аралыгына айлантат. Эгер жаңылык эч бир топко жетишерлик окшош болбосо, статистикалык балл бейтарап деп кабыл алынат.
7. Топтун сапаты: Sharpe сыяктуу өлчөм
Изилдөөдө ар бир топтун ишенимдүүлүгүн өлчөө үчүн Sharpe сыяктуу сапат көрсөткүчү да колдонулат:
Бул формула бир топтун орточо баа реакциясын ал реакциялардын туруксуздугуна бөлөт. Эгер топ ырааттуу түрдө бирдей багытта баа реакциясын өндүрсө, анын мааниси маанилүүрөөк болот. Чуулуу топтор болсо ансамблдин ичинде азыраак мааниге ээ болот же кыркылат.
8. Ансамбль баллы: Үч сигналды бириктирүү
Системанын акыркы маанай баллы ар кандай сигналдардын салмакталган бирикмеси болуп саналат:
Бул жерде \(s_{lex}\), сөзгө негизделген баллды; \(s_{stat}\), статистикалык топ баллын; \(s_{llm}\), милдеттүү эмес чоң тил моделинин баллын билдирет. \(w\) маанилери сигналдын салмагы, ал эми \(c\) маанилери ар бир сигналдын ишеним коэффициенти.
Бул түзүм аркылуу система бир гана методго байланбайт. Кээ бир мезгилде сөздүк сигналы жакшыраак иштесе, кээ бир мезгилде статистикалык топ сигналы маанилүүрөөк болуп калышы мүмкүн.
9. Ишке ашкан баа реакциясы менен калибрлөө
Система жаңылык келгенден кийинки ишке ашкан баа кыймылын эсептөө аркылуу сигналдарды текшерет:
Бул жерде \(ES_{snapshot}\), жаңылык келген учурдагы ES баасын; \(ES_{current}\), калибрлөө учурундагы ES баасын билдирет. Бул маани жаңылыктан кийин рыноктун кайсы багытта жылганы боюнча болжолдуу байкоону камсыздайт.
10. Салмактардын өзүн жаңылоосу
Ар бир сигналдын акыркы мезгилдеги ишке ашкан баа кыймылы менен канчалык шайкеш экендиги Spearman корреляциясы менен өлчөнөт. Андан кийин салмактар жаңыртылат:
Бул жерде \(\rho_k\), тиешелүү сигналдын ишке ашкан баа кыймылы менен болгон корреляциясын билдирет. Формулада \(0.05\) базалык маанисинин колдонулушу эч бир сигналдын системадан толук чыгарылбашын камсыздайт. Ошентип модель ар түрдүүлүк үлүшүн сактап калат.
11. Сигнал-ызы-чуу катышы
Изилдөөдө ансамбль баллынын ишке ашкан кыймылдарды канчалык түшүндүрөрүн чагылдырган жөнөкөй сигнал-ызы-чуу өлчөмү да берилет:
Бул маани ансамбль баллынын ишке ашкан баа кыймылындагы дисперсиянын канчасын түшүндүрө ала тургандыгы жөнүндө болжолдуу түшүнүк берет.
График, Таблица жана Схеманын Негизги Билдирүүсү
Изилдөөдөгү архитектуралык схема системаны үч баскычтуу маалымат линиясы катары түшүндүрөт: жаңылыктарды алуу, балл берүү, андан кийин ишке ашкан баа реакциясына жараша калибрлөө. Бул түзүм классикалык маанай талдоосунан айырмаланат. Анткени система жаңылыктын "лингвистикалык тонун" гана эмес, жаңылыктан кийин рыноктун эмне кылганын да көзөмөлдөйт.
Жандуу көрсөткүч схемасы колдонуучу көрө турган натыйжаны жөнөкөйлөтөт. Негизги көрсөткүчтө жалпы рыноктун маанайы \(-100\) менен \(+100\) аралыгында көрсөтүлөт. Андан тышкары сөзгө негизделген балл, статистикалык топ баллы жана LLM баллы өзүнчө сунушталат. ES, Nasdaq, мунай жана Bitcoin сыяктуу активдердин заматта пайыздык өзгөрүүлөрү да көрсөткүчкө кошулат.
Салыштыруу таблицасынын негизги билдирүүсү болсо баа, кечигүү жана ыңгайлашуу жөндөмүнүн ортосундагы айырмачылык болуп саналат. Изилдөөгө ылайык, FinBERT жана LLM негизиндеги ыкмалар тилди түшүнүү жагынан күчтүүрөөк мүмкүнчүлүккө ээ болушу мүмкүн; бирок GPU, API чыгымдарын же жогорураак кечигүүнү талап кылышы мүмкүн. Сунушталган система болсо жеңилирээк, арзаныраак жана рыноктун реакциясына жараша өзүн жаңырта алган альтернатива катары позицияланат.
Эксперименттер кандайча жасалган?
Система Tradeflags NewsFeed API аркылуу келген жаңылыктардын аталыштарын жана бир эле учурда жазылган баалардын заматта көрүнүштөрүн колдонот. Ар бир жаңылык элементинде аталыш, булак, сүрөттөмө, шилтеме жана жарыялоо убактысы сыяктуу тексттик талаалар менен катар; ES, NQ, SPY, DJIA, IWM, мунай, Bitcoin жана Ethereum сыяктуу активдерге тиешелүү баа жана пайыздык өзгөрүү талаалары орун алган.
Маалымат линиясы үч сааттык циклдер менен иштей тургандай иштелип чыккан. Биринчи кадамда жаңылыктар алынат жана кайталанган аталыштар тазаланат. Экинчи кадамда жаңылыктар каржылык сөздүк, статистикалык кластер жана милдеттүү эмес LLM ыкмасы менен бааланат. Үчүнчү кадамда система белгилүү бир аралыкта өткөндөгү баллдарды ишке ашкан баа кыймылдары менен салыштырат жана ансамбль салмактарын жаңыртат.
Изилдөөдө колдонулган программалык камсыздоо стеги абдан жеңил. Ал Python, MySQL жана бир нече негизги пакеттер менен иштейт. Терең үйрөнүү китепканасы, GPU же чоң моделди жүктөө милдеттүүлүгү жок. Бул системаны чакан серверлерде иштетүүгө мүмкүн кылат.
Натыйжалар эмнени көрсөтүп турат?
Изилдөөнүн натыйжалары сунушталган системанын үч негизги артыкчылыгын баса белгилейт: төмөн баа, тез иштөө жана адаптация жөндөмү.
Система 50 жаңылыктан турган партиялык процессте эки секунддан аз убакытта иштей тургандай иштелип чыккан. Сөзгө негизделген баллдоочу ар бир аталыш үчүн миллисекунддан аз убакытта иштейт. TF-IDF векторлоштуруу жана кластердик издөө да CPUда аз кечигүү менен аяктайт.
Изилдөө GPT-4 сыяктуу чоң тил моделине негизделген ыкмалар жогорураак тактык потенциалына ээ болушу мүмкүн экенин кабыл алат. Бирок бул ыкмалар баа жана кечигүү жагынан өндүрүш чөйрөсүндө дайыма эле ылайыктуу боло бербеши мүмкүн экенин баса белгилейт. Сунушталган системанын максаты эң күчтүү тил моделин жеңүү эмес, реалдуу убакытта жана арзан рыноктук маанай инфраструктурасын куруу болуп саналат.
Эң маанилүү салым - адаптивдүү TF-IDF кластер үйрөнүүчүсү. Система окшош жаңылыктардын аталыштарын бир эле семантикалык аймакка топтойт жана бул аймактардын орточо баа реакциясын убакыттын өтүшү менен жаңыртат. Рынок режими өзгөргөн сайын, мисалы, "пайыздык чендин жогорулашы" сыяктуу сөздүн баа таасири айырмаланса, топтун орточо баа реакциясы да акырындык менен өзгөрөт.
Бул эмне үчүн маанилүү?
Финансылык жаңылыктарды талдоо текстти классификациялоо көйгөйү гана эмес. Рынок үчүн эң маанилүү суроо төмөнкүдөй: Бул жаңылык чындап эле баалардын кыймылы менен байланыштуубу?
Бул изилдөө маанилүү, анткени ал финансылык маанай талдоосун рыноктук реалдуулук менен байланыштырууга аракет кылат. Эгер аталыш лингвистикалык жактан оң көрүнсө да рынок реакция кылбаса, бул сигнал транзакция үчүн алсыз болушу мүмкүн. Тескерисинче, лингвистикалык жактан бейтарап көрүнгөн кээ бир аталыштар белгилүү бир рыноктук шарттарда күчтүү баа реакциясын жаратышы мүмкүн.
Бул ыкма өзгөчө жаңылыктарга негизделген чечимдерди колдоо системалары, рыноктук панелдер, финансылык маалымат платформалары жана аз чыгымдуу талдоо куралдары үчүн баалуу. Чоң моделдер кымбат болгон чөйрөлөрдө, жеңил, бирок өзүн-өзү калибрлөөчү статистикалык системалар практикалык альтернатива сунуштай алат.
Көңүл буруу пункттары
Изилдөө алдын ала басып чыгаруу мүнөзүндө. Ошондуктан натыйжалар көз карандысыз тастыктоо жана кеңирирээк маалымат топтомдору менен колдоого алынышы керек.
Система жаңылык менен баа кыймылынын ортосундагы корреляцияны кармайт; бирок себеп-натыйжа байланышын далилдебейт. Баанын өзгөрүшү жаңылыктан улам болушу мүмкүн, бирок ошол эле убакыт аралыгында башка рыноктук окуя да таасирин тийгизиши мүмкүн.
Ишке ашкан баа кыймылын өлчөө болжолдуу ыкма менен жасалган. Изилдөөдө бул жагдай чектөө катары ачык көрсөтүлөт. Тагыраак натыйжалар үчүн 1 мүнөт, 5 мүнөт же 15 мүнөт алдыга багытталган так tick маалыматы талап кылынат.
Статистикалык кластер үйрөнүүчүсү муздак баштоо көйгөйүнө туш болот. Жетиштүү жаңылык топтолмоюнча топтун борборлору жана орточо баа реакциялары ишенимдүү болбой калышы мүмкүн.
Система учурдагы абалында англис тилиндеги финансылык жаңылыктар үчүн иштелип чыккан. Түрк тилиндеги жаңылыктарда окшош натыйжа күтүү үчүн түркчө финансылык сөздүк, түркчө токенизация жана өзүнчө калибрлөө талап кылынат.
Бул макала инвестициялык кеңеш эмес. Жаңылык маанайынын баллдары транзакциялык чечим кабыл алуу үчүн жалгыз өзү жетиштүү эмес.
Жыйынтык
Бул изилдөө финансылык жаңылыктардын маанайын талдоодо кымбат жана оор моделдерден тышкары колдонула турган жолдор бар экенин көрсөтүп турат. Сунушталган система каржылык сөздүктү, адаптивдүү TF-IDF кластерин үйрөнүүнү жана ишке ашкан баа реакциясына жараша ансамблди калибрлөөнү бириктирет.
Эң көрүнүктүү идея - маанайды талдоо тексттин лингвистикалык мааниси менен гана чектелбеши керек. Система жаңылыктардын аталыштарын рыноктун чыныгы реакциясы менен шайкеш келтирип, "мындай жаңылыктар мурун кандайча бааланган?" деген суроого жооп издейт.
Verianla үчүн бул изилдөөнүн негизги билдирүүсү төмөнкүдөй: Финансылык жасалма интеллект дайыма эле эбегейсиз моделдерди жана жогорку чыгымдуу инфраструктураларды талап кылбайт. Туура иштелип чыккан жеңил статистикалык методдор, өзгөчө жандуу маалымат агымында жана арзан системаларда күчтүү чечим кабыл алууну колдоо катмарын түзө алат.
Булак жана Метод Эскертүүсү
Бул мазмун Hybrid News Sentiment Engine: Real-Time Market Analysis via Adaptive Ensemble Learning on News–Price Pairs аттуу академиялык PDFти карап чыгуу менен даярдалган. Текст сөзмө-сөз котормо эмес. Изилдөөнүн максаты, методу, негизги формулалары, системанын архитектурасы, табылгалары жана чектөөлөрү Verianla окурмандары үчүн жөнөкөйлөштүрүлүп, оригиналдуу жана редактордук түрк тили менен кайрадан баяндалган.
Формулалар изилдөөдөгү негизги математикалык түзүмгө ишенимдүү болуу менен MathJax менен шайкеш келген LaTeX форматында берилген. Макала инвестициялык кеңеш, сатып алуу-сатуу сунушу же жандуу соода системасынын сунушу эмес.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген