

İlkin Qiymətləndirmə
Bu yazı maliyyə xəbər başlıqlarından bazar sentimenti yaratmağa çalışan hibrid sistem haqqında hazırlanıb. Araşdırılan tədqiqat Hybrid News Sentiment Engine: Real-Time Market Analysis via Adaptive Ensemble Learning on News–Price Pairs başlığını daşıyır və arXiv-də preprint kimi yayımlanıb.
Tədqiqatın əsas iddiası budur: Maliyyə xəbərlərinin sentiment təhlili yalnız “müsbət” və ya “mənfi” sözləri saymaqla məhdudlaşmamalıdır. Xəbər başlığı həqiqətən bazarda təsir yaratdımı, yaratmadımı? Sistem bu suala cavab verə bilmək üçün xəbər başlıqlarını eyni andakı qiymət görüntüləri ilə uyğunlaşdırır və sonra proqnoz siqnallarını reallaşmış qiymət hərəkətləri ilə müqayisə edərək özünü yeniləyir.
Bu tədqiqat xüsusilə maraqlıdır, çünki böyük dil modeli və ya GPU məcburiyyəti olmadan, CPU üzərində işləyən daha yüngül bazar sentiment mühərriki təklif edir. Lakin nəticələr birbaşa al-sat siqnalı və ya investisiya tövsiyəsi kimi oxunmamalıdır. Sistem xəbər ilə qiymət hərəkəti arasında korrelyasiya tutmağa çalışır; lakin xəbərin qiymət hərəkətinə həqiqətən səbəb olduğunu qəti şəkildə sübut etmir.
Yeni akademik tədqiqat maliyyə xəbər başlıqlarını real vaxt qiymət hərəkətləri ilə uyğunlaşdıraraq işləyən hibrid bazar sentiment mühərriki təklif edir. Sistem maliyyə söz lüğətini, TF-IDF əsaslı adaptiv xəbər klasterləşdirməsini və reallaşmış qiymət reaksiyasına görə çəkiləri yeniləyən ensemble quruluşunu birləşdirir. Ən diqqətçəkici tərəfi GPU və ya bahalı böyük dil modeli çağırışı tələb etmədən CPU üzərində işləyə bilməsi və bazar rejimi dəyişdikcə özünü yenidən kalibrasiya edə bilməsidir.
Problem Nədir?
Maliyyə bazarları hər gün xəbər başlıqları, şirkət açıqlamaları, mərkəzi bank mesajları, iqtisadi göstəricilər və sosial media axınları ilə qidalanır. Bazar iştirakçıları bu xəbərləri şərh edir və qiymətlər çox vaxt bu şərhlərə uyğun hərəkət edir. Lakin bir xəbərin bazarda həqiqətən necə qarşılıq tapdığını ölçmək asan deyil.
Klassik sentiment təhlilləri adətən mətni müsbət, mənfi və ya neytral kimi təsnif edir. Məsələn, “artım”, “ralli”, “mənfəət” kimi sözlər müsbət; “eniş”, “iflas”, “resessiya” kimi sözlər mənfi qəbul edilir. Lakin maliyyə bazarlarında kontekst çox vacibdir. “Faiz artımı” bəzi dövrlərdə mənfi qəbul edilə bilər, başqa dövrdə isə iqtisadiyyatın güclü olduğuna işarə kimi şərh oluna bilər.
Böyük dil modelləri bu konteksti daha yaxşı tuta bilər. Lakin GPT sinifli modellərin xərci, gecikməsi və istehsal mühitində API asılılığı ciddi problem yaradır. Bundan əlavə, əvvəlcədən öyrədilmiş modellər bazar narrativləri dəyişdikcə köhnələ bilər. Bu tədqiqatın çıxış nöqtəsi də budur: Daha ucuz, daha sürətli və özünü qiymət reaksiyasına görə yeniləyə bilən xəbər sentiment sistemi qurmaq mümkündürmü?
Metod Nə Təklif Edir?
Tədqiqatda təklif olunan sistem üç əsas siqnalı birləşdirir.
Birinci siqnal maliyyə sahəsi üçün hazırlanmış söz lüğətinə əsaslanır. Bu hissə xəbər başlığındakı müsbət, mənfi, qeyri-müəyyənlik və hüquqi risk çağırışlı sözləri sayır. Klassik söz əsaslı üsullara bənzəyir; lakin maliyyə mətninə xas terminlərlə genişləndirilib.
İkinci siqnal tədqiqatın ən orijinal hissəsidir. Sistem xəbər başlıqlarını TF-IDF üsulu ilə vektorlara çevirir və oxşar başlıqları klasterləşdirir. Daha sonra hər xəbər klasterinin keçmişdə orta hesabla necə qiymət reaksiyası ilə uyğunlaşdığını izləyir. Məsələn, “faiz endirimi gözləntisi”, “neft təchizatı riski” və ya “texnologiya səhmlərində yüksəliş” kimi oxşar başlıqlar zamanla eyni semantik qonşuluqda toplana bilər. Bu klasterin qiymət reaksiyası dəyişərsə, sistemin sentiment şərhi də dəyişir.
Üçüncü siqnal istəyə bağlı böyük dil modeli skorudur. Tədqiqatda LLM siqnalı arxitekturaya dəstək kimi daxil edilib; lakin xərc səbəbilə standart olaraq söndürülüb. Əsas quruluş maliyyə lüğəti və statistik klaster öyrənicisi ilə CPU üzərində işləyə biləcək formada dizayn edilib.
Son mərhələdə bu siqnallar ensemble, yəni birləşik skor halına gətirilir. Sistem müəyyən intervallarla əvvəllər yaratdığı sentiment skorlarını reallaşmış qiymət hərəkətləri ilə müqayisə edir. Hansı siqnal son dövrdə daha yaxşı işləyibsə, onun çəkisi artırılır. Beləliklə sistem yalnız mətnin dil mənasına deyil, bazarın həmin mətnə verdiyi real reaksiyaya da uyğunlaşmağa çalışır.
Formullar Nəyi İzah Edir?
Tədqiqatdakı formullar xəbər başlığından sentiment skoru yaratma prosesinin necə qurulduğunu göstərir. Formulları üç əsas qrupa ayırmaq olar: söz əsaslı skor, TF-IDF klasterləşdirməsi və qiymət reaksiyasına görə ensemble kalibrasiyası.
1. Maliyyə söz skoru
İlk formul xəbər başlığındakı müsbət və mənfi maliyyə sözlərini sayaraq lüğət skoru yaradır:
Burada \(P\) müsbət sözlərin sayını; \(N\) mənfi sözlərin sayını; \(U\) qeyri-müəyyənlik ifadə edən sözlərin sayını; \(C\) hüquqi və ya məhkəmə riski çağırışlı sözlərin sayını göstərir. \(|T|\) başlıqdakı ümumi token, yəni söz/hissə sayıdır.
Formulda mənfi sözlər \(1.2\) əmsalı ilə daha sərt cəzalandırılır. Səbəb maliyyə bazarlarında pis xəbərlərin çox vaxt eyni gücdə yaxşı xəbərlərə nisbətən daha böyük qiymət təsiri yarada bilməsidir. Nəticə \(-1\) ilə \(+1\) aralığında məhdudlaşdırılır. Beləliklə skor çox qısa və ya həddindən artıq xəbərlərdə nəzarətsiz böyümür.
2. Lüğət skorunun etibarlılığı
Sistemin yalnız skor yaratması kifayət deyil; bu skora nə qədər etibar ediləcəyi də hesablanır:
Bu formul başlıqda maliyyə lüğəti ilə uyğunlaşan sözlərin sayı artdıqca etibarlılığın yüksəlməsini təmin edir. Xəbər başlığı maliyyə termini baxımından zəifdirsə, lüğət skoru da aşağı etibarlılıqla ensemble-a daxil olur.
3. TF-IDF: Başlıqları rəqəmsal vektora çevirmək
Sistem xəbər başlıqlarını yalnız söz siyahısı kimi deyil, rəqəmsal vektorlar kimi də nəzərdən keçirir. Bunun üçün TF-IDF istifadə olunur:
Burada \(TF_i(t)\) \(t\) termininin müvafiq başlıqda nə qədər tez-tez keçdiyini göstərir. \(IDF(t)\) isə həmin sözün bütün başlıqlar arasında nə qədər fərqləndirici olduğunu ölçür. Çox tez-tez işlənən ümumi sözlər aşağı çəki alır, daha xüsusi və fərqləndirici sözlər isə daha yüksək çəki alır.
Başlığın vektor təmsili belə qurulur:
Burada \(V\) sistemin seçdiyi söz ehtiyatını ifadə edir. Tədqiqatda ən fərqləndirici ilk 2000 termindən ibarət lüğətdən istifadə olunduğu bildirilir.
4. Oxşar xəbərləri klasterə yerləşdirmək
Sistem yeni xəbər başlığını əvvəldən yaranmış xəbər klasterləri ilə müqayisə etmək üçün kosinus oxşarlığından istifadə edir:
Burada \(v_i\) yeni xəbər başlığının TF-IDF vektorudur. \(\mu_j\) \(C_j\) klasterinin mərkəz vektorudur. Oxşarlıq dəyəri müəyyən həddi keçərsə, xəbər ən yaxın klasterə əlavə olunur. Tədqiqatda bu hədd \(\theta=0.35\) olaraq verilib.
Klaster mərkəzi isə həmin klasterə aid vektorların ortası ilə təmsil olunur:
Bu quruluş sayəsində sistem bütün verilənləri yenidən sıfırdan öyrətmədən yeni xəbərləri mövcud klasterlərə əlavə edə bilir. Xəbər mövcud klasterlərə kifayət qədər bənzəmirsə, yeni klaster yaradılır.
5. Klasterlərin qiymət reaksiyasını öyrənməsi
Hər xəbər klasteri keçmişdə həmin klasterə daxil olan xəbərlərin orta qiymət reaksiyasını saxlayır:
Burada \(ES_j\) müvafiq xəbər klasterinin S&P 500 fyuçers tərəfindəki orta qiymət reaksiyasını; \(NQ_j\) isə Nasdaq fyuçers tərəfindəki orta qiymət reaksiyasını ifadə edir. Tədqiqatda sistemin müxtəlif aktiv sinifləri üçün çoxlu qiymət sahələrini izləyə bildiyi bildirilir.
6. Statistik sentiment skoru
Yeni xəbər başlığı klasterlə uyğunlaşarsa, həmin klasterin keçmiş qiymət reaksiyası statistik sentiment skoru kimi istifadə olunur:
Bu formul xəbərin ən yaxşı uyğunlaşdığı klasterin keçmişdəki orta ES reaksiyasını \(-1\) ilə \(+1\) aralığına çevirir. Xəbər heç bir klasterə kifayət qədər bənzəmirsə, statistik skor neytral qəbul olunur.
7. Klaster keyfiyyəti: Sharpe-ə bənzər ölçü
Tədqiqatda hər klasterin etibarlılığını ölçmək üçün Sharpe-ə bənzər keyfiyyət metriyi də istifadə olunur:
Bu formul klasterin orta qiymət reaksiyasını həmin reaksiyaların dəyişkənliyinə bölür. Klaster ardıcıl şəkildə eyni istiqamətdə qiymət reaksiyası yaradırsa, dəyəri daha mənalı olur. Səs-küylü klasterlər isə ensemble daxilində daha az əhəmiyyət qazanır və ya budanır.
8. Ensemble skoru: Üç siqnalı birləşdirmək
Sistemin yekun sentiment skoru müxtəlif siqnalların çəkili birləşməsidir:
Burada \(s_{lex}\) söz əsaslı skoru; \(s_{stat}\) statistik klaster skorunu; \(s_{llm}\) isə istəyə bağlı böyük dil modeli skorunu ifadə edir. \(w\) dəyərləri siqnal çəkiləridir, \(c\) dəyərləri isə hər siqnalın etibarlılıq əmsallarıdır.
Bu quruluş sayəsində sistem yalnız bir üsuldan asılı qalmır. Bəzi dövrlərdə lüğət siqnalı daha yaxşı işləyə bilər, bəzi dövrlərdə isə statistik klaster siqnalı daha mənalı ola bilər.
9. Reallaşmış qiymət reaksiyası ilə kalibrasiya
Sistem xəbər gəldikdən sonra reallaşmış qiymət hərəkətini hesablayaraq siqnalları yoxlayır:
Burada \(ES_{snapshot}\) xəbər gəldiyi andakı ES qiymətini; \(ES_{current}\) kalibrasiya anındakı ES qiymətini ifadə edir. Bu dəyər xəbərdən sonra bazarın hansı istiqamətdə hərəkət etdiyinə dair təxmini müşahidə verir.
10. Çəkilərin özünü yeniləməsi
Hər siqnalın son dövrdə reallaşmış qiymət hərəkəti ilə nə qədər uyğun olduğu Spearman korrelyasiyası ilə ölçülür. Sonra çəkilər yenilənir:
Burada \(\rho_k\) müvafiq siqnalın reallaşmış qiymət hərəkəti ilə korrelyasiyasını ifadə edir. Formulda \(0.05\) baza dəyərinin istifadə olunması heç bir siqnalın sistemdən tam kənarlaşdırılmamasını təmin edir. Beləliklə model müxtəliflik payını qoruyur.
11. Siqnal-səs-küy nisbəti
Tədqiqatda ensemble skorunun reallaşmış hərəkətləri nə qədər izah etdiyini ümumiləşdirən sadə siqnal-səs-küy ölçüsü də verilir:
Bu dəyər ensemble skorunun reallaşmış qiymət hərəkətindəki variasiyanın nə qədərini izah edə bildiyinə dair təxmini fikir verir.
Qrafik, Cədvəl və Sxemin Əsas Mesajı
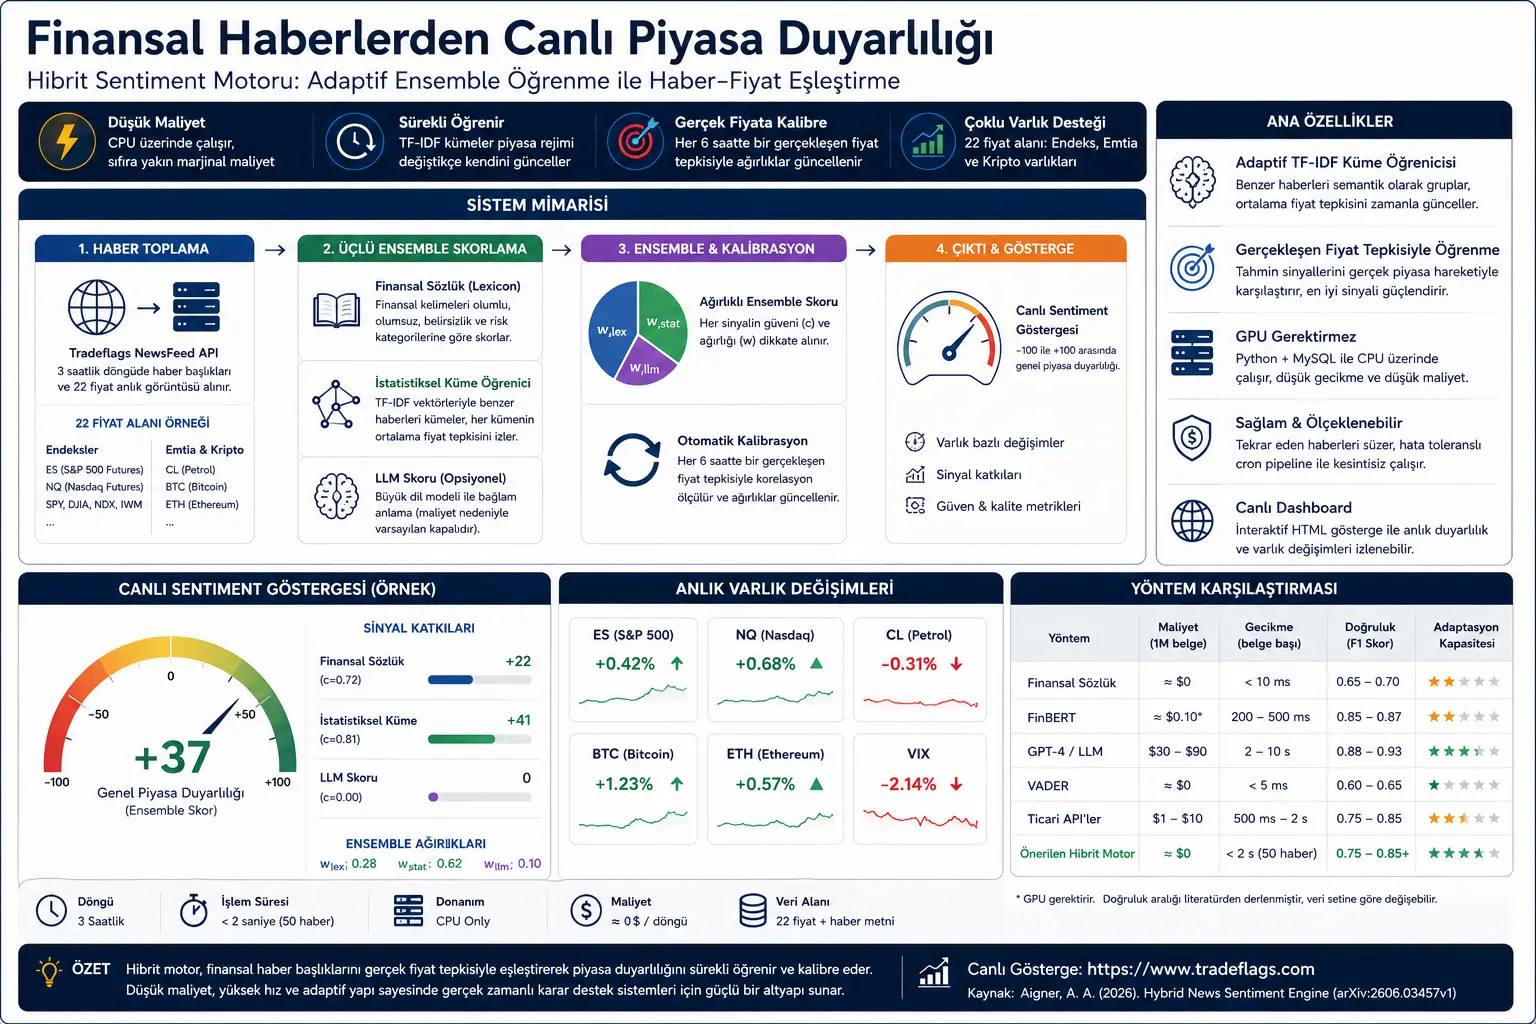
Tədqiqatdakı arxitektura sxemi sistemi üçmərhələli məlumat xətti kimi izah edir: xəbərləri qəbul et, skorlaşdır, sonra reallaşmış qiymət reaksiyasına görə kalibrasiya et. Bu quruluş klassik sentiment təhlilindən fərqlənir. Çünki sistem yalnız xəbərin “dil tonunu” deyil, xəbərdən sonra bazarın nə etdiyini də izləyir.
Canlı göstərici sxemi istifadəçinin görəcəyi çıxışı sadələşdirir. Əsas göstəricidə ümumi bazar sentimenti \(-100\) ilə \(+100\) arasında göstərilir. Bundan əlavə, söz əsaslı skor, statistik klaster skoru və LLM skoru ayrıca təqdim olunur. ES, Nasdaq, neft və Bitcoin kimi aktivlərin ani faiz dəyişmələri də göstəriciyə əlavə edilir.
Müqayisə cədvəlinin əsas mesajı isə xərc, gecikmə və uyğunlaşma qabiliyyəti arasındakı fərqdir. Tədqiqata görə FinBERT və LLM əsaslı yanaşmalar daha güclü dil anlama qabiliyyətinə malik ola bilər; lakin GPU, API xərci və ya daha yüksək gecikmə tələb edə bilər. Təklif olunan sistem isə daha yüngül, daha ucuz və bazar reaksiyasına görə özünü yeniləyə bilən alternativ kimi yerləşdirilir.
Təcrübələr Necə Aparılıb?
Sistem Tradeflags NewsFeed API-dən gələn xəbər başlıqlarından və eyni anda qeydə alınan qiymət görüntülərindən istifadə edir. Hər xəbər elementində başlıq, mənbə, açıqlama, keçid və yayım vaxtı kimi mətn sahələri ilə yanaşı; ES, NQ, SPY, DJIA, IWM, neft, Bitcoin və Ethereum kimi aktivlərə aid qiymət və faiz dəyişmə sahələri yerləşir.
Məlumat xətti üçsaatlıq dövrlərlə işləyəcək şəkildə dizayn edilib. İlk addımda xəbərlər alınır və təkrarlanan başlıqlar çıxarılır. İkinci addımda xəbərlər söz lüğəti, statistik klaster və istəyə bağlı LLM üsulu ilə skorlaşdırılır. Üçüncü addımda sistem müəyyən intervallarla keçmiş skorları reallaşmış qiymət hərəkətləri ilə müqayisə edir və ensemble çəkilərini yeniləyir.
Tədqiqatda istifadə olunan proqram təminatı yığını olduqca yüngüldür. Python, MySQL və bir neçə əsas paketlə işləyir. Dərin öyrənmə kitabxanası, GPU və ya böyük model endirmə məcburiyyəti yoxdur. Bu da sistemi kiçik serverlərdə işlək edir.
Nəticələr Nəyi Göstərir?
Tədqiqatın nəticələri təklif olunan sistemin üç əsas üstünlüyünü önə çıxarır: aşağı xərc, sürətli işləmə və adaptasiya qabiliyyəti.
Sistem 50 xəbərlik toplu emalda iki saniyədən az müddətdə işləyəcək şəkildə dizayn edilib. Söz əsaslı skorlayıcı hər başlıq üçün millisaniyədən az vaxt sərf edir. TF-IDF vektorlaşdırma və klaster axtarışı da CPU üzərində aşağı gecikmə ilə tamamlanır.
Tədqiqat GPT-4 kimi böyük dil modeli əsaslı üsulların daha yüksək dəqiqlik potensialına malik ola biləcəyini qəbul edir. Lakin bu üsulların xərc və gecikmə baxımından istehsal mühitində həmişə uyğun olmaya biləcəyini vurğulayır. Təklif olunan sistemin məqsədi ən güclü dil modelini məğlub etməkdən çox, real vaxtlı və aşağı xərcli bazar sentiment infrastrukturu qurmaqdır.
Ən vacib töhfə adaptiv TF-IDF klaster öyrənicisidir. Sistem oxşar xəbər başlıqlarını eyni semantik qonşuluqda toplayır və bu qonşuluqların orta qiymət reaksiyasını zamanla yeniləyir. Bazar rejimi dəyişdikcə, məsələn “faiz artımı” ifadəsinin qiymət təsiri fərqlənərsə, klasterin orta qiymət reaksiyası da tədricən dəyişir.
Bu Niyə Vacibdir?
Maliyyə xəbər təhlili yalnız mətn təsnifatı problemi deyil. Bazar baxımından əsas vacib sual budur: Bu xəbər həqiqətən qiymətlərdə hərəkətlə əlaqəlidirmi?
Bu tədqiqat maliyyə sentiment təhlilini bazar reallaşmaları ilə bağlamağa çalışdığı üçün vacibdir. Başlıq dil baxımından müsbət görünsə belə bazar reaksiya verməyibsə, bu siqnal əməliyyat baxımından zəif ola bilər. Əksinə, dil baxımından neytral görünən bəzi başlıqlar müəyyən bazar şəraitində güclü qiymət reaksiyası yarada bilər.
Bu yanaşma xüsusilə xəbər əsaslı qərar dəstəyi sistemləri, bazar panelləri, maliyyə məlumat platformaları və aşağı xərcli təhlil alətləri üçün dəyərlidir. Böyük modellərin bahalı olduğu mühitlərdə yüngül, lakin özünü kalibrasiya edə bilən statistik sistemlər praktik alternativ təklif edə bilər.
Diqqət Edilməli Məqamlar
Tədqiqat preprint xarakterlidir. Buna görə nəticələrin müstəqil doğrulama və daha geniş verilənlər dəstləri ilə dəstəklənməsi lazımdır.
Sistem xəbər ilə qiymət hərəkəti arasında korrelyasiya tutur; lakin səbəbiyyət sübut etmir. Qiymət hərəkəti xəbərə görə baş vermiş ola bilər, amma eyni zaman intervalında başqa bazar hadisəsi də təsir göstərə bilər.
Reallaşmış qiymət hərəkətinin ölçülməsi təxmini üsulla aparılıb. Tədqiqatda bu vəziyyət açıq şəkildə məhdudiyyət kimi qeyd olunur. Daha dəqiq nəticələr üçün 1 dəqiqə, 5 dəqiqə və ya 15 dəqiqə irəliyə baxan dəqiq tick verilənləri tələb olunur.
Statistik klaster öyrənicisi soyuq başlanğıc problemi yaşayır. Kifayət qədər xəbər toplanmadan klaster mərkəzləri və orta qiymət reaksiyaları etibarlı səviyyəyə çatmaya bilər.
Sistem hazırkı halında ingilisdilli maliyyə xəbərləri üçün dizayn edilib. Azərbaycan dilində xəbərlərdə oxşar performans gözləmək üçün Azərbaycan dilində maliyyə lüğəti, Azərbaycan dili tokenizasiyası və ayrıca kalibrasiya tələb olunur.
Bu yazı investisiya tövsiyəsi deyil. Xəbər sentiment skorları təkbaşına əməliyyat qərarı vermək üçün kifayət deyil.
Nəticə
Bu tədqiqat maliyyə xəbər sentiment təhlilində bahalı və ağır modellərdən başqa da tətbiq oluna bilən yollar olduğunu göstərir. Təklif olunan sistem maliyyə söz lüğətini, adaptiv TF-IDF klaster öyrənməsini və reallaşmış qiymət reaksiyasına görə ensemble kalibrasiyasını birləşdirir.
Ən diqqətçəkici fikir sentiment təhlilinin yalnız mətnin dil mənası ilə məhdud qalmamasıdır. Sistem xəbər başlıqlarını bazarın real reaksiyası ilə uyğunlaşdıraraq “bu tip xəbərlər keçmişdə necə qiymətləndirilmişdi?” sualına cavab axtarır.
Verianla baxımından bu tədqiqatın əsas mesajı budur: Maliyyə süni intellekti həmişə nəhəng modellər və yüksək xərcli infrastrukturlar tələb etmək məcburiyyətində deyil. Düzgün dizayn edilmiş yüngül statistik üsullar, xüsusilə canlı məlumat axınında və aşağı xərcli sistemlərdə güclü qərar dəstəyi qatı yarada bilər.
Mənbə və Metod Qeydi
Bu məzmun Hybrid News Sentiment Engine: Real-Time Market Analysis via Adaptive Ensemble Learning on News–Price Pairs adlı akademik PDF araşdırılaraq hazırlanıb. Mətn sözbəsöz tərcümə deyil. Tədqiqatın məqsədi, metodu, əsas formulları, sistem arxitekturası, tapıntıları və məhdudiyyətləri Verianla oxucuları üçün sadələşdirilmiş, orijinal və redaksiya Azərbaycan dilində yenidən izah olunub.
Formullar tədqiqatdakı əsas riyazi quruluşa sadiq qalınaraq MathJax uyğun LaTeX formatında verilib. Yazı investisiya tövsiyəsi, al-sat təklifi və ya canlı əməliyyat sistemi tövsiyəsi deyil.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib