

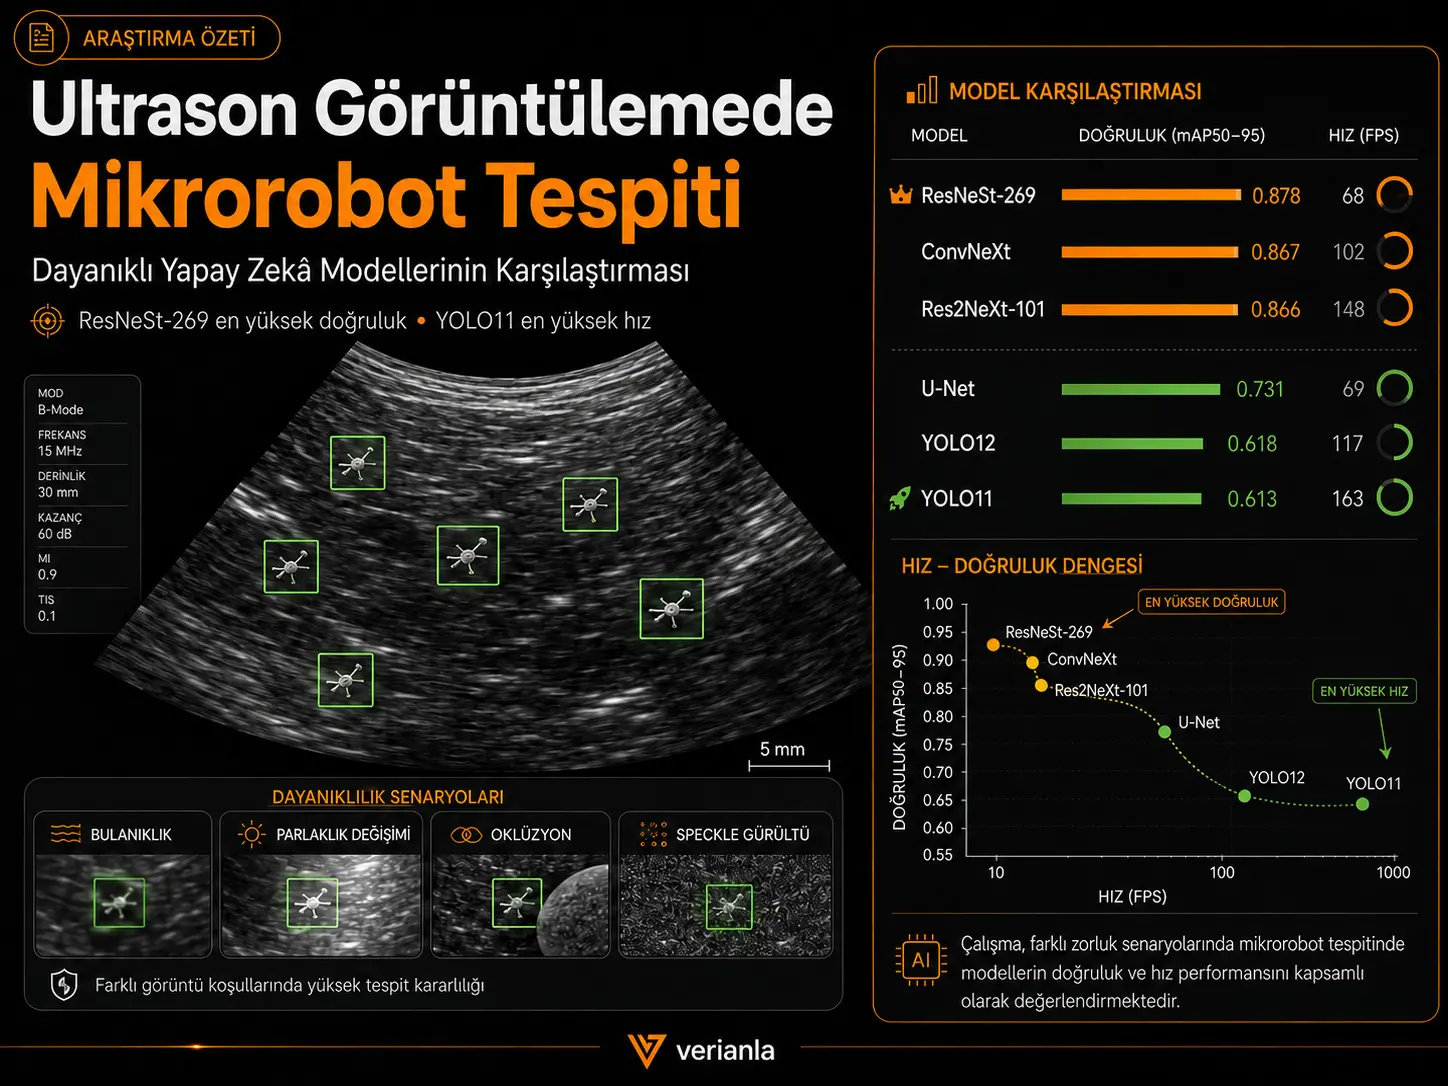
Bu araştırma, ultrason görüntülerindeki mikrorobotların yapay zekâ ile tespitinde altı farklı mimarinin doğruluk, bozunumlara dayanıklılık ve hesaplama verimliliğini karşılaştırmaktadır. ConvNeXt, Res2NeXt-101, ResNeSt-269, U-Net, YOLO11 ve YOLO12; sekiz farklı manyetik mikrorobot tipini içeren USMicroMagSet veri setinin toplam 32.511 kullanılabilir görüntüsü üzerinde değerlendirilmiştir. Tablo 4'te ResNeSt-269, 0,878249645 mAP(50–95) ile en yüksek genel doğruluğa ulaşırken ConvNeXt 0,866752148 ve Res2NeXt-101 0,866416454 ile birbirine çok yakın sonuç vermiştir. Buna karşılık YOLO11, 6,1 ms/görüntü gecikme ve 163 FPS ile en hızlı modeldir. Sonuçlar, en yüksek algılama doğruluğuna sahip mimari ile en düşük hesaplama maliyetine sahip mimarinin aynı olmadığını göstermektedir. Çalışma bir veri seti ve model benchmark çalışmasıdır; gerçek hastalarda klinik kullanım, tedavi başarısı veya canlı insan vücudunda güvenli mikrorobot navigasyonu gösterilmemiştir.
USMicroMagSet, 1920 × 1080 piksel B-mod ultrason görüntülerinden oluşmaktadır. Kaynak veri setinde 40.000'den fazla anotasyonlu kare bulunmasına karşın araştırmada kullanılabilir görüntü sayısı 32.511 olarak bildirilmiştir. Bunların 21.127'si eğitim/validasyon yapısında, 11.384'ü bağımsız test klasöründe yer almaktadır. Eğitim bölümünde beş katlı çapraz doğrulama uygulanmış; her katmanda eğitim verisinin %80'i eğitim, %20'si validasyon için ayrılmıştır. Bütün mimariler 30 epoch, 16 batch size, AdamW optimizasyonu ve 0,0001 öğrenme oranı gibi ortak temel ayarlarla değerlendirilmiştir.
Araştırmanın dikkat çekici sonucu yalnızca “hangi model en doğru?” sorusuna yanıt vermemesi, ultrason görüntülerinin gerçekçi bozulmalarında modellerin davranışlarının birbirinden ciddi ölçüde ayrıldığını göstermesidir. Parlaklık değişimi U-Net'te %84,85, YOLO12'de %71,10 ve YOLO11'de %60,23 AP kaybına yol açarken ConvNeXt'teki kayıp %14,78'dir. Buna karşılık speckle gürültüsünde YOLO mimarileri belirgin biçimde daha dayanıklı görünmektedir. Bu nedenle tek bir genel doğruluk metriği, gerçek zamanlı ultrason tabanlı mikrorobot izleme sistemi seçimi için tek başına yeterli değildir.
Türkiye açısından: Çalışma Türkiye'de yürütülmemiştir ve sonuçlar Türkiye'deki hastanelere, ultrason cihazlarına veya klinik uygulamalara doğrudan aktarılmış bir doğrulama sunmamaktadır. Türkiye'de benzer bir sistem geliştirilmek istenirse kullanılan ultrason donanımı, prob ayarları, operatör farklılıkları, görüntü kalitesi, mikrorobot geometrisi ve mevcut hesaplama altyapısı üzerinde ayrı doğrulama gerekir. Özellikle araştırmanın NVIDIA B200 gibi çok güçlü bir GPU üzerinde yürütülmüş olması, elde edilen gecikme ve FPS değerlerinin daha sınırlı yerel donanımlarda aynı kalacağının varsayılamayacağı anlamına gelir.
Araştırmanın temel sorusu nedir?
Mikrorobotların tıbbi uygulamalarda hedeflenen noktaya yönlendirilmesi için yalnızca hareket ettirilebilmeleri değil, vücut içindeki konumlarının güvenilir biçimde tespit ve takip edilebilmesi gerekir. Araştırmacılar bu problemi ultrason görüntüleme ve derin öğrenme tabanlı nesne algılama modelleri üzerinden ele almaktadır.
Çalışmanın temel amacı, ultrason görüntülerinde mikrorobot algılama için farklı yapay zekâ mimarilerini aynı benchmark çerçevesinde karşılaştırmak ve yalnızca temel doğruluk metriklerini değil, görüntü bozulmalarına dayanıklılığı, görsel özellik bağımlılıklarını ve gerçek zamanlı kullanıma ilişkin hesaplama maliyetini de ölçmektir.
Ultrason neden merkezde?
Araştırmada manyetik rezonans görüntüleme (MRI), bilgisayarlı tomografi (CT), optik görüntüleme ve ultrason gibi yöntemler tartışılmaktadır. Yazarların kurduğu çerçevede ultrason; taşınabilirlik, görece düşük maliyet, iyonlaştırıcı radyasyon kullanmaması ve yüksek zamansal çözünürlüğü nedeniyle gerçek zamanlı mikrorobot izleme için uygun bir adaydır.
Bununla birlikte ultrason görüntüsünün düşük kontrast, sınırlı uzamsal çözünürlük, doku artefaktları ve speckle gürültüsü gibi özellikleri küçük mikrorobotların tespitini güçleştirmektedir. Çalışmanın yapay zekâ benchmark'ı tam olarak bu zorlu görüntüleme ortamını hedeflemektedir.
Hangi mikrorobotlar kullanıldı?
USMicroMagSet veri seti sekiz mikrorobot sınıfını içermektedir: cube, cylinder, flagella, helical, rollingcube, sheetrobot, sphere1 ve sphere3. Çalışmadaki Şekil 5, her sınıf için anotasyonsuz ultrason görüntüsünü ve yeşil sınırlayıcı kutuyla işaretlenmiş karşılığını yan yana göstermektedir. Böylece sınıfların ultrason görüntüsündeki biçim, kontrast ve sınır farklılıkları doğrudan görülebilmektedir.
| Mikrorobot sınıfı | Eğitim sayısı | Test sayısı |
|---|---|---|
| cube | 2267 | 1222 |
| cylinder | 1596 | 861 |
| flagella | 1956 | 1054 |
| helical | 3155 | 1699 |
| rollingcube | 1255 | 677 |
| sheetrobot | 3010 | 1622 |
| sphere1 | 5900 | 3178 |
| sphere3 | 1988 | 1071 |
| Toplam | 21.127 | 11.384 |
Veri dağılımı dengeli değildir. Örneğin sphere1 sınıfında 5900 eğitim görüntüsü bulunurken rollingcube için sayı 1255'tir. Yazarlar bu sınıf dengesizliğini çalışmanın sınırlılıklarından biri olarak kabul etmektedir. Bununla birlikte kendi sonuçlarına dayanarak ham örnek sayısının tek başına model başarısını açıklamadığını ve mimari özelliklerin önemli olduğunu savunmaktadırlar.
Altı model neden birlikte değerlendirildi?
Benchmark; ConvNeXt, Res2NeXt-101, ResNeSt-269, U-Net, YOLO11 ve YOLO12 mimarilerini kapsar. Araştırmada bu modeller farklı mimari özellikleri nedeniyle seçilmiştir. ConvNeXt geniş çekirdekler ve hiyerarşik özellik çıkarımına dayanan modern CNN yaklaşımını; ResNeSt-269 split-attention mekanizmasını; Res2NeXt-101 çok ölçekli özellik temsilini; U-Net encoder-decoder ve skip connection yapısını; YOLO11 ve YOLO12 ise daha kompakt, gerçek zamanlı algılama yaklaşımını temsil etmektedir.
Şekil 3'te araştırmacılar model seçimini yalnızca doğruluk beklentisi üzerinden değil; mimari çeşitlilik, hız, klinik kullanım potansiyeli ve ultrason görüntüsündeki farklı görsel ipuçlarına duyarlılık üzerinden açıklamaktadır.
Genel algılama doğruluğunda hangi model önde?
Tablo 4'teki kesin mAP(50–95) değerlerine göre ResNeSt-269 en yüksek sonucu vermiştir. ConvNeXt ve Res2NeXt-101 ise birbirine son derece yakın performans göstermektedir. Kaynağın özet ve sonuç metni Res2NeXt-101'i ikinci, ConvNeXt'i üçüncü sırada ifade etmesine rağmen tablo değerleri ConvNeXt'in 0,866752148 ile Res2NeXt-101'in 0,866416454 değerinden çok küçük bir farkla yüksek olduğunu göstermektedir. Bu nedenle burada sıralama yorumu yerine kesin sayısal değerler esas alınmıştır.
| Model | mAP (50–95) | mAP50 | mAP75 | Precision | Recall |
|---|---|---|---|---|---|
| YOLO12 | 0.617824433 | 0.962943476 | 0.670267625 | 0.93580446 | 0.840348152 |
| YOLO11 | 0.613175223 | 0.949897181 | 0.690278055 | 0.962045926 | 0.769022882 |
| ConvNeXt | 0.866752148 | 0.98678273 | 0.916006863 | 0.985324123 | 0.995195712 |
| ResNeSt-269 | 0.878249645 | 0.988578439 | 0.930365086 | 0.986016259 | 0.995728513 |
| Res2NeXt-101 | 0.866416454 | 0.988445342 | 0.919016898 | 0.985829465 | 0.995924184 |
| U-Net | 0.7309196 | 0.875163198 | 0.781938016 | 0.7309196 | 0.880745351 |
mAP50 değerlerinin YOLO modellerinde de yüksek olması, daha gevşek IoU eşiğinde bu modellerin çok sayıda nesneyi bulabildiğini; mAP(50–95) değerinin belirgin biçimde düşmesi ise daha sıkı lokalizasyon eşikleri birlikte değerlendirildiğinde performans farkının büyüdüğünü göstermektedir. Araştırmacılar mikrorobot uygulamalarında hassas lokalizasyonun önemli olması nedeniyle mAP(50–95) metriğini temel değerlendirme ölçütlerinden biri olarak kullanmıştır.
Hangi mikrorobot sınıfları daha zor?
Altı modelin bütünleşik sınıf analizinde en düşük performans gösteren üç sınıf rollingcube, sheetrobot ve sphere1 olarak bildirilmiştir. Araştırmacıların verdiği bütünleşik AP(50–95) değerleri sırasıyla 0,598, 0,676 ve 0,768'dir.
YOLO11'in rollingcube sınıfındaki recall değeri 0,002394288 ve F1 skoru 0,004777139'dur. YOLO12'de aynı sınıf için recall 0 ve F1 skoru 0 olarak rapor edilmiştir. Buna karşılık ConvNeXt, ResNeSt-269 ve Res2NeXt-101 rollingcube sınıfında sırasıyla 0,939757824, 0,93028307 ve 0,941604495 mAP(50–95) elde etmiştir. Bu fark, genel model başarısının belirli mikrorobot geometrilerindeki davranışı gizleyebileceğini göstermektedir.
Bulanıklık, parlaklık ve örtülme modelleri nasıl etkiliyor?
Araştırma yalnızca temiz test görüntülerine bakmamış; gerçekçi görüntüleme zorluklarını taklit etmek amacıyla bulanıklık, parlaklık/kontrast değişimi, örtülme ve speckle gürültüsü eklemiştir. Şekil 7, ilk üç bozunum koşulunda modellerin AP kayıplarını göstermektedir.
Verianla Live: Görüntü bozunumlarında AP kaybı
Tablodaki değerler Şekil 7'de çubukların üzerinde verilen AP kaybı yüzdeleridir. Daha düşük kayıp, ilgili bozunum koşulunda daha yüksek dayanıklılık anlamına gelir.
| Model | Bulanıklık AP kaybı (%) | Parlaklık AP kaybı (%) | Örtülme AP kaybı (%) | Kaynak |
|---|---|---|---|---|
| YOLO12 | 29.79 | 71.10 | 25.84 | Şekil 7 |
| YOLO11 | 18.06 | 60.23 | 26.66 | Şekil 7 |
| ConvNeXt | 12.53 | 14.78 | 17.33 | Şekil 7 |
| ResNeSt-269 | 20.87 | 32.04 | 20.13 | Şekil 7 |
| Res2NeXt-101 | 13.73 | 28.14 | 17.81 | Şekil 7 |
| U-Net | 79.17 | 84.85 | 47.72 | Şekil 7 |
Verianla Live: Görselleştirme, yukarıdaki görünür bilimsel veri tablosundan runtime sırasında oluşturulur. Animasyon süresi bilimsel deney süresini temsil etmez.
Şekil 7'nin en belirgin mesajı parlaklık değişiminin birçok model için güçlü bir stres faktörü olmasıdır. ConvNeXt'te parlaklık kaynaklı AP kaybı %14,78 iken YOLO11'de %60,23, YOLO12'de %71,10 ve U-Net'te %84,85'tir. Res2NeXt-101 %28,14, ResNeSt-269 ise %32,04 kayıp göstermiştir.
Bulanıklıkta ConvNeXt %12,53 ve Res2NeXt-101 %13,73 AP kaybıyla en dayanıklı sonuçlar arasındadır. U-Net'te kayıp %79,17'ye yükselmektedir. Örtülme koşulu bütün modelleri etkilerken U-Net %47,72 AP kaybıyla yine en büyük düşüşü göstermektedir.
Speckle gürültüsünde farklı bir tablo ortaya çıkıyor
Speckle gürültüsü ultrason görüntülemede özel önem taşıdığı için araştırmacılar 0,02, 0,04, 0,06, 0,08 ve 0,1 olmak üzere beş gürültü varyansı kullanmıştır. Şekil 8'de YOLO12 için AP kayıpları sırasıyla %1,1, %1,2, %1,3, %1,5 ve %1,7; YOLO11 için %1,1, %1,8, %2,3, %3,3 ve %4,0 olarak gösterilmektedir.
Şekil 8'de ConvNeXt için görünen değerler %5,3, %8,9, %11,9, %14,0 ve %16,2'dir. Ancak aynı şekli açıklayan metin ConvNeXt için AP kaybı aralığını %5,3–11,2 olarak vermektedir. Kaynak içindeki bu sayı uyuşmazlığı nedeniyle iki bilgi tek bir “düzeltilmiş” değere dönüştürülmemiştir.
Şekil 8'de ResNeSt-269 için AP kaybı gürültü seviyesi arttıkça yaklaşık %29,8'den %70,5'e; U-Net için %2,4'ten %68,2'ye çıkmaktadır. Kaynak metni de varyans 0,08'e ulaştığında ResNeSt-269 ve U-Net kayıplarının %50'nin üzerine çıktığını belirtmektedir. Bunun hemen ardından gelen “strong noise tolerance” ifadesi bu sayılarla mantıksal olarak uyuşmadığından kaynak içi anlatım tutarsızlığı olarak değerlendirilmelidir.
Modeller hangi görsel ipuçlarına daha fazla bağımlı?
Çalışmada klasik piksel düzeyindeki Grad-CAM yaklaşımı yerine bozunumlara bağlı mAP kayıplarından özellik katkısı türetilmiştir. Araştırmacılar bulanıklığı kenar özellikleriyle, parlaklık değişimini aydınlatmayla, örtülmeyi uzamsal özelliklerle ve speckle gürültüsünü doku bilgisiyle eşleştirmiştir.
| Model | Kenar (%) | Doku (%) | Aydınlatma (%) | Uzamsal (%) |
|---|---|---|---|---|
| YOLO12 | 23.26 | 1.05 | 55.52 | 20.18 |
| YOLO11 | 16.81 | 2.33 | 56.05 | 24.81 |
| ConvNeXt | 22.42 | 20.16 | 26.43 | 31.00 |
| ResNeSt-269 | 16.39 | 42.62 | 25.17 | 15.81 |
| Res2NeXt-101 | 17.15 | 25.47 | 35.14 | 22.24 |
| U-Net | 32.29 | 13.65 | 34.60 | 19.46 |
YOLO11 ve YOLO12'nin aydınlatmaya katkı oranı yaklaşık %56 iken doku katkısı %3'ün altındadır. Araştırmacılar rollingcube ve sheetrobot sınıflarının koyu, düşük yoğunluklu ve doku temelli görünümlerini YOLO modellerindeki düşük sınıf performansıyla ilişkilendirmektedir.
ResNeSt-269'da doku katkısının %42,62 olması çalışmadaki en yüksek doku bağımlılığıdır. Araştırmacılar split-attention yapısının ince yoğunluk değişimlerini yakalayabilmesini, özellikle zor mikrorobot geometrilerindeki güçlü performansın olası açıklaması olarak sunmaktadır.
ConvNeXt daha dengeli bir profil göstermektedir: kenar %22,42, doku %20,16, aydınlatma %26,43 ve uzamsal özellik %31,00. Bu sonuç araştırmacıların ConvNeXt'i farklı görüntü koşullarında daha genelleştirilmiş özellik çıkaran bir mimari olarak yorumlamasına temel oluşturmaktadır.
En doğru model aynı zamanda en hızlı model mi?
Hayır. Çalışmanın temel mühendislik sonucu doğruluk ile hesaplama maliyeti arasında belirgin bir ödünleşim bulunmasıdır. ResNeSt-269 en yüksek mAP(50–95) değerine sahipken aynı zamanda en büyük ve en yavaş modellerden biridir. YOLO11 ise genel doğrulukta daha düşük kalmasına rağmen en yüksek FPS değerine ulaşmıştır.
| Model | Gecikme (ms/görüntü) | FPS | Parametre (milyon) | Model dosyası (MB) |
|---|---|---|---|---|
| YOLO11 | 6.1 | 163 | 2.58 | 5 |
| Res2NeXt-101 | 6.7 metin / 6.8 Şekil 10a | 148 | 61.04 | 233 |
| YOLO12 | 8.5 | 117 | 2.56 | 5 |
| ConvNeXt | 9.8 | 102 | 45.08 | 172 |
| U-Net | 14.4 | 69 | 31.04 | 118 |
| ResNeSt-269 | 14.5 | 68 | 126.76 | 485 |
ResNeSt-269'un yaklaşık 126,76 milyon parametre ve 485 MB model dosyasına karşılık YOLO11'in 2,58 milyon parametre ve yaklaşık 5 MB dosya boyutunda olması, gerçek zamanlı veya gömülü sistem tasarımında yalnız doğruluk metriğinin neden yeterli olmadığını göstermektedir.
Buradaki hız değerlerinin NVIDIA B200 GPU üzerinde elde edildiği unutulmamalıdır. Aynı modeller daha sınırlı bir GPU, CPU veya gömülü işlemci üzerinde aynı gecikme ve FPS sonuçlarını vermek zorunda değildir.
Şekiller araştırmanın hangi yönlerini gösteriyor?
Şekil 1, mikrorobotların hedeflenen ilaç taşıma, lokal terapi, minimal invaziv girişimler, tanısal görüntüleme ve damar içi navigasyon gibi potansiyel kullanım alanlarını kavramsal bir akış şemasıyla göstermektedir. Bu şekil çalışma içinde klinik sonuç kanıtı değil, uygulama bağlamını açıklayan bir şemadır.
Şekil 2, MRI, CT ve ultrasonun mikrorobot takibi açısından yazarlar tarafından nasıl karşılaştırıldığını gösterir. Şemanın ana mesajı ultrasonun gerçek zamanlı görüntüleme, iyonlaştırıcı radyasyon kullanmaması ve taşınabilirlik özellikleri nedeniyle araştırmanın tercih ettiği görüntüleme yöntemi olmasıdır.
Şekil 3, altı modelin mimari aile, doğruluk-verimlilik dengesi, klinik/teknik ilgi ve farklı bozunumlara karşı tamamlayıcı özellikler açısından neden seçildiğini özetler.
Şekil 4, deneylerin çalıştırıldığı NVIDIA B200 Blackwell altyapısını HBM3e bellek yığınları, işlem kümeleri, SM ve Tensor Core düzeyinde şematik olarak göstermektedir.
Şekil 5, sekiz mikrorobot tipinin anotasyonsuz ve etiketli ultrason örneklerini yan yana gösterir. Bu görsel, sınıflar arasındaki şekil, yoğunluk ve sınır farklarının model performansını neden etkileyebileceğini anlamak açısından özellikle önemlidir.
Şekil 6, 1920 × 1080 ultrason görüntüsünden başlayarak ön işleme, sabit rastgele tohum, karma hassasiyet, altı model, beş katlı çapraz doğrulama, final model yeniden eğitimi ve dört ayrı değerlendirme koluna uzanan benchmark sürecini göstermektedir.
Şekil 7 ve Şekil 8, bozunum stres testlerinin ana sayısal sonuçlarını; Şekil 9 model özellik katkılarını; Şekil 10 ise gecikme, FPS, parametre ve dosya boyutu arasındaki mühendislik ödünleşimini göstermektedir.
Çalışmanın desteklediği sonuçlar
- USMicroMagSet benchmark koşullarında ResNeSt-269 en yüksek genel mAP(50–95) değerine ulaşmıştır.
- ConvNeXt ve Res2NeXt-101 genel algılama doğruluğunda ResNeSt-269'a yakın sonuçlar vermiştir.
- YOLO11 en düşük gecikme ve en yüksek FPS değerini göstermiştir.
- Modellerin bulanıklık, parlaklık, örtülme ve speckle gürültüsüne tepkileri ciddi biçimde farklılaşmıştır.
- Belirli mikrorobot sınıflarında model mimarisi ve görsel özellik bağımlılığı performans farklarını açıklamak için kullanılabilir.
- Algılama doğruluğu ile model boyutu/hız arasında belirgin bir mühendislik ödünleşimi vardır.
Çalışmanın desteklemediği veya test etmediği sonuçlar
- Bu çalışma gerçek hastalarda klinik başarı göstermemektedir.
- Modellerin insan vücudunda gerçek zamanlı mikrorobot navigasyonunu güvenli biçimde yönettiği gösterilmemiştir.
- Yüksek mAP değeri tedavi etkinliği, hasta güvenliği veya tanısal başarı garantisi değildir.
- B200 GPU üzerindeki FPS değerlerinin gömülü veya hastane tipi donanımlarda aynı kalacağı gösterilmemiştir.
- USMicroMagSet dışındaki ultrason cihazları, hasta anatomileri, prob ayarları ve farklı operatör koşullarında genelleme doğrudan kanıtlanmamıştır.
- Çalışma mikrorobot teknolojisinin klinik kullanıma hazır olduğunu kanıtlamamaktadır.
Çalışmanın Yöntemi ve Bulguları
Deney altyapısı
Deneyler ticari GPU bulut platformu RunPod.io üzerinde gerçekleştirilmiştir. Hesaplama altyapısında Blackwell mimarisine sahip tek NVIDIA B200 GPU, 180 GB VRAM, AMD EPYC 9555 tabanlı 28 vCPU ve 200 GB ağ depolaması kullanılmıştır. Yazılım ortamı PyTorch üzerinde Ultralytics ve Torchvision kütüphanelerine dayanmaktadır.
| Parametre | Değer / Ayar | Amaç |
|---|---|---|
| Epoch | 30 | Mimariler arasında aynı eğitim süresi |
| Batch size | 16 | Aynı gradient güncelleme sıklığı |
| Dataloader workers | 16 | Aynı veri aktarım yapısı |
| Girdi çözünürlüğü | 1080 × 1920; YOLO imgsz = 1920 | Tutarlı görüntü ölçeği |
| Optimizasyon | AdamW | Ortak optimizasyon davranışı |
| Öğrenme oranı | 0.0001 | Ortak öğrenme dinamiği |
| Karma hassasiyet | AMP etkin | FP16/Tensor Core hızlandırması |
| Model derleme | torch.compile / compile = True | Ortak hesaplama optimizasyonu |
Beş katlı çapraz doğrulama
Eğitim verisi her fold için rastgele %80 eğitim ve %20 validasyon olarak ayrılmıştır. Rastgele tohum 42'dir. Beş katlı çapraz doğrulama sırasında patience = 5 kullanılmış, her fold için en iyi ağırlıklar ve loglar kaydedilmiştir.
Beş fold tamamlandıktan sonra final model, eğitim ve validasyon verilerinin tamamı kullanılarak yeniden eğitilmiştir. Bu aşamada validasyon ve erken durdurma devre dışı bırakılmış ve patience = 0 olarak ayarlanmıştır. Bağımsız test klasörü final değerlendirmede kullanılmıştır.
Bozunum deneyi: Gaussian bulanıklık
Bulanıklık için 21 × 21 Gaussian çekirdeği ve k = 10 kullanılmış; OpenCV tarafından σ ≈ 3,5 hesaplandığı belirtilmiştir. Araştırmacılar bu işlemi mikrorobot hareketi, fizyolojik hareket veya zayıf akustik pencere gibi durumları taklit etmek amacıyla kullanmıştır.
\[ I_b(x,y,c)=(I \ast G_{\sigma})(x,y,c) \]
Burada \(I\) özgün görüntüyü, \(G_{\sigma}\) Gaussian çekirdeğini, \(\ast\) iki boyutlu konvolüsyonu, \(x\) ve \(y\) piksel koordinatlarını, \(c\) ise renk kanalını temsil etmektedir.
Bozunum deneyi: parlaklık ve kontrast
Parlaklık/kontrast testi için α = 1,8 ve β = −40 kullanılmıştır. Kaynakta α kontrast kontrolü, β parlaklık kontrolü olarak tanımlanmıştır.
\[ I_{bc}(x,y,c)=clip(\alpha I(x,y,c)+\beta) \]
Bu dönüşüm ultrason cihazı/operator ayarları, time gain compensation ve sinyal zayıflamasından kaynaklanan görüntü değişimlerini taklit etmek amacıyla uygulanmıştır.
Bozunum deneyi: örtülme
Her görüntüye beş siyah kutu eklenmiştir. Her kutunun yüksekliği ve genişliği özgün görüntü boyutunun %15'i olarak belirlenmiştir.
Kaynakta örtülmüş bölge metin içinde O olarak adlandırılırken denklem koşulunda karakter 0 biçiminde basılmıştır. Kaynak içindeki bu gösterim tutarsızlığı sessizce düzeltilmemiştir:
\[ I_{oc}(x,y,c)= \begin{cases} 0, & (x,y)\in 0 \\ (x,y,c), & otherwise \end{cases} \]
Denklemin hemen öncesindeki açıklamaya göre amaç, örtülme bölgesindeki pikselleri sıfırlamak ve geri kalan görüntüyü değiştirmeden bırakmaktır; ancak kaynak formülündeki O/0 yazımı bibliyografik olarak olduğu gibi not edilmelidir.
Bozunum deneyi: speckle gürültüsü
Speckle gürültüsü için \(\sigma_s^2 = 0.02,\ 0.04,\ 0.06,\ 0.08,\ 0.1\) varyansları kullanılmıştır. Her piksele normal dağılımdan üretilmiş çarpımsal gürültü uygulanmıştır.
\[ n(x,y,c)\sim N(0,\sigma_s^2) \]
\[ I_{sp}(x,y,c)=clip(I(x,y,c)[1+n(x,y,c)]) \]
Araştırmanın Şekil 8'i, speckle gürültüsüne karşı model dayanıklılığının diğer bozunum türlerinden farklı sıralanabileceğini göstermektedir. Özellikle YOLO11 ve YOLO12, temel mAP(50–95) değerleri daha düşük olmasına rağmen bu gürültü testinde düşük AP kayıpları sergilemiştir.
Özellik katkısı hesabı
Araştırmacılar bozunum kaynaklı mAP düşüşlerini kenar, doku, aydınlatma ve uzamsal bilgi gibi soyut görsel özelliklerle eşleştirerek göreli katkı hesabı yapmıştır:
\[ W_f = 100 \cdot \frac{\max(0,d_f)} {\sum_{f'}\max(0,d_{f'})} \]
Burada \(d_f\), belirli bozunum altında gözlenen mAP kaybını; \(W_f\) ise bu kayıptan türetilen göreli özellik katkısını temsil etmektedir. Bu analiz doğrudan piksel düzeyinde özellik aktivasyonu ölçümü değil, bozunumlara karşı performans değişimlerinden türetilen model düzeyinde bir duyarlılık analizidir.
Çapraz doğrulama güven aralıkları
| Model | %95 GA alt sınır | %95 GA üst sınır |
|---|---|---|
| YOLO12 | 0.5591 | 0.6126 |
| YOLO11 | 0.3186 | 0.7536 |
| ConvNeXt | 0.7955 | 0.8484 |
| ResNeSt-269 | 0.8219 | 0.8515 |
| Res2NeXt-101 | 0.8211 | 0.8563 |
| U-Net | 0.732 | 0.8141 |
Araştırmacılar bu güven aralıklarının final test setindeki belirsizliği değil, beş katlı eğitim/validasyon sürecindeki değişkenliği temsil ettiğini özellikle belirtmektedir. Final model bütün eğitim verisi üzerinde yeniden eğitildiği için test sonucu bazı durumlarda çapraz doğrulama güven aralığının dışında kalabilmektedir.
Temel sınırlılıklar
- Veri seti büyük olsa da çeşitliliği sınırlıdır.
- Sınıf dağılımı dengesizdir.
- Gerçek hasta anatomisi, prob ayarları ve operatör tercihleri vakadan vakaya değişebilir.
- Test edilen bozunum türleri ve bozunum seviyeleri gerçek dünyanın bütün olasılıklarını kapsamamaktadır.
- Hesaplamalar güçlü NVIDIA B200 altyapısında yapılmıştır.
- Kaynak kısıtlı veya gömülü donanımlarda aynı gerçek zamanlı performans gösterilmemiştir.
- Çalışma klinik uygulama veya insan üzerinde mikrorobot kullanımının doğrulaması değildir.
Kaynak ve Yöntem Notu
Tam özgün çalışma adı: Benchmarking Robust AI for Microrobot Detection with Ultrasound Imaging
Yazarlar: Ahmed Almaghthawi, Changyan He, Suhuai Luo, Furqan Alam, Majid Roshanfar, Lingbo Cheng.
Yazar sırası: Kaynakta verilen sıra aynen korunmuştur.
Eş katkı / eş birinci yazar: Kaynakta eş birinci veya eş katkı beyanı belirtilmemiştir.
Sorumlu yazarlar: Ahmed Almaghthawi ve Changyan He.
Kurumlar:
- School of Information and Physical Sciences, University of Newcastle, Newcastle, Australia.
- School of Engineering, University of Newcastle, Newcastle, Australia.
- Department of Computer Science, College of Science & Art at Mahayil, King Khalid University, Abha, Saudi Arabia.
- Faculty of Computing and Information Technology (FoCIT), Sohar University, Sohar, Oman.
- PCIGITI Center, SickKids Hospital, Toronto, Canada.
Kaynak türü: Hakemli araştırma makalesi; yapay zekâ tabanlı mikrorobot algılama benchmark ve veri analizi çalışması.
Dergi: Actuators.
Yayınevi: MDPI.
Bibliyografik künyesi: Actuators 2026, 15(1), 16.
Makale numarası: 16.
DOI: 10.3390/act15010016.
Resmî yayın bağlantısı:https://doi.org/10.3390/act15010016
Gönderim: 6 Ekim 2025.
Revizyon: 5 Aralık 2025.
Kabul: 11 Aralık 2025.
Çevrim içi yayın: 29 Aralık 2025.
Lisans: Creative Commons Attribution (CC BY).
Finansman: Araştırmacılar çalışmanın dış finansman almadığını bildirmiştir.
Veri erişilebilirliği: Araştırmada kullanılan USMicroMagSet veri setinin IEEE DataPort üzerinden kamuya açık olduğu ve kaynak çalışmada atıf verildiği belirtilmiştir.
Çıkar çatışması: Yazarlar çıkar çatışması olmadığını bildirmiştir.
Kurumsal etik ve bilgilendirilmiş onam: Kaynakta “not applicable” olarak belirtilmiştir.
Yazar katkıları: Kavramsallaştırma A.A., C.H., F.A. ve S.L.; metodoloji A.A.; yazılım A.A.; doğrulama C.H., S.L. ve F.A.; formel analiz ve araştırma A.A.; kaynaklar A.A.; ilk taslak A.A.; gözden geçirme ve düzenleme C.H., F.A., L.C., M.R. ve S.L.; görselleştirme A.A., M.R. ve L.C.; danışmanlık C.H., S.L. ve F.A.; proje yönetimi C.H. ve S.L.; finansman edinimi S.L., C.H. ve L.C. olarak bildirilmiştir.
Bilimsel içerik sınırı: Bu Verianla yazısındaki bilimsel yöntem, veri, formüller, sayısal sonuçlar ve yorumlar yalnızca incelenen kaynak çalışmaya dayanmaktadır. Bibliyografik kimlik dışındaki alanlara dış kaynaklardan yeni bilimsel bulgu eklenmemiştir.
Kaynak içindeki önemli tutarsızlıklar
- Metin içinde Tablo 1'in sınıf dağılımı olduğu belirtilen bir noktada gerçek Tablo 1 eğitim ayarlarını göstermektedir; sınıf dağılımı Tablo 2'dir.
- Başka bir bölümde Tablo 2'nin dedektör karşılaştırması olduğu ifade edilirken gerçek dedektör karşılaştırması Tablo 3'tedir.
- Rollingcube sınıfındaki YOLO başarısızlığını açıklayan metin Tablo 4'e gönderme yapmasına rağmen ayrıntılı sınıf sonuçları Tablo 5'tedir.
- Özet ve sonuç metni ResNeSt-269'dan sonra Res2NeXt-101 ve ConvNeXt sıralamasını verirken Tablo 4'te ConvNeXt mAP(50–95) değeri 0.866752148, Res2NeXt-101 değeri 0.866416454'tür.
- Speckle bölümündeki metin ConvNeXt AP kaybını %5,3–11,2 olarak verirken Şekil 8'de görünen değerler %5,3, %8,9, %11,9, %14,0 ve %16,2'dir.
- ResNeSt-269 ve U-Net'in speckle gürültüsünde %50'den büyük AP kaybı yaşadığı belirtildikten sonra kaynakta “strong noise tolerance” ifadesinin kullanılması sayısal sonuçla çelişmektedir.
- Res2NeXt-101 gecikmesi metinde 6,7 ms, Şekil 10a'da 6,8 ms olarak gösterilmektedir.
- Örtülme denkleminin hemen öncesinde örtülme bölgesi O olarak tanımlanırken denklem içinde koşul karakteri 0 biçiminde basılmıştır.
Bu farklılıklar Verianla metninde sessizce tek bir “doğru” değere dönüştürülmemiş; mümkün olduğunda tablo veya şeklin doğrudan görünen verisi ayrıca belirtilmiş ve kaynak içi uyuşmazlık açıkça korunmuştur.
Çalışmanın sonuçları ultrason görüntülerindeki mikrorobot algılama modellerinin karşılaştırmalı performansına ilişkindir. Araştırma, herhangi bir modelin gerçek hastalarda güvenli kullanımını, klinik tedavi başarısını veya otonom mikrorobot sisteminin insan vücudunda doğrulanmış saha performansını göstermemektedir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir