

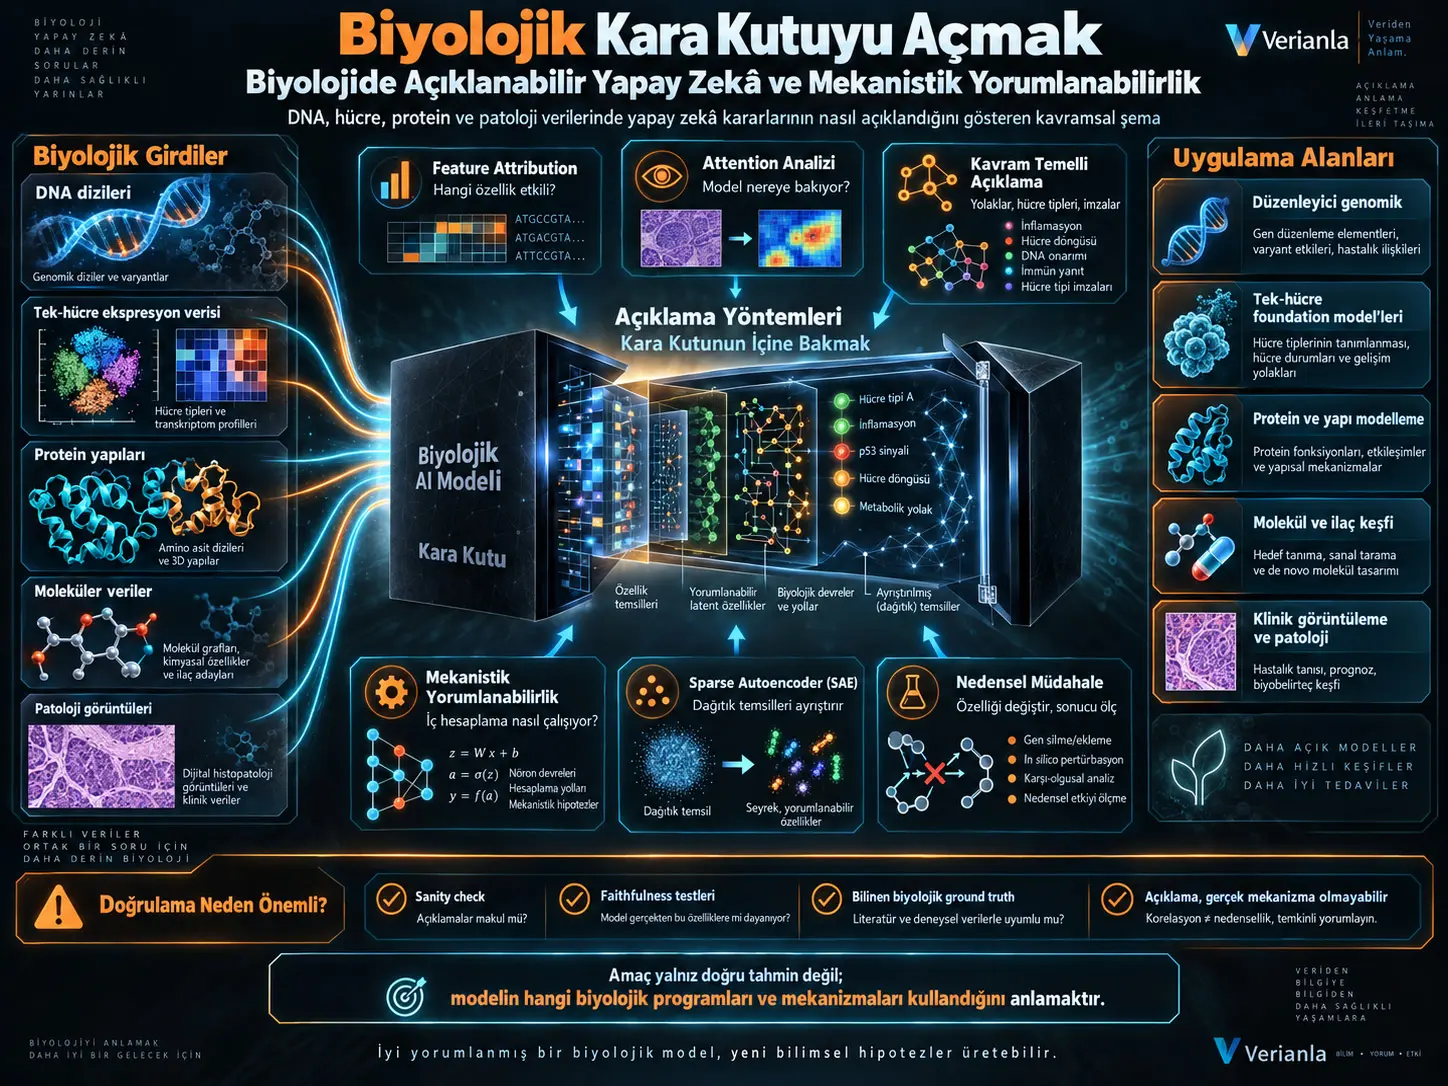
Açıklanabilir yapay zekâ (Explainable Artificial Intelligence, XAI), bir yapay zekâ modelinin tahmin veya kararlarının hangi girdilere, kavramlara ya da iç hesaplamalara dayandığını insanlar tarafından incelenebilir hale getirmeye çalışan yöntemler bütünüdür. Olivia Denvis'in survey çalışması, biyolojide kullanılan açıklama yöntemlerini feature attribution, attention analizi, concept-based explanation ve mechanistic interpretability ekseninde; uygulamaları ise genomik, tek-hücre foundation model'leri, protein modelleme, ilaç keşfi ve biyomedikal görüntüleme alanlarında sınıflandırmaktadır. Survey'nin temel vurgusu, biyolojik yapay zekâ araştırmalarının yalnız doğru tahmin üreten modellerden, modelin içinde hangi biyolojik programların ve hesaplama mekanizmalarının oluştuğunu inceleyen yaklaşımlara doğru ilerlediğidir.
Bu değişimde sparse autoencoder'lar (SAE) özellikle önem kazanmıştır. SAE'ler, büyük yapay sinir ağlarının birbirine karışmış iç temsillerini daha seyrek ve yorumlanabilir özelliklere ayırmayı amaçlar. Survey, bu yöntemin dil modellerinden biyolojik foundation model'lere taşınmasının; hücre tipi, gen programı veya histolojik yapı gibi biyolojik kavramların dağıtık embedding'ler içinden ayrıştırılmasına yönelik yeni bir araştırma hattı oluşturduğunu öne çıkarır.
Çalışma aynı zamanda önemli bir uyarı yapmaktadır: bir açıklamanın görsel olarak ikna edici olması, onun gerçekten modelin karar mekanizmasını temsil ettiği anlamına gelmez. Attention haritaları, saliency map'leri veya feature attribution değerleri modelden bağımsız örüntüler, girdinin kendi geometrisi veya korelasyonlar nedeniyle yanıltıcı olabilir. Bu nedenle biyolojik XAI'nin hedefi yalnız açıklama üretmek değil, açıklamanın model davranışına gerçekten bağlı olduğunu faithfulness testleri, sanity check'ler ve mümkün olduğunda müdahale deneyleriyle doğrulamaktır.
Neden biyolojide yapay zekânın kara kutu olması özel bir sorundur?
Birçok mühendislik uygulamasında modelin amacı doğru bir karar üretmek olabilir. Biyolojide ise model çoğu zaman doğrudan bilimsel anlamanın bir aracıdır. Bir biyolog yalnız bir DNA dizisinin düzenleyici olduğunu öğrenmek istemez; hangi nükleotidlerin etkili olduğunu, hangi motifin transkripsiyon faktörü bağlanmasını yönettiğini ve hangi mekanizma üzerinden gen ifadesinin değiştiğini de bilmek ister.
Aynı durum proteinler, hücreler ve moleküller için de geçerlidir. Bir protein modeli doğru yapıyı tahmin edebilir; fakat hangi aminoasit ilişkilerinin modeli bu yapıya götürdüğü ayrı bir bilimsel sorudur. Bir tek-hücre modeli hücre tipini doğru sınıflandırabilir; ancak kararın gerçekten biyolojik gen programına mı yoksa teknik batch etkisine mi dayandığı bilinmiyorsa model bilimsel olarak yanıltıcı olabilir.
Survey bu nedenle biyolojide açıklanabilirliğin yalnız güven veya kullanıcı deneyimi meselesi olmadığını, doğrudan bilimsel hipotez üretimiyle ilişkili olduğunu savunmaktadır.
Biyolojide Açıklanabilir Yapay Zekâ Ne Yapmaya Çalışır?
Biyolojik XAI, model çıktısının hangi biyolojik girdilerle, temsil edilen kavramlarla veya iç hesaplama süreçleriyle ilişkili olduğunu belirleyerek tahmini biyolojik olarak anlamlandırılabilir bir açıklamaya dönüştürmeye çalışır; ancak böyle bir açıklamanın bilimsel değer taşıması için model davranışına gerçekten faithful olduğunun ayrıca doğrulanması gerekir.
Intrinsic ve post-hoc açıklama
Survey iki temel yaklaşımı birbirinden ayırmaktadır. Intrinsic interpretability, modelin kendi yapısının anlaşılır olmasıdır. Seyrek doğrusal modeller, kısa karar listeleri veya biyolojik olarak anlamlandırılmış latent değişkenlere sahip mimariler buna örnek olabilir.
Post-hoc explanation ise karmaşık ve doğrudan okunamayan bir model eğitildikten sonra onun davranışını açıklamak için ek yöntemler kullanır. SHAP, Integrated Gradients veya Grad-CAM gibi yöntemler bu sınıfa girer.
Post-hoc yaklaşım güçlü modellerin incelenmesini mümkün kılar; fakat açıklama modelin kendisi değil, model hakkında sonradan hesaplanan bir nesnedir. Bu nedenle açıklamanın modelin gerçek karar mantığına sadık olup olmadığı ayrıca sınanmalıdır.
Local ve global açıklama
Bir local explanation, tek bir model çıktısına odaklanır. Örneğin belirli bir DNA dizisinin neden enhancer olarak sınıflandırıldığını veya belirli bir hücrenin neden T hücresi olarak tanımlandığını açıklamaya çalışır.
Global explanation ise modelin genel davranışını inceler. Örneğin genom boyunca modelin sürekli hangi motifleri kullandığı veya protein modeli içinde belirli attention head'lerinin genel olarak hangi yapısal ilişkileri temsil ettiği araştırılabilir.
Feature attribution
Feature-attribution yöntemleri model çıktısındaki değişimin hangi giriş özellikleriyle ilişkili olduğunu puanlamaya çalışır. Biyoloji açısından bu yaklaşım özellikle doğaldır; çünkü giriş özelliklerinin kendileri çoğu zaman fiziksel veya biyolojik birimlerdir:
- DNA modelinde nükleotid,
- tek-hücre modelinde gen,
- protein modelinde aminoasit kalıntısı,
- molekül modelinde atom veya bağ,
- histopatoloji modelinde piksel veya görüntü bölgesi.
Survey'nin ele aldığı başlıca feature-attribution yöntemleri LIME, SHAP, Integrated Gradients, DeepLIFT, Layer-wise Relevance Propagation ve Grad-CAM'dir.
| Yöntem ailesi | Temel soru | Tipik çıktı | Biyolojik kullanım biçimi |
|---|---|---|---|
| LIME | Bu tek tahmin çevresinde hangi özellikler etkili? | Yerel surrogate model | Belirli örneğin özellik katkıları |
| SHAP | Her özelliğin tahmine marjinal katkısı nedir? | Shapley tabanlı önem değerleri | Gen, klinik özellik veya moleküler özellik atfı |
| Integrated Gradients | Girişten çıktıya gradient boyunca hangi özellikler katkı sağlıyor? | Girdi-başına attribution | Nükleotid, aminoasit veya görüntü pikseli önem haritası |
| DeepLIFT | Aktivasyon referansa göre nasıl değişiyor? | Katkı skorları | Özellikle genomik motif analizi |
| Grad-CAM | Görüntünün hangi bölgeleri sınıf skorunu destekliyor? | Isı haritası | Histopatoloji ve tıbbi görüntüleme |
| TCAV | Model insan tarafından tanımlanmış bir kavrama duyarlı mı? | Concept activation yönü | Yolak, hücre tipi veya biyolojik imza analizi |
| Sparse Autoencoder | Dağıtık iç temsiller hangi seyrek özelliklere ayrılabilir? | Yorumlanabilir latent özellikler | Foundation model içindeki hücre tipi veya doku programlarının ayrıştırılması |
Attention Ağırlıkları Neden Tek Başına Açıklama Sayılmaz?
Attention ağırlıkları modelin belirli tokenlar arasında hangi bilgi yollarına ağırlık verdiğini gösterebilir, ancak aynı model çıktısının farklı attention dağılımlarıyla üretilebilmesi nedeniyle yüksek attention değeri tek başına nedensel veya faithful bir açıklama değildir; biyolojide attention haritaları bu nedenle doğrulanması gereken hipotezler olarak ele alınmalıdır.
Bu ayrım protein modelleri açısından özellikle önemlidir. Protein dizisindeki tokenlar aminoasitleri temsil ettiğinde bir attention head'in belirli rezidülere yüksek ağırlık vermesi biyolojik olarak çekici bir görüntü oluşturabilir. Ancak bunun gerçekten bağlanma arayüzü, temas bölgesi veya işlevsel motif anlamına geldiği ancak bağımsız yapısal bilgiyle karşılaştırılarak gösterilebilir.
Survey, protein dil modellerine ilişkin çalışmalarda belirli attention head'lerinin yapısal temaslar, bağlanma bölgeleri ve post-translational modification bölgeleriyle ilişkili olduğunun nicel karşılaştırmalarla araştırıldığını örnek olarak verir. Ana yöntemsel ders, attention görselleştirmesinin sonuç değil başlangıç noktası olmasıdır.
Kavram-temelli açıklamalar
Tek bir nükleotid veya gen düzeyindeki attribution, biyoloğun düşündüğü kavram ölçeğinden daha düşük olabilir. Araştırmacı çoğu zaman “hangi gen?” yerine “hangi yolak?”, “hangi hücre programı?” veya “hangi biyolojik süreç?” sorusunu sorar.
Concept-based yöntemler model aktivasyonlarının insan tarafından tanımlanmış yüksek düzeyli kavramlarla ilişkisini incelemeyi amaçlar. Survey'nin ele aldığı Testing with Concept Activation Vectors (TCAV), belirli bir kavram için aktivasyon uzayında bir yön öğrenir ve model tahminlerinin bu yöne duyarlılığını ölçer.
Biyoloji bu yaklaşım için zengin bir alan sunar; çünkü gen setleri, hücre tipi imzaları, moleküler yolaklar ve fonksiyonel ontolojiler insan tarafından önceden tanımlanmış kavram sözlükleri oluşturur.
Mekanistik Yorumlanabilirlik Feature Attribution'dan Nasıl Ayrılır?
Feature attribution bir tahminin hangi girdilerle ilişkili olduğunu sorarken mechanistic interpretability modelin iç aktivasyonları ve ağırlıkları içinde hangi özelliklerin temsil edildiğini, bu özelliklerin hangi bağlantılar üzerinden birleştiğini ve belirli çıktıyı oluşturmak için hangi hesaplama devrelerinin çalıştığını çözmeye çalışır.
Bu nedenle mekanistik yorumlanabilirlik, modeli dışarıdan sorgulamak yerine iç yapısını tersine mühendislik konusu haline getirir. Amaç yalnız “bu gen önemli” demek değil, modelin belirli bir hücre programını hangi latent temsil içinde kodladığını ve bu temsilin sonraki katmanlarda hangi hesaplamayı etkilediğini belirlemektir.
Superposition problemi
Modern sinir ağlarında tek bir nöronun yalnız tek bir insan-anlamlı özelliği temsil ettiği varsayımı çoğu zaman geçerli değildir. Bir ağ, sahip olduğu fiziksel nöron sayısından daha fazla özelliği üst üste binen yönlerde kodlayabilir. Survey bu durumu superposition kavramıyla açıklar.
Sonuç olarak tek bir nöron birden fazla kavramla ilişkili olabilir ve doğrudan “bu nöron T hücresini temsil ediyor” biçimindeki yorumlar yanıltıcı hale gelebilir.
Sparse Autoencoder Biyolojik Foundation Model'lerde Ne Sağlar?
Sparse autoencoder, yoğun ve üst üste binmiş model aktivasyonlarını daha geniş fakat seyrek etkinleşen bir özellik sözlüğüne ayırmaya çalışarak tek tek latent özelliklerin belirli hücre tipleri, gen programları veya histolojik yapılar gibi biyolojik kavramlarla eşleştirilmesini kolaylaştırır.
SAE yaklaşımında modelin kendi parametrelerinin yerine belirli ara katman aktivasyonları analiz edilir. Autoencoder bu aktivasyonları daha yüksek boyutlu bir feature dictionary üzerinden yeniden oluşturmayı öğrenir; sparsity kısıtı aynı örnekte yalnız az sayıdaki özelliğin güçlü biçimde aktive olmasını teşvik eder.
Survey'nin özellikle vurguladığı gelişme, bu yöntemin büyük dil modeli yorumlanabilirliğinden biyolojik foundation model'lere taşınmasıdır. Kaynak, patoloji foundation model'lerinde histolojik yapılarla ve tek-hücre foundation model temsillerinde hücre tipi programlarıyla ilişkilendirilebilen sparse özelliklerin raporlandığı çalışmaları tartışmaktadır.
Bunun bilimsel önemi yalnız latent özelliklere isim vermek değildir. Eğer belirli bir SAE özelliği aktive veya baskılanarak model çıktısı sistematik biçimde değiştirilebiliyorsa, açıklama korelasyondan müdahale düzeyine yaklaşır.
Düzenleyici genomik
Genomik, XAI'nin biyolojide erken kullanıldığı alanlardan biridir. DNA dizileri doğrudan model girdisi olduğunda her nükleotid veya motif üzerinde attribution hesabı yapmak mümkündür.
Survey DeepBind, DeepSEA, Basset, ExPecto, BPNet ve Enformer gibi model ailelerini bu gelişim hattı içinde tartışmaktadır. Özellikle base-resolution modeller ile DeepLIFT ve motif keşfi yöntemlerinin birleştirilmesi, yalnız bilinen motiflerin yeniden bulunmasını değil motiflerin birlikte nasıl düzenlendiğine ilişkin hipotezlerin oluşturulmasını da mümkün hale getirmiştir.
Tek-hücre foundation model'leri
Geneformer, scGPT, scFoundation ve Universal Cell Embeddings gibi modeller milyonlarca hücreden öğrenilen dağıtık temsiller oluşturur. Bu embedding'ler hücre tipi sınıflandırma ve perturbation prediction gibi downstream görevlerde kullanılabilir; ancak bir embedding boyutunun biyolojik olarak ne temsil ettiği çoğu zaman doğrudan bilinmez.
Survey'ye göre mekanistik yorumlanabilirliğin biyolojiye taşınmasının en belirgin örneklerinden biri bu alandır. Sparse dictionary learning ile latent özelliklerin hücre tipi ve gene-set programlarıyla eşleştirilmesi, foundation model'in iç temsilini biyologların kullandığı kavram sözlüğüne yaklaştırmaktadır.
Ancak bir özellik ile bir gene-set arasındaki korelasyon tek başına mekanistik sonuç değildir. Survey özellikle belirli latent özelliklere müdahale edilip model davranışının değişip değişmediğinin test edilmesini daha güçlü kanıt standardı olarak öne çıkarır.
Protein modelleri
Protein dil modelleri yüz milyonlarca protein dizisinden yapısal ve fonksiyonel temsiller öğrenebilir. Protein tokenlarının doğrudan aminoasit kalıntılarına karşılık gelmesi yorumlanabilirlik açısından özel bir avantaj sağlar.
Attention head'lerinin temas noktaları, bağlanma bölgeleri veya post-translational modification konumlarıyla eşleşip eşleşmediği doğrudan yapısal anotasyonlarla karşılaştırılabilir. Bu yapı protein model'lerini mechanistic interpretability ve sparse dictionary yöntemleri için güçlü bir hedef haline getirmektedir.
Molekül ve ilaç keşfi
Graph neural network'ler molekülleri atom ve bağlardan oluşan grafikler olarak işler. Bir molekülün aktivitesini açıklamak, çoğu zaman hangi altgraf veya kimyasal grubun tahmine katkı sağladığını belirlemek anlamına gelir.
Survey GNNExplainer gibi yöntemlerin tahmini mümkün olduğunca koruyan küçük bir moleküler altgraf bulmaya çalıştığını açıklar. Böylece açıklama yalnız bir önem skoru olmaktan çıkıp kimyagerin inceleyebileceği bir moleküler motif haline gelebilir.
Klinik görüntüleme ve dijital patoloji
Histopatoloji ve diğer biyomedikal görüntülerde Grad-CAM ve saliency tabanlı yöntemler, sınıflandırma kararını etkileyen görüntü alanlarını işaretlemek için yaygın biçimde kullanılmaktadır.
Fakat bu alan XAI'nin en kritik riskini de açık biçimde gösterir: bir tümör sınıflandırıcısı gerçek histolojik özellik yerine tarayıcı artefaktını, hastane işaretini veya görüntüleme protokolünü kullanabilir. Görsel açıklama bu tür shortcut'ları fark etmeye yardımcı olabilir; fakat kötü tasarlanmış bir açıklama yöntemi aynı artefaktı biyolojik sinyal gibi de gösterebilir.
Çalışmanın Yöntemi ve Bulguları
Bu çalışma ne tür bir yöntem kullanmıştır?
Çalışma yeni bir deneysel model geliştirmemektedir. Yazar mevcut XAI ve mechanistic interpretability literatürünü kavramsal bir taksonomi altında birleştirmektedir. Survey iki bağımsız eksen kullanır:
- Yöntem ekseni: feature attribution, attention analysis, concept-based explanation ve mechanistic interpretability.
- Uygulama ekseni: genomik, tek-hücre/foundation model'ler, proteinler, molekül ve ilaç keşfi, klinik görüntüleme ve patoloji.
| Alan | Model girdisi / temsili | Tipik yorumlanabilirlik sorusu | Doğrulama imkânı |
|---|---|---|---|
| Düzenleyici genomik | DNA dizisi | Hangi nükleotid veya motif çıktıyı etkiliyor? | Bilinen motifler, bağlanma ve düzenleyici deneyler |
| Tek-hücre biyolojisi | Gen ifadesi / hücre embedding'i | Hangi gen programı veya hücre durumu temsil ediliyor? | Gene-set, hücre tipi anotasyonu ve perturbation |
| Protein modelleri | Aminoasit dizisi / internal representation | Model hangi yapısal veya işlevsel ilişkiyi kodluyor? | Protein yapıları, temas ve bağlanma bölgeleri |
| Molekül ve ilaç keşfi | Atom-bağ grafiği | Hangi alt-yapı aktivite tahminini yönlendiriyor? | Kimyasal deneyler ve yapı-aktivite ilişkisi |
| Dijital patoloji | Görüntü | Model hangi doku bölgelerine dayanıyor? | Patoloji anotasyonu ve klinik doğrulama |
Açıklamanın doğru olduğunu nasıl anlarız?
Survey'nin en güçlü metodolojik mesajlarından biri açıklamanın ayrıca değerlendirilmesi gerektiğidir. Bir modelin tahmini doğru olsa bile açıklaması yanlış olabilir.
Kaynak üç temel doğrulama yaklaşımını öne çıkarır:
- Sanity check: Model ağırlıkları veya etiketler rastgeleleştirildiğinde açıklama da değişiyor mu?
- Faithfulness testi: Önemli olduğu iddia edilen özellik kaldırıldığında veya değiştirildiğinde model çıktısı gerçekten etkileniyor mu?
- Biyolojik ground truth karşılaştırması: Attribution veya model özelliği bilinen motif, bağlanma bölgesi, pathway veya hücre tipi anotasyonuyla uyuşuyor mu?
Bu kontrollerin amacı bir açıklamanın insan gözüne anlamlı görünmesini değil, modelin gerçek hesaplamasıyla bağlantısını sınamaktır.
Nedensel Müdahale Neden Daha Güçlü Bir Açıklama Testidir?
Nedensel müdahale, model içinde belirli bir latent özellik veya devre kontrollü biçimde azaltıldığında ya da güçlendirildiğinde çıktıdaki değişimi ölçtüğü için yalnız korelasyonu göstermekten daha güçlüdür; bu yaklaşım biyolojideki perturbation deneyinin mantığını yapay sinir ağının iç temsillerine uygular.
Bir latent feature belirli bir hücre tipiyle korelasyon gösteriyorsa bu tek başına o feature'ın model kararında gerekli olduğunu kanıtlamaz. Özellik devre dışı bırakıldığında hücre sınıflandırması veya başka bir downstream davranış sistematik olarak değişirse, mekanistik ilişki için daha güçlü kanıt elde edilir.
Survey bu interventionist standardı, biyolojinin deneysel kültürüyle özellikle uyumlu görmektedir.
Açık problem: biyolojik ground truth eksiktir
XAI'nin biyolojideki temel paradokslarından biri şudur: açıklamanın doğru olup olmadığını kontrol etmek için biyolojik gerçekliğe ihtiyaç vardır; fakat incelenen mekanizmanın kendisi çoğu zaman henüz tam bilinmemektedir.
Bir genom modeli bilinmeyen bir bölgeyi önemli gösterdiğinde iki açıklama mümkündür:
- model gerçekten yeni bir biyolojik düzenleyici unsur yakalamıştır;
- model veri setindeki bir artefakta dayanıyordur.
Yalnız attribution haritasına bakarak bu iki olasılık ayrıştırılamaz. Yeni biyolojik deney veya bağımsız doğrulama gerekebilir.
Açık problem: foundation model ölçeği
Biyolojik foundation model'ler büyüdükçe her nöron veya circuit'in insan tarafından tek tek analiz edilmesi mümkün olmaktan çıkar. Sparse dictionary learning bu sorunu kısmen otomatikleştirmeyi vaat eder; ancak survey dictionary size seçimi, tek bir biyolojik kavramın birden fazla sparse feature'a parçalanması ve özelliklerin circuit düzeyinde birbirine bağlanması gibi sorunların henüz çözülmediğini vurgular.
Interpretability by design
Kaynağın araştırma gündemindeki bir diğer yön, modeli eğittikten sonra açıklamak yerine baştan biyolojik olarak anlamlandırılabilir latent yapılarla tasarlamaktır.
Örneğin latent değişkenler doğrudan pathway, hücre tipi veya biyofiziksel büyüklüklerle sınırlandırılabilirse post-hoc açıklamaya olan ihtiyaç azalabilir. Ancak bunun model doğruluğunu ve genellemesini nasıl etkilediği ayrıca araştırılmalıdır.
Çalışmanın desteklediği sonuçlar
Survey'nin desteklediği: Biyolojik XAI literatürü basit feature attribution'dan daha yüksek düzeyli kavramsal ve mekanistik analizlere doğru genişlemektedir. Sparse autoencoder ve circuit analysis gibi yöntemlerin biyolojik foundation model'lere uygulanmaya başlaması, model içindeki temsilleri biyolojik kavramlarla ilişkilendirmek için yeni imkânlar açmaktadır. Bununla birlikte explanation faithfulness bağımsız olarak test edilmelidir.
Çalışmanın desteklemediği sonuçlar
Survey'nin desteklemediği: Her attention map'in biyolojik mekanizmayı temsil ettiği, her saliency map'in güvenilir olduğu, sparse autoencoder feature'larının otomatik olarak gerçek biyolojik varlıklara karşılık geldiği veya mechanistic interpretability'nin mevcut haliyle biyolojik foundation model'leri tamamen çözdüğü sonucuna varılamaz.
Ayrıca survey yeni biyolojik mekanizmaları kendi deneyleriyle keşfetmemekte veya referans verdiği bütün çalışmaların sonuçlarını yeniden üretmemektedir.
Kaynak ve Yöntem Notu
Özgün çalışma: Opening the Biological Black Box: A Survey of Explainable and Mechanistic Interpretability Methods for AI in Biology.
Yazar: Olivia Denvis.
Afiliyasyon: Independent Researcher.
Kaynak türü: Survey / SSRN preprint.
Çalışma tarihi: 15 Haziran 2026.
SSRN yayım tarihi: 23 Haziran 2026.
SSRN Abstract ID: 6968318.
DOI: 10.2139/ssrn.6968318.
Hakemlik durumu: Kaynak, hakemli dergi makalesi olarak değil preprint olarak yayımlanmıştır.
Yayın lisansı / hak durumu: SSRN kaydı açık Creative Commons yeniden kullanım lisansı göstermemektedir ve korunan materyalin izinsiz yeniden kullanımına izin verilmediğini belirtmektedir. Bu nedenle Verianla metni kaynak ifadelerinin yeniden yayımı değildir; literatür survey'sinde raporlanan bilimsel kavramların bağımsız öğretici sentezidir.
Yeni deney/veri: Çalışma yeni biyolojik deney, veri seti veya benchmark üretmemektedir. Literatürdeki XAI ve mechanistic interpretability çalışmalarını sınıflandırmakta ve değerlendirmektedir.
Temel yöntemsel sınırlılık: Survey'nin aktardığı sonuçların deneysel kanıtı ilgili birincil çalışmalardadır. Bir yöntem veya uygulamaya ilişkin ayrıntılı performans değerlendirmesi için orijinal referansa dönülmelidir.
Temel epistemik sınırlılık: Biyolojide ground truth kısmi ve tartışmalı olabilir. Bu nedenle model açıklamasının bilinen biyolojiyle uyuşmaması her zaman açıklamanın yanlış olduğunu; uyuşması da otomatik olarak nedensel mekanizma olduğunu göstermez.
Referans kapsamı: Survey 44 çalışma üzerinden klasik XAI, biyolojik deep learning uygulamaları, foundation model'ler, mechanistic interpretability ve explanation-validation literatürünü bir araya getirmektedir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir