


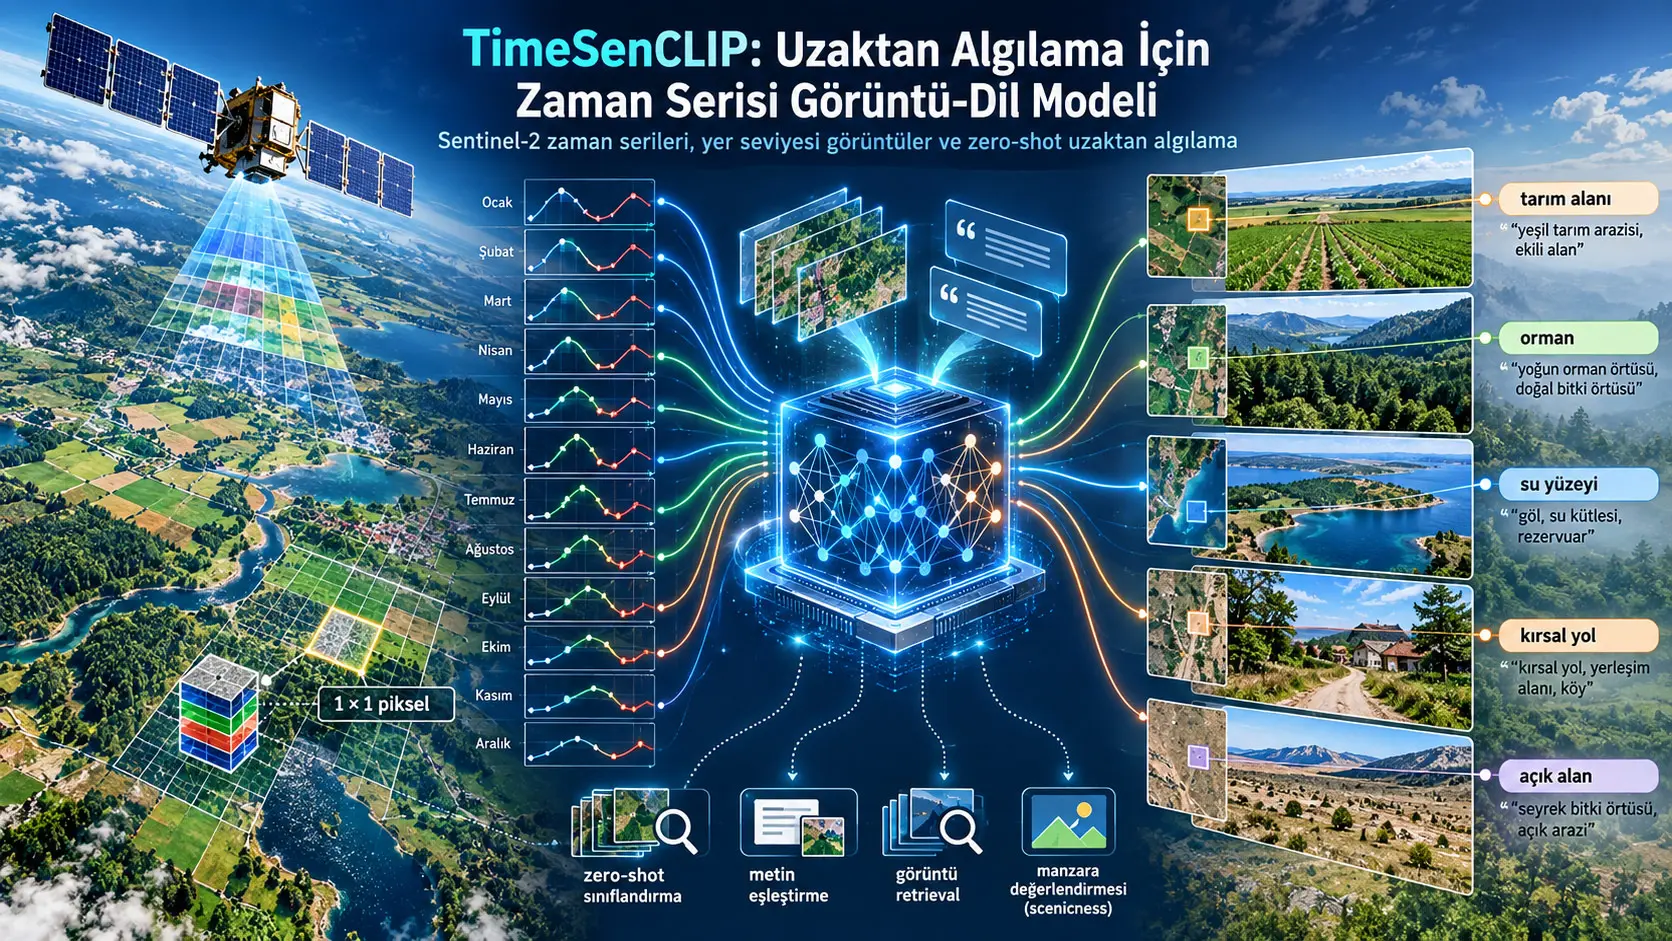
TimeSenCLIP, çok-spektrumlu Sentinel-2 uydu zaman serilerini coğrafi etiketli yer seviyesi fotoğraflarının semantik CLIP temsilleriyle çapraz-görünüm kontrastif öğrenme kullanarak hizalayan hafif bir görüntü–dil modelidir. Modelin ayırt edici özelliği, uydu tarafında büyük görüntü patch'lerine veya eğitim sırasında metinsel caption'lara ihtiyaç duymadan, yalnızca tek bir Sentinel-2 pikselinin spektral–zamansal değişiminden semantik temsil öğrenebilmesidir.
TimeSenCLIP; LUCAS 2018 yer seviyesi görüntüleri ile Sen4Map Sentinel-2 zaman serileri kullanılarak eğitilmiş; arazi örtüsü, arazi kullanımı, habitat, ürün türü ve biyocoğrafik bölge zero-shot sınıflandırması, çapraz-modal retrieval ve scenicness tahmini üzerinde değerlendirilmiştir. Ana 12-aylık, tek-piksel, multispektral TimeSenCLIP-P1 modeli descriptive promptlarla genel zero-shot Top-1 doğruluğunda %47,35 ± 0,18 değerine ulaşmıştır. Aynı modelin aylık zaman serisiyle genel çapraz-modal Recall@1 değeri Ground-to-Satellite yönünde 0,446, Satellite-to-Ground yönünde 0,535'tir.
Çalışmanın ana sonucu, Sentinel-2 gibi orta çözünürlüklü uzaktan algılama verilerinde zamansal ve spektral dinamiklerin birçok görev için geniş uzamsal bağlamın önemli bölümünü telafi edebildiğidir. Bununla birlikte bu sonuç bütün görevlerde “tek piksel her zaman yeterlidir” anlamına gelmez: habitat sınıflandırması ve scenicness gibi uzamsal yapı, doku ve arazi geometrisinin önemli olduğu problemlerde daha büyük patch'ler avantaj sağlayabilmektedir. Ayrıca model yalnız Sentinel-2 ve Avrupa merkezli LUCAS verileriyle değerlendirilmiştir; farklı sensörler, iklimler ve coğrafi bölgelerde aynı başarı henüz gösterilmemiştir.
Araştırma problemi
Uzaktan algılama için geliştirilen birçok vision–language model (VLM), doğal görüntüler için oluşturulmuş CLIP benzeri mimarileri uydu görüntülerine uyarlamaktadır. Bu yaklaşım üç temel sorun yaratır. Birincisi, eğitim çoğu zaman uydu görüntüsü–metin caption çiftlerine ihtiyaç duyar; bu tür açıklamalar hem pahalıdır hem de kullanılan sözcük dağarcığı tarafından sınırlandırılabilir. İkincisi, modeller genellikle yüzlerce piksel genişliğinde büyük uzamsal patch'lere dayanır. Sentinel-2 gibi orta çözünürlüklü sensörlerde büyük patch, heterojen bir tarım veya ekosistem mozaiğinde birbirinden farklı alanları tek girdiye karıştırabilir. Üçüncüsü, klasik RGB tabanlı yaklaşım mevsimsellik, fenoloji ve farklı dalga boylarındaki yansıtım özelliklerini yeterince kullanmaz.
TimeSenCLIP bu problemi tersinden sorar: Bir Sentinel-2 pikselinin yıl boyunca değişen çok-spektrumlu zaman serisi, büyük bir uzamsal görüntü patch'i olmadan arazi ve ekosistem semantiğini öğrenmek için yeterli bilgi taşıyor mu?
Çalışmanın yaklaşımı özellikle tarımsal ve ekolojik sınıflar açısından anlamlıdır. Örneğin buğday, mısır veya farklı vejetasyon sistemleri yalnız tek bir tarihteki görüntüleriyle birbirine benzeyebilir; fakat ekim, büyüme, olgunlaşma ve hasat boyunca oluşan yansıtım değişimleri farklı zamansal imzalar üretir.
TimeSenCLIP Tek Bir Sentinel-2 Pikselinden Nasıl Semantik Bilgi Öğreniyor?
TimeSenCLIP, aynı coğrafi konuma ait Sentinel-2 spektral–zamansal dizisini ve yer seviyesindeki fotoğrafları ortak bir embedding uzayında birbirine yaklaştırarak öğrenir; yer fotoğraflarının dondurulmuş CLIP görüntü kodlayıcısından gelen semantik bilgi uydu zaman serisine aktarılır ve eğitim tamamlandığında yalnız uydu encoder'ı ile CLIP text encoder kullanılarak yeni metin sınıfları üzerinde zero-shot tahmin yapılabilir.
Eğitimde iki görünüm bulunuyor
Yer seviyesi görünümü: LUCAS noktalarında dört ana yönde çekilmiş coğrafi etiketli fotoğraflar dondurulmuş CLIP ViT-B/32 görüntü encoder'ından geçirilir. CLIP doğal görüntüler ile dil arasında daha önce öğrenilmiş bir semantik uzaya sahip olduğundan bu fotoğraflar TimeSenCLIP için metinle hizalı semantik hedef görevi görür.
Uydu görünümü: Aynı konumun Sentinel-2 zaman serisi ayrı bir Transformer encoder tarafından işlenir. Uydu encoder'ı sıfırdan eğitilir ve yer görüntüsü embedding'ine yaklaşmayı öğrenir.
Kaynak-içi adlandırma notu: yöntemin genel özetinde birden fazla yer görüntüsünün “attention pooling” ile birleştirildiği belirtilmektedir. Ayrıntılı mimari açıklamasında ve Appendix A.4.3'te ise “average pooling” kullanılmaktadır. Kaynak bu iki ifadeyi ayrıca uzlaştırmadığı için burada tek bir ifadeyle sessizce değiştirilmemiştir.
Denklem (1): CLIP embedding'lerinin L2 normalizasyonu
\[ \mathbf{v}_i= \frac{f_{\mathrm{img}}(I_i)} {\left\|f_{\mathrm{img}}(I_i)\right\|_2}, \qquad \mathbf{t}_i= \frac{f_{\mathrm{text}}(T_i)} {\left\|f_{\mathrm{text}}(T_i)\right\|_2}. \tag{1} \]
Formül neyi hesaplar? Görüntü encoder'ının ve text encoder'ın ürettiği embedding vektörlerini birim uzunluğa getirir.
Değişkenler: \(I_i\), \(i\). görüntü; \(T_i\), ona karşılık gelen metin; \(f_{\mathrm{img}}\) görüntü encoder'ı; \(f_{\mathrm{text}}\) text encoder; \(\|\cdot\|_2\) Öklid/L2 normudur.
Matematiksel rol: Normalizasyon sonrasında embedding'lerin uzunluğu 1 olur. Böylece iki temsil arasındaki dot product doğrudan cosine similarity'ye karşılık gelir:
\[ \operatorname{sim}(\mathbf{v}_i,\mathbf{t}_j) = \mathbf{v}_i\cdot\mathbf{t}_j. \]
Embedding değerleri fiziksel ölçüm birimine sahip değildir; temsil uzayındaki boyutsuz sayılardır.
Denklem (2): InfoNCE kaybı
\[ \mathcal{L}_{\mathrm{InfoNCE}} (\mathbf{x},\mathbf{x}^{+},\{\mathbf{x}_{j}^{-}\}) = -\log \frac{ \exp(\mathbf{x}\cdot\mathbf{x}^{+}/\tau) }{ \exp(\mathbf{x}\cdot\mathbf{x}^{+}/\tau) + \sum_{j=1}^{J} \exp(\mathbf{x}\cdot\mathbf{x}_{j}^{-}/\tau) }. \tag{2} \]
Ne hesaplar? Bir anchor embedding'in doğru eşleşmeyle ne kadar güçlü, yanlış eşleşmelerle ne kadar zayıf benzerlik taşıdığını tek bir kontrastif kayıpta ölçer.
\(\mathbf{x}\) anchor örnek, \(\mathbf{x}^{+}\) doğru pozitif eşleşme, \(\mathbf{x}_{j}^{-}\) negatif örnekler ve \(\tau\) öğrenilebilir temperature parametresidir. Tüm büyüklükler embedding uzayında olduğundan fiziksel birimleri yoktur.
Pozitif çiftin cosine similarity'si yükseldiğinde pay büyür ve kayıp azalır. Negatif bir örneğin benzerliği yükseldiğinde payda büyür ve kayıp artar. Böylece model aynı coğrafi noktaya ait iki farklı görünümü birbirine yaklaştırırken diğer konumları uzaklaştırmayı öğrenir.
Denklem (3): Sentinel-2 zaman adımının embedding'e çevrilmesi
\[ \mathbf{r}_t= \operatorname{Linear} \left( \operatorname{Flatten}(\mathbf{R}_t) \right), \qquad t=1,\ldots,T. \tag{3} \]
Uydu girdisinin tamamı:
\[ \mathbf{R}\in \mathbb{R}^{T\times C\times H\times W} \]
biçimindedir. \(T\) zaman adımı sayısı, \(C\) spektral bant sayısı, \(H\times W\) uzamsal boyuttur. Ana TimeSenCLIP-P1 konfigürasyonunda \(H=W=1\), \(C=10\) ve aylık kullanımda \(T=12\)'dir.
Her \(\mathbf{R}_t\) zaman dilimi önce düzleştirilir, ardından öğrenilebilir linear projection ile Transformer'ın kullanabileceği embedding boyutuna dönüştürülür. Sentinel-2 bantları eğitimden önce bant bazında min–max normalizasyonuyla \([0,1]\) aralığına ölçeklenmiştir.
Denklem (4): Zamansal token dizisinin oluşturulması
\[ \mathbf{Z} = [ \mathbf{p}_{\mathrm{cls}}; \mathbf{r}_1+\mathbf{p}_1; \ldots; \mathbf{r}_T+\mathbf{p}_T ]. \tag{4} \]
\(\mathbf{p}_{\mathrm{cls}}\), tüm zaman serisinin özetini taşıması için öğrenilen CLS token'ıdır. \(\mathbf{p}_t\), \(t\). zaman adımının dizideki yerini kodlayan öğrenilebilir temporal position embedding'dir.
Bu yapı neden gereklidir? Aynı yansıtım değerinin Mart ayında görülmesiyle Ağustos ayında görülmesi ekolojik açıdan aynı anlamı taşımayabilir. Position embedding modelin “hangi gözlem hangi ay/zaman konumunda?” bilgisini korumasına yardım eder.
Denklem (5): Transformer zaman serisi encoder'ı
\[ \hat{\mathbf{s}} = f_S(\mathbf{Z}). \tag{5} \]
\(f_S\), TimeSenCLIP'in eğitilebilir uydu Transformer encoder'ıdır. Kaynakta bu encoder 6 Transformer katmanı, 8 attention head, 256 hidden dimension ve 512 latent dimension kullanmaktadır. GELU aktivasyonları ve LayerNorm uygulanır. Son CLS çıktısı iki katmanlı hafif bir MLP projection head'den geçirilir.
Denklem (6): Uydu ve yer embedding'lerinin normalizasyonu
\[ \mathbf{s} = \frac{\hat{\mathbf{s}}}{\|\hat{\mathbf{s}}\|_2}, \qquad \mathbf{g} = \frac{\hat{\mathbf{g}}}{\|\hat{\mathbf{g}}\|_2}. \tag{6} \]
\(\hat{\mathbf{s}}\) uydu encoder'ının ham çıktısı, \(\hat{\mathbf{g}}\) yer seviyesi CLIP temsilidir. Normalizasyondan sonra \(\mathbf{s}\) ve \(\mathbf{g}\) aynı 512 boyutlu ortak latent uzayda karşılaştırılabilir.
Denklem (7): TimeSenCLIP'in gerçek eğitim kaybı
\[ \mathcal{L}_{\mathrm{TimeSenCLIP}} ( \{\mathbf{s}_i\}, \{\mathbf{g}_i\}, \mathcal{Q} ) = \sum_i \mathcal{L}_{\mathrm{InfoNCE}} \left( \mathbf{s}_i, \mathbf{g}_i^{+}, \{\mathbf{g}_{j}^{-}\}_i \cup \mathcal{Q} \right). \tag{7} \]
\(\mathbf{g}_i^{+}\), uydu örneğiyle aynı coğrafi noktaya ait yer görüntüsü temsilidir. \(\mathbf{g}_{j}^{-}\), batch içindeki farklı konumlardan gelen negatif örneklerdir. \(\mathcal{Q}\), geçmiş batch'lerden gelen yer embedding'lerini saklayan MoCo-tipi memory queue'dur.
Queue büyüklüğü kaynakta \(K=2048\)'dir. Bunun amacı çok büyük batch'ler gerektirmeden uydu örneğinin çok sayıda negatif konuma karşı öğrenebilmesini sağlamaktır.
Zamansal augmentasyon neden kullanılıyor?
Gerçek Sentinel-2 zaman serilerinde bulut, eksik acquisition veya mevsimsel veri boşlukları görülebilir. TimeSenCLIP eğitim sırasında her batch için %50 olasılıkla üç zamansal perturbasyondan birini uygular:
- Median Pooling: bütün zaman adımlarını tek bir median spektral vektöre indirger.
- Random Quarter Mask: birbirini izleyen yaklaşık üç aylık bir bölümü maskeler.
- Random Temporal Mask: 1–11 zaman adımını rastgele maskeler; en az bir gözlem korunur.
Bu augmentasyonlar yalnız eğitim sırasında kullanılır. Çıkarım sırasında model aylık \(T=12\), çeyreklik \(T=4\) veya bütün yılın medianını kullanan tek-zaman \(T=1\) girdiyle çalıştırılabilir.
Metin promptları nasıl oluşturuldu?
Zero-shot değerlendirmede üç prompt biçimi karşılaştırılmıştır:
- Class-name: yalnız sınıfın adı.
- Generic: “a centered satellite image of {class name}” gibi genel şablon.
- Description: sınıfın görünüşünü veya ekolojik özelliklerini açıklayan doğal dil cümleleri.
Her sınıf için beş descriptive varyasyon GPT-4 kullanılarak SenCLIP yaklaşımına benzer biçimde oluşturulmuştur. Bu promptlar eğitim caption'ı değildir; modelin zero-shot değerlendirilmesi sırasında CLIP text encoder'a verilen sınıf açıklamalarıdır. Descriptive promptlar için text embedding'leri late prompt ensembling ile birleştirilmiştir.
Zamansal Bilgi Büyük Uydu Patch'lerinin Yerini Tutabilir mi?
Çalışmanın sonuçlarına göre birçok arazi, ürün ve biyobölge görevinde uzun bir Sentinel-2 zaman serisi tek piksel girdinin daha büyük uzamsal patch'lerle rekabet etmesini veya onları aşmasını sağlayabilir; ancak habitat ve scenicness gibi doku, geometri ve geniş uzamsal düzen gerektiren görevlerde daha büyük patch'ler hâlâ yarar sağlamaktadır.
Çalışmanın Yöntemi ve Bulguları
LUCAS ve Sen4Map veri yapısı
| Öğe | Kaynakta kullanılan yapı |
|---|---|
| LUCAS yılı | 2018 |
| LUCAS kapsamı | Yaklaşık 235.000 coğrafi referanslı nokta, 28 ülke |
| Yer görüntüleri | Kuzey, doğu, güney ve batı yönlerinde yüksek çözünürlüklü fotoğraflar |
| Sentinel-2 kaynağı | Sen4Map |
| Kaynak patch | 64 × 64 piksel |
| Spektral bant | 10 bant; 10 m ve 20 m çözünürlükler |
| Yıllık zaman adımı | 12 aylık median kompozit |
| Eğitim | 140.000 örnek |
| Doğrulama | 30.000 örnek |
| Test | 50.000 örnek |
| Ana TimeSenCLIP girdisi | Patch merkezinden 1 × 1 piksel |
| Spatial ablation | 1×1, 5×5, 9×9, 16×16 ve 64×64 bağlamlar |
Değerlendirme görevleri
| Görev | Sınıf / veri yapısı | Ana metrik |
|---|---|---|
| Land Cover | 8 sınıf | Top-1 accuracy |
| Land Use | 16 sınıf | Top-1 accuracy |
| Crops | Tablo 2'de 40 sınıf; metinde 38 specific crop type | Top-1 accuracy |
| EUNIS Habitat | 44 terrestrial habitat tipi | Top-1 accuracy |
| Bioregion | Tablo 2'de 8 sınıf | Top-1 accuracy |
| Country retrieval | 28 ülke etiketi | Recall@1 |
| Scenicness | UK ScenicOrNot; 2411 eşleşmiş örnek | Pearson \(R\), Kendall \(\tau\) |
Crop-class kaynak notu: ana yöntem metni LUCAS Level-1'in 38 specific crop type içerdiğini söylerken Tablo 2 “Crops — 40 classes” değerini vermektedir. Kaynak farkı burada aynen korunmuştur.
Eğitim hiperparametreleri
| Ground encoder | CLIP ViT-B/32, dondurulmuş |
|---|---|
| Ground embedding | 512 boyut |
| Satellite Transformer | 6 katman, 8 attention head |
| Hidden dimension | 256 |
| Latent dimension | 512 |
| Memory queue | 2048 negatif embedding |
| Optimizer | AdamW |
| Başlangıç learning rate | \(10^{-4}\) |
| Weight decay | \(1\times10^{-6}\) |
| AdamW \(\beta_1,\beta_2\) | 0,9; 0,999 |
| Schedule | Cosine annealing |
| Warm-up | 10 epoch |
| Toplam eğitim | 200 epoch |
| Batch size | 1024 |
| Donanım | Tek NVIDIA TITAN X GPU |
Zero-shot sınıflandırmada ana sonuç
| Model | Girdi | T | Overall C (%) | Overall G (%) | Overall D (%) |
|---|---|---|---|---|---|
| CLIP | 64×64 RGB | 1 | 20,37 ± 0,22 | 22,14 ± 0,21 | 22,66 ± 0,20 |
| GeoRSCLIP | 64×64 RGB | 1 | 21,35 ± 0,10 | 24,74 ± 0,22 | 27,32 ± 0,15 |
| RemoteCLIP | 64×64 RGB | 1 | 20,35 ± 0,14 | 23,78 ± 0,10 | 23,31 ± 0,11 |
| SkyCLIP | 64×64 RGB | 1 | 7,91 ± 0,06 | 10,36 ± 0,10 | 16,68 ± 0,10 |
| SenCLIP | 64×64 RGB | 1 | 25,75 ± 0,10 | 25,91 ± 0,10 | 25,89 ± 0,14 |
| Llama3-MS-CLIP | Multispektral | 1 | 24,29 ± 0,12 | 25,35 ± 0,11 | 26,28 ± 0,13 |
| TimeSenCLIP-P64 | 64×64 RGB | 1 | 34,68 ± 0,16 | 36,27 ± 0,15 | 39,15 ± 0,24 |
| TimeSenCLIP-P1-RGB | 1×1 RGB | 1 | 32,33 ± 0,16 | 32,97 ± 0,14 | 32,49 ± 0,12 |
| TimeSenCLIP-P1-MS | 1×1 multispektral | 1 | 35,26 ± 0,11 | 36,47 ± 0,13 | 37,46 ± 0,15 |
| TimeSenCLIP-P1-MS | 1×1 multispektral | 12 | 42,02 ± 0,15 | 44,22 ± 0,16 | 47,35 ± 0,18 |
Aylık tek-piksel multispektral model görev bazında ne yaptı?
| Görev | Class-name (%) | Generic (%) | Description (%) |
|---|---|---|---|
| Land Cover | 62,40 | 61,35 | 66,49 |
| Land Use | 54,45 | 60,67 | 64,59 |
| Habitat | 24,06 | 25,01 | 30,90 |
| Crops | 29,33 | 28,42 | 40,36 |
| Bioregion | 49,87 | 45,65 | 34,42 |
Descriptive promptlar genel ortalamada en yüksek sonucu verse de her görevde aynı prompt türü en iyi değildir. Örneğin Bioregion için yalnız sınıf adıyla %49,87 doğruluk, descriptive prompt ile %34,42 doğruluk elde edilmiştir. Bu, “daha uzun prompt her zaman daha iyi” sonucunun desteklenmediğini gösterir.
Cross-modal retrieval sonuçları
Retrieval değerlendirmesinde Recall@1 kullanılır. Bir sorgunun ilk sırada döndürdüğü örnek sorguyla aynı sınıfa aitse başarılı kabul edilir.
| Model | Genel G2S Recall@1 | Genel S2G Recall@1 |
|---|---|---|
| CLIP | 0,327 | 0,161 |
| GeoRSCLIP | 0,360 | 0,209 |
| RemoteCLIP | 0,291 | 0,232 |
| SkyCLIP | 0,126 | 0,167 |
| SenCLIP | 0,362 | 0,306 |
| Llama3-MS-CLIP | 0,218 | 0,167 |
| TimeSenCLIP-P64-RGB, T=1 | 0,416 | 0,460 |
| TimeSenCLIP-P1-RGB, T=1 | 0,331 | 0,331 |
| TimeSenCLIP-P1-MS, T=1 | 0,352 | 0,365 |
| TimeSenCLIP-P1-MS, T=12 | 0,446 | 0,535 |
Aylık tek-piksel model özellikle S2G yönünde güçlüdür. Görev bazında S2G Recall@1; Land Cover 0,660, Land Use 0,682, Habitat 0,433, Crops 0,411, Bioregion 0,634 ve Country 0,392'dir.
Scenicness tahmini
Scenicness, bir manzaranın insanlar tarafından algılanan görsel güzelliğine ilişkin sürekli bir skordur. Çalışma Birleşik Krallık ScenicOrNot verisinden 2411 örneği, en yakın Sen4Map konumuyla 100 m içinde eşleştirmiştir.
Pearson \(R\) tahmin ile ground-truth arasındaki doğrusal korelasyonu, Kendall \(\tau\) ise sıralama uyumunu ölçer. Her iki ölçü de boyutsuzdur.
| Model | T | Girdi | Late \(R\) | Late \(\tau\) |
|---|---|---|---|---|
| CLIP — yer görüntüsü | 1 | Yer fotoğrafı | 0,660 | 0,465 |
| CLIP — satellite | 1 | 64×64 | 0,519 | 0,363 |
| SenCLIP | 1 | 64×64 | 0,421 | 0,283 |
| TimeSenCLIP-RGB | 1 | 64×64 | 0,660 | 0,450 |
| TimeSenCLIP-MS | 1 | 1×1 | 0,318 | 0,205 |
| TimeSenCLIP-MS | 4 | 1×1 | 0,451 | 0,312 |
| TimeSenCLIP-MS | 12 | 1×1 | 0,527 | 0,363 |
Appendix A.1'de tüm prompt-ensemble stratejilerinin ortalaması incelendiğinde TimeSenCLIP-P64-RGB aylık girişte \(R=0.639\), \(\tau=0.440\); tek-piksel P1-MS ise \(R=0.526\), \(\tau=0.363\) elde etmiştir. Bu sonuç scenicness için zamansal bilginin yardımcı olduğunu, ancak geniş uzamsal bağlamın manzara geometrisi ve doku gibi özellikler nedeniyle değerini koruduğunu göstermektedir.
Klasik zaman serisi mimarileriyle karşılaştırma
| Model | Overall C (%) | Overall G (%) | Overall D (%) |
|---|---|---|---|
| Supervised upper bound | 73,70 | – | – |
| CNN1D | 39,04 ± 0,19 | 41,96 ± 0,22 | 44,88 ± 0,15 |
| ConvTran | 40,06 ± 0,24 | 42,76 ± 0,24 | 45,89 ± 0,22 |
| MLP | 41,20 ± 0,24 | 43,89 ± 0,22 | 46,72 ± 0,14 |
| TempCNN | 41,94 ± 0,24 | 43,45 ± 0,22 | 45,41 ± 0,11 |
| Transformer — TimeSenCLIP | 42,02 ± 0,15 | 44,22 ± 0,16 | 47,35 ± 0,18 |
Transformer genel ortalamada en yüksek sonucu vermiştir; ancak her görev hücresinde rakipsiz değildir. TempCNN örneğin Habitat descriptive promptta %33,37 ile Transformer'ın %30,90 değerini geçmektedir. Dolayısıyla kaynak “Transformer bütün alt görevlerde mutlak en iyi mimaridir” iddiası sunmamaktadır.
Temporal dropout gerçekten işe yaradı mı?
| T | Temporal Drop | MS Drop | Land Cover | Land Use | Habitat | Bioregion | Crops | Ortalama |
|---|---|---|---|---|---|---|---|---|
| 1 | Hayır | Hayır | 28,69 | 25,86 | 9,52 | 18,68 | 3,23 | 17,20 |
| 1 | Hayır | Evet | 23,76 | 27,88 | 8,39 | 18,18 | 2,93 | 16,23 |
| 1 | Evet | Hayır | 56,32 | 57,83 | 31,29 | 25,30 | 12,61 | 36,67 |
| 1 | Evet | Evet | 53,52 | 56,15 | 28,03 | 25,00 | 7,81 | 34,10 |
| 12 | Hayır | Hayır | 61,72 | 59,76 | 23,43 | 38,71 | 31,82 | 43,09 |
| 12 | Hayır | Evet | 63,12 | 58,77 | 25,15 | 40,47 | 31,14 | 43,73 |
| 12 | Evet | Hayır | 63,63 | 60,03 | 25,54 | 40,24 | 32,23 | 44,34 |
| 12 | Evet | Evet | 62,42 | 58,17 | 26,68 | 39,42 | 31,64 | 43,67 |
Tek-zaman girdide temporal dropout ortalama doğruluğu %17,20'den %36,67'ye çıkarmıştır. Tam 12 aylık girişte katkısı daha küçüktür: %43,09'dan %44,34'e. Bu davranış kaynak yorumuyla uyumludur; temporal dropout özellikle eksik veya sınırlı zaman gözlemlerine karşı dayanıklılık kazandırmaktadır.
Multispectral dropout ise genel olarak aynı ölçüde fayda sağlamamıştır. Kaynak bunu RGB dışı bantların bitki ve ekosistem ayrımı için değerli spektral bilgi taşımasıyla ilişkilendirmektedir.
Retrieval'da temporal dropout
Appendix A.3'te tek-zaman \(T=1\) retrieval ortalaması temporal dropout olmadan 0,219 iken temporal dropout kullanıldığında 0,369'a yükselmiştir. Çeyreklik girişte artış 0,452 → 0,457 düzeyine düşmüş, aylık girdide ise temporal dropout kullanılmayan 0,516 ortalama daha yüksek kalmıştır. Bu nedenle düzenleyicinin en büyük faydası zaman bilgisinin eksik olduğu rejimdedir.
Yer görüntülerinde dört fotoğraf gerekli mi?
Appendix A.4, dört yönlü yer görüntüsünün average pooling ile birleştirilmesini yalnız tek bir rastgele yer görüntüsü kullanımıyla karşılaştırmıştır. Genel zero-shot Top-1 doğruluğu average pooling için %41,30, single image için %41,24'tür. Fark çok küçüktür. Kaynak bunu, bazı uygulamalarda tek bir temsil edici yer görüntüsünün veri toplama ve hesaplama gereksinimini azaltabileceğine işaret eden bir sonuç olarak yorumlamaktadır.
Hesaplama verimliliği
| Model | FLOPs / GMac | Parametre (M) | Throughput (örnek/s) | Peak Memory (MB) |
|---|---|---|---|---|
| CLIP | 4,46 | 151,28 | 565,33 | 3045,13 |
| TimeSenCLIP 1×1 | 0,105 | 8,17 | 19.530,50 | 584,60 |
| TimeSenCLIP 5×5 | 0,106 | 8,29 | 19.424,24 | 596,32 |
| TimeSenCLIP 9×9 | 0,110 | 8,58 | 19.428,41 | 624,08 |
| TimeSenCLIP 16×16 | 0,121 | 9,48 | 17.798,35 | 709,12 |
Yazarların hesaplamasına göre 1×1 TimeSenCLIP, standart CLIP'e kıyasla FLOPs'ta yaklaşık %97–98, parametre sayısında yaklaşık %94 azalma sağlamakta ve throughput bakımından 33 katın üzerinde hız sunmaktadır. Bu ölçümler çalışmanın kendi donanım ve batch-size düzenine aittir; farklı GPU veya deployment ortamlarında aynı sayılar garanti edilmez.
Prediction map'ler ne gösteriyor?
Kaynak Şekil 4 ve 5, aylık Sentinel-2 zaman serisinin her piksele bağımsız uygulanmasıyla LULC ve crop prediction map'leri oluşturur. LUCAS yalnız merkez nokta için ground-truth etiketi verdiğinden bu haritalar tam piksel düzeyinde segmentation ground truth ile doğrulanmamıştır.
Haritalarda geniş alanlar semantik olarak tutarlı görünmekle birlikte komşu pikseller arasında lokal “salt-and-pepper” sınıf değişimleri bulunmaktadır. Kaynak bunun nedenini modelin her pikseli bağımsız sınıflandırması ve spatial smoothing post-processing kullanılmaması olarak açıklamaktadır.
Kaynak Şekil A.4'teki confusion matrix'ler de hataların önemli bölümünün semantik veya yapısal olarak benzer sınıflar arasında toplandığını göstermektedir. Örneğin crop sınıflarında buğday ve arpa gibi fenolojik olarak yakın tahıllar, Land Cover'da shrubland ve woodland, habitatlarda ise benzer vejetasyon yapısına sahip grassland ve tarımsal sınıflar birbirine karışabilmektedir.
Çalışmanın doğrudan desteklediği sonuçlar
- Sentinel-2'nin çok-spektrumlu zamansal değişimleri zero-shot uzaktan algılama görevlerinde güçlü bir temsil kaynağıdır.
- 12 aylık tek-piksel TimeSenCLIP-P1-MS, karşılaştırılan CLIP tabanlı modellerden genel zero-shot sınıflandırmada daha yüksek sonuç üretmiştir.
- Temporal depth özellikle ürün ve biyobölge gibi fenolojiye bağlı sınıflarda güçlü katkı sağlamıştır.
- Multispektral bantlar RGB'ye göre özellikle Land Cover ve Crops görevlerinde ek bilgi sağlamıştır.
- Uzamsal bağlamın katkısı göreve bağlıdır; Habitat, Land Cover/Use ve scenicness gibi görevlerde daha geniş patch yararlı olabilir.
- Temporal dropout özellikle eksik veya tek-zaman gözlemlerinde dayanıklılığı belirgin biçimde artırmıştır.
- Tek-piksel mimari CLIP tabanlı büyük encoder'lara göre çok daha düşük hesaplama ve bellek maliyetiyle çalışmıştır.
- Ground-to-Satellite ve Satellite-to-Ground retrieval sonuçları, zaman serisi embedding'lerinin yer görüntüsü semantiğiyle anlamlı biçimde hizalanabildiğini göstermektedir.
Çalışmanın desteklemediği genellemeler ve sınırlılıklar
- Model yalnız Sentinel-2 ve Avrupa Birliği/LUCAS bağlamında değerlendirilmiştir; diğer kıtalar, iklimler ve sensörlerde aynı performans kanıtlanmamıştır.
- Tek piksel bütün görevlerde büyük patch'in yerine geçmemektedir.
- Habitat ve scenicness gibi uzamsal yapı gerektiren problemlerde geniş bağlam önemini korumaktadır.
- Prediction map'ler tam segmentation ground truth ile değerlendirilmemiştir; LUCAS ground truth yalnız merkez örnek noktasını verir.
- CLIP'in kendi semantik uzayı internet görüntüleri ve caption'larından öğrenildiği için yalnız zaman içinde gözlenebilen bazı özellikler ground-image embedding'de bulunmayabilir.
- Farklı sensörlerin, özellikle Sentinel-1 + Sentinel-2 gibi multisensor kombinasyonların kullanımı bu çalışmada doğrulanmamıştır.
- Küresel ölçekli ground-level fotoğraf kaynaklarıyla eğitim gelecekteki araştırma yönüdür.
- Ürün ve habitat gibi çok sınıflı ve semantik olarak birbirine yakın görevlerde supervised upper bound ile zero-shot model arasında hâlâ belirgin performans farkı bulunmaktadır.
Gelecek çalışma
Yazarlar TimeSenCLIP'in başka sensörlere ve farklı iklim/fenoloji bölgelerine genişletilmesini, Sentinel-1 ve Sentinel-2 gibi çoklu sensörlerin birlikte kullanılmasını ve Avrupa dışındaki coğrafyalardan daha geniş yer görüntüsü koleksiyonlarının eğitim sürecine eklenmesini önemli gelecek yönleri olarak tanımlamaktadır.
Kaynak ayrıca CLIP yer görüntüsü temsillerinin zamanla gözlenebilen bazı çevresel özellikleri içermeyebileceğini belirtmekte ve bu boşluğun coğrafi konuma bağlı metinsel açıklamalar gibi ek semantik kaynaklarla tamamlanabileceğini önermektedir.
Kaynak ve Yöntem Notu
Özgün başlık: TimeSenCLIP: A time series vision–language model for remote sensing
Yazarlar: Pallavi Jain; Diego Marcos; Dino Ienco; Roberto Interdonato; Tristan Berchoux.
Sorumlu yazar: Pallavi Jain.
Kurumlar: Mediterranean Agronomic Institute of Montpellier – CIHEAM-IAMM; Inria; INRAE; Cirad; UMR TETIS; University of Montpellier, Fransa.
Dergi: ISPRS Journal of Photogrammetry and Remote Sensing.
Yayınevi: Elsevier B.V., International Society for Photogrammetry and Remote Sensing (ISPRS) adına.
Bibliyografik kayıt: Volume 236 (2026), 99–119.
DOI: 10.1016/j.isprsjprs.2026.03.043
Resmî bağlantı: https://doi.org/10.1016/j.isprsjprs.2026.03.043
Gönderim: 14 Ağustos 2025. Revizyon: 20 Şubat 2026. Kabul: 26 Mart 2026. Cilt tarihi: Haziran 2026.
Kaynak türü: Hakemli deneysel makine öğrenmesi / uzaktan algılama araştırma makalesi.
Lisans: Creative Commons Attribution 4.0 (CC BY 4.0).
Veri ve kod: Makale LUCAS, Sen4Map, EUNIS/EEA ve ScenicOrNot gibi mevcut veri kaynaklarını kullanmaktadır. TimeSenCLIP kodunun https://github.com/pallavijain-pj/TimeSenCLIP adresinde yayımlandığı kaynak özetinde belirtilmiştir.
Finansman/destek: Çalışma “Giving Rural Actors Novel Data and Re-Usable Tools to Lead Public Action in Rural Areas” (GRANULAR) projesi üzerinden European Union Horizon Europe Research and Innovation Programme, Grant Agreement No. 101061068 tarafından; ayrıca ANR OBTEA projesi (ANR-22-CPJ1-0054-01) ve University of Montpellier I-SITE Excellence Program / Investissements France 2030 kapsamında desteklenmiştir.
Çıkar çatışması: Yazarlar çalışmayı etkileyebilecek bilinen rekabet eden finansal çıkar veya kişisel ilişki bulunmadığını bildirmiştir.
AI destekli yazım bildirimi: Yazarlar makale hazırlanırken cümle yapılandırması ve dilbilgisi iyileştirmesi amacıyla LLM kullandıklarını, son içeriği kendilerinin gözden geçirip düzenlediğini ve sorumluluğunu üstlendiklerini belirtmiştir.
Yazar katkıları: Pallavi Jain: ilk taslak, gözden geçirme/düzenleme, görselleştirme, doğrulama, metodoloji, araştırma, biçimsel analiz, veri kürasyonu ve kavramsallaştırma. Diego Marcos: gözden geçirme/düzenleme, danışmanlık, kaynaklar, metodoloji, finansman edinimi ve kavramsallaştırma. Dino Ienco: gözden geçirme/düzenleme, danışmanlık ve kaynaklar. Roberto Interdonato: gözden geçirme/düzenleme, danışmanlık ve kaynaklar. Tristan Berchoux: gözden geçirme/düzenleme, danışmanlık, kaynaklar, proje yönetimi ve finansman edinimi.
Kaynak-içi raporlama notu 1: Ana yöntem özetinde çok yönlü ground-level image embedding'lerinin attention pooling ile birleştirildiği belirtilirken ayrıntılı mimari açıklaması ve Appendix A.4.3 average pooling kullanmaktadır. Kaynak bu iki ifadeyi ayrıca uzlaştırmamaktadır.
Kaynak-içi raporlama notu 2: Dataset açıklaması Level-1'in 38 specific crop type içerdiğini söylerken Tablo 2 “Crops — 40 classes” raporlamaktadır. Verianla iki sayıyı sessizce birleştirmemiştir.
Temel yöntemsel sınır: TimeSenCLIP'in raporlanan genelleme başarısı Sentinel-2 ve Avrupa merkezli LUCAS/Sen4Map değerlendirme ortamına aittir. Başka sensör, kıta, iklim ve fenolojik rejimlere cross-domain aktarım bu çalışmada doğrudan doğrulanmamıştır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir