

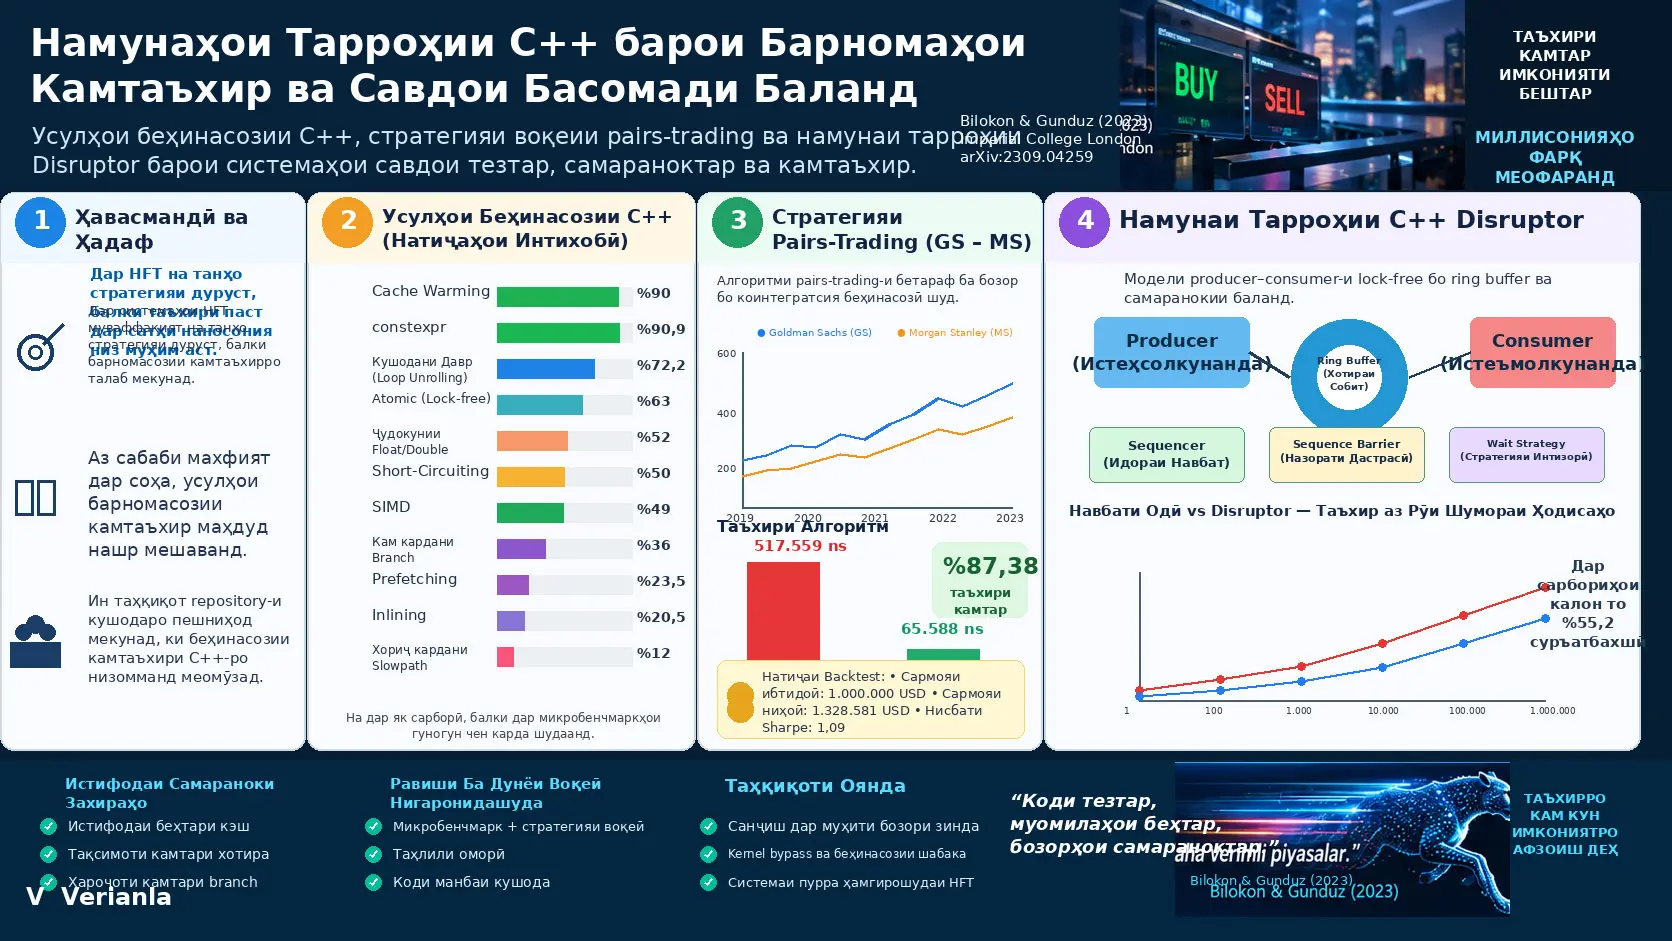
Беҳинасозии C++ барои таъхири паст равиши муҳандисии самаранокист, ки бо ҳадафи кам кардани на танҳо вақти миёнаи иҷро, балки тағйирпазирии таъхир низ хароҷоти сатҳи CPU, аз ҷумла дастрасӣ ба хотира, истифодаи кэш, ҳисобҳои вақти компилятсия, шохабандӣ, ҷойгиркунии додаҳо, иҷрои параллелӣ ва иртиботи байни thread-ҳоро ба таври низомманд танзим мекунад. Кори Paul Bilokon ва Burak Gunduz ин равишро дар се қабат меомӯзад: Low-Latency Programming Repository, ки шумораи зиёди усулҳои беҳинасозии C++-ро алоҳида benchmark мекунад; алгоритми market-neutral pairs-trading backtest, ки ин усулҳо дар он татбиқ шудаанд; ва сохтори LMAX Disruptor, ки барои иртиботи producer–consumer бо C++ амалӣ шудааст.
Дар манбаъ, дар микробенчмаркҳои ҷудошуда баландтарин афзоишҳои гузоришшудаи суръат барои cache warming ва constexpr тақрибан %90, барои loop unrolling %72,24, барои ҳисобкунаки atomic-и lock-free тақрибан %63, дар намунае, ки омехта накардани намудҳои float/double санҷида шудааст, ба ибораи муаллифони манбаъ тақрибан %52, барои short-circuiting тақрибан %50 ва барои ҷамъкунии массив бо SIMD тақрибан %49 мебошанд. Дар муқобил, inlining %20,5, prefetching %23,5, compile-time dispatch тақрибан %26, branch reduction %36, slowpath removal %12 ва муқоисаи дахлдори signed/unsigned тақрибан %12,15 беҳбудӣ нишон додаанд. Ин фоизҳо ба микробенчмаркҳои гуногун тааллуқ доранд; онҳоро дар як барнома ҷамъ карда, ҳамчун фоизи умумии суръатбахшӣ маънидод кардан мумкин нест.
Дар барномаи pairs-trading, вақте SIMD/AVX2, loop unrolling, истифодаи массиви андозаи собит ва inlining якҷоя карда шуданд, дар арзёбӣ бар асоси 10 иҷрои benchmark таъхири миёна тақрибан аз 517.559 ns то 65.588 ns коҳиш ёфт ва манбаъ инро ҳамчун %87,38 беҳбудии таъхир гузориш кардааст. Инҳирофи стандартӣ низ аз 4.233 ns то 400 ns паст шудааст. Аммо ин озмоиш рӯйи коди backtest, ки бо додаҳои таърихӣ кор мекунад, анҷом ёфтааст; ҷараёни зиндаи додаҳои бозор, network latency, пайвастшавӣ ба биржа ва рафтори воқеии Order Management System ба ин натиҷа дохил намешаванд.
Дар қабати сеюми таҳқиқот C++ Disruptor бо queue-и стандартӣ, ки mutex ва condition variable истифода мекунад, муқоиса шудааст. Бо зиёд шудани шумораи event бартарии ченшудаи Disruptor умуман бештар шудааст; манбаъ дар Ҷадвали 4 барои 10 event суръатбахшии %11,9, барои 1.000 event %48,8, барои 10.000 event %55,2 ва барои 1.000.000 event %38,7 гузориш кардааст. Дар як таҷрибаи ҷудогонаи 20-иҷроӣ бо 1.000-event барои Simple Queue таъхири миёнаи 931.255 ns ва барои Disruptor 74.908 ns дода шуда, t-статистикаи фарқ 22,596 ва p-арзиш \(1.243\times10^{-23}\) гузориш шудааст. Азбаски вақтҳои мутлақ аз силсилаи benchmark-и қаблӣ фарқ мекунанд, ин ду маҷмӯи дода набояд мисли як силсилаи ягонаи ченкунӣ якҷоя карда шаванд.
Таҳқиқот кӯшиш мекунад кадом мушкилро ҳал кунад?
Дар системаҳои савдои басомади баланд танҳо дуруст қарор қабул кардани нармафзор кофӣ нест; таъхире, ки қарор бо он қабул мешавад, ва он ки ин таъхир аз як иҷро то иҷрои дигар то чӣ андоза тағйир меёбад, низ аҳамияти муҳим дорад. Аз ин рӯ, таҳқиқот ба санҷиши беҳинасозиҳои зоҳиран хурд дар коди C++ бо ченкуниҳои воқеӣ дар сатҳи CPU тамаркуз мекунад.
Ангезаи асосии муаллифон ин аст, ки қисми муҳими муҳандисии таъхири паст дар саноати HFT бинобар рақобат ва махфият дар адабиёти кушоди академӣ ба таври муфассал мавҷуд нест. Барои коҳиш додани ин холигӣ Low-Latency Programming Repository ҳамчун бойгонии амалӣ бо коди benchmark ва ченкуниҳо тарҳрезӣ шудааст, на ҳамчун рӯйхате, ки танҳо номи усулҳоро меорад.
Чаро Cache Warming дар C++-и Камтаъхир Муҳим аст?
Cache warming ин пешакӣ дастрас кардан ва дар кэши CPU омода нигоҳ доштани додаҳо ё дастурҳои барои самаранокӣ муҳим пеш аз он аст, ки воқеан ба онҳо ниёз шавад. Азбаски “hot path” дар HFT ҳатто агар кам кор кунад ҳам, ҳангоми фаъол шудан бояд хеле зуд бошад, таҳқиқот нишон медиҳад, ки пешакӣ иҷро ё хондани дода ва коди марбут ба муҳаррики иҷро ва нигоҳ доштани онҳо дар cache метавонад таъхири дастрасӣ ба хотираро кам кунад.
Манбаъ ду сенарияи гуногуни Google Benchmark сохтааст. BM_CacheCold ба маҷмӯи бузурги додаҳо ба таври тасодуфӣ дастрасӣ карда, spatial locality-и заиф эҷод мекунад, дар ҳоле ки BM_CacheWarm пеш аз benchmark ва ҳангоми он ба додаҳо пайдарпай дастрасӣ мекунад.
| Метрика | BM_CacheCold | BM_CacheWarm |
|---|---|---|
| Вақт | 267.685.006 ns | 25.635.035 ns |
| Instruction | 4.931.929.489 | 12.013.354.366 |
| Cache reference | 146.264.562 | 61.306.992 |
| Cache miss / cache reference | %73,964 | %71,559 |
Муаллифон фарқи вақтро тақрибан ҳамчун %90 беҳбудии суръат маънидод мекунанд. Ҷолиб он аст, ки ҳарчанд нисбати cache-miss аз %73,964 танҳо то %71,559 коҳиш ёфтааст, шумораи умумии cache reference ба таври назаррас кам шудааст. Ин натиҷа нишон медиҳад, ки беҳинасозии cache-ро танҳо бо “фоизи miss” маънидод кардан мумкин нест; тартиби дастрасӣ, ҳаҷми умумии memory traffic ва миқдори кори дар ҳамон вақт анҷомёфта низ муҳиманд.
Compile-time dispatch
Runtime dispatch ба интихоб шудани функсияи иҷрошаванда ҳангоми кор кардани барнома асос меёбад, дар ҳоле ки compile-time dispatch ин қарорро дар марҳилаи компилятсия қабул мекунад. Дар benchmark-и манбаъ ду намунаи runtime-dispatch 2,60 ns ва 2,15 ns чен шудаанд, дар ҳоле ки вариантҳои compile-time дар ҳар ду ҳолат 1,92 ns буданд. Арзёбии ҷамъбастии таҳқиқот ба ин усул тақрибан %26 беҳбудии суръат нисбат медиҳад.
Constexpr
constexpr имкон медиҳад, ки ифодаҳои мувофиқ ба ҷойи runtime ҳангоми компилятсия арзёбӣ шаванд. Дар таҳқиқот версияи constexpr барои ҳисоби факториали 10 тақрибан 0,245 ns, версияи runtime recursive бошад 2,69 ns чен шуда, манбаъ тақрибан %90,88 фарқи суръат гузориш кардааст.
Муаллифон ин натиҷаро ҳамчун қоидаи умумии “constexpr ҳамеша %90 суръат мебахшад” пешниҳод намекунанд. Compiler-ҳои муосир метавонанд коди ғайри-constexpr-ро ҳам беҳина кунанд. Фарқи таҷриба дар доираи ҳамин код ва рафтори compiler ба вуҷуд омадааст.
Inlining
Inlining ҳадаф дорад, ки ба ҷойи даъвати функсия, тани функсия дар маҳалли даъват ҷойгир карда шавад. Озмоише, ки always_inline истифода кардааст, тақрибан 1,90 ns ва функсияи оддӣ тақрибан 2,39 ns давом карда, манбаъ тақрибан %20,5 беҳбудӣ гузориш кардааст. Бо вуҷуди ин, inlining-и аз ҳад зиёд метавонад андозаи executable-ро зиёд ва рафтори instruction cache-ро бадтар кунад.
Loop unrolling
Loop unrolling барои кам кардани шумораи такрори идоракунии давр дар як итератсия чанд амалро ба таври ошкор иҷро мекунад. Дар озмоиши манбаъ даври стандартӣ 4.539 ns ва даври unrolled-и чорқадамӣ 1.260 ns давом карда, %72,24 беҳбудӣ гузориш шудааст.
Ин усул ҳам беохир миқёспазир нест. Binary-и калонтар, фишори instruction cache ва сарбориҳои memory-bound метавонанд фоидаро кам кунанд.
Short-circuiting
Short-circuiting ин иҷро накардани ҳисобҳои дигарест, ки баъд аз муайян шудани натиҷаи ифодаи Boolean дигар лозим нестанд. Дар манбаъ, дар озмоишҳои гуногун аз 8 то 8.192 итератсия, версияи short-circuit тақрибан дар нисфи вақти версияи оддӣ кор кардааст; беҳбудиҳо аз %49,53 то %52,83 гузориш шудаанд.
Slowpath removal
Slowpath removal коркарди хато, логгирӣ ё коди ҳолатҳои нодирро аз hot path-и доимӣ фаъол берун мебарад. Дар benchmark-и манбаъ, ки hot path %90 ва slow path %10 кор мекунад, коди slowpath-и дарунсохт 28.074 ns ва версияе, ки ба функсияи ҷудогонаи HandleError интиқол дода шудааст, 24.755 ns давом карда, тақрибан %12 беҳбудӣ дида шудааст.
Branch reduction
Branch reduction ба ҷойи пай дар пай анҷом додани санҷишҳои зиёди хато дар як hot path, ҳолатҳои хатогиро масалан дар bit mask муттаҳид карда, шумораи branch-ҳоро кам мекунад. Дар таҷрибаи манбаъ сохтори классикӣ 7,35 ns, сохтори камшудаи branch 4,68 ns давом карда, тақрибан %36 беҳбудӣ гузориш шудааст.
Prefetching
Дар озмоиши ҷамъкунии вектори калон бо __builtin_prefetch, версияи бе prefetch 8.235.924 ns ва версияи бо prefetch 6.301.400 ns давом кардааст. Манбаъ инро тақрибан %23,5 фоидаи самаранокӣ гузориш мекунад. Фоида ба пешгӯишавандагии дастрасӣ ба дода, андозаи дода ва меъмории протсессор вобаста аст.
Муқоисаи signed ва unsigned integer
Дар озмоиши махсуси манбаъ функсия бо signed integer 0,282 ns ва версияи unsigned 0,321 ns чен шуда, барои версияи signed тақрибан %12,15 бартарии суръат ҳисоб шудааст. Сабаб ин аст, ки compiler дар намуна барои ҳифзи ҳолати unsigned overflow дастурҳои иловагии assembly тавлид кардааст.
Ин натиҷаро ба шакли “signed ҳамеша аз unsigned тезтар аст” умумӣ кардан мумкин нест. Худи манбаъ микробенчмарки мушаххас бо давр ва семантикаи муайяни overflow-ро чен мекунад.
Омехта кардани намудҳои float ва double
Коркарди арзиши float бо literal-и мисли 1.23, ки ба таври пешфарз double аст, метавонад табдилдиҳии float → double → float эҷод кунад. Дар манбаъ версияи mixed 21,6 ns, версияи танҳо float бо 1.23f 14,2 ns чен шуда, муаллифон версияи unmixed-ро тақрибан %52 тезтар номидаанд.
SIMD
Single Instruction, Multiple Data (SIMD) имкон медиҳад бо як дастури CPU дар чанд элементи дода ба таври параллелӣ амал иҷро шавад. Дар озмоиши array-addition бо SSE2 версияи классикӣ 21.447 ns ва версияи SIMD 10.929 ns давом карда, тақрибан %49 коҳиши вақти амал гузориш шудааст.
Барномасозии Lock-free
Таҳқиқот амалҳои атомиро бо синхронизатсияи бар асоси mutex муқоиса кардааст. Барои 10.000 increment версияи atomic тақрибан 65.369 ns, версияи mutex 175.904 ns давом карда, манбаъ барои равиши атомӣ тақрибан %63 беҳбудии самаранокӣ гузориш кардааст.
Барномасозии lock-free гарчанде қулф истифода намекунад, “ройгон” нест. Хароҷоти Atomics, CAS, memory ordering ва cache-coherence боқӣ мемонад; инчунин амалӣ кардани тарҳи дурусти lock-free метавонад аз коди бар асоси mutex мураккабтар бошад.
Kernel bypass
Kernel bypass дар доираи таҳқиқот benchmark нашудааст. Ин усул ба ҷойи гузаронидани бастаҳои шабака аз kernel networking stack, иртиботи мустақимтари фазои корбар бо NIC-ро ҳадаф мегирад. Манбаъ технологияҳое мисли OpenOnload, VMA ва DPDK-ро мисол меорад, аммо самаранокии онҳоро ҳамчун таҷрибаи худи таҳқиқот пешниҳод намекунад.
Чаро LMAX Disruptor аз Навбати Анъанавӣ Фарқ Мекунад?
LMAX Disruptor меъмории паёмрасонии камтаъхирест, ки интиқоли додаҳоро байни producer ва consumer бо истифода аз ring buffer-и пешакӣ ҷудошуда, рақамҳои sequence-и пайваста афзоянда ва wait strategy-и интихобшаванда идора мекунад. Фарқи асосии он аз равиши анъанавии mutex/condition-variable queue ин аст, ки бо то ҳадди имкон кам кардани хароҷоти runtime memory allocation ва lock contention, ба producer ва consumer имкон медиҳад ба додаҳои муштарак тавассути ҷойгиркунии хотираи пешгӯишаванда дастрасӣ пайдо кунанд.
Ring buffer
Ring buffer сохтори додаҳои андозаи собит ва даврашакл бозистифодашаванда аст. Азбаски хотира дар оғоз ҷудо мешавад, барои ҳар event allocation/deallocation-и нав лозим нест. Ин истифодаи хотираро пешгӯишаванда мекунад ва метавонад аз ҷиҳати cache locality низ бартарӣ диҳад.
Sequencer
Sequencer бо рақамҳои sequence назорат мекунад, ки кадом slot-ҳои ring-buffer аз ҷониби producer навишта ва аз ҷониби consumer хонда шуда метавонанд. Producer баъд аз навиштани event sequence-и дахлдорро нашр мекунад; consumer нуқтаи пешрафти худро тавассути sequence пайгирӣ мекунад.
Sequence Barrier ва Wait Strategy
Sequence Barrier ба consumer имкон медиҳад муайян кунад, ки event барои хондани бехатар омода аст ё не. Агар дода ҳанӯз мавҷуд набошад, Wait Strategy фаъол мешавад. Busy-spin метавонад latency-и пасттаринро ҳадаф гирад, аммо CPU-и зиёд масраф мекунад; sleeping CPU-и камтар истифода карда, метавонад latency-и баландтар эҷод кунад.
Wait strategy-и истифодашуда дар benchmark-ҳои таҳқиқот yield wait аст. Бо busy-spin, sleeping ё стратегияҳои дигар муқоисаи низомманд анҷом нашудааст. Аз ин рӯ, арзишҳои latency-и Disruptor барои ҳамаи конфигуратсияҳои эҳтимолӣ натиҷаи умумӣ нестанд.
Усул ва Натиҷаҳои Таҳқиқот
Қабати якуми таҷрибавӣ: Low-Latency Programming Repository
Муаллифон беҳинасозиҳоро зери сарлавҳаҳои compile-time features, optimisation techniques, data handling, concurrency ва system programming гурӯҳбандӣ кардаанд. Google Benchmark воситаи асосии вақтсанҷӣ ва Linux perf махсусан барои таҳлили cache-reference ва cache-miss истифода шудааст.
| Усул | Беҳбудии тахминии гузоришшуда дар манбаъ | Механизми асосӣ |
|---|---|---|
| Cache warming | %90 | Пешакӣ ба cache овардани дода/дастур |
| Constexpr | %90,88 | Интиқоли ҳисоб аз runtime ба compile-time |
| Loop unrolling | %72,24 | Кам кардани бори идоракунии давр |
| Atomic / lock-free ҳисобкунак | %63 | Кам кардани хароҷоти mutex ва context-switch |
| Омехта накардани Float/double | Ба ибораи манбаъ %52 | Бартараф кардани implicit conversion |
| Short-circuiting | Тақрибан %50 | Иҷро накардани ҳисобҳои нолозими Boolean |
| SIMD array addition | Тақрибан %49 | Коркарди чанд элементи дода бо як дастур |
| Branch reduction | %36 | Кам кардани шумораи branch дар hot path |
| Compile-time dispatch | Тақрибан %26 | Бартараф кардани қарори Runtime dispatch |
| Prefetching | %23,5 | Дархости дода ба cache пеш аз истифода |
| Inlining | %20,5 | Кам кардани бори даъвати функсия |
| Намунаи Signed vs unsigned | %12,15 | Дар benchmark-и махсус дастурҳои камтари assembly |
| Slowpath removal | %12 | Ҷудо кардани коди нодир аз instruction hot path |
Ин ҷадвал набояд ҳамчун рейтинги “кадом беҳинасозӣ беҳтарин аст?” маънидод шавад. Ҳар сатр амали дигар, ҳаҷми дода, рафтори compiler ва сохтори benchmark-и худро дорад. Масалан, натиҷаи 90% cache-warming аз benchmark-и калони memory-access ва натиҷаи 90,88% constexpr аз намунаи факториали 10 меояд.
Қабати дуюми таҷрибавӣ: pairs trading
Барои дидани беҳинасозиҳо дар як барномаи воқеитар, таҳқиқот backtest-и statistical-arbitrage pairs-trading-ро рӯйи додаҳои панҷсолаи ҳаррӯзаи adjusted-close-и саҳмияҳои Goldman Sachs Group Inc. (GS) ва Morgan Stanley (MS) истифода кардааст.
Cointegration дар Стратегияи Pairs Trading Чӣ Маъно Дорад?
Cointegration ҳолатест, ки ду силсилаи вақт, ки ҳар кадом алоҳида non-stationary мебошанд, дорои як комбинасияи хаттии stationary бошанд. Дар ин таҳқиқот санҷиши силсилаҳои adjusted-close-и GS ва MS бо усули дуқадамаи Engle–Granger барои ба даст овардани далели оморӣ оид ба мавҷудияти муносибати мувозинати дарозмуддат байни силсилаҳои нарх дар давраи панҷсолаи баррасишуда истифода шудааст.
Дар намоиши консептуалии манбаъ ду силсила:
ба ин шакл баррасӣ мешаванд. Агар:
комбинатсия stationary бошад, \(Y_t\) ва \(X_t\) cointegrated арзёбӣ мешаванд. Дар ин ҷо \(\gamma\) муносибати хаттии дарозмуддати байни ду силсиларо ифода мекунад.
Дар санҷиши Engle–Granger барои GS–MS манбаъ p≈0,0149 ва t≈−3,7684 гузориш мекунад. Дар сатҳи significance-и \(0,05\) гипотезаи no-cointegration null рад шудааст. Ин натиҷа барои cointegration далели оморӣ медиҳад; он исбот намекунад, ки муносибат дар оянда тағйир намеёбад ё стратегияи trading ҳатман фоидаовар мешавад.
Тавлиди сигнал бо Z-score
Алгоритм бо истифода аз rolling mean ва standard deviation-и spread, spread-и ҷориро стандартӣ мекунад:
Дар ин ҷо \(Z\) z-score, \(X\) spread-и ҷорӣ, \(\mu\) миёнаи rolling spread ва \(\sigma\) арзиши rolling spread standard deviation мебошад.
Дар стратегияи манбаъ:
- \(Z>1.0\): GS нисбатан гарон ҳисоб мешавад; сигнали GS short, MS long эҷод мешавад.
- \(Z<-1.0\): GS нисбатан арзон ҳисоб мешавад; сигнали GS long, MS short эҷод мешавад.
- \(|Z|<0.8\): бо фарзияи бозгашти spread ба миёна, мавқеи кушода баста мешавад.
- Дар минтақаҳои дигар сигнали нави савдо эҷод намешавад.
Натиҷаи молиявии Backtest
Дар backtest-и манбаъ портфел бо 1.000.000 доллари ИМА оғоз шуда, бо 1.328.581 доллари ИМА анҷом меёбад. Sharpe ratio-и гузоришшуда 1,09 аст.
\(R_p\) бозدهи портфел, \(R_f\) боздеҳи бехатар ва \(\sigma_p\) арзиши standard deviation-и excess-return-и портфел мебошад.
Ба ибораи худи таҳқиқот, арзёбии ҳамаҷонибаи муваффақияти молиявии алгоритми trading ҳадафи асосии таҳқиқот нест. Ин натиҷа ба backtest-и додаҳои таърихӣ тааллуқ дорад ва transaction cost, execution quality-и воқеӣ, order-book dynamics, slippage, network delay ва ҳамаи аномалияҳои бозори зиндаро ифода намекунад.
Беҳинасозиҳои CPU дар алгоритми Pairs-trading
Дар ҳисоби rolling spread mean ва standard-deviation алгоритм AVX2 истифода шудааст. Дар register-и 256-bit __m256d чор double ҳамзамон коркард шуда, ҷамъбасти spread ва ҷамъбасти квадратҳо ба таври параллелӣ ҳисоб шудаанд. Ин тарҳ ҳамзамон loop unrolling-ро бо қадамҳои чорэлементӣ иҷро мекунад.
Маҳдудияти муҳиме, ки манбаъ барои ин барнома зикр мекунад, зарурати ба чор карат будани window size аст. Ин аз тарҳи истифодашудаи AVX2 бармеояд.
Тағйироти дуюми муҳим истифодаи array-и андозаи собит ва rolling index ба ҷойи dynamic container мебошад. Вақте spread-и нав меояд, элементи кӯҳнатарин дар ҳамон мавқеи array иваз мешавад; ҳамин тавр ниёз ба dynamic memory allocation-и такрорӣ коҳиш меёбад.
Ба функсияҳои ҳисобкунии mean ва standard-deviation inlining низ татбиқ шудааст.
| Сохтор | Latency | Беҳбудии гузоришшуда дар манбаъ |
|---|---|---|
| Inlining | 406.709 ns | %21,41 |
| SIMD + loop unrolling | 355.618 ns | %31,28 |
| Fixed array | 266.146 ns | %48,58 |
| Combined | 65.580 ns | %87,33 |
Дар бахши баъдии evaluation-и 10-иҷроӣ манбаъ барои алгоритми беҳина нашуда миёнаи 517.559 ns ва standard deviation-и 4.233 ns; барои алгоритми беҳинашуда миёнаи 65.588 ns ва standard deviation-и 400 ns медиҳад. Бар ин асос коҳиши гузоришшудаи latency %87,38 аст.
Дар бахши пешинаи усул барои baseline арзиши 519.772 ns низ омадааст. Азбаски манбаъ фарқи хурди байни ду рақами baseline-ро ошкоро шарҳ намедиҳад, арзишҳо маҷбуран ба як рақам якҷоя карда нашудаанд.
Шумораи Instruction ва рафтори Cache-miss
| Усул | Instruction | Cache misses / cache references |
|---|---|---|
| Бе беҳинасозӣ | 6,01 миллиард | %16,001 |
| Combined | 3,27 миллиард | %33,879 |
| Fixed array | 8,27 миллиард | %19,089 |
| Inlining | 9,07 миллиард | %19,151 |
| SIMD + loop unrolling | 8,35 миллиард | %16,829 |
Ин ҷадвал натиҷаи муҳимро намоён мекунад: фоизи пасттари cache-miss ё шумораи камтари instruction худ аз худ маънои барномаи тезтарро надорад. Версияи Combined, гарчанде баландтарин фоизи cache-miss дошт, пасттарин latency-ро ба вуҷуд овард. Самаранокии CPU натиҷаи якҷояи instruction-level parallelism, memory layout, branch behavior, беҳинасозиҳои compiler ва тартиби дастрасӣ ба додаҳо мебошад.
Санҷиши оморӣ
Дар benchmark-ҳои pairs-trading ҳар сохтор 10 маротиба иҷро шуда, ба ченкуниҳои latency-и беҳинашуда/беҳинашуда paired t-test татбиқ шудааст. Манбаъ t-статистикаҳои хеле калон ва p-арзишҳои хеле хурд гузориш мекунад ва қайд менамояд, ки эҳтимоли танҳо бо вариатсияи тасодуфӣ шарҳ додани фарқи ченшудаи latency паст аст.
Бо вуҷуди ин, манбаъ ошкоро эътироф мекунад, ки истифодаи танҳо 10 нуқтаи дода маҳдудият аст ва ченкуниҳои бештар дақиқиро беҳтар хоҳанд кард.
Тафсири фоидаоварӣ бояд дар кадом ҳад бимонад?
Манбаъ пасттар будани latency-ро бо адабиёт пайваст карда, пешниҳод мекунад, ки он метавонад аз ҷиҳати молиявӣ муфид бошад, зеро имкон медиҳад ба имкониятҳои кӯтоҳмуддати бозор зудтар посух дода шавад. Илова бар ин, бо истифода аз робитаи гузоришшуда дар як таҳқиқоти дигар байни latency ва дучоршавӣ ба тағйироти манфии order-book, ҳисобе пешниҳод мешавад, ки %87,32 афзоиши суръатро бо тақрибан %78,59 exposure-и камтар мувофиқ мекунад.
Ин арзиши %78,59 натиҷае нест, ки таҳқиқот онро дар бозори зинда мустақим чен карда бошад. Ин проексияи баргирифта аз манбаъ аст, ки муносибати регрессияи таҳқиқоти дигарро бо фоидаи latency-и backtest-и ин таҳқиқот ба таври хаттӣ якҷоя мекунад. Нишон дода нашудааст, ки дар системаи воқеии HFT ҳамон коҳиши exposure рух медиҳад.
Қабати сеюми таҷрибавӣ: C++ Disruptor
Имплементацияи C++ Disruptor аз ҷузъҳои producer, ring buffer, sequencer, event processor, sequence barrier, event ва wait strategy сохта шудааст. Дар заминаи HFT event метавонад объекти order бошад; дар benchmark-и манбаъ event-и оддии string истифода шудааст.
Модели муқоиса аз ду thread иборат аст. Дар версияи Disruptor producer додаҳоро ба ring buffer нашр мекунад ва consumer дар thread-и ҷудогона мувофиқи рақамҳои sequence коркард мекунад. Дар версияи Simple Queue бошад std::queue<std::string>, std::mutex ва std::condition_variable истифода мешаванд.
| Event | Simple Queue | Disruptor | Суръатбахшии гузоришшуда дар манбаъ |
|---|---|---|---|
| 10 | 20.646 ns | 18.182 ns | %11,9 |
| 100 | 99.458 ns | 64.686 ns | %35,0 |
| 1.000 | 881.092 ns | 451.251 ns | %48,8 |
| 10.000 | 9.735.102 ns | 4.361.096 ns | %55,2 |
| 100.000 | 90.088.609 ns | 52.562.872 ns | %41,7 |
| 1.000.000 | 884.871.405 ns | 543.171.556 ns | %38,7 |
Манбаъ қайд мекунад, ки бо зиёд шудани шумораи event фарқи мутлақи вақт байни ду сохтор меафзояд. Барои 10 event фарқи миёна 2.464 ns ва барои 1.000.000 event 341.699.849 ns гузориш шудааст.
Рафтори Cache-и Disruptor
Дар сарбориҳои хурд мисли 10 ва 100 event нисбати cache-miss-и Disruptor каме баландтар аз Simple Queue будааст. Дар фосилаи 1.000–1.000.000 event бошад муносибат баръакс шуда, Disruptor нисбатҳои пасттари cache-miss нишон додааст. Ин ҳолат ишора мекунад, ки ring buffer метавонад дар ҷараёнҳои бузурги event рафтори самараноктари memory-access фароҳам оварад.
Дар озмоиши 10-event Disruptor тақрибан 586.000 instruction камтар иҷро кардааст. Манбаъ инро бо коҳиши lock contention, хотираи пешакӣ ҷудошудаи ring-buffer ва иртиботи пешгӯишавандаи producer–consumer мепайвандад.
Санҷиши Омории Самаранокии Disruptor Чӣ Нишон Медиҳад?
Дар озмоиши ҷудогонаи 20-иҷроӣ ва 1.000-event-и манбаъ барои Simple Queue latency-и миёна 931.255 ns ва standard deviation 453.766 ns; барои Disruptor latency-и миёна 74.908 ns ва standard deviation 53.600 ns чен шудааст. Азбаски натиҷаи T-test ҳамчун \(t=22.596\) ва \(p=1.243\times10^{-23}\) гузориш шудааст, дар ин маҷмӯи таҷрибаҳо фарқи ченшудаи latency-и миёнаи ду сохтор аз ҷиҳати оморӣ қавӣ аст.
Ин натиҷа вақтҳои мутлақеро дар бар мегирад, ки аз арзишҳои 1.000-event дар Ҷадвали 4 фарқ мекунанд. Манбаъ онҳоро ҳамчун арзёбиҳои benchmark-и гуногун медиҳад, аммо манбаи конфигуратсия ё ченкунии фарқро муфассал шарҳ намедиҳад. Аз ин рӯ, 451.251 ns ва 74.908 ns набояд ба як арзиши ягонаи “дуруст”-и Disruptor latency коҳиш дода шаванд.
Маҳдудиятҳои арзёбии Disruptor
Benchmark асосан ба суръати inter-thread communication тамаркуз кардааст. Memory consumption ва CPU load ба таври ҳамаҷониба муқоиса нашудаанд. Илова бар ин, танҳо yield wait strategy истифода шудааст; busy-spin, sleep ва wait strategy-ҳои дигар систематикӣ санҷида нашудаанд. Аз ин рӯ, натиҷаҳои ченшуда ҳамаи конфигуратсияҳои Disruptor-ро намояндагӣ намекунанд.
Арзёбии корбарии Low-Latency Repository
Repository аз ҷониби ҳамагӣ 17 иштирокчӣ аз чор донишгоҳ баррасӣ шудааст: Imperial College London, University College London, King's College London ва University of Oxford. Аз иштирокчиён 11 нафар дар соҳаи илми компютер ва шаш нафар дар математика, физика ё муҳандисӣ буданд.
| Категория | Миёна | Пасттарин | Баландтарин |
|---|---|---|---|
| Comprehensiveness | 8,3 | 6,5 | 9,1 |
| Clarity | 8,7 | 7,8 | 8,9 |
Ин арзёбӣ далели самаранокии нармафзор нест, балки намунаи хурди корбарон дар бораи қобили истифода будани repository барои омӯзиш аст.
Натиҷаҳое, ки таҳқиқот дастгирӣ мекунад
Манбаъ нишон медиҳад, ки дар муҳитҳои benchmark-и баррасишуда ҷойгиркунии додаҳо дар сатҳи C++, истифодаи cache, ҳисобҳои compile-time, кам кардани branch, SIMD, atomics ва стратегияҳои allocation метавонанд ба latency таъсири ченшаванда расонанд. Benchmark-и pairs-trading, ки дар он чанд беҳинасозӣ якҷоя истифода шудаанд, нисбат ба беҳинасозиҳои ҷудогона коҳиши бештари умумии latency ба вуҷуд овардааст. Имплементацияи C++ Disruptor бошад дар сарбориҳои producer–consumer-и санҷидашуда аз mutex/condition-variable queue тезтар чен шудааст.
Умумисозиҳое, ки таҳқиқот дастгирӣ намекунад
Таҳқиқот нишон намедиҳад, ки фоизҳои фоидаи benchmark дар CPU, compiler, системаи оператсионӣ ё сохтори додаҳои дигар айнан такрор мешаванд. Аз ин натиҷа гирифтан мумкин нест, ки cache warming дар ҳар сарборӣ %90, constexpr дар ҳар ҳисоб %90 ё SIMD дар ҳар алгоритм %49 суръат медиҳад. Ҳамин тавр, коҳиши latency-и backtest-ро мустақим ба фоидаоварии trading-и зинда баробар кардан мумкин нест ва benchmark-и Disruptor end-to-end latency-и як OMS-и пурраи воқеиро намесанҷад.
Пешниҳодҳои кори оянда
Манбаъ се самти асосӣ пешниҳод мекунад. Якум, васеъ кардани repository бо усулҳои нав, аз ҷумла variadic templates, kernel bypass ва networking optimisations. Дуюм, санҷидани алгоритми pairs-trading рӯйи live market-data feed. Сеюм, якҷоя кардани Disruptor бо алгоритми trading ва сохтани benchmark-и фарогиртари trading-system, ки дар он объектҳои order тавассути ring buffer интиқол дода мешаванд.
Ёддошт оид ба Манбаъ ва Усул
Унвони пурраи аслӣ: C++ design patterns for low-latency applications including high-frequency trading
Муаллифон: Paul Bilokon; Burak Gunduz.
Аффилиатсияҳо: Paul Bilokon — Departments of Computing and Mathematics, Imperial College London; Burak Gunduz — Department of Computing, Imperial College London.
Навъи манбаъ: Preprint.
Санаи навишташуда дар Manuscript: 11 сентябри 2023.
Санаи версияи аввали arXiv: 8 сентябри 2023.
arXiv: 2309.04259v1 [cs.PF].
DOI: 10.48550/arXiv.2309.04259.
Платформа: arXiv / CoRR.
Ҳолати баррасии ҳамтоён: Дар сабтҳои библиографии тасдиқшуда кор ҳамчун preprint / informal publication нишон дода мешавад; версияи маҷаллаи баррасишуда тасдиқ нашудааст.
Артефакти нармафзор: Манбаъ мегӯяд, ки Low-Latency Programming Repository, коди pairs-trading ва имплементацияи Disruptor-ро дар репозитории 0burak/imperial_hft пешниҳод кардааст.
Литсензия: Азбаски дар PDF-и боршуда литсензияи ошкори мундариҷа муайян нашудааст, ягон Creative Commons ё литсензияи монанд таъин нашудааст.
Маблағгузорӣ: Дар preprint-и боршуда изҳороти ҷудогонаи маблағгузорӣ муайян нашудааст.
Бархӯрди манфиатҳо: Дар preprint-и боршуда изҳороти ҷудогонаи бархӯрди манфиатҳо муайян нашудааст.
CRediT / саҳмҳои муаллифон: Изҳороти ҷудогонаи CRediT гузориш нашудааст.
Воситаҳои асосии усул: Ченкунии вақт бо Google Benchmark; рафтори cache бо Linux perf; микробенчмаркҳои C++-и камтаъхир; санҷиши Engle–Granger cointegration ва pairs-trading backtest бо додаҳои adjusted-close-и GS–MS; беҳинасозии AVX2/SIMD; муқоисаи C++ ring-buffer/Disruptor; paired t-test.
Маҳдудиятҳои асосӣ: Қисми муҳими benchmark-ҳо дар сатҳи CPU ва нармафзор мебошанд. Шабакаи пурраи истеҳсолии HFT, co-location, exchange order flow, hardware timestamping ва шароити live market-data якҷоя чен нашудаанд. Алгоритми pairs-trading backtest-и додаҳои таърихӣ аст. Беҳинасозии AVX2 сахтафзори дастгиркунанда ва дар имплементацияи таҳқиқот window size-и ба чор каратро талаб мекунад. Дар таҷрибаи Disruptor memory consumption ва CPU load ба таври ҳамаҷониба арзёбӣ нашуда, wait strategy-ҳои алтернативӣ муқоиса нашудаанд.
Ёддошти якпорчагии рақамҳо дар дохили манбаъ: Вақти pairs-trading baseline дар бахши усул 519.772 ns ва дар бахши баъдии evaluation 517.559,10 ns нишон дода шудааст. Илова бар ин, арзишҳои 1.000-event-и Disruptor байни Ҷадвали 4 ва санҷиши омории баъдии 20-иҷроӣ фарқ мекунанд. Verianla яке аз ин арзишҳоро хомӯшона ислоҳ ё бо дигаре иваз накардааст.
Шарҳ гузоред
Нишонии почтаи электронии шумо нашр намешавад. Майдонҳои ҳатмӣ бо * нишон дода шудаанд