

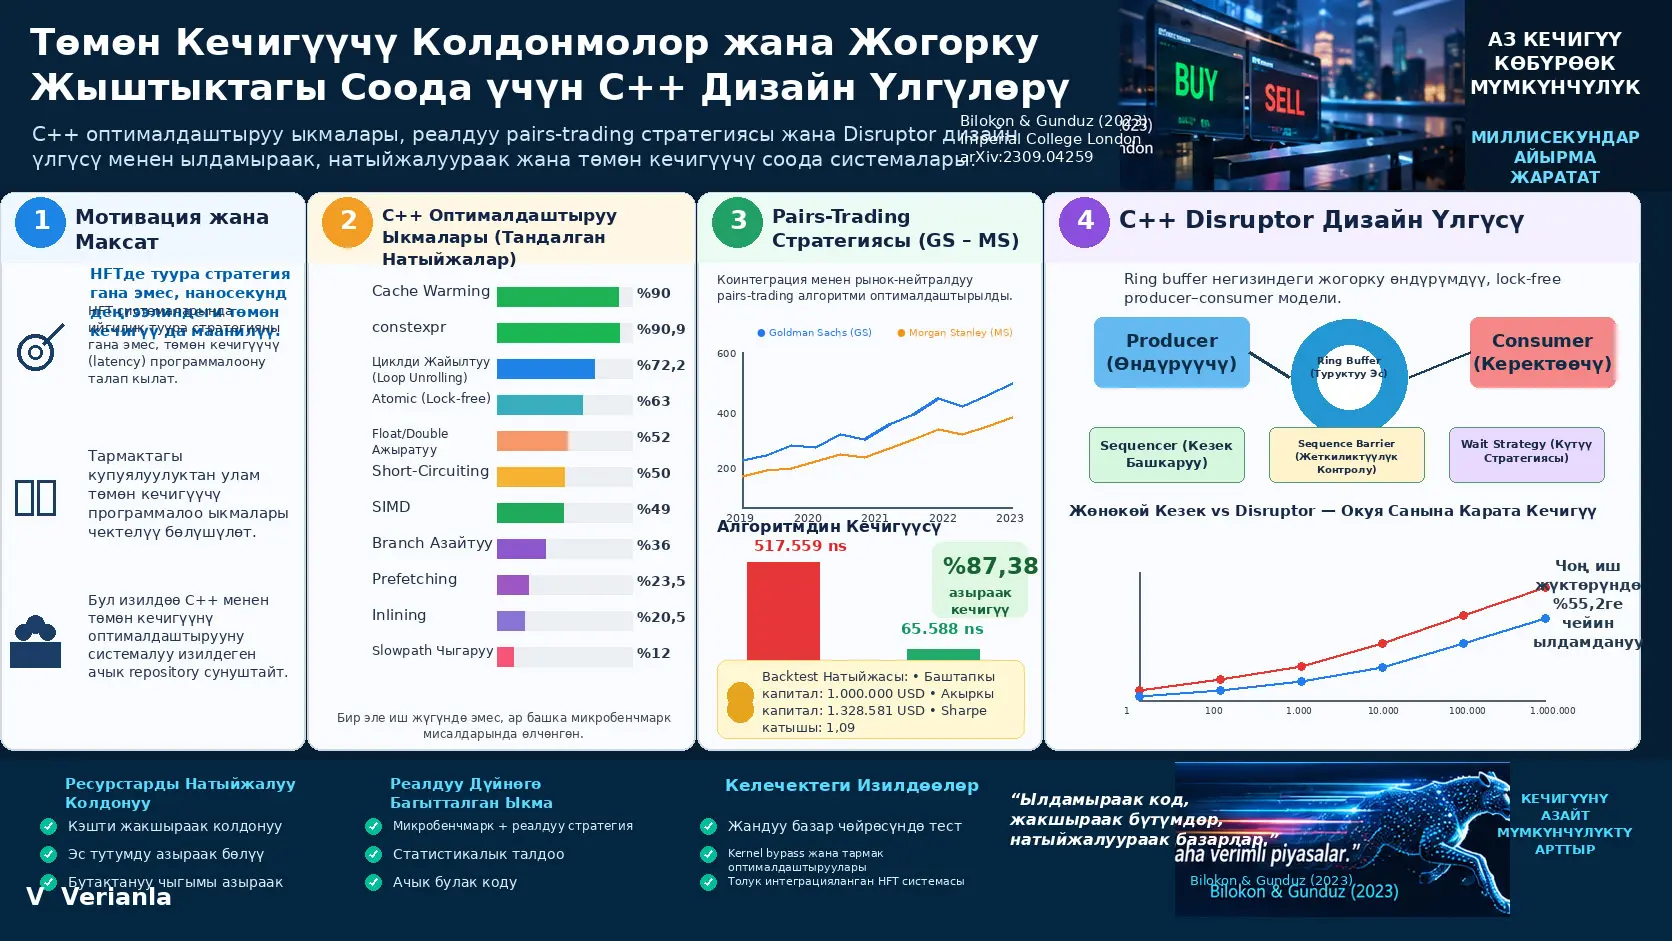
Төмөн кечигүүчү C++ оптималдаштыруу — программанын орточо иштөө убактысын гана эмес, кечигүүнүн өзгөрмөлүүлүгүн да азайтуу максатында эс тутумга жетүү, кэшти колдонуу, компиляция убагындагы эсептөөлөр, бутактануу, маалыматтарды жайгаштыруу, параллелдүү аткаруу жана thread'дер аралык байланыш сыяктуу CPU деңгээлиндеги чыгымдарды системалуу түрдө жөнгө салган өндүрүмдүүлүк инженериясынын ыкмасы. Paul Bilokon жана Burak Gunduzдун изилдөөсү бул ыкманы үч катмарда карайт: көп сандагы C++ оптималдаштыруу ыкмаларын өз-өзүнчө benchmark кылган Low-Latency Programming Repository, ошол ыкмалар колдонулган рынок-нейтралдуу pairs-trading backtest алгоритми жана producer–consumer байланышы үчүн C++ менен ишке ашырылган LMAX Disruptor түзүмү.
Булакта изоляцияланган микробенчмарктарда эң жогорку билдирилген ылдамдык өсүштөрү cache warming жана constexpr үчүн болжол менен %90, loop unrolling үчүн %72,24, atomic негизиндеги lock-free эсептегич үчүн болжол менен %63, float/double түрлөрүн аралаштырбоо сыналган мисалда булак авторлорунун сөзү менен болжол менен %52, short-circuiting үчүн болжол менен %50 жана SIMD массив кошуусу үчүн болжол менен %49 болгон. Ал эми inlining %20,5, prefetching %23,5, compile-time dispatch болжол менен %26, branch reduction %36, slowpath removal %12 жана тиешелүү signed/unsigned салыштыруусу болжол менен %12,15 жакшырууну көрсөткөн. Бул пайыздар бири-биринен айырмаланган микробенчмарктарга тиешелүү; аларды бир колдонмодо кошуп, жалпы ылдамдануу пайызы катары чечмелөөгө болбойт.
Pairs-trading колдонмосунда SIMD/AVX2, loop unrolling, туруктуу өлчөмдөгү массивди колдонуу жана inlining бириктирилгенде, 10 benchmark иштетүүсүнө негизделген баалоодо орточо кечигүү болжол менен 517.559 ns'ден 65.588 ns'ге түшүп, булак муну %87,38 кечигүүнүн жакшырышы катары билдирген. Стандарттык четтөө да 4.233 ns'ден 400 ns'ге төмөндөгөн. Бирок бул тест тарыхый маалыматтар менен иштеген backtest кодунда өткөрүлгөн; жандуу рыноктук маалымат агымы, network latency, биржа байланышы жана чыныгы Order Management System жүрүм-туруму бул натыйжага кирбейт.
Изилдөөнүн үчүнчү катмарында C++ Disruptor mutex жана condition variable колдонгон стандарттуу queue менен салыштырылган. Event саны көбөйгөн сайын Disruptor'дун өлчөнгөн артыкчылыгы жалпысынан өскөн; булак 4-таблицада 10 event үчүн %11,9, 1.000 event үчүн %48,8, 10.000 event үчүн %55,2 жана 1.000.000 event үчүн %38,7 ылдамданууну билдирген. Өзүнчө 20-иштетүүлүк 1.000-event экспериментинде Simple Queue үчүн 931.255 ns, Disruptor үчүн 74.908 ns орточо кечигүү берилген жана айырманын t-статистикасы 22,596, p-мааниси болсо \(1.243\times10^{-23}\) деп билдирилген. Абсолюттук убакыттар мурдагы benchmark сериясынан айырмалангандыктан бул эки маалымат топтому бир эле өлчөө катары бириктирилбеши керек.
Изилдөө кайсы көйгөйдү чечүүгө аракет кылат?
Жогорку жыштыктагы соода системаларында программалык камсыздоонун туура чечим кабыл алышы гана жетиштүү эмес; чечим кандай кечигүү менен кабыл алынганы жана бул кечигүүнүн иштетүүдөн иштетүүгө канчалык өзгөрөрү да маанилүү. Ошондуктан изилдөө C++ кодунда майда көрүнгөн оптималдаштырууларды CPU деңгээлинде чыныгы өлчөөлөр менен сыноого көңүл бурат.
Авторлордун негизги мотивациясы — HFT тармагындагы төмөн кечигүү инженериясынын маанилүү бөлүгү атаандаштык жана купуялуулук себептеринен улам ачык академиялык адабиятта кеңири баяндалбайт. Бул боштукту азайтуу үчүн түзүлгөн Low-Latency Programming Repository ыкмаларды жөн гана атаган тизме эмес, benchmark коду жана өлчөөлөрү бар колдонмо архив катары иштелип чыккан.
Cache Warming Төмөн Кечигүүчү C++ үчүн Эмне Үчүн Маанилүү?
Cache warming — өндүрүмдүүлүк үчүн маанилүү маалыматтарды же нускамаларды чындап керек боло электе CPU кэшине жеткирип, даяр абалда кармоо. HFT'деги “hot path” сейрек иштесе да, ишке киргенде өтө тез болушу керек болгондуктан, изилдөө аткаруу кыймылдаткычынын тиешелүү маалыматын жана кодун алдын ала иштетүү же окуу аркылуу cache ичинде кармоо эс тутумга жетүү кечигүүсүн азайтышы мүмкүн экенин көрсөтөт.
Булак эки башка Google Benchmark сценарийин түзгөн. BM_CacheCold чоң маалымат топтомуна туш келди жетип, начар spatial locality түзөт, ал эми BM_CacheWarm маалыматка алдын ала жана benchmark учурунда иреттүү түрдө жетет.
| Метрика | BM_CacheCold | BM_CacheWarm |
|---|---|---|
| Убакыт | 267.685.006 ns | 25.635.035 ns |
| Instruction | 4.931.929.489 | 12.013.354.366 |
| Cache reference | 146.264.562 | 61.306.992 |
| Cache miss / cache reference | %73,964 | %71,559 |
Авторлор убакыт айырмасын болжол менен %90 ылдамдык жакшырышы катары чечмелешет. Кызыгы, cache-miss катышы %73,964'төн болгону %71,559'га гана төмөндөгөнүнө карабай жалпы cache reference саны олуттуу азайган. Бул жыйынтык cache оптималдаштыруусун “miss пайызына” гана карап чечмелөөгө болбой турганын көрсөтөт; жетүү үлгүсү, жалпы memory traffic жана ошол эле убакытта аткарылган иштин көлөмү да маанилүү.
Compile-time dispatch
Runtime dispatch иштей турган функцияны программа иштеп жатканда тандоого негизделсе, compile-time dispatch бул чечимди компиляция баскычында чыгарат. Булак benchmarkында эки runtime-dispatch мисалы 2,60 ns жана 2,15 ns өлчөнгөн, ал эми compile-time варианттары эки учурда тең 1,92 ns болгон. Изилдөөнүн жалпы баалоосу бул ыкмага болжол менен %26 ылдамдык жакшыруусун таандык кылат.
Constexpr
constexpr ылайыктуу туюнтмаларды runtime ордуна компиляция учурунда баалоого мүмкүнчүлүк берет. Изилдөөдө факториал 10 эсебинин constexpr версиясы болжол менен 0,245 ns, runtime recursive версиясы болсо 2,69 ns өлчөнүп, булак болжол менен %90,88 ылдамдык айырмасын билдирген.
Авторлор бул жыйынтыкты жалпы “constexpr ар дайым %90 ылдамдатат” деген эреже катары көрсөтүшпөйт. Заманбап compiler'лер constexpr эмес кодду да оптималдаштыра алышат. Эксперименттеги айырма ушул конкреттүү код жана compiler жүрүм-туруму шартында чыккан.
Inlining
Inlining функция чакыруусунун ордуна функциянын денесин чакырылган жерге жайгаштырууну максат кылат. always_inline колдонулган тест болжол менен 1,90 ns, кадимки функция болжол менен 2,39 ns созулуп, булак болжол менен %20,5 жакшырууну билдирген. Бирок ашыкча inlining executable өлчөмүн чоңойтуп, instruction cache жүрүм-турумун начарлатышы мүмкүн.
Loop unrolling
Loop unrolling цикл башкаруусунун кайталануу санын азайтуу үчүн бир итерацияда бир нече операцияны ачык аткарат. Булактагы тестте стандарттык цикл 4.539 ns, төрт кадамдуу unrolled цикл 1.260 ns созулуп, %72,24 жакшыруу билдирилген.
Бул ыкма да чексиз масштабдалбайт. Чоңураак binary, instruction cache басымы жана memory-bound иш жүктөрү пайданы азайтышы мүмкүн.
Short-circuiting
Short-circuiting Boolean туюнтмасынын жыйынтыгы анык болгондо керексиз болуп калган эсептөөлөрдү аткарбоо. Булакта 8 менен 8.192 итерацияга чейинки ар түрдүү тесттерде short-circuit версиясы болжол менен кадимки версиянын жарым убактысында иштеп, жакшыруулар %49,53 менен %52,83 аралыгында билдирилген.
Slowpath removal
Slowpath removal ката иштетүү, логдоо же сейрек кездешүүчү кодду дайыма иштеген hot path'тен сыртка чыгарат. Булакта hot path %90, slow path %10 иштеген benchmarkта түздөн-түз камтылган slowpath коду 28.074 ns, өзүнчө HandleError функциясына чыгарылган версия 24.755 ns созулуп, болжол менен %12 жакшыруу байкалган.
Branch reduction
Branch reduction бир эле hot path ичинде катар-катар көп ката текшерүүнүн ордуна ката абалдарын, мисалы, bit mask ичинде бириктирип branch санын азайтууну максат кылат. Булак экспериментинде классикалык түзүм 7,35 ns, азайтылган branch түзүмү 4,68 ns созулуп, болжол менен %36 жакшыруу билдирилген.
Prefetching
__builtin_prefetch колдонулган чоң вектор кошуу тестинде prefetch колдонулбаган версия 8.235.924 ns, prefetch колдонулган версия 6.301.400 ns созулган. Булак муну болжол менен %23,5 өндүрүмдүүлүк пайдасы катары билдирет. Пайда маалыматка жетүүнүн алдын ала болжолдонушуна, маалымат көлөмүнө жана процессор архитектурасына көз каранды.
Signed жана unsigned integer салыштыруусу
Булактын атайын тестинде signed integer колдонулган функция 0,282 ns, unsigned версия 0,321 ns өлчөнүп, signed версия үчүн болжол менен %12,15 ылдамдык артыкчылыгы эсептелген. Мунун себеби мисалда compiler unsigned overflow абалын сактоо үчүн кошумча assembly нускаларын түзгөн.
Бул жыйынтыкты “signed ар дайым unsigned'дан тез” деп жалпылоого болбойт. Булактын өзү конкреттүү цикл жана overflow семантикасы бар микробенчмаркты өлчөйт.
Float жана double түрлөрүн аралаштыруу
float маанисин 1.23 сыяктуу демейки боюнча double болгон literal менен иштетүү float → double → float айланууларын жаратышы мүмкүн. Булакта mixed версия 21,6 ns, float гана колдонгон 1.23f версиясы 14,2 ns өлчөнүп, авторлор unmixed версияны болжол менен %52 ылдамыраак деп билдиришкен.
SIMD
Single Instruction, Multiple Data (SIMD) бир CPU нускасы менен бир нече маалымат элементинде параллелдүү операция аткарууга мүмкүндүк берет. SSE2 колдонулган array-addition тестинде классикалык версия 21.447 ns, SIMD версиясы 10.929 ns созулуп, операция убактысында болжол менен %49 кыскаруу билдирилген.
Lock-free программалоо
Изилдөө атомдук операцияларды mutex негизиндеги синхрондоштуруу менен салыштырган. 10.000 increment үчүн atomic версия болжол менен 65.369 ns, mutex версиясы 175.904 ns созулуп, булак атомдук ыкма үчүн болжол менен %63 өндүрүмдүүлүк жакшыруусун билдирген.
Lock-free программалоо кулпу колдонбосо да “акысыз” эмес. Atomics, CAS, memory ordering жана cache-coherence чыгымдары кала берет; андан тышкары туура lock-free дизайнды ишке ашыруу mutex негизиндеги кодго караганда татаалыраак болушу мүмкүн.
Kernel bypass
Kernel bypass изилдөөнүн алкагында benchmark кылынган эмес. Ыкма тармак пакеттерин kernel networking stack аркылуу өткөрүүнүн ордуна колдонуучу мейкиндигинин NIC менен түзүрөөк байланышышын максат кылат. Булак OpenOnload, VMA жана DPDK сыяктуу технологияларды мисал келтирет, бирок алардын өндүрүмдүүлүгүн изилдөөнүн өз экспериментиндей көрсөтпөйт.
LMAX Disruptor Эмне Үчүн Салттуу Кезектен Айырмаланат?
LMAX Disruptor producer жана consumer'лердин ортосунда алдын ала бөлүнгөн ring buffer, дайыма өсүп турган sequence номерлери жана тандалуучу wait strategy колдонуу аркылуу маалымат өткөрүүнү башкарган төмөн кечигүүчү билдирүү алмашуу архитектурасы. Салттуу mutex/condition-variable queue ыкмасынан негизги айырмасы runtime memory allocation жана lock contention чыгымдарын мүмкүн болушунча азайтып, producer менен consumer'ге жалпы маалыматка болжолдоого ыңгайлуу эс тутум жайгашуусу аркылуу жетүүгө шарт түзөт.
Ring buffer
Ring buffer туруктуу өлчөмдөгү, тегерек түрдө кайра колдонулуучу маалымат түзүмү. Эс тутум башында бөлүнгөндүктөн ар бир event үчүн жаңы allocation/deallocation жасоонун кереги жок. Бул эс тутум колдонууну көбүрөөк болжолдоого мүмкүн кылат жана cache locality жагынан артыкчылык бериши мүмкүн.
Sequencer
Sequencer кайсы ring-buffer slot'торуна producer жаза аларын жана consumer окуй аларын sequence номерлери менен көзөмөлдөйт. Producer event'ти жазгандан кийин тиешелүү sequence'ти жарыялайт; consumer өзүнүн алдыга жылуу чекитин sequence аркылуу байкайт.
Sequence Barrier жана Wait Strategy
Sequence Barrier consumer'ге event'ти коопсуз окууга болор-болбосун аныктоого мүмкүнчүлүк берет. Маалымат али жок болсо Wait Strategy ишке кирет. Busy-spin эң төмөн latency'ни көздөшү мүмкүн, бирок CPU көп сарптайт; sleeping азыраак CPU колдонуп, жогорку latency жаратышы мүмкүн.
Изилдөөнүн benchmarkтарында колдонулган wait strategy yield wait. Busy-spin, sleeping же башка стратегиялар менен системалуу салыштыруу жүргүзүлгөн эмес. Ошондуктан Disruptor latency маанилери бардык мүмкүн болгон конфигурациялар үчүн жалпы жыйынтык эмес.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Биринчи эксперименттик катмар: Low-Latency Programming Repository
Авторлор оптималдаштырууларды compile-time features, optimisation techniques, data handling, concurrency жана system programming аталыштары астында топтошкон. Google Benchmark негизги убакыт өлчөө куралы; Linux perf болсо өзгөчө cache-reference жана cache-miss анализи үчүн колдонулган.
| Ыкма | Булакта билдирилген болжолдуу жакшыруу | Негизги механизм |
|---|---|---|
| Cache warming | %90 | Маалымат/нусканы алдын ала cache'ке алып келүү |
| Constexpr | %90,88 | Эсептөөнү runtime'дан compile-time'га жылдыруу |
| Loop unrolling | %72,24 | Цикл башкаруу жүгүн азайтуу |
| Atomic / lock-free эсептегич | %63 | Mutex жана context-switch чыгымын азайтуу |
| Float/double аралаштырбоо | Булактын сөзү менен %52 | Implicit conversion'дорду алып салуу |
| Short-circuiting | Болжол менен %50 | Керексиз Boolean эсептөөлөрүн аткарбоо |
| SIMD array addition | Болжол менен %49 | Бир нуска менен бир нече маалымат элементин иштетүү |
| Branch reduction | %36 | Hot path ичиндеги branch санын азайтуу |
| Compile-time dispatch | Болжол менен %26 | Runtime dispatch чечимин алып салуу |
| Prefetching | %23,5 | Маалыматты колдонордон мурун cache'ке суроо |
| Inlining | %20,5 | Функция чакыруу жүгүн азайтуу |
| Signed vs unsigned мисалы | %12,15 | Атайын benchmarkта азыраак assembly нускасы |
| Slowpath removal | %12 | Сейрек кодду instruction hot path'тен ажыратуу |
Бул таблицаны “кайсы оптималдаштыруу эң жакшы?” деген рейтинг катары чечмелөөгө болбойт. Ар бир сап ар башка операцияга, маалымат көлөмүнө, compiler жүрүм-турумуна жана benchmark түзүмүнө ээ. Мисалы, 90% cache-warming жыйынтыгы чоң memory-access benchmarkынан, 90,88% constexpr жыйынтыгы болсо факториал 10 мисалынан алынган.
Экинчи эксперименттик катмар: pairs trading
Изилдөө оптималдаштырууларды реалдуураак колдонмодо көрүү үчүн Goldman Sachs Group Inc. (GS) жана Morgan Stanley (MS) акцияларынын беш жылдык күнүмдүк adjusted-close маалыматтарында statistical-arbitrage pairs-trading backtestин колдонгон.
Cointegration Pairs Trading Стратегиясында Эмне Дегенди Билдирет?
Cointegration — өз-өзүнчө non-stationary болгон эки убакыт катарынан белгилүү бир сызыктуу комбинация stationary болгон абал. Бул изилдөөдө GS жана MS adjusted-close катарларын Engle–Granger эки баскычтуу ыкмасы менен текшерүү, каралган беш жылдык мезгилде баа катарларынын ортосунда узак мөөнөттүү тең салмак байланышына статистикалык далил алуу үчүн колдонулган.
Булактын концептуалдык көрсөтүүсүндө эки катар:
түрүндө каралат. Эгер:
комбинациясы stationary болсо, \(Y_t\) жана \(X_t\) cointegrated катары бааланат. Бул жердеги \(\gamma\) эки катардын ортосундагы узак мөөнөттүү сызыктуу байланышты билдирет.
GS–MS үчүн Engle–Granger тестинде булак p≈0,0149 жана t≈−3,7684 билдирет. \(0,05\) significance деңгээлинде no-cointegration null гипотезасы четке кагылган. Бул жыйынтык cointegration үчүн статистикалык далил берет; байланыш келечекте өзгөрбөй турганын же trading стратегиясы кепилденген кирешелүү болорун далилдебейт.
Z-score менен сигнал түзүү
Алгоритм spread'дин rolling mean жана standard deviation маанилерин колдонуп, учурдагы spread'ди стандартташтырат:
Бул жерде \(Z\) z-score, \(X\) учурдагы spread, \(\mu\) rolling spread орточосу жана \(\sigma\) rolling spread standard deviation мааниси.
Булак стратегиясында:
- \(Z>1.0\): GS салыштырмалуу кымбат деп эсептелет; GS short, MS long сигналы түзүлөт.
- \(Z<-1.0\): GS салыштырмалуу арзан деп эсептелет; GS long, MS short сигналы түзүлөт.
- \(|Z|<0.8\): spread орточого кайтып келди деген божомол менен ачык позиция жабылат.
- Башка аймактарда жаңы соода сигналы түзүлбөйт.
Backtest каржылык жыйынтыгы
Булак backtestинде портфель 1.000.000 АКШ доллары менен башталып, 1.328.581 АКШ доллары менен аяктайт. Билдирилген Sharpe ratio 1,09.
\(R_p\) портфель кирешеси, \(R_f\) тобокелсиз киреше жана \(\sigma_p\) портфель excess-return standard deviation мааниси.
Изилдөөнүн өз сөзү боюнча trading алгоритминин каржылык ийгилигин толук баалоо изилдөөнүн негизги максаты эмес. Бул жыйынтык тарыхый маалымат backtestине тиешелүү жана transaction cost, чыныгы execution quality, order-book dynamics, slippage, network delay жана жандуу рынок аномалияларынын баарын камтыбайт.
Pairs-trading алгоритминдеги CPU оптималдаштыруулары
Алгоритмдин rolling spread mean жана standard-deviation эсебинде AVX2 колдонулган. 256-bit __m256d register ичинде төрт double бир убакта иштетилип, spread суммасы жана квадраттар суммасы параллелдүү эсептелген. Бул түзүлүш ошол эле учурда төрт элементтик кадамдар менен loop unrolling аткарат.
Булактын бул колдонмо үчүн белгилеген маанилүү чектөөсү — window size төрттүн эселиги болушу керек. Бул колдонулган AVX2 дизайнынан келип чыгат.
Экинчи маанилүү өзгөртүү — dynamic container ордуна туруктуу өлчөмдөгү array жана rolling index колдонуу. Жаңы spread келгенде эң эски элемент ошол эле array ичиндеги орунда алмаштырылат; ошентип кайталанган dynamic memory allocation муктаждыгы азайтылат.
Mean жана standard-deviation эсептөө функцияларына inlining да колдонулган.
| Түзүм | Latency | Булакта билдирилген жакшыруу |
|---|---|---|
| Inlining | 406.709 ns | %21,41 |
| SIMD + loop unrolling | 355.618 ns | %31,28 |
| Fixed array | 266.146 ns | %48,58 |
| Combined | 65.580 ns | %87,33 |
Кийинки 10-иштетүүлүк evaluation бөлүмүндө булак оптималдаштырылбаган алгоритм үчүн орточо 517.559 ns жана standard deviation 4.233 ns; оптималдаштырылган алгоритм үчүн орточо 65.588 ns жана standard deviation 400 ns берет. Буга ылайык билдирилген latency азайышы %87,38.
Мурунку ыкма бөлүмүндө baseline үчүн 519.772 ns деген сан да бар. Булак эки baseline санынын ортосундагы чакан айырманы ачык түшүндүрбөгөндүктөн, маанилер бир санга зордоп бириктирилген эмес.
Instruction саны жана cache-miss жүрүм-туруму
| Ыкма | Instruction | Cache misses / cache references |
|---|---|---|
| Оптималдаштыруусуз | 6,01 миллиард | %16,001 |
| Combined | 3,27 миллиард | %33,879 |
| Fixed array | 8,27 миллиард | %19,089 |
| Inlining | 9,07 миллиард | %19,151 |
| SIMD + loop unrolling | 8,35 миллиард | %16,829 |
Бул таблица маанилүү жыйынтыкты көрсөтөт: төмөн cache-miss пайызы же азыраак instruction саны өзүнчө эле тезирээк программа дегенди билдирбейт. Combined версия эң жогорку cache-miss пайызына ээ болсо да, эң төмөн latency'ни берген. CPU өндүрүмдүүлүгү instruction-level parallelism, memory layout, branch behavior, compiler оптималдаштыруулары жана маалыматка жетүү үлгүсүнүн биргелешкен натыйжасы.
Статистикалык тест
Pairs-trading benchmarkтарында ар бир түзүм 10 жолу иштетилип, оптималдаштырылган/оптималдаштырылбаган latency өлчөөлөрүнө paired t-test колдонулган. Булак абдан чоң t-статистикаларды жана өтө кичине p-маанилерди билдирип, өлчөнгөн latency айырмасын жөн гана кокус вариация менен түшүндүрүү ыктымалдыгы төмөн экенин белгилейт.
Ошол эле учурда булак 10 гана маалымат чекити колдонулушун чектөө катары ачык кабыл алып, көбүрөөк өлчөө тактыкты жогорулатарын билдирет.
Кирешелүүлүк чечмеси кайсы чекте калышы керек?
Булак төмөн latency кыска мөөнөттүү рынок мүмкүнчүлүктөрүнө эртерээк жооп берүү потенциалы аркылуу каржылык жактан пайдалуу болушу мүмкүн экенин адабият менен байланыштырат. Ошондой эле башка изилдөөдө билдирилген latency менен терс order-book өзгөрүүсүнө дуушар болуу байланышына таянып, %87,32 ылдамдык өсүшүн болжол менен %78,59 төмөн exposure менен байланыштырган эсептөөнү берет.
Бул %78,59 мааниси изилдөөнүн жандуу рынокто түз өлчөгөн жыйынтыгы эмес. Бул башка изилдөөдөгү регрессия байланышы менен ушул изилдөөнүн backtest latency пайдасын сызыктуу бириктирген булактык проекция. Чыныгы HFT системасында ошол эле exposure азайышы болору көрсөтүлгөн эмес.
Үчүнчү эксперименттик катмар: C++ Disruptor
C++ Disruptor имплементациясы producer, ring buffer, sequencer, event processor, sequence barrier, event жана wait strategy компоненттеринен түзүлгөн. HFT контекстинде event order объекти болушу мүмкүн; булак benchmarkында жөнөкөй string event колдонулган.
Салыштыруу модели эки thread'ден турат. Disruptor версиясында producer маалыматты ring buffer'га жарыялайт жана consumer өзүнчө thread'де sequence номерлерине жараша иштетет. Simple Queue версиясында болсо std::queue<std::string>, std::mutex жана std::condition_variable колдонулат.
| Event | Simple Queue | Disruptor | Булакта билдирилген ылдамдануу |
|---|---|---|---|
| 10 | 20.646 ns | 18.182 ns | %11,9 |
| 100 | 99.458 ns | 64.686 ns | %35,0 |
| 1.000 | 881.092 ns | 451.251 ns | %48,8 |
| 10.000 | 9.735.102 ns | 4.361.096 ns | %55,2 |
| 100.000 | 90.088.609 ns | 52.562.872 ns | %41,7 |
| 1.000.000 | 884.871.405 ns | 543.171.556 ns | %38,7 |
Булак event саны өскөн сайын эки түзүмдүн ортосундагы абсолюттук убакыт айырмасы чоңоёрын белгилейт. 10 event'те орточо айырма 2.464 ns, 1.000.000 event'те 341.699.849 ns деп билдирилген.
Disruptor'дун cache жүрүм-туруму
10 жана 100 event сыяктуу кичине иш жүктөрүндө Disruptor'дун cache-miss катышы Simple Queue'дан бир аз жогору болгон. 1.000–1.000.000 event аралыгында болсо байланыш тескерисине өзгөрүп, Disruptor төмөн cache-miss катыштарын көрсөткөн. Бул ring buffer чоң event агымдарында натыйжалуураак memory-access жүрүм-турумун камсыз кыла аларын көрсөтөт.
10-event тестинде Disruptor болжол менен 586.000 азыраак instruction иштеткен. Булак муну lock contention азайышы, алдын ала бөлүнгөн ring-buffer эс тутуму жана көбүрөөк болжолдоого ыңгайлуу producer–consumer байланышы менен түшүндүрөт.
Disruptor'дун Статистикалык Өндүрүмдүүлүк Тести Эмнени Көрсөтөт?
Булактын өзүнчө 20-иштетүүлүк жана 1.000-event тестинде Simple Queue үчүн орточо latency 931.255 ns, standard deviation 453.766 ns; Disruptor үчүн орточо latency 74.908 ns жана standard deviation 53.600 ns өлчөнгөн. T-test жыйынтыгы \(t=22.596\) жана \(p=1.243\times10^{-23}\) деп билдирилгендиктен, бул эксперимент топтомунда эки түзүмдүн өлчөнгөн орточо latency айырмасы статистикалык жактан күчтүү.
Бул жыйынтык 4-таблицадагы 1.000-event маанилеринен айырмаланган абсолюттук убакыттарды камтыйт. Булак аларды ар башка benchmark баалоолору катары берет, бирок айырманын конфигурация же өлчөө булагын кеңири түшүндүрбөйт. Ошондуктан 451.251 ns менен 74.908 ns бир гана “туура” Disruptor latency маанисине түшүрүлбөшү керек.
Disruptor баалоосунун чектөөлөрү
Benchmark негизинен inter-thread communication ылдамдыгына көңүл бурган. Memory consumption жана CPU load кеңири салыштырылган эмес. Ошондой эле yield wait strategy гана колдонулган; busy-spin, sleep жана башка wait strategy'лер системалуу түрдө текшерилген эмес. Ошондуктан өлчөнгөн жыйынтыктар Disruptor'дун бардык конфигурацияларын билдирбейт.
Low-Latency Repository колдонуучу баалоосу
Repository төрт университеттен жалпы 17 катышуучу тарабынан каралган: Imperial College London, University College London, King's College London жана University of Oxford. Катышуучулардын 11 катышуучусу компьютер илимдери; алтоо математика, физика же инженерия тармактарынан.
| Категория | Орточо | Эң төмөн | Эң жогору |
|---|---|---|---|
| Comprehensiveness | 8,3 | 6,5 | 9,1 |
| Clarity | 8,7 | 7,8 | 8,9 |
Бул баалоо программалык өндүрүмдүүлүктүн далили эмес, repository'нин билим берүү жагынан колдонууга ыңгайлуулугу боюнча чакан колдонуучу үлгүсү.
Изилдөө колдогон жыйынтыктар
Булак каралган benchmark шарттарында C++ деңгээлиндеги маалымат жайгашуусу, cache колдонуу, compile-time эсептөө, branch азайтуу, SIMD, atomics жана allocation стратегиялары latency'ге өлчөнүүчү таасир бере аларын көрсөтөт. Бир нече оптималдаштыруу бирге колдонулган pairs-trading benchmarkы өзүнчө оптималдаштырууларга караганда чоңураак жалпы latency азайышын берген. C++ Disruptor имплементациясы болсо сыналган producer–consumer иш жүктөрүндө mutex/condition-variable queue'дан тезирээк өлчөнгөн.
Изилдөө колдобогон жалпылоолор
Изилдөө benchmarkтагы пайыздык пайдалар башка CPU, compiler, операциялык система же маалымат түзүмүндө так эле кайталанарын көрсөтпөйт. Cache warming ар бир иш жүктө %90, constexpr ар бир эсептөөгө %90 же SIMD ар бир алгоритмге %49 ылдамдык берет деген жыйынтык чыгарууга болбойт. Ошол сыяктуу backtest latency азайышын жандуу trading кирешелүүлүгүнө түз теңөөгө болбойт жана Disruptor benchmarkы толук чыныгы OMSтин end-to-end latency'син өлчөбөйт.
Келечектеги иш сунуштары
Булак үч негизги багытты сунуштайт. Биринчиси repository'ни variadic templates, kernel bypass жана networking оптималдаштыруулары сыяктуу жаңы ыкмалар менен кеңейтүү. Экинчиси pairs-trading алгоритмин жандуу market-data feed үстүндө сынап көрүү. Үчүнчүсү болсо Disruptor менен trading алгоритмин бириктирип, order объекттери ring buffer аркылуу өткөрүлө турган кеңири trading-system benchmarkын түзүү.
Булак жана Ыкма Жөнүндө Эскертүү
Толук оригинал аталышы: C++ design patterns for low-latency applications including high-frequency trading
Авторлор: Paul Bilokon; Burak Gunduz.
Аффилиациялар: Paul Bilokon — Departments of Computing and Mathematics, Imperial College London; Burak Gunduz — Department of Computing, Imperial College London.
Булак түрү: Preprint.
Manuscript'те көрсөтүлгөн дата: 11 сентябрь 2023.
arXiv биринчи версия датасы: 8 сентябрь 2023.
arXiv: 2309.04259v1 [cs.PF].
DOI: 10.48550/arXiv.2309.04259.
Платформа: arXiv / CoRR.
Рецензия статусу: Текшерилген библиографиялык жазууларда иш preprint / informal publication катары көрүнөт; рецензияланган журнал версиясы тастыкталган эмес.
Программалык артефакт: Булак Low-Latency Programming Repository, pairs-trading коду жана Disruptor имплементациясын 0burak/imperial_hft репозиторийинде сунуштаганын билдирет.
Лицензия: Жүктөлгөн PDF ичинде ачык контент лицензиясы табылбагандыктан белгилүү Creative Commons же окшош лицензия дайындалган эмес.
Каржылоо: Жүктөлгөн preprintте өзүнчө каржылоо билдирүүсү табылган эмес.
Кызыкчылыктардын кагылышы: Жүктөлгөн preprintте өзүнчө кызыкчылыктардын кагылышы билдирүүсү табылган эмес.
CRediT / автордук салымдар: Өзүнчө CRediT билдирүүсү кабарланган эмес.
Негизги ыкма куралдары: Google Benchmark менен убакыт өлчөө; Linux perf менен cache жүрүм-туруму; C++ төмөн кечигүү микробенчмарктары; GS–MS adjusted-close маалыматтары менен Engle–Granger cointegration тести жана pairs-trading backtestи; AVX2/SIMD оптималдаштыруу; C++ ring-buffer/Disruptor салыштыруусу; paired t-test.
Негизги чектөөлөр: Benchmarkтардын маанилүү бөлүгү CPU жана программалык камсыздоо деңгээлинде. Толук өндүрүштүк HFT тармагы, co-location, exchange order flow, hardware timestamping жана жандуу market-data шарттары бирге өлчөнгөн эмес. Pairs-trading алгоритми тарыхый маалымат backtestи. AVX2 оптималдаштыруусу аны колдогон hardware'ди жана изилдөө имплементациясында төрттүн эселиги болгон window size'ды талап кылат. Disruptor экспериментинде memory consumption жана CPU load кеңири бааланган эмес; альтернативдүү wait strategy'лер салыштырылган эмес.
Булак ичиндеги сан бүтүндүгү боюнча эскертүү: Pairs-trading baseline убактысы ыкма бөлүмүндө 519.772 ns, кийинки evaluation бөлүмүндө 517.559,10 ns деп көрсөтүлөт. Ошондой эле 1.000-event Disruptor маанилери 4-таблица менен кийинки 20-иштетүүлүк статистикалык тесттин ортосунда айырмаланат. Verianla бул маанилердин бирин унчукпай оңдогон же экинчисинин ордуна койгон эмес.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген