

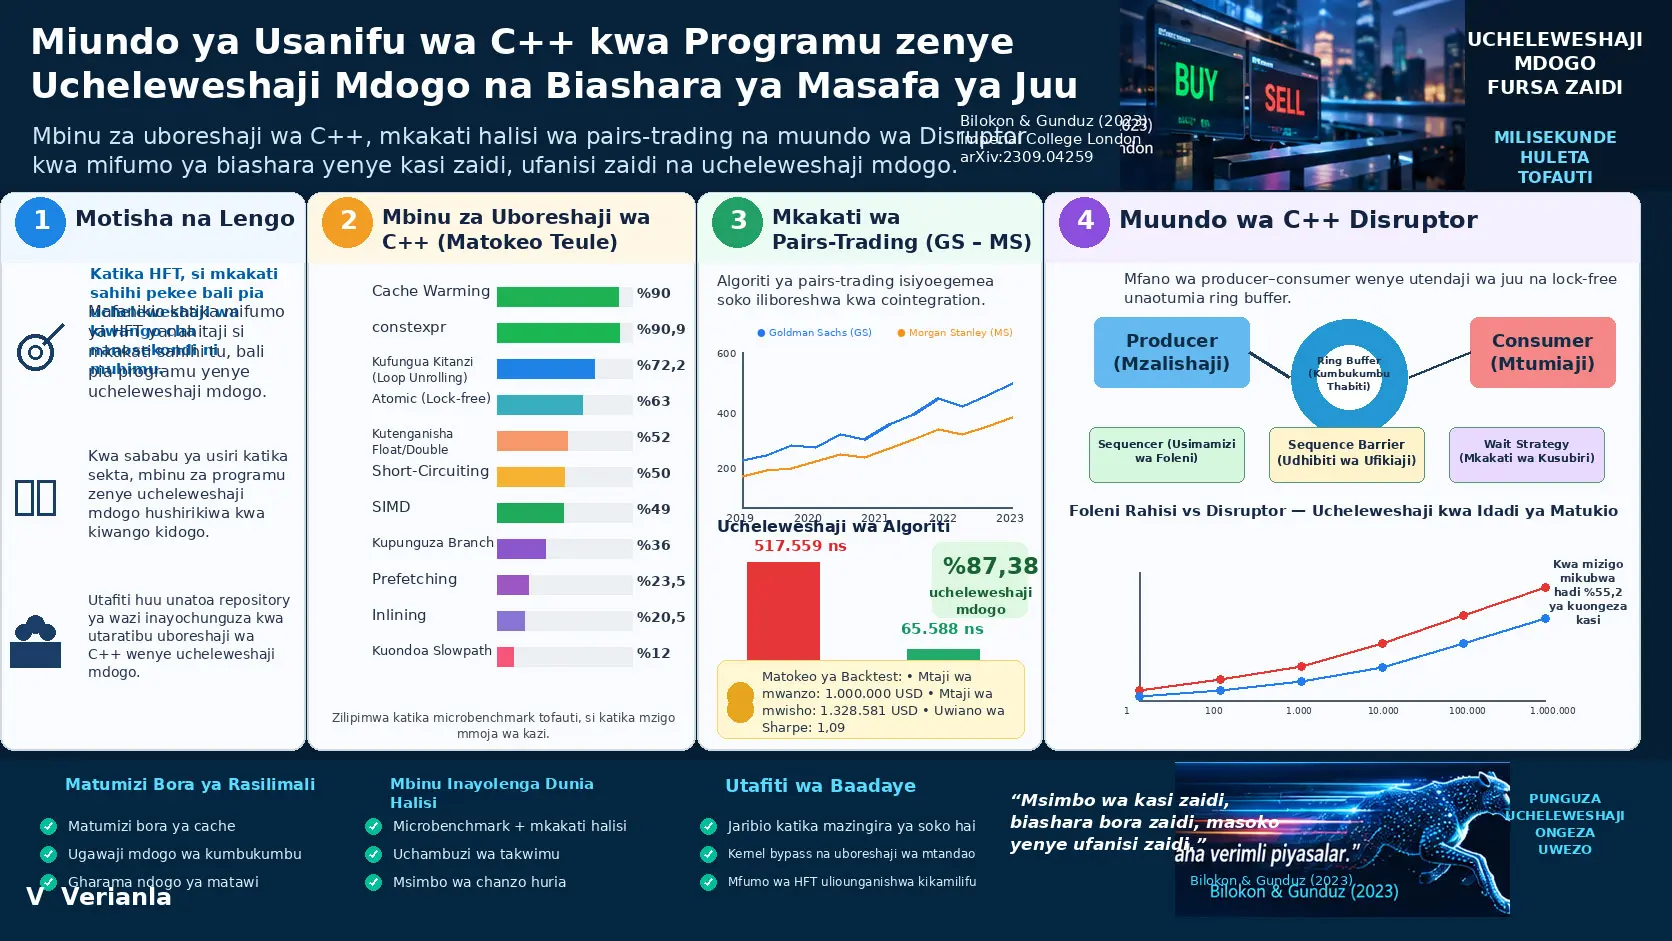
Uboreshaji wa C++ wenye ucheleweshaji mdogo ni mbinu ya uhandisi wa utendaji inayopanga kwa utaratibu gharama za kiwango cha CPU, kama vile ufikiaji wa kumbukumbu, matumizi ya cache, hesabu za wakati wa ukompaili, matawi, mpangilio wa data, utekelezaji sambamba na mawasiliano kati ya thread, kwa lengo la kupunguza si muda wa wastani wa utekelezaji pekee bali pia utofauti wa ucheleweshaji. Utafiti wa Paul Bilokon na Burak Gunduz unachunguza mbinu hii katika tabaka tatu: Low-Latency Programming Repository inayofanyia benchmark mbinu nyingi za uboreshaji wa C++ moja moja, algoriti ya backtest ya pairs-trading isiyoegemea upande wa soko ambamo mbinu hizi zimetumika, na muundo wa LMAX Disruptor uliotekelezwa kwa C++ kwa mawasiliano ya producer–consumer.
Katika chanzo, ongezeko kubwa zaidi la kasi lililoripotiwa kwenye microbenchmark zilizotengwa lilikuwa takriban %90 kwa cache warming na constexpr, %72,24 kwa loop unrolling, takriban %63 kwa kihesabu cha atomic lock-free, kwa maneno ya waandishi wa chanzo takriban %52 katika mfano uliopima kutochanganya aina za float/double, takriban %50 kwa short-circuiting na takriban %49 kwa uongezaji wa safu kwa SIMD. Kwa upande mwingine, inlining ilionyesha %20,5, prefetching %23,5, compile-time dispatch takriban %26, branch reduction %36, slowpath removal %12 na ulinganisho husika wa signed/unsigned takriban %12,15 ya uboreshaji. Asilimia hizi zinatokana na microbenchmark tofauti; haziwezi kujumlishwa katika programu moja na kutafsiriwa kama asilimia ya jumla ya kuongeza kasi.
Katika programu ya pairs-trading, wakati SIMD/AVX2, loop unrolling, matumizi ya safu yenye ukubwa usiobadilika na inlining vilipounganishwa, tathmini iliyotokana na mizunguko 10 ya benchmark ilionyesha ucheleweshaji wa wastani ukishuka kutoka takriban 517.559 ns hadi 65.588 ns, na chanzo kiliripoti hili kama uboreshaji wa ucheleweshaji wa %87,38. Mkengeuko sanifu pia ulipungua kutoka 4.233 ns hadi 400 ns. Hata hivyo, jaribio hili lilifanywa kwenye msimbo wa backtest unaotumia data za kihistoria; mtiririko hai wa data ya soko, network latency, muunganisho wa soko na tabia ya Order Management System halisi hazijajumuishwa katika matokeo haya.
Katika tabaka la tatu la utafiti, C++ Disruptor ililinganishwa na queue ya kawaida inayotumia mutex na condition variable. Kadiri idadi ya event ilivyoongezeka, faida iliyopimwa ya Disruptor kwa ujumla iliongezeka; chanzo kiliripoti katika Jedwali 4 kuongeza kasi kwa %11,9 kwa event 10, %48,8 kwa event 1.000, %55,2 kwa event 10.000 na %38,7 kwa event 1.000.000. Katika jaribio tofauti la mizunguko 20 la event 1.000, ucheleweshaji wa wastani ulitolewa kama 931.255 ns kwa Simple Queue na 74.908 ns kwa Disruptor, huku t-statistic ya tofauti ikiwa 22,596 na p-value ikiwa \(1.243\times10^{-23}\). Kwa kuwa nyakati kamili zinatofautiana na mfululizo uliopita wa benchmark, seti hizi mbili za data hazipaswi kuunganishwa kana kwamba ni mfululizo mmoja wa kipimo.
Utafiti unajaribu kutatua tatizo gani?
Katika mifumo ya biashara ya masafa ya juu, haitoshi kwa programu kufanya uamuzi sahihi pekee; ucheleweshaji ambao uamuzi huo unafanywa nao na kiasi ambacho ucheleweshaji huo hubadilika kutoka mzunguko mmoja hadi mwingine pia ni muhimu. Kwa hiyo, utafiti unalenga kupima kwa vipimo halisi katika kiwango cha CPU uboreshaji unaoonekana kuwa mdogo katika msimbo wa C++.
Msukumo mkuu wa waandishi ni kwamba sehemu muhimu ya uhandisi wa ucheleweshaji mdogo katika sekta ya HFT haipatikani kwa undani katika fasihi ya wazi ya kitaaluma kwa sababu ya ushindani na usiri. Ili kupunguza pengo hili, Low-Latency Programming Repository iliundwa si kama orodha inayotaja tu mbinu, bali kama hifadhi ya vitendo yenye msimbo wa benchmark na vipimo.
Kwa Nini Cache Warming ni Muhimu katika C++ yenye Ucheleweshaji Mdogo?
Cache warming ni kuweka data au maagizo muhimu kwa utendaji tayari katika cache ya CPU kwa kuyafikia kabla hayajahitajika kikweli. Kwa kuwa “hot path” katika HFT, hata ikiwa haitumiki mara nyingi, inapaswa kuwa ya haraka sana inapochochewa, utafiti unaonyesha kuwa kuendesha au kusoma mapema data na msimbo husika wa injini ya utekelezaji na kuuweka ndani ya cache kunaweza kupunguza ucheleweshaji wa ufikiaji wa kumbukumbu.
Chanzo kiliunda hali mbili tofauti za Google Benchmark. BM_CacheCold hufikia seti kubwa ya data kwa nasibu na kuunda spatial locality dhaifu, ilhali BM_CacheWarm hufikia data kwa mpangilio kabla na wakati wa benchmark.
| Kipimo | BM_CacheCold | BM_CacheWarm |
|---|---|---|
| Muda | 267.685.006 ns | 25.635.035 ns |
| Instruction | 4.931.929.489 | 12.013.354.366 |
| Cache reference | 146.264.562 | 61.306.992 |
| Cache miss / cache reference | %73,964 | %71,559 |
Waandishi wanatafsiri tofauti ya muda kama takriban %90 ya uboreshaji wa kasi. Jambo la kuvutia ni kwamba, ingawa kiwango cha cache-miss kilipungua kutoka %73,964 hadi %71,559 pekee, jumla ya cache reference ilipungua kwa kiasi kikubwa. Matokeo haya yanaonyesha kuwa uboreshaji wa cache hauwezi kutafsiriwa kwa kuangalia “asilimia ya miss” pekee; mpangilio wa ufikiaji, jumla ya memory traffic na kiasi cha kazi kinachofanywa ndani ya muda uleule pia ni muhimu.
Compile-time dispatch
Runtime dispatch hutegemea kuchagua kazi itakayotekelezwa wakati programu inaendelea, ilhali compile-time dispatch hufanya uamuzi huo katika hatua ya ukompaili. Katika benchmark ya chanzo, mifano miwili ya runtime-dispatch ilipimwa kwa 2,60 ns na 2,15 ns, huku matoleo ya compile-time yakikuwa 1,92 ns katika hali zote mbili. Tathmini ya jumla ya utafiti inahusisha mbinu hii na takriban %26 ya uboreshaji wa kasi.
Constexpr
constexpr huruhusu misemo inayofaa kutathminiwa wakati wa ukompaili badala ya runtime. Katika utafiti, toleo la constexpr la hesabu ya factorial 10 lilipimwa kwa takriban 0,245 ns, huku toleo la runtime recursive likiwa 2,69 ns, na chanzo kikiripoti tofauti ya kasi ya takriban %90,88.
Waandishi hawawasilishi matokeo haya kama kanuni ya jumla kwamba “constexpr daima huharakisha kwa %90.” Compiler za kisasa zinaweza pia kuboresha msimbo usio wa constexpr. Tofauti katika jaribio hili ilitokea chini ya msimbo huu mahususi na tabia ya compiler.
Inlining
Inlining hulenga kuweka mwili wa kazi mahali pa wito badala ya kufanya wito wa kazi. Jaribio lililotumia always_inline lilichukua takriban 1,90 ns, kazi ya kawaida takriban 2,39 ns, na chanzo kiliripoti takriban %20,5 ya uboreshaji. Hata hivyo, inlining kupita kiasi inaweza kuongeza ukubwa wa executable na kuzorotesha tabia ya instruction cache.
Loop unrolling
Loop unrolling hufanya shughuli kadhaa wazi katika iteresheni moja ili kupunguza idadi ya marudio ya udhibiti wa kitanzi. Katika jaribio la chanzo, kitanzi cha kawaida kilichukua 4.539 ns na kitanzi cha unrolled cha hatua nne 1.260 ns, huku uboreshaji wa %72,24 ukiripotiwa.
Mbinu hii pia haina uwezo wa kupanuka bila kikomo. Binary kubwa zaidi, shinikizo la instruction cache na mizigo ya kazi ya memory-bound inaweza kupunguza faida.
Short-circuiting
Short-circuiting ni kutofanya hesabu zisizohitajika mara tu matokeo ya usemi wa Boolean yanapokuwa yameamuliwa. Katika chanzo, kwenye majaribio tofauti kati ya iteresheni 8 na 8.192, toleo la short-circuit lilifanya kazi kwa takriban nusu ya muda wa toleo la kawaida; maboresho yaliripotiwa kati ya %49,53 na %52,83.
Slowpath removal
Slowpath removal huhamisha uchakataji wa hitilafu, logging au msimbo wa hali nadra nje ya hot path inayoendelea kufanya kazi. Katika benchmark ya chanzo ambapo hot path ilifanya kazi %90 na slow path %10, msimbo wa slowpath uliopachikwa moja kwa moja ulichukua 28.074 ns, toleo lililohamishwa kwenye kazi tofauti ya HandleError likachukua 24.755 ns, na uboreshaji wa takriban %12 ukaonekana.
Branch reduction
Branch reduction hulenga kupunguza idadi ya branch kwa kuunganisha hali za hitilafu, kwa mfano ndani ya bit mask, badala ya kufanya ukaguzi mwingi mfululizo katika hot path ileile. Katika jaribio la chanzo, muundo wa kawaida ulichukua 7,35 ns, muundo uliopunguza branch 4,68 ns, na uboreshaji wa takriban %36 ukaripotiwa.
Prefetching
Katika jaribio kubwa la uongezaji wa vekta lililotumia __builtin_prefetch, toleo lisilotumia prefetch lilichukua 8.235.924 ns na toleo linalotumia prefetch 6.301.400 ns. Chanzo kinaripoti hili kama faida ya utendaji ya takriban %23,5. Faida hutegemea uwezo wa kutabiri ufikiaji wa data, ukubwa wa data na usanifu wa prosesa.
Ulinganisho wa signed na unsigned integer
Katika jaribio maalum la chanzo, kazi inayotumia signed integer ilipimwa kwa 0,282 ns na toleo la unsigned kwa 0,321 ns, na faida ya kasi ya takriban %12,15 ikakokotolewa kwa toleo la signed. Sababu ni kwamba katika mfano huo compiler ilitoa maagizo ya ziada ya assembly ili kuhifadhi hali ya unsigned overflow.
Matokeo haya hayawezi kujumlishwa kuwa “signed daima ni haraka kuliko unsigned.” Chanzo chenyewe kinapima microbenchmark yenye kitanzi maalum na semantiki maalum ya overflow.
Kuchanganya aina za float na double
Kushughulikia thamani ya float kwa literal kama 1.23, ambayo kwa chaguo-msingi ni double, kunaweza kuunda ubadilishaji wa float → double → float. Katika chanzo, toleo la mixed lilipimwa kwa 21,6 ns na toleo linalotumia float pekee kwa 1.23f kwa 14,2 ns, na waandishi wakasema toleo la unmixed ni takriban %52 haraka zaidi.
SIMD
Single Instruction, Multiple Data (SIMD) huruhusu shughuli sambamba kwenye vipengele vingi vya data kwa amri moja ya CPU. Katika jaribio la array-addition lililotumia SSE2, toleo la kawaida lilichukua 21.447 ns na toleo la SIMD 10.929 ns; kupungua kwa muda wa operesheni kwa takriban %49 kuliripotiwa.
Programu ya Lock-free
Utafiti ulilinganisha shughuli za atomiki na usawazishaji unaotegemea mutex. Kwa increment 10.000, toleo la atomic lilichukua takriban 65.369 ns na toleo la mutex 175.904 ns, huku chanzo kikiripoti takriban %63 ya uboreshaji wa utendaji kwa mbinu ya atomiki.
Programu ya lock-free si “bure” licha ya kutotumia kufuli. Gharama za Atomics, CAS, memory ordering na cache-coherence zinaendelea kuwepo; pia kutekeleza muundo sahihi wa lock-free kunaweza kuwa changamano zaidi kuliko msimbo unaotegemea mutex.
Kernel bypass
Kernel bypass haikufanyiwa benchmark ndani ya utafiti huu. Mbinu hiyo inalenga kufanya user space iwasiliane na NIC kwa njia ya moja kwa moja zaidi badala ya kupitisha paketi za mtandao kupitia kernel networking stack. Chanzo kinataja teknolojia kama OpenOnload, VMA na DPDK kama mifano, lakini hakiwasilishi utendaji wake kama jaribio la utafiti huu.
Kwa Nini LMAX Disruptor ni Tofauti na Foleni ya Kawaida?
LMAX Disruptor ni usanifu wa ujumbe wenye ucheleweshaji mdogo unaosimamia uhamishaji wa data kati ya producer na consumer kwa kutumia ring buffer iliyotengewa mapema, nambari za sequence zinazoendelea kuongezeka na wait strategy inayoweza kuchaguliwa. Tofauti yake kuu na mbinu ya kawaida ya mutex/condition-variable queue ni kupunguza kadiri iwezekanavyo gharama za runtime memory allocation na lock contention, ili producer na consumer wafikie data ya pamoja kupitia mpangilio wa kumbukumbu unaotabirika zaidi.
Ring buffer
Ring buffer ni muundo wa data wenye ukubwa usiobadilika unaotumiwa tena kwa mzunguko. Kwa kuwa kumbukumbu hutengwa mwanzoni, hakuna haja ya allocation/deallocation mpya kwa kila event. Hii hufanya matumizi ya kumbukumbu kuwa yanayotabirika zaidi na inaweza pia kutoa faida kwa cache locality.
Sequencer
Sequencer hufuatilia kwa nambari za sequence ni slot zipi za ring-buffer zinazoweza kuandikwa na producer na kusomwa na consumer. Baada ya producer kuandika event, huchapisha sequence husika; consumer hufuatilia hatua yake ya maendeleo kupitia sequence.
Sequence Barrier na Wait Strategy
Sequence Barrier humwezesha consumer kuamua kama event inaweza kusomwa kwa usalama. Ikiwa data bado haipatikani, Wait Strategy huanza kutumika. Busy-spin inaweza kulenga latency ya chini kabisa lakini hutumia CPU nyingi; sleeping inaweza kutumia CPU kidogo huku ikisababisha latency ya juu zaidi.
Wait strategy iliyotumika katika benchmark za utafiti ni yield wait. Hakukuwa na ulinganisho wa kimfumo na busy-spin, sleeping au mikakati mingine. Kwa hiyo, thamani za latency za Disruptor si matokeo ya jumla kwa usanidi wote unaowezekana.
Mbinu na Matokeo ya Utafiti
Tabaka la kwanza la majaribio: Low-Latency Programming Repository
Waandishi walikusanya uboreshaji chini ya vichwa vya compile-time features, optimisation techniques, data handling, concurrency na system programming. Google Benchmark ilikuwa zana kuu ya kupima muda; Linux perf ilitumika hasa kwa uchambuzi wa cache-reference na cache-miss.
| Mbinu | Uboreshaji wa takriban ulioripotiwa katika chanzo | Utaratibu mkuu |
|---|---|---|
| Cache warming | %90 | Kuleta data/agizo kwenye cache mapema |
| Constexpr | %90,88 | Kuhamisha hesabu kutoka runtime hadi compile-time |
| Loop unrolling | %72,24 | Kupunguza mzigo wa udhibiti wa kitanzi |
| Atomic / lock-free counter | %63 | Kupunguza gharama za mutex na context-switch |
| Kutochanganya Float/double | Kwa maneno ya chanzo %52 | Kuondoa implicit conversion |
| Short-circuiting | Takriban %50 | Kutotekeleza hesabu zisizohitajika za Boolean |
| SIMD array addition | Takriban %49 | Kuchakata vipengele vingi vya data kwa amri moja |
| Branch reduction | %36 | Kupunguza idadi ya branch ndani ya hot path |
| Compile-time dispatch | Takriban %26 | Kuondoa uamuzi wa Runtime dispatch |
| Prefetching | %23,5 | Kuomba data kwenye cache kabla ya kutumiwa |
| Inlining | %20,5 | Kupunguza mzigo wa wito wa kazi |
| Mfano wa Signed vs unsigned | %12,15 | Maagizo machache ya assembly katika benchmark maalum |
| Slowpath removal | %12 | Kutenganisha msimbo nadra na instruction hot path |
Jedwali hili halipaswi kutafsiriwa kama orodha ya “uboreshaji upi ni bora zaidi?” Kila mstari una operesheni, ukubwa wa data, tabia ya compiler na muundo wa benchmark tofauti. Kwa mfano, matokeo ya 90% ya cache-warming yanatokana na benchmark kubwa ya memory-access, ilhali matokeo ya 90,88% ya constexpr yanatokana na mfano wa factorial 10.
Tabaka la pili la majaribio: pairs trading
Ili kuona uboreshaji katika programu iliyo karibu zaidi na uhalisia, utafiti ulitumia backtest ya statistical-arbitrage pairs-trading kwenye data za adjusted-close za kila siku za miaka mitano za hisa za Goldman Sachs Group Inc. (GS) na Morgan Stanley (MS).
Cointegration Inamaanisha Nini katika Mkakati wa Pairs Trading?
Cointegration ni hali ambapo mchanganyiko fulani wa mstari wa misururu miwili ya muda ambayo kila mmoja ni non-stationary huwa stationary. Katika utafiti huu, kupima misururu ya adjusted-close ya GS na MS kwa mbinu ya hatua mbili ya Engle–Granger kulitumiwa kutoa ushahidi wa takwimu kwamba kulikuwa na uhusiano wa muda mrefu wa usawaziko kati ya misururu ya bei katika kipindi cha miaka mitano kilichochunguzwa.
Katika uwasilishaji wa dhana wa chanzo, misururu miwili:
huchukuliwa kwa namna hii. Ikiwa:
mchanganyiko ni stationary, basi \(Y_t\) na \(X_t\) hutathminiwa kuwa cointegrated. Hapa \(\gamma\) inawakilisha uhusiano wa muda mrefu wa mstari kati ya misururu miwili.
Katika jaribio la Engle–Granger kwa GS–MS, chanzo kinaripoti p≈0,0149 na t≈−3,7684. Katika kiwango cha significance cha \(0,05\), no-cointegration null hypothesis ilikataliwa. Matokeo haya yanatoa ushahidi wa takwimu wa cointegration; hayathibitishi kwamba uhusiano hautabadilika siku zijazo au kwamba mkakati wa trading utakuwa na faida kwa uhakika.
Uzalishaji wa ishara kwa Z-score
Algoriti husanifisha spread ya sasa kwa kutumia rolling mean na standard deviation ya spread:
Hapa \(Z\) ni z-score, \(X\) ni spread ya sasa, \(\mu\) ni rolling spread mean na \(\sigma\) ni thamani ya rolling spread standard deviation.
Katika mkakati wa chanzo:
- \(Z>1.0\): GS huchukuliwa kuwa ghali kwa kulinganisha; ishara ya GS short, MS long hutolewa.
- \(Z<-1.0\): GS huchukuliwa kuwa nafuu kwa kulinganisha; ishara ya GS long, MS short hutolewa.
- \(|Z|<0.8\): kwa dhana kwamba spread imerudi kwenye wastani, nafasi iliyo wazi hufungwa.
- Katika maeneo mengine hakuna ishara mpya ya biashara inayotolewa.
Matokeo ya kifedha ya Backtest
Katika backtest ya chanzo, jalada huanza na dola za Marekani 1.000.000 na kumalizika na dola za Marekani 1.328.581. Sharpe ratio iliyoripotiwa ni 1,09.
\(R_p\) ni mapato ya jalada, \(R_f\) ni mapato yasiyo na hatari na \(\sigma_p\) ni thamani ya standard deviation ya excess-return ya jalada.
Kulingana na maelezo ya utafiti wenyewe, tathmini kamili ya mafanikio ya kifedha ya algoriti ya trading si lengo kuu la utafiti. Matokeo haya yanatokana na backtest ya data za kihistoria na hayawakilishi transaction cost, execution quality halisi, order-book dynamics, slippage, network delay na hitilafu zote za soko hai.
Uboreshaji wa CPU katika algoriti ya Pairs-trading
AVX2 ilitumika katika hesabu ya rolling spread mean na standard-deviation ya algoriti. Ndani ya register ya 256-bit __m256d, thamani nne za double zilichakatwa kwa wakati mmoja, huku jumla ya spread na jumla ya miraba zikihesabiwa sambamba. Mpangilio huu pia unatekeleza loop unrolling kwa hatua za vipengele vinne.
Kikomo muhimu ambacho chanzo kinataja kwa programu hii ni hitaji kwamba window size iwe kizidishi cha nne. Hii inatokana na muundo wa AVX2 uliotumika.
Mabadiliko ya pili muhimu ni kutumia array yenye ukubwa usiobadilika na rolling index badala ya dynamic container. Spread mpya inapokuja, kipengele cha zamani zaidi hubadilishwa katika nafasi ileile ndani ya array; hivyo hitaji la dynamic memory allocation inayorudiwa hupunguzwa.
Inlining pia ilitumika kwa kazi za kuhesabu mean na standard-deviation.
| Muundo | Latency | Uboreshaji ulioripotiwa katika chanzo |
|---|---|---|
| Inlining | 406.709 ns | %21,41 |
| SIMD + loop unrolling | 355.618 ns | %31,28 |
| Fixed array | 266.146 ns | %48,58 |
| Combined | 65.580 ns | %87,33 |
Katika sehemu ya baadaye ya evaluation ya mizunguko 10, chanzo kinatoa wastani wa 517.559 ns na standard deviation ya 4.233 ns kwa algoriti isiyoboreshwa; na wastani wa 65.588 ns na standard deviation ya 400 ns kwa algoriti iliyoboreshwa. Kwa hivyo, upungufu wa latency ulioripotiwa ni %87,38.
Katika sehemu ya awali ya mbinu pia kuna thamani ya 519.772 ns kwa baseline. Kwa kuwa chanzo hakielezi wazi tofauti ndogo kati ya nambari hizi mbili za baseline, thamani hizo hazijalazimishwa kuunganishwa kuwa nambari moja.
Idadi ya Instruction na tabia ya Cache-miss
| Mbinu | Instruction | Cache misses / cache references |
|---|---|---|
| Bila uboreshaji | 6,01 bilioni | %16,001 |
| Combined | 3,27 bilioni | %33,879 |
| Fixed array | 8,27 bilioni | %19,089 |
| Inlining | 9,07 bilioni | %19,151 |
| SIMD + loop unrolling | 8,35 bilioni | %16,829 |
Jedwali hili linafanya matokeo muhimu yaonekane: asilimia ndogo ya cache-miss au idadi ndogo ya instruction peke yake haimaanishi programu ya haraka zaidi. Ingawa toleo la Combined lilikuwa na asilimia kubwa zaidi ya cache-miss, lilitoa latency ya chini zaidi. Utendaji wa CPU ni matokeo ya pamoja ya instruction-level parallelism, memory layout, branch behavior, uboreshaji wa compiler na mpangilio wa ufikiaji wa data.
Jaribio la takwimu
Katika benchmark za pairs-trading, kila muundo uliendeshwa mara 10 na paired t-test ikatumika kwa vipimo vya latency vilivyoboreshwa/isivyoboreshwa. Chanzo kinaripoti t-statistics kubwa sana na p-values ndogo sana, na kinaeleza kuwa uwezekano wa tofauti iliyopimwa ya latency kuelezwa tu na mabadiliko ya nasibu ni mdogo.
Hata hivyo, chanzo kinakubali wazi kuwa kutumia pointi 10 tu za data ni kizuizi na kinaeleza kuwa vipimo zaidi vinaweza kuongeza usahihi.
Tafsiri ya faida inapaswa kubaki ndani ya mpaka gani?
Chanzo kinaunganisha latency ya chini na fasihi kwa hoja kwamba inaweza kuwa na manufaa ya kifedha kwa sababu ya uwezo wa kuitikia mapema fursa za soko za muda mfupi. Pia, kwa kutumia uhusiano ulioripotiwa katika utafiti mwingine kati ya latency na kukabiliwa na mabadiliko hasi ya order-book, kinatoa hesabu inayolinganishwa ongezeko la kasi la %87,32 na takriban %78,59 ya exposure ndogo zaidi.
Thamani hii ya %78,59 si matokeo yaliyopimwa moja kwa moja na utafiti katika soko hai. Ni makadirio yanayotokana na chanzo kwa kuunganisha kwa mstari uhusiano wa regresheni wa utafiti mwingine na faida ya latency ya backtest ya utafiti huu. Haijaonyeshwa kwamba upungufu huo huo wa exposure hutokea katika mfumo halisi wa HFT.
Tabaka la tatu la majaribio: C++ Disruptor
Utekelezaji wa C++ Disruptor umeundwa kutokana na vipengele producer, ring buffer, sequencer, event processor, sequence barrier, event na wait strategy. Katika muktadha wa HFT, event inaweza kuwa kitu cha order; katika benchmark ya chanzo event rahisi ya string ilitumika.
Muundo wa kulinganisha una thread mbili. Katika toleo la Disruptor, producer huchapisha data kwenye ring buffer na consumer huichakata katika thread tofauti kulingana na nambari za sequence. Katika toleo la Simple Queue, std::queue<std::string>, std::mutex na std::condition_variable hutumika.
| Event | Simple Queue | Disruptor | Kuongeza kasi kulikoripotiwa katika chanzo |
|---|---|---|---|
| 10 | 20.646 ns | 18.182 ns | %11,9 |
| 100 | 99.458 ns | 64.686 ns | %35,0 |
| 1.000 | 881.092 ns | 451.251 ns | %48,8 |
| 10.000 | 9.735.102 ns | 4.361.096 ns | %55,2 |
| 100.000 | 90.088.609 ns | 52.562.872 ns | %41,7 |
| 1.000.000 | 884.871.405 ns | 543.171.556 ns | %38,7 |
Chanzo kinaeleza kwamba kadiri idadi ya event inavyoongezeka, tofauti kamili ya muda kati ya miundo miwili inaongezeka. Kwa event 10 tofauti ya wastani iliripotiwa kuwa 2.464 ns, na kwa event 1.000.000 kuwa 341.699.849 ns.
Tabia ya cache ya Disruptor
Katika mizigo midogo kama event 10 na 100, kiwango cha cache-miss cha Disruptor kilikuwa juu kidogo kuliko Simple Queue. Katika masafa ya event 1.000–1.000.000, uhusiano huo uligeuka na Disruptor ikaonyesha viwango vya chini vya cache-miss. Hii inaashiria kuwa ring buffer inaweza kutoa tabia bora zaidi ya memory-access katika mitiririko mikubwa ya event.
Katika jaribio la 10-event, Disruptor ilitekeleza takriban 586.000 instruction chache. Chanzo kinaunganisha hili na kupungua kwa lock contention, kumbukumbu ya ring-buffer iliyotengwa mapema na mawasiliano ya producer–consumer yanayotabirika zaidi.
Jaribio la Utendaji wa Takwimu la Disruptor Linaonyesha Nini?
Katika jaribio tofauti la chanzo la mizunguko 20 na event 1.000, Simple Queue ilipimwa kuwa na latency ya wastani ya 931.255 ns na standard deviation ya 453.766 ns; Disruptor latency ya wastani ya 74.908 ns na standard deviation ya 53.600 ns. Kwa kuwa matokeo ya T-test yaliripotiwa kama \(t=22.596\) na \(p=1.243\times10^{-23}\), ndani ya seti hii ya majaribio tofauti ya latency ya wastani iliyopimwa kati ya miundo miwili ni yenye nguvu kitakwimu.
Matokeo haya yana nyakati kamili zinazotofautiana na thamani za 1.000-event katika Jedwali 4. Chanzo kinawasilisha hizi kama tathmini tofauti za benchmark lakini hakielezi kwa kina chanzo cha tofauti ya usanidi au kipimo. Kwa hiyo, 451.251 ns na 74.908 ns hazipaswi kupunguzwa kuwa thamani moja “sahihi” ya Disruptor latency.
Vikwazo vya tathmini ya Disruptor
Benchmark imelenga hasa kasi ya inter-thread communication. Memory consumption na CPU load hazikulinganishwa kwa kina. Aidha, yield wait strategy pekee ndiyo iliyotumika; busy-spin, sleep na wait strategy nyingine hazikujaribiwa kwa utaratibu. Kwa hiyo, matokeo yaliyopimwa hayawakilishi usanidi wote wa Disruptor.
Tathmini ya watumiaji wa Low-Latency Repository
Repository ilikaguliwa na jumla ya washiriki 17 kutoka vyuo vikuu vinne: Imperial College London, University College London, King's College London na University of Oxford. Washiriki 11 walikuwa katika sayansi ya kompyuta; sita katika hisabati, fizikia au uhandisi.
| Kategoria | Wastani | Chini zaidi | Juu zaidi |
|---|---|---|---|
| Comprehensiveness | 8,3 | 6,5 | 9,1 |
| Clarity | 8,7 | 7,8 | 8,9 |
Tathmini hii si ushahidi wa utendaji wa programu, bali ni sampuli ndogo ya watumiaji kuhusu matumizi ya repository katika elimu.
Matokeo yanayoungwa mkono na utafiti
Chanzo kinaonyesha kwamba katika mazingira ya benchmark yaliyokaguliwa, mpangilio wa data katika kiwango cha C++, matumizi ya cache, hesabu za compile-time, kupunguza branch, SIMD, atomics na mikakati ya allocation vinaweza kuwa na athari inayopimika kwenye latency. Benchmark ya pairs-trading iliyotumia uboreshaji kadhaa pamoja ilitoa upungufu mkubwa zaidi wa jumla wa latency kuliko uboreshaji mmoja mmoja. Utekelezaji wa C++ Disruptor ulipimwa kuwa wa haraka zaidi kuliko mutex/condition-variable queue katika mizigo ya producer–consumer iliyojaribiwa.
Ujumla ambao utafiti hauuungi mkono
Utafiti hauonyeshi kwamba faida za asilimia katika benchmark zitarudiwa sawa kwenye CPU, compiler, mfumo wa uendeshaji au muundo wa data mwingine. Haiwezi kuhitimishwa kwamba cache warming itatoa %90 katika kila mzigo wa kazi, constexpr %90 katika kila hesabu au SIMD %49 katika kila algoriti. Vivyo hivyo, kupungua kwa latency ya backtest hakuwezi kusawazishwa moja kwa moja na faida ya live trading, na benchmark ya Disruptor haipimi end-to-end latency ya OMS kamili halisi.
Mapendekezo ya kazi ya baadaye
Chanzo kinapendekeza mwelekeo mkuu mitatu. Kwanza, kupanua repository kwa mbinu mpya kama variadic templates, kernel bypass na networking optimisations. Pili, kujaribu algoriti ya pairs-trading kwenye live market-data feed. Tatu, kuunganisha Disruptor na algoriti ya trading na kuunda benchmark pana zaidi ya trading-system ambamo vitu vya order huhamishwa kupitia ring buffer.
Maelezo ya Chanzo na Mbinu
Kichwa kamili cha asili: C++ design patterns for low-latency applications including high-frequency trading
Waandishi: Paul Bilokon; Burak Gunduz.
Uhusiano wa taasisi: Paul Bilokon — Departments of Computing and Mathematics, Imperial College London; Burak Gunduz — Department of Computing, Imperial College London.
Aina ya chanzo: Preprint.
Tarehe iliyoandikwa kwenye Manuscript: 11 Septemba 2023.
Tarehe ya toleo la kwanza la arXiv: 8 Septemba 2023.
arXiv: 2309.04259v1 [cs.PF].
DOI: 10.48550/arXiv.2309.04259.
Jukwaa: arXiv / CoRR.
Hali ya mapitio ya kitaalamu: Katika rekodi za bibliografia zilizothibitishwa, kazi inaonekana kama preprint / informal publication; toleo la jarida lililopitiwa na wataalamu halijathibitishwa.
Artefakti ya programu: Chanzo kinaeleza kwamba Low-Latency Programming Repository, msimbo wa pairs-trading na utekelezaji wa Disruptor zimetolewa katika hazina ya 0burak/imperial_hft.
Leseni: Kwa kuwa hakuna leseni wazi ya maudhui iliyogunduliwa katika PDF iliyopakiwa, hakuna Creative Commons maalum au leseni inayofanana iliyoainishwa.
Ufadhili: Hakuna taarifa tofauti ya ufadhili iliyogunduliwa katika preprint iliyopakiwa.
Mgongano wa maslahi: Hakuna taarifa tofauti ya mgongano wa maslahi iliyogunduliwa katika preprint iliyopakiwa.
CRediT / michango ya waandishi: Hakuna taarifa tofauti ya CRediT iliyoripotiwa.
Zana kuu za mbinu: Kipimo cha muda kwa Google Benchmark; tabia ya cache kwa Linux perf; microbenchmark za C++ zenye ucheleweshaji mdogo; jaribio la Engle–Granger cointegration na pairs-trading backtest kwa data za adjusted-close za GS–MS; uboreshaji wa AVX2/SIMD; ulinganisho wa C++ ring-buffer/Disruptor; paired t-test.
Vikwazo kuu: Sehemu muhimu ya benchmark ziko katika kiwango cha CPU na programu. Mtandao kamili wa uzalishaji wa HFT, co-location, exchange order flow, hardware timestamping na hali za live market-data hazikupimwa pamoja. Algoriti ya pairs-trading ni backtest ya data za kihistoria. Uboreshaji wa AVX2 unahitaji hardware inayounga mkono na, katika utekelezaji wa utafiti, window size ambayo ni kizidishi cha nne. Katika jaribio la Disruptor, memory consumption na CPU load hazikutathminiwa kwa kina; wait strategy mbadala hazikulinganishwa.
Maelezo ya uadilifu wa nambari ndani ya chanzo: Muda wa pairs-trading baseline unaonekana kama 519.772 ns katika sehemu ya mbinu na 517.559,10 ns katika sehemu ya baadaye ya evaluation. Aidha, thamani za 1.000-event za Disruptor zinatofautiana kati ya Jedwali 4 na jaribio la baadaye la takwimu la mizunguko 20. Verianla haijarekebisha kimya kimya thamani mojawapo au kuibadilisha na nyingine.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *