

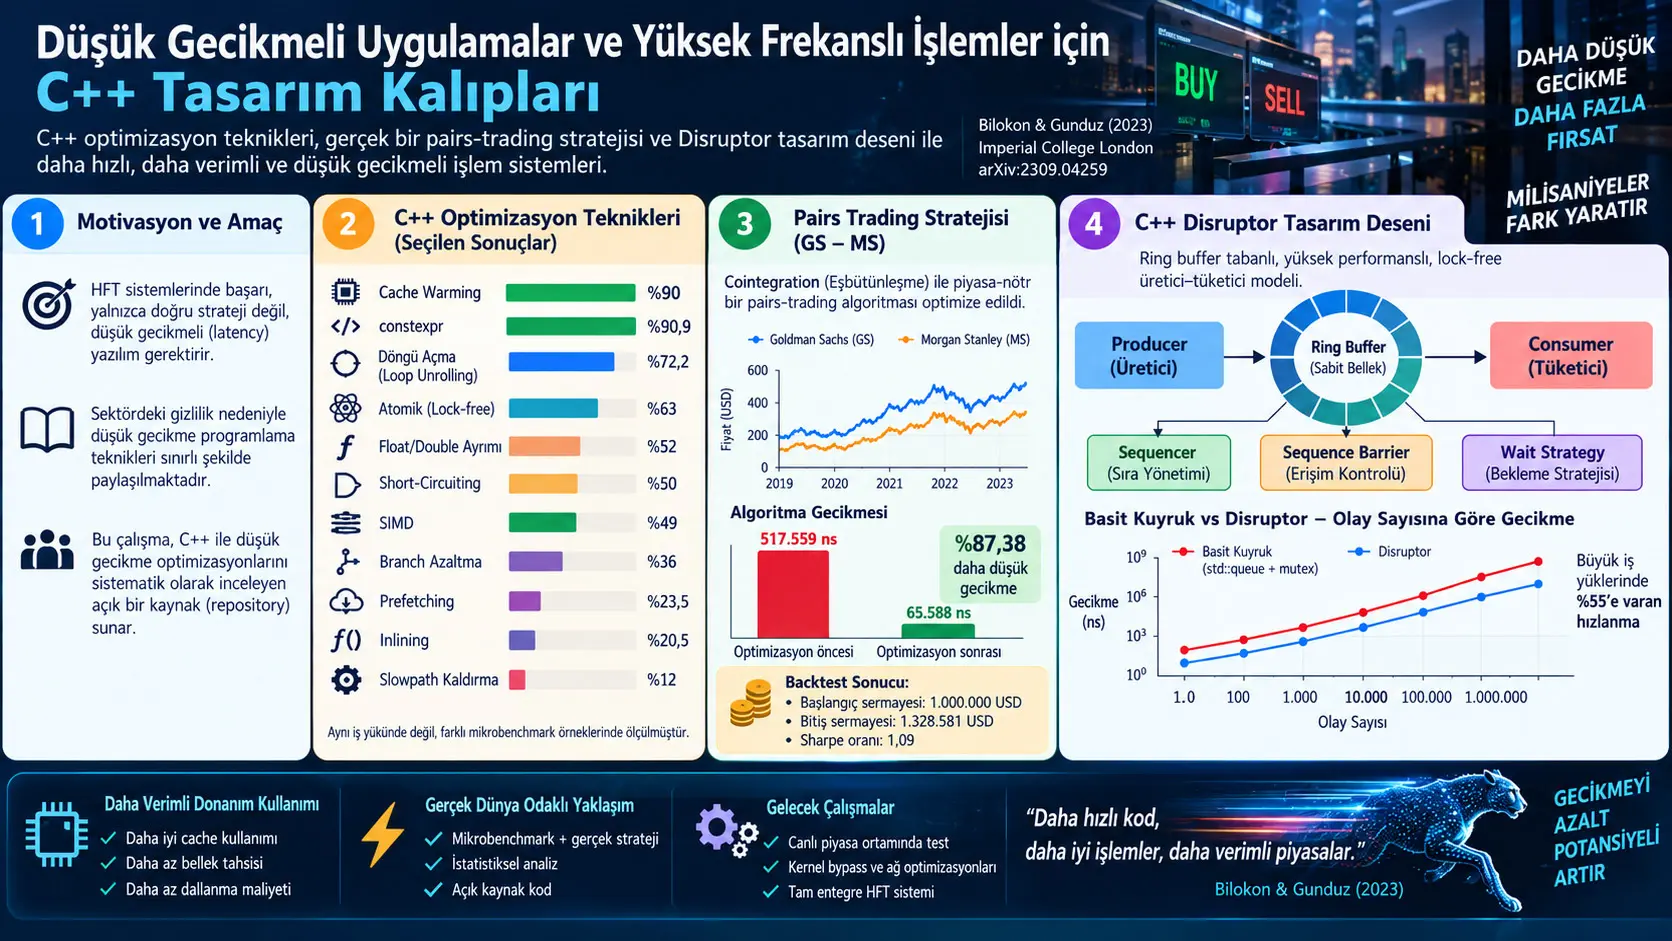
Düşük gecikmeli C++ optimizasyonu, bir programın yalnız ortalama çalışma süresini değil, gecikmenin değişkenliğini de azaltmak amacıyla bellek erişimi, önbellek kullanımı, derleme zamanı hesaplamaları, dallanma, veri yerleşimi, paralel yürütme ve thread'ler arası iletişim gibi CPU düzeyindeki maliyetleri sistematik biçimde düzenleyen performans mühendisliği yaklaşımıdır. Paul Bilokon ve Burak Gunduz'un çalışması bu yaklaşımı üç katmanda inceler: çok sayıda C++ optimizasyon tekniğini ayrı ayrı benchmark eden bir Low-Latency Programming Repository, bu tekniklerin uygulandığı piyasa-nötr bir pairs-trading backtest algoritması ve producer–consumer iletişimi için C++ ile gerçekleştirilen LMAX Disruptor yapısı.
Kaynakta izole mikrobenchmarklarda en yüksek raporlanan hız artışları cache warming ve constexpr için yaklaşık %90, loop unrolling için %72,24, atomic tabanlı lock-free sayaç için yaklaşık %63, float/double türlerini karıştırmamanın test edildiği örnekte kaynak yazarlarının ifadesiyle yaklaşık %52, short-circuiting için yaklaşık %50 ve SIMD dizi toplama için yaklaşık %49'dur. Buna karşılık inlining %20,5, prefetching %23,5, compile-time dispatch yaklaşık %26, branch reduction %36, slowpath removal %12 ve ilgili signed/unsigned karşılaştırması yaklaşık %12,15 iyileşme göstermiştir. Bu oranlar birbirinden farklı mikrobenchmarklara aittir; tek bir uygulamada toplanarak genel bir hızlanma yüzdesi gibi yorumlanamaz.
Pairs-trading uygulamasında SIMD/AVX2, loop unrolling, sabit boyutlu dizi kullanımı ve inlining bir araya getirildiğinde 10 benchmark koşusuna dayalı değerlendirmede ortalama gecikme yaklaşık 517.559 ns'den 65.588 ns'ye düşmüş ve kaynak bunu %87,38 gecikme iyileşmesi olarak raporlamıştır. Standart sapma da 4.233 ns'den 400 ns'ye düşmüştür. Ancak bu test geçmiş verilerle çalışan bir backtest kodu üzerindedir; canlı piyasa veri akışı, network latency, borsa bağlantısı ve gerçek Order Management System davranışı bu sonucun içinde değildir.
Çalışmanın üçüncü katmanında C++ Disruptor, mutex ve condition variable kullanan standart bir queue ile karşılaştırılmıştır. Event sayısı arttıkça Disruptor'un ölçülen avantajı genel olarak büyümüş; kaynak Tablo 4'te 10 event için %11,9, 1.000 event için %48,8, 10.000 event için %55,2 ve 1.000.000 event için %38,7 hızlanma raporlamıştır. Ayrı bir 20-koşuluk 1.000-event deneyinde Simple Queue için 931.255 ns, Disruptor için 74.908 ns ortalama gecikme verilmiş ve farkın t-istatistiği 22,596, p-değeri ise \(1.243\times10^{-23}\) olarak raporlanmıştır. Mutlak süreler önceki benchmark serisinden farklı olduğundan bu iki veri kümesi aynı ölçüm dizisi gibi birleştirilmemelidir.
Çalışma hangi problemi çözmeye çalışıyor?
Yüksek frekanslı işlem sistemlerinde yazılımın yalnız doğru karar vermesi yeterli değildir; kararın hangi gecikmeyle verildiği ve bu gecikmenin koşudan koşuya ne kadar değiştiği de kritik hale gelir. Bu nedenle çalışma, C++ kodundaki küçük görünen optimizasyonların CPU seviyesinde gerçek ölçümlerle test edilmesine odaklanır.
Yazarların temel motivasyonu, HFT endüstrisindeki düşük gecikme mühendisliğinin önemli bölümünün rekabet ve gizlilik nedeniyle kamuya açık akademik literatürde ayrıntılı biçimde bulunmamasıdır. Bu boşluğu azaltmak amacıyla oluşturulan Low-Latency Programming Repository, teknikleri yalnız isimlendiren bir liste değil, benchmark kodu ve ölçümleri bulunan uygulamalı bir arşiv olarak tasarlanmıştır.
Cache Warming Düşük Gecikmeli C++'ta Neden Önemlidir?
Cache warming, performans açısından kritik veri veya komutların gerçekten ihtiyaç duyulmadan önce CPU önbelleğine erişilerek hazır tutulmasıdır. HFT'deki “hot path” seyrek çalışsa bile tetiklendiğinde çok hızlı olması gerektiğinden, çalışma yürütme motorunun ilgili veri ve kodunun önceden çalıştırılarak veya okunarak cache içinde tutulmasının bellek erişim gecikmesini azaltabileceğini göstermektedir.
Kaynak iki farklı Google Benchmark senaryosu oluşturmuştur. BM_CacheCold büyük bir veri kümesine rastgele erişerek zayıf spatial locality oluştururken BM_CacheWarm veriye önce ve benchmark sırasında sıralı biçimde erişmektedir.
| Metrik | BM_CacheCold | BM_CacheWarm |
|---|---|---|
| Süre | 267.685.006 ns | 25.635.035 ns |
| Instruction | 4.931.929.489 | 12.013.354.366 |
| Cache reference | 146.264.562 | 61.306.992 |
| Cache miss / cache reference | %73,964 | %71,559 |
Yazarlar süre farkını yaklaşık %90 hız iyileşmesi olarak yorumlamaktadır. İlginç olan, cache-miss oranının %73,964'ten yalnız %71,559'a düşmesine rağmen toplam cache reference sayısının büyük ölçüde azalmasıdır. Bu sonuç cache optimizasyonunun yalnız “miss yüzdesine” bakılarak yorumlanamayacağını gösterir; erişim düzeni, toplam memory traffic ve aynı zaman içinde yapılan iş miktarı da önemlidir.
Compile-time dispatch
Runtime dispatch, çalışacak fonksiyonun program çalışırken seçilmesine dayanırken compile-time dispatch bu kararı derleme aşamasında verir. Kaynak benchmarkında iki runtime-dispatch örneği 2,60 ns ve 2,15 ns ölçülürken compile-time karşılıkları her iki durumda da 1,92 ns olmuştur. Çalışmanın toplu değerlendirmesi bu tekniğe yaklaşık %26 hız iyileşmesi atfetmektedir.
Constexpr
constexpr, uygun ifadelerin runtime yerine derleme sırasında değerlendirilmesine izin verir. Çalışmada faktöriyel 10 hesabının constexpr sürümü yaklaşık 0,245 ns, runtime recursive sürümü ise 2,69 ns ölçülmüş ve kaynak yaklaşık %90,88 hız farkı bildirmiştir.
Yazarlar bu sonucu genel bir “constexpr her zaman %90 hızlandırır” kuralı olarak sunmamaktadır. Modern compiler'lar constexpr olmayan kodu da optimize edebilir. Deneydeki fark, bu özel kod ve compiler davranışı altında oluşmuştur.
Inlining
Inlining, fonksiyon çağrısı yerine fonksiyon gövdesinin çağrı konumuna yerleştirilmesini amaçlar. always_inline kullanılan test yaklaşık 1,90 ns, normal fonksiyon yaklaşık 2,39 ns sürmüş ve kaynak yaklaşık %20,5 iyileşme raporlamıştır. Bununla birlikte aşırı inlining executable boyutunu artırabilir ve instruction cache davranışını kötüleştirebilir.
Loop unrolling
Loop unrolling, döngü kontrolünün tekrar sayısını azaltmak için tek iterasyonda birden çok işlemi açık biçimde gerçekleştirir. Kaynaktaki testte standart döngü 4.539 ns, dört adımlı unrolled döngü 1.260 ns sürmüş ve %72,24 iyileşme raporlanmıştır.
Bu teknik de sınırsız biçimde ölçeklenmez. Daha büyük binary, instruction cache baskısı ve memory-bound iş yükleri kazanımı azaltabilir.
Short-circuiting
Short-circuiting, Boolean bir ifadenin sonucu kesinleştiği anda gereksiz kalan hesapların yapılmamasıdır. Kaynakta 8 ile 8.192 iterasyon arasındaki farklı testlerde short-circuit sürüm yaklaşık olarak normal sürümün yarısı sürede çalışmış; iyileşmeler %49,53 ile %52,83 arasında raporlanmıştır.
Slowpath removal
Slowpath removal, hata işleme, loglama veya nadir durum kodlarını sürekli çalışan hot path'in dışına taşır. Kaynakta hot path'in %90, slow path'in %10 çalıştığı benchmarkta doğrudan gömülü slowpath kodu 28.074 ns, ayrı HandleError fonksiyonuna taşınmış sürüm 24.755 ns sürmüş ve yaklaşık %12 iyileşme görülmüştür.
Branch reduction
Branch reduction, aynı hot path içerisinde art arda çok sayıda hata kontrolü yapmak yerine hata durumlarını örneğin bir bit maskesi içinde birleştirerek branch sayısını azaltmayı amaçlar. Kaynak deneyinde klasik yapı 7,35 ns, azaltılmış branch yapısı 4,68 ns sürmüş ve yaklaşık %36 iyileşme raporlanmıştır.
Prefetching
__builtin_prefetch kullanılan büyük vektör toplama testinde prefetch kullanılmayan sürüm 8.235.924 ns, prefetch kullanılan sürüm 6.301.400 ns sürmüştür. Kaynak bunu yaklaşık %23,5 performans kazanımı olarak raporlamaktadır. Kazanç veri erişiminin öngörülebilirliğine, veri büyüklüğüne ve işlemci mimarisine bağlıdır.
Signed ve unsigned integer karşılaştırması
Kaynağın özel testinde signed integer kullanılan fonksiyon 0,282 ns, unsigned sürüm 0,321 ns ölçülmüş ve signed sürüm için yaklaşık %12,15 hız avantajı hesaplanmıştır. Bunun nedeni örnekte compiler'ın unsigned overflow durumunu korumak için ek assembly talimatları üretmesidir.
Bu sonuç “signed her zaman unsigned'dan hızlıdır” şeklinde genellenemez. Kaynağın kendisi belirli döngü ve overflow semantiğine sahip bir mikrobenchmarkı ölçmektedir.
Float ve double türlerinin karıştırılması
Bir float değerini 1.23 gibi varsayılan olarak double olan literal ile işlemek, float → double → float dönüşümleri yaratabilir. Kaynakta mixed sürüm 21,6 ns, yalnız float kullanan 1.23f sürümü 14,2 ns ölçülmüş ve yazarlar unmixed sürümü yaklaşık %52 daha hızlı olarak ifade etmiştir.
SIMD
Single Instruction, Multiple Data (SIMD), tek CPU komutuyla birden fazla veri elemanı üzerinde paralel işlem yapılmasına olanak verir. SSE2 kullanan array-addition testinde klasik sürüm 21.447 ns, SIMD sürümü 10.929 ns sürmüş; operasyon süresinde yaklaşık %49 düşüş raporlanmıştır.
Lock-free programlama
Çalışma atomik işlemleri mutex tabanlı senkronizasyonla karşılaştırmıştır. 10.000 increment için atomic sürüm yaklaşık 65.369 ns, mutex sürümü 175.904 ns sürmüş ve kaynak atomik yaklaşım için yaklaşık %63 performans iyileşmesi bildirmiştir.
Lock-free programlama kilit kullanmamasına rağmen “ücretsiz” değildir. Atomics, CAS, memory ordering ve cache-coherence maliyetleri devam eder; ayrıca doğru lock-free tasarımın uygulanması mutex tabanlı koddan daha karmaşık olabilir.
Kernel bypass
Kernel bypass çalışma kapsamında benchmark edilmemiştir. Teknik, ağ paketlerinin kernel networking stack üzerinden geçirilmesi yerine kullanıcı alanının NIC ile daha doğrudan iletişim kurmasını amaçlar. Kaynak OpenOnload, VMA ve DPDK gibi teknolojileri örneklemektedir fakat bunların performansını çalışmanın kendi deneyi gibi sunmamaktadır.
LMAX Disruptor Neden Geleneksel Kuyruktan Farklıdır?
LMAX Disruptor, producer ve consumer'lar arasında önceden ayrılmış bir ring buffer, sürekli artan sequence numaraları ve seçilebilir wait strategy kullanarak veri aktarımını yöneten düşük gecikmeli bir mesajlaşma mimarisidir. Geleneksel mutex/condition-variable queue yaklaşımından temel farkı, runtime memory allocation ve lock contention maliyetlerini mümkün olduğunca azaltarak producer ile consumer'ın ortak veriye daha öngörülebilir bir bellek düzeni üzerinden erişmesini sağlamasıdır.
Ring buffer
Ring buffer sabit büyüklükte, dairesel olarak yeniden kullanılan bir veri yapısıdır. Bellek başlangıçta ayrıldığı için her event'te yeni allocation/deallocation yapılması gerekmez. Bu hem bellek kullanımını daha öngörülebilir hale getirir hem de cache locality açısından avantaj sağlayabilir.
Sequencer
Sequencer, hangi ring-buffer slotlarının producer tarafından yazılabileceğini ve consumer tarafından okunabileceğini sequence numaralarıyla takip eder. Producer event'i yazdıktan sonra ilgili sequence'i yayımlar; consumer kendi ilerleme noktasını sequence üzerinden izler.
Sequence Barrier ve Wait Strategy
Sequence Barrier, consumer'ın bir event'in güvenli biçimde okunabilir olup olmadığını belirlemesini sağlar. Veri henüz mevcut değilse Wait Strategy devreye girer. Busy-spin en düşük latency hedefleyebilir fakat yüksek CPU tüketir; sleeping daha az CPU kullanırken daha yüksek latency yaratabilir.
Çalışmanın benchmarklarında kullanılan wait strategy yield wait'tir. Busy-spin, sleeping veya diğer stratejilerle sistematik karşılaştırma yapılmamıştır. Bu nedenle Disruptor latency değerleri tüm olası yapılandırmalar için genel sonuç değildir.
Çalışmanın Yöntemi ve Bulguları
Birinci deney katmanı: Low-Latency Programming Repository
Yazarlar optimizasyonları compile-time features, optimisation techniques, data handling, concurrency ve system programming başlıkları altında toplamıştır. Google Benchmark temel zamanlama aracı; Linux perf ise özellikle cache-reference ve cache-miss analizi için kullanılmıştır.
| Teknik | Kaynakta raporlanan yaklaşık iyileşme | Ana mekanizma |
|---|---|---|
| Cache warming | %90 | Veri/komutu önceden cache'e taşıma |
| Constexpr | %90,88 | Hesabı runtime'dan compile-time'a taşıma |
| Loop unrolling | %72,24 | Döngü kontrol yükünü azaltma |
| Atomic / lock-free sayaç | %63 | Mutex ve context-switch maliyetini azaltma |
| Float/double karıştırmama | Kaynak ifadesiyle %52 | Implicit conversionları kaldırma |
| Short-circuiting | Yaklaşık %50 | Gereksiz Boolean hesaplarını çalıştırmama |
| SIMD array addition | Yaklaşık %49 | Bir komutla birden fazla veri elemanı işleme |
| Branch reduction | %36 | Hot path içindeki branch sayısını azaltma |
| Compile-time dispatch | Yaklaşık %26 | Runtime dispatch kararını kaldırma |
| Prefetching | %23,5 | Veriyi kullanılmadan önce cache'e isteme |
| Inlining | %20,5 | Fonksiyon çağrı yükünü azaltma |
| Signed vs unsigned örneği | %12,15 | Özel benchmarkta daha az assembly talimatı |
| Slowpath removal | %12 | Nadir kodu instruction hot path'ten ayırma |
Bu tablo bir “hangisi en iyi optimizasyon?” sıralaması olarak yorumlanmamalıdır. Her satır farklı işlem, veri büyüklüğü, compiler davranışı ve benchmark yapısına sahiptir. Örneğin 90% cache-warming sonucu büyük bir memory-access benchmarkından, 90,88% constexpr sonucu ise faktöriyel 10 örneğinden gelmektedir.
İkinci deney katmanı: pairs trading
Çalışma optimizasyonları daha gerçekçi bir uygulamada görmek için Goldman Sachs Group Inc. (GS) ve Morgan Stanley (MS) hisselerinin beş yıllık günlük adjusted-close verileri üzerinde bir statistical-arbitrage pairs-trading backtesti kullanmıştır.
Cointegration Pairs Trading Stratejisinde Ne Anlama Gelir?
Cointegration, tek tek non-stationary olan iki zaman serisinin belirli bir doğrusal kombinasyonunun stationary olması durumudur. Bu çalışmada GS ve MS adjusted-close serilerinin Engle–Granger iki aşamalı yöntemiyle test edilmesi, fiyat serileri arasında incelenen beş yıllık dönemde uzun dönemli bir denge ilişkisi bulunduğuna dair istatistiksel kanıt üretmek için kullanılmıştır.
Kaynağın kavramsal gösteriminde iki seri:
şeklinde ele alınır. Eğer:
kombinasyonu stationary ise \(Y_t\) ve \(X_t\) cointegrated olarak değerlendirilir. Buradaki \(\gamma\), iki seri arasındaki uzun dönemli doğrusal ilişkiyi temsil eder.
GS–MS için Engle–Granger testinde kaynak p≈0,0149 ve t≈−3,7684 raporlamaktadır. \(0,05\) significance düzeyinde no-cointegration null hipotezi reddedilmiştir. Bu sonuç cointegration için istatistiksel kanıt sağlar; ilişkinin gelecekte değişmeyeceğini veya trading stratejisinin garantili kârlı olacağını kanıtlamaz.
Z-score ile sinyal üretimi
Algoritma spread'in rolling mean ve standard deviation değerlerini kullanarak mevcut spread'i standardize eder:
Burada \(Z\) z-score, \(X\) mevcut spread, \(\mu\) rolling spread ortalaması ve \(\sigma\) rolling spread standard deviation değeridir.
Kaynak stratejide:
- \(Z>1.0\): GS relatif olarak pahalı kabul edilir; GS short, MS long sinyali oluşturulur.
- \(Z<-1.0\): GS relatif olarak ucuz kabul edilir; GS long, MS short sinyali oluşturulur.
- \(|Z|<0.8\): spread'in ortalamaya döndüğü varsayımıyla açık pozisyon kapatılır.
- Diğer bölgelerde yeni işlem sinyali oluşturulmaz.
Backtest finansal sonucu
Kaynak backtestinde portföy 1.000.000 ABD doları ile başlamakta ve 1.328.581 ABD doları ile sona ermektedir. Raporlanan Sharpe ratio 1,09'dur.
\(R_p\) portföy getirisi, \(R_f\) risksiz getiri ve \(\sigma_p\) portföy excess-return standard deviation değeridir.
Çalışmanın kendi ifadesiyle trading algoritmasının finansal başarısının kapsamlı değerlendirilmesi araştırmanın ana amacı değildir. Bu sonuç geçmiş veri backtestine aittir ve transaction cost, gerçek execution quality, order-book dynamics, slippage, network delay ve canlı piyasa anomalilerinin tamamını temsil etmez.
Pairs-trading algoritmasındaki CPU optimizasyonları
Algoritmanın rolling spread mean ve standard-deviation hesabında AVX2 kullanılmıştır. 256-bit __m256d register içinde dört double aynı anda işlenerek spread toplamı ve kareler toplamı paralel hesaplanmıştır. Bu düzen aynı zamanda dört elemanlık adımlarla loop unrolling gerçekleştirmektedir.
Kaynağın bu uygulama için belirttiği önemli sınır, window size'ın dördün katı olması gerekliliğidir. Bu, kullanılan AVX2 tasarımından kaynaklanır.
İkinci önemli değişiklik dynamic container yerine sabit boyutlu array ve rolling index kullanılmasıdır. Yeni spread geldiğinde en eski eleman aynı array içindeki konumda değiştirilir; böylece tekrarlanan dynamic memory allocation ihtiyacı azaltılır.
Mean ve standard-deviation hesaplama fonksiyonlarına inlining de uygulanmıştır.
| Yapı | Latency | Kaynakta raporlanan iyileşme |
|---|---|---|
| Inlining | 406.709 ns | %21,41 |
| SIMD + loop unrolling | 355.618 ns | %31,28 |
| Fixed array | 266.146 ns | %48,58 |
| Combined | 65.580 ns | %87,33 |
Daha sonraki 10-koşuluk evaluation bölümünde kaynak optimize edilmemiş algoritma için ortalama 517.559 ns ve standard deviation 4.233 ns; optimize algoritma için ortalama 65.588 ns ve standard deviation 400 ns vermektedir. Buna göre raporlanan latency azalması %87,38'dir.
Önceki yöntem bölümünde baseline için 519.772 ns ifadesi de bulunmaktadır. Kaynak iki baseline sayısı arasındaki küçük farkı açıkça açıklamadığından değerler tek sayıya zorla birleştirilmemiştir.
Instruction sayısı ve cache-miss davranışı
| Teknik | Instruction | Cache misses / cache references |
|---|---|---|
| Optimizasyonsuz | 6,01 milyar | %16,001 |
| Combined | 3,27 milyar | %33,879 |
| Fixed array | 8,27 milyar | %19,089 |
| Inlining | 9,07 milyar | %19,151 |
| SIMD + loop unrolling | 8,35 milyar | %16,829 |
Bu tablo önemli bir sonucu görünür kılar: daha düşük cache-miss yüzdesi veya daha az instruction sayısı tek başına daha hızlı program anlamına gelmez. Combined sürüm en yüksek cache-miss yüzdesine sahip olmasına rağmen en düşük latency'yi üretmiştir. CPU performansı instruction-level parallelism, memory layout, branch behavior, compiler optimizasyonları ve veri erişim düzeninin birlikte oluşturduğu sonuçtur.
İstatistiksel test
Pairs-trading benchmarklarında her yapı 10 kez çalıştırılmış ve optimize edilmiş/edilmemiş latency ölçümlerine paired t-test uygulanmıştır. Kaynak çok büyük t-istatistikleri ve çok küçük p-değerleri raporlamakta ve ölçülen latency farkının yalnız rastlantısal varyasyonla açıklanmasının düşük olasılıklı olduğunu belirtmektedir.
Bununla birlikte kaynak yalnız 10 veri noktası kullanılmasının bir sınırlılık olduğunu açıkça kabul etmekte ve daha fazla ölçümün doğruluğu artıracağını belirtmektedir.
Kârlılık yorumu hangi sınırda kalmalıdır?
Kaynak daha düşük latency'nin kısa ömürlü piyasa fırsatlarına daha erken tepki verebilme potansiyeli nedeniyle finansal açıdan yararlı olabileceğini literatürle ilişkilendirmektedir. Ayrıca başka bir çalışmada bildirilen latency ile olumsuz order-book değişimine maruz kalma ilişkisini kullanarak %87,32 hız artışını yaklaşık %78,59 daha düşük exposure ile eşleştiren bir hesaplama yapmaktadır.
Bu %78,59 değeri çalışmanın canlı piyasada doğrudan ölçtüğü bir sonuç değildir. Başka bir çalışmadaki regresyon ilişkisi ile bu çalışmanın backtest latency kazancının lineer biçimde birleştirildiği kaynak-türevli bir projeksiyondur. Gerçek bir HFT sisteminde aynı exposure azalmasının oluştuğu gösterilmemiştir.
Üçüncü deney katmanı: C++ Disruptor
C++ Disruptor implementasyonu producer, ring buffer, sequencer, event processor, sequence barrier, event ve wait strategy bileşenlerinden oluşturulmuştur. HFT bağlamında event bir order nesnesi olabilir; kaynak benchmarkında basit string event kullanılmıştır.
Karşılaştırma modeli iki thread'den oluşur. Disruptor sürümünde producer veriyi ring buffer'a yayımlar ve consumer ayrı thread'de sequence numaralarına göre işler. Simple Queue sürümünde ise std::queue<std::string>, std::mutex ve std::condition_variable kullanılır.
| Event | Simple Queue | Disruptor | Kaynakta raporlanan hızlanma |
|---|---|---|---|
| 10 | 20.646 ns | 18.182 ns | %11,9 |
| 100 | 99.458 ns | 64.686 ns | %35,0 |
| 1.000 | 881.092 ns | 451.251 ns | %48,8 |
| 10.000 | 9.735.102 ns | 4.361.096 ns | %55,2 |
| 100.000 | 90.088.609 ns | 52.562.872 ns | %41,7 |
| 1.000.000 | 884.871.405 ns | 543.171.556 ns | %38,7 |
Kaynak, event sayısı büyüdükçe iki yapı arasındaki mutlak zaman farkının arttığını belirtmektedir. 10 event'te ortalama fark 2.464 ns, 1.000.000 event'te 341.699.849 ns olarak raporlanmıştır.
Disruptor'un cache davranışı
10 ve 100 event gibi küçük iş yüklerinde Disruptor'un cache-miss oranı Simple Queue'dan hafif yüksek bulunmuştur. 1.000–1.000.000 event aralığında ise ilişki tersine dönmüş ve Disruptor daha düşük cache-miss oranları göstermiştir. Bu durum ring buffer'ın büyük event akışlarında daha verimli memory-access davranışı sağlayabildiğine işaret etmektedir.
10-event testinde Disruptor yaklaşık 586.000 daha az instruction çalıştırmıştır. Kaynak bunu lock contention'ın azaltılması, önceden ayrılmış ring-buffer belleği ve daha öngörülebilir producer–consumer iletişimi ile ilişkilendirmektedir.
Disruptor'un İstatistiksel Performans Testi Ne Gösteriyor?
Kaynağın ayrı 20-koşuluk ve 1.000-event testinde Simple Queue için ortalama latency 931.255 ns, standard deviation 453.766 ns; Disruptor için ortalama latency 74.908 ns ve standard deviation 53.600 ns olarak ölçülmüştür. T-test sonucu \(t=22.596\) ve \(p=1.243\times10^{-23}\) olarak raporlandığından bu deney kümesi içinde iki yapının ölçülen ortalama latency farkı istatistiksel olarak güçlüdür.
Bu sonuç Tablo 4'teki 1.000-event değerlerinden farklı mutlak süreler içermektedir. Kaynak bunları farklı benchmark değerlendirmeleri olarak vermekte fakat farkın yapılandırma veya ölçüm kaynağını ayrıntılı biçimde açıklamamaktadır. Bu nedenle 451.251 ns ile 74.908 ns tek bir “doğru” Disruptor latency değerine indirgenmemelidir.
Disruptor değerlendirmesinin sınırları
Benchmark ağırlıklı olarak inter-thread communication hızına odaklanmıştır. Memory consumption ve CPU load kapsamlı biçimde karşılaştırılmamıştır. Ayrıca yalnız yield wait strategy kullanılmış; busy-spin, sleep ve diğer wait strategy'ler sistematik olarak test edilmemiştir. Bu nedenle ölçülen sonuçlar Disruptor'un tüm konfigürasyonlarını temsil etmez.
Low-Latency Repository kullanıcı değerlendirmesi
Repository dört üniversiteden toplam 17 katılımcı tarafından incelenmiştir: Imperial College London, University College London, King's College London ve University of Oxford. Katılımcıların 11'i bilgisayar bilimi; altısı matematik, fizik veya mühendislik alanlarındadır.
| Kategori | Ortalama | En düşük | En yüksek |
|---|---|---|---|
| Comprehensiveness | 8,3 | 6,5 | 9,1 |
| Clarity | 8,7 | 7,8 | 8,9 |
Bu değerlendirme yazılım performans kanıtı değil, repository'nin eğitimsel kullanılabilirliğine ilişkin küçük bir kullanıcı örneklemidir.
Çalışmanın desteklediği bulgular
Kaynak, incelenen benchmark ortamlarında C++ seviyesindeki veri yerleşimi, cache kullanımı, compile-time hesaplama, branch azaltma, SIMD, atomics ve allocation stratejilerinin latency üzerinde ölçülebilir etkiler yaratabileceğini göstermektedir. Birden fazla optimizasyonun birlikte kullanıldığı pairs-trading benchmarkı, tek tek optimizasyonlardan daha büyük toplam latency azalması üretmiştir. C++ Disruptor implementasyonu ise test edilen producer–consumer iş yüklerinde mutex/condition-variable kuyruğundan daha hızlı ölçülmüştür.
Çalışmanın desteklemediği genellemeler
Çalışma, benchmarktaki yüzde kazanımların başka CPU, compiler, işletim sistemi veya veri yapısında aynen tekrarlanacağını göstermemektedir. Cache warming'in her iş yükünde %90, constexpr'in her hesaplamada %90 veya SIMD'in her algoritmada %49 hız sağlayacağı sonucu çıkarılamaz. Benzer biçimde backtest latency azalması canlı trading kârlılığına doğrudan eşitlenemez ve Disruptor benchmarkı tam bir gerçek OMS'nin uçtan uca latency'sini ölçmez.
Gelecek çalışma önerileri
Kaynak üç ana yön önermektedir. Birincisi repository'nin variadic templates, kernel bypass ve networking optimizasyonları gibi yeni tekniklerle genişletilmesidir. İkincisi pairs-trading algoritmasının canlı market-data feed üzerinde sınanmasıdır. Üçüncüsü ise Disruptor ile trading algoritmasının birleştirilerek order nesnelerinin ring buffer üzerinden aktarıldığı daha kapsamlı bir trading-system benchmarkının oluşturulmasıdır.
Kaynak ve Yöntem Notu
Tam özgün başlık: C++ design patterns for low-latency applications including high-frequency trading
Yazarlar: Paul Bilokon; Burak Gunduz.
Afiliyasyonlar: Paul Bilokon — Departments of Computing and Mathematics, Imperial College London; Burak Gunduz — Department of Computing, Imperial College London.
Kaynak türü: Preprint.
Manuscript üzerinde yazan tarih: 11 Eylül 2023.
arXiv ilk sürüm tarihi: 8 Eylül 2023.
arXiv: 2309.04259v1 [cs.PF].
DOI: 10.48550/arXiv.2309.04259.
Platform: arXiv / CoRR.
Hakemlik durumu: Doğrulanan bibliyografik kayıtlarda çalışma preprint / informal publication olarak görünmektedir; hakemli dergi sürümü doğrulanmamıştır.
Yazılım artefaktı: Kaynak, Low-Latency Programming Repository, pairs-trading kodu ve Disruptor implementasyonunu 0burak/imperial_hft deposunda sunduğunu belirtmektedir.
Lisans: Yüklenen PDF içinde açık bir içerik lisansı tespit edilmediğinden belirli bir Creative Commons veya benzeri lisans atanmamıştır.
Finansman: Yüklenen preprintte ayrı bir finansman bildirimi tespit edilmemiştir.
Çıkar çatışması: Yüklenen preprintte ayrı bir çıkar çatışması bildirimi tespit edilmemiştir.
CRediT / yazar katkıları: Ayrı bir CRediT bildirimi raporlanmamıştır.
Temel yöntem araçları: Google Benchmark ile zaman ölçümü; Linux perf ile cache davranışı; C++ düşük gecikme mikrobenchmarkları; GS–MS adjusted-close verileriyle Engle–Granger cointegration testi ve pairs-trading backtesti; AVX2/SIMD optimizasyonu; C++ ring-buffer/Disruptor karşılaştırması; paired t-test.
Temel sınırlılıklar: Benchmarkların önemli bölümü CPU ve yazılım seviyesindedir. Tam üretim HFT ağı, co-location, exchange order flow, hardware timestamping ve canlı market-data koşulları birlikte ölçülmemiştir. Pairs-trading algoritması geçmiş veri backtestidir. AVX2 optimizasyonu destekleyen donanıma ve çalışmadaki implementasyonda dördün katı window size'a ihtiyaç duymaktadır. Disruptor deneyinde memory consumption ve CPU load kapsamlı biçimde değerlendirilmemiş; alternatif wait strategy'ler karşılaştırılmamıştır.
Kaynak-içi sayı bütünlüğü notu: Pairs-trading baseline süresi yöntem bölümünde 519.772 ns, sonraki evaluation bölümünde 517.559,10 ns olarak geçmektedir. Ayrıca 1.000-event Disruptor değerleri Tablo 4 ve sonraki 20-koşuluk istatistiksel test arasında farklıdır. Verianla bu değerlerden birini sessizce düzeltmemiş veya diğerinin yerine koymamıştır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir