

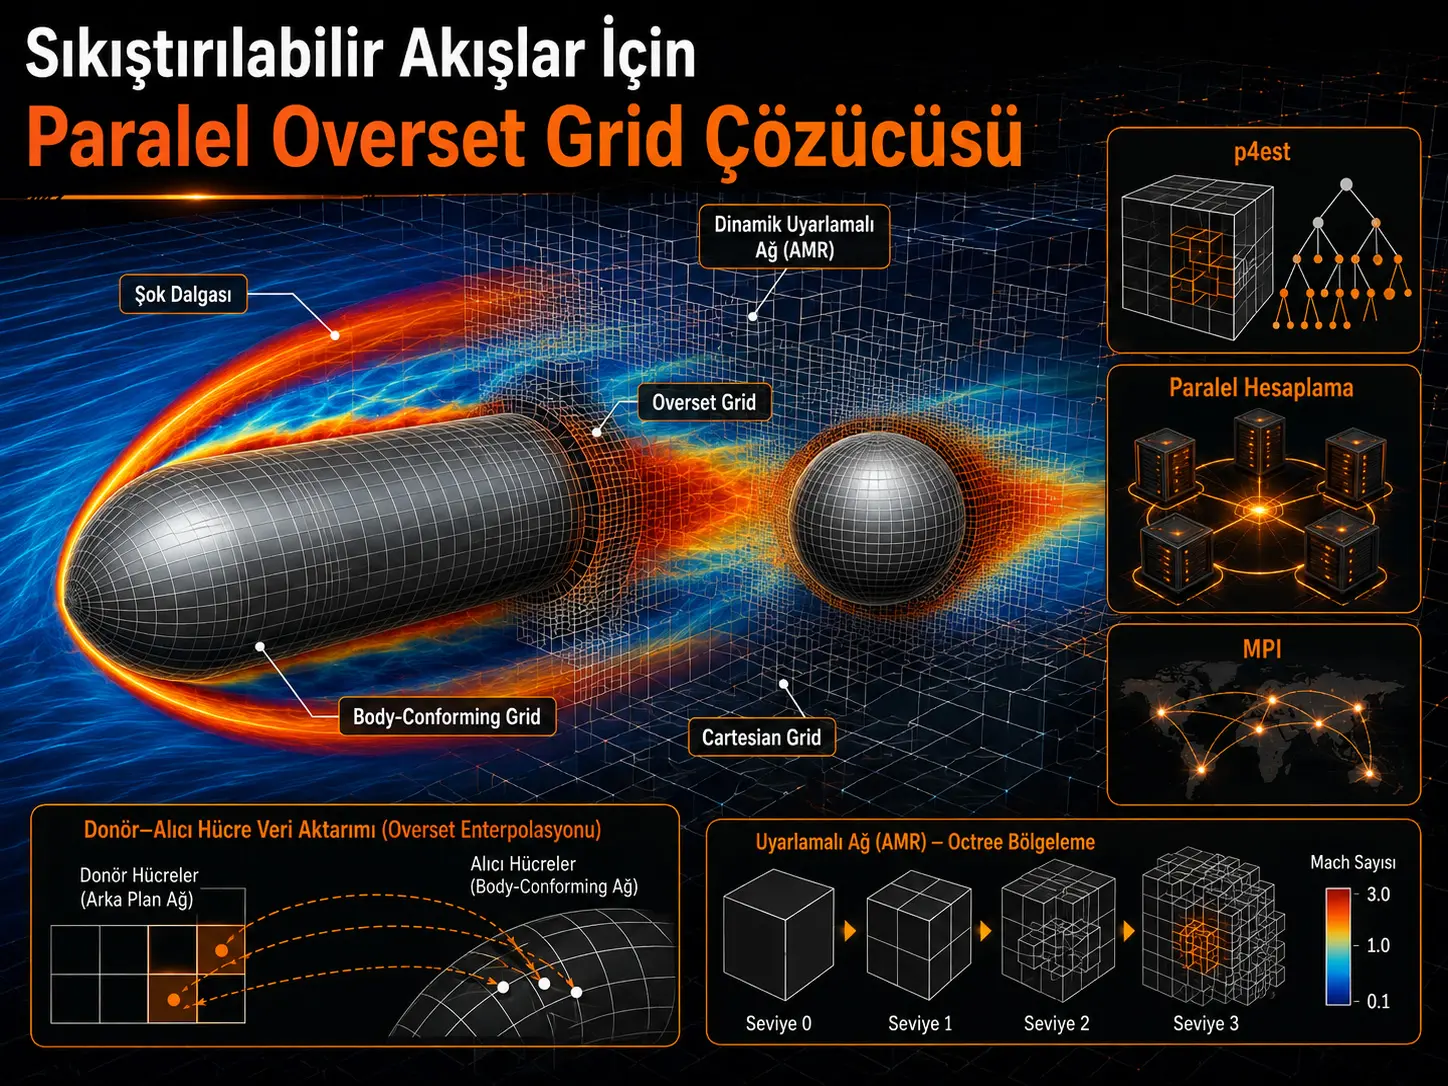
Ин таҳқиқот барои ҳал кардани масъалаҳои ҷараёни сеандозаи фишурдашаванда ҳалкунандаи Navier–Stokes-ро таҳия мекунад, ки параллелӣ кор карда, ба finite-volume асос ёфтааст ва қобилияти динамикии Adaptive Mesh Refinement (AMR) дорад. Усул ду сохтори гуногуни шабакаро ба ҳам меорад: body-conforming grid, ки сатҳи геометрияро пайгирӣ мекунад, ва Cartesian off-body grid, ки дар қисми боқимондаи майдони ҷараён метавонад ба таври динамикӣ майдатар ё дағалтар карда шавад. Ташкили шабакаи адаптивии Cartesian, амалҳои partition ва тавозуни бор бо китобхонаи кушодасарчашмаи p4est octree иҷро карда мешавад.
Навоварии асосии нармафзор дар таҳқиқот ҷудо кардани маълумоти майдони ҷараён аз майдони маълумоти node-и худи p4est мебошад. Дар сохтори классикӣ зичӣ, суръат, ҳарорат, тағйирёбандаҳои турбулентӣ, градиентҳо ва маълумоти MUSCL limiter ҳамроҳи node-ҳои p4est интиқол меёбанд, аммо дар архитектураи пешниҳодшуда дар дохили p4est танҳо нишондиҳандаи суроға ва маълумоти MPI rank нигоҳ дошта мешавад. Майдони воқеии ҷараён дар сохтори алоҳидаи маълумот нигоҳ дошта мешавад. Ҳамин тавр, вақте шабака аз нав тақсим мешавад, интиқоли ҳамаи маълумоте, ки метавонанд аз нав ҳисоб карда шаванд ё дигар эътибори худро гум кардаанд, тавассути MPI лозим намешавад; интиқоли танҳо тағйирёбандаҳои асосии ҷараён кофӣ мегардад.
Ҳалкунандаи таҳияшуда дар ду масъалаи сеандозаи benchmark санҷида шудааст. Дар ҳолати устуворе, ки ҷараёни суръаташ Mach 2 аз болои силиндри нимабадии бинӣ-кунд мегузарад, коэффитсиенти ададии фишори сатҳӣ дар маҷмӯъ бо натиҷаҳои таҷрибавӣ мувофиқат нишон додааст ва шабакаи адаптивӣ дар минтақаи bow shock ба таври худкор зич шудааст. Дар санҷиши дуюм ҳамтаъсирии мавҷи зарбаи ҳамвор бо Mach 2,89 бо кураи дар ҳавои сокин буда моделсозӣ шудааст; зарбаи инъикосшуда, triple point, зарбаи дифраксияшуда ва wake vortex бо мутобиқсозии динамикии шабака пайгирӣ карда шудаанд.
Дар таҷрибаи иҷрои параллелӣ ҳалли устувори overset дар 32 MPI rank самаранокии параллелии %89,7, дар 64 rank %80 ва дар 128 rank %65 нишон додааст. Дар масъалаи динамикии кура–шок, вақте flow solver ва AMR якҷоя арзёбӣ шуданд, самаранокии параллелӣ дар 128 MPI rank ҳамчун %61 гузориш шудааст. Равиши тақсимшудаи пешниҳодшуда нисбат ба татбиқи пешинаи master–slave дар 32 MPI rank дар самаранокии умумии параллелии ҳалкунанда %50 афзоиш фароҳам овардааст. Бо вуҷуди ин, ҳангоми расидан ба 128 rank, махсусан аз сабаби тақсимоти нобаробари шумораи ками ҳуҷайраҳои donor–receiver байни rank-ҳо, дар марҳилаҳои interpolation ва overset grid assembly самаранокӣ паст мешавад.
Аз нигоҳи Türkiye: Таҳқиқот мустақиман ба ҳалкунандаи CFD асос меёбад, ки дар İstanbul Teknik Üniversitesi таҳия шудааст. Аз ин рӯ, аз нигоҳи Türkiye ин танҳо татбиқи як усули хориҷӣ нест, балки намунаи мушаххаси таҳияи усули ададӣ барои якҷо кардани ҷараёни сеандозаи фишурдашаванда, AMR-и динамикӣ, overset grid ва ҷузъҳои ҳисоббарории параллелии MPI дар ҳамон ҳалкунандаи дохилимуассисавӣ мебошад. Бо вуҷуди ин, мақола санҷишро танҳо дар ду benchmark ва як гиреҳи HPC пешниҳод мекунад; геометрияҳои воқеии ҳавопаймо, миқёспазирии суперкомпютерии бисёргиреҳӣ ё тасдиқи саноатӣ дар ин таҳқиқот санҷида нашудаанд.
Чаро overset grid ва Adaptive Mesh Refinement якҷоя истифода мешаванд?
Ҳадафи асосӣ ин аст, ки ба ҷойи ҳал кардани тамоми домени ҳисоббарорӣ бо шабакаи ҳамеша хеле майда, ҳалли баланд танҳо дар минтақаҳое истифода шавад, ки аз ҷиҳати физикӣ заруранд. Дар минтақаҳое чун мавҷҳои зарба, градиентҳои қавӣ ва минтақаҳои ҷудошавӣ андозаи ҳуҷайра хурд карда мешавад, дар ҳоле ки дар майдонҳои дур шабакаи дағалтар метавонад истифода шавад. Ҳамин тавр ҳал кардани ҳамон падидаи физикӣ бо шумораи умумии камтари ҳуҷайраҳо имконпазир мегардад.
Равиши overset ин мутобиқсозиро аз геометрия ҷудо мекунад. Дар ҳоле ки body-conforming grid сатҳи геометрия ва қабати сарҳадиро ҳал мекунад, ҷараёни дур аз геометрия дар off-body Cartesian grid ҳисоб карда мешавад. Ду шабака болои ҳам гузошта мешаванд ва барои ҳуҷайраҳои receiver дар минтақаҳои буриш аз ҳуҷайраҳои donor дар шабакаи дигар интерполятсия анҷом дода мешавад.
Ин сохтор махсусан дар масъалаҳое бартарӣ дорад, ки сохторҳои сеандозаи ҳаракаткунанда ё шокҳои қавӣ доранд; зеро амалҳои refine/coarsen дар Cartesian off-body grid маҷбур нестанд геометрияи мураккаби сатҳро мустақиман аз нав тавлид кунанд.
Кадом муодилаҳои ҷараён ҳал карда мешаванд?
Ҳар ду benchmark бо муодилаҳои сеандозаи фишурдашавандаи Navier–Stokes моделсозӣ шудаанд. Азбаски масъалаи ҷисми бинӣ-кунди устувор турбулентӣ аст, формулятсияи Reynolds-Averaged Navier–Stokes (RANS) истифода мешавад, дар ҳоле ки масъалаи гузарои кура–шок формулятсияи ламинариро истифода мебарад.
Ҳифзи масса:
\[ \frac{\partial \rho}{\partial t} + \frac{\partial \rho u_j}{\partial x_j} =0 \]
Ҳифзи импулс:
\[ \frac{\partial \rho u_i}{\partial t} + \frac{\partial \rho u_i u_j}{\partial x_j} = -\frac{\partial p}{\partial x_i} + \frac{\partial \tau_{ij}}{\partial x_j} \]
Ҳифзи энергияи умумӣ:
\[ \frac{\partial \rho e_t}{\partial t} + \frac{\partial \rho e_t u_j}{\partial x_j} = -\frac{\partial p u_j}{\partial x_j} + \frac{\partial}{\partial x_j} \left( k\frac{\partial T}{\partial x_j} \right) + \frac{\partial u_i\tau_{ij}}{\partial x_j} \]
Дар benchmark-и устувор барои моделсозии шиддатҳои Reynolds модели турбулентии k–ω SST 2003 истифода шудааст. Газ аз ҷиҳати калорӣ комил қабул шудааст. Дар ҳолати устувор тағйири часпакӣ бо ҳарорат бо қонуни Sutherland моделсозӣ шудааст, дар ҳоле ки дар benchmark-и гузаро часпакии динамикӣ ҳамчун собити мустақил аз ҳарорат гирифта шудааст.
Ҷараёнҳои ададӣ чӣ гуна ҳисоб мешаванд?
Муодилаҳо бо усули finite-volume дискретизатсия шудаанд. Муодилаи нимадискретии як ҳуҷайра дар манбаъ дар шакли умумии зерин дода шудааст:
\[ \frac{\partial W_i}{\partial t} = \frac{1}{V_i} \sum_{j=1}^{J} \left(F_{v,ij}-F_{c,ij}\right)S_{ij} + Q_i \]
Дар ҷараёнҳои конвективӣ схемаи AUSM+up истифода шуда, барои дақиқии фазоии дараҷаи дуюм реконструксияи MUSCL татбиқ шудааст. Барои фурӯ нишондани лаппишҳо дар наздикии нопайвастагиҳо, ба мисли шок, Venkatakrishnan slope limiter истифода шудааст. Diffusive flux-ҳо бо равиши фарқи марказии дараҷаи дуюм ҳисоб шуда, интегратсияи вақт бо усули explicit Euler-и дараҷаи якум анҷом дода шудааст.
Дар ҳалли устувор қадами вақт барои ҳар ҳуҷайра тибқи адади собити Courant ба таври маҳаллӣ муайян мешавад, дар масъалаҳои transient бошад қадами вақт барои ҳамаи ҳуҷайраҳо ҳамчун арзиши ҳадди ақале интихоб шудааст, ки аз шарти Courant ба даст меояд.
Шабакаҳои off-body ва body-conforming чӣ гуна якҷо мешаванд?
Off-body Cartesian grid аз блокҳое иборат аст, ки дар сатҳҳои гуногуни refinement шумораи собити ҳуҷайраҳоро доранд. Фарқи максималӣ байни сатҳҳои refinement-и ду блоки ҳамсояи grid ҳамчун 1 нигоҳ дошта мешавад; ба ибораи дигар, шарти 2:1 balance ҳифз мегардад.
Дар сатҳи муштараки ҳуҷайраҳои Cartesian бо сатҳҳои гуногуни refinement ба ҷойи overset interpolation-и классикӣ равиши hanging-cell истифода мешавад. Ҷараёни сатҳии як ҳуҷайраи дағал бо ҷамъи ҷараёнҳои ҳуҷайраҳои майдаи ҳамсоя ҳисоб мешавад:
\[ F_i=\sum_{j=1}^{4}F_j \]
Дар минтақае, ки шабакаҳои body-conforming ва Cartesian ҳамдигарро мепӯшонанд, муносибати donor–receiver истифода мешавад. Як хусусияти ҷараён дар ҳуҷайраи receiver бо интерполятсияи inverse-distance:
\[ \phi_i= \frac{\sum_{j=1}^{J}w_j\phi_j} {\sum_{j=1}^{J}w_j} \]
ва вазн:
\[ w_j= \frac{1} {|x_{c,j}-x_{c,i}|} \]
ҳисоб карда мешавад.
p4est дар ин система чӣ кор мекунад?
p4est китобхонаи кушодасарчашмаест, ки маҷмӯаҳои octree, яъне сохтори “forest of octrees”-ро ба таври параллелӣ идора мекунад. Дар таҳқиқот ҳар як octree node аз ҷиҳати физикӣ ба як блоки Cartesian grid мувофиқат мекунад. Node-ҳо дар тӯли Morton ё Z-order space-filling curve мураттаб карда мешаванд.
Ин сохтор ба p4est имкон медиҳад, ки:
- grid refinement ва coarsening,
- 2:1 balance,
- partitioning,
- ташкили ghost-layer,
- тақсим кардани блокҳои grid байни MPI rank-ҳо
-ро иҷро кунад.
Истифодаи p4est дар таҳқиқот комилан ба CPU ва MPI асос ёфтааст. GPU ё device offloading ба accelerator-и дигар татбиқ нашудааст.
Мушкили архитектураи хотираи пешина чӣ буд?
Дар модели классикии маълумоти корбарии p4est барои ҳар node як блоки маълумот бо андозае, ки корбар муайян мекунад, аз ҷониби p4est allocate ва идора карда мешавад. Дар ҳалкунандаи CFD ин блок танҳо чанд адад, мисли зичӣ ё суръатро дар бар намегирад; он бояд маълумоти ҷараёни тамоми блоки grid-ро бардорад.
Манбаъ се гурӯҳи маълумотро ҷудо мекунад:
- Gp: хусусиятҳои асосии ҷараён \([\rho,u,v,w,T,k,\omega]\),
- Gs: хусусиятҳои дуюмдараҷа, ба монанди часпакӣ, фишор ва градиентҳои ҷараён,
- Gl: истилоҳҳои MUSCL limiter.
Дар сохтори классикӣ ҳамаи ин гурӯҳҳои маълумот бояд ҳамроҳи p4est node нигоҳ дошта ва дар вақти partition интиқол дода шаванд. Аммо қисми муҳими Gs метавонад аз Gp аз нав ҳисоб карда шавад; илова бар ин, градиентҳо ва арзишҳои limiter дар марҳилаи grid migration ба итератсияи пешина тааллуқ доранд ва дар итератсияи нав ба ҳар ҳол аз нав тавлид мешаванд.
Сохтори пешниҳодшудаи маълумоти ҷудошуда чӣ гуна кор мекунад?
Таҳқиқотчиён маълумоти ҷараёнро аз майдони allocation-и p4est берун карда, дар сохтори алоҳидаи маълумоти q нигоҳ медоранд. Дар майдони корбарии p4est node бошад танҳо:
- pointer, ки суроғаи маълумоти ҷараёнро дар хотира нишон медиҳад,
- MPI rank, ки node ба он тааллуқ дорад
нигоҳ дошта мешавад.
Ин тағйири хурд ду мушкили муҳимро ҳал мекунад.
Пешгирии аз даст рафтани маълумот ҳангоми coarsen–balance
Дар ҷараёни классикии p4est, вақте як гурӯҳи node-ҳо coarsen карда мешаванд, хусусиятҳои ҷараёни ҳуҷайраҳои child дар ҳуҷайраи parent бо миёнаи ҳаҷмвазн якҷо карда мешаванд:
\[ \phi_i= \sum_{j=1}^{J} \left( \frac{\phi_j V_j}{V_i} \right) \]
Аммо агар parent node-и пайдошуда шарти 2:1 balance-ро вайрон кунад, даъвати баъдии p4est_balance метавонад ин node-ро дубора refine кунад. Дар ин ҳолат маълумоте, ки аввал аз child-ҳо ба parent миёна карда шуда буд, баъдан дубора ба child-ҳо тақсим мешавад ва иттилооти аслии баландҳаллият аз даст меравад.
Дар сохтори пешниҳодшуда, азбаски майдони ҷараён аз node allocation-и p4est ҷудост, маълумоти воқеии child-ҳо ҳангоми амали coarsen фавран нест карда намешавад. Агар амали balance coarsen-ро баргардонад, маълумоти кӯҳна ба child node-ҳои аз нав сохташуда пайваст мешавад. Танҳо агар натиҷаи coarsen воқеан доимӣ шавад, маълумоти child-и ниқобшуда озод карда мешавад.
Коҳиши трафики нолозими MPI ҳангоми Load balancing
Вақте p4est_partition блокҳои шабакаро байни MPI rank-ҳо аз нав тақсим мекунад, равиши классикӣ ҳамаи маълумоти корбарии node-ро интиқол медиҳад. Таҳқиқотчиён бошад таъмин мекунанд, ки танҳо гурӯҳи Gp ба MPI rank-и нав фиристода шавад. Gs ва Gl дар даври нави ҳалли масъала дубора сохта мешаванд.
Ҳамин тавр, гарчанде марҳилаи partition ба ду қадами иртиботӣ ҷудо шавад, ҳаҷми умумии маълумоти интиқолшаванда кам карда мешавад. Иддаои таҳқиқот он аст, ки ин равиш вақти иртибот ва умумии solver runtime-ро коҳиш медиҳад.
Вақте шабакаи динамикӣ тағйир меёбад, чаро пайвастҳои overset аз нав сохта мешаванд?
Вақте Cartesian grid refine ё coarsen мешавад, ҷуфтҳои мавҷудаи ҳуҷайраҳои donor–receiver метавонанд эътибори худро аз даст диҳанд. Пас аз Load balancing соҳибияти MPI rank-и блокҳои grid низ тағйир меёбад. Аз ин рӯ, пас аз ҳар даъвати AMR бояд overset grid assembly дубора анҷом дода шавад.
Дар равиши пешинаи master–slave геометрияҳои receiver ба як MPI rank-и марказӣ фиристода мешуданд, master rank ҳамаи маълумоти body-conforming grid-ро нигоҳ медошт ва ҷустуҷӯи donor-ро дар як нуқта анҷом медод. Ин ҳам истеъмоли хотираро зиёд мекард ва ҳам ҳангоми афзоиши шумораи MPI rank тангнои марказӣ эҷод менамуд.
Дар усули нав grid assembly пурра тақсимшуда карда мешавад.
Равиши bounding box иртиботро чӣ гуна маҳдуд мекунад?
Ҳар як partition-и Cartesian ва body-conforming grid бо bounding box ифода мешавад, ки координатаҳои минималӣ ва максималиро дар бар мегирад. Bounding box-ҳои ҳуҷайраҳои receiver ба MPI rank-ҳо эълон карда мешаванд ва маълумоти муфассали геометрия танҳо байни partition-ҳои буришкунанда мубодила мешавад.
Буриши ду partition дар як самти муайяни координата:
\[ x_{A,max}\geq x_{B,min} \quad\land\quad x_{A,min}\leq x_{B,max} \]
бо ин шарт санҷида мешавад.
Ҳамин тавр як rank маҷбур нест ҳамаи ҳуҷайраҳои grid-и худро ба ҳамаи rank-ҳои дигар фиристад.
Ҷустуҷӯи donor дар body-conforming grid чӣ гуна тезонида мешавад?
Барои body-conforming grid Alternating Digital Tree (ADT) сохта мешавад. Ҳар ҳуҷайра ҳамчун tree node ифода шуда, тибқи координатаҳои bounding box ба сохтори binary tree ҷойгир карда мешавад.
Ҳангоми ҷустуҷӯи donor барои ҳуҷайраи receiver кор аз решаи дарахт оғоз мешавад. Агар bounding box-ҳо буриш надошта бошанд, бо ёрии муқоисаи координата як шохаи дарахт пурра хориҷ карда мешавад. Агар буриш бошад, ҳуҷайра ба рӯйхати donor-и номзад илова мешавад ва ҷустуҷӯ дар шохаҳои поёнӣ идома меёбад. Дар натиҷа номзаде, ки centroid-и он ба ҳуҷайраи receiver наздиктарин аст, ҳамчун donor интихоб мешавад ва барои interpolation stencil ҳамсояҳои атрофи он низ истифода мешаванд.
Азбаски body-conforming grid пешакӣ partition шудааст ва геометрияи он дар вақти ҳалли масъала тағйир намеёбад, ADT метавонад дар аввали ҳалли масъала танҳо як бор сохта шуда, дар хотира нигоҳ дошта шавад.
Дар ҷустуҷӯи donor-и Cartesian коди Morton чӣ гуна истифода мешавад?
Азбаски Cartesian grid аллакай аз ҷониби p4est octree forest идора мешавад, зарурати сохтани spatial tree-и алоҳида нест. Координатаҳои ҳуҷайраи receiver тибқи баландтарин сатҳи refinement ба пайдарпаии битҳо табдил дода шуда, ин битҳо дар се андоза дар як коди Morton якҷо карда мешаванд.
Гурӯҳҳои дахлдори битҳои коди Morton пайдарҳам хонда мешаванд, муайян карда мешавад, ки дар дохили octree ба кадом child node рафтан лозим аст, ва вақте ба leaf node расида мешавад, блоки Cartesian grid, ки нуқтаи receiver-ро фаро мегирад, ёфта мешавад.
Ин система барои ҷустуҷӯи donor сохтори фазоии маълумоти аллакай мавҷудаи p4est-ро бори дуюм истифода мебарад.
Benchmark-и аввал чӣ гуна сохта шуд?
Масъалаи аввалини санҷиш ҷараёни устувор ва турбулентии фишурдашаванда аст, ки дар он ҷараёни озоди Mach 2 аз болои силиндри нимабадии бинӣ-кунд мегузарад.
| Параметри ҷараёни озод | Арзиши дар манбаъ истифодашуда |
|---|---|
| Адади Mach | 2 |
| Адади Reynolds | 353.100 |
| Ҳарорат | 242,3 K |
| Шиддати турбулентӣ | %0,05 |
Ҳарчанд масъала меҳварсимметрӣ аст, барои нишон додани иҷрои сеандозаи ҳалкунанда чоряки домени ҳисоббарорӣ ба таври сеандоза моделсозӣ шудааст.
Cartesian grid бо 3 × 3 × 3 octree forest оғоз карда шудааст ва ҳар node блоки grid-и 2 × 2 × 2 ҳуҷайраиро ифода кардааст. Сатҳи максималии refinement 5 аст. Меъёри refinement градиенти Mach мебошад ва арзишҳои остона:
\[ Q_{lower}=0.185, \qquad Q_{upper}=0.218 \]
ҳамчун меъёр истифода шудаанд. Аввалин ҳуҷайраи девории body-conforming grid тақрибан ба \(y^+=5\) мувофиқ сохта шуда, меъёри наздикшавӣ барои cumulative residual relative error ҳамчун %0,01 муайян шудааст.
Дар омӯзиши наздикшавии шабака чанд ҳуҷайра истифода шуд?
Се сатҳи шабака муқоиса шудааст:
| Ҳаллияти шабака | Сатҳи максималии refinement | Шумораи ҳуҷайраҳо дар ҳолати устувор |
|---|---|---|
| Дағал | 4 | 334.627 |
| Миёна — ҳалли асосӣ | 5 | 1.419.996 |
| Майда | 6 | 3.697.852 |
Муқоисаи каҷҳои коэффитсиенти фишор нишон додааст, ки шабакаи миёна барои ин масъала кофӣ аст. Аз ин рӯ, таҳқиқотчиён дар таҳлилҳои иҷро шабакаи миёнаи тақрибан 1,42 миллион ҳуҷайраро истифода кардаанд.
Оё натиҷаи ҷисми бинӣ-кунд бо таҷриба мувофиқат мекунад?
Дар маҷмӯъ, ҳа. Тақсимоти ададии \(C_p\) бо натиҷаҳои таҷрибавии истинодӣ мувофиқати хуб нишон додааст. Бо вуҷуди ин, дар минтақаи stagnation point бо \(s/D=0\) ва дар минтақаи наздик ба tip-base-и ҷисм бо \(s/D>0.8\) ҳалли масъала арзишҳои таҷрибавиро каме пасттар пешбинӣ мекунад.
Тибқи муқоисаи таҳқиқот, натиҷаи ҳалкунандаи таҳияшуда нисбат ба натиҷаи ададии пешинаи scFLOW, ки дар ҳамон график дода шудааст, ба маълумоти таҷрибавӣ наздиктар менамояд. Ин муқоиса танҳо барои ҳамин benchmark ва шароити истифодашуда эътибор дорад; маънои бартарии умумии нармафзори CFD-ро надорад.
Дар тасвирҳои Numerical schlieren ва Mach contour дида мешавад, ки Cartesian grid-и адаптивӣ дар тӯли хати bow shock ба баландтарин сатҳи refinement мегузарад. Ҳамин тавр нопайвастагии шок дар ҳалли баланд нигоҳ дошта мешавад, бе он ки дар минтақаҳои дур шабакаи нолозими майда истифода шавад.
Benchmark-и устувор чӣ гуна ба таври параллелӣ миқёс гирифт?
Дар таҷрибаи strong-scaling grid-и 1.419.996 ҳуҷайраӣ собит нигоҳ дошта шуда, шумораи MPI rank тадриҷан зиёд карда шудааст. Шумораи ҳуҷайраҳои receiver дар ин шабака 34.970 мебошад. Барои ҳар шумораи rank вақти wall-clock-и 100 итератсияи ҳал чен карда шудааст.
Speed-up:
\[ S_f=\frac{T_1}{T_N} \]
ва самаранокии параллелӣ:
\[ \eta=\frac{S_f}{N}\times100 \]
ҳамчун чунин таъриф шудааст.
Verianla Live: Самаранокии параллелии ҳалкунандаи overset вобаста ба шумораи MPI rank
Арзишҳои зер самаранокии параллелии ҳалкунандаи overset-grid-ро нишон медиҳанд, ки дар benchmark-и устувори ҷисми бинӣ-кунди Mach 2 ҳангоми собит нигоҳ доштани тақрибан 1,42 миллион ҳуҷайра чен карда шудааст. Инҳо натиҷаҳои weak-scaling нестанд, балки натиҷаҳои strong-scaling мебошанд.
| Шумораи MPI rank | Самаранокии параллелӣ (%) | Навъи санҷиш | Манбаъ |
|---|---|---|---|
| 32 | 89,7 | Strong scaling — overset solver | Шакли 12 ва матни натиҷа |
| 64 | 80 | Strong scaling — overset solver | Шакли 12 ва матни натиҷа |
| 128 | 65 | Strong scaling — overset solver | Шакли 12 ва матни натиҷа |
Ёддошти манбаи Verianla Live: Визуализатсия аз ҳамин ҷадвали намоёни маълумоти илмӣ сохта мешавад. Ҷадвал ҳамчун source-of-truth-и илмӣ нигоҳ дошта мешавад.
Solver то 32 MPI rank миқёспазирии қавӣ нишон додааст. Самаранокии параллелӣ дар 32 rank %89,7 буд, дар 64 rank ба %80 ва дар 128 rank ба %65 паст мешавад. Дар 128 rank фарқи иҷрои параллелӣ байни ҳалли overset ва истиноди single-grid бо ҳамон шумораи ҳуҷайраҳо ҳадди аксар тақрибан %7 гузориш шудааст.
Чаро Interpolation нисбат ба solver-и умумӣ бадтар миқёс мегирад?
Ҳисоббарорӣ барои Interpolation бо ҳуҷайраҳои donor–receiver маҳдуд аст. Бо зиёд шудани шумораи MPI rank шумораи receiver, ки ба ҳар rank рост меояд, хеле кам мешавад ва ҳуҷайраҳои overlap байни rank-ҳо баробар тақсим намешаванд.
Самаранокии параллелии сегменти Interpolation computation тақрибан ба ин сатҳҳо поён меояд:
- то 32 MPI rank %70,
- дар 64 MPI rank %44,
- дар 128 MPI rank %30
.
Бо вуҷуди ин, азбаски interpolation танҳо тақрибан %0,2-и арзиши умумии итератсияро дар 1 rank ва %5,11-и онро дар 128 rank ташкил медиҳад, ин самаранокии пасти зеррутина ба иҷрои умумии solver танҳо ба андозаи маҳдуд таъсир мерасонад.
Равиши нав нисбат ба ҳалкунандаи пешинаи master–slave то чӣ андоза беҳтар аст?
Манбаъ гузориш медиҳад, ки ҳангоми муқоиса бо равиши пешинаи master–slave-и ҳамон гурӯҳи таҳқиқотӣ, усули нави тақсимшуда самаранокии умумии параллелии solver-ро дар 32 MPI rank %50 зиёд кардааст.
Ин натиҷа муқоисаест, ки барои сахтафзор, grid ва benchmark-и мушаххас анҷом дода шудааст. Таҳқиқот нишон надодааст, ки алгоритми нав дар ҳар масъала ё ҳар архитектураи HPC маҳз %50 фоида медиҳад.
Чаро benchmark-и дуюм душвортар аст?
Масъалаи дуюм устувор нест. Мавҷи зарбаи ҳамворе, ки бо суръати Mach 2,89 пеш меравад, дар оғоз ба курае мезанад, ки дар ҳавои сокин қарор дорад; бо гузашти вақт зарбаи инъикосшуда, incident shock, triple point, difracted shock ва сохторҳои vortex пайдо мешаванд.
Азбаски ин сохторҳои ҷараён ҳаракат мекунанд, минтақаи grid-и майда низ бояд бо вақт ҳаракат кунад. Бинобар ин шабакаи собите, ки танҳо як маротиба refine шудааст, кофӣ нест; AMR дар ҷараёни ҳал борҳо даъват карда мешавад.
Адади Reynolds-и ҷараён ҳамчун 7800 дода шуда, моделсозӣ ламинарӣ анҷом шудааст. Барои ҳавои истифодашуда манбаъ ин арзишҳоро медиҳад:
- \(R=287.2\) J/(kg·K),
- \(c_p=1005.2\) J/(kg·K),
- \(\gamma=1.4\)
.
Чаро маълумоти Region 1 ва Region 2 дар benchmark-и кура бояд бо эҳтиёт хонда шавад?
Матни манбаъ мегӯяд, ки Region 1 сокин аст, Region 2 бошад минтақаи post-shock буда, суръати ниҳоии x-самтро дар бар мегирад. Баръакс, Tablo 2-и нашршуда ин арзишҳоро медиҳад:
| Бузургии дар манбаъ додашуда | Region 1 | Region 2 |
|---|---|---|
| Зичӣ — дар ҷадвал ҳамчун kg/m³ нишон дода шудааст | 5,1432014 | 1,4 |
| Ҳарорат — дар ҷадвал ҳамчун K нишон дода шудааст | 0,006123676 | 0,002487067 |
| Суръат — дар ҷадвал ҳамчун m/s нишон дода шудааст | 2,0451168 | 0 |
Арзишҳои суръат бо таърифи матнии Region ба самти баръакс меоянд: ҷадвал Region 1-ро ҳаракаткунанда ва Region 2-ро сокин нишон медиҳад. Илова бар ин, дода шудани арзишҳои ҳарорат дар тартиби 10−3 бо нишонаи K ба масъалаи миқёспазирӣ/нишонагузорӣ монанд аст, ки бо ҳарорати воқеии андозадор мувофиқат намекунад. Азбаски манбаъ инро шарҳ намедиҳад, Verianla воҳиди ин рақамҳо ё тартиби Region-ҳоро бо фарзия ислоҳ намекунад.
AMR-и динамикӣ чӣ гуна танзим шуд?
Cartesian grid бо 10 × 5 × 5 base octree node оғоз шуда, ҳар node блоки grid-и 2 × 2 × 2 ҳуҷайраиро дар бар гирифтааст. Сатҳи максималии refinement 5 аст. AMR ҳар 25 flow-solver итератсия як бор даъват шудааст.
Меъёри refinement density gradient мебошад:
\[ Q_{lower}=0.6, \qquad Q_{upper}=0.625 \]
Таъмин шудааст, ки аввалин ҳуҷайраи body-conforming grid тақрибан \(y^+\approx2.5\) бошад ва шабака аз сатҳи кура 2,5D ба берун дароз карда шудааст.
Ҳал бо CFL = 0,7 иҷро шудааст; қадами глобалии беандозаи вақт вобаста ба итератсия тақрибан байни \(9.2\times10^{-5}\) ва \(1.5\times10^{-4}\) тағйир ёфтааст.
Чаро дар шумораи ҳуҷайраҳо дар benchmark-и кура манбаъ зиддият дорад?
Дар як қисми таҳқиқот барои “initial overset grid system” 3.241.936 ҳуҷайра ва 54.294 ҳуҷайраи receiver дода шудааст. Аммо дар қисми баъдӣ, ки рушди ҷараёнро бо гузашти вақт тавсиф мекунад, навишта шудааст, ки дар лаҳзаи \( \bar{t}=1.832 \) grid аз 2.232.704 ҳуҷайраи ибтидоӣ ба 3.241.936 ҳуҷайра расидааст.
Азбаски ин ду баён як шумораи “ибтидоӣ”-и ҳуҷайраҳоро дастгирӣ намекунанд, ин ҷо он ҳамчун носозгории дохилии манбаъ нигоҳ дошта мешавад. Баръакс, барои \( \bar{t}=1.832 \) арзиши 3.241.936 ҳуҷайра дар ҳар ду замина дида мешавад ва шабакае, ки дар санҷиши strong-scaling ҳамчун ҳолати динамикии сербор интихоб шудааст, ҳамин аст.
Мавҷи шок дар атрофи кура чӣ гуна инкишоф ёфт?
Тасвирҳои Numerical schlieren ва Mach рушди ҷараёнро дар чанд нуқтаи вақти беандоза нишон медиҳанд:
- \(\bar{t}=0\): incident shock-и ҳамвор тақрибан 0,6D аз маркази кура дур аст.
- \(\bar{t}\approx0.307\): вақте шок ба сатҳи кура мерасад, reflected shock пайдо мешавад.
- \(\bar{t}=0.615\): дар буриши incident ва reflected shock triple point равшан мешавад.
- \(\bar{t}=1.832\): diffracted shock ва triple point ба минтақаи wake-и кура пеш мераванд ва як vortex дида мешавад.
Хатҳои шабакаи адаптивӣ нишон медиҳанд, ки сатҳи баланди refinement сохторҳои ҳаракаткунандаи шокро пайгирӣ мекунад. Таҳқиқотчиён ҳамчунин қайд мекунанд, ки дар лаҳзаи \( \bar{t}=1.832 \), дар минтақае ки reflected shock ба triple point мепайвандад, аз сабаби заиф шудани density gradient дар сифати пайгирӣ талафоти хурд ба вуҷуд омадааст.
Муқоисаи schlieren-и таҷрибавӣ чӣ нишон дод?
Тасвири Numerical schlieren бо тасвири таҷрибавии классикии Bryson ва Gross муқоиса шудааст. Гузориш шудааст, ки мавқеъҳои reflected shock, triple point ва transmitted shock дар маҷмӯъ бо таҷриба хуб мувофиқат мекунанд.
Аз ҷиҳати reflected shock standoff distance фарқи хурд вуҷуд дорад. Муаллифон пешниҳод мекунанд, ки ин фарқ метавонад аз артефактҳои тасвирбарорӣ вобаста ба деформатсияҳое сарчашма гирад, ки дар тасвири таҷрибавӣ дида мешаванд. Ин тавзеҳ шарҳи муаллифон аст; таҳқиқот сабаби ин фарқро алоҳида таҷрибавӣ насанҷидааст.
Дар як даъвати динамикии AMR кадом амалҳо анҷом мешаванд?
Дар таҳқиқот раванди AMR ба панҷ сегменти пайдарпай ҷудо карда мешавад:
- Cell flagging: ҳуҷайраҳо бо sensor function арзёбӣ шуда, барои refine/coarsen ишора карда мешаванд.
- Grid adaptation: блокҳои ишорашуда refine ё coarsen карда мешаванд.
- Load balancing: блокҳои grid байни MPI rank-ҳо аз нав тақсим мешаванд ва ghost layer-ҳо сохта мешаванд.
- Connectivities: пайвастҳои ҳуҷайраҳои ҳамсоя аз нав сохта ва cache карда мешаванд.
- Grid assembly: ҷуфтҳои overset donor–receiver, коэффитсиентҳои interpolation ва ҷадвалҳои communication аз нав сохта мешаванд.
Дар масъалаи динамикӣ ҳамаи ин панҷ марҳила ҳар 25 итератсияи solver як бор такрор мешаванд.
Арзиши ҳисоббарории AMR чӣ қадар аст?
Амали AMR дар ҳамаи шумораҳои MPI rank аз як итератсияи flow-solver кӯтоҳтар давом мекунад; аммо дар ҳамон дараҷа аст. Азбаски AMR танҳо ҳар 25 итератсия як бор кор мекунад, таъсири умумии он кам-пайдарпай мешавад.
Дар 128 MPI rank давомнокии як даъвати AMR тақрибан %8-и давомнокии умумии 25 итератсияи flow-solver байни ду AMR гузориш шудааст.
Қисми аз ҳама гарони AMR overset grid assembly мебошад. Дар шумораҳои rank-и баррасишуда grid assembly на камтар аз %53-и давомнокии AMR-ро ташкил мекунад.
Масъалаи динамикӣ дар 128 MPI rank чӣ гуна миқёс гирифт?
Иҷрои scaling-и раванди AMR ба танҳоӣ ба қуввати solver баробар нест. Сабаби асосии ин тақсимоти нобаробари дархостҳои donor/receiver ва минтақаҳои overlap байни MPI rank-ҳост.
Бо вуҷуди ин, азбаски AMR танҳо ҳар 25 итератсия даъват мешавад, тамоми низоми flow solver + AMR дар шумораҳои баланди rank беҳтар рафтор мекунад. Таҳқиқот барои benchmark-и динамикӣ дар 128 MPI rank тақрибан %61 самаранокии параллелӣ гузориш медиҳад.
Дар бахши натиҷаҳо гуфта мешавад, ки марҳилаҳои AMR ва overset-grid-assembly дар 64 MPI rank ба тақрибан %42 самаранокии параллелӣ расидаанд.
Оё Load balancing воқеан кор мекунад?
Бале; дар benchmark-и истифодашуда фоидаи ченшаванда вуҷуд дорад. Таҳқиқотчиён барои 32 MPI rank ҳамон ҳолати динамикии grid-ро бо load balancing фаъол ва ғайрифаъол муқоиса кардаанд.
Дар ҳолати load-balanced тақсимоти normalize CPU workload-и rank-ҳо яксонтар шудааст. Манбаъ дар MPI rank-ҳо ҳадди ақал %17,4 коҳиши workload гузориш медиҳад.
Аз рӯйи давомнокии wall-clock, ки ghost-layer ва inter-grid communication-ро низ дар бар мегирад, итератсияи solver-и load-balanced нисбат ба итератсияе, ки load balancing татбиқ нашудааст, %10,1 кӯтоҳтар давом кардааст.
Ин ченак барои як ҳолати пас аз adaptation аст. Муаллифон қайд мекунанд, ки дар ҳалли воқеӣ AMR борҳо даъват мешавад, бинобар ин фоида метавонад дар тӯли ҳалли масъала ҷамъ шавад.
Натиҷаҳое, ки таҳқиқот дастгирӣ мекунад
- Бо p4est AMR-и сеандозаи block-based Cartesian бо body-conforming overset grid дар ҳамон ҳалкунандаи CFD-и фишурдашаванда якҷо карда шудааст.
- Архитектурае, ки маълумоти ҷараёнро аз p4est node allocation ҷудо мекунад, data migration-и нолозимро кам мекунад ва ҳангоми coarsen–balance талафоти нолозими иттилооти ҷараёнро пешгирӣ менамояд.
- Бо сохторҳои ҷустуҷӯии distributed bounding-box, ADT ва octree overset reassembly бе ниёз ба master rank-и марказӣ татбиқ шудааст.
- Дар benchmark-и ҷисми бинӣ-кунди Mach 2 коэффитсиенти ҳисобшудаи фишори сатҳӣ дар маҷмӯъ бо маълумоти таҷрибавӣ мувофиқ аст.
- Adaptive grid дар атрофи bow shock ба сатҳи баланди refinement гузаштааст.
- Дар benchmark-и кура–шок сохторҳои reflected shock, triple point, diffracted/transmitted shock ва vortex ба таври ададӣ гирифта шудаанд.
- Дар benchmark-и устувор overset solver дар 128 MPI rank %65 самаранокии параллелӣ нишон додааст.
- Низоми динамикии solver + AMR дар 128 MPI rank тақрибан %61 самаранокии параллелӣ нишон додааст.
- Таҷрибаи load balancing дар 32 MPI rank дар вақти wall-clock iteration %10,1 коҳиш додааст.
- Равиши нави тақсимшуда нисбат ба версияи пешинаи master–slave дар 32 MPI rank дар самаранокии умумии параллелӣ %50 афзоиш фароҳам овардааст.
Натиҷаҳое, ки таҳқиқот дастгирӣ ё санҷиш накардааст
- Нишон дода нашудааст, ки ҳалкунанда дар ҳамаи масъалаҳои CFD-и фишурдашаванда ҳамон дақиқӣ ё иҷрои scaling-ро медиҳад.
- Дар таҳқиқот GPU ё accelerator offloading санҷида нашудааст.
- Берун аз 128 ядро ё дар болои беш аз як HPC node санҷиши scaling анҷом нашудааст.
- Дар геометрияи воқеии ҳавопаймо, мушак, ракета ё турбомошин validation-и саноатӣ анҷом нашудааст.
- Дар benchmark-и ҷисми бинӣ-кунд фарқи таҷрибавӣ дар минтақаҳои stagnation ва tip-base пурра бартараф карда нашудааст.
- Дар benchmark-и кура ҳамаи сохторҳои шок комилан пайгирӣ нашудаанд; дар атрофи \( \bar{t}=1.832 \) аз сабаби заиф шудани density gradient талафоти хурди tracking дида шудааст.
- Нишон дода нашудааст, ки overset grid assembly дар MPI rank-ҳои баланд ба таври идеалӣ load-balanced аст.
- Носозгориҳои дохилии манбаъ дар ҳолатҳои ибтидоии Region 1/Region 2 ва шумораи ибтидоии ҳуҷайраҳо ҳал нашудаанд.
- Самаранокии параллелии %65 ё %61, ки дар як гиреҳ ба даст омадааст, ба муҳити суперкомпютерии бисёргиреҳӣ мустақиман умумӣ карда намешавад.
Усул ва Натиҷаҳои Таҳқиқот
Архитектураи ҳалкунандаи ададӣ
Нармафзори таҳияшуда ҳалкунандаи сеандозаи density-based finite-volume-и Navier–Stokes барои ҷараёни фишурдашаванда мебошад. Дар масъалаи устувори турбулентӣ модели k–ω SST 2003 истифода шудааст. Дар ҷараёнҳои конвективӣ AUSM+up, дар реконструксияи дараҷаи дуюм MUSCL ва дар наздикии нопайвастагӣ Venkatakrishnan limiter татбиқ шудаанд. Истилоҳҳои Diffusive бо усули марказии дараҷаи дуюм ва интегратсияи вақт бо explicit Euler ҳисоб шудаанд.
Архитектураи Grid аз ду ҷузъ иборат аст:
- structured body-conforming grid, ки пешакӣ partition шудааст ва геометрияву ҷараёни наздики деворро ҳал мекунад,
- block-based adaptive Cartesian off-body grid, ки аз ҷониби p4est octree forest идора мешавад.
Меъёри refinement ва coarsening
Дар ҳар блоки Cartesian grid параметри интихобшудаи ҷараён \(Q\) бо остонаҳои поёнӣ ва болоӣ муқоиса мешавад:
- агар \(Q>Q_{upper}\) бошад refine,
- агар \(Q<Q_{lower}\) бошад coarsen
татбиқ мешавад.
Тартиби grid adaptation дар тарафи p4est чунин аст:
p4est_refinep4est_balancep4est_coarsenp4est_balance
. Даъвати дуюми balance барои аз нав таъмин кардани шарти 2:1 balance пас аз coarsen зарур аст.
Мантиқи computational-и архитектураи пешниҳодшудаи маълумот
Дар сохтори пешниҳодшудаи маълумот p4est танҳо бо grid topology ва маълумоти partition ownership сарукор дорад, дар ҳоле ки векторҳои ҳалли физикӣ аз ҷониби solver дар хотираи алоҳида нигоҳ дошта мешаванд.
Ҳангоми Load balancing танҳо интиқоли:
\[ G_p=[\rho,u,v,w,T,k,\omega] \]
гурӯҳи асосии маълумот кофӣ қабул шудааст. Фишор, часпакӣ ва арзишҳои secondary-и фарқшаванда аз нав ҳисоб карда мешаванд; арзишҳои градиент ва MUSCL limiter дар давоми solver cycle-и нав аз нав тавлид мешаванд.
Ин равиш махсусан ҳангоми зиёд шудани шумораи MPI rank ба коҳиш додани ҳаҷми иртибот нигаронида шудааст.
Алгоритми Overset reassembly
Пас аз тағйири динамикии grid, аз нав сохтани муносибати receiver–donor-ро метавон дар се марҳила баррасӣ кард:
- Бо истифода аз partition bounding box-ҳо муайян мешавад, ки кадом MPI rank-ҳо аз ҷиҳати геометрӣ метавонанд ҳамтаъсир шаванд.
- Номзадҳои donor барои body-conforming grid бо ADT, номзадҳои donor барои Cartesian бошад бо сохтори p4est octree/Morton ҷустуҷӯ мешаванд.
- Пас аз муайян шудани ҷуфтҳои donor–receiver, коэффитсиентҳои interpolation ва ҷадвалҳои inter-grid MPI communication сохта мешаванд.
Ин усул зарурати нигоҳ доштани нусхаи пурраи body-conforming grid-ро дар master rank бартараф мекунад.
Натиҷаҳои асосии ададии benchmark-и устувор
| Бузургии ченшуда ё истифодашуда | Натиҷа |
|---|---|
| Адади Mach | 2 |
| Адади Reynolds | 353.100 |
| Шумораи ҳуҷайраҳои grid-и асосӣ | 1.419.996 |
| Шумораи ҳуҷайраҳои receiver | 34.970 |
| Самаранокии параллелии 32 MPI rank | %89,7 |
| Самаранокии параллелии 64 MPI rank | %80 |
| Самаранокии параллелии 128 MPI rank | %65 |
| Фарқи иҷро дар 128 rank нисбат ба single-grid | Ҳадди аксар тақрибан %7 |
Ин benchmark ҳам дақиқии ададии ҳалкунанда ва ҳам рафтори strong-scaling-ро ҳангоми зиёд шудани шумораи MPI rank дар андозаи собити масъала месанҷад.
Натиҷаҳои асосии ададии benchmark-и динамикӣ
| Бузургии ченшуда ё истифодашуда | Натиҷаи дар манбаъ додашуда |
|---|---|
| Адади Mach-и Incident shock | 2,89 |
| Адади Reynolds | 7800 |
| Фосилаи даъвати AMR | Ҳар 25 итератсияи solver як бор |
| Сатҳи максималии refinement | 5 |
| Остонаҳои density-gradient refine | 0,6 / 0,625 |
| Шумораи ҳуҷайраҳои шабака дар \(\bar{t}=1.832\) | 3.241.936 |
| Самаранокии параллелии 128 MPI rank solver + AMR | %61 |
| Ҳиссаи вақти AMR дар фосилаи 25 итератсия дар 128 rank | Тақрибан %8 |
| Ҳиссаи минималии Grid assembly дар вақти AMR | %53 |
| Фоидаи wall-clock-и 32 rank load balancing | %10,1 |
Чаро самаранокии параллелӣ идеалӣ нест?
Таҳқиқот нишон медиҳад, ки унсури асосие, ки дар шумораи баланди MPI rank самаранокии параллелиро маҳдуд мекунад, танҳо арзиши умумии иртиботи MPI нест. Шумораи ҳуҷайраҳои donor–receiver дар минтақаи overset overlap ҳангоми амали space-filling-curve partition-и p4est бо вазни махсус тақсим карда намешавад.
Дар натиҷа дар баъзе rank-ҳо шумораи зиёди дархостҳои interpolation вуҷуд дошта метавонад, дар баъзе rank-ҳо бошад хеле кам. Бо зиёд шудани шумораи MPI rank миқдори ҳисоб барои ҳар ҳуҷайраи receiver кам мешавад ва communication latency ҳамроҳи workload imbalance равшантар мегардад.
Ин таъсир махсусан дар зеррутинаҳои grid assembly ва interpolation дида мешавад. Ҳисоби Navier–Stokes, ки flow solver дар ҳамаи ҳуҷайраҳо анҷом медиҳад, азбаски муназзамтар тақсим мешавад, scaling-и умумии solver қавитар мемонад.
Саҳми асосии муҳандисии таҳқиқот
Саҳми асосии таҳқиқот таҳияи муодилаи нави Navier–Stokes ё shock-capturing flux-и нав нест. Навоварӣ ба он равона шудааст, ки ҷузъҳои мавҷуда ва тасдиқшудаи CFD дар дохили AMR-и динамикии параллелии overset бо архитектураи самараноктари маълумот ва иртибот чӣ гуна якҷо карда шаванд.
Махсусан:
- ҷудо кардани маълумоти ҷараён аз p4est grid management,
- migration-и танҳо solution variables-и зарурӣ,
- ҳифзи иттилооти ҷараён ҳангоми coarsen–balance,
- distributed overset assembly ба ҷойи master rank,
- истифодаи якҷояи ADT ва octree тибқи навъи grid
дар маркази саҳмҳои алгоритмии таҳқиқот қарор доранд.
Маҳдудиятҳои асосӣ
- Санҷишҳои scaling дар як dual-socket HPC node анҷом дода шудаанд.
- Миқёси баландтарини санҷиш 128 MPI rank мебошад.
- GPU истифода нашудааст.
- Танҳо ду benchmark баррасӣ шудааст.
- Overset assembly workload байни MPI rank-ҳо мустақиман бо вазн тавозун карда намешавад.
- Дар шумораи баланди rank, communication ва кам шудани зичии receiver-cell иҷрои assembly-ро маҳдуд мекунанд.
- Таърифҳои Region ва шумораи ибтидоии ҳуҷайраҳо дар benchmark-и кура дар дохили манбаъ носозгоранд.
- Бо геометрияи воқеии ҳавопаймои саноатӣ ё киштии кайҳонӣ санҷиш анҷом дода нашудааст.
Ёддошт оид ба Манбаъ ва Усул
Номи пурраи кори аслӣ: A Parallel Solver on a Dynamically Adaptive Overset Grid for Compressible Flow Problems
Муаллифон: Mohamad El Hajj Ali Barada; Bayram Celik.
Тартиби муаллифон: Тартиби аслии манбаъ айнан нигоҳ дошта шудааст.
Саҳми баробар/муаллифи якуми баробар: Дар манбаъ зикр нашудааст.
Муаллифи масъул: Mohamad El Hajj Ali Barada.
Муассисаҳо: Aeronautical and Astronautical Engineering Program, Istanbul Technical University, Istanbul 34469, Turkey; Department of Astronautical Engineering, дар манбаъ ба шакли “Istanbul Tehnical University” навишта шудааст, Istanbul 34469, Turkey.
Ёддошти имлои аффилиатсия: Дар аффилиатсияи аввал “Istanbul Technical University”, дар аффилиатсияи дуюм бошад “Istanbul Tehnical University” навишта шудааст. Verianla қайд мекунад, ки нишонаи қавӣ вуҷуд дорад, ки ин дар аффилиатсияи дуюм хатои имлоӣ аст; аммо матни аслии манбаъро хомӯшона тағйир намедиҳад.
Навъи манбаъ: Мақолаи таҳқиқотии рецензияшуда; таҳқиқоти усули ададӣ, ки ҳалкунандаи сеандозаи CFD-и фишурдашаванда, ҳисоббарории параллелӣ, dynamic adaptive mesh refinement ва тасдиқи benchmark-ро дар бар мегирад.
Маҷалла: Aerospace
Ношир: MDPI
Ҷилд / рақами мақола: 13, 656
Санаи нашр: 20 Temmuz 2026
DOI: 10.3390/aerospace13070656
Пайванди расмии нашр: https://www.mdpi.com/2226-4310/13/7/656
Пайванди DOI: https://doi.org/10.3390/aerospace13070656
Ҳолати рецензия: Таҳқиқот мақолаи таҳқиқотиест, ки дар маҷаллаи рецензияшудаи Aerospace нашр шудааст.
Иҷозатнома: Creative Commons Attribution 4.0 International (CC BY 4.0).
Маблағгузорӣ: Таҳқиқот маблағгузории беруна нагирифтааст.
Дастрасии маълумот: Қайд шудааст, ки маълумоти пешниҳодшуда дар таҳқиқот бо дархости оқилона аз муаллифи масъул дастрас карда мешавад.
Ихтилофи манфиатҳо: Муаллифон ихтилофи манфиатҳоро гузориш надодаанд.
Саҳмҳои муаллифон: Bayram Celik; барои бозбинӣ ва таҳрир, назорат ва дарёфти захираҳои ҳисоббарорӣ масъул аст. Mohamad El Hajj Ali Barada; нусхаи аввал, computational software development, таҳлили маълумот, методология ва консептуализатсияро анҷом додааст.
Платформаи ҳисоббарорӣ: Benchmark-ҳо дар як HPC compute node-и dual-socket иҷро шудаанд. Node ду протсессори AMD EPYC 7742, басомади асосии 2,25 GHz ва дар маҷмӯъ 128 CPU ядро дорад. p4est ва ҳалкунанда дар сатҳи CPU-и ба MPI асосёфта иҷро шудаанд; GPU ё device offloading истифода нашудааст.
Ёддошти носозгории Region 1 / Region 2: Тавсифи матнии benchmark-и кура–шок Region 1-ро ҳамчун минтақаи сокин ва Region 2-ро ҳамчун минтақаи post-shock бо суръати ниҳоӣ муайян мекунад. Аммо Tablo 2-и манбаъ арзиши суръатро барои Region 1 ҳамчун 2,0451168 ва барои Region 2 ҳамчун 0 медиҳад. Verianla тартиби минтақаҳоро бо фарзия баръакс накардааст.
Ёддошти воҳиди Tablo 2: Дар ҳамон ҷадвал арзишҳои ҳарорат 0,006123676 ва 0,002487067 дода шуда, воҳид ҳамчун K нишон дода шудааст. Азбаски манбаъ шарҳ намедиҳад, ки ин рақамҳои хеле хурд ҳарорати беандозаанд ё не, арзишҳо ҳамчун ҳарорати воқеии Kelvin тафсир нашудаанд.
Ёддошти носозгории шумораи ибтидоии ҳуҷайраҳо: Як қисми манбаъ барои “initial overset grid” дар benchmark-и кура 3.241.936 ҳуҷайра гузориш медиҳад. Қисми баъдӣ бошад мегӯяд, ки дар \( \bar{t}=1.832 \) шабака аз 2.232.704 ҳуҷайраи ибтидоӣ ба 3.241.936 ҳуҷайра расидааст. Азбаски ду арзиши ибтидоӣ бо ҳам мувофиқат намекунанд, Verianla яке аз онҳоро хомӯшона ислоҳ накардааст.
Ҳади тасдиқи ададӣ: Ҳалкунанда бо ду benchmark арзёбӣ шудааст: ҷисми нимабадии бинӣ-кунди Mach 2 ва ҳамтаъсирии шоки ҳамвор–кураи Mach 2,89. Тасдиқҳо бо маълумоти мавҷудаи истинодии таҷрибавӣ анҷом шудаанд; худи таҳқиқот маъракаи нави таҷрибаи физикӣ нест.
Ҳади иҷрои параллелӣ: Натиҷаҳои самаранокии параллелӣ, ба монанди %89,7, %80, %65 ва %61, барои андозаҳои муайяни grid, шумораҳои MPI rank ва як HPC node дар дохили таҳқиқот эътибор доранд. Онҳо ба системаҳои бисёргиреҳӣ ё GPU-асос мустақиман умумӣ карда намешаванд.
Усули тавлиди муҳтаво: Усулҳои илмӣ, муодилаҳо, шароити benchmark, шумораи ҳуҷайраҳо, натиҷаҳои MPI ва маҳдудиятҳо дар ин шарҳи Verianla ба таҳқиқоти манбаи баррасишуда асос ёфтаанд. Санҷиши беруна танҳо барои тасдиқи библиографии шахсияти нашр ва ҳолати рецензия шудани маҷалла истифода шудааст; аз берун натиҷаи нави CFD, маълумоти нави benchmark ё арзиши ададии иҷрое, ки дар манбаъ нест, ба матни асосӣ илова нашудааст.
Шарҳ гузоред
Нишонии почтаи электронии шумо нашр намешавад. Майдонҳои ҳатмӣ бо * нишон дода шудаанд