

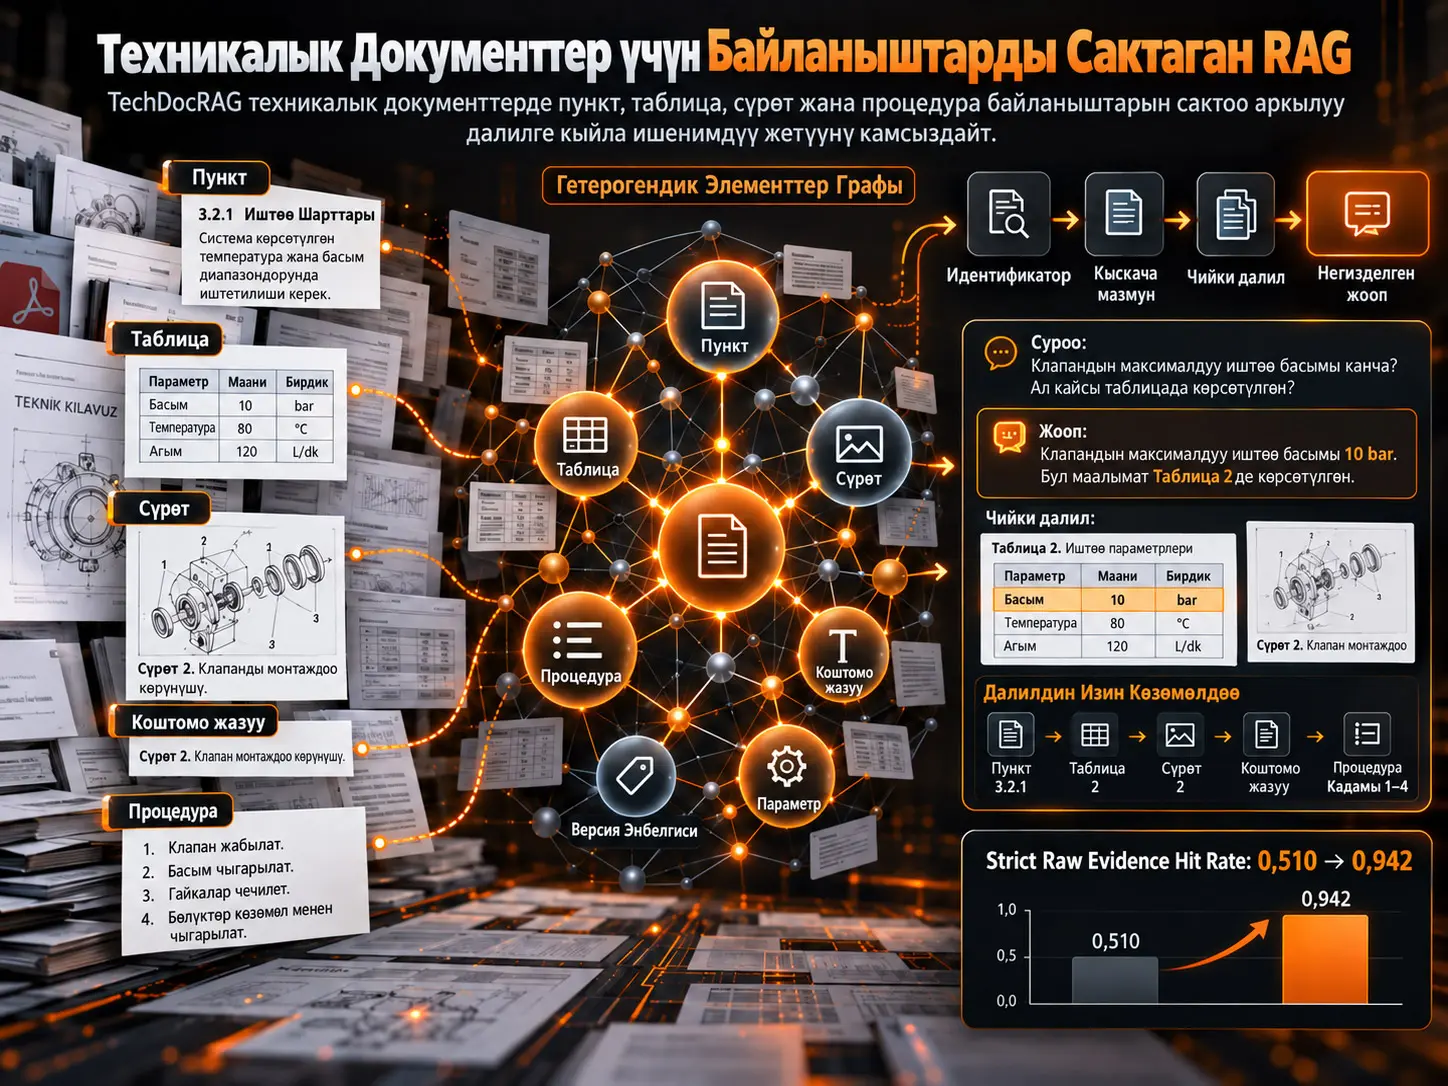
TechDocRAG — техникалык документтерди өз алдынча текст үзүндүлөрүнүн жалпак жыйындысы катары эмес, пункттардын, абзацтардын, таблицалардын, сүрөттөрдүн, коштомо жазуулардын, бөлүмдөрдүн жана процедуралык кадамдардын ортосундагы байланыштарды сактаган гетерогендик элементтер графы катары көрсөткөн retrieval-augmented generation (RAG) алкагы. Система ар бир документ элементин үч өз ара шайкеш көрүнүш менен индекстейт: техникалык идентификаторлор, семантикалык кыскача мазмун жана чийки далил. Суроо берилгенде адегенде техникалык идентификаторлор аркылуу талапкер элементтер табылат, андан кийин суроонун ниетине жараша байланышкан элементтерге граф аркылуу кеңейтүү жүргүзүлөт, семантикалык кыскача мазмундар кайра иреттелет жана акыркы этапта бири-бири менен байланышкан чийки далил объекттери бир эле контекст пакетинин ичинде генеративдик моделге жөнөтүлөт.
Изилдөө TechDocRAG’ди MPMQA, DesignQA, MMLongBench-Doc жана LongDocURL аттуу төрт benchmark боюнча, тең салмакталган 7500дөн ашык суроо-жооп жуптары менен баалаган. Бир эле жооп генератору жана салыштырууга боло турган контекст бюджеттери колдонулган эксперименттерде TechDocRAG MPMQAда 68,5, DesignQAда 62,2, MMLongBench-Docта 58,4 жана LongDocURLда 55,2 упай алган. Төрт benchmark боюнча орточо көрсөткүчтө эң күчтүү flat ыкма болгон Hybrid Dense+BM25ке салыштырмалуу 20,3 упай, ал эми эң күчтүү non-flat ыкма болгон VisRAGге салыштырмалуу 9,3 упай жогору натыйжа билдирилген.
Далилдин изин көзөмөлдөө жагында айырма андан да ачык. Exact identifier дал келүүсүн колдонгон эң катуу Raw Evidence Hit Rate (REHR) баалоосунда Hybrid RAG 0,510 болсо, TechDocRAG 0,942ге жеткен. Абляциялык эксперименттер identifier-aware recall алынып салынганда чийки далилге жетүү, relation edge’дер алынып салынганда далилдердин байланыштуулугу, raw bundling алынып салынганда болсо түзүлгөн ырастоолордун чийки далил менен колдоого алынышы олуттуу зыян тартарын көрсөтөт.
Ошол эле учурда система техникалык документтерди парсинг кылуунун сапатына көз каранды. Айрыкча пункт номери, параметрдин аталышы, сүрөт же таблица энбелгиси сыяктуу техникалык идентификаторлордун олуттуу бузулушу биринчи retrieval баскычын иштен чыгарат. Ошондуктан натыйжаларды “граф колдонгон ар бир RAG жакшыраак” деп эмес; техникалык документтерде туура далилге жетүү үчүн документтин ичиндеги түзүмдүк жана шилтеме байланыштарын сактоо маанилүү экенин көрсөткөн эксперименттик далил катары чечмелөө керек.
Техникалык документ RAG’и эмне үчүн кадимки текст RAG’инен айырмаланат?
Техникалык спецификациялар, колдонуу боюнча колдонмолор, тейлөө документтери жана инженердик стандарттар адатта бир бүтүн баяндоочу текст эмес. Бир талаптын аныктамасы Бөлүм 4.2де, чектик мааниси Таблица 7де, туташуу схемасы Сүрөт 3тө, ал эми өзгөчө жагдай тууралуу эскертүү кийинки процедуралык кадамда болушу мүмкүн.
Ошондуктан семантикалык жактан окшош бир абзацты гана табуу туура жооп түзүү үчүн жетишсиз болушу мүмкүн. Система туура пунктту тапса да, ошол пункт шилтеме берген таблицаны, сүрөттү же коңшу процедуралык кадамды алып келе албаса, далилдер чынжыры толук болбой калат.
TechDocRAG’дин негизги маселеси дал ушунда: тиешелүү текстти табуу менен жоопту колдогон толук жана байланышкан далилди табуу бир эле милдет эмес.
TechDocRAG Стандарттык RAG’ден Кандай Айырмаланат?
Стандарттык chunk негизиндеги RAG документти көбүнчө туруктуу узундуктагы же семантикалык текст бөлүктөрүнө бөлүп, бул бөлүктөрдү өз алдынча retrieval бирдиктери катары иштетет. TechDocRAG болсо пункт, таблица, сүрөт, caption, процедуралык кадам жана версия маалыматы сыяктуу баштапкы документ объекттерин сактайт; алардын ортосундагы table_ref, figure_ref, caption_of, step_next, version_of жана ушул сыяктуу байланыштарды граф кырлары катары сактайт. Ошентип retrieval “кайсы мазмун окшош?” деген суроого гана эмес, “бул далил кайсы башка далилдер менен чогуу окулушу керек?” деген суроого да жооп берет.
Документ гетерогендик элементтер графына айландырылат
Техникалык документ \(d\) изилдөөдө төмөнкү граф менен көрсөтүлөт:
\[ G_d=(V_d,E_d) \]
Бул жерде \(V_d\) документтеги элемент түйүндөрүн, ал эми \(E_d\) ошол элементтердин ортосундагы байланыштарды билдирет.
Ар бир түйүн:
\[ v=(\tau_v,r_v,k_v,s_v,m_v) \]
түрүндө аныкталат.
- \(\tau_v\): Элементтин түрү; мисалы, пункт, абзац, таблица, сүрөт, caption же процедуралык кадам.
- \(r_v\): Чийки документ объекти.
- \(k_v\): Техникалык идентификаторлор жана ачкыч сөздөр.
- \(s_v\): Семантикалык кыскача мазмун.
- \(m_v\): Барак индекси, bounding box, бөлүм жолу, документ түрү, версия жана normative label сыяктуу metadata.
Бул түзүм flat chunking учурунда жоголуп кетиши мүмкүн болгон документтин идентификациясын сактайт.
Граф кырлары кайсы байланыштарды билдирет?
| Байланыш | Мааниси |
|---|---|
| contains | Бөлүмдүн же жогорку деңгээлдеги элементтин төмөнкү элементтерди камтышы |
| precedes | Жергиликтүү окуу тартибинде бир элементтин экинчисинен мурда келиши |
| same_section | Бир эле бөлүмдүн же бөлүмчөнүн ичинде жайгашуу |
| step_next | Процедуралык кадамдардын ырааттуу байланышы |
| clause_ref | Бир пункттун башка пунктка ачык шилтемеси |
| table_ref | Тексттен таблицага берилген шилтеме |
| figure_ref | Тексттен сүрөткө берилген шилтеме |
| caption_of | Сүрөт же таблица менен caption ортосундагы байланыш |
| same_identifier | Бир эле техникалык идентификатордун ар башка элементтерде кайра колдонулушу |
| version_of / supersedes | Документтин ар башка версияларынын ортосундагы байланыш |
Retrieval максаты “эң тиешелүү бөлүк” менен гана чектелбейт
Изилдөө retrieval маселесин байланышкан далил подграфын табуу маселеси катары аныктайт:
\[ H_q^*=\arg\max_{H\subseteq G} \left[ Rel(q,H)+\lambda Conn(H)+\gamma Valid(q,H)-\mu Cost(H) \right] \]
Бул максаттык функцияда:
- \(Rel(q,H)\) суроо менен далил подграфынын ортосундагы лексикалык жана семантикалык шайкештикти;
- \(Conn(H)\) далил түйүндөрүнүн байланыштуулугун жана бүтүндүгүн;
- \(Valid(q,H)\) документ версиясы же документ түрү сыяктуу metadata шайкештигин;
- \(Cost(H)\) retrieval жана контекст түзүү чыгымын
билдирет.
\(\lambda\), \(\gamma\) жана \(\mu\) — бул компоненттердин максаттык функциядагы салмактары. Математикалык максат эң окшош түйүндөрдү гана топтоо эмес, жетиштүү байланышкан жана metadata жагынан жарактуу далил подграфын түзүү болуп саналат.
Тандалган подграф андан кийин жооп генераторуна өткөрүлөт:
\[ (y_q,\Pi_q)=f_\theta(q,H_q^*) \]
Бул жерде \(y_q\) түзүлгөн жоопту, ал эми \(\Pi_q\) түзүлгөн ырастоолордон чийки далил түйүндөрүнө чейинки provenance байланыштарын билдирет.
Үчтүк “Identifier–Summary–Raw” Түзүмү Эмне Үчүн Керек?
TechDocRAG ар бир документ элементин бир эле идентификацияга байланган үч retrieval көрүнүшүндө сактайт: identifier көрүнүшү так техникалык якорлорду табуу үчүн, summary көрүнүшү суроо менен семантикалык шайкештикти баалоо үчүн, ал эми raw evidence көрүнүшү акыркы жооп чындап таянган баштапкы текстти, таблицаны, сүрөттү же процедураны генеративдик моделге берүү үчүн колдонулат. Бул бөлүштүрүү семантикалык жактан пайдалуу, бирок булакка түздөн-түз көзөмөлдөнбөгөн кыскача мазмундардын чийки далилдин ордуна өтүшүнө жол бербейт.
Identifier жана кыскача мазмун кантип түзүлөт?
Ар бир түйүн үчүн техникалык identifier топтому жана семантикалык кыскача мазмун:
\[ k_v=ExtractId(r_v,m_v), \qquad s_v=Summarize(r_v,N(v)) \]
түрүндө аныкталат.
\(N(v)\) — түйүндүн жергиликтүү байланыш коңшулугу. Кыскача мазмун элементтин өзүнүн чийки мазмунунан гана эмес, аны түшүндүргөн жакын документ контекстинен да пайдалана алат.
Ар бир түйүндүн шайкештирилген көрсөтүлүшү:
\[ \phi(v)=\{k_v,s_v,r_v,m_v\} \]
түрүндө берилет.
Корпус деңгээлиндеги маалымат базасы болсо:
\[ D=(I_{id},I_{sum},R,G) \]
түрүндө аныкталат.
- \(I_{id}\): Техникалык identifier индекси.
- \(I_{sum}\): Семантикалык кыскача мазмун индекси.
- \(R\): Чийки далил сактагычы.
- \(G\): Байланыш графы.
Identifier индекси эмне үчүн маанилүү?
Техникалык документтерде “Section 4.2”, “Table 7”, “parameter Z”, “error E105”, API буйругу же версия энбелгиси семантикалык жактан кадимки сөздөн кыйла күчтүү якорь болушу мүмкүн.
Ошондуктан TechDocRAG биринчи retrieval катмарында техникалык идентификаторлорго өзгөчө салмак берет. Абляциялык экспериментте identifier-aware recall алынып салынганда REHR@10 мааниси толук моделдеги 0,94төн 0,65ке түшөт. Бул системанын маанилүү натыйжалуулук булактарынын бири туура техникалык якорду эрте этапта табуу экенин көрсөтөт.
Суроо адегенде талданат
Ар бир суроо үч компонентке бөлүнөт:
\[ (k_q,e_q,z_q)=Analyze(q) \]
- \(k_q\): Суроодогу техникалык identifier жана ачкыч сөздөр.
- \(e_q\): Семантикалык суроо көрсөтүлүшү.
- \(z_q\): Суроонун ниети.
Булакта колдонулган ниет түрлөрүнө аныктама/талап издөө, процедура же troubleshooting, текст-таблица боюнча ой жүгүртүү, текст-сүрөт grounding, cross-reference чечүү жана версияга сезимтал суроолор кирет.
Ар бир суроо үчүн бир эле retrieval саясаты колдонулбайт
| Суроонун түрү | Алдыңкы байланыштар | Максималдуу hop | Негизги максат |
|---|---|---|---|
| Аныктама / талап | contains, same_identifier, clause_ref | 1-2 | Пункт же абзац |
| Процедура / troubleshooting | step_next, contains, same_section | 2 | Процедуралык кадамдар |
| Текст-таблица | table_ref, caption_of, same_identifier | 2 | Таблица сабы / баш ат жолу |
| Текст-сүрөт | figure_ref, caption_of, same_section | 2 | Сүрөт-caption жубу |
| Cross-reference | clause_ref, table_ref, figure_ref | 2 | Шилтеме берилген элемент |
| Версияга сезимтал суроо | version_of, supersedes, same_identifier | 1 | Активдүү ревизия түйүндөрү |
Бул саясаттын логикасы мындай: “Бир параметр деген эмне?” деген суроо менен “Y сенсору кантип кайра калибрленет?” деген суроо талап кылган документ байланыштары бирдей эмес.
TechDocRAG Суроону Кадам-Кадам Кантип Иштетет?
Онлайн retrieval чынжыры identifier-aware recall менен башталып, суроонун ниетине жараша графты кеңейтүү менен уланат, кеңейтилген талапкерлер семантикалык кыскача мазмун талаасында кайра иреттелет, тандалган түйүндөр чийки далил объекттерине чечмеленет жана байланышкан далилдер контекст бюджети ичинде бир пакетке бириктирилет. Акыркы жооп ушул пакеттин негизинде гана түзүлөт жана ырастоолор provenance байланыштары аркылуу чийки далилге байланат.
1. Identifier-aware recall
Баштапкы талапкерлер жыйындысы булакта төмөнкүдөй аныкталат:
\[ C_{id}= TopK_{v\in V} \left[ \lambda_1 BM25(q,k_v) +\lambda_2 IdMatch(k_q,k_v) +\lambda_3 MetaMatch(q,m_v) \right] \]
BM25 лексикалык дал келүүнү, IdMatch техникалык identifier шайкештигин, ал эми MetaMatch суроо менен metadata шайкештигин баалайт.
2. Байланыш графында кеңейтүү
Баштапкы талапкерлердин суроонун ниетине ылайык коңшулары кошулат:
\[ C_{id}^{e}=C_{id}\cup Expand(C_{id},\Omega(z_q)) \]
\(\Omega(z_q)\) — тиешелүү суроо ниети үчүн кайсы байланыш түрлөрү ээрчилерин аныктаган саясат.
3. Summary-level reranking
Кеңейтилген элементтер семантикалык кыскача мазмун талаасында кайра иреттелет:
\[ C_{sum}=TopL_{v\in C_{id}^{e}} \left[ \alpha \cos(e_q,e_v) +\beta RelScore(v,C_{id}) +\gamma TypePrior(z_q,\tau_v) \right] \]
Мындагы негизги идея — биринчи катмар exact technical anchors үчүн жогорку recall камсыз кылат; экинчи катмар болсо бул талапкерлерди суроонун чыныгы семантикалык максаты боюнча тарытат.
4. Чийки далилди пакеттөө
Кайра иреттелген түйүндөр чийки далилге айландырылат:
\[ C_{raw}=\bigcup_{v\in C_{sum}}Bundle(v) \]
Бир Bundle бир эле текст бөлүгүнөн көбүрөөк нерсени камтышы мүмкүн. Мисалы, бир пункт + ал шилтеме берген таблица; же сүрөт кесиндиси + caption + сүрөткө шилтеме берген абзац бир эле далил пакетинде сакталат.
5. Контекст бюджети
Чийки далилдер контекст бюджети \(B\) ичинде пакеттелет:
\[ E_q=Pack(C_{raw},B) \]
Эксперименттик протоколдо контекст бюджети 2048 текст токени жана multimodal ыкмалар үчүн 10 визуалдык регион катары нормалдаштырылган.
6. Grounded generation жана provenance
Акыркы жооп:
\[ (\hat{y}_q,\Pi_q)=g_\theta(q,E_q) \]
менен түзүлөт.
Ырастоо деңгээлиндеги provenance болсо:
\[ \Pi_q=\{(c_i,U_i)\}_{i=1}^{M}, \qquad U_i\subseteq C_{raw} \]
түрүндө аныкталат. Бул жерде ар бир \(c_i\) түзүлгөн бир ырастоо, ал эми \(U_i\) ошол ырастоону колдогон чийки далил объекттери.
PDFдеги Сүрөт 1 эмнени түшүндүрөт?
Булактагы Сүрөт 1 архитектураны эки негизги бөлүккө бөлөт. Offline index construction тарабында техникалык документтер parse жана canonicalize кылынат, гетерогендик элементтер графы түзүлөт жана identifier index, summary index, raw store менен relation store шайкештирилет. Online query-time тарабында колдонуучунун суроосу талданат, identifier-aware recall жүргүзүлөт, байланыш кеңейтүү жана summary reranking колдонулат, чийки далил пакети түзүлөт жана provenance камтыган жооп чыгарылат.
PDFдеги Сүрөт 2 эмнени кошот?
Сүрөт 2 өзгөчө онлайн чечим агымына көңүл бурат. Суроону identifier жана ниет компоненттерине бөлүү кайсы relation policy тандаларын аныктаарын, retrievalдан кийин байланышкан коңшулар алынарын жана генеративдик моделге өз алдынча фрагменттердин ордуна байланышкан чийки далил пакеттери жөнөтүлөрүн көрсөтөт.
Байланыштарды Сактоо Чындап Эле Натыйжалуулукту Жогорулаттыбы?
Булактагы эксперименттерде TechDocRAG төрт benchmarkтын баарында салыштырылган системалардан жогорку end-to-end упай берген. Эң чоң айырма жөнөкөй пункт издөөдө гана эмес; процедура, текст-таблица, cross-reference жана версияга сезимтал суроолордо байкалган. Бул көрүнүш изилдөөнүн негизги гипотезасына шайкеш: түзүмдүк байланыштардын эң чоң баалуулугу жооп бир нече байланышкан документ объекттерине таянган суроолордо пайда болот.
Төрт benchmark
- MPMQA: Продукт колдонмолорунда multimodal суроо-жооп; PM209 корпусу 209 колдонмону жана 22.021 адам тарабынан белгиленген суроо-жооп жубун камтыйт.
- DesignQA: Formula SAE эрежелери, CAD сүрөттөрү жана инженердик чиймелер боюнча grounded түшүнүү.
- MMLongBench-Doc: 130 узун PDF боюнча 1062 эксперт белгилеген суроо; документтин орточо узундугу 49,4 барак.
- LongDocURL: 33.000ден ашык баракты камтыган 2325 суроо-жооп жубу; түшүнүү, ой жүгүртүү жана жайгашкан жерди табуу тапшырмалары.
Контролдолгон баалоо ушул төрт benchmarkтан тандалган тең салмактуу 7500дөн ашык суроо-жооп жубун колдонгон.
Салыштырылган RAG ыкмалары
TechDocRAG Dense Chunk RAG, Hybrid Dense+BM25, Self-RAG, CRAG, RAPTOR, GraphRAG, LightRAG, HippoRAG 2 жана VisRAG менен салыштырылган.
Адилеттүү салыштыруу үчүн бардык ыкмаларда мүмкүн болушунча бир эле жооп генератору колдонулган: Gemini-3.1-Flash-Lite-Preview. Тышкы веб жеткиликтүүлүгү өчүрүлгөн, CRAG корпус ичиндеги retrieval менен чектелген жана контекст бюджеттери нормалдаштырылган.
TechDocRAG ишке ашыруу деталдары
| Компонент | Конфигурация |
|---|---|
| Документ parser | Layout segmentation, figure-caption alignment жана typed element extraction колдонгон OCR негизиндеги multimodal parser |
| Identifier canonicalization | Пункт IDлери, таблица/сүрөт энбелгилери, параметр аттары жана версия энбелгилери үчүн эрежеге негизделген нормалдаштыруу; суроо учурунда fuzzy matching |
| Identifier index | Нормалдаштырылган identifier, пункт номери, энбелги жана тармактык ачкыч сөздөр боюнча BM25 |
| Summary vector index | all-MiniLM-L6-v2 |
| Query analyzer | TinyLlama-1.1B-Chat-v1.0; batch size 16 |
| Answer generator | Gemini-3.1-Flash-Lite-Preview |
| Relation extraction | Ачык cross-reference parsing + layout heuristics |
| Retrieval | Top-10 identifier recall, 2-hop graph expansion, top-5 summary reranking |
| Context budget | 2048 текст токени + 10 visual region |
| Аппараттык камсыздоо | Single-GPU inference |
Изилдөөнүн Ыкмасы жана Жыйынтыктары
End-to-end жыйынтыктар
| Ыкма | MPMQA | DesignQA | MMLong | LongDoc |
|---|---|---|---|---|
| Dense Chunk RAG | 44,8 | 40,5 | 33,2 | 31,4 |
| Hybrid Dense+BM25 | 48,2 | 44,1 | 36,5 | 34,2 |
| Self-RAG | 51,8 | 47,5 | 39,8 | 37,5 |
| CRAG | 52,4 | 48,8 | 40,5 | 38,2 |
| RAPTOR | 50,5 | 46,2 | 41,4 | 38,8 |
| GraphRAG | 54,8 | 50,5 | 44,8 | 42,4 |
| LightRAG | 55,6 | 51,2 | 46,1 | 43,8 |
| HippoRAG 2 | 56,5 | 52,8 | 47,5 | 45,2 |
| VisRAG | 54,2 | 57,5 | 48,8 | 46,5 |
| TechDocRAG | 68,5 | 62,2 | 58,4 | 55,2 |
Булак төрт benchmarkтын орточо көрсөткүчүндө Hybrid Dense+BM25ке салыштырмалуу 20,3 упай жана VisRAGге салыштырмалуу 9,3 упай айырма билдирет. Булар benchmark упайларынын абсолюттук айырмалары; пайыздык өзгөрүү эмес.
Raw Evidence Hit Rate эмне үчүн маанилүү?
Raw Evidence Hit Rate (REHR) системанын чыныгы алтын-стандарт чийки далил түйүндөрүнүн жок дегенде бирин retrieval натыйжасынын ичинде кармай алган-албаганын өлчөйт:
\[ REHR@K= \frac{1}{|Q|} \sum_{q\in Q} \mathbf{1} \left[ V_q^*\cap\hat{V}_q^{(K)}\neq\varnothing \right] \]
Exact identifier дал келүүсүн талап кылган L0 деңгээлиндеги жыйынтыктар төмөнкүдөй:
| Ыкма | Strict REHR |
|---|---|
| Dense | 0,452 |
| Hybrid | 0,510 |
| TechDocRAG | 0,942 |
Критерий 1-hop, 2-hop, 3-hop жана 4-hop коңшулугуна чейин жумшартылганда TechDocRAG REHR тиешелүүлүгүнө жараша 0,965, 0,984, 0,992 жана 1,000 маанилерине жеткен.
Grounding метрикалары
Изилдөө классикалык Recall@10 жана Mean Reciprocal Rank менен катар техникалык документ байланыштарын баалоо үчүн атайын метрикаларды аныктайт.
Summary-to-Raw Trace Accuracy (SRTA) алынган кыскача мазмун түйүнүн туура чийки далилге чейин көзөмөлдөөгө болобу же жокпу өлчөйт.
Evidence Connectivity Recall (ECR):
\[ ECR= \frac{1}{|Q|} \sum_{q\in Q} \frac{|\hat{E}_q\cap E_q^*|}{|E_q^*|} \]
аркылуу retrieval учурунда зарыл relation edge’дердин канчасы кайра алынганын өлчөйт.
Version Consistency Score (VCS) түзүлгөн ырастоолордун суроого тиешелүү туура документ версиясына таянуу үлүшүн баалайт.
Procedure Order Accuracy (POA) процедуралык суроолордо кадамдардын туура тартиби сакталышын өлчөйт.
Claim Support Rate (CSR) түзүлгөн ырастоолордун жок дегенде бир чийки далил пакети тарабынан колдоого алынуу үлүшүн өлчөйт.
| Ыкма | Recall@10 | MRR | REHR@10 | SRTA | ECR | CSR |
|---|---|---|---|---|---|---|
| Hybrid Dense+BM25 | 45,8 | 0,31 | 0,510 | 0,485 | 0,425 | 0,512 |
| HippoRAG 2 | 58,5 | 0,45 | 0,721 | 0,685 | 0,652 | 0,704 |
| VisRAG | 54,2 | 0,40 | 0,654 | 0,611 | 0,582 | 0,625 |
| TechDocRAG | 69,2 | 0,56 | 0,942 | 0,914 | 0,852 | 0,942 |
Суроо түрүнө жараша натыйжалуулук
TechDocRAG’дин артыкчылыгы жөнөкөй clause же parameter суроолорунда салыштырмалуу чектелүү, бирок документ байланыштарын сактоону талап кылган суроолордо кыйла чоң.
| Суроонун түрү | Hybrid Chunk RAG | TechDocRAG |
|---|---|---|
| Clause | 52,1 | 65,8 |
| Parameter | 48,4 | 64,2 |
| Procedure | 35,2 | 62,1 |
| Text–Table | 31,4 | 60,5 |
| Text–Figure | 28,5 | 58,4 |
| Cross-Reference | 25,1 | 57,2 |
| Version | 22,4 | 54,1 |
| Macro Average | 34,7 | 60,3 |
Абляциялык эксперименттер эмнени көрсөтөт?
| Вариант | Main Score | REHR@10 | ECR | CSR | VCS | POA |
|---|---|---|---|---|---|---|
| Толук модель | 62,5 | 0,94 | 0,85 | 0,82 | 0,78 | 0,75 |
| Relation edge жок | 51,2 | 0,88 | 0,42 | 0,65 | 0,74 | 0,48 |
| Identifier recall жок | 54,8 | 0,65 | 0,72 | 0,75 | 0,68 | 0,65 |
| Summary routing жок | 56,4 | 0,91 | 0,81 | 0,78 | 0,72 | 0,70 |
| Raw bundling жок | 58,2 | 0,92 | 0,83 | 0,45 | 0,75 | 0,72 |
| Intent-aware expansion жок | 55,6 | 0,90 | 0,58 | 0,72 | 0,74 | 0,61 |
| Version metadata жок | 59,4 | 0,93 | 0,84 | 0,81 | 0,32 | 0,74 |
Бул таблица система компоненттеринин ар башка функциялары бар экенин көрсөтөт. Relation edge’дерди алып салуу ECRди 0,85тен 0,42ге түшүрөт. Identifier recall алып салынганда REHR 0,94төн 0,65ке төмөндөйт. Raw bundling алынып салынганда CSR 0,82ден 0,45ке түшөт. Version metadata алынып салынганда VCS 0,78ден 0,32ге чейин төмөндөйт.
Демек, системанын утушу бир эле компоненттен келбейт; exact anchor табуу, түзүмдүк байланыш, семантикалык кайра иреттөө, чийки далилди пакеттөө жана версия metadataсы ар башка ката түрлөрүн бутага алат.
Натыйжалуулук чоңураак эсептөө бюджетинен келип жатабы?
Булактагы профилдөө муну жалгыз түшүндүрмө катары колдобойт.
| Ыкма | Offline indexing | Индекс өлчөмү | Орточо суроо кечигүүсү | Peak GPU эстутуму |
|---|---|---|---|---|
| Dense Chunk RAG | 2,5 s | 2,0 MB | 5,2 ms | ~150 MB |
| Hybrid Dense+BM25 | 3,8 s | 3,5 MB | 7,8 ms | ~180 MB |
| HippoRAG 2 | 12,4 s | 8,2 MB | 45,6 ms | ~450 MB |
| TechDocRAG | 6,36 s | 2,28 MB | 8,3 ms | 314,4 MB |
TechDocRAG’дин offline индекс түзүүсү Hybrid RAGден кымбатыраак; анткени граф жана үчтүк көрсөтүлүш түзүлөт. Ошол эле учурда орточо query latency 8,3 ms болуп, Hybridдин 7,8 ms маанисине жакын жана HippoRAG 2нин 45,6 ms маанисинен кыйла төмөн.
Identifier бузулушуна туруктуулук
Изилдөөнүн robustness экспериментинде OCRге окшош бузулуулар пункт номерлерине, параметр аттарына жана таблица/сүрөт энбелгилерине киргизилген.
| Бузулуу / жоготуу деңгээли | REHR: identifier corruption | ECR: relation dropout |
|---|---|---|
| %0 | 1,0000 | 0,9875 |
| %5 | 1,0000 | 0,9825 |
| %10 | 1,0000 | 0,9725 |
| %20 | 0,0700 | 0,9525 |
| %30 | Маалымдалган эмес | 0,9310 |
Натыйжа асимметриялуу. Relation edge’дердин бир бөлүгү жоголгондо системанын натыйжалуулугу акырындык менен төмөндөсө, техникалык identifierлердин катуу бузулушу кыйла кескин ката жаратат. Бул натыйжа системада граф байланыштары жагынан белгилүү деңгээлде ашыкча камтуулук бар экенин, бирок ал баштапкы retrieval якорунун туура parse кылынышына күчтүү көз каранды бойдон каларын көрсөтөт.
Изилдөөнүн чектөөлөрү
- TechDocRAG документ parser сапатына көз каранды.
- Таблица extraction, caption alignment жана clause numbering каталары relation graphты бузушу мүмкүн.
- Ачык cross-reference’тер кыйыр шилтемелерге караганда ишенимдүүрөөк иштетилет.
- Стандарттуу эмес layout жана адамга түшүнүктүү, бирок машина үчүн көмүскө формалдык белгилер көйгөй жаратышы мүмкүн.
- Документтин ар башка версияларында бир эле identifier ар башка шарттар менен кайра колдонулушу мүмкүн.
- Relation-aware grounding метрикалары далилди кол менен аннотациялоону талап кылат.
- Натыйжалуулук көрсөткүчтөрү белгилүү benchmarkтар, retrieval конфигурациялары жана жалпы жооп генератору шартында алынган.
- Булактын негизги жыйынтык таблицаларында кайталанма эксперименттик дисперсия, ишеним интервалы же классикалык маанилүүлүк тести берилген эмес; ошондуктан упай айырмаларын статистикалык маанилүүлүк катары кеңейтүүгө болбойт.
Практикалык каталарды азайтуу сунуштары
Авторлор сапаты төмөн OCR барактарын confidence-based filtering менен белгилөөнү, көйгөйлүү аймактарды тандалма түрдө кайра parse кылууну жана пункт IDси, таблица энбелгиси, сүрөт энбелгиси жана версия tag’дери үчүн rule-based текшерүүнү колдонууну сунушташат.
Кымбатыраак vision/OCR операцияларын бардык барактарга колдонгондун ордуна ишенимдүүлүгү төмөн аймактарга багыттоо да чыгым жагынан сунушталат. Ишеним дагы эле төмөн болсо, система page-level же region-level retrievalге кайтып, provenanceты белгисиз деп белгилеши мүмкүн.
Изилдөө эмне дейт?
Техникалык документтердеги RAG ийгилигин көбүрөөк текст бөлүгүн retrieval кылуу менен гана түшүндүрүүгө болбойт. Пункт шилтеме берген таблица, сүрөттүн caption’ы, процедуралык кадамдардын тартиби же документтин туура версиясы сыяктуу байланыштарды сактоо answer grounding жана evidence traceability жагынан маанилүү натыйжалуулук өсүшүн камсыздай алат.
Изилдөө эмне дебейт?
TechDocRAG бардык RAG тапшырмаларында абсолюттук эң мыкты ыкма экени көрсөтүлгөн эмес. Натыйжаларды жалпы web QA, эркин формадагы маалымат издөө же байланышы жок текст коллекцияларына түздөн-түз жалпылоого болбойт. Ошондой эле система кемчиликсиз OCR же parsing маселесин чечпейт; тескерисинче, identifier катуу бузулганда анын натыйжалуулугу кескин төмөндөй турганы түз эксперимент менен көрсөтүлгөн.
Булак жана Ыкма Жөнүндө Эскертүү
Түпнуска изилдөө: TechDocRAG: Relation-Preserving Retrieval-Augmented Generation (RAG) for Technical Documents
Авторлор: Seungjoon Lee; Myungryul Choi.
Жооптуу автор: Myungryul Choi.
Мекемелер: Department of EECI Engineering, Hanyang University; Division of Electrical Engineering, Hanyang University, Seoul, Republic of Korea.
Журнал: AI.
Басмакана: MDPI.
Библиографиялык жазуу: AI 2026, 7(5), 161.
DOI: 10.3390/ai7050161
Булак түрү: Изилдөө макаласы.
Жарыялоо процесси: Алынган 15 Март 2026; кайра каралган 21 Апрель 2026; кабыл алынган 27 Апрель 2026; жарыяланган 6 Май 2026.
Лицензия: Creative Commons Attribution (CC BY).
Каржылоо: Изилдөө тышкы каржылоо алган эмес.
Маалыматтын жеткиликтүүлүгү: MPMQA, DesignQA, MMLongBench-Doc жана LongDocURL аттуу жалпыга ачык benchmark маалымат топтомдору колдонулган. Жаңы ири масштабдуу benchmark түзүлгөн эмес. Туунду аннотациялар, promptтар жана ишке ашыруу деталдары биринчи автордон суралышы мүмкүн.
Кызыкчылыктардын кагылышы: Авторлор кызыкчылыктардын кагылышын билдиришкен эмес.
Автордук салымдар: Seungjoon Lee концептуалдаштыруу, методология, программалык камсыздоо, текшерүү, формалдык анализ, изилдөө, ресурстар, маалыматтарды курациялоо, алгачкы долбоор жана визуалдаштырууну жүргүзгөн. Seungjoon Lee менен Myungryul Choi карап чыгуу жана редакциялоону бирге аткарган; Myungryul Choi супервизия жана долбоорду башкаруу үчүн жооптуу болгон.
Салыштыруу ыкмасы: Flat retrieval, adaptive/corrective RAG, hierarchical RAG, graph RAG, memory-oriented RAG жана multimodal retrieval ыкмалары салыштырылган. Мүмкүн болушунча бир эле жооп генератору жана эквиваленттүү далил бюджети колдонулган. CRAG тышкы веб жеткиликтүүлүгү жок corpus-only режиминде бааланган.
Негизги методологиялык чектөө: Отчетто benchmark упайларына байланыштуу классикалык статистикалык маанилүүлүк тесттери, confidence interval же run-to-run вариация берилген эмес. Ошондуктан натыйжалуулук таблицаларын изилдөө протоколунун шартында байкалган салыштырма benchmark жыйынтыктары катары кароо керек.
Verianla мазмун ыкмасы: Бул кыргызча текст булак макаланын сүйлөммө-сүйлөм котормосу эмес. Маселенин аныктамасы, гетерогендик элементтер графы, identifier-summary-raw архитектурасы, математикалык retrieval формулировкасы, query intent саясаттары, benchmark түзүлүшү, evaluation метрикалары, абляциялар, ресурс чыгымы, robustness эксперименттери жана методологиялык чектөөлөр сакталып, өз алдынча кыргызча илимий баяндоо түзүлгөн. Булакта жок натыйжалуулук, статистика же система өзгөчөлүгү кошулган эмес.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген