

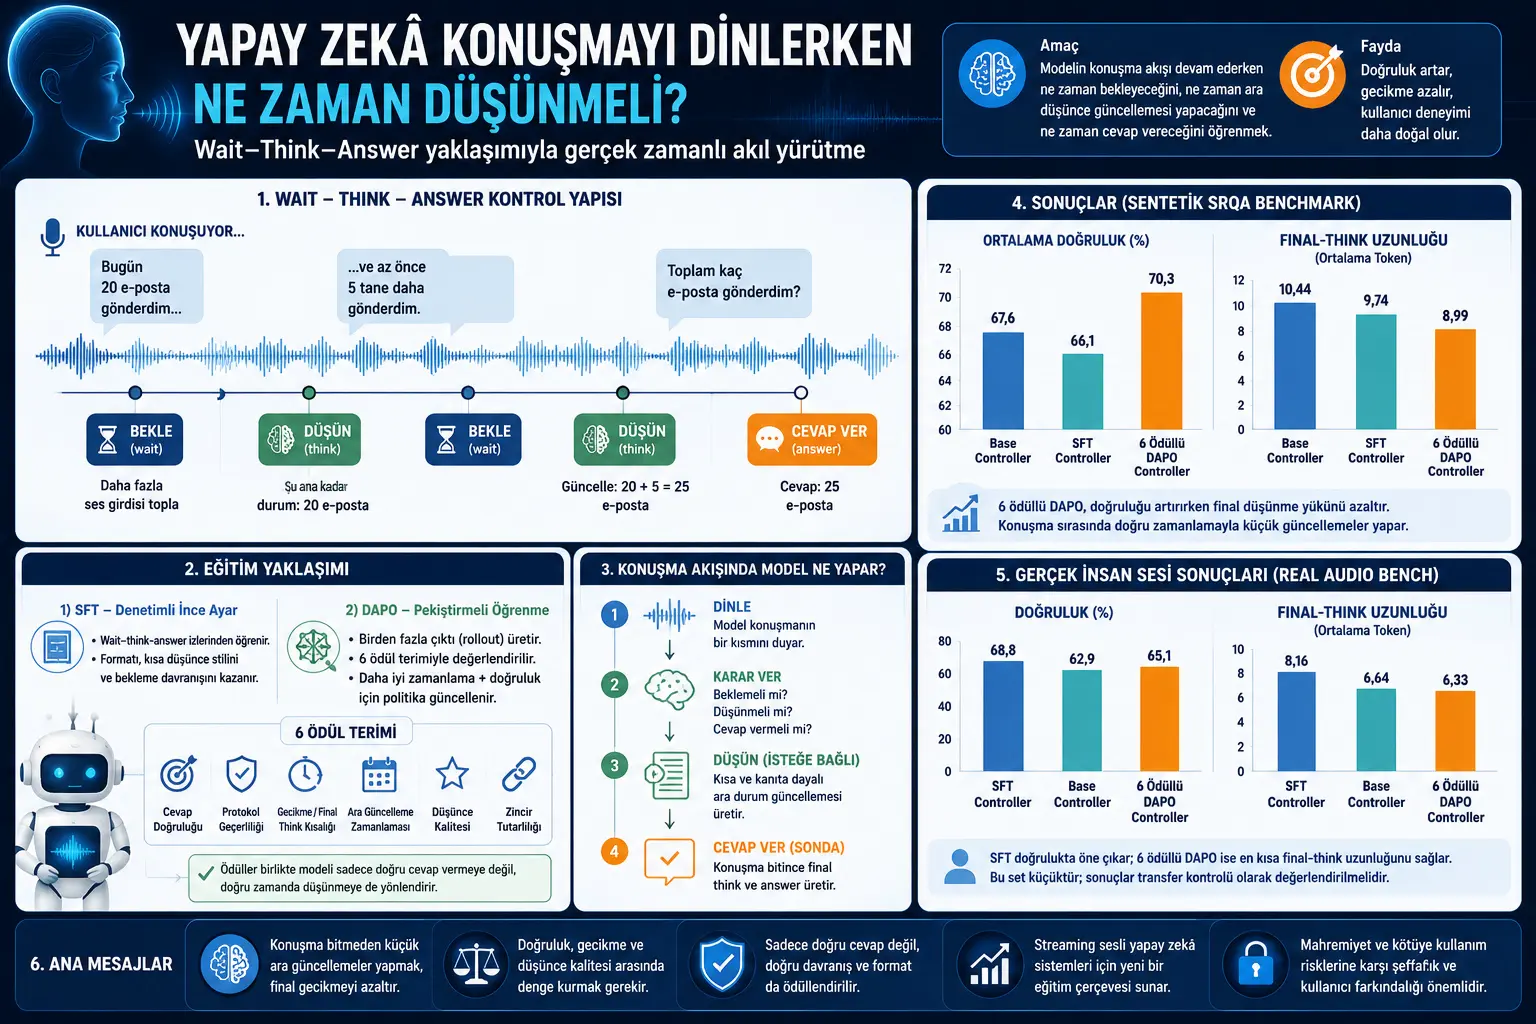
Miundo mikubwa ya sasa ya sauti-lugha inaweza kutambua mazungumzo na kutoa majibu ya maandishi au ya sauti. Hata hivyo, katika mwingiliano wa mazungumzo ya wakati halisi, kutoa jibu sahihi pekee hakutoshi. Ikiwa modeli itajibu kuchelewa sana, mtumiaji hupitia ukimya mrefu. Ikiwa itajibu mapema sana, inaweza kukosa taarifa muhimu inayokuja mwishoni mwa usemi.
Utafiti huu unashughulikia usawazishaji huu kupitia muundo wa udhibiti unaoitwa wait-think-answer. Modeli ina vitendo vitatu vya msingi: kusubiri, kuzalisha fikra/sasisho la kati, na kujibu. Kitendo cha kusubiri huruhusu kukusanya ingizo zaidi la sauti. Kitendo cha think huzalisha sasisho fupi la hali ya kati linalotegemea taarifa iliyosikika hadi wakati huo. Kitendo cha answer hutoa jibu la mwisho.
Mbinu inayopendekezwa inajaribiwa kwenye modeli ya sauti-lugha inayotegemea Qwen2.5-Omni-7B. Kwanza, kupitia uboreshaji unaosimamiwa, yaani SFT, modeli hujifunza lugha hii ya vitendo. Kisha, kwa uboreshaji wa sera unaotegemea reinforcement learning uitwao DAPO, modeli huzawadiwa si kwa kutoa jibu sahihi tu, bali pia kwa kufikiri kwa wakati sahihi, kuepuka fikra ndefu zisizo za lazima, kutoharibu umbizo, na kudumisha uthabiti kati ya jibu na fikra za kati.
Matokeo yanaonyesha kwamba katika miundo ya mazungumzo ya streaming, badala ya kuacha “fikra” zote hadi mwisho, kufanya masasisho madogo na yenye maana wakati wa mazungumzo kunaweza kuboresha usawa kati ya usahihi wa jibu na ucheleweshaji.
Tatizo ni Nini?
Katika mifumo ya kawaida ya maswali na majibu ya sauti, modeli kwa kawaida husikiliza mazungumzo yote ya mtumiaji, kisha hufikiri na kutoa jibu. Njia hii ni rahisi kwa tathmini, kwa sababu modeli huzalisha jibu moja baada ya kuona ingizo lote. Lakini katika uzoefu wa msaidizi wa wakati halisi, hali hii si ya asili.
Katika mazungumzo ya moja kwa moja, mtumiaji huunda sentensi vipande vipande. Wakati mwingine taarifa muhimu huja mwanzoni, wakati mwingine kauli inayokuja mwisho hubadilisha jibu. Kwa mfano, baada ya mtumiaji kusema “Leo nimetuma barua pepe 20…”, ikiwa modeli itajibu mapema inaweza kusema 20; lakini mtumiaji akiendelea kusema “...na sasa hivi nimetuma nyingine 5”, jibu sahihi huwa 25.
Katika hali hii, kuna mvutano wa pande tatu kwa AI ya sauti:
1. Usahihi: Modeli ikijibu kabla ya ushahidi wa kutosha kufika, inaweza kukosea.
2. Ucheleweshaji: Modeli ikisubiri mazungumzo yote yamalizike kisha ifikiri kwa muda mrefu, mtumiaji husubiri.
3. Ubora wa fikra za kati: Ikiwa modeli itafanya masasisho ya kati wakati wa mazungumzo, masasisho hayo yanapaswa kuwa mafupi, sahihi, yanayotegemea ushahidi, na yanayounga mkono jibu linalofuata.
Swali kuu la makala ni hili: Je, modeli kubwa ya sauti-lugha inaweza kujifunza wakati wa kusubiri, wakati wa kutoa sasisho fupi la kati, na wakati wa kutoa jibu la mwisho huku mtiririko wa mazungumzo ukiendelea?
Mbinu Inapendekeza Nini?
Utafiti unaeleza hoja za mazungumzo ya streaming kama tatizo la udhibiti mtandaoni. Wakati wa mtiririko wa sauti, kwenye nyakati fulani za uamuzi, modeli huona kiambishi cha sauti ilichosikia hadi wakati huo na masasisho ya hali ya kati yaliyokwisha kuzalishwa. Kisha huchagua mojawapo ya vitendo vitatu:
<wait/>: Modeli haitoi jibu wala fikra; inasubiri ingizo zaidi la sauti.
<think>...</think>: Modeli huzalisha sasisho fupi la hali ya kati linalotegemea ushahidi uliosikika hadi wakati huo. Hii haimaanishi kwamba modeli inafungua kikamilifu hesabu zake za ndani; ni kutoa noti ya hali inayoonekana, fupi na inayolenga kazi.
<answer>...</answer>: Modeli hutoa jibu la mwisho. Katika utafiti huu, kitendo cha kujibu kimefungwa baada ya mazungumzo; yaani katika majaribio, modeli haijifunzi kutoa jibu la mwisho kabla mazungumzo hayajaisha. Msisitizo mkuu ni muda wa kusubiri na kutoa sasisho za kati wakati wa mazungumzo.
Mbinu hutumia mafunzo ya hatua mbili:
1. SFT, yaani supervised fine-tuning: Modeli hujifunza umbizo la vitendo, mtindo wa fikra fupi, tabia ya kusubiri na muundo wa jibu la mwisho kupitia alama za wait-think-answer zilizoandaliwa.
2. DAPO policy optimization: Baadaye modeli huboreshwa kwa kutumia fungsi ya tuzo. Tuzo haiangalii tu usahihi wa jibu la mwisho. Uhalali wa umbizo, ucheleweshaji wa jibu, muda wa masasisho ya kati, ubora wa fikra na uthabiti wa mnyororo pia hutathminiwa pamoja.
Lengo la mbinu hii ni kuzuia modeli isirundike hoja zote hadi baada ya mazungumzo kuisha. Ikiwa modeli itafanya masasisho mafupi ya kati kadiri taarifa muhimu zinavyofika, mzigo wa fikra unaobaki kabla ya jibu la mwisho unaweza kupungua.
Formuli Zinasema Nini?
Formuli katika PDF zinaeleza muundo wa udhibiti wa wait-think-answer, fungsi ya tuzo na uboreshaji wa DAPO. Formuli zilizo hapa chini zimetolewa kwa namna inayolingana na MathJax.
1. Uchunguzi wa kidhibiti na uteuzi wa kitendo
\[ o_k=(x_{1:t_k},z_{
Hapa \(o_k\), ni uchunguzi wa kidhibiti katika hatua ya uamuzi \(k\). \(x_{1:t_k}\), huwakilisha kiambishi cha sauti kilichosikika hadi wakati huo; \(z_{
2. Tuzo iliyoundwa kwa trajectory halali
Formuli hii inaonyesha jumla ya tuzo kwa mtiririko halali wa wait-think-answer. \(R_a\) huwakilisha usahihi wa jibu, \(R_f\) uhalali wa umbizo, \(R_s\) ucheleweshaji/ufupi wa final-think, \(R_u\) muda wa sasisho za kati, \(R_t\) ubora wa fikra, na \(R_c\) uthabiti kati ya mnyororo wa fikra na jibu la mwisho.
Maelezo muhimu ni haya: bonasi ya uthabiti huanza kutumika tu ikiwa jibu ni sahihi. Hivyo modeli haiwezi kupata tuzo ya ziada kwa kutoa maelezo yenye uthabiti lakini yasiyo sahihi kwa jibu lisilo sahihi.
3. Tuzo ya mwisho iliyodhibitiwa na itifaki
Formuli hii inaonyesha kwamba uhalali wa umbizo/itifaki una kipaumbele. Ikiwa modeli itajibu katika mpangilio usio sahihi, itaharibu lebo zinazohitajika, au itazalisha mlolongo batili wa vitendo, usahihi wa jibu la mwisho hauiokoi. Kwanza, itifaki ya mwingiliano lazima iwe sahihi.
4. Uzito wa tuzo uliotumiwa
Uzito huu unaamua umuhimu wa jamaa wa vipengele vya tuzo. Hasa \(\lambda_u=3.0\) unaonyesha kwamba muda wa sasisho la kati umepewa uzito mkubwa. Yaani, si muhimu tu kwamba modeli izalishe fikra, bali pia izalishe fikra kwa wakati sahihi.
5. Hesabu ya faida ya jamaa ya kundi katika DAPO
Formuli hii huhesabu faida ya jamaa ya rollout ya \(i\) kati ya rollout \(G\) zinazozalishwa kwa prompt ileile. Ikiwa toweo limepata tuzo bora kuliko wastani wa kundi, hupata faida chanya; likiwa baya zaidi, hupata faida hasi. Hii husaidia modeli kujifunza ndani ya kundi ni milolongo ipi ya vitendo iliyo bora zaidi.
6. Lengo la DAPO katika kiwango cha token
Formuli hii inaonyesha sasisho la sera lililokatwa katika kiwango cha token kwa DAPO. \(M\) ni mask ya token za ukamilishaji. \(r_{i,t}\) ni uwiano wa uwezekano kati ya sera mpya na sera ya zamani. Token zenye faida chanya huimarishwa; token zenye faida hasi hudhoofishwa. Kukata huzuia sasisho kukua kupita kiasi.
7. Uwiano wa sera
Usemi huu unaonyesha jinsi uwezekano wa sera mpya kuzalisha token fulani unavyobadilika ikilinganishwa na sera ya zamani. Mabadiliko makubwa huzuiliwa na utaratibu wa kukata. Hii hufanya mafunzo ya RL kuwa thabiti zaidi.
Ujumbe Mkuu wa Grafu, Jedwali na Skema
Figure 1 kwenye ukurasa wa 3: Skema inaonyesha kwamba modeli husikiliza mazungumzo vipande vipande na katika kila hatua ya uamuzi ama husubiri, ama huzalisha sasisho fupi la fikra ya kati, au hatimaye hutoa jibu. Kupitia mfano wa “nilituma barua pepe 20, nikatuma nyingine 5”, inaelezwa kwamba modeli kwanza hushikilia hali ya kati “hadi sasa ni 20”, kisha hujiandaa kwa jibu la mwisho kwa sasisho “20 + 5 = 25”. Ujumbe mkuu: badala ya kuacha fikra zote baada ya mazungumzo, modeli inaweza kukusanya masasisho madogo na sahihi ya hali wakati mazungumzo yanaendelea.
Table 1 kwenye ukurasa wa 5: Vipengele vya tuzo vimefupishwa chini ya vichwa sita: usahihi wa jibu, uhalali wa itifaki, ucheleweshaji, muda wa sasisho la kati, ubora wa fikra na uthabiti wa mnyororo. Jedwali linaonyesha kwamba utafiti hauridhiki na tuzo ya “toa jibu sahihi” pekee; pia unafundisha tabia sahihi katika kipindi chote cha mazungumzo.
Figure 2 kwenye ukurasa wa 6: Inaonyesha jinsi mfumo wa tuzo unavyotathmini mtiririko wa wait-think-answer. Vipengele vya kikanuni hudhibiti umbizo, muda, usahihi na ucheleweshaji wa mwisho; vipengele vinavyosaidiwa na judge hutathmini ubora wa fikra za kati na uthabiti unaounga mkono jibu la mwisho. Ujumbe mkuu: modeli nzuri si ile tu inayotoa jibu sahihi la mwisho, bali ni ile inayofanya masasisho ya kati kwa wakati sahihi, kwa ufupi na kwa manufaa.
Table 2 kwenye ukurasa wa 8: Katika matokeo ya SRQA yenye hotuba sanisi, kidhibiti cha DAPO chenye tuzo sita kinatoa usahihi wa wastani ulio bora zaidi ndani ya familia ya Qwen streaming controller. Base controller inaonyesha wastani wa usahihi wa %67,6 na urefu wa final-think wa token 10,44, huku DAPO yenye tuzo sita ikitoa usahihi wa %70,3 na urefu wa final-think wa token 8,99. Jedwali hili linaonyesha kwamba modeli imeboresha usahihi na mzigo wa residual reasoning kwa pamoja.
Figure 3 kwenye ukurasa wa 8: Usahihi wa kazi kwa kazi wa base controller na DAPO yenye tuzo sita unalinganishwa. DAPO inaonyesha maboresho hasa katika kazi kama ARC-E, SIQA, PIQA na GSM8K. GSM8K inaonyeshwa kwenye paneli tofauti kwa sababu kiwango chake cha jumla cha usahihi hubaki chini kuliko kazi nyingine.
Table 3 kwenye ukurasa wa 9: Matokeo ya Real Audio Bench yanaripotiwa kwenye mifano 186 iliyoundwa kwa rekodi za binadamu. SFT controller inatoa matokeo ya juu zaidi kwa usahihi wa %68,8, huku DAPO yenye tuzo sita ikijitokeza kama lahaja pekee iliyojifunzwa inayozalisha final-think fupi kuliko base controller, ikiwa na usahihi wa %65,1 na urefu wa final-think wa 6,33. Ujumbe mkuu: katika jaribio la sauti halisi ya binadamu, matokeo ni changamano zaidi; usahihi na ucheleweshaji mdogo haviungani kila mara katika lahaja moja.
Figure 4 kwenye ukurasa wa 14: Mikunjo ya mafunzo ya SFT inaonyesha kwamba hasara ya mafunzo na uthibitishaji inapungua na usahihi wa token unaongezeka. Hii inaunga mkono kwamba hatua ya SFT huunda sera ya mwanzo iliyo thabiti kwa DAPO.
Jedwali la ablation kwenye ukurasa wa 18: Kadiri vipengele vya tuzo vinavyoongezwa, usahihi wa SRQA sanisi unaongezeka. Base controller imeripotiwa kuwa %67,6, SFT %66,1, DAPO yenye tuzo nne %68,5, DAPO yenye tuzo tano %69,2, na DAPO yenye tuzo sita %70,3. Jedwali hili linaonyesha mchango wa hatua kwa hatua wa vipengele vya tuzo.
Majaribio Yalifanywaje?
Katika utafiti, mazingira mawili makuu ya tathmini yanatumika.
1. Benchmark ya SRQA yenye hotuba sanisi: Hutumika familia sita za kazi: ARC-Easy, ARC-Challenge, PIQA, SocialIQA, GSM8K na LLaMA-QS. Jumla kuna mifano 8.959. Maswali ya maandishi hubadilishwa kuwa muundo wa mazungumzo, hugeuzwa kuwa sauti kwa TTS, na modeli hutathminiwa kupitia maingizo haya ya sauti.
2. Real Audio Bench: Hutumika benchmark ndogo ya uhamisho inayojumuisha sauti halisi zilizorekodiwa na binadamu. Wazungumzaji watano hurekodi mifano 200 ya wagombea; baada ya kuondoa mifano isiyoeleweka au yenye makosa, rekodi 186 hubaki. Seti hii hutathminiwa si kama utafiti mkubwa wa watumiaji, bali kama udhibiti wa uhamisho nje ya TTS.
Familia ya modeli inayotumika ni Qwen2.5-Omni-7B. Katika hatua ya SFT, uboreshaji hufanywa kwa LoRA. Katika hatua ya DAPO, rollouts za streaming controller huzalishwa, matokeo haya hupimwa kwa vipengele sita vya tuzo, na sera husasishwa katika kiwango cha token.
Katika tathmini kuna itifaki mbili:
Offline mode: Modeli husikiliza mazungumzo yote, kisha hufikiri mara moja na kujibu. Hii ndiyo njia ya kawaida ya tathmini ya sauti kamili.
Deployment mode: Sauti huja katika gridi ya uamuzi ya sekunde 0,5. Katika kila hatua, modeli huona kiambishi cha sauti kilichopo na hali za fikra zinazoonekana zilizotangulia. Kabla mazungumzo hayajaisha, huchagua mojawapo ya vitendo vya kusubiri au kuzalisha fikra ya kati. Mwishoni mwa mazungumzo, huzalisha final think na answer.
Miongoni mwa modeli zinazolinganishwa kuna Qwen2.5-Omni-7B base controller, SFT controller, DAPO controller zenye tuzo nne/tano/sita, Audio Flamingo 3, GLM-4-Voice-9B na lahaja za Moshi zilizoripotiwa kwenye fasihi. Hata hivyo, kwa kuwa modeli za wahusika wengine hazifungui kiolesura kilekile cha streaming controller, ulinganisho wa moja kwa moja wa deployment mode hufanywa tu ndani ya familia ya Qwen.
Matokeo Yanaonyesha Nini?
1. Hoja za sauti za streaming zinaweza kufundishwa kama tatizo la udhibiti. Modeli inaweza kujifunza si tu kuzalisha jibu la mwisho, bali pia wakati wa kusubiri na wakati wa kutoa sasisho fupi la hali ya kati wakati mtiririko wa mazungumzo unaendelea.
2. DAPO yenye tuzo sita inatoa usawa bora zaidi katika benchmark sanisi. Wakati base controller inabaki kwenye usahihi wa wastani wa %67,6, DAPO yenye tuzo sita inapanda hadi %70,3. Wakati huo huo, urefu wa final-think hushuka kutoka token 10,44 hadi 8,99. Hii inaonyesha kwamba sehemu ya fikra inaweza kufanywa mapema na kwa ufupi zaidi wakati wa mazungumzo.
3. SFT peke yake hufundisha umbizo, lakini haitoshi kama tuzo ya kazi. SFT controller hujifunza lugha ya wait-think-answer; lakini katika usahihi wa wastani wa sanisi hubaki nyuma ya base controller. Hatua ya DAPO huinua tena utendaji kwa kutoa tuzo inayolinganishwa na kazi.
4. Katika sauti halisi ya binadamu, matokeo yanapaswa kutafsiriwa kwa tahadhari zaidi. Real Audio Bench ni seti ndogo ya data. SFT hutoa usahihi wa juu zaidi, wakati DAPO yenye tuzo sita hutoa urefu mfupi zaidi wa final-think. Kwa kuwa vipindi vya kujiamini vinaingiliana, seti hii inapaswa kusomwa kama udhibiti wa uhamisho badala ya orodha ya mwisho ya ubora wa modeli.
5. Ucheleweshaji si kasi ya mfumo pekee. Makala hutumia urefu wa final-think kama kiashiria cha mzigo wa hoja unaobaki baada ya mtumiaji kumaliza kuzungumza. Kwa hiyo, ucheleweshaji hapa si muda wa maunzi au huduma tu; pia unahusiana na kiwango ambacho modeli imeacha fikra hadi mwisho.
6. Uzalishaji wa cache-native bado ni eneo la kazi ya baadaye. Makala inabainisha kwamba njia rasmi ya Qwen serving haitoi moja kwa moja kiolesura cha cache-native kwa mzunguko huu wa udhibiti; kwa hiyo, kwenye benchmark hutumiwa full-prefix replay. Ingawa prototipu tofauti inaonyesha kwamba mtiririko huo wa taarifa unaweza kutekelezwa kwa cache-native, haidaiwi kuwa ni mfumo wa mazungumzo ulioboreshwa kwa kiwango cha uzalishaji.
Kwa Nini Hili ni Muhimu?
Wasaidizi wa sauti wa AI wanazidi kuwa wa wakati halisi. Watumiaji sasa hawaandiki tu swali kwenye kisanduku cha maandishi; wanazungumza, wanajirekebisha, wanaanza kwa nusu sentensi na kuongeza taarifa muhimu dakika ya mwisho. Katika mazingira haya, si muhimu tu kwa modeli kutoa majibu mazuri, bali pia kusimamia vizuri mtiririko wa mazungumzo.
Utafiti huu unaweka wazi tatizo la “muda wa kufikiri” katika wasaidizi wa sauti. Ikiwa modeli haifanyi chochote hadi mazungumzo yaishe, inaweza kuhitaji kufikiri kwa muda mrefu baadaye. Ikiwa inafanya masasisho mafupi ya kati yanayotegemea ushahidi wakati mazungumzo yanaendelea, ucheleweshaji wa mwisho unaweza kupungua. Hata hivyo, masasisho hayo hayapaswi kuwa yasiyo ya lazima, marefu au yenye makosa.
Wazo hili ni muhimu kwa wasaidizi wa elimu ya moja kwa moja, zana za ufikivu, tafsiri ya wakati halisi, wasaidizi wa mikutano, mifumo ya msaada wa vituo vya simu na violesura vya mtumiaji vya sauti. Hasa kwa watumiaji wenye ulemavu, wale wanaotumia manukuu ya papo hapo au mifumo ya msaada wa mazungumzo, ucheleweshaji unaweza kuunda tatizo kubwa zaidi la uzoefu wa mtumiaji.
Pia ni muhimu kwa usalama na maadili. Ikiwa mifumo inayoweza kufikiri wakati wa mazungumzo itageuka kuwa zana zinazomsikiliza mtumiaji bila kutambuliwa na kuchambua mazungumzo mapema, inaweza kuleta hatari za faragha na udanganyifu. Kwa sababu hiyo makala hupunguza nafasi ya vitendo kuwa kusubiri/kufikiri/kujibu na huadhibu uzalishaji wa fikra zisizo za lazima.
Mambo ya Kuzingatia
1. Utafiti ni preprint. Matokeo hayapaswi kutathminiwa kana kwamba yana uhakika wa toleo la mwisho lililopitiwa na rika.
2. Huu si mfumo wa uzalishaji ulioboreshwa kikamilifu. Makala hutumia benchmark ya full-prefix replay badala ya cache-native serving. Kwa hiyo, uhandisi wa ziada unahitajika kwa utendaji halisi wa bidhaa.
3. Real Audio Bench ni ndogo. Rekodi 186 hazitoshi kuwakilisha kikamilifu lafudhi, kelele za mazingira, mitindo ya kuzungumza na utofauti wa watumiaji.
4. Uonekanaji wa fikra za kati unapaswa kubuniwa kwa uangalifu. Kuzalisha sasisho za kati zinazoonekana kunaweza kumpa mtumiaji uelezekaji; lakini maoni ya kati yasiyo ya lazima au yasiyo sahihi yanaweza kumpotosha mtumiaji.
5. Jibu la mwisho limefungwa baada ya mazungumzo. Katika utafiti huu, lengo kuu la kujifunza si modeli kutoa jibu la mwisho kabla mazungumzo hayajaisha. Msisitizo mkuu ni muda wa masasisho ya fikra za kati wakati wa mazungumzo.
6. Mazungumzo ya binadamu yana utofauti mkubwa. Kusita, lafudhi, kuzungumza haraka, kelele, kubadilisha mada na sentensi zisizokamilika vinaweza kufanya tabia ya modeli kuwa ngumu katika matumizi halisi.
7. Kuna hatari ya faragha na matumizi mabaya. Mifumo inayochambua mazungumzo ya sehemu haipaswi kutumika bila uelewa wa mtumiaji na mifumo ya ruhusa. Katika uchambuzi wa mazungumzo ya wakati halisi, taarifa wazi na mipaka ya usalama ni muhimu.
Dokezo la eneo hatarishi: Utafiti unahusu mifumo ya AI inayosikiliza mazungumzo kwa wakati halisi na kufanya masasisho ya hoja za kati kupitia ingizo la sauti la sehemu. Mifumo ya aina hii inaweza kuwa na manufaa kwa ufikivu, tafsiri ya moja kwa moja, elimu na wasaidizi wa sauti; lakini pia inaweza kuleta hatari kama kufuatilia mazungumzo bila ufahamu wa mtumiaji, uhandisi wa kijamii au ukiukaji wa faragha. Makala hii inalenga kutoa taarifa za kiufundi.
Tathmini ya jumla: Makala inalenga tatizo muhimu la wasaidizi wa sauti wa AI: je, modeli inapaswa kusubiri wakati mtumiaji anazungumza, kufanya sasisho la taarifa ya kati, au kujibu mara moja? Katika mazungumzo ya binadamu, msikilizaji mara nyingi hujiandaa kujibu kabla mazungumzo hayajaisha. Utafiti huu unapeleka wazo hilo kwenye miundo mikubwa ya sauti-lugha na kushughulikia swali “inapaswa kufikiri lini wakati inasikiliza?” kama tatizo la udhibiti linaloweza kujifunzwa.
Hitimisho
Makala hii inachunguza swali muhimu kwa miundo mikubwa ya sauti-lugha: modeli inapaswa kufikiri lini wakati inasikiliza mazungumzo? Katika mbinu ya kawaida, modeli husubiri sauti yote, kisha hufikiri na kujibu. Lakini katika mazungumzo ya wakati halisi, mbinu hii inaweza kuunda ucheleweshaji. Kujibu mapema pia kunaweza kusababisha makosa.
Udhibiti wa wait-think-answer huleta fremu ya vitendo kwa usawa huu. Wakati wa mazungumzo, modeli huchagua kati ya kusubiri na kutoa sasisho fupi la hali ya kati. Kadiri taarifa muhimu zinavyofika, hukusanya masasisho madogo ya fikra yanayolenga kazi. Hivyo mzigo wa fikra unaobaki katika hatua ya jibu la mwisho unaweza kupungua.
Matokeo yanaonyesha kwamba kidhibiti cha DAPO chenye tuzo sita huongeza usahihi na kupunguza urefu wa final-think kwenye benchmark sanisi yenye hotuba. Katika jaribio la sauti halisi ya binadamu, matokeo ni ya tahadhari zaidi: vidhibiti vilivyojifunzwa vinafanya kazi, lakini usahihi na fikra fupi ya mwisho haviungani kila mara katika lahaja moja.
Kwa msomaji wa Verianla, ujumbe mkuu ni huu: wasaidizi wa sauti wa AI wa baadaye watalazimika kujifunza si tu “watajibu nini”, bali pia “wakati mazungumzo yanaendelea watasubiri lini, watafanya sasisho fupi lini na watajibu lini”. Utafiti huu unalifanya tatizo hilo la muda kuwa kazi ya udhibiti inayoweza kupimwa na kufundishwa.
Dokezo la Chanzo na Mbinu
Makala hii ni maudhui asilia ya kiharikiri ya Kituruki yaliyotayarishwa kwa msingi wa PDF ya kitaaluma yenye kichwa “Learning When to Think While Listening in Large Audio-Language Models”. Si tafsiri ya neno kwa neno; tatizo, mbinu, formuli, vielelezo, majedwali, itifaki ya majaribio, matokeo na mipaka ya utafiti vimefafanuliwa kwa lugha rahisi.
Katika makala hii, neno “kufikiri” linaeleza uzalishaji wa sasisho fupi la hali linaloonekana kwa mtumiaji; halipaswi kutathminiwa kama sawa kabisa na fikra ya binadamu katika ulimwengu halisi.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *