

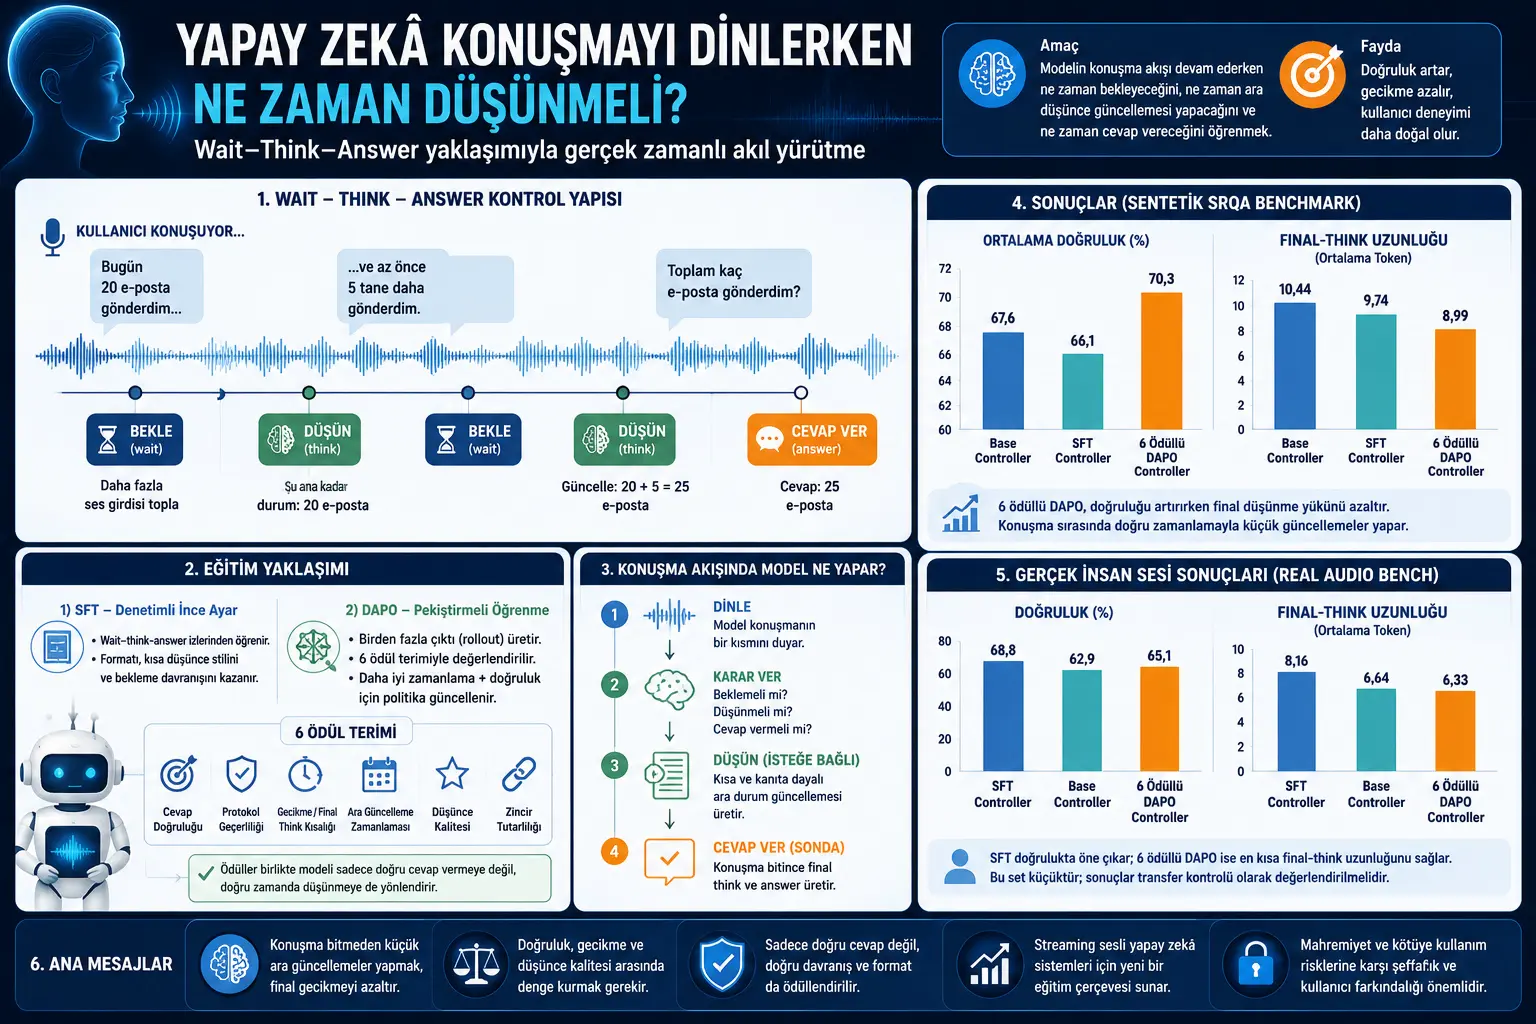
Азыркы чоң аудио-тил моделдери сүйлөөнү кабыл алып, тексттик же үн менен жооп чыгара алат. Бирок реалдуу убакыттагы сүйлөшүүдө туура жооп берүү гана жетишсиз. Модель өтө кеч жооп берсе, колдонуучу узак тыныгууга туш болот. Өтө эрте жооп берсе, сүйлөөнүн аягында келген маанилүү маалыматты өткөрүп жибериши мүмкүн.
Бул изилдөө ушул тең салмакты wait-think-answer деп аталган башкаруу түзүмү аркылуу карайт. Моделдин үч негизги аракети бар: күтүү, аралык ой/жаңыртуу чыгаруу жана жооп берүү. Күтүү аракети көбүрөөк аудио киришти чогултууга мүмкүнчүлүк берет. Think аракети ошол учурга чейин угулган маалыматка таянган кыска аралык абал жаңыртуусун чыгарат. Answer аракети болсо акыркы жоопту берет.
Сунушталган ыкма Qwen2.5-Omni-7B негизиндеги аудио-тил моделинде сыналат. Адегенде supervised fine-tuning, башкача айтканда SFT аркылуу модель бул аракет тилин үйрөнөт. Андан кийин DAPO деп аталган reinforcement learning негизиндеги policy optimization менен модель туура жооп бергени үчүн гана эмес; туура учурда ой жүгүрткөнү, керексиз узак ойлонбогону, форматты бузбаганы жана жооп менен аралык ойлордун ортосунда ырааттуулук түзгөнү үчүн да сыйлык алат.
Жыйынтыктар streaming сүйлөшүү моделдеринде “ой жүгүртүүнү аягына калтыруунун” ордуна, сүйлөшүү учурунда кичине жана маанилүү аралык жаңыртууларды жасоо жооптун тактыгы менен кечигүүнүн ортосундагы тең салмакты жакшырта аларын көрсөтөт.
Көйгөй эмнеде?
Классикалык үн менен суроо-жооп системаларында модель адатта колдонуучунун сүйлөгөнүн толугу менен угат, андан кийин ойлонуп, жооп берет. Бул ыкма баалоо үчүн ыңгайлуу, анткени модель бүт киришти көргөндөн кийин бир жооп чыгарат. Бирок реалдуу убакыттагы ассистент тажрыйбасында бул табигый эмес.
Жандуу сүйлөшүүдө колдонуучу сүйлөмүн бөлүк-бөлүк курат. Кээде маанилүү маалымат башында келет, кээде акыркы учурда келген сөз жоопту өзгөртөт. Мисалы, колдонуучу “Бүгүн 20 электрондук кат жөнөттүм...” дегенден кийин модель эрте жооп берсе 20 деп айтышы мүмкүн; бирок колдонуучу “...жана азыр эле дагы 5 жөнөттүм” деп улантса, туура жооп 25 болот.
Мындай учурда үн менен иштеген жасалма интеллект үчүн үч тараптуу чыңалуу пайда болот:
1. Тактык: Модель жетиштүү далил келбей туруп жооп берсе, жаңылышышы мүмкүн.
2. Кечигүү: Модель бүт сүйлөшүү бүткөндөн кийин узак ойлонсо, колдонуучу күтөт.
3. Аралык ой жүгүртүүнүн сапаты: Модель сүйлөшүү учурунда аралык жаңыртуу жасай турган болсо, бул жаңыртуулар кыска, туура, далилге байланган жана кийинки жоопту колдогон болушу керек.
Макаланын негизги суроосу мындай: чоң аудио-тил модели сүйлөшүү агымы уланып жатканда качан күтүү керектигин, качан кыска аралык жаңыртуу жасоо керектигин жана качан акыркы жооп берүү керектигин үйрөнө алабы?
Ыкма эмнени сунуштайт?
Изилдөө streaming сүйлөшүүдө ой жүгүртүүнү online башкаруу көйгөйү катары аныктайт. Модель аудио агымынын жүрүшүндө белгилүү чечим учурларында ошол учурга чейин уккан аудио префиксин жана мурда чыгарган аралык абал жаңыртууларын көрөт. Анан үч аракеттин бирин тандайт:
<wait/>: Модель жооп же ой чыгарбайт, көбүрөөк аудио киришти күтөт.
<think>...</think>: Модель ошол учурга чейин угулган далилге таянган кыска аралык абал жаңыртуусун чыгарат. Бул моделдин ички эсептөөлөрүн толугу менен ачуу дегенди билдирбейт; системанын көрүнгөн, кыска жана тапшырмага багытталган абал эскертмесин чыгаруусу.
<answer>...</answer>: Модель акыркы жоопту берет. Бул изилдөөдө жооп берүү аракети сүйлөө аяктагандан кийинки этапка чектелген; башкача айтканда эксперименттерде модель сүйлөө бүтө электе акыркы жооп берүүнү үйрөнбөйт, негизги көңүл сүйлөшүү учурунда күтүү жана аралык жаңыртуунун убактысына бурулат.
Ыкма эки баскычтуу окутууну колдонот:
1. SFT, башкача айтканда supervised fine-tuning: Модель даярдалган wait-think-answer издери аркылуу аракет форматын, кыска ой жүгүртүү стилин, күтүү жүрүм-турумун жана акыркы жооп түзүмүн үйрөнөт.
2. DAPO policy optimization: Андан кийин модель сыйлык функциясы менен оптималдаштырылат. Сыйлык акыркы жооптун тууралыгына гана карабайт. Форматтын жарактуулугу, жооп кечигүүсү, аралык жаңыртуунун убактысы, ой жүгүртүүнүн сапаты жана чынжыр ырааттуулугу да бирге бааланат.
Бул ыкманын максаты — моделдин бүт ой жүгүртүүнү сүйлөшүү бүткөндөн кийинки этапка топтоп коюшуна жол бербөө. Эгер модель маанилүү маалымат келген сайын кыска аралык жаңыртууларды жасап турса, акыркы жооптун алдында калган ой жүгүртүү жүгүн азайтууга болот.
Формулалар эмнени түшүндүрөт?
PDF’теги формулалар wait-think-answer башкаруу түзүмүн, сыйлык функциясын жана DAPO оптималдаштыруусун түшүндүрөт. Төмөнкү формулалар MathJax менен шайкеш түрдө берилген.
1. Controller байкоосу жана аракет тандоо
\[ o_k=(x_{1:t_k},z_{
Бул жерде \(o_k\) — \(k\)-чечим учурундагы controller байкоосу. \(x_{1:t_k}\) ошол учурга чейин угулган аудио префиксин; \(z_{
2. Жарактуу trajectory үчүн калыптандырылган сыйлык
Бул формула жарактуу wait-think-answer агымы үчүн жалпы сыйлыкты көрсөтөт. \(R_a\) жооптун тактыгын, \(R_f\) форматтын жарактуулугун, \(R_s\) кечигүү/final-think кыскалыгын, \(R_u\) аралык жаңыртуунун убактысын, \(R_t\) ой жүгүртүүнүн сапатын, \(R_c\) болсо ой чынжыры менен акыркы жооптун ортосундагы ырааттуулукту билдирет.
Маанилүү жагы мындай: ырааттуулук бонусу жооп туура болгондо гана иштейт. Башкача айтканда модель туура эмес жоопко ырааттуу, бирок жаңылыш түшүндүрмө бергени үчүн кошумча сыйлык ала албайт.
3. Протокол менен чектелген акыркы сыйлык
Бул формула формат/протокол жарактуулугу биринчи орунда экенин көрсөтөт. Эгер модель туура эмес тартипте жооп берсе, керектүү тегдерди бузса же жараксыз аракеттер тизмегин чыгарса, акыркы жооптун туура болушу аны куткарбайт. Алгач өз ара аракеттенүү протоколу туура болушу керек.
4. Колдонулган сыйлык салмактары
Бул салмактар сыйлык компоненттеринин салыштырмалуу маанисин аныктайт. Айрыкча \(\lambda_u=3.0\), аралык жаңыртуунун убактысына чоң салмак берилгенин көрсөтөт. Демек моделдин ой чыгарышы гана эмес, аны туура учурда чыгарышы да маанилүү.
5. DAPO топко салыштырмалуу advantage эсеби
Бул формула бир эле prompt үчүн чыгарылган \(G\) rollout арасындагы \(i\)-rolloutтун салыштырмалуу advantage маанисин эсептейт. Эгер чыгарылыш топтун орточосунан жогору сыйлык алса, оң advantage алат; начарыраак болсо терс advantage алат. Бул моделге кайсы аракет тизмектери жакшыраак экенин топ ичинде үйрөнүүгө жардам берет.
6. Token деңгээлиндеги DAPO максаты
Бул формула DAPO’нун token деңгээлиндеги clipped policy update процессин көрсөтөт. \(M\) completion tokenдарынын маскасы. \(r_{i,t}\) жаңы policy менен эски policy ортосундагы ыктымалдык катышы. Оң advantage’га ээ tokenдар күчөтүлөт; терс advantage’га ээ tokenдар алсыратылат. Clipping жаңыртуунун өтө чоң болуп кетишин чектейт.
7. Policy катышы
Бул туюнтма жаңы policy’нин белгилүү tokenды чыгаруу ыктымалдыгы эски policy’ге салыштырмалуу канчалык өзгөргөнүн көрсөтөт. Чоң өзгөрүүлөр clipping механизми менен чектелет. Бул RL окутуусун туруктуураак кылат.
График, таблица жана схеманын негизги билдирүүсү
3-беттеги Figure 1: Схема модель сүйлөшүүнү бөлүк-бөлүк угарын жана ар бир чечим кадамында же күтөрүн, же кыска аралык ой жаңыртуусун жасарын, же эң аягында жооп берерин көрсөтөт. “20 электрондук кат жөнөттүм, дагы 5 жөнөттүм” мисалында модель адегенде “азырынча 20” деген аралык абалды кармап, андан кийин “20 + 5 = 25” жаңыртуусу менен акыркы жоопко даярданары түшүндүрүлөт. Негизги билдирүү: модель бүт ой жүгүртүүнү сүйлөшүүдөн кийинкиге калтырбай, сүйлөшүү учурунда кичине жана туура абал жаңыртууларын топтой алат.
5-беттеги Table 1: Сыйлык терминдери алты баштыкта жыйынтыкталат: жооптун тактыгы, протокол жарактуулугу, кечигүү, аралык жаңыртуунун убактысы, ой жүгүртүүнүн сапаты жана чынжыр ырааттуулугу. Таблица изилдөө “туура жооп бер” сыйлыгы менен гана чектелбей, сүйлөшүү бою туура жүрүм-турум формасын да үйрөтөрүн көрсөтөт.
6-беттеги Figure 2: Сыйлык системасы wait-think-answer агымын кантип баалаары көрсөтүлөт. Эрежеге негизделген терминдер форматты, убакытты, тактыкты жана акыркы кечигүүнү текшерет; judge колдогон терминдер болсо аралык ойдун сапатын жана акыркы жоопту колдогон ырааттуулукту баалайт. Негизги билдирүү: жакшы модель туура акыркы жооп берген гана эмес; туура учурда кыска жана пайдалуу аралык жаңыртууларды жасаган модель.
8-беттеги Table 2: Синтетикалык сүйлөшүү SRQA жыйынтыктарында алты сыйлыктагы DAPO controller Qwen streaming controller үй-бүлөсүндө эң жакшы орточо тактыкты берет. Base controller орточо %67,6 тактык жана 10,44 final-think token узундугун көрсөтсө, алты сыйлыктагы DAPO %70,3 тактык жана 8,99 final-think узундугун берет. Бул таблица модель тактык жана residual reasoning жүгү боюнча да жакшырганын көрсөтөт.
8-беттеги Figure 3: Base controller менен алты сыйлыктагы DAPO’нун тапшырма боюнча тактыктары салыштырылат. DAPO айрыкча ARC-E, SIQA, PIQA жана GSM8K сыяктуу тапшырмаларда жакшырууну көрсөтөт. GSM8K өзүнчө панелде берилет, анткени жалпы тактык деңгээли башка тапшырмаларга салыштырмалуу төмөн бойдон калат.
9-беттеги Table 3: Real Audio Bench жыйынтыктары адамдар жаздырган 186 үлгү боюнча берилет. SFT controller %68,8 тактык менен эң жогорку натыйжаны берсе, алты сыйлыктагы DAPO %65,1 тактык жана 6,33 final-think узундугу менен base controller’дан кыскараак акыркы ой жүгүртүү чыгарган жалгыз үйрөтүлгөн вариант катары айырмаланат. Негизги билдирүү: чыныгы адам үнүндөгү тестте натыйжалар татаалыраак; тактык менен аз кечигүү дайыма бир эле вариантта бирикпейт.
14-беттеги Figure 4: SFT окутуу ийри сызыктары окутуу жана валидация жоготуусунун азайганын, token тактыгынын өскөнүн көрсөтөт. Бул SFT баскычы DAPO үчүн бекем баштапкы policy түзгөнүн колдойт.
18-беттеги ablation таблицасы: Сыйлык компоненттери көбөйгөн сайын синтетикалык SRQA тактыгы жогорулайт. Base controller %67,6, SFT %66,1, төрт сыйлыктагы DAPO %68,5, беш сыйлыктагы DAPO %69,2, алты сыйлыктагы DAPO %70,3 деп билдирилет. Бул таблица сыйлык компоненттеринин этап-этабы менен кошкон салымын көрсөтөт.
Эксперименттер кандай жүргүзүлгөн?
Изилдөөдө эки негизги баалоо чөйрөсү колдонулат.
1. Синтетикалык сүйлөшүү SRQA benchmark: ARC-Easy, ARC-Challenge, PIQA, SocialIQA, GSM8K жана LLaMA-QS болуп алты тапшырма үй-бүлөсү колдонулат. Жалпы 8.959 үлгү бар. Тексттик суроолор сүйлөшүү формасына айландырылып, TTS аркылуу үнгө өткөрүлөт жана модель ушул аудио кириштер аркылуу бааланат.
2. Real Audio Bench: Адамдар жаздырган чыныгы үндөрдөн турган кичине transfer benchmark колдонулат. Беш сүйлөөчү 200 талапкер үлгү жаздырат; бүдөмүк же ката үлгүлөр чыгарылгандан кийин 186 жазуу калат. Бул топтом чоң масштабдагы колдонуучу изилдөөсү эмес, TTS’тен тышкары transfer текшерүүсү катары бааланат.
Модель үй-бүлөсү катары Qwen2.5-Omni-7B колдонулат. SFT баскычында LoRA менен fine-tuning жүргүзүлөт. DAPO баскычында streaming controller rolloutтары чыгарылып, бул чыгыштар алты сыйлык компоненти менен бааланат жана policy token деңгээлинде жаңыртылат.
Баалоодо эки протокол бар:
Offline mode: Модель толук сүйлөөнү уккандан кийин бир жолу ойлонуп, жооп берет. Бул классикалык full-audio баалоо формасы.
Deployment mode: Аудио 0,5 секунддук чечим торунда келет. Модель ар бир кадамда учурдагы аудио префиксин жана мурдагы көрүнгөн ой абалдарын көрөт. Сүйлөө бүтө электе күтүү же аралык ой чыгаруу аракеттеринин бирин тандайт. Сүйлөө соңунда final think жана answer чыгарат.
Салыштырылган моделдердин арасында Qwen2.5-Omni-7B base controller, SFT controller, төрт/беш/алты сыйлыктагы DAPO controller, Audio Flamingo 3, GLM-4-Voice-9B жана адабиятта билдирилген Moshi варианттары бар. Бирок үчүнчү тарап моделдери бирдей streaming controller интерфейсин ачпагандыктан, түз deployment mode салыштыруу Qwen үй-бүлөсүнүн ичинде гана жүргүзүлөт.
Жыйынтыктар эмнени көрсөтөт?
1. Streaming үн reasoningин башкаруу көйгөйү катары үйрөтүүгө болот. Модель акыркы жоопту чыгарууну гана эмес, сүйлөшүү агымында качан күтүү жана качан кыска аралык абал жаңыртуусун жасоо керектигин да үйрөнө алат.
2. Алты сыйлыктагы DAPO синтетикалык benchmark’та эң жакшы тең салмакты берет. Base controller %67,6 орточо тактыкта калса, алты сыйлыктагы DAPO %70,3кө чыгат. Ошол эле учурда final-think узундугу 10,44төн 8,99 tokenга түшөт. Бул ой жүгүртүүнүн бир бөлүгү сүйлөшүү учурунда эртерээк жана кыска формада аткарылышы мүмкүн экенин көрсөтөт.
3. SFT өзү форматты үйрөткөнү менен, тапшырма сыйлыгындай жетиштүү эмес. SFT controller wait-think-answer тилин үйрөнөт; бирок синтетикалык орточо тактыкта base controller’дан артта калат. DAPO баскычы тапшырмага шайкеш сыйлык берип, натыйжалуулукту кайра жогорулатат.
4. Чыныгы адам үнүндөгү жыйынтыктар этият чечмелениши керек. Real Audio Bench кичине dataset. SFT эң жогорку тактыкты берет, алты сыйлыктагы DAPO болсо эң кыска final-think узундугун камсыздайт. Ишеним интервалдары бири-бирине дал келгендиктен, бул топтом так модель рейтингинен көрө transfer текшерүүсү катары окулушу керек.
5. Кечигүү — системанын ылдамдыгы гана эмес. Макала final-think узундугун колдонуучунун сүйлөөсү бүткөндөн кийин калган reasoning жүгүнүн көрсөткүчү катары колдонот. Башкача айтканда, бул жерде кечигүү аппараттык же сервис убактысы гана эмес, модель ой жүгүртүүнүн канчасын акырына калтырганы менен да байланыштуу.
6. Cache-native өндүрүш дагы эле келечектеги иш багыты. Макала расмий Qwen serving жолу бул башкаруу цикли үчүн түз cache-native интерфейс бербегенин; ошондуктан benchmark’та full-prefix replay колдонулганын белгилейт. Өзүнчө прототип ошол эле маалымат агымын cache-native ыкмада ишке ашырууга болорун көрсөтсө да, production деңгээлинде оптималдаштырылган сүйлөшүү системасы бар деп айтылбайт.
Бул эмне үчүн маанилүү?
Үн менен иштеген жасалма интеллект ассистенттери барган сайын реалдуу убакытка жакындап жатат. Колдонуучулар эми текст талаасына суроо жазуу менен эле чектелбейт; алар сүйлөйт, оңдойт, жарым сүйлөм менен баштайт жана акыркы учурда маанилүү маалымат кошот. Мындай чөйрөдө модель жакшы жооп гана чыгарбастан, сүйлөшүү агымын да жакшы башкарууга тийиш.
Бул изилдөө үн ассистенттериндеги “ой жүгүртүүнүн убактысы” көйгөйүн көрүнүктүү кылат. Модель сүйлөшүү бүткөнгө чейин эч нерсе кылбаса, кийин узак ойлонушу мүмкүн. Сүйлөшүү уланып жатканда кыска, далилге таянган аралык жаңыртууларды жасаса, акыркы кечигүү азайышы мүмкүн. Бирок бул жаңыртуулар керексиз, узак же туура эмес болбошу керек.
Бул идея жандуу билим берүү ассистенттери, жеткиликтүүлүк куралдары, реалдуу убакыттагы котормо, жыйын ассистенттери, call-center колдоо системалары жана үн колдонуучу интерфейстери үчүн маанилүү. Айрыкча мүмкүнчүлүгү чектелген колдонуучулар, реалдуу убакыттагы субтитр же сүйлөөнү колдоо системаларын колдонгондор үчүн кечигүү чоңураак колдонуучу тажрыйбасы көйгөйүн жаратышы мүмкүн.
Мындан тышкары, бул коопсуздук жана этика жагынан да маанилүү. Сүйлөшүү учурунда ойлонгон системалар колдонуучу байкабай турган түрдө угуп, сүйлөөнү алдын ала талдаган куралга айланса, купуялуулук жана манипуляция тобокелдиги жаралышы мүмкүн. Макала ошондуктан аракет мейкиндигин күтүү/ойлонуу/жооп берүү менен чектеп, керексиз ой чыгарууну жазалайт.
Көңүл буруучу жагдайлар
1. Изилдөө preprint. Жыйынтыктар акыркы рецензияланган версиянын тактыгы менен бааланбашы керек.
2. Бул толук оптималдаштырылган production системасы эмес. Макала cache-native serving ордуна full-prefix replay негизиндеги benchmark колдонот. Ошондуктан реалдуу продукт натыйжалуулугу үчүн кошумча инженердик иш керек.
3. Real Audio Bench кичине. 186 жазуу акценттерди, айлана-чөйрө ызы-чуусун, сүйлөө стилин жана колдонуучулардын ар түрдүүлүгүн толук чагылдырууга жетишсиз.
4. Аралык ойдун көрүнүшү этият долбоорлонууга тийиш. Моделдин көрүнгөн аралык жаңыртуу чыгарышы колдонуучуга түшүндүрмөлүүлүк бере алат; бирок керексиз же туура эмес аралык комментарийлер колдонуучуну адаштырышы мүмкүн.
5. Акыркы жооп сүйлөө аяктагандан кийинки этапка чектелген. Бул изилдөөдө модель сүйлөө бүтө электе акыркы жооп берүүнү үйрөнүү негизги максат эмес. Негизги көңүл сүйлөшүү учурунда аралык ой жаңыртууларынын убактысына бурулат.
6. Адамдын сүйлөөсү өтө ар түрдүү. Тыныгуулар, акценттер, тез сүйлөө, ызы-чуу, теманы өзгөртүү жана жарым сүйлөмдөр реалдуу колдонууда моделдин жүрүм-турумун татаалдаштырышы мүмкүн.
7. Купуялуулук жана туура эмес пайдалануу тобокелдиги бар. Жарым-жартылай сүйлөөнү талдаган системалар колдонуучунун маалымдуулугу жана уруксат механизмдерисиз колдонулбашы керек. Реалдуу убакыттагы сүйлөшүү анализинде ачык маалымат берүү жана коопсуздук чектери маанилүү.
Тобокелдүү тармак боюнча эскертүү: Изилдөө сүйлөөнү реалдуу убакытта угуп, жарым-жартылай аудио кириштин негизинде аралык reasoning жаңыртууларын жасаган жасалма интеллект системаларына байланыштуу. Мындай системалар жеткиликтүүлүк, жандуу котормо, билим берүү жана үн ассистенттери үчүн пайдалуу болушу мүмкүн; бирок колдонуучунун маалымдуулугусуз сүйлөөнү көзөмөлдөө, social engineering же купуялуулукту бузуу сыяктуу тобокелдиктерди да жаратышы мүмкүн. Бул жазуу техникалык маалымат берүү максатында.
Жалпы баалоо: Макала үн менен иштеген жасалма интеллект ассистенттеринин маанилүү көйгөйүнө көңүл бурат: колдонуучу сүйлөп жатканда модель күтүшү керекпи, аралык маалымат жаңыртуусун жасашы керекпи же дароо жооп бериши керекпи? Адамдык сүйлөшүүдө угуучу көбүнчө сүйлөө бүтө электе жоопко даярдана баштайт. Бул изилдөө окшош идеяны чоң аудио-тил моделдерине алып келип, “угуп жатканда качан ойлонуу керек?” деген суроону үйрөнүлө турган башкаруу көйгөйү катары карайт.
Жыйынтык
Бул макала чоң аудио-тил моделдери үчүн маанилүү суроону карайт: модель сүйлөөнү угуп жатканда качан ойлонушу керек? Классикалык ыкмада модель бүт аудиону күтөт, андан кийин ойлонуп, жооп берет. Бирок реалдуу убакыттагы сүйлөшүүдө бул ыкма кечигүү жаратышы мүмкүн. Эрте жооп болсо катага алып келиши мүмкүн.
Wait-think-answer башкаруусу бул тең салмакка практикалык алкак сунуштайт. Модель сүйлөшүү учурунда күтүү менен кыска аралык абал жаңыртуусунун ортосунда тандоо жасайт. Маанилүү маалымат келген сайын кичине жана тапшырмага багытталган ой жаңыртууларын топтойт. Ошентип акыркы жооп баскычында калган ой жүгүртүү жүгү азайышы мүмкүн.
Жыйынтыктар алты сыйлыктагы DAPO controller синтетикалык сүйлөшүү benchmark’ында тактыкты да жогорулатып, final-think узундугун да кыскартканын көрсөтөт. Чыныгы адам үнүндөгү тестте болсо жыйынтыктар этиятыраак: үйрөтүлгөн controllerлер иштейт, бирок тактык менен кыска акыркы ой жүгүртүү дайыма бир эле вариантта бирикпейт.
Verianla окурманы үчүн негизги билдирүү мындай: келечектеги үн менен иштеген жасалма интеллект ассистенттери “эмне деп жооп берүүнү” гана эмес, “сүйлөшүү жүрүп жатканда качан күтүү, качан кыска жаңыртуу жасоо жана качан жооп берүү керектигин” да үйрөнүүгө тийиш. Бул изилдөө ушул убакыт көйгөйүн өлчөнө турган жана үйрөтүлө турган башкаруу тапшырмасына айлантат.
Булак жана ыкма боюнча эскертүү
Бул жазуу “Learning When to Think While Listening in Large Audio-Language Models” аттуу академиялык PDF негизинде даярдалган оригиналдуу кыргызча редакциялык контент. Текст сөзмө-сөз котормо эмес; изилдөөдөгү көйгөй, ыкма, формулалар, визуалдар, таблицалар, эксперимент протоколу, жыйынтыктар жана чектөөлөр жөнөкөйлөтүлүп баяндалган.
Бул жазууда “ой жүгүртүү” деген сөз моделдин колдонуучуга көрүнгөн кыска абал жаңыртуусун чыгарышын билдирет; аны реалдуу дүйнөдөгү адамдын ой жүгүртүүсү менен так бирдей мааниде кабыл албоо керек.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген