

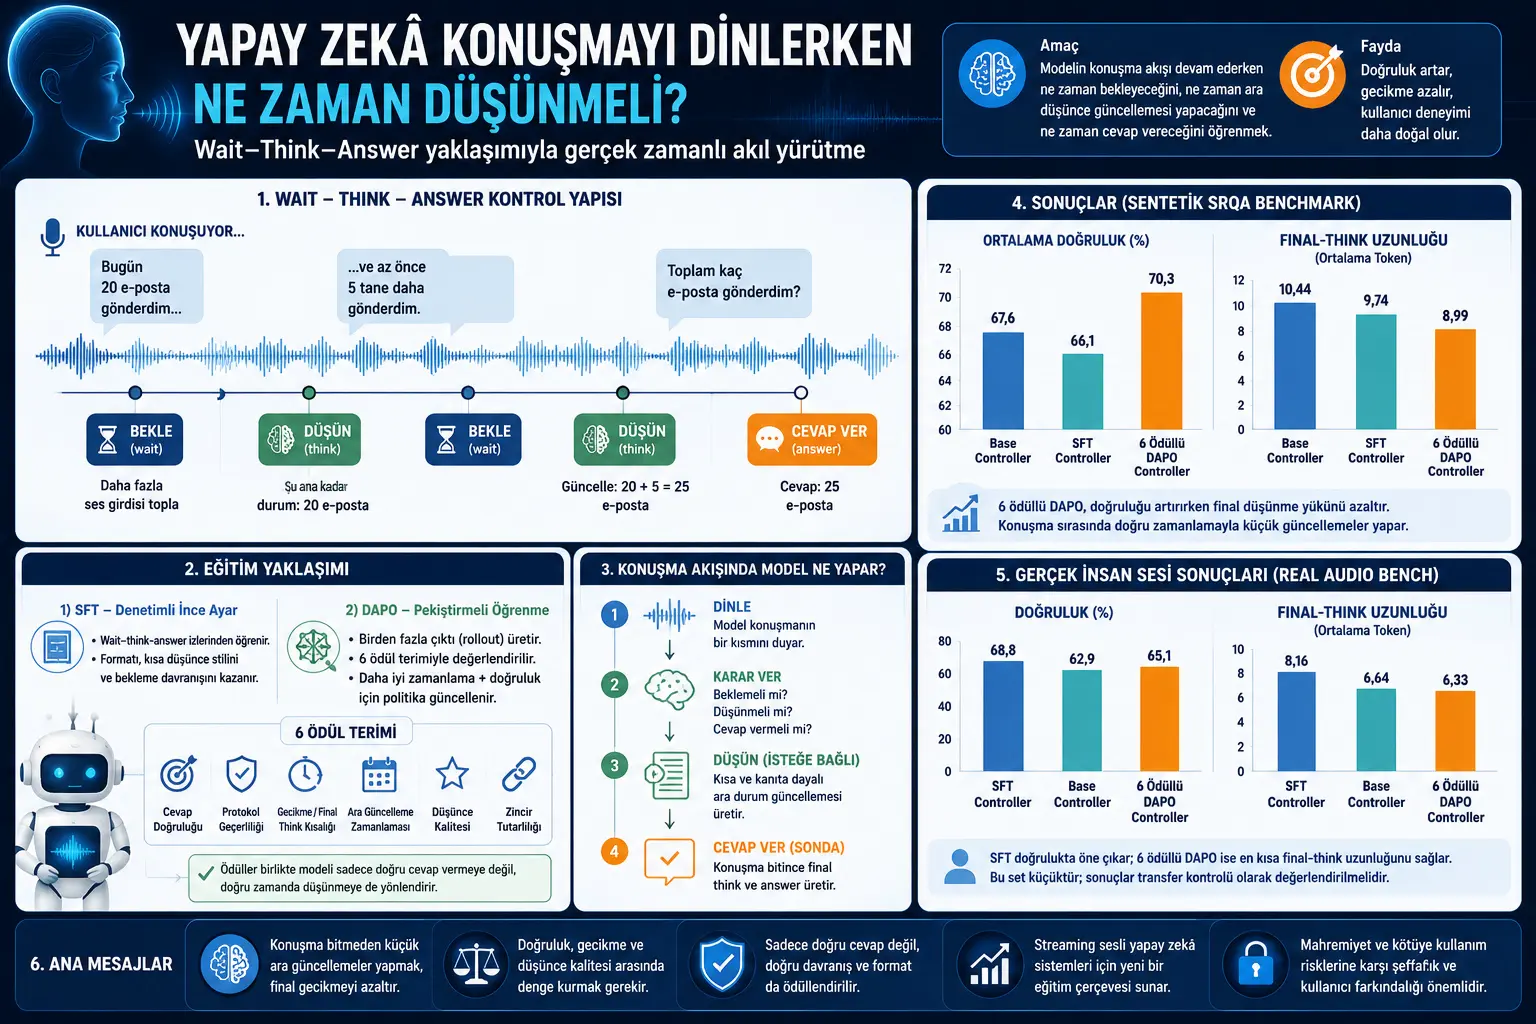
Müasir böyük audio-dil modelləri nitqi qəbul edib mətn və ya səsli cavab yarada bilir. Lakin real vaxtlı danışıq qarşılıqlı əlaqəsində yalnız düzgün cavab vermək kifayət deyil. Model çox gec cavab versə, istifadəçi uzun sükut yaşayır. Çox erkən cavab versə, danışığın sonunda gələn kritik məlumatı qaçıra bilər.
Bu iş həmin tarazlığı wait-think-answer adlanan idarəetmə quruluşu ilə nəzərdən keçirir. Modelin üç əsas hərəkəti var: gözlə, aralıq düşüncə/yeniləmə yarat, cavab ver. Gözləmə hərəkəti daha çox audio girişi toplamağa imkan verir. Think hərəkəti həmin ana qədər eşidilən məlumata əsaslanan qısa aralıq vəziyyət yeniləməsi yaradır. Answer hərəkəti isə yekun cavabı verir.
Təklif olunan yanaşma Qwen2.5-Omni-7B əsaslı audio-dil modeli üzərində sınaqdan keçirilir. Əvvəlcə supervised fine-tuning, yəni SFT ilə model bu hərəkət dilini öyrənir. Daha sonra DAPO adlı reinforcement learning əsaslı policy optimization ilə modelin yalnız düzgün cavab verməsi deyil; düzgün vaxtda düşünməsi, lazımsız uzun düşünməməsi, formatı pozmaması və cavabla aralıq düşüncələr arasında ardıcıllıq qurması da mükafatlandırılır.
Nəticələr streaming danışıq modellərində “düşünməyi sona saxlamaq” əvəzinə, danışıq zamanı kiçik və mənalı aralıq yeniləmələr etməyin cavab dəqiqliyi ilə gecikmə arasındakı tarazlığı yaxşılaşdıra biləcəyini göstərir.
Problem nədir?
Klassik səsli sual-cavab sistemlərində model adətən istifadəçinin danışığını tam dinləyir, sonra düşünür və cavab verir. Bu üsul qiymətləndirmə üçün asandır; çünki model bütün girişi gördükdən sonra tək cavab yaradır. Lakin real vaxtlı assistent təcrübəsində bu təbii deyil.
Canlı danışıqda istifadəçi cümləsini hissə-hissə qurur. Bəzən kritik məlumat lap əvvəl gəlir, bəzən isə son anda gələn ifadə cavabı dəyişir. Məsələn istifadəçi “Bu gün 20 e-poçt göndərdim...” dedikdən sonra model erkən cavab versə 20 deyə bilər; amma istifadəçi “...və indicə daha 5 dənə göndərdim” deyə davam etsə, düzgün cavab 25 olur.
Bu halda səsli süni intellekt üçün üçtərəfli gərginlik yaranır:
1. Dəqiqlik: Model kifayət qədər sübut gəlmədən cavab versə səhv edə bilər.
2. Gecikmə: Model bütün danışıq bitəndən sonra uzun-uzadı düşünərsə istifadəçi gözləyər.
3. Aralıq reasoning keyfiyyəti: Model danışıq zamanı aralıq yeniləmə edəcəksə, bu yeniləmələr qısa, düzgün, sübuta bağlı və sonrakı cavabı dəstəkləyən olmalıdır.
Məqalənin əsas sualı budur: böyük audio-dil modeli danışıq axını davam edərkən nə vaxt gözləməli olduğunu, nə vaxt qısa aralıq yeniləmə etməli olduğunu və nə vaxt yekun cavab verməli olduğunu öyrənə bilərmi?
Metod nə təklif edir?
İş streaming danışıq reasoningini bir online idarəetmə problemi kimi müəyyən edir. Model audio axını boyunca müəyyən qərar anlarında həmin ana qədər eşitdiyi audio prefiksini və əvvəllər yaratdığı aralıq vəziyyət yeniləmələrini görür. Sonra üç hərəkətdən birini seçir:
<wait/>: Model cavab və ya düşüncə yaratmır, daha çox audio girişi gözləyir.
<think>...</think>: Model həmin ana qədər eşitdiyi sübuta əsaslanan qısa aralıq vəziyyət yeniləməsi yaradır. Bu, modelin daxili hesablamalarını tam açması demək deyil; sistemin görünən, qısa və tapşırıq yönümlü vəziyyət qeydi yaratmasıdır.
<answer>...</answer>: Model yekun cavabı verir. Bu işdə cavab vermə hərəkəti danışıq bitəndən sonrakı mərhələ ilə məhdudlaşdırılıb; yəni təcrübələrdə model danışıq bitmədən final cavab verməyi öyrənmir, əsas diqqət danışıq zamanı gözləmə və aralıq yeniləmə vaxtlamasına yönəlib.
Metod iki mərhələli təlimdən istifadə edir:
1. SFT, yəni supervised fine-tuning: Model hazırlanmış wait-think-answer izləri ilə hərəkət formatını, qısa düşüncə üslubunu, gözləmə davranışını və final cavab quruluşunu öyrənir.
2. DAPO policy optimization: Model daha sonra mükafat funksiyası ilə optimallaşdırılır. Mükafat yalnız final cavabın düzgünlüyünə baxmır. Format etibarlılığı, cavab gecikməsi, aralıq yeniləmə vaxtı, düşüncə keyfiyyəti və zəncir ardıcıllığı da birlikdə qiymətləndirilir.
Bu yanaşmanın məqsədi modelin bütün reasoning prosesini danışıq bitdikdən sonraya yığmasının qarşısını almaqdır. Əgər model kritik məlumatlar gəldikcə qısa aralıq yeniləmələr etsə, final cavabdan əvvəl qalan düşünmə yükü azala bilər.
Formullar nəyi izah edir?
PDF-dəki formullar wait-think-answer idarəetmə quruluşunu, mükafat funksiyasını və DAPO optimallaşdırmasını izah edir. Aşağıdakı formullar MathJax uyğun şəkildə verilmişdir.
1. Controller müşahidəsi və hərəkət seçimi
\[ o_k=(x_{1:t_k},z_{
Burada \(o_k\), \(k\)-cı qərar anındakı controller müşahidəsidir. \(x_{1:t_k}\), həmin ana qədər eşidilən audio prefiksini; \(z_{
2. Etibarlı trajectory üçün formalaşdırılmış mükafat
Bu formul etibarlı wait-think-answer axını üçün ümumi mükafatı göstərir. \(R_a\) cavab dəqiqliyini, \(R_f\) format etibarlılığını, \(R_s\) gecikmə/final-think qısalığını, \(R_u\) aralıq yeniləmə vaxtını, \(R_t\) düşüncə keyfiyyətini, \(R_c\) isə düşüncə zənciri ilə final cavab arasındakı ardıcıllığı ifadə edir.
Mühüm detal budur: ardıcıllıq bonusu yalnız cavab düzgün olduqda işə düşür. Yəni model səhv cavaba ardıcıl, amma yanlış izah verdiyi üçün əlavə mükafat ala bilməz.
3. Protokolla qapılan yekun mükafat
Bu formul format/protokol etibarlılığının prioritet olduğunu göstərir. Model yanlış ardıcıllıqla cavab versə, tələb olunan etiketləri pozsa və ya etibarsız hərəkət ardıcıllığı yaratsa, final cavabın düzgün olması onu xilas etmir. Əvvəlcə qarşılıqlı əlaqə protokolu düzgün olmalıdır.
4. İstifadə olunan mükafat çəkiləri
Bu çəkilər mükafat komponentlərinin nisbi əhəmiyyətini müəyyən edir. Xüsusilə \(\lambda_u=3.0\), aralıq yeniləmə vaxtlamasına güclü çəki verildiyini göstərir. Yəni modelin yalnız düşüncə yaratması deyil, onu düzgün anda yaratması vacibdir.
5. DAPO qrup-nisbi advantage hesabı
Bu formul eyni prompt üçün yaradılan \(G\) rollout arasında \(i\)-rolloutun nisbi advantage dəyərini hesablayır. Çıxış qrup ortalamasından daha yaxşı mükafat alırsa müsbət advantage, daha zəifdirsə mənfi advantage alır. Bu, modelə hansı hərəkət ardıcıllıqlarının daha yaxşı olduğunu qrup daxilində öyrənməyə kömək edir.
6. Token səviyyəli DAPO məqsədi
Bu formul DAPO-nun token səviyyəsində clipped policy update prosesini göstərir. \(M\) completion tokenlarının maskasıdır. \(r_{i,t}\) yeni policy ilə köhnə policy arasındakı ehtimal nisbətidir. Müsbət advantage-li tokenlar gücləndirilir; mənfi advantage-li tokenlar zəiflədilir. Clipping yenilənmənin həddən artıq böyüməsinin qarşısını alır.
7. Policy nisbəti
Bu ifadə yeni policy-nin müəyyən token yaratma ehtimalının köhnə policy-yə nisbətən nə qədər dəyişdiyini göstərir. Böyük dəyişikliklər clipping mexanizmi ilə məhdudlaşdırılır. Bu, RL təlimini daha sabit edir.
Qrafik, cədvəl və sxemin əsas mesajı
Səhifə 3-dəki Figure 1: Sxem modelin danışığı hissə-hissə dinlədiyini və hər qərar addımında ya gözlədiyini, ya qısa aralıq düşüncə yeniləməsi etdiyini, ya da ən sonda cavab verdiyini göstərir. “20 e-poçt göndərdim, daha 5 dənə göndərdim” nümunəsində modelin əvvəl “indiyə qədər 20” kimi aralıq vəziyyət saxladığı, sonra “20 + 5 = 25” yeniləməsi ilə final cavaba hazırlaşdığı izah olunur. Əsas mesaj: model bütün düşünməni danışıqdan sonraya saxlamaq əvəzinə, danışıq zamanı kiçik və düzgün vəziyyət yeniləmələri toplaya bilər.
Səhifə 5-dəki Table 1: Mükafat terminləri altı başlıqda ümumiləşdirilir: cavab dəqiqliyi, protokol etibarlılığı, gecikmə, aralıq yeniləmə vaxtı, düşüncə keyfiyyəti və zəncir ardıcıllığı. Cədvəl işin yalnız “düzgün cavab ver” mükafatı ilə kifayətlənmədiyini; danışıq boyunca düzgün davranış formasını da öyrətdiyini göstərir.
Səhifə 6-dakı Figure 2: Mükafat sisteminin wait-think-answer axınını necə qiymətləndirdiyi göstərilir. Qayda əsaslı terminlər formatı, vaxtlamanı, dəqiqliyi və final gecikməni yoxlayır; judge dəstəkli terminlər isə aralıq düşüncə keyfiyyətini və final cavabı dəstəkləyən ardıcıllığı qiymətləndirir. Əsas mesaj: yaxşı model yalnız düzgün final cavab verən deyil; düzgün vaxtda qısa və faydalı aralıq yeniləmələr edən modeldir.
Səhifə 8-dəki Table 2: Sintetik danışıq SRQA nəticələrində altı mükafatlı DAPO controller Qwen streaming controller ailəsində ən yaxşı orta dəqiqliyi verir. Base controller orta hesabla %67,6 dəqiqlik və 10,44 final-think token uzunluğu göstərərkən, altı mükafatlı DAPO %70,3 dəqiqlik və 8,99 final-think uzunluğu verir. Bu cədvəl modelin həm dəqiqlik, həm də residual reasoning yükü baxımından yaxşılaşdığını göstərir.
Səhifə 8-dəki Figure 3: Base controller ilə altı mükafatlı DAPO-nun tapşırıq üzrə dəqiqlikləri müqayisə edilir. DAPO xüsusilə ARC-E, SIQA, PIQA və GSM8K kimi tapşırıqlarda yaxşılaşma göstərir. GSM8K ayrıca paneldə verilir, çünki ümumi dəqiqlik səviyyəsi digər tapşırıqlara nisbətən daha aşağı qalır.
Səhifə 9-dakı Table 3: Real Audio Bench nəticələri insan qeydlərindən ibarət 186 nümunə üzrə verilir. SFT controller %68,8 dəqiqliklə ən yüksək nəticəni verərkən, altı mükafatlı DAPO %65,1 dəqiqlik və 6,33 final-think uzunluğu ilə base controller-dan daha qısa final düşünmə yaradan yeganə öyrədilmiş variant kimi seçilir. Əsas mesaj: real insan səsi testində nəticələr daha mürəkkəbdir; dəqiqlik və aşağı gecikmə həmişə eyni variantda birləşmir.
Səhifə 14-dəki Figure 4: SFT təlim əyriləri təlim və doğrulama itkisinin azaldığını, token dəqiqliyinin yüksəldiyini göstərir. Bu, SFT mərhələsinin DAPO üçün möhkəm başlanğıc policy yaratdığını dəstəkləyir.
Səhifə 18-dəki ablation cədvəli: Mükafat komponentləri artdıqca sintetik SRQA dəqiqliyi yüksəlir. Base controller %67,6, SFT %66,1, dörd mükafatlı DAPO %68,5, beş mükafatlı DAPO %69,2, altı mükafatlı DAPO %70,3 kimi bildirilir. Bu cədvəl mükafat komponentlərinin mərhələli töhfəsini göstərir.
Təcrübələr necə aparılıb?
İşdə iki əsas qiymətləndirmə mühiti istifadə olunur.
1. Sintetik danışıq SRQA benchmark: ARC-Easy, ARC-Challenge, PIQA, SocialIQA, GSM8K və LLaMA-QS olmaqla altı tapşırıq ailəsi istifadə olunur. Ümumilikdə 8.959 nümunə var. Mətn sualları danışıq formasına çevrilir, TTS ilə audioya çevrilir və model bu audio girişlər üzərindən qiymətləndirilir.
2. Real Audio Bench: İnsanların yazdığı real səslərdən ibarət kiçik transfer benchmark istifadə olunur. Beş danışan 200 namizəd nümunə yazır; qeyri-müəyyən və ya səhv nümunələr çıxarıldıqdan sonra 186 qeyd qalır. Bu dəst böyük miqyaslı istifadəçi araşdırması deyil, TTS-dən kənara transfer yoxlaması kimi qiymətləndirilir.
Model ailəsi kimi Qwen2.5-Omni-7B istifadə olunur. SFT mərhələsində LoRA ilə fine-tuning edilir. DAPO mərhələsində isə streaming controller rolloutları yaradılır, bu çıxışlar altı mükafat komponenti ilə qiymətləndirilir və policy token səviyyəsində yenilənir.
Qiymətləndirmədə iki protokol var:
Offline mode: Model bütün danışığı dinlədikdən sonra bir dəfə düşünür və cavab verir. Bu, klassik full-audio qiymətləndirmə formasıdır.
Deployment mode: Audio 0,5 saniyəlik qərar gridində gəlir. Model hər addımda mövcud audio prefiksini və əvvəlki görünən düşüncə vəziyyətlərini görür. Danışıq bitmədən gözləmə və ya aralıq düşüncə yaratma hərəkətlərindən birini seçir. Danışıq sonunda final think və answer yaradır.
Müqayisə edilən modellər arasında Qwen2.5-Omni-7B base controller, SFT controller, dörd/beş/altı mükafatlı DAPO controller, Audio Flamingo 3, GLM-4-Voice-9B və ədəbiyyatda bildirilən Moshi variantları yer alır. Lakin üçüncü tərəf modelləri eyni streaming controller interfeysini açmadığı üçün birbaşa deployment mode müqayisəsi yalnız Qwen ailəsi daxilində aparılır.
Nəticələr nə göstərir?
1. Streaming səsli reasoning idarəetmə problemi kimi öyrədilə bilər. Model yalnız final cavabı yaratmağı deyil, danışıq axını zamanı nə vaxt gözləməli və nə vaxt qısa aralıq vəziyyət yeniləməsi etməli olduğunu da öyrənə bilir.
2. Altı mükafatlı DAPO sintetik benchmark-da ən yaxşı tarazlığı verir. Base controller %67,6 orta dəqiqlikdə qalarkən, altı mükafatlı DAPO %70,3-ə yüksəlir. Eyni zamanda final-think uzunluğu 10,44-dən 8,99 tokenə düşür. Bu, düşünmənin bir hissəsinin danışıq zamanı daha erkən və qısa formada həyata keçirilə biləcəyini göstərir.
3. SFT təkbaşına formatı öyrətsə də, tapşırıq mükafatı qədər yetərli deyil. SFT controller wait-think-answer dilini öyrənir; lakin sintetik orta dəqiqlikdə base controller-dan geri qalır. DAPO mərhələsi tapşırığa uyğun mükafat verərək performansı yenidən yüksəldir.
4. Real insan səsində nəticələr daha ehtiyatla şərh edilməlidir. Real Audio Bench kiçik datasetdir. SFT ən yüksək dəqiqliyi verir, altı mükafatlı DAPO isə ən qısa final-think uzunluğunu təmin edir. Güvən intervalları üst-üstə düşdüyünə görə bu dəst qəti model sıralaması əvəzinə transfer yoxlaması kimi oxunmalıdır.
5. Gecikmə yalnız sistem sürəti deyil. Məqalə final-think uzunluğunu istifadəçi danışığı bitdikdən sonra qalan reasoning yükünün göstəricisi kimi istifadə edir. Yəni burada gecikmə yalnız aparat və ya servis vaxtı deyil, modelin düşünmənin nə qədərini sona saxlaması ilə də əlaqəlidir.
6. Cache-native istehsal hələ gələcək iş sahəsidir. Məqalə rəsmi Qwen serving yolunun bu idarəetmə dövrəsi üçün birbaşa cache-native interfeys təqdim etmədiyini; buna görə benchmark-da full-prefix replay istifadə edildiyini bildirir. Ayrı prototip eyni informasiya axınının cache-native tətbiq oluna biləcəyini göstərsə də, production səviyyəsində optimallaşdırılmış danışıq sistemi iddia edilmir.
Bu niyə vacibdir?
Səsli süni intellekt assistentləri getdikcə daha real vaxtlı olur. İstifadəçilər artıq yalnız mətn sahəsinə sual yazmır; danışır, düzəliş edir, yarım cümlə ilə başlayır və son anda kritik məlumat əlavə edir. Bu mühitdə modelin yalnız yaxşı cavab yaratması deyil, danışıq axınını da yaxşı idarə etməsi lazımdır.
Bu iş səsli assistentlərdə “düşünmə vaxtlaması” problemini görünən edir. Model danışıq bitənədək heç nə etməsə, sonra uzun düşünə bilər. Danışıq davam edərkən qısa, sübuta əsaslanan aralıq yeniləmələr etsə, final gecikmə azala bilər. Lakin bu yeniləmələr lazımsız, uzun və ya yanlış olmamalıdır.
Bu fikir canlı təhsil assistentləri, əlçatanlıq alətləri, real vaxtlı tərcümə, görüş assistentləri, çağrı mərkəzi dəstək sistemləri və səsli istifadəçi interfeysləri üçün vacibdir. Xüsusilə əlilliyi olan istifadəçilər, ani altyazı və ya danışıq dəstək sistemlərindən istifadə edən şəxslər üçün gecikmə daha böyük istifadəçi təcrübəsi problemi yarada bilər.
Eyni zamanda təhlükəsizlik və etika baxımından da vacibdir. Danışıq zamanı düşünə bilən sistemlər istifadəçi hiss etmədən dinləyən və danışığı əvvəlcədən təhlil edən alətlərə çevrilərsə, məxfilik və manipulyasiya riski yarana bilər. Məqalə buna görə hərəkət sahəsini gözlə/düşün/cavab ilə məhdudlaşdırır və lazımsız düşüncə yaratmağı cəzalandırır.
Diqqət ediləsi məqamlar
1. İş preprintdir. Nəticələr yekun rəyli versiyanın dəqiqliyi ilə qiymətləndirilməməlidir.
2. Bu tam optimallaşdırılmış production sistemi deyil. Məqalə cache-native serving əvəzinə full-prefix replay əsaslı benchmark istifadə edir. Buna görə real məhsul performansı üçün əlavə mühəndislik tələb olunur.
3. Real Audio Bench kiçikdir. 186 qeyd aksentləri, mühit səs-küyünü, danışıq üslubunu və istifadəçi müxtəlifliyini tam təmsil etmək üçün kifayət deyil.
4. Aralıq düşüncənin görünməsi diqqətlə dizayn edilməlidir. Modelin görünən aralıq yeniləmə yaratması istifadəçiyə izah ediləbilənlik verə bilər; lakin lazımsız və ya yanlış aralıq şərhlər istifadəçini çaşdıra bilər.
5. Final cavab danışıqdan sonrakı mərhələ ilə məhdudlaşdırılıb. Bu işdə modelin danışıq bitmədən yekun cavab verməsi əsas öyrənmə hədəfi deyil. Əsas diqqət danışıq zamanı aralıq düşüncə yeniləmələrinin vaxtlamasına yönəlib.
6. İnsan danışığı çox müxtəlifdir. Pauzalar, aksentlər, sürətli danışıq, səs-küy, mövzu dəyişmə və yarımçıq cümlələr real istifadədə model davranışını çətinləşdirə bilər.
7. Məxfilik və sui-istifadə riski var. Qismən danışığı təhlil edən sistemlər istifadəçi məlumatlılığı və icazə mexanizmləri olmadan istifadə edilməməlidir. Real vaxtlı danışıq analizində açıq məlumatlandırma və təhlükəsizlik sərhədləri vacibdir.
Riskli sahə qeydi: İş danışığı real vaxtda dinləyən və qismən audio giriş əsasında aralıq reasoning yeniləmələri edən süni intellekt sistemləri ilə bağlıdır. Belə sistemlər əlçatanlıq, canlı tərcümə, təhsil və səsli assistentlər üçün faydalı ola bilər; lakin istifadəçi məlumatı olmadan danışığı izləmə, social engineering və ya məxfilik pozuntusu kimi risklər də yarada bilər. Bu yazı texniki məlumatlandırma məqsədi daşıyır.
Ümumi qiymətləndirmə: Məqalə səsli süni intellekt assistentlərinin vacib probleminə fokuslanır: istifadəçi danışarkən model gözləməlidir, aralıq məlumat yeniləməsi etməlidir, yoxsa dərhal cavab verməlidir? İnsan danışığında dinləyici çox vaxt danışıq bitmədən cavaba hazırlaşır. Bu iş oxşar fikri böyük audio-dil modellərinə daşıyaraq “dinləyərkən nə vaxt düşünməli?” sualını öyrənilə bilən idarəetmə problemi kimi nəzərdən keçirir.
Nəticə
Bu məqalə böyük audio-dil modelləri üçün vacib bir sualı araşdırır: model danışığı dinləyərkən nə vaxt düşünməlidir? Klassik yanaşmada model bütün audionu gözləyir, sonra düşünür və cavab verir. Lakin real vaxtlı danışıqda bu yanaşma gecikmə yarada bilər. Erkən cavab isə səhvə səbəb ola bilər.
Wait-think-answer idarəetməsi bu tarazlığa praktik çərçivə gətirir. Model danışıq zamanı gözləmə ilə qısa aralıq vəziyyət yeniləməsi arasında seçim edir. Kritik məlumat gəldikcə kiçik və tapşırıq yönümlü düşüncə yeniləmələri toplayır. Beləcə final cavab mərhələsində qalan düşünmə yükü azala bilər.
Nəticələr altı mükafatlı DAPO controller-in sintetik danışıq benchmark-ında həm dəqiqliyi artırdığını, həm də final-think uzunluğunu azaltdığını göstərir. Real insan səsi testində isə nəticələr daha ehtiyatlıdır: öyrədilmiş controller-lər işləyir, amma dəqiqlik və qısa final düşünmə həmişə eyni variantda birləşmir.
Verianla oxucusu üçün əsas mesaj budur: gələcəyin səsli süni intellekt assistentləri yalnız “nə cavab verəcəyini” deyil, “danışıq axarkən nə vaxt gözləməli, nə vaxt qısa yeniləmə etməli və nə vaxt cavab verməli olduğunu” da öyrənməli olacaq. Bu iş həmin vaxtlama problemini ölçülə bilən və öyrədilə bilən idarəetmə tapşırığına çevirir.
Mənbə və metod qeydi
Bu yazı “Learning When to Think While Listening in Large Audio-Language Models” adlı akademik PDF əsasında hazırlanmış orijinal azərbaycanca redaksiya məzmunudur. Mətn sözbəsöz tərcümə deyil; işdəki problem, metod, formullar, vizuallar, cədvəllər, təcrübə protokolu, nəticələr və məhdudiyyətlər sadələşdirilərək izah edilmişdir.
Yazıda “düşünmə” ifadəsi modelin istifadəçiyə görünən qısa vəziyyət yeniləməsi yaratmasını bildirir; real dünyadakı insan düşüncəsi ilə tam eyni mənada qiymətləndirilməməlidir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib