


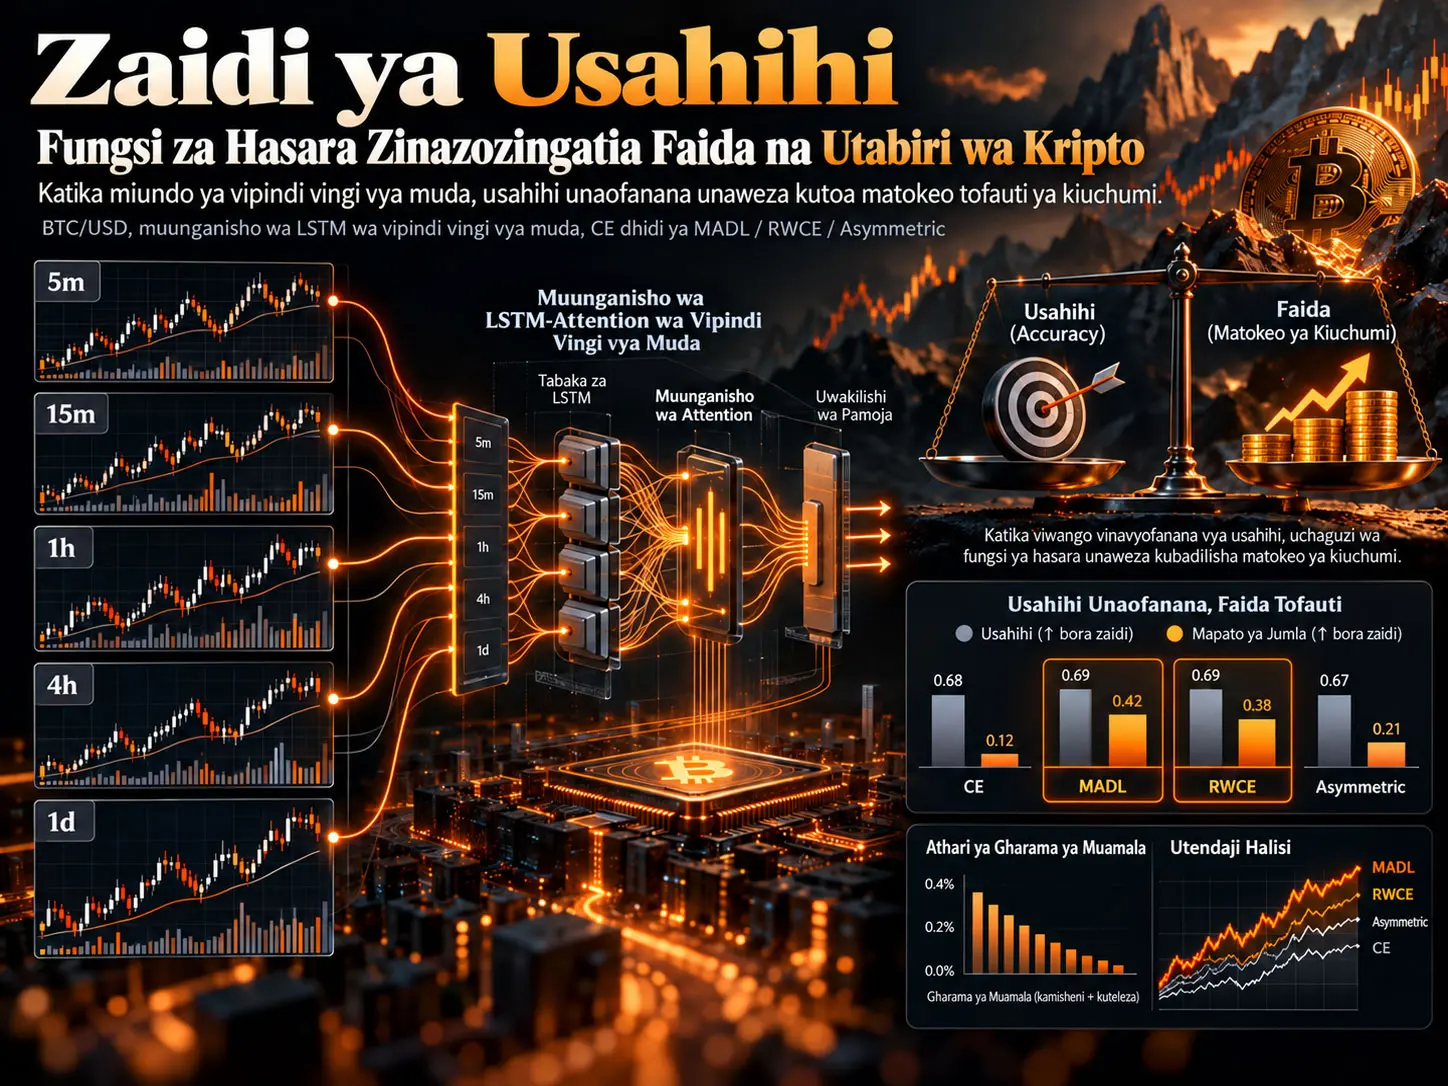
Kitendakazi cha hasara kinachozingatia faida, ni lengo la kufundisha modeli linalopima makosa ya uainishaji si kwa usahihi au kutokuwa sahihi pekee, bali pia kwa ukubwa wa mwendo wa bei ya kifedha unaohusishwa na kosa au athari yake kwa mapato yaliyorekebishwa kwa hatari. Haruki Tanabe analinganisha Cross-Entropy (CE) ya kawaida na loss tano zinazozingatia faida kwa kutumia modeli ya LSTM-attention inayounganisha vipindi vitano vya muda kwenye takribani miaka 5,3 ya data ya BTC/USD Bybit perpetual kati ya 2019–2024: MADL, Return-Weighted CE (RWCE), Profit-Guided Loss, Sharpe Loss na Asymmetric Directional Loss. Matokeo makuu ni kwamba mbinu za return-magnitude-weighted zinazodumisha takribani usahihi uleule wa mwelekeo wa %72 kama CE zinaongeza mapato halisi kwa kila bar kutoka 14,83 bp hadi 15,55–15,57 bp, yaani takribani %4,9–%5,0. Hata hivyo, utafiti ni backtest kwenye data ya kihistoria; si ushahidi wa utendaji wa biashara ya moja kwa moja au faida halisi ya jalada.
Ugunduzi muhimu wa kimuundo wa utafiti ni kwamba MADL na RWCE si familia mbili tofauti za loss katika implementa hiyo. Zote zinatumia kiini kilekile cha return-weighted cross-entropy na zinatofautiana tu katika kikomo cha juu cha clipping \(\tau\) kinachotumika kwa sampuli zenye mapato makubwa. Kwa MADL thamani chaguomsingi ni \(\tau=5\), na kwa RWCE ni \(\tau=3\). Katika jaribio kuu eneo la \(\tau=3\)–5 linaonekana kuwa na nguvu, lakini katika rejimu tatu za walk-forward thamani za \(\tau\in[2,15]\) hazikuweza kutofautishwa kitakwimu ndani ya fold.
Thamani za Sharpe zilizofanywa kuwa za mwaka kutoka kwa mapato ya kila saa kwa \(\sqrt{8760}\) zinaonyesha ongezeko la takribani %5,4–%5,5 kwa return-weighted trio; lakini viwango kamili vya Sharpe vya 25–29 ni vikubwa isivyo kawaida na vinategemea dhana ya uongezaji wa i.i.d. Katika ujumuishaji wa kila siku, faida hushuka hadi +%0,4–%3,1; katika marekebisho ya Newey–West HAC mpangilio unabaki, lakini umuhimu wa MADL baada ya ulinganisho mwingi unabaki mpakani. Kwa hiyo, matokeo imara zaidi ya kiuchumi ya utafiti si Sharpe kamili iliyofanywa ya mwaka, bali ni mapato halisi ya basis point kwa kila bar baada ya gharama za miamala.
Tatizo la utafiti: Kwa nini Accuracy pekee haitoshi?
Katika utabiri wa mwelekeo wa kifedha, tatizo la kawaida la uainishaji ni kutabiri kama bei itaenda juu au chini katika siku zijazo. Cross-Entropy ya kawaida huadhibu kila sampuli iliyowekwa katika darasa lisilo sahihi kulingana na kosa la uwezekano; lakini haizingatii moja kwa moja ukubwa wa kiuchumi wa mwendo wa bei uliotabiriwa vibaya.
Hali hii inaweza kuleta kutolingana muhimu katika matumizi ya kifedha. Kukosea mwelekeo wa mwendo wa bei wa %5 na kukosea mwendo wa %0,01 kunaweza kuwa sawa kwa mtazamo wa classification loss; lakini athari zake kwa trading PnL si sawa.
Utafiti unaliita pengo hili accuracy–profitability gap. Swali kuu la utafiti ni kama kulandanisha training loss vizuri zaidi na umuhimu wa kifedha wa mwendo wa bei kunaweza kuboresha utendaji wa backtest huku usahihi wa mwelekeo ukibaki kwa kiwango kikubwa.
Kitendakazi cha Hasara Kinachozingatia Faida ni Nini na Kwa Nini ni Tofauti na Accuracy?
Kitendakazi cha hasara kinachozingatia faida hujumuisha umuhimu wa kifedha wa sampuli ndani ya loss wakati wa mafunzo; katika utafiti huu, loss zinazopa uzito zaidi mabadiliko makubwa ya bei zilitoa mapato halisi ya juu zaidi kwa kila bar huku zikidumisha takribani usahihi uleule wa mwelekeo kama CE. Hii haimaanishi kwamba accuracy haina umuhimu; inaonyesha kwamba utabiri sahihi na usio sahihi wenye ukubwa tofauti wa kiuchumi unaweza kutofautishwa vibaya chini ya classification metric moja.
Loss sita zilizolinganishwa
| Loss | Kategoria | Utaratibu mkuu | Chaguomsingi kuu |
|---|---|---|---|
| Cross-Entropy (CE) | Uainishaji wa kawaida | Huadhibu makosa yote bila kujali ukubwa wa kifedha. | Hakuna |
| MADL | Return-weighted | Hupa Cross-entropy uzito kulingana na ukubwa wa \(|r|\). | \(\tau=5\) |
| Return-Weighted CE (RWCE) | Return-weighted | Kiini sawa na MADL; kikomo cha clipping tofauti. | \(\tau=3\) |
| Profit-Guided | Profit-direct | Huongeza kipengele cha differentiable PnL kwenye CE. | \(\alpha=0.5\), warmup=5 |
| Sharpe Loss | Risk-adjusted | Huchanganya CE na lengo linalofanana na differentiable Sharpe. | \(\beta\) floor=0.5, warmup=5 |
| Asymmetric Directional | Asimetria | Inaweza kubadilisha gharama za makosa ya juu/chini kwa coefficients tofauti. | \(\lambda_{up}=\lambda_{down}=1.5\), \(\tau=3\) |
Vigezo vya pamoja
Loss zote hutumia kiolesura cha \(L(z,y,r)\). \(z\) ni logits za modeli ya madaraja mawili; \(y\in\{0,1\}\) ni lebo ya mwelekeo; \(r\) ni mapato ya baadaye yanayohusika. Uwezekano wa mwelekeo wa juu:
\[ p_i=\operatorname{softmax}(z_i)_1 \]
hufafanuliwa hivyo. Soft trading position:
\[ pos_i=2p_i-1 \]
hutumika. \(pos_i\) hutumiwa wakati wa mafunzo kwa differentiable financial objectives; katika uamuzi halisi wa backtest, ikiwa \(p_i>0.5\) hutumika long, vinginevyo short hard decision.
Cross-Entropy
\[ L_{CE} = -\frac{1}{N} \sum_{i=1}^{N} \left[ y_i\log p_i+(1-y_i)\log(1-p_i) \right] \]
Cross-Entropy hupima kosa la uwezekano wa uainishaji wa mwelekeo. Ukubwa wa mapato kwa asilimia au basis point hauingii moja kwa moja katika mlinganyo huu.
Familia ya return-weighted loss
Muundo uliounganishwa wa utafiti ni:
\[ L_{RW}(\tau) = \frac{1}{N} \sum_{i=1}^{N} \tilde{w}_i(\tau)\,CE(z_i,y_i) \]
na:
\[ w_i(\tau) = \operatorname{clip} \left( \frac{|r_i|}{|r|_B}, 0.1, \tau \right), \qquad \tilde{w}_i=\frac{w_i}{\bar{w}} \]
kwa namna hiyo.
\(|r_i|\) ni mapato kamili ya sampuli \(i\). \(|r|_B\) ni wastani wa mapato kamili ndani ya batch. \(\tau\) ni kikomo cha juu cha clipping kinachozuia uzito mkubwa sana wa return kutawala gradient. Uzito wa mwisho hunormalishwa ili wastani wa batch uwe tena 1.
Kwa njia hii, mabadiliko makubwa yanakuwa muhimu zaidi ndani ya CE huku ikizuiwa hali ambapo mwendo mmoja uliokithiri wa bei unadhibiti batch loss nzima.
Je, MADL na RWCE ni Vitendakazi Tofauti vya Hasara katika Utafiti Huu?
Katika implementa hii, hapana: MADL na RWCE hutumia kiini kilekile cha \(L_{RW}(\tau)\) na kiutendaji hutofautiana tu katika kikomo cha juu cha clipping \(\tau\); MADL hutumia \(\tau=5\) kama chaguomsingi, huku RWCE ikitumia \(\tau=3\). Kwa hiyo, kulingana na matokeo ya utafiti wenyewe, tatizo la kiutendaji ni zaidi kuchagua thamani ya \(\tau\) ndani ya familia moja ya return-weighting kuliko kuchagua kati ya familia mbili tofauti za loss.
Chanzo pia kinaeleza wazi kwamba chapisho asili la MADL halikutumia clipping na renormalization. Kwa hiyo, toleo la \(\tau=5\) linaloripotiwa hapa chini ya jina “MADL” ni utekelezaji uliorekebishwa wa kanuni ya MADL kwa madhumuni ya stability katika utafiti huu.
Profit-Guided Loss
\[ L_{PGL} = L_{CE} - \alpha \frac{1}{N} \sum_{i=1}^{N}pos_i r_i \]
\(\alpha\) ni uzito wa kipengele cha PnL. Utafiti hutumia warmup kuongeza \(\alpha\) kutoka sifuri hadi thamani lengwa katika epoch za mwanzo.
Hata hivyo, mwingiliano usiotarajiwa huonekana kati ya early stopping na warmup. Katika usanidi wa chaguomsingi wa warmup=5, kwa kuwa epoch bora 6 huchaguliwa, \(\alpha\) inayofanya kazi hubaki ndogo sana/CE-dominant. Hata warmup inapoondolewa, uboreshaji haujafikia kiwango cha MADL/RWCE.
Sharpe Loss
\[ L_{Sharpe} = \beta L_{CE} + (1-\beta) \left( -\frac{E[pos\cdot\tilde r]} {\operatorname{std}(pos\cdot\tilde r)+\epsilon} \right) \]
ambapo:
\[ \tilde r = \frac{r}{|r|_B+\epsilon}, \qquad \epsilon=10^{-6} \]
hutumika.
Katika usanidi wa chaguomsingi, Sharpe optimization iligongana na classification gradient na kupunguza accuracy kwa takribani pointi za asilimia 1,4. Hata hivyo, Appendix C inaonyesha kwamba kwa utafutaji wa pande mbili wa \((\beta,warmup)\), Sharpe Loss inaweza kurejea hadi takribani 28,00. Kwa hiyo, chanzo hakitafsiri Sharpe Loss kama kisichofanya kazi kimsingi, bali kama chenye gharama kubwa ya tuning na nyeti kwa giperparameta za chaguomsingi.
Asymmetric Directional Loss
Loss ya asimetria:
\[ L_{Asym} = \frac{1}{N} \sum_i a_i w_i CE(z_i,y_i) \]
na coefficient ya mwelekeo:
\[ a_i = 1 + y_i(\lambda_{up}-1)(1-p_i) + (1-y_i)(\lambda_{down}-1)p_i \]
huandikwa hivyo.
\(\lambda_{up}\) na \(\lambda_{down}\) huruhusu gharama za makosa ya mwelekeo wa juu na chini kutofautishwa. Hata hivyo, katika jaribio kuu coefficients zote mbili ni 1,5, kwa hiyo upendeleo wa mwelekeo wenye asimetria kamili hautumiki. Chanzo kinaeleza kwamba tabia halisi ya non-LRW hujitokeza wakati \(\lambda_{up}\neq\lambda_{down}\).
Kwa nini usambazaji wa mapato ya crypto ni muhimu?
Chanzo kinaripoti leptokurtosis ya juu sana katika mapato rahisi ya BTC ya dakika 15 na kinahoji kwamba kuna mazingira ya usambazaji yenye mikia mizito zaidi kuliko equity intraday returns. Mantiki ya return weighting ina maana zaidi hasa katika usambazaji kama huu ambapo harakati kubwa ni nadra lakini muhimu kiuchumi.
Hata hivyo, haiwezi kuhitimishwa kwamba “crypto ina mikia mizito, kwa hiyo \(\tau=5\) ni optimum ya ulimwengu wote”. Katika uchambuzi wa walk-forward, \(\tau\) argmax zilibadilika kwa rejimu tofauti za excess-kurtosis, lakini eneo pana la \([2,15]\) halikuweza kutofautishwa kitakwimu ndani ya fold.
Ufafanuzi wa coupling ya \(\kappa-\lambda\)
Chanzo kinachukulia \(\kappa\) kama tail heaviness/excess kurtosis, na \(\lambda\) kama kipengele cha kinadharia cha variance ya gradient/noise inayotokana na loss. Kwa kuwa \(\lambda\) haionekani moja kwa moja katika jaribio la soko halisi, cross-seed Sharpe standard deviation hutumiwa kama proxy.
Katika seli 18 zinazotokana na walk-forward fold tatu na loss sita:
\[ r_{\text{Pearson}} = +0.633, \qquad p=0.005 \]
imepatikana. Hakuna uhusiano wazi kati ya kiwango cha kosa kinachotegemea accuracy na kurtosis. Mwandishi anatafsiri matokeo haya kama msaada kwa nadharia kwamba wakati heavy tails na training noise zinaongezeka pamoja, hitaji la clipping bora linaweza kusawazishwa kwa sehemu.
Utaratibu huu si sheria ya kifizikia iliyothibitishwa kwa majaribio. \(\lambda\) inayotumika si kipimo cha moja kwa moja cha noise bali ni proxy; na katika ujumuishaji upya wa fold-mean idadi ya sampuli huru ni tatu tu.
Usanifu wa LSTM-fusion wa vipindi vingi vya muda
Modeli huchakata vipindi vitano vya muda kwa sambamba:
| Kipindi cha muda | Jukumu ndani ya modeli |
|---|---|
| Dakika 5 | Harakati za soko za muda mfupi zaidi |
| Dakika 15 | Mhimili mkuu wa lengo |
| Saa 1 | Muktadha wa muda mfupi-kati |
| Saa 4 | Muktadha mpana wa mwenendo |
| Siku 1 | Muktadha wa muda mrefu wa soko |
Kwa kila timeframe hutumiwa LSTM huru ya tabaka mbili:
\[ h^{(k)}=LSTM_k(X^{(k)}) \]
Urefu wa kila mlolongo wa ingizo ni \(T=48\), na ukubwa wa vipengele katika kila kipindi cha muda ni \(d_k=19\).
Matokeo ya encoder tano:
\[ H\in\mathbb{R}^{5\times128} \]
huwekwa kama stack na scaled dot-product attention hutumika:
\[ Attn(Q,K,V) = softmax \left( \frac{QK^\top}{\sqrt{H}} \right)V \]
Kisha fused representation hutengenezwa kwa timeframe attention weights na classifier ya 128→64→2 hutoa uwezekano wa mwelekeo.
Vipengele 19
| Kundi la vipengele | Mifano inayotumiwa katika chanzo |
|---|---|
| Bei | Return, log-return |
| Wastani unaosogea | Uwiano wa SMA-7/25/50/99, uwiano wa EMA-12/26 |
| Oscillators | RSI(14), normalize RSI, MACD histogram, normalize MACD |
| Volatility | Bollinger Band position, ATR(14), ATR ratio, rolling volatility 10/20 |
| Kiasi | Volume SMA(10), volume ratio |
Lengo la utabiri
Binary target kuu:
\[ y_t=\mathbf{1}[p_{t+4}>p_t] \]
na hutabiri mwelekeo wa bei baada ya bar nne katika kipindi cha dakika 15, yaani takribani saa 1 baadaye.
Usambazaji wa lebo ni %50,7 juu na %49,3 chini; kwa hiyo hakuna class imbalance kubwa.
Kuzuia look-ahead bias
Katika modeli, viashiria vyote vya rolling vya kiufundi huhesabiwa kwa causal operators. Kwa index ya utabiri \(t\), mstari wa vipengele wa \(t-1\) hutumiwa. Data za timeframe za juu hutoka tu kwa bar zilizofungwa kikamilifu kabla ya muda wa utabiri. StandardScaler hufit tu kwenye training set. Train/validation/test split ni ya mpangilio wa muda.
Kwa Daily timeframe, bar ya mwisho inayopatikana inaweza katika baadhi ya hali kuwa ya takribani saa 23 dakika 59 kabla; chanzo kinakubali hili kama hali ya stale-context ambayo ni gharama ya kuepuka leakage.
Diagnostiki za leakage
Katika mafunzo ya Shuffled-label, test accuracy:
%50,79 ± takribani 0
hushuka hadi kiwango hicho na modeli huangukia darasa moja. Kwa lebo za kawaida, accuracy ni takribani %72.
Jaribio la Target horizon linaonyesha ishara ikidhoofika hatua kwa hatua katika upeo wa saa 1, saa 4, saa 16, saa 25, saa 64 na saa 250. Accuracy ya takribani %72,3 kwa saa 1 hushuka hadi takribani %42,4 karibu na saa 250.
Matokeo haya hayalingani na leakage ya horizon-invariant. Hata hivyo, chanzo kinabainisha kuwa kwa kuwa jaribio hili linatumia seed moja tu, haliondoi njia zote zinazowezekana za horizon-specific leakage.
Muunganisho wa Vipindi Vingi vya Muda ni Muhimu Kiasi Gani kwa Matokeo?
Muunganisho wa vipindi vingi vya muda unaonekana kuwa muhimu sana kwa matokeo ya utafiti: inapoutumika timeframe ya dakika 15 pekee, accuracy hushuka hadi takribani kiwango cha class-prior cha %50–%53 na loss zote sita hutoa matokeo hasi ya trading. Kwa hiyo, faida ya loss inayozingatia faida si utaratibu unaochukua nafasi ya multi-timeframe representation yenye nguvu; ni uboreshaji wa loss-design unaoongezwa juu ya representation hiyo.
Mbinu na Matokeo ya Utafiti
Seti ya data
| Sifa | Thamani ya chanzo |
|---|---|
| Mali kuu | BTC/USD, Bybit perpetual futures |
| Kipindi | 2019-10-01 – 2024-12-31 |
| Bar ya dakika 5 | 552.672 |
| Uwiano wa ufunikaji wa kalenda | Takribani %99,2 |
| Vipindi vya muda | 5m, 15m, 1h, 4h, 1d |
| Bar ya 15m | 184.224 |
| Bar ya 1h | 46.056 |
| Train/validation/test | %70 / %15 / %15 kwa mpangilio wa muda |
| Idadi kuu ya test bar | 23.040 |
Usanidi wa mafunzo ya modeli
| Parameta | Thamani |
|---|---|
| Idadi ya tabaka za LSTM | 2 / timeframe |
| Hidden size | 128 |
| Dropout | 0,2 |
| Jumla ya parameta | Takribani milioni 1,1 |
| Optimizer | Adam |
| Learning rate | 0,001 |
| Batch size | 64 |
| Early stopping patience | 10 |
| Epoch ya juu | 100 |
| Seed kuu | 42–51 |
| Idadi kuu ya marudio | 10 seed/loss |
Masharti ya trading simulation
| Sharti | Thamani |
|---|---|
| Notional ya kuanzia | 10.000 USD |
| Transaction cost | %0,1 / trade |
| Gharama ya round-trip | %0,2 |
| Slippage | %0,05 |
| Uamuzi wa position | \(p>0.5\Rightarrow+1\), vinginevyo \(-1\) |
| Ukubwa wa position | Full-size katika kila ishara |
| Ujumlishaji wa mapato | Rahisi, non-compound |
| Funding | Haijajumuishwa katika gharama kuu ya backtest |
Utendaji mkuu wa uainishaji
| Loss | Accuracy | F1 | MCC |
|---|---|---|---|
| CE | 0,7228 ± 0,0032 | 0,7226 ± 0,0032 | 0,4471 ± 0,0064 |
| MADL | 0,7218 ± 0,0033 | 0,7215 ± 0,0036 | 0,4451 ± 0,0061 |
| Profit-Guided | 0,7198 ± 0,0033 | 0,7193 ± 0,0037 | 0,4425 ± 0,0048 |
| Sharpe Loss | 0,7084 ± 0,0036 | 0,7078 ± 0,0040 | 0,4197 ± 0,0066 |
| RWCE | 0,7231 ± 0,0027 | 0,7226 ± 0,0031 | 0,4489 ± 0,0044 |
| Asymmetric | 0,7224 ± 0,0024 | 0,7220 ± 0,0025 | 0,4472 ± 0,0054 |
CE, MADL, RWCE na Asymmetric haziwezi kutofautishwa kitakwimu kwa upande wa accuracy. Profit-Guided inaonyesha upungufu modest wa accuracy, huku Sharpe Loss ya chaguomsingi ikionyesha upungufu mkubwa zaidi wa accuracy.
Utendaji mkuu wa kiuchumi
| Loss | Sharpe iliyofanywa ya mwaka | Net avg/bar | Max drawdown | Tofauti ya Sharpe vs CE |
|---|---|---|---|---|
| CE | 27,07 ± 0,72 | 14,83 bp | -2,61 ± 0,47% | — |
| MADL | 28,53 ± 0,30 | 15,55 bp | -2,34 ± 0,22% | +%5,4 |
| Profit-Guided | 26,73 ± 0,63 | 14,66 bp | -2,65 ± 0,44% | -%1,3 |
| Sharpe Loss, default | 25,73 ± 1,17 | 14,14 bp | -2,65 ± 0,58% | -%5,0 |
| Sharpe Loss, best tuned | 28,00, n=3 | 15,36 bp | Haijaripotiwa | +%3,4 vs 10-seed CE baseline |
| RWCE | 28,52 ± 0,38 | 15,55 bp | -2,51 ± 0,26% | +%5,4 |
| Asymmetric | 28,56 ± 0,69 | 15,57 bp | -2,51 ± 0,35% | +%5,5 |
Dai kuu la kiuchumi ni mapato halisi kwa kila bar badala ya Sharpe iliyofanywa ya mwaka. Return-weighted trio inatoa takribani 0,72–0,74 bp/bar ya ziada ikilinganishwa na CE.
Mapato kwa kila bar yanahesabiwaje?
Chanzo katika Table 7 kinatumia:
\[ Avg/bar\;(bp) = \frac{ROI(\%)\times10000} {100\times n_{bar}} \]
na \(n_{bar}=23{,}040\).
Ubadilishaji huu hugawanya cumulative simple ROI kwa idadi ya test bar ili kutoa wastani unaoweza kulinganishwa wa mapato kwa kila bar.
Je, Thamani za Sharpe 25–29 katika Utafiti Zinaweza Kusomwa kama Utendaji Halisi wa Jalada?
Hapana. Thamani za Sharpe zilizofanywa za mwaka za 25–29 katika chanzo zinategemea kuongeza Sharpe ya kila saa kwa \(\sqrt{8760}\) na dhana ya mapato ya i.i.d.; mwandishi anaonyesha katika ujumuishaji wa kila siku na ukaguzi wa Newey–West HAC kwamba thamani kamili hushuka kwa kiasi kikubwa na anasisitiza metric ya net bp/bar kama ushahidi mkuu wa kiuchumi. Vivyo hivyo, mikunjo ya cumulative non-compound ROI inayofikia maelfu ya asilimia si mapato halisi ya jalada yaliyokokotolewa kwa compound.
Ukaguzi wa uthabiti wa Sharpe wa kila siku
| Loss | Sharpe ya kila siku iliyofanywa ya mwaka | Tofauti dhidi ya CE |
|---|---|---|
| CE | 23,89 ± 1,10 | — |
| MADL | 23,99 ± 0,14 | +%0,4 |
| Profit-Guided | 24,15 ± 1,04 | +%1,1 |
| Sharpe | 24,31 ± 0,87 | +%1,8 |
| RWCE | 24,63 ± 0,30 | +%3,1 |
| Asymmetric | 23,49 ± 1,29 | -%1,7 |
Hasa kubadilika kwa matokeo ya kila saa ya Asymmetric kutoka +%5,5 hadi -%1,7 katika kipimo cha kila siku kunaonyesha jinsi frequency ya annualization ilivyo muhimu kwa tafsiri.
Matokeo ya Newey–West HAC
| Loss | IID Sharpe | Newey–West Sharpe | NW/IID SE inflator | p vs CE, NW |
|---|---|---|---|---|
| CE | 27,07 ± 0,72 | 16,37 ± 0,38 | 1,65 | — |
| MADL | 28,39 ± 0,43 | 16,73 ± 0,28 | 1,70 | 0,054 |
| RWCE | 28,02 ± 0,54 | 16,64 ± 0,35 | 1,68 | 0,222 |
Bonferroni m=2 ikitumika, matokeo ya MADL yanaongezeka hadi p=0,108. Mpangilio unabaki, lakini uhakika wa kitakwimu wa tofauti ya Sharpe si mkubwa kama matokeo ya per-bar return.
Marekebisho ya ulinganisho mwingi
Katika ulinganisho uliopangwa awali wa MADL, RWCE na Asymmetric vs CE Sharpe, paired t-test, Bonferroni, Holm na Wilcoxon zinaunga mkono kwamba return-weighted trio iko juu ya CE.
| Loss | ∆Sharpe | p raw | p Bonferroni | p Holm |
|---|---|---|---|---|
| MADL | +1,46 | <0,001 | <0,001 | <0,001 |
| RWCE | +1,45 | <0,001 | <0,001 | <0,001 |
| Asymmetric | +1,48 | <0,001 | 0,0025 | 0,0015 |
| Profit-Guided | -0,34 | 0,1699 | 0,8495 | 0,1699 |
| Sharpe default | -1,34 | 0,0061 | 0,0306 | 0,0123 |
Cohen’s d itafsiriweje?
Kwa MADL paired Cohen’s d=2,63, kwa RWCE 2,51, na kwa Asymmetric 2,09. Chanzo kinasisitiza hasa kwamba effect-size hizi kubwa hazimaanishi uthabiti wa ulimwengu wote katika kiwango cha soko. Variance katika denominator inatokana tu na training stochasticity ya mafunzo yenye random seed tofauti.
Kwa hiyo d>2 haimaanishi “athari kubwa sana katika masoko ya dunia”; inaonyesha kwamba chini ya data na hali zilezile za modeli, tofauti ya loss ni kubwa ikilinganishwa na seed-noise.
Matokeo ya market regime
| Loss | Up Sharpe | Down Sharpe | Flat Sharpe |
|---|---|---|---|
| CE | 29,6 | 29,6 | 25,4 |
| MADL | 30,8 | 31,3 | 26,9 |
| RWCE | 31,0 | 31,3 | 26,8 |
| Asymmetric | 30,7 | 31,2 | 27,0 |
| Profit-Guided | 29,0 | 29,1 | 25,1 |
| Sharpe Loss | 27,9 | 26,8 | 24,6 |
Faida kubwa zaidi ya jamaa ya return-weighted loss dhidi ya CE inaonekana katika down-period. MADL hutoa Sharpe 31,3 na CE 29,6; tofauti ni takribani %5,7.
Transaction-cost sensitivity
| Gharama ya upande mmoja | CE Sharpe | MADL Sharpe | RWCE Sharpe |
|---|---|---|---|
| %0,05 | 35,1 | 36,5 | 36,4 |
| Bybit taker ≈ %0,055 | 33,9 | 35,4 | 35,3 |
| %0,1 baseline | 26,4 | 28,4 | 28,2 |
| %0,2 | 10,6 | 13,4 | 13,0 |
| %0,5 | -19,0 | -15,4 | -16,0 |
Je, Faida ya Return-Weighted Loss Inadumu Gharama za Miamala Zinapoongezeka?
Katika wigo wa %0,05–%0,5 wa gharama ya muamala wa upande mmoja uliopimwa katika chanzo, mpangilio wa MADL≈RWCE>CE unadumu; lakini kwa gharama ya %0,5 utendaji wa mikakati yote mitatu huwa hasi. Kwa hiyo utafiti hauonyeshi kwamba return-weighted loss huondoa gharama, bali kwamba ni imara zaidi kuliko CE katika viwango vya gharama vilivyopimwa.
Katika baseline ya %0,1, chanzo kinakadiria MADL kuzalisha takribani %8,4 na RWCE %6,9 gharama ya jumla ya miamala iliyo chini kuliko CE. Mwandishi anahusisha hili na kupungua kwa mabadiliko yasiyo ya lazima ya position katika bar zenye ishara dhaifu.
Ablation ya kipindi kimoja cha muda
| Loss | 15m-only accuracy | Sharpe | ROI diagnostic |
|---|---|---|---|
| CE | 52,33% | -5,77 | -767,1% |
| MADL | 50,26% | -3,35 | -445,4% |
| RWCE | 50,64% | -3,13 | -416,9% |
| Asymmetric | 50,83% | -5,69 | -755,8% |
| Profit-Guided | 52,75% | -5,68 | -756,4% |
| Sharpe Loss | 51,53% | -3,83 | -506,3% |
Ablation hii inaonyesha kwamba multi-timeframe representation ndiyo chanzo kikuu cha ishara ya modeli.
Unyeti wa clipping wa \(\tau\)
| \(\tau\) | Accuracy | Sharpe | Max DD |
|---|---|---|---|
| 1 | 72,05% | 27,6 | -2,68% |
| 2 | 72,51% | 28,0 | -2,54% |
| 3, RWCE | 72,33% | 28,2 | -2,43% |
| 5, MADL | 72,12% | 28,4 | -2,38% |
| 10 | 71,65% | 27,3 | -2,57% |
Katika split kuu kuna pattern ya U iliyogeuzwa. Hata hivyo, katika walk-forward fold uchunguzi mpana wa \(\tau=\{1,2,3,5,7,10,15\}\) ulionyesha kwamba chaguo za \(\tau\ge2\) hazikuweza kutofautishwa kwa kuaminika ndani ya fold. Kwa hiyo si sahihi kutafsiri \(\tau=5\) kama optimum ya ulimwengu wote.
Replication ya Binance spot
| Loss | Accuracy | Sharpe |
|---|---|---|
| CE | 70,56 ± 0,53% | 27,86 ± 0,38 |
| MADL | 69,13 ± 0,80% | 28,47 ± 1,16 |
| RWCE | 70,18 ± 0,15% | 29,56 ± 0,91 |
| Asymmetric | 69,74 ± 0,43% | 28,57 ± 1,10 |
| Profit-Guided | 70,43 ± 0,60% | 27,77 ± 0,58 |
| Sharpe Loss | 68,96 ± 1,13% | 27,82 ± 0,53 |
Katika kipindi cha Binance spot, mwelekeo wa ubora wa familia ya return-weighted unabaki; lakini tofauti ya MADL–CE Sharpe hupungua kutoka takribani +%5,4 kwenye Bybit BTC perpetual hadi takribani +%2,2. Ukubwa wa athari unategemea rejimu ya soko.
Uthibitishaji wa cross-asset wa ETH/USDT
| Loss | Accuracy | Sharpe | Max DD |
|---|---|---|---|
| MADL | 0,7204 ± 0,0019 | 31,22 ± 0,78 | -5,05 ± 0,79% |
| Asymmetric | 0,7219 ± 0,0025 | 31,13 ± 0,70 | -4,86 ± 0,58% |
| RWCE | 0,7223 ± 0,0017 | 31,08 ± 0,60 | -5,05 ± 0,80% |
| CE | 0,7232 ± 0,0013 | 30,45 ± 0,63 | -5,05 ± 0,46% |
| Profit-Guided | 0,7222 ± 0,0021 | 30,36 ± 0,71 | -5,12 ± 0,46% |
| Sharpe Loss | 0,7152 ± 0,0018 | 29,27 ± 0,57 | -6,30 ± 1,71% |
Ubora wa Sharpe wa MADL, Asymmetric na RWCE dhidi ya CE ni muhimu pia kwenye ETH; lakini effect size hushuka hadi takribani \(d\approx1\). Kulingana na chanzo, ikilinganishwa na \(d>2\) kwenye BTC, kubana huku kunatokana na gap ndogo ya wastani na cross-seed variance kubwa zaidi.
Uthibitishaji wa walk-forward
| Loss | Bear Sharpe | Recovery Sharpe | Bull Sharpe | Wastani |
|---|---|---|---|---|
| CE | 22,9 | 17,0 | 27,7 | 22,5 |
| MADL | 24,0 | 20,9 | 28,2 | 24,3 |
| RWCE | 24,0 | 20,4 | 28,2 | 24,2 |
| Asymmetric | 23,7 | 20,6 | 28,4 | 24,2 |
| Profit-Guided | 23,1 | 19,1 | 27,4 | 23,2 |
| Sharpe Loss | 23,8 | 18,2 | 27,1 | 23,0 |
Return-weighted trio inaonekana juu ya CE katika kila fold. Hata hivyo, kwa kuwa kuna fold tatu tu, paired t-test fold means si muhimu. Matokeo ya p=5,6×10⁻⁴ ya Page trend test yanatoa ushahidi wa ziada kwamba mpangilio si wa nasibu.
Utafutaji wa giperparameta za PGL
\(\alpha\in\{0.1,0.3,0.5,1.0,2.0\}\) na warmup \(\in\{0,3,5,10\}\), yaani usanidi 20 × seed 3, ulipimwa. PGL bora:
\(\alpha=1.0\), warmup=0, Sharpe≈27,0
ilikuwa. Katika seed hizo tatu CE baseline ni 26,42. Uboreshaji huu haufikii kiwango cha MADL/RWCE 28,5.
Utafutaji wa giperparameta za Sharpe Loss
\(\beta\in\{0.1,0.3,0.5,0.7,0.9\}\) na warmup \(\in\{0,3,5,10\}\) zilipimwa. Usanidi bora:
\(\beta=0.3\), warmup=0, Sharpe=28,00±0,60
ulikuwa. Matokeo haya yanaonyesha kuwa Sharpe Loss inaweza kurejeshwa kwa tuning sahihi, lakini inahitaji utafutaji wa pande mbili wenye gharama zaidi kuliko parameta moja ya \(\tau\) ya return-weighted loss.
Pilot za weighting mbadala
Katika Appendix G, Confidence-Weighted LRW na GMADL zilijaribiwa kama pilot. Confidence-Weighted LRW inaonekana kuwa -0,66 Sharpe chini ya MADL; GMADL kwa chaguomsingi \(a=10,b=2\) hushusha accuracy hadi takribani %61,7 na Sharpe hadi 22,14.
Chanzo hakichukulii matokeo ya GMADL kama ushahidi wa haki wa head-to-head superiority. Kinaeleza kwamba parameta zilikalibishwa kwa data ya equity yenye frequency ya chini, hakuna grid search tofauti ya \((a,b)\) iliyofanywa, na matokeo ni “default-hyperparameter transfer failure”.
Algorithm 1: kuchagua loss
| Lengo la trading | Loss inayopendekezwa | Mantiki ya chanzo |
|---|---|---|
| General-purpose | RWCE, \(\tau=3\) | Accuracy ya juu + top-tier Sharpe + seed variance ndogo |
| Max Sharpe, aggressive | MADL, \(\tau=5\) | Top-tier Sharpe, top-tier std ya chini zaidi, drawdown ndogo zaidi |
| Max Sharpe, conservative | RWCE, \(\tau=3\) | Top-tier Sharpe na accuracy ya juu zaidi |
| Asymmetric preference | Asymmetric Directional | Upendeleo wa hatari ya mwelekeo kupitia \(\lambda_{up}\) na \(\lambda_{down}\) |
| Maximum accuracy only | Cross-Entropy | Haihitaji HP ya kifedha |
Algorithm 1 pia hutoa onyo wakati gharama ya muamala \(c>0.005\), kwa kutegemea Table 12, kwamba pipeline iliyopimwa haina faida katika kiwango hicho cha gharama.
Kwa nini RWCE ndiyo pendekezo la chaguomsingi?
Chanzo kinachagua RWCE kama chaguomsingi ya general-purpose kwa sababu katika jaribio kuu la BTC inatoa accuracy ya juu zaidi (%72,31), huku ikiendelea kuwa katika kundi lilelile la top-tier Sharpe kama MADL na Asymmetric, na cross-seed Sharpe variance yake ni ndogo kuliko ya Asymmetric. MADL huhifadhiwa kama chaguo la aggressive maximum-Sharpe; tofauti zenyewe ni ndogo na zinategemea rejimu.
Matokeo yanayoungwa mkono na utafiti
- Kwenye multi-timeframe LSTM-fusion, return-magnitude weighting inaweza kutoa net bp/bar ya juu zaidi kwa accuracy inayofanana na CE.
- MADL na RWCE katika implementa hii ziko katika familia moja ya \(L_{RW}(\tau)\) na hutumia thamani tofauti za \(\tau\).
- Katika split kuu ya BTC, MADL/RWCE/Asymmetric zina takribani %4,9–%5,0 zaidi ya CE katika mapato halisi kwa kila bar.
- Matokeo makuu ya per-bar ya return-weighted trio yanadumu baada ya marekebisho ya multiple testing.
- Cross-seed variance hupungua kwa kiasi kikubwa katika MADL ikilinganishwa na CE.
- Mbinu za return-weighted zilitoa Sharpe ya juu kuliko CE katika rejimu za up, down na flat market.
- Uthibitishaji wa Binance BTC spot na ETH/USDT unaunga mkono mpangilio wa mwelekeo.
- Katika walk-forward fold zote tatu return-weighted trio inabaki juu ya CE.
- Single-timeframe ablation inaonyesha kwamba utendaji wenye nguvu unategemea kwa kiasi kikubwa multi-timeframe representation.
- Kushindwa kwa Sharpe Loss ya chaguomsingi kunaweza kurejeshwa kwa sehemu baada ya tuning.
Matokeo ambayo utafiti hauungi mkono
- Haijaonyeshwa kwamba return-weighted loss lazima ziwe na faida katika live trading.
- Cumulative ROI ya maelfu ya asilimia si mapato halisi, compound na yanayoweza kutekelezwa ya uwekezaji.
- Thamani za Sharpe 25–29 si Sharpe halisi ya jalada iliyo huru na dhana ya i.i.d.
- Haijaonyeshwa kwamba MADL ni bora kuliko RWCE katika mali zote za crypto au masoko yote.
- Haijaonyeshwa kwamba \(\tau=5\) ni optimum ya ulimwengu wote.
- Haijapimwa kama return-weighting hutoa faida ya ukubwa uleule katika SOL, XRP au mali za jadi za low-kurtosis.
- Full-size position sizing haiwakilishi bajeti halisi ya hatari.
- Funding, market impact na execution halisi ya order book hazijajumuishwa kikamilifu katika modeli kuu ya backtest.
- Haijaonyeshwa kwamba mpangilio wa loss uliopatikana kwenye usanifu mmoja unabaki sawa katika Transformer au backbone nyingine.
- Cross-seed Cohen’s d si kipimo cha market-level external validity.
Vikwazo vikuu
- Upeo wa cross-asset umewekewa BTC na ETH.
- Hakuna udhibiti wa soko la jadi la low-\(\kappa\).
- Model backbone ni LSTM-attention iliyo thabiti.
- Feature normalization inafanywa kwa global StandardScaler; rolling normalization haijapimwa.
- Slippage ni %0,05 isiyobadilika katika jaribio kuu.
- Funding haijajumuishwa katika utendaji mkuu wa backtest; chanzo kinasema ranking inadumu katika ukaguzi tofauti.
- Kwa PGL, early-stopping patience >10 haijapimwa.
- Walk-forward ni 3 fold × 3 seed pekee.
- Signal-decay leakage diagnostic imefanywa kwa seed moja.
- Uthibitishaji wa ETH unahusisha kipindi na rejimu tofauti.
- Position sizing ni full-size kwa kila ishara.
- Kelly sizing au volatility targeting haikutumika.
- Hakuna ulinganisho mpana zaidi wa differentiable-Sharpe, distributional-regression na focal-loss.
Maeneo ya utafiti wa baadaye
Chanzo kinapendekeza uchaguzi wa data-driven wa \(\tau\), mali za ziada kama SOL/XRP, udhibiti wa low-kurtosis, Kelly au volatility-targeting deployment, live trading halisi, Transformer/gated-fusion backbone na ulinganisho wa moja kwa moja na familia pana zaidi za loss kama maeneo ya utafiti wa baadaye.
Maelezo ya Chanzo na Mbinu
Kichwa kamili cha asili: Beyond Accuracy: A Systematic Comparison of Profit-Aware Loss Functions for Multi-Timeframe Cryptocurrency Price Prediction.
Mwandishi: Haruki Tanabe.
Corresponding author: Haruki Tanabe.
ORCID: 0009-0000-9423-5609.
Uhusiano wa PDF: School of Computer Science, Tokyo University of Technology, 1404-1 Katakuracho, Hachioji, Tokyo, Japan.
Jukwaa: SSRN.
SSRN Abstract ID: 6928679.
DOI: 10.2139/ssrn.6928679.
Tarehe ya posting: 12 Juni 2026.
Idadi ya kurasa: 61.
Aina ya chanzo: Preprint research paper.
Hali ya peer review: Chanzo kinaeleza wazi kwamba kazi haijapitia peer review.
Toleo lililopitiwa: Katika uthibitishaji wa sasa wa bibliografia, version of record tofauti haijathibitishwa.
Leseni: SSRN — All rights reserved; hakuna matumizi tena bila ruhusa.
Maneno muhimu: Loss function design; Cryptocurrency prediction; Multi-timeframe analysis; Deep learning; Trading profitability.
Data kuu: BTC/USD Bybit perpetual, 1 Oktoba 2019–31 Desemba 2024.
Uchunguzi mkuu: Bar 552.672 za OHLCV za dakika 5.
Vipindi vya muda: 5m, 15m, 1h, 4h, 1d.
Lengo kuu: Utabiri wa mwelekeo wa saa 1, \(y_t=\mathbf{1}[p_{t+4}>p_t]\).
Idadi ya vipengele: 19 kwa kila timeframe.
Modeli: LSTM encoder tano huru za tabaka mbili + scaled dot-product attention fusion + binary classifier.
Hidden size: 128.
Dropout: 0,2.
Jumla ya parameta: Takribani milioni 1,1.
Optimizer: Adam.
Learning rate: 0,001.
Batch size: 64.
Early stopping: patience 10, maksimum 100 epoch.
Seed: 42–51 katika majaribio makuu.
Loss kuu: CE, MADL, Profit-Guided, Sharpe Loss, RWCE, Asymmetric Directional.
MADL chaguomsingi: \(\tau=5\).
RWCE chaguomsingi: \(\tau=3\).
Profit-Guided chaguomsingi: \(\alpha=0.5\), warmup 5.
Sharpe Loss chaguomsingi: \(\epsilon=10^{-6}\), warmup 5, CE floor 0,5.
Asymmetric chaguomsingi: \(\lambda_{up}=1.5\), \(\lambda_{down}=1.5\), \(\tau_{mag}=3\).
Matokeo makuu ya kiuchumi: CE 14,83 bp/bar; return-weighted trio 15,55–15,57 bp/bar.
Ongezeko kuu la jamaa: Takribani +%4,9–%5,0.
Matokeo makuu ya multiple-comparison: Katika ulinganisho uliopangwa wa MADL/RWCE/Asymmetric vs CE Sharpe, umuhimu hudumu baada ya Bonferroni.
IID Sharpe ya mwaka: CE 27,07; MADL 28,53; RWCE 28,52; Asymmetric 28,56.
Kikomo cha tafsiri: Thamani hizi kamili za Sharpe zinategemea annualization ya kila saa ya i.i.d. kwa \(\sqrt{8760}\).
Tofauti za Sharpe za kila siku: Katika return-weighted trio, takribani +%0,4 hadi +%3,1 dhidi ya CE; Asymmetric hubadilika hadi -%1,7 katika hesabu ya kila siku.
Newey–West HAC: Ranking hudumu; kwa MADL vs CE raw p=0,054, baada ya Bonferroni takribani 0,108.
Matokeo ya cross-seed variance: Variance ya net bp/bar ya MADL ni takribani %58 chini kuliko CE.
Trading cost baseline: %0,1 / muamala + %0,05 slippage.
Cost sensitivity: Katika kiwango cha %0,5 / muamala, mikakati yote mikuu iliyopimwa ni hasi.
Cross-exchange validation: Binance BTC/USDT spot, 2023-07–2024-12.
Cross-asset validation: ETH/USDT Bybit perpetual, takribani 2021-03-15–2024-12-31.
Walk-forward: Expanding-window fold tatu: Bear, Recovery na Bull.
Ukaguzi wa leakage: Shuffled labels test accuracy %50,79; normal labels takribani %72.
Vifaa vya reproducibility: NVIDIA RTX 5070 Ti, 16 GB VRAM; CUDA 12.8; PyTorch 2.7.
Bajeti ya kukokotoa ya jaribio kuu: 6 loss × 10 seed = 60 run, takribani saa 2,5.
Upatikanaji wa data: BTC/ETH OHLCV inaweza kupatikana kutoka Bybit v5 na Binance Spot API. Trained artefacts, numerical CSV na code zinaweza kutolewa na mwandishi kwa ombi linalofaa.
Ufadhili: Hakuna grant maalum kutoka taasisi za umma, kibiashara au zisizo za faida iliyopokelewa.
Mgongano wa maslahi: Mwandishi haripoti competing financial interest inayojulikana au uhusiano binafsi unaoweza kuathiri kazi.
CRediT: Haruki Tanabe — Conceptualization, Methodology, Software, Validation, Formal analysis, Investigation, Data Curation, Writing – Original Draft, Writing – Review & Editing, Visualization.
Taarifa ya Generative AI: Anthropic Claude Opus 4; ilitumika kwa manuscript editing, reviewer-response anticipation, statistical sanity-checking na LaTeX formatting. Uwajibikaji wa mwisho wa maudhui ni wa mwandishi.
Kikomo kikuu cha external validity: Matokeo ya chanzo yamethibitishwa hasa kwa masoko ya crypto ya BTC/ETH na LSTM-attention backbone iliyotumika; ujanibishaji kwa mali zenye kurtosis ya chini au familia nyingine za modeli lazima upimwe tofauti.
Kikomo cha backtest: Utafiti si wa live trading; unatumia full-size hard position, modeli iliyorahisishwa ya cost/slippage na non-compound diagnostic equity.
Kikomo cha hakimiliki: Kwa kuwa toleo la SSRN la chanzo ni All rights reserved, mpangilio wa figure wa asili au screenshots hazipaswi kutumiwa tena; ni namba za ukweli na mahusiano ya mbinu tu yanayopaswa kuwasilishwa upya kwa michoro mipya ya Verianla.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *