

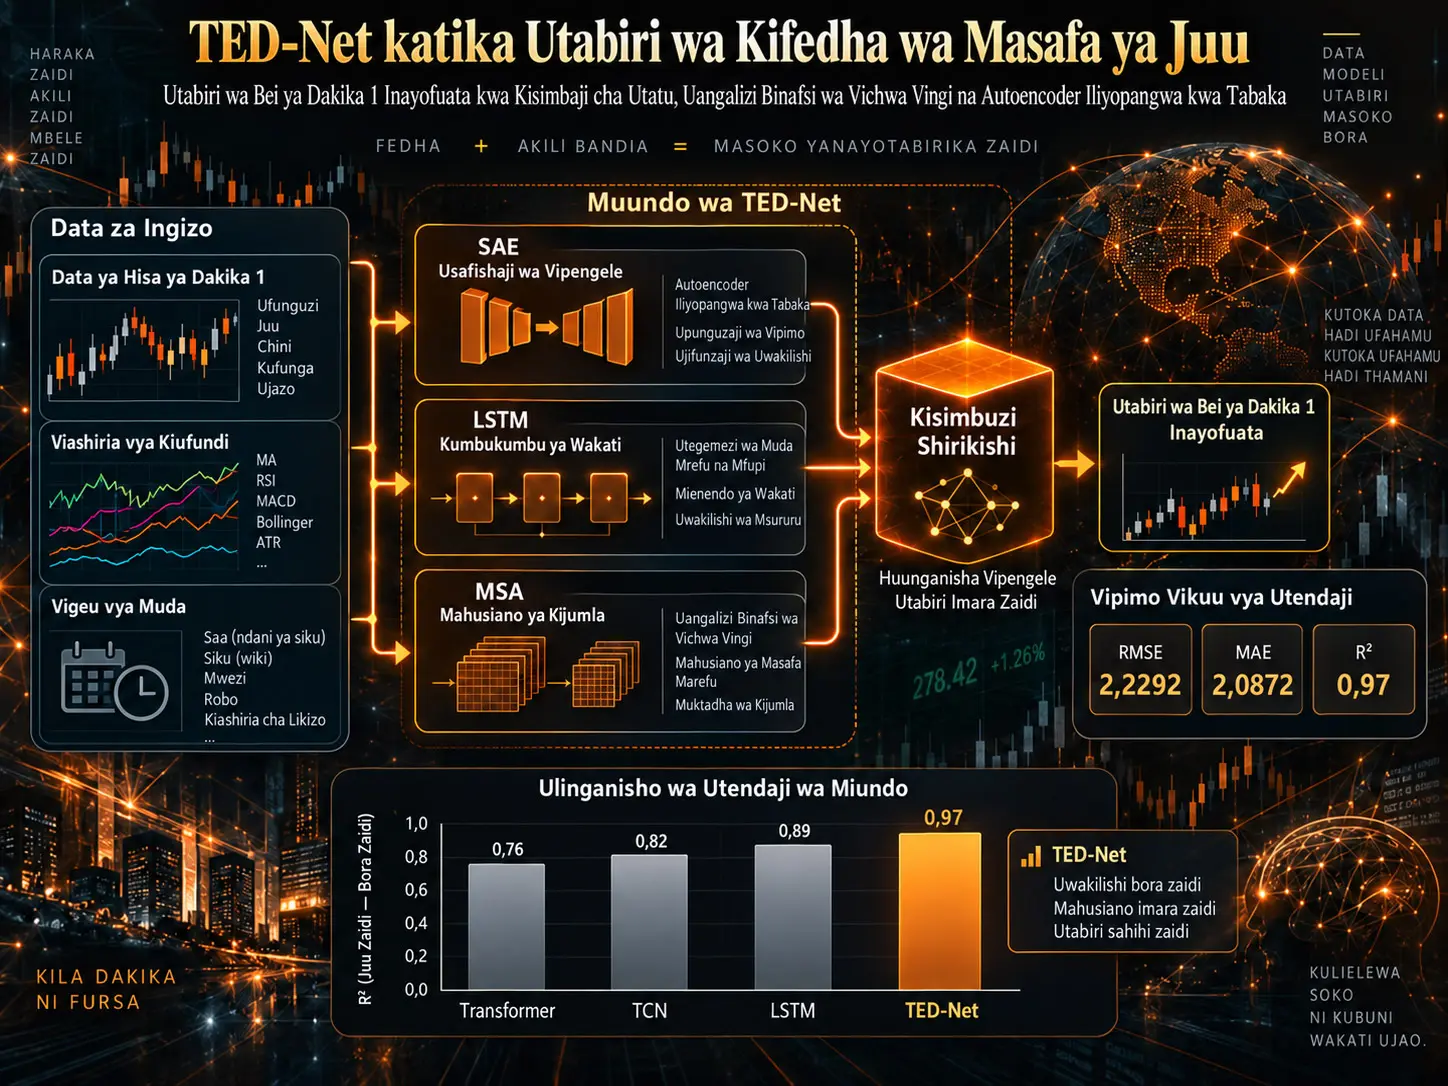
Mfululizo wa muda wa kifedha ni vyanzo vigumu vya data kwa miundo ya utabiri kwa sababu ya muundo usio wa mstari, sifa za kitakwimu zinazobadilika, kelele nyingi na utegemezi wa muda mrefu. Utafiti huu unapendekeza usanifu mseto wa ujifunzaji wa kina uitwao TED-Net (Triple Encoder-Decoder Network) ili kushughulikia matatizo haya ndani ya modeli moja. TED-Net inaunganisha mbinu tatu tofauti za usimbaji: Stacked Autoencoder (SAE) husafisha vipengele na kuunda uwakilishi wa vipimo vichache zaidi; LSTM-Seq2Seq hujifunza utegemezi wa muda mfupi na muda mrefu katika mfululizo; Multi-Head Self-Attention (MSA) hujaribu kunasa mahusiano ya jumla kati ya nyakati tofauti na nafasi ndogo za uwakilishi. Vyanzo hivi vitatu vya taarifa huunganishwa na collaborative decoder inayotumia gated fusion na attention ili kutoa utabiri wa bei inayofuata.
Katika majaribio, kwa hisa 15 za A-share kutoka sekta na thamani tofauti za soko, kila moja ilitumia uchunguzi 24.000 wa dakika moja; %80 ya kwanza ilitengwa kwa training na %20 ya mwisho kwa validation. Katika kazi kuu ya utabiri, bei ya kufunga ya dakika inayofuata hutabiriwa kwa kutumia taarifa za dakika 30 zilizopita. Chanzo kinaeleza kuwa TED-Net ilionyesha usahihi wa juu zaidi ulioripotiwa katika majedwali mengi au yote ya wastani wa hisa katika ulinganisho na Transformer, TCN na LSTM-Seq2Seq. Katika jaribio tofauti la CATL, TED-Net iliripoti RMSE 2,2292, MAE 2,0872 na R² 0,97.
Hata hivyo, usemi “high-frequency trading” katika utafiti huu unapaswa kufasiriwa kwa tahadhari. Data iliyotumika ni mfululizo wa muda wa dakika moja, na modeli haifanyi kazi kwenye ujumbe halisi wa kitabu cha oda au mtiririko wa execution wa kiwango cha mikrosekunde. Aidha, utafiti hujaribu utabiri wa bei, si mkakati wa biashara; hauwasilishi matokeo ya P&L, transaction cost, slippage, Sharpe ratio au utekelezaji wa oda moja kwa moja.
| Kipengele | Kazi kuu |
|---|---|
| Stacked Autoencoder — SAE | Kupunguza kelele za vipengele na kutoa uwakilishi uliofinywa zaidi |
| LSTM-Seq2Seq | Kuunda modeli ya utegemezi wa muda mfupi na muda mrefu |
| Multi-Head Self-Attention — MSA | Kunasa mahusiano ya jumla kati ya nyakati tofauti |
| Dynamic Window Attention | Kupunguza eneo la hesabu ya attention katika mifuatano mirefu |
| Collaborative Decoder | Kuunganisha kwa kubadilika taarifa zinazotoka kwa encoder tatu |
| Tokeo | Utabiri wa bei ya dakika inayofuata |
TED-Net inajaribu kutatua matatizo gani matatu?
Utafiti wa chanzo unaeleza utabiri wa kifedha wa masafa ya juu kupitia matatizo matatu ya msingi.
Tatizo la vipengele: Viashiria vya kifedha vinaweza kuwa na uhusiano mkubwa kati yao na vinaweza kuwa na kelele nyingi. Vigezo vingi vinavyofanana au vyenye taarifa kidogo vinaweza kufanya mafunzo ya modeli kuwa magumu.
Tatizo la muda: Katika mifuatano mirefu, taarifa za zamani zinaweza kupotea kadiri muda unavyopita. Ingawa LSTM hupunguza tatizo hili ikilinganishwa na RNN za kawaida, bado inaweza kupata ugumu wa kuhifadhi taarifa zote za kihistoria kwa kiwango sawa katika mifuatano mirefu sana.
Tatizo la uhusiano: Modeli moja ya mfuatano inaweza kujifunza mahusiano ya karibu ya muda, lakini inaweza kuwakilisha kwa upungufu mahusiano ya jumla kati ya sehemu tofauti za mfuatano.
TED-Net hujaribu kujibu matatizo haya matatu kwa SAE, LSTM na MSA kwa mtiririko huo.
Usanifu wa usimbaji wa sehemu tatu hufanyaje kazi?
Mtiririko wa jumla wa ujifunzaji katika chanzo:
Usafishaji wa vipengele → Uundaji wa modeli ya muda → Utoaji wa uhusiano wa jumla → Decoding ya pamoja → Utabiri
unaweza kufupishwa kwa namna hii.
Katika hatua ya kwanza, SAE hubadilisha viashiria vya kifedha kuwa uwakilishi latent uliofinywa zaidi. Tokeo hili huchakatwa na LSTM kama mfuatano wa muda. MSA huhesabu mahusiano kati ya nyakati tofauti katika mfuatano kwa kutumia uzito wa attention. Kisha Decoder huunganisha uwakilishi huu mitatu ili kutoa utabiri mmoja.
Kwa nini Stacked Autoencoder inatumika?
Autoencoder ni mtandao wa neva unaosimba ingizo kuwa uwakilishi latent wa vipimo vichache zaidi na kisha kujaribu kulijenga upya. Modeli inapojifunza kujenga upya ingizo huku ikihifadhi tu mifumo muhimu, athari za kelele na vigezo visivyo muhimu zinaweza kupunguzwa.
Katika chanzo, tabaka za encoding:
\[ h^{(l)} = \sigma \left( W^{(l)}h^{(l-1)}+b^{(l)} \right) \]
zinaelezwa kwa namna hii.
Katika TED-Net, SAE si chombo huru tu cha uchakataji wa awali, bali ni kipengele cha kwanza cha muundo wa encoder wa sehemu tatu.
LSTM hubeba taarifa gani?
Kwa msaada wa memory cell, input gate, forget gate na output gate, LSTM hujifunza ni taarifa zipi za zamani zinapaswa kuhifadhiwa au kusahauliwa.
Chanzo hufafanua sasisho la msingi la LSTM kama:
\[ i_t=\sigma(W_{xi}x_t+W_{hi}h_{t-1}+W_{ci}c_{t-1}+b) \]
\[ f_t=\sigma(W_{xf}x_t+W_{hf}h_{t-1}+W_{cf}c_{t-1}+b) \]
\[ c_t=f_tc_{t-1}+i_t\tanh(W_{xc}x_t+W_{hc}h_{t-1}+b) \]
\[ o_t=\sigma(W_{xo}x_t+W_{ho}h_{t-1}+W_{co}c_t+b) \]
\[ h_t=o_t\tanh(c_t) \]
.
Katika muundo wa Seq2Seq, encoder huchakata mfuatano uliopita, huku decoder ikitumia uwakilishi uliopatikana kutoka encoder kutoa mfuatano lengwa au thamani ya baadaye.
Kwa nini Multi-Head Self-Attention imeongezwa?
Kwa sababu LSTM hufanya kazi kwa mfuatano, uhusiano kati ya nyakati mbili zilizo mbali hupitishwa kupitia hali nyingi za kati. Self-attention, kwa upande mwingine, inaweza kuhesabu moja kwa moja ni kiasi gani wakati mmoja unapaswa kuzingatia nyakati nyingine.
Chanzo:
\[ Q=W_QX+b_Q,\qquad K=W_KX+b_K,\qquad V=W_VX+b_V \]
hutumia mabadiliko haya.
Kisha uzito wa attention:
\[ \alpha_t= Softmax \left( \frac{Q_tK_t^T}{\sqrt{d_h}} \right) \]
huhesabiwa kwa namna hii.
Dynamic Window Self-Attention ni nini?
Kwa sababu self-attention kamili huhitaji kulinganisha nyakati zote na nyakati nyingine katika mifuatano mirefu, gharama ya hesabu inaweza kuongezeka haraka.
Kwa hiyo TED-Net inapendekeza, kwa kila nukta \(t\), kutumia tu vekta za key na value zilizo katika dirisha fulani la \(S_t\).
Lengo la mbinu hii ni:
- kupunguza gharama ya attention,
- kuelekeza umakini kwenye nyakati za karibu na zinazohusiana,
- na kupunguza mzigo wa hesabu katika mifuatano mirefu ya kifedha.
Chanzo hakitoi kwa undani algorithimu au kanuni ya uboreshaji ya jinsi urefu wa dirisha unavyochaguliwa kwa nguvu; muundo mkuu wa kihisabati ni kuhesabu self-attention ndani ya dirisha.
Je, modeli kweli hutumia data ya HFT ya kiwango cha mikrosekunde?
Hapana. Ingawa chanzo kinataja katika utangulizi asili ya HFT ya kiwango cha mikrosekunde, data ya majaribio ina masafa ya dakika moja.
Kazi kuu:
taarifa za dakika 30 zilizopita → bei ya kufunga ya dakika 1 inayofuata
.
Kwa hiyo, utafiti unapaswa kutathminiwa katika muktadha wa utabiri wa mfululizo wa muda wa kifedha wa azimio la juu, badala ya utafiti wa order-book HFT au execution yenye latency ndogo.
Mbinu na Matokeo ya Utafiti
Muundo wa data
Utafiti ulichagua hisa 15 za A-share kutoka sekta na thamani tofauti za soko.
Kwa kila hisa:
- uchunguzi 24.000 wa dakika moja,
- %80 training,
- %20 validation,
- sequence ya muda mfupi ya dakika 30,
- sequence ya muda mrefu ya dakika 120
zimefafanuliwa.
Chanzo kinaeleza katika sehemu hiyo hiyo kuwa modeli hutumia dakika 30 zilizopita kutabiri bei ya kufunga ya dakika inayofuata. Njia kamili ya kutumia sequence ya muda mrefu ya dakika 120 ndani ya modeli imeelezwa kwa undani mdogo.
Vipengele
Inaelezwa kuwa muundo wa awali wa data una indicator 15. Baada ya PCA, chanzo kinaripoti viashiria saba:
- MACD,
- TRIX,
- VR,
- OBV,
- ROC,
- MTM,
- PSY.
Thamani 0,78, 0,69, 0,76, 0,68, 0,75, 0,72 na 0,67 zimehusishwa navyo. Hata hivyo, chanzo hakielezi kama thamani hizi ni PCA loading, mchango wa variance au feature score nyingine.
Vigezo vya msingi vya mafunzo
| Kigezo | Thamani |
|---|---|
| Tabaka la LSTM | 3 |
| Hidden unit | 128 |
| Learning rate | 0,007 |
| Dropout | 0,03 jaribio kuu; 0,1 jaribio la kulinganisha |
| Optimizer | Adam |
| Batch size | 100 |
| Sequence length | 30 |
| Loss | MSE + L2 regularization |
Katika jaribio la kulinganisha, Transformer ilipewa \(d_m=128\), attention head nane na encoder/decoder layer sita; TCN ilipewa kernel size 3, dilation base 2, residual block sita na filter 64.
Majaribio ya ablation
| Modeli | AUC | Precision | Recall | MF1 |
|---|---|---|---|---|
| LSTM-Seq2Seq | 0,83 | 0,95 | 0,80 | 0,87 |
| + SAE | 0,88 | 0,96 | 0,85 | 0,91 |
| TED-Net: SAE + MSA | 0,92 | 0,98 | 0,89 | 0,94 |
Jedwali linaonyesha kuwa metriki zilizoripotiwa huongezeka kadiri SAE na MSA zinavyoongezwa.
Hata hivyo, ingawa kazi kuu ya modeli ni regression ya bei, jedwali hili linatumia metriki za classification. Chanzo hakielezi jinsi bei iliyotabiriwa ilivyobadilishwa kuwa lebo ya “rising / non-rising”, decision threshold au mgawanyo wa madarasa. Kwa hiyo, haiwezekani kuzalisha upya jedwali hili la ablation kikamilifu.
Ulinganisho wa hisa kumi na tano
Katika Table 3, chanzo kinatoa asilimia za “prediction accuracy” kwa hisa 15 kwa Transformer, TCN, LSTM-Seq2Seq na TED-Net.
| Hisa | Transformer | TCN | LSTM-Seq2Seq | TED-Net |
|---|---|---|---|---|
| ZTE | %87,73 | %86,04 | %87,18 | %89,12 |
| Gansu Consulting | %95,37 | %95,14 | %95,08 | %96,21 |
| East Money | %96,79 | %96,63 | %96,91 | %97,82 |
| BYD | %91,96 | %92,28 | %92,15 | %93,67 |
| Shanxi Coking | %71,13 | %68,28 | %72,79 | %75,06 |
TED-Net inaonyesha thamani ya juu zaidi katika safu zote 15 za wastani zilizoorodheshwa katika Table 3.
Hata hivyo, kwa kuwa chanzo hakitoi ufafanuzi wa kihisabati wa kipimo cha “prediction accuracy”, si salama kufasiri asilimia hizi kama classification accuracy ya kawaida.
Seti ya data ya jaribio la CATL
Katika jaribio tofauti la CATL:
- 8 Julai 2025 – 13 Machi 2026,
- uchunguzi 39.604 wa dakika moja,
- %80 training,
- %20 validation
zilitumika.
Katika Figure 5, chanzo kinaweka muda bora wa mafunzo kuwa takriban epoch 40 na kinaeleza kuwa loss ilitulia karibu na kiwango cha 0,00575.
Matokeo ya CATL
| Modeli | RMSE | MAE | R² |
|---|---|---|---|
| LSTM | 3,4521 | 2,8910 | 0,92 |
| TCN | 3,2145 | 2,7234 | 0,93 |
| Transformer | 3,0876 | 2,6012 | 0,94 |
| TED-Net | 2,2292 | 2,0872 | 0,97 |
Jedwali hili linaonyesha kuwa TED-Net ilitoa RMSE na MAE za chini zaidi pamoja na R² ya juu zaidi katika jaribio la chanzo.
Je, upungufu wa %42 wa RMSE uliotajwa katika chanzo unaweza kuzalishwa upya?
Katika sehemu ya matokeo, inaelezwa kuwa TED-Net ilipunguza RMSE kwa %42,0 dhidi ya baseline. Hata hivyo, wakati thamani za CATL Table 4 zinapotumika:
- LSTM → TED-Net: takriban upungufu wa %35,4,
- TCN → TED-Net: takriban upungufu wa %30,7,
- Transformer → TED-Net: takriban upungufu wa %27,8
hupatikana.
Chanzo hakielezi asilimia %42 ilihesabiwa kutoka jaribio gani tofauti au baseline ipi. Kwa hiyo, Verianla haitumii kiwango hiki kama matokeo ya CATL yaliyothibitishwa.
Je, utafiti huu unaonyesha mkakati wa HFT wenye faida?
Hapana. Modeli hutabiri bei ya dakika inayofuata.
Katika utafiti:
- kanuni ya uamuzi wa kununua/kuuza,
- ukubwa wa nafasi,
- bid-ask spread,
- commission,
- slippage,
- queue position,
- network latency,
- P&L ya biashara iliyotekelezwa,
- Sharpe ratio,
- maximum drawdown
hakuna trading backtest inayofanywa kwa vipengele hivi.
Kwa hiyo, RMSE ya chini au R² ya juu si sawa moja kwa moja na mkakati wa biashara wenye faida kiuchumi.
Nguvu za utafiti
- Kuunganisha SAE, LSTM na MSA katika usanifu mmoja wenye majukumu yaliyo wazi.
- Kuunganisha aina tofauti za uwakilishi kupitia collaborative decoder.
- Kufanya ulinganisho katika hisa kumi na tano tofauti.
- Kuwasilisha matokeo ya ablation kwa SAE na MSA.
- Kuripoti metriki wazi za regression kama RMSE, MAE na R² kwenye CATL.
- Kutumia miundo imara ya mfululizo wa muda kama Transformer na TCN kama benchmark.
Vikwazo vikuu
- Utafiti bado ni v1 preprint ambao haujapitiwa na mapitio ya wenzao.
- Data ya dakika moja si sawa na ufafanuzi wa kawaida wa HFT wa kiwango cha mikrosekunde.
- Dai la data ya “Million-level” haliendani na idadi ya observation iliyoelezwa.
- Mbinu za tathmini za regression na classification zimechanganywa.
- Ufafanuzi wa metriki ya Table 3 accuracy haujatolewa.
- Katika majaribio tofauti, ukubwa wa ingizo hubadilika kati ya 10 na 8.
- Matumizi ya pamoja ya miundo miwili ya sequence ya dakika 30 na 120 hayajaelezwa vya kutosha.
- Maana ya coefficients zilizotolewa baada ya PCA haiko wazi.
- Upungufu wa %42 wa RMSE hauwezi kuthibitishwa moja kwa moja kwa jedwali la CATL.
- Kauli “1,5 yuan average error” haiendani na MAE 2,0872.
- Hakuna trading profitability au execution backtest.
- Bado kuna placeholder za uhariri katika maandishi ya chanzo.
Maelezo ya Chanzo na Mbinu
Kichwa asilia: A Triple Encoder-Decoder Network with Multi-Head Self-Attention and Stacked Autoencoder for High-Frequency Trading Prediction
Waandishi: Zhuxi Zhang; Yan Zhang; Haolin Yuan; Min Zhu; Zihan Zhao.
Taasisi: China Institute of Finance, University of International Business and Economics, Beijing; Digital Technology Research and Development Center, Beijing Research Institute of Ansteel Co., Ltd., Beijing.
Aina ya chanzo: Preprint / Article.
Jukwaa: Preprints.org.
Toleo: Version 1.
Iliwasilishwa: 10 Septemba 2026.
Iliwekwa: 14 Septemba 2026.
DOI: 10.20944/preprints202609.0978.v1.
Hali ya mapitio ya wenzao: Haijapitiwa na mapitio ya wenzao. Chanzo na rekodi ya Preprints.org zinaonyesha wazi kauli “Not peer-reviewed”.
Leseni: Creative Commons Attribution 4.0 International — CC BY 4.0.
Mbinu kuu: Stacked Autoencoder + LSTM-Seq2Seq + Multi-Head Self-Attention + Dynamic Window Attention + collaborative decoder.
Kazi kuu: Kutabiri kwa regression bei ya hisa ya dakika inayofuata kutoka data ya kifedha ya dakika moja.
Jaribio kuu: Hisa 15 za A-share × uchunguzi 24.000 wa dakika moja; %80 training na %20 validation.
Seti ya jaribio la CATL: Uchunguzi 39.604 wa dakika moja kati ya 8 Julai 2025–13 Machi 2026.
Tokeo kuu la CATL: TED-Net RMSE 2,2292; MAE 2,0872; R² 0,97.
Ufadhili: National Major Science and Technology Project of Intelligent Manufacturing Systems and Robots; grant 2025ZD1607900.
Upatikanaji wa data: Waandishi wanaeleza kuwa data inaweza kupatikana kutoka kwa corresponding author kwa ombi.
Mgongano wa maslahi: Waandishi wanatangaza kuwa hakuna mgongano wa maslahi.
Onyo la draft-status: Dokezo la idhini ya uhariri katika sehemu ya Author Contributions na placeholder ya mwandishi iliyokosekana katika Reference 22 zimebaki katika toleo la preprint.
Onyo la kimethodolojia: Ubadilishaji kati ya metriki za classification katika sehemu ya ablation na kazi kuu ya regression haujaelezwa. Ufafanuzi wa metriki ya Table 3 prediction-accuracy pia haujatolewa.
Onyo la istilahi ya HFT: Utafiti haujaribu execution ya kiwango cha mikrosekunde au tick-level limit-order-book HFT; majaribio yanafanywa kwenye mfululizo wa muda wa dakika moja.
Kikomo cha tafsiri ya kiuchumi: Usahihi wa utabiri au R², bila matokeo ya mkakati wa biashara unaojumuisha transaction cost na tabia ya execution, si kiashiria cha moja kwa moja cha faida.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *