

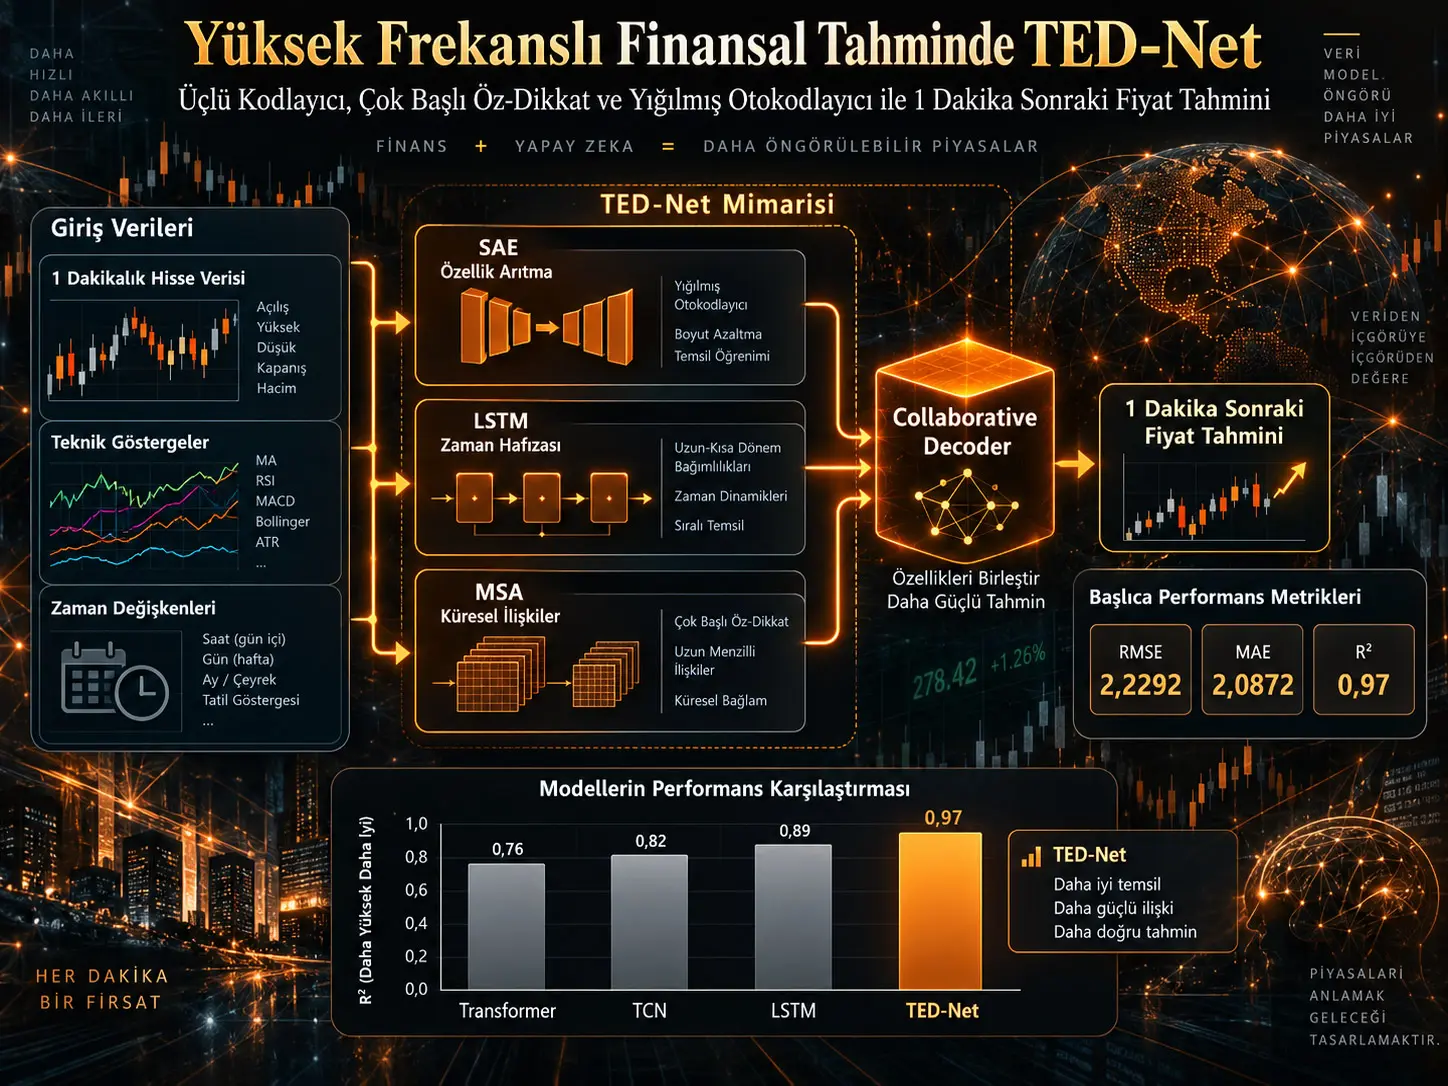
Finansal zaman serileri doğrusal olmayan yapı, değişen istatistiksel özellikler, yüksek gürültü ve uzun dönemli bağımlılıklar nedeniyle tahmin modelleri için zorlu veri kaynaklarıdır. Bu çalışma, bu sorunların aynı model içinde ele alınması amacıyla TED-Net (Triple Encoder-Decoder Network) adlı hibrit bir derin öğrenme mimarisi önermektedir. TED-Net üç ayrı kodlama mekanizmasını birleştirir: Stacked Autoencoder (SAE) özellikleri arıtıp daha düşük boyutlu bir temsil oluşturur; LSTM-Seq2Seq zaman içindeki kısa ve uzun dönem bağımlılıkları öğrenir; Multi-Head Self-Attention (MSA) ise farklı zaman noktaları ve temsil alt-uzayları arasındaki küresel ilişkileri yakalamaya çalışır. Bu üç bilgi kaynağı gated fusion ve attention kullanan collaborative decoder tarafından birleştirilerek bir sonraki fiyat tahmini üretilir.
Deneylerde farklı sektör ve piyasa değerlerinden 15 A-share hisse için her biri 24.000 adet bir dakikalık gözlem kullanılmış; ilk %80 eğitim, son %20 doğrulama verisi olarak ayrılmıştır. Temel tahmin görevinde önceki 30 dakikalık bilgiyle bir sonraki dakikanın kapanış fiyatı tahmin edilmektedir. Kaynakta TED-Net'in Transformer, TCN ve LSTM-Seq2Seq karşılaştırmalarında çoğu veya bütün ortalama hisse tablolarında daha yüksek raporlanan doğruluk gösterdiği belirtilmektedir. CATL üzerinde yapılan ayrı deneyde TED-Net için RMSE 2,2292, MAE 2,0872 ve R² 0,97 raporlanmıştır.
Bununla birlikte çalışmanın “high-frequency trading” ifadesi dikkatle yorumlanmalıdır. Kullanılan veri bir dakikalık zaman serileridir ve model gerçek emir defteri mesajı veya mikro-saniye execution akışı üzerinde çalışmamaktadır. Ayrıca çalışma bir işlem stratejisini değil fiyat tahminini test etmektedir; P&L, transaction cost, slippage, Sharpe ratio veya canlı emir yürütme sonuçları sunulmamaktadır.
| Bileşen | Temel görevi |
|---|---|
| Stacked Autoencoder — SAE | Özellik gürültüsünü azaltmak ve daha kompakt temsil üretmek |
| LSTM-Seq2Seq | Kısa ve uzun dönemli zamansal bağımlılıkları modellemek |
| Multi-Head Self-Attention — MSA | Farklı zaman noktaları arasındaki küresel ilişkileri yakalamak |
| Dynamic Window Attention | Uzun dizilerde attention hesaplama alanını sınırlamak |
| Collaborative Decoder | Üç encoder'dan gelen bilgiyi adaptif olarak birleştirmek |
| Çıktı | Bir sonraki dakikanın fiyat tahmini |
TED-Net hangi üç problemi çözmeye çalışıyor?
Kaynak çalışma yüksek frekanslı finansal tahmini üç temel problem üzerinden tanımlamaktadır.
Özellik problemi: Finansal göstergeler birbirleriyle yüksek korelasyon gösterebilir ve önemli miktarda gürültü içerebilir. Çok fazla benzer veya düşük bilgi taşıyan değişken modelin eğitimini zorlaştırabilir.
Zamansal problem: Uzun dizilerde geçmiş bilgi zaman içinde kaybolabilir. LSTM klasik RNN'lere göre bu sorunu azaltmasına rağmen çok uzun dizilerde bütün tarihsel bilgiyi eşit derecede korumakta yine zorlanabilir.
Korelasyon problemi: Tek bir ardışık model yakın zamansal ilişkileri öğrenebilirken dizinin farklı bölümleri arasındaki küresel ilişkileri eksik temsil edebilir.
TED-Net bu üç probleme sırasıyla SAE, LSTM ve MSA ile yanıt vermeye çalışmaktadır.
Üçlü kodlama mimarisi nasıl çalışıyor?
Kaynağın genel öğrenme akışı:
Özellik arıtma → Zamansal modelleme → Küresel korelasyon çıkarımı → Ortak decoding → Tahmin
şeklinde özetlenebilir.
SAE ilk aşamada finansal göstergeleri daha kompakt latent temsile dönüştürür. Bu çıktı LSTM tarafından zaman dizisi olarak işlenir. MSA, dizideki farklı zaman noktalarının birbirleriyle ilişkilerini attention ağırlıklarıyla hesaplar. Decoder daha sonra bu üç temsili tek bir tahmin üretmek üzere birleştirir.
Stacked Autoencoder neden kullanılıyor?
Autoencoder, girdiyi daha düşük boyutlu bir latent temsile kodlayıp ardından yeniden oluşturmaya çalışan sinir ağıdır. Model yalnız önemli örüntüleri koruyarak girdiyi yeniden üretmeyi öğrendiğinde gürültü ve gereksiz değişkenlerin etkisi azaltılabilir.
Kaynakta encoding katmanları:
\[ h^{(l)} = \sigma \left( W^{(l)}h^{(l-1)}+b^{(l)} \right) \]
biçiminde ifade edilmektedir.
TED-Net'te SAE yalnız bağımsız bir ön işlem aracı değil, üçlü encoder yapısının ilk bileşenidir.
LSTM hangi bilgiyi taşıyor?
LSTM bellek hücresi, input gate, forget gate ve output gate yardımıyla hangi geçmiş bilginin korunacağını veya unutulacağını öğrenir.
Kaynak temel LSTM güncellemesini:
\[ i_t=\sigma(W_{xi}x_t+W_{hi}h_{t-1}+W_{ci}c_{t-1}+b) \]
\[ f_t=\sigma(W_{xf}x_t+W_{hf}h_{t-1}+W_{cf}c_{t-1}+b) \]
\[ c_t=f_tc_{t-1}+i_t\tanh(W_{xc}x_t+W_{hc}h_{t-1}+b) \]
\[ o_t=\sigma(W_{xo}x_t+W_{ho}h_{t-1}+W_{co}c_t+b) \]
\[ h_t=o_t\tanh(c_t) \]
ile tanımlamaktadır.
Seq2Seq yapısında encoder geçmiş diziyi işler, decoder ise encoder'dan elde edilen temsil yardımıyla gelecekteki hedef dizisini veya değeri üretir.
Multi-Head Self-Attention neden eklenmiş?
LSTM ardışık biçimde çalıştığı için iki uzak zaman noktası arasındaki ilişki birçok ara durum üzerinden taşınır. Self-attention ise bir zaman noktasının diğer zaman noktalarına doğrudan ne kadar dikkat etmesi gerektiğini hesaplayabilir.
Kaynak:
\[ Q=W_QX+b_Q,\qquad K=W_KX+b_K,\qquad V=W_VX+b_V \]
dönüşümlerini kullanır.
Daha sonra attention ağırlıkları:
\[ \alpha_t= Softmax \left( \frac{Q_tK_t^T}{\sqrt{d_h}} \right) \]
ile hesaplanır.
Dynamic Window Self-Attention nedir?
Tam self-attention uzun dizilerde bütün zaman noktalarının birbirleriyle karşılaştırılmasını gerektirdiğinden hesaplama maliyeti hızla büyüyebilir.
TED-Net bu nedenle her \(t\) noktası için yalnız belirli bir \(S_t\) penceresindeki key ve value vektörlerini kullanmayı önerir.
Bu yaklaşımın amacı:
- attention maliyetini azaltmak,
- yakın ve ilgili zaman noktalarına odaklanmak,
- uzun finansal dizilerde hesaplama yükünü sınırlamaktır.
Kaynak pencere uzunluğunun nasıl dinamik seçildiğine ilişkin algoritmayı veya optimizasyon kuralını ayrıntılı biçimde vermemektedir; esas matematiksel yapı pencere içinde self-attention hesaplanmasıdır.
Model gerçekten mikro-saniyelik HFT verisi kullanıyor mu?
Hayır. Kaynak giriş bölümünde HFT'nin mikro-saniye düzeyindeki doğasından söz etse de deneysel veri bir dakikalık frekanstadır.
Temel görev:
son 30 dakikalık bilgi → sonraki 1 dakikanın kapanış fiyatı
şeklindedir.
Bu nedenle çalışma order-book HFT veya düşük gecikmeli execution araştırması yerine yüksek çözünürlüklü finansal zaman serisi tahmini bağlamında değerlendirilmelidir.
Çalışmanın Yöntemi ve Bulguları
Veri yapısı
Çalışmada farklı sektör ve piyasa değerlerinden 15 A-share hisse seçilmiştir.
Her hisse için:
- 24.000 adet bir dakikalık gözlem,
- %80 eğitim,
- %20 validation,
- 30 dakikalık kısa dönem sequence,
- 120 dakikalık uzun dönem sequence
tanımlanmaktadır.
Kaynak aynı bölümde modelin önceki 30 dakikayı kullanarak sonraki bir dakikalık kapanış fiyatını tahmin ettiğini belirtmektedir. 120 dakikalık uzun dönem dizinin model içindeki tam kullanım yöntemi daha az ayrıntılı açıklanmıştır.
Özellikler
İlk veri yapısında 15 indicator bulunduğu belirtilmektedir. PCA sonrasında kaynak yedi gösterge raporlamaktadır:
- MACD,
- TRIX,
- VR,
- OBV,
- ROC,
- MTM,
- PSY.
Bunlara 0,78, 0,69, 0,76, 0,68, 0,75, 0,72 ve 0,67 değerleri iliştirilmiştir. Ancak kaynak bu değerlerin PCA loading'i mi, variance katkısı mı veya başka bir feature score mu olduğunu açıklamamaktadır.
Temel eğitim parametreleri
| Parametre | Değer |
|---|---|
| LSTM katmanı | 3 |
| Hidden unit | 128 |
| Learning rate | 0,007 |
| Dropout | 0,03 ana deney; 0,1 karşılaştırmalı deney |
| Optimizer | Adam |
| Batch size | 100 |
| Sequence length | 30 |
| Loss | MSE + L2 regularization |
Karşılaştırmalı deneyde Transformer için \(d_m=128\), sekiz attention head ve altı encoder/decoder layer; TCN için kernel size 3, dilation base 2, altı residual block ve 64 filter verilmiştir.
Ablation deneyleri
| Model | AUC | Precision | Recall | MF1 |
|---|---|---|---|---|
| LSTM-Seq2Seq | 0,83 | 0,95 | 0,80 | 0,87 |
| + SAE | 0,88 | 0,96 | 0,85 | 0,91 |
| TED-Net: SAE + MSA | 0,92 | 0,98 | 0,89 | 0,94 |
Tablo, SAE ve MSA eklendikçe raporlanan metriklerin yükseldiğini göstermektedir.
Ancak modelin temel görevi fiyat regresyonu olduğu halde bu tabloda sınıflandırma metrikleri kullanılmaktadır. Tahmin fiyatının “rising / non-rising” etikete nasıl dönüştürüldüğü, decision threshold veya sınıf dağılımı kaynakta açıklanmamıştır. Bu nedenle bu ablation tablosunun tam olarak yeniden üretilmesi mümkün değildir.
On beş hisse karşılaştırması
Kaynak Table 3'te Transformer, TCN, LSTM-Seq2Seq ve TED-Net için 15 hisse üzerinde “prediction accuracy” yüzdeleri verir.
| Hisse | Transformer | TCN | LSTM-Seq2Seq | TED-Net |
|---|---|---|---|---|
| ZTE | %87,73 | %86,04 | %87,18 | %89,12 |
| Gansu Consulting | %95,37 | %95,14 | %95,08 | %96,21 |
| East Money | %96,79 | %96,63 | %96,91 | %97,82 |
| BYD | %91,96 | %92,28 | %92,15 | %93,67 |
| Shanxi Coking | %71,13 | %68,28 | %72,79 | %75,06 |
TED-Net Table 3'te listelenen 15 ortalama satırın tamamında en yüksek değeri göstermektedir.
Bununla birlikte kaynak “prediction accuracy” ölçüsünün matematiksel tanımını vermediğinden bu yüzdelerin klasik classification accuracy olarak yorumlanması güvenli değildir.
CATL deneyinin veri seti
CATL için ayrı deneyde:
- 8 Temmuz 2025 – 13 Mart 2026,
- 39.604 adet bir dakikalık observation,
- %80 training,
- %20 validation
kullanılmıştır.
Kaynak Figure 5'te optimum eğitim süresini yaklaşık 40 epoch olarak belirlemekte ve loss'un yaklaşık 0,00575 seviyesinde stabilize olduğunu ifade etmektedir.
CATL sonuçları
| Model | RMSE | MAE | R² |
|---|---|---|---|
| LSTM | 3,4521 | 2,8910 | 0,92 |
| TCN | 3,2145 | 2,7234 | 0,93 |
| Transformer | 3,0876 | 2,6012 | 0,94 |
| TED-Net | 2,2292 | 2,0872 | 0,97 |
Bu tablo TED-Net'in kaynak deneyinde en düşük RMSE ve MAE ile en yüksek R² değerini verdiğini göstermektedir.
Kaynakta belirtilen %42 RMSE düşüşü yeniden üretilebilir mi?
Sonuç bölümünde TED-Net'in baseline'a göre RMSE'yi %42,0 azalttığı ifade edilmektedir. Ancak CATL Table 4 değerleri kullanıldığında:
- LSTM → TED-Net: yaklaşık %35,4 azalma,
- TCN → TED-Net: yaklaşık %30,7 azalma,
- Transformer → TED-Net: yaklaşık %27,8 azalma
elde edilmektedir.
Kaynak %42 oranını hangi farklı deney veya baseline'dan hesapladığını açıklamamaktadır. Bu nedenle Verianla bu oranı doğrulanmış CATL sonucu olarak kullanmamaktadır.
Bu çalışma kârlı bir HFT stratejisi gösteriyor mu?
Hayır. Model bir sonraki dakikanın fiyatını tahmin etmektedir.
Çalışmada:
- alım/satım karar kuralı,
- pozisyon büyüklüğü,
- bid-ask spread,
- commission,
- slippage,
- queue position,
- network latency,
- gerçekleşen işlem P&L'si,
- Sharpe ratio,
- maximum drawdown
üzerinden bir trading backtest yapılmamaktadır.
Dolayısıyla düşük RMSE veya yüksek R² doğrudan ekonomik olarak kârlı bir işlem stratejisine eşit değildir.
Çalışmanın güçlü yönleri
- SAE, LSTM ve MSA'yı tek mimaride açık rollerle birleştirmesi.
- Farklı temsil türlerini collaborative decoder ile bütünleştirmesi.
- On beş farklı hisse üzerinde karşılaştırma yapması.
- SAE ve MSA için ablation sonuçları sunması.
- CATL üzerinde RMSE, MAE ve R² gibi açık regresyon metrikleri raporlaması.
- Transformer ve TCN gibi güçlü zaman serisi modellerini benchmark olarak kullanması.
Başlıca sınırlılıklar
- Çalışma henüz hakem değerlendirmesinden geçmemiş v1 preprinttir.
- Bir dakikalık veri, klasik mikro-saniye HFT tanımıyla aynı değildir.
- “Million-level” veri iddiası açıklanan observation sayısıyla uyuşmamaktadır.
- Regression ve classification değerlendirme metodolojileri birbirine karışmaktadır.
- Table 3 accuracy metriğinin tanımı verilmemektedir.
- Farklı deneylerde giriş boyutu 10 ve 8 olarak değişmektedir.
- 30 ve 120 dakikalık iki sequence yapısının birlikte kullanımı yeterince açıklanmamaktadır.
- PCA sonucu verilen katsayıların anlamı açık değildir.
- RMSE %42 düşüşü CATL tablosuyla doğrudan doğrulanamamaktadır.
- “1,5 yuan average error” ifadesi MAE 2,0872 ile uyuşmamaktadır.
- Trading profitability veya execution backtest'i bulunmamaktadır.
- Kaynak metinde editoryal placeholder'lar hâlâ bulunmaktadır.
Kaynak ve Yöntem Notu
Özgün başlık: A Triple Encoder-Decoder Network with Multi-Head Self-Attention and Stacked Autoencoder for High-Frequency Trading Prediction
Yazarlar: Zhuxi Zhang; Yan Zhang; Haolin Yuan; Min Zhu; Zihan Zhao.
Kurumlar: China Institute of Finance, University of International Business and Economics, Beijing; Digital Technology Research and Development Center, Beijing Research Institute of Ansteel Co., Ltd., Beijing.
Kaynak türü: Preprint / Article.
Platform: Preprints.org.
Sürüm: Version 1.
Submitted: 10 Eylül 2026.
Posted: 14 Eylül 2026.
DOI: 10.20944/preprints202609.0978.v1.
Hakemlik durumu: Hakem değerlendirmesinden geçmemiştir. Kaynak ve Preprints.org kaydı açık biçimde “Not peer-reviewed” ibaresini taşımaktadır.
Lisans: Creative Commons Attribution 4.0 International — CC BY 4.0.
Temel yöntem: Stacked Autoencoder + LSTM-Seq2Seq + Multi-Head Self-Attention + Dynamic Window Attention + collaborative decoder.
Temel görev: Bir dakikalık finansal veriden bir sonraki dakikanın hisse fiyatını regresyon yoluyla tahmin etmek.
Ana deney: 15 A-share hisse × 24.000 adet bir dakikalık gözlem; %80 training ve %20 validation.
CATL deney seti: 8 Temmuz 2025–13 Mart 2026 arasında 39.604 adet bir dakikalık gözlem.
CATL temel sonucu: TED-Net RMSE 2,2292; MAE 2,0872; R² 0,97.
Finansman: National Major Science and Technology Project of Intelligent Manufacturing Systems and Robots; grant 2025ZD1607900.
Veri erişimi: Yazarlar verinin corresponding author'dan talep üzerine sağlanabileceğini belirtmektedir.
Çıkar çatışması: Yazarlar çıkar çatışması bulunmadığını beyan etmektedir.
Draft-status uyarısı: Author Contributions bölümündeki editoryal onay notu ve Reference 22'deki eksik yazar placeholder'ı preprint sürümünde kalmıştır.
Yöntemsel uyarı: Ablation bölümündeki classification metrikleri ile temel regression görevi arasındaki dönüşüm açıklanmamaktadır. Table 3 prediction-accuracy metriğinin tanımı da verilmemiştir.
HFT terminoloji uyarısı: Çalışma mikro-saniye execution veya tick-level limit-order-book HFT'si test etmemektedir; deneyler bir dakikalık zaman serileri üzerinde yapılmaktadır.
Ekonomik yorum sınırı: Tahmin doğruluğu veya R², transaction cost ve execution davranışı içeren işlem stratejisi sonuçları olmadan doğrudan kârlılık göstergesi değildir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir