

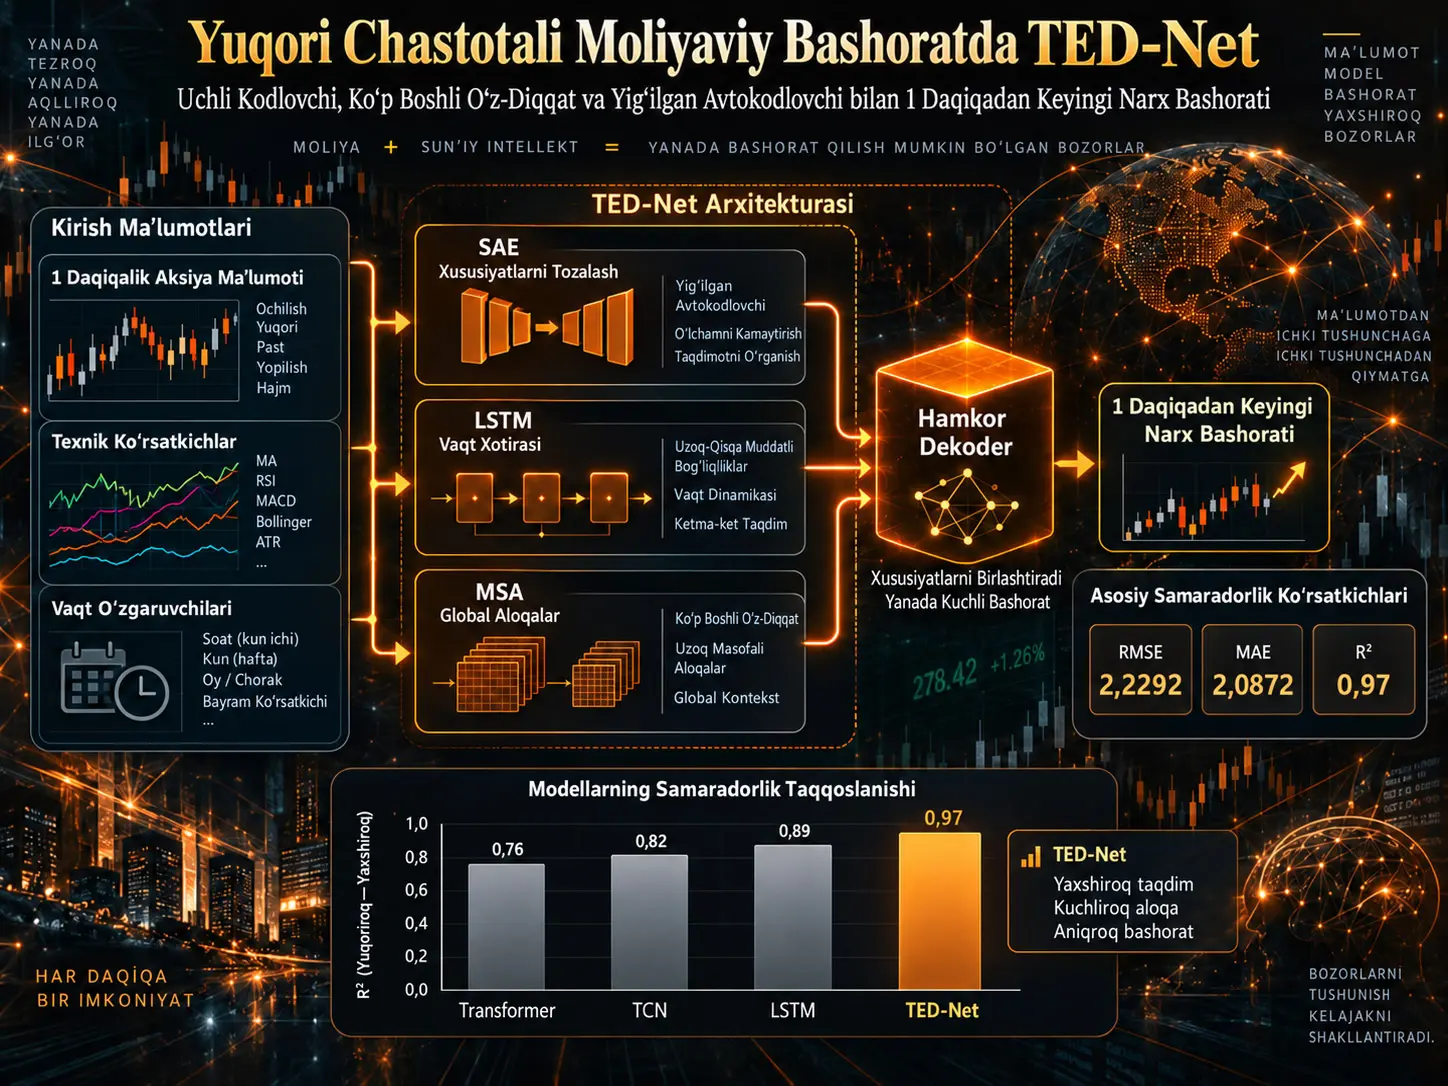
Moliyaviy vaqt qatorlari chiziqli bo‘lmagan tuzilma, o‘zgaruvchan statistik xususiyatlar, yuqori shovqin va uzoq muddatli bog‘liqliklar sababli bashorat modellari uchun murakkab ma’lumot manbalaridir. Ushbu tadqiqot mazkur muammolarni bitta model doirasida hal qilish maqsadida TED-Net (Triple Encoder-Decoder Network) nomli gibrid chuqur o‘rganish arxitekturasini taklif qiladi. TED-Net uchta alohida kodlash mexanizmini birlashtiradi: Stacked Autoencoder (SAE) xususiyatlarni tozalab, o‘lchami pastroq tasvirni hosil qiladi; LSTM-Seq2Seq vaqt bo‘yicha qisqa va uzoq muddatli bog‘liqliklarni o‘rganadi; Multi-Head Self-Attention (MSA) esa turli vaqt nuqtalari va tasvir quyi fazolari o‘rtasidagi global munosabatlarni ushlashga intiladi. Ushbu uchta axborot manbai gated fusion va attention qo‘llaydigan collaborative decoder tomonidan birlashtirilib, keyingi narx bashorati hosil qilinadi.
Tajribalarda turli sektorlar va bozor qiymatlariga mansub 15 ta A-share aksiya uchun har biriga 24.000 ta bir daqiqalik kuzatuv ishlatilgan; dastlabki %80 o‘qitish, oxirgi %20 esa validation ma’lumoti sifatida ajratilgan. Asosiy bashorat vazifasida avvalgi 30 daqiqalik ma’lumot yordamida keyingi daqiqaning yopilish narxi bashorat qilinadi. Manbada TED-Net Transformer, TCN va LSTM-Seq2Seq bilan taqqoslashlarda aksiyalarning o‘rtacha jadvallarining aksariyati yoki barchasida yuqoriroq qayd etilgan aniqlikni ko‘rsatgani bildiriladi. CATL bo‘yicha alohida tajribada TED-Net uchun RMSE 2,2292, MAE 2,0872 va R² 0,97 qayd etilgan.
Shu bilan birga, tadqiqotdagi “high-frequency trading” iborasi ehtiyotkorlik bilan talqin qilinishi kerak. Ishlatilgan ma’lumotlar bir daqiqalik vaqt qatorlaridir va model haqiqiy buyurtmalar kitobi xabarlari yoki mikrosoniyalik execution oqimi ustida ishlamaydi. Bundan tashqari, tadqiqot savdo strategiyasini emas, narx bashoratini sinaydi; P&L, transaction cost, slippage, Sharpe ratio yoki jonli buyurtma bajarilishi natijalari taqdim etilmagan.
| Komponent | Asosiy vazifasi |
|---|---|
| Stacked Autoencoder — SAE | Xususiyatlar shovqinini kamaytirish va ixchamroq tasvir hosil qilish |
| LSTM-Seq2Seq | Qisqa va uzoq muddatli vaqt bog‘liqliklarini modellashtirish |
| Multi-Head Self-Attention — MSA | Turli vaqt nuqtalari o‘rtasidagi global munosabatlarni ushlash |
| Dynamic Window Attention | Uzun ketma-ketliklarda attention hisoblash maydonini cheklash |
| Collaborative Decoder | Uchta encoder-dan kelgan ma’lumotni moslashuvchan tarzda birlashtirish |
| Chiqish | Keyingi daqiqaning narx bashorati |
TED-Net qaysi uchta muammoni hal qilishga urinadi?
Manba tadqiqot yuqori chastotali moliyaviy bashoratni uchta asosiy muammo orqali tavsiflaydi.
Xususiyat muammosi: Moliyaviy ko‘rsatkichlar o‘zaro yuqori korrelyatsiyaga ega bo‘lishi va sezilarli miqdorda shovqin saqlashi mumkin. Juda ko‘p o‘xshash yoki kam axborot tashuvchi o‘zgaruvchilar modelni o‘qitishni qiyinlashtirishi mumkin.
Vaqt muammosi: Uzun ketma-ketliklarda o‘tmishdagi ma’lumot vaqt o‘tishi bilan yo‘qolishi mumkin. LSTM klassik RNN-larga nisbatan bu muammoni kamaytirsa-da, juda uzun ketma-ketliklarda barcha tarixiy ma’lumotni bir xil darajada saqlashda yana qiyinchilikka duch kelishi mumkin.
Korrelyatsiya muammosi: Bitta ketma-ket model yaqin vaqt munosabatlarini o‘rgana olsa-da, ketma-ketlikning turli qismlari orasidagi global munosabatlarni to‘liq bo‘lmagan tarzda ifodalashi mumkin.
TED-Net ushbu uch muammoga mos ravishda SAE, LSTM va MSA yordamida javob berishga harakat qiladi.
Uchli kodlash arxitekturasi qanday ishlaydi?
Manbadagi umumiy o‘rganish oqimi:
Xususiyatlarni tozalash → Vaqtni modellashtirish → Global korrelyatsiyani ajratish → Birgalikdagi decoding → Bashorat
ko‘rinishida umumlashtirilishi mumkin.
SAE birinchi bosqichda moliyaviy ko‘rsatkichlarni ixchamroq latent tasvirga aylantiradi. Bu chiqish LSTM tomonidan vaqt ketma-ketligi sifatida qayta ishlanadi. MSA ketma-ketlikdagi turli vaqt nuqtalarining o‘zaro munosabatlarini attention og‘irliklari bilan hisoblaydi. Decoder so‘ng ushbu uch tasvirni bitta bashorat yaratish uchun birlashtiradi.
Stacked Autoencoder nima uchun ishlatiladi?
Autoencoder kirishni o‘lchami pastroq latent tasvirga kodlab, so‘ng uni qayta tiklashga urinadigan neyron tarmoqdir. Model faqat muhim naqshlarni saqlagan holda kirishni qayta hosil qilishni o‘rgansa, shovqin va keraksiz o‘zgaruvchilarning ta’siri kamaytirilishi mumkin.
Manbada encoding qatlamlari:
\[ h^{(l)} = \sigma \left( W^{(l)}h^{(l-1)}+b^{(l)} \right) \]
ko‘rinishida ifodalanadi.
TED-Net-da SAE faqat mustaqil dastlabki ishlov vositasi emas, balki uchli encoder tuzilmasining birinchi komponentidir.
LSTM qanday ma’lumotni tashiydi?
LSTM xotira katagi, input gate, forget gate va output gate yordamida qaysi o‘tmish ma’lumoti saqlanishi yoki unutilishini o‘rganadi.
Manba asosiy LSTM yangilanishini:
\[ i_t=\sigma(W_{xi}x_t+W_{hi}h_{t-1}+W_{ci}c_{t-1}+b) \]
\[ f_t=\sigma(W_{xf}x_t+W_{hf}h_{t-1}+W_{cf}c_{t-1}+b) \]
\[ c_t=f_tc_{t-1}+i_t\tanh(W_{xc}x_t+W_{hc}h_{t-1}+b) \]
\[ o_t=\sigma(W_{xo}x_t+W_{ho}h_{t-1}+W_{co}c_t+b) \]
\[ h_t=o_t\tanh(c_t) \]
bilan belgilaydi.
Seq2Seq tuzilmasida encoder o‘tmish ketma-ketligini qayta ishlaydi, decoder esa encoder-dan olingan tasvir yordamida kelajakdagi maqsad ketma-ketligini yoki qiymatni hosil qiladi.
Multi-Head Self-Attention nima uchun qo‘shilgan?
LSTM ketma-ket ishlagani sababli ikki uzoq vaqt nuqtasi orasidagi munosabat ko‘plab oraliq holatlar orqali uzatiladi. Self-attention esa bir vaqt nuqtasi boshqa vaqt nuqtalariga to‘g‘ridan-to‘g‘ri qanchalik e’tibor qaratishi kerakligini hisoblashi mumkin.
Manba:
\[ Q=W_QX+b_Q,\qquad K=W_KX+b_K,\qquad V=W_VX+b_V \]
o‘zgartirishlaridan foydalanadi.
So‘ng attention og‘irliklari:
\[ \alpha_t= Softmax \left( \frac{Q_tK_t^T}{\sqrt{d_h}} \right) \]
bilan hisoblanadi.
Dynamic Window Self-Attention nima?
To‘liq self-attention uzun ketma-ketliklarda barcha vaqt nuqtalarini o‘zaro taqqoslashni talab qilgani sababli hisoblash xarajati tez ortishi mumkin.
TED-Net shu sababli har bir \(t\) nuqta uchun faqat ma’lum bir \(S_t\) oynasidagi key va value vektorlaridan foydalanishni taklif qiladi.
Ushbu yondashuvning maqsadi:
- attention xarajatini kamaytirish,
- yaqin va tegishli vaqt nuqtalariga e’tibor qaratish,
- uzun moliyaviy ketma-ketliklarda hisoblash yukini cheklashdir.
Manbada oyna uzunligi dinamik ravishda qanday tanlanishi haqidagi algoritm yoki optimallashtirish qoidasi batafsil berilmagan; asosiy matematik tuzilma oyna ichida self-attention hisoblanishidir.
Model haqiqatan mikrosoniyalik HFT ma’lumotidan foydalanadimi?
Yo‘q. Manba kirish qismida HFT-ning mikrosoniya darajasidagi tabiatini tilga olsa-da, tajriba ma’lumoti bir daqiqalik chastotadadir.
Asosiy vazifa:
so‘nggi 30 daqiqalik ma’lumot → keyingi 1 daqiqaning yopilish narxi
ko‘rinishidadir.
Shu sababli tadqiqot order-book HFT yoki past kechikishli execution tadqiqoti o‘rniga yuqori aniqlikdagi moliyaviy vaqt qatori bashorati kontekstida baholanishi kerak.
Tadqiqot Usuli va Natijalari
Ma’lumotlar tuzilmasi
Tadqiqotda turli sektor va bozor qiymatlaridan 15 ta A-share aksiya tanlangan.
Har bir aksiya uchun:
- 24.000 ta bir daqiqalik kuzatuv,
- %80 o‘qitish,
- %20 validation,
- 30 daqiqalik qisqa muddatli sequence,
- 120 daqiqalik uzoq muddatli sequence
belgilangan.
Manba shu bo‘limda model avvalgi 30 daqiqadan foydalanib keyingi bir daqiqaning yopilish narxini bashorat qilishini bildiradi. 120 daqiqalik uzoq muddatli ketma-ketlikning model ichida aniq qanday ishlatilishi kamroq batafsil tushuntirilgan.
Xususiyatlar
Dastlabki ma’lumot tuzilmasida 15 ta indicator mavjudligi aytiladi. PCA-dan keyin manba yettita ko‘rsatkichni qayd etadi:
- MACD,
- TRIX,
- VR,
- OBV,
- ROC,
- MTM,
- PSY.
Ularga 0,78, 0,69, 0,76, 0,68, 0,75, 0,72 va 0,67 qiymatlari biriktirilgan. Biroq manba bu qiymatlar PCA loading-mi, variance hissasimi yoki boshqa bir feature score-mi ekanini tushuntirmaydi.
Asosiy o‘qitish parametrlari
| Parametr | Qiymat |
|---|---|
| LSTM qatlami | 3 |
| Hidden unit | 128 |
| Learning rate | 0,007 |
| Dropout | 0,03 asosiy tajriba; 0,1 taqqoslama tajriba |
| Optimizer | Adam |
| Batch size | 100 |
| Sequence length | 30 |
| Loss | MSE + L2 regularization |
Taqqoslama tajribada Transformer uchun \(d_m=128\), sakkizta attention head va oltita encoder/decoder layer; TCN uchun kernel size 3, dilation base 2, oltita residual block va 64 filter berilgan.
Ablation tajribalari
| Model | AUC | Precision | Recall | MF1 |
|---|---|---|---|---|
| LSTM-Seq2Seq | 0,83 | 0,95 | 0,80 | 0,87 |
| + SAE | 0,88 | 0,96 | 0,85 | 0,91 |
| TED-Net: SAE + MSA | 0,92 | 0,98 | 0,89 | 0,94 |
Jadval SAE va MSA qo‘shilgani sari qayd etilgan metrikalar oshganini ko‘rsatadi.
Biroq modelning asosiy vazifasi narx regressiyasi bo‘lsa-da, bu jadvalda tasniflash metrikalari ishlatilgan. Bashorat narxi “rising / non-rising” yorlig‘iga qanday aylantirilgani, decision threshold yoki sinf taqsimoti manbada tushuntirilmagan. Shu sababli ushbu ablation jadvalini to‘liq qayta ishlab chiqish mumkin emas.
O‘n beshta aksiyani taqqoslash
Manba Table 3-da Transformer, TCN, LSTM-Seq2Seq va TED-Net uchun 15 ta aksiya bo‘yicha “prediction accuracy” foizlarini beradi.
| Aksiya | Transformer | TCN | LSTM-Seq2Seq | TED-Net |
|---|---|---|---|---|
| ZTE | %87,73 | %86,04 | %87,18 | %89,12 |
| Gansu Consulting | %95,37 | %95,14 | %95,08 | %96,21 |
| East Money | %96,79 | %96,63 | %96,91 | %97,82 |
| BYD | %91,96 | %92,28 | %92,15 | %93,67 |
| Shanxi Coking | %71,13 | %68,28 | %72,79 | %75,06 |
TED-Net Table 3-da keltirilgan 15 ta o‘rtacha qatorning barchasida eng yuqori qiymatni ko‘rsatadi.
Biroq manba “prediction accuracy” o‘lchovining matematik ta’rifini bermagani uchun bu foizlarni klassik classification accuracy sifatida talqin qilish xavfsiz emas.
CATL tajribasining ma’lumotlar to‘plami
CATL uchun alohida tajribada:
- 8 iyul 2025 – 13 mart 2026,
- 39.604 ta bir daqiqalik observation,
- %80 training,
- %20 validation
ishlatilgan.
Manba Figure 5-da optimal o‘qitish muddatini taxminan 40 epoch deb belgilaydi va loss taxminan 0,00575 darajasida barqarorlashganini bildiradi.
CATL natijalari
| Model | RMSE | MAE | R² |
|---|---|---|---|
| LSTM | 3,4521 | 2,8910 | 0,92 |
| TCN | 3,2145 | 2,7234 | 0,93 |
| Transformer | 3,0876 | 2,6012 | 0,94 |
| TED-Net | 2,2292 | 2,0872 | 0,97 |
Ushbu jadval TED-Net manba tajribasida eng past RMSE va MAE hamda eng yuqori R² qiymatini berganini ko‘rsatadi.
Manbada ko‘rsatilgan %42 RMSE kamayishini qayta hosil qilish mumkinmi?
Natijalar bo‘limida TED-Net baseline-ga nisbatan RMSE-ni %42,0 kamaytirgani aytiladi. Biroq CATL Table 4 qiymatlari ishlatilganda:
- LSTM → TED-Net: taxminan %35,4 kamayish,
- TCN → TED-Net: taxminan %30,7 kamayish,
- Transformer → TED-Net: taxminan %27,8 kamayish
hosil bo‘ladi.
Manba %42 ko‘rsatkichini qaysi boshqa tajriba yoki baseline-dan hisoblaganini tushuntirmaydi. Shu sababli Verianla bu nisbatni tasdiqlangan CATL natijasi sifatida ishlatmaydi.
Bu tadqiqot foydali HFT strategiyasini ko‘rsatadimi?
Yo‘q. Model keyingi daqiqaning narxini bashorat qiladi.
Tadqiqotda:
- xarid/sotuv qarori qoidasi,
- pozitsiya hajmi,
- bid-ask spread,
- commission,
- slippage,
- queue position,
- network latency,
- amalga oshirilgan savdo P&L-si,
- Sharpe ratio,
- maximum drawdown
bo‘yicha trading backtest o‘tkazilmaydi.
Shuning uchun past RMSE yoki yuqori R² to‘g‘ridan-to‘g‘ri iqtisodiy jihatdan foydali savdo strategiyasiga teng emas.
Tadqiqotning kuchli tomonlari
- SAE, LSTM va MSA-ni bitta arxitekturada aniq rollar bilan birlashtirishi.
- Turli tasvir turlarini collaborative decoder bilan integratsiyalashi.
- O‘n beshta turli aksiya bo‘yicha taqqoslash o‘tkazishi.
- SAE va MSA uchun ablation natijalarini taqdim etishi.
- CATL bo‘yicha RMSE, MAE va R² kabi aniq regressiya metrikalarini qayd etishi.
- Transformer va TCN kabi kuchli vaqt qatori modellaridan benchmark sifatida foydalanishi.
Asosiy cheklovlar
- Tadqiqot hali hakamlar ko‘rigidan o‘tmagan v1 preprintdir.
- Bir daqiqalik ma’lumot klassik mikrosoniya HFT ta’rifi bilan bir xil emas.
- “Million-level” ma’lumot da’vosi tushuntirilgan observation soniga mos kelmaydi.
- Regression va classification baholash metodologiyalari bir-biriga aralashgan.
- Table 3 accuracy metrikasining ta’rifi berilmagan.
- Turli tajribalarda kirish o‘lchami 10 va 8 bo‘lib o‘zgaradi.
- 30 va 120 daqiqalik ikki sequence tuzilmasining birgalikda ishlatilishi yetarlicha tushuntirilmagan.
- PCA natijasida berilgan koeffitsiyentlarning ma’nosi aniq emas.
- RMSE %42 kamayishi CATL jadvali bilan bevosita tasdiqlanmaydi.
- “1,5 yuan average error” iborasi MAE 2,0872 bilan mos kelmaydi.
- Trading profitability yoki execution backtest mavjud emas.
- Manba matnida tahririy placeholder-lar hanuz mavjud.
Manba va Usul Haqida Izoh
Asl sarlavha: A Triple Encoder-Decoder Network with Multi-Head Self-Attention and Stacked Autoencoder for High-Frequency Trading Prediction
Mualliflar: Zhuxi Zhang; Yan Zhang; Haolin Yuan; Min Zhu; Zihan Zhao.
Muassasalar: China Institute of Finance, University of International Business and Economics, Beijing; Digital Technology Research and Development Center, Beijing Research Institute of Ansteel Co., Ltd., Beijing.
Manba turi: Preprint / Article.
Platforma: Preprints.org.
Versiya: Version 1.
Yuborilgan: 10 sentyabr 2026.
Joylangan: 14 sentyabr 2026.
DOI: 10.20944/preprints202609.0978.v1.
Hakamlik holati: Hakamlar ko‘rigidan o‘tmagan. Manba va Preprints.org yozuvi ochiq ravishda “Not peer-reviewed” iborasini ko‘rsatadi.
Litsenziya: Creative Commons Attribution 4.0 International — CC BY 4.0.
Asosiy usul: Stacked Autoencoder + LSTM-Seq2Seq + Multi-Head Self-Attention + Dynamic Window Attention + collaborative decoder.
Asosiy vazifa: Bir daqiqalik moliyaviy ma’lumotdan keyingi daqiqaning aksiya narxini regressiya orqali bashorat qilish.
Asosiy tajriba: 15 ta A-share aksiya × 24.000 ta bir daqiqalik kuzatuv; %80 training va %20 validation.
CATL tajriba to‘plami: 8 iyul 2025–13 mart 2026 oralig‘ida 39.604 ta bir daqiqalik kuzatuv.
CATL asosiy natijasi: TED-Net RMSE 2,2292; MAE 2,0872; R² 0,97.
Moliyalashtirish: National Major Science and Technology Project of Intelligent Manufacturing Systems and Robots; grant 2025ZD1607900.
Ma’lumotlardan foydalanish: Mualliflar ma’lumotni corresponding author-dan so‘rov bo‘yicha olish mumkinligini bildiradilar.
Manfaatlar to‘qnashuvi: Mualliflar manfaatlar to‘qnashuvi yo‘qligini ma’lum qiladilar.
Draft-status ogohlantirishi: Author Contributions bo‘limidagi tahririy tasdiq qaydi va Reference 22-dagi yetishmayotgan muallif placeholder-i preprint versiyasida qolgan.
Metodologik ogohlantirish: Ablation bo‘limidagi classification metrikalari bilan asosiy regression vazifasi o‘rtasidagi o‘tish tushuntirilmagan. Table 3 prediction-accuracy metrikasining ta’rifi ham berilmagan.
HFT terminologiyasi ogohlantirishi: Tadqiqot mikrosoniyalik execution yoki tick-level limit-order-book HFT-ni sinamaydi; tajribalar bir daqiqalik vaqt qatorlari ustida o‘tkazilgan.
Iqtisodiy talqin chegarasi: Bashorat aniqligi yoki R², transaction cost va execution xatti-harakatini o‘z ichiga olgan savdo strategiyasi natijalarisiz bevosita foydalilik ko‘rsatkichi emas.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan