

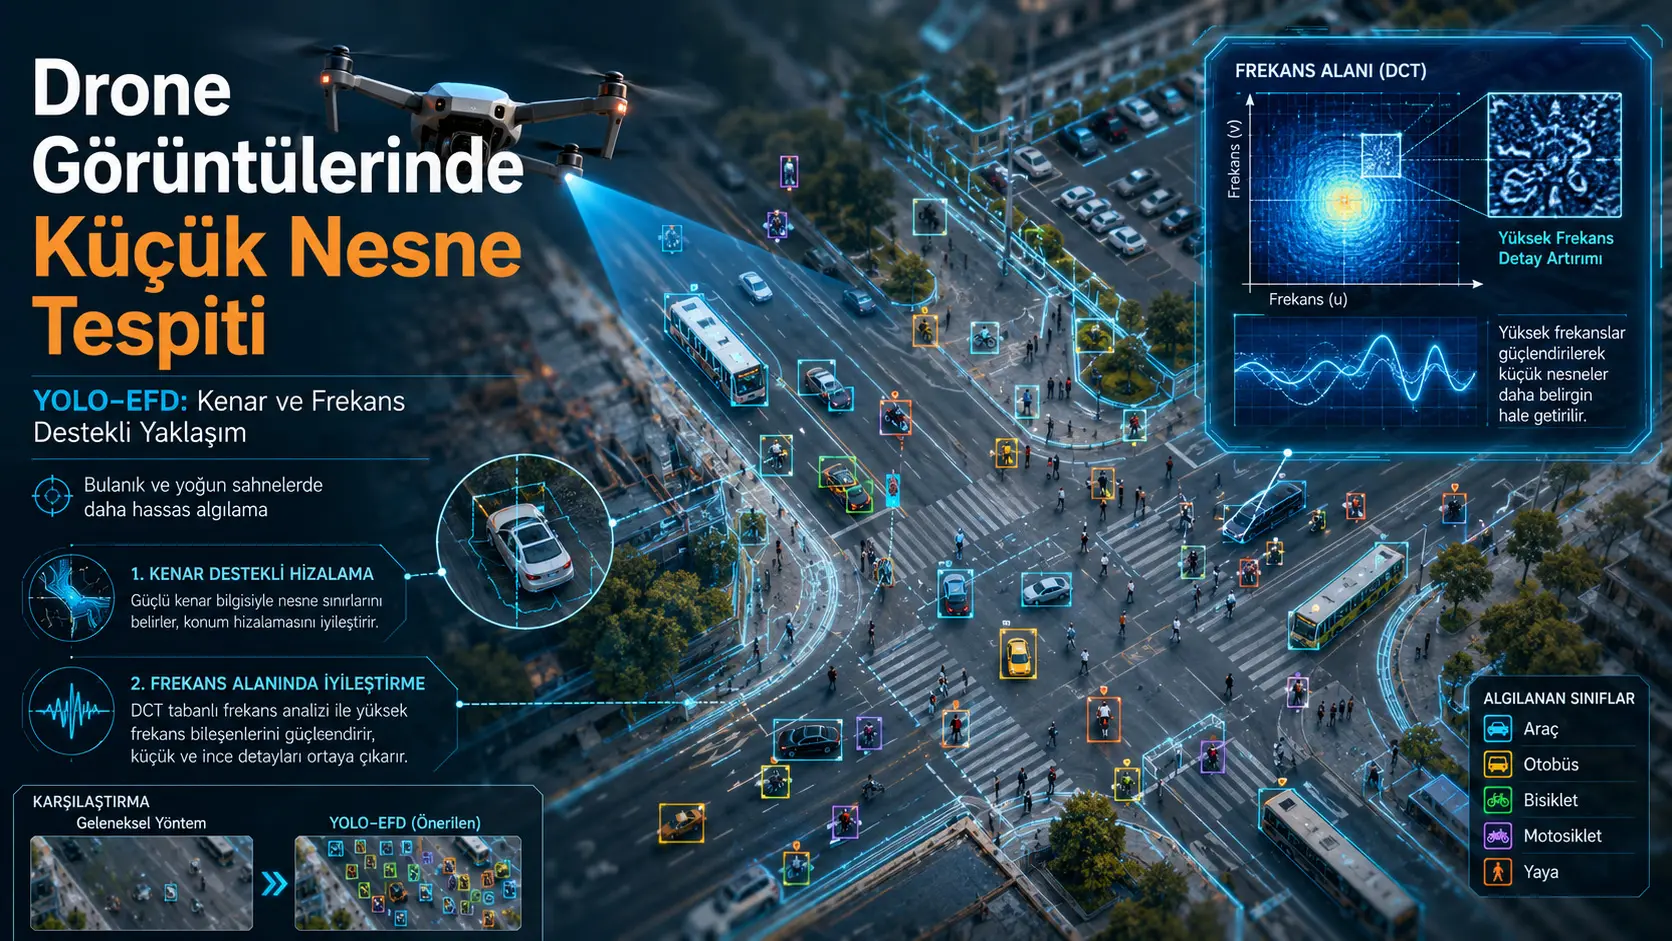
Katika picha za drone na remote-sensing, vitu kama magari, watembea kwa miguu, baiskeli au pikipiki wakati mwingine huonekana kwa ukubwa wa pixels chache tu. Image blur, msongamano wa magari, vitu vinavyofunika vingine na complex backgrounds vinaweza kufanya standard object-detection systems zikose hizi small targets au kuziweka mahali pasipo sahihi. Utafiti huu unapendekeza YOLO-EFD, new small-object detection model based on YOLOv11n.
YOLO-EFD ina modules mbili maalum. Edge-Guided Dual-Path Alignment Module inajaribu kualign feature maps za resolutions tofauti katika same geometric position kwa kutumia Scharr edge information na deformable convolution. Frequency-Domain Dual Attention Module inaongeza high-frequency information inayohusiana na object edges na textures kupitia Discrete Cosine Transform, huku ikisuppress low-frequency background components.
Model ilitestwa kwenye VisDrone2019 na UAVDT datasets. According to main comparison table, VisDrone2019 ilitoa %38,2 mAP@0.5, %22,5 mAP@0.5:0.95, %46,6 precision na %39,3 recall. Katika UAVDT, %32,1 mAP@0.5, %18,9 mAP@0.5:0.95 na %30,5 recall ziliripotiwa. Model ina 3,4 million parameters na 12,5 GFLOP computational load.
Results zinaonyesha kwamba edge-based alignment na frequency-domain detail enhancement zinaweza kutoa benefit pamoja katika small-object detection. Hata hivyo, study haijapitia peer review; latency, frames per second na energy consumption hazijapimwa kwenye real drone. Pia, some numerical values katika main result tables hazilingani kikamilifu.
Kwa nini small-object detection ni tatizo gumu?
Katika aerial images, object inaweza kuchukua sehemu ndogo sana ya image kwa sababu ya camera height na viewing angle. Gari au pedestrian ikiwa na pixels chache tu, color, texture, shape na boundary information zinakuwa weak sana. Successive downsampling operations katika convolutional neural networks zinaweza pia kupoteza zaidi limited information hii.
Katika first figure ya study, main problems mbili zimevisualizeiwa. Katika blurred scene, edges na textures za distant objects zinafifia kwa sababu ya atmospheric effects, loss of focus au platform motion. Katika dense scene, many vehicles ziko close together, some objects zimeoccludeiwa partly na boundaries kati ya objects zimekuwa unclear.
Katika conditions hizi, object-detection model inahitaji kujibu correctly questions mbili tofauti:
- Object iko wapi? Feature maps katika different scales zinahitaji kuwa geometrically aligned correctly.
- Je, detail inayoonekana kweli ni ya object? Object edges zinahitaji kutenganishwa na background texture na image noise.
YOLO-EFD modules mbili zinashughulikia questions hizi kwa operations tofauti lakini complementary.
Tatizo katika standard YOLO feature fusion
Object-detection networks katika YOLO family zinaunganisha high-resolution positional information kutoka shallow layers na semantic information kutoka deep layers. Katika conventional approach, deep feature map inaupsampleiwa na kuunganishwa directly na shallow feature map.
Hata hivyo, deep features zilizopitia downsampling na re-upsampling zinaweza kutowakilisha exactly same geometric position na pixels katika shallow layer. Katika large objects, shift ya few pixels inaweza kuvumilika, lakini kwa target yenye ukubwa wa 10–20 pixels tu, same shift inaweza kuathiri significant part ya object box.
Kwa hiyo study imebadilisha standard upsampling na fusion operation kwenye feature path inayoenda small-object detection head kwa dynamic alignment module inayoongozwa na edge information.
General architecture ya YOLO-EFD
Model inadumisha backbone–neck–detection head structure ya YOLOv11n. Special modules zimewekwa mainly kwenye neck section ambako multi-scale features zinafuseiwa.
- Backbone: Inatengeneza feature maps katika different resolutions kutoka input image.
- EGA module: Inaalign shallow na deep features geometrically kwa msaada wa edge information.
- FDAM module: Inaongeza high-frequency edge na texture information katika aligned features.
- Detection heads: Zinapredict object classes na bounding boxes.
Kuweka special modules only kwenye feature path inayoenda small-object head kunalenga kuongeza representation power kwa small targets bila kufanya entire network kuwa heavy.
Edge-Guided Dual-Path Alignment Module
Edge extraction kwa Scharr operator
Module inayoitwa EGA kwanza inahesabu horizontal na vertical intensity changes katika shallow, high-resolution feature map kwa Scharr filters:
\[ E_x=\operatorname{Conv}(P_i,K_{\mathrm{Scharr},x}) \]
\[ E_y=\operatorname{Conv}(P_i,K_{\mathrm{Scharr},y}) \]
- Pi: High-resolution feature map kutoka shallow layer.
- KScharr,x: Scharr kernel inayohesabu intensity change katika horizontal direction.
- KScharr,y: Scharr kernel inayohesabu intensity change katika vertical direction.
- Ex na Ey: Horizontal na vertical gradient responses.
Gradients za directions mbili kisha zinaunganishwa kuwa single edge-magnitude map:
\[ E=\sqrt{E_x^2+E_y^2+\varepsilon} \]
ε hapa ni small constant inayohakikisha numerical stability ya square-root calculation. Resulting E map ni geometric prior information inayowakilisha regions ambapo outer boundaries za small objects zinaweza kuwepo.
Kutumia semantic na geometric information pamoja
Kutumia edge map pekee haitoshi. Road markings, building boundaries na shadows pia zinaweza kutengeneza strong edges. Kwa hiyo study inatumia semantic features kutoka deep layer pamoja na edge map.
Baada ya deep feature map kuupsampleiwa hadi resolution ya shallow map, inaunganishwa channel-wise na edge map. Positional offsets zinazotumika katika deformable convolution zinapredictiwa kwa operation ifuatayo:
\[ \Delta=\operatorname{Conv}_{\mathrm{offset}}\left(\operatorname{Concat}(P'_{i+1},E)\right) \]
- P′i+1: Semantic feature kutoka deep layer iliyoupsampleiwa hadi size ya shallow map.
- E: Edge map iliyotolewa kutoka shallow layer.
- Δ: Positional offset field inayoamua deformable convolution ichukue samples kutoka points zipi.
Deep features zinasaidia model kuelewa structure ipi inaweza kuwa gari, pedestrian au object nyingine; edge map inasaidia kuestimate boundary ya object iko wapi.
Deformable dual-path alignment
Same predicted offset field inatumika kwa both shallow na deep features:
\[ P_i^{\mathrm{aligned}}=\mathcal{D}(P_i,\Delta) \]
\[ {P'}_{i+1}^{\mathrm{aligned}}=\mathcal{D}(P'_{i+1},\Delta) \]
𝒟 inawakilisha deformable-convolution operation. Standard convolution inatumia fixed sampling grid, wakati deformable convolution inaweza kukusanya information kutoka positions tofauti according to predicted offsets.
Aligned feature maps mbili zinaunganishwa na kupitishwa kwenye 1 × 1 convolution:
\[ F_{\mathrm{out}}=\operatorname{Conv}_{1\times1}\left(\operatorname{Concat}(P_i^{\mathrm{aligned}},{P'}_{i+1}^{\mathrm{aligned}})\right) \]
Kwa njia hii, features zinazotumwa small-object head zinalengwa kubeba both detailed positional information na deep semantic information.
Frequency-Domain Dual Attention Module
Kwa nini frequency domain imetumika?
Broad na slowly varying regions za image zinawakilishwa katika low-frequency components; sharp edges, fine textures na sudden brightness changes zinawakilishwa katika high-frequency components. Boundary na texture information inayohitajika kutofautisha small objects mara nyingi iko upande wa high frequency.
Downsampling operations katika convolutional networks zinaweza kusmooth high-frequency details. FDAM module inalenga kutenganisha na kuenhance details hizi directly katika frequency domain.
Discrete Cosine Transform
Spatial feature map inahamishwa kwenda frequency domain kwa two-dimensional Discrete Cosine Transform:
\[ F(u,v)=\mathcal{T}_{\mathrm{DCT}}\left(f(x,y)\right) \]
- f(x,y): Input feature map katika spatial domain.
- F(u,v): Frequency components obtained after DCT.
- u na v: Horizontal na vertical coordinates katika frequency plane.
Upper-left region ya DCT spectrum inawakilisha low-frequency information, wakati components zinapoelekea lower-right regions zinawakilisha higher-frequency information.
High-pass frequency mask
Study inatumia mask inayocontroliwa na α parameter kusuppress sehemu ya low-frequency region:
\[ F_{\mathrm{filtered}}(u,v)=F(u,v)\odot M(u,v;\alpha) \]
M(u,v;α) inawakilisha frequency mask, na ⊙ element-wise multiplication. Filtered spectrum inarudishwa spatial domain kwa inverse DCT na kutengeneza attention map inayosisitiza edges na fine details.
α value ikiwa too small, background suppression inaweza kutotosha. Ikiwa too large, useful low- na mid-frequency object information pia inaweza kupotea. Katika experiments, best value ilipatikana kuwa α = 0,25.
Second-order channel attention
Second path ya FDAM inahesabu si mean tu bali pia variance ya kila feature channel:
\[ \mu_c=\mathbb{E}[x_c] \]
\[ \sigma_c^2=\mathbb{E}\left[(x_c-\mu_c)^2\right] \]
- μc: Mean activation katika channel c.
- σc2: Spatial variance ya activations.
- xc: Feature values katika relevant channel.
Kwa sababu activations zinaweza kubadilika rapidly around boundary ya small object, channels zinazobeba object detail zinatarajiwa kuwa na high variance. Channels zinazodominated na flat na uniform background regions zinaweza kuwa na lower variance.
Mean na variance values zinaunganishwa na channel weights zinatengenezwa kupitia 1 × 1 convolution na sigmoid activation. Spatial attention kutoka frequency path inaunganishwa na weights kutoka channel path ili kuenhance detail-bearing regions na channels.
Modules mbili zinafanyaje kazi pamoja?
EGA module kwanza inarekebisha geometric positions za shallow na deep features. FDAM kisha inaenhance edges na high-frequency details katika aligned features hizi.
- Edge information inatolewa kutoka shallow layer.
- Positional offsets zinapredictiwa kutoka edge na deep semantic features.
- Shallow na deep features zinaaligniwa kwa deformable convolution.
- Aligned features zinagawanywa kuwa frequency components kwa DCT.
- Sehemu ya low-frequency background inasuppressiwa.
- Mean- na variance-based channel attention inatumika.
- Enhanced features zinatumwa kwenye small-object detection head.
Datasets zilizotumika
VisDrone2019
VisDrone2019 ina drone images zilizopigwa katika cities, altitudes, camera angles, lighting na weather conditions tofauti. Study imetumia object-detection subset. Sehemu hii ina roughly 10.209 images na zaidi ya 540.000 bounding boxes.
Ten classes zilizotathminiwa ni:
- Pedestrian
- Person
- Bicycle
- Car
- Van
- Truck
- Tricycle
- Awning-tricycle
- Bus
- Motorcycle
UAVDT
UAVDT dataset ina 100 video sequences na roughly 80.000 frames zilizochaguliwa kutoka roughly ten hours za aerial video. Images zinajumuisha traffic environments kama highway, intersection, parking lot na toll station. Main detection classes ni car, truck na bus.
VisDrone inatoa broad test environment kwa different object classes na scales, wakati UAVDT inalenga dynamic urban conditions kama motion blur, dense traffic na vehicle occlusion.
Training environment na hyperparameters
| Variable | Value iliyotumika |
|---|---|
| Graphics processor | NVIDIA GeForce RTX 4090 |
| Deep-learning framework | PyTorch 2.4.1 |
| Environment management | Anaconda3 |
| Input resolution | 640 × 640 pixels |
| Training duration | 300 epoch |
| Batch size | 16 |
| Initial learning rate | 0,01 |
| Momentum | 0,937 |
| Weight decay | 0,0005 |
| Optimization algorithm | Stochastic Gradient Descent |
Text haielezi kwa undani kama all models zililinganishwa kwa same data augmentation operations, random seed na training repetitions. Pia hakuna open repository link iliyotolewa kwa model code, trained weights na full configuration files.
Evaluation metrics
Precision inapima ni sehemu gani ya examples zilizomarkiwa kama objects na model zilikuwa correct:
\[ \operatorname{Precision}=\frac{TP}{TP+FP}\times100 \]
Recall inaonyesha ni sehemu gani ya objects zilizokuwepo kweli katika images zilikamatwa:
\[ \operatorname{Recall}=\frac{TP}{TP+FN}\times100 \]
- TP: Objects zilizodetectiwa correctly.
- FP: Objects zilizodetectiwa ingawa hazikuwepo kweli.
- FN: Real objects zilizokosekana na model.
Average precision kwa class moja imefafanuliwa kama area under precision–recall curve:
\[ AP=\int_0^1 P(R)\,dR \]
Mean ya AP values across multiple classes ni:
\[ mAP=\frac{1}{K}\sum_{i=1}^{K}AP_i\times100 \]
mAP@0.5 inahesabiwa wakati intersection-over-union ratio kati ya predicted box na ground-truth box ni at least 0,5. mAP@0.5:0.95 inachukua mean kwenye ten different thresholds kati ya 0,5 na 0,95, hivyo inapima localization accuracy more strictly.
VisDrone2019 results
| Model | mAP@0.5 | Precision | Recall | mAP@0.5:0.95 | Parameters | GFLOP |
|---|---|---|---|---|---|---|
| YOLOv5n | %32,9 | %40,5 | %33,1 | %18,6 | 2,5 million | 7,2 |
| YOLOv8n | %33,9 | %41,3 | %34,7 | %19,2 | 3,2 million | 8,7 |
| YOLOv10n | %34,0 | %42,8 | %33,7 | %19,9 | 2,3 million | 6,5 |
| YOLOv11n | %33,9 | %42,1 | %34,9 | %19,8 | 2,6 million | 6,6 |
| YOLOv7-Tiny | %36,8 | %42,8 | %40,1 | %20,8 | 6,1 million | 13,3 |
| EdgeYolo-t | %38,5 | %48,9 | %37,8 | %22,4 | 5,5 million | 27,2 |
| YOLO-EFD | %38,2 | %46,6 | %39,3 | %22,5 | 3,4 million | 12,5 |
According to main comparison table, YOLO-EFD imeongeza mAP@0.5 kutoka %33,9 hadi %38,2, recall kutoka %34,9 hadi %39,3 na stricter mAP kutoka %19,8 hadi %22,5 relative na YOLOv11n.
Model haitoi single highest result katika all comparison metrics. EdgeYolo-t imetoa slightly higher mAP@0.5 na precision. Main advantage ya YOLO-EFD ni kwamba dhidi ya 27,2 GFLOP computational load ya EdgeYolo-t, inafikia similar accuracy range kwa 12,5 GFLOP.
Computational load ya YOLO-EFD bado imeongezeka noticeably relative na base YOLOv11n: number ya parameters imeongezeka kutoka 2,6 million hadi 3,4 million, na GFLOP kutoka 6,6 hadi 12,5. Kwa hiyo, accuracy gain inakuja na computational load inayokaribia double relative na base model.
UAVDT results
| Model | mAP@0.5 | Precision | Recall | mAP@0.5:0.95 | Parameters | GFLOP |
|---|---|---|---|---|---|---|
| YOLOv11n | %31,3 | %37,8 | %27,5 | %18,3 | 2,6 million | 6,6 |
| YOLOv7-Tiny | %31,7 | %38,3 | %28,4 | %18,3 | 6,1 million | 13,3 |
| EdgeYolo-t | %32,3 | %40,1 | %29,6 | %18,7 | 5,5 million | 27,2 |
| YOLO-EFD | %32,1 | %39,3 | %30,5 | %18,9 | 3,4 million | 12,5 |
Katika UAVDT, YOLO-EFD imetoa highest recall value among compared models. Relative na YOLOv11n, recall imeongezeka kutoka %27,5 hadi %30,5. Increase hii inatoa evidence kwamba model inakosa objects chache katika dense na blurred traffic images.
EdgeYolo-t ina small advantage katika mAP@0.5 na precision, huku YOLO-EFD ikitoa higher recall na mAP@0.5:0.95. Kwa hiyo results zinaonyesha different trade-offs kati ya accuracy na computational cost zaidi ya single model kuwa superior katika every metric.
Module ablation experiments
| Configuration | mAP@0.5:0.95 | mAP@0.5 | Precision | Recall |
|---|---|---|---|---|
| YOLOv11n base model | %19,8 | %33,9 | %44,1 | %34,9 |
| EGA only | %21,5 | %36,7 | %45,8 | %37,2 |
| FDAM only | %20,8 | %35,2 | %45,2 | %35,8 |
| EGA na FDAM | %22,2 | %38,2 | %46,6 | %39,3 |
EGA module pekee imeongeza mAP@0.5 kwa 2,8 points na recall kwa 2,3 points. FDAM pekee imetoa smaller lakini positive change katika all metrics. Highest results zilipatikana wakati modules mbili zilitumika together.
Finding hii inaunga mkono kwamba geometric alignment na frequency-detail enhancement zinaingilia separate components mbili za same problem. Hata hivyo, haijaelezwa kama ablation experiments ni single random seed au mean ya multiple training repeats.
Frequency-filter parameter
| α | mAP@0.5:0.95 | mAP@0.5 |
|---|---|---|
| 0,00 | %21,5 | %37,8 |
| 0,25 | %22,2 | %38,2 |
| 0,50 | %21,8 | %37,5 |
| 0,75 | %21,6 | %37,4 |
| 1,00 | %21,3 | %37,2 |
Best result ilipatikana kwa α = 0,25. Performance kushuka gradually wakati stronger filtering inatumika inaonyesha kwamba si all low-frequency information ni unnecessary. General object shape na context pia zinaweza kuwa katika lower-frequency components.
Confusion matrices zilionyesha nini?
Katika VisDrone2019 confusion matrices, reductions ziliripotiwa katika rates za small-object classes kuchanganywa na background:
- Kwa pedestrian class, background confusion ilishuka kutoka 0,72 hadi 0,59.
- Katika motorcycle class, ilishuka kutoka 0,52 hadi 0,49.
- Katika bicycle class, ilishuka kutoka 0,85 hadi 0,78.
- Matrix diagonal value ya car class iliongezeka kutoka 0,70 hadi 0,76.
Katika class-based visual comparison, pedestrian value iliongezeka kutoka %25 hadi %38, motorcycle kutoka %26 hadi %37, bicycle kutoka %16 hadi %29, bus kutoka %37 hadi %45 na truck kutoka %28 hadi %36. Values hizi si class-wise AP results, bali classification ratios zilizotumika katika confusion matrix na category comparison ya study.
Grad-CAM na example images
Katika Grad-CAM visuals, base YOLOv11n model imeonyeshwa kusambaza attention yake kwenye road, building au different background regions katika some scenes, wakati YOLO-EFD imeconcentrate activations zaidi around vehicles na pedestrians.
Katika blurred example scene, base model iliripotiwa kudetect three vehicles, wakati YOLO-EFD ilidetect eight vehicles. Katika dense-traffic example, YOLO-EFD boxes zinaonekana kufit tighter kwenye boundaries za closely spaced vehicles.
Images hizi zinasaidia kueleza model behavior, lakini zinajumuisha selected examples chache. Individual images si evidence peke yake ya performance across entire dataset au reliability katika real flight conditions.
Strengths za study
- Si conceptual proposal pekee; working object-detection model imewasilishwa.
- Model imetathminiwa kwenye two different na widely used UAV datasets.
- Separate effects za EGA na FDAM modules zimechunguzwa kwa ablation experiment.
- Controlled comparison imefanywa kwa α parameter ya frequency filter.
- Parameter count na GFLOP information zimeripotiwa pamoja na accuracy metrics.
- Visual explanations zimeongezwa kwenye quantitative results kupitia confusion matrix, Grad-CAM na detection images.
- Simple-background na extremely small-target conditions ambapo model inaweza kufail zimeelezwa explicitly katika results section.
Internal inconsistencies na technical limitations
- Abstract, highlighted findings na ablation table zinaripoti %22,2 mAP@0.5:0.95 kwa VisDrone2019, wakati main comparison table inatoa %22,5.
- YOLOv11n precision imeandikwa %42,1 katika main comparison table na %44,1 katika ablation table.
- Haijaelezwa kama differences hizi zimetokana na separate training runs, different validation subsets au typographical errors.
- Caption ya Kielelezo 4 inayoonyesha FDAM architecture imeandikwa kimakosa kama EGA architecture. Some figure-number references katika text pia hazilingani na actual visuals.
- Standard deviation, confidence interval, statistical significance au multiple random seeds hazijaripotiwa kwa results.
- Haijaelezwa sufficiently kama all compared models ziliretrainiwa under same codebase, data-augmentation settings na training conditions.
- Licha ya real-time-use claim, FPS, per-image latency, memory use na power consumption hazijapimwa.
- Experiments zilifanywa kwenye RTX 4090; hakuna test iliyofanywa kwenye embedded processor inayoweza kutumika kwenye drone, Jetson platform au other edge device.
- Kwa sababu GFLOP imeongezeka kutoka 6,6 hadi 12,5 relative na base YOLOv11n, computational cost imeongezeka noticeably.
- Hakuna open link iliyotolewa kwa model code, trained weights, data-split files na complete hyperparameter configuration.
- Ingawa UAVDT ina attributes kama weather, altitude, camera angle na density, results hazijaripotiwa separately according to conditions hizi.
- Study inakubali kwamba katika simple backgrounds na extremely small sparse targets inaweza kuoverfocus kwenye high-frequency noise na kutengeneza false detections.
Study inaunga mkono nini?
Results zinaunga mkono kwamba ku-align features za resolutions tofauti kwa edge-guided deformable convolution kunaweza kuongeza small-object performance ya YOLOv11n. Experimental evidence pia imetolewa kwamba DCT-based high-frequency enhancement inaweza kutoa additional contribution especially kwa small targets zenye weak au blurred edges.
Kutumia modules mbili together kumetoa higher results kuliko kuzitumia separately kwenye datasets zilizochunguzwa. Model pia imekaribia similar accuracy range na heavier method kama EdgeYolo-t kwa lower parameter na GFLOP values.
Study haithibitishi nini?
Study haithibitishi kwamba YOLO-EFD ni best model katika all UAV tasks au all small-object datasets. Some comparison models zimetoa higher results katika particular metrics. Experiments zimewekewa limit ya public datasets mbili na one reported training setup.
Haijaonyeshwa kwamba model inafanya kazi real time kwenye real drone, inatumia low energy au inadumisha same performance katika bad weather, night, fog, vibration na different camera systems. GFLOP na parameter count si direct equivalent ya real-device latency.
Results pia hazionyeshi kwamba model inaweza kufanya reliable decisions peke yake katika critical areas kama search-and-rescue, security au traffic management. Kwa applications kama hizi, false negatives, false positives na different environmental conditions zinahitaji separate validation.
Possible significance kwa Uturuki
Approach iliyopendekezwa katika study inaweza kuhamishwa methodologically kwa areas nchini Uturuki kama drone-based traffic monitoring, post-disaster area scanning, forest-fire surveillance, agricultural imaging, coastal control na infrastructure inspection. Especially kutofautisha small vehicles au people katika high-altitude imagery ni one common technical problem katika applications hizi.
Kwa system itakayotumika Uturuki, model inahitaji kuretrainiwa kwa local urban texture, different road markings, vehicle types, vegetation, topography, weather conditions na drone cameras zinazotumika. VisDrone na UAVDT results haziwakilishi directly operational accuracy nchini Uturuki.
Kabla ya practical use, out-of-domain tests kwenye images za Uturuki, night na bad-weather tests, embedded-hardware latency measurements, energy consumption, confidence intervals na error classification zinapaswa kufanywa.
Mbinu na Matokeo ya Utafiti
| Method component | Application | Main finding | Interpretation limit |
|---|---|---|---|
| Base model | YOLOv11n | Small-object path imebadilishwa kwa EGA na FDAM | Other YOLO scales hazikutestwa |
| EGA edge extraction | 3 × 3 Scharr filters | Edge map imetengenezwa kutoka horizontal na vertical gradients | Strong background edges pia zinaweza kutengeneza response |
| EGA alignment | Positional offset kwa edge na semantic features; deformable convolution | Geometric compatibility ya shallow na deep features imeongezeka | Separate accuracy analysis ya positional offsets haijatolewa |
| FDAM frequency path | DCT, high-pass mask na inverse DCT | High-frequency edge na texture details zimeenhanceiwa | Excessive filtering inaweza kupunguza useful information |
| FDAM channel path | Channel mean na variance | Higher weight imetolewa kwa detail-rich channels | Hakuna detailed comparison na alternative attention methods |
| VisDrone2019 | Roughly 10.209 images, zaidi ya 540.000 boxes na 10 classes | %38,2 mAP@0.5 na %39,3 recall | mAP@0.5:0.95 result imetolewa kama two different values, %22,2 na %22,5, katika text |
| UAVDT | 100 video sequences na roughly 80.000 frames | %32,1 mAP@0.5 na %30,5 recall | Video tracking au temporal modeling haikufanywa |
| Ablation | EGA, FDAM na combined model zilitestwa separately | Combined structure ilitoa highest results | Hakuna multiple training repetitions na standard deviation |
| α parameter | Five values katika 0,00–1,00 range | Best value ilikuwa 0,25 | Imetolewa only kwenye VisDrone validation set |
| Computational cost | 3,4 million parameters na 12,5 GFLOP | Lower computational cost kuliko EdgeYolo-t | Hakuna real-device FPS na energy measurement |
Most important numerical results
- Katika VisDrone2019 main table, mAP@0.5 ya YOLO-EFD imetolewa kuwa %38,2.
- VisDrone2019 recall ni %39,3 na precision ni %46,6.
- VisDrone2019 mAP@0.5:0.95 ni %22,5 katika main table; %22,2 katika abstract na ablation table.
- Katika UAVDT, mAP@0.5 ni %32,1, mAP@0.5:0.95 ni %18,9, precision %39,3 na recall %30,5.
- EGA module pekee imeongeza mAP@0.5 kwa 2,8 points relative na base model.
- FDAM module pekee imeongeza mAP@0.5 kwa 1,3 points.
- Modules mbili together zimeongeza mAP@0.5 kutoka %33,9 hadi %38,2.
- Optimum frequency-mask parameter ilipatikana kuwa α = 0,25.
- Model ina 3,4 million parameters na 12,5 GFLOP computational load.
- EdgeYolo-t kwa 27,2 GFLOP imeproduce %38,5 mAP@0.5, wakati YOLO-EFD kwa 12,5 GFLOP imeproduce %38,2.
Things zinazohitajika kabla ya operational use
- Kuchapisha model code, weights na data-split files ili results ziwe reproduced.
- Kuripoti mean na standard deviations kwa at least three to five different random seeds.
- Kufanya external validation kwenye drone images zilizopigwa Uturuki.
- Kutest night, fog, rain, vibration, different altitude na different camera resolutions separately.
- Kupima FPS, latency, memory na power consumption kwenye Jetson au similar edge hardware.
- Kufanya cost analysis ya false positives na false negatives according to application type.
- Kuendeleza adaptive filters zinazopunguza overfocus kwenye high-frequency noise katika simple backgrounds.
- Kuongeza temporal consistency kwenye model kwa video object detection na multi-object tracking.
Maelezo ya Chanzo na Mbinu
Jina la asili la study: YOLO-EFD: Edge-guided and Frequency-domain Dual Enhancement for Small Object Detection in UAV Aerial Imagery
Waandishi na correct order: Xin Song, Peng Li, Xuecong Liu, Xin Zhao.
Equal first author: Hakuna equal-first-authorship au equal-contribution statement katika study.
Corresponding/contact author: Xin Song.
Institutional affiliations:
- School of Computer Science and Engineering, Northeastern University, Shenyang, Liaoning, China.
- Hebei Key Laboratory of Marine Perception Network and Data Processing, Northeastern University at Qinhuangdao, Qinhuangdao, Hebei, China.
- Shandong Province Key Laboratory of Independent and Reliable Computing Technology and Equipment, Chaoyue Technology Co., Ltd., Jinan, Shandong, China.
Official study page:Official SSRN record
Publication platform: SSRN.
Upload date: 1 Julai 2026.
Journal: Peer-reviewed journal publication au specific journal name haijathibitishwa. Page footer ina phrase “Preprint submitted to Elsevier”, lakini target journal haijaelezwa.
Peer-review status: Study ni preprint ambayo haijapitia peer review.
Source type: Computational computer-vision study yenye new deep-learning architecture, comparative experiments kwenye two public datasets, module-ablation tests na parameter analysis.
Funding: Research iliungwa mkono na Open Research Project Fund ya Shandong Province Key Laboratory of Independent and Reliable Computing Technology and Equipment kwa number KT25500300-lab.
Generative-AI use: Waandishi wameripoti kwamba walitumia DeepSeek kwa language correction na paragraph organization; walireview final content na kukubali responsibility.
Conflict of interest: Uploaded version haina explicit conflict-of-interest statement.
Data na code access: VisDrone2019 na UAVDT ni public datasets. Hata hivyo, hakuna link iliyotolewa kwa YOLO-EFD code, trained weights, random seeds na full experiment configuration.
Bibliographic warning: Kuna older SSRN record yenye same title na same authors, DOI 10.2139/ssrn.6878454. Kwa sababu all pages za uploaded version zina record number 7031768, DOI 10.2139/ssrn.7031768 imetumika kama msingi katika article hii.
Maelezo haya ya Kituruki yameandaliwa based on text, equations, tables, network schematics, heat maps, confusion matrices na experimental images za uploaded study. Hakuna external source iliyoongezwa kwa scientific results; external checking ililimitishwa only kwa verification ya bibliographic identity information kama title, authors, DOI, SSRN record date na corresponding author.
Main reporting problem ya study ni kwamba VisDrone2019 mAP@0.5:0.95 na base-model precision values hazilingani katika different sections. Kwa hiyo wakati results zinawasilishwa, value ya %22,5 katika main comparison table na value ya %22,2 katika abstract na ablation table zinapaswa kutajwa together.
Study haitoi field validation kwenye real drone hardware, latency measurement au energy-consumption experiment. Kwa hiyo assessment ya “real-time na suitable for edge devices” inapaswa kusomwa kama potential based on parameter na GFLOP results, si kama validated operational performance.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *