


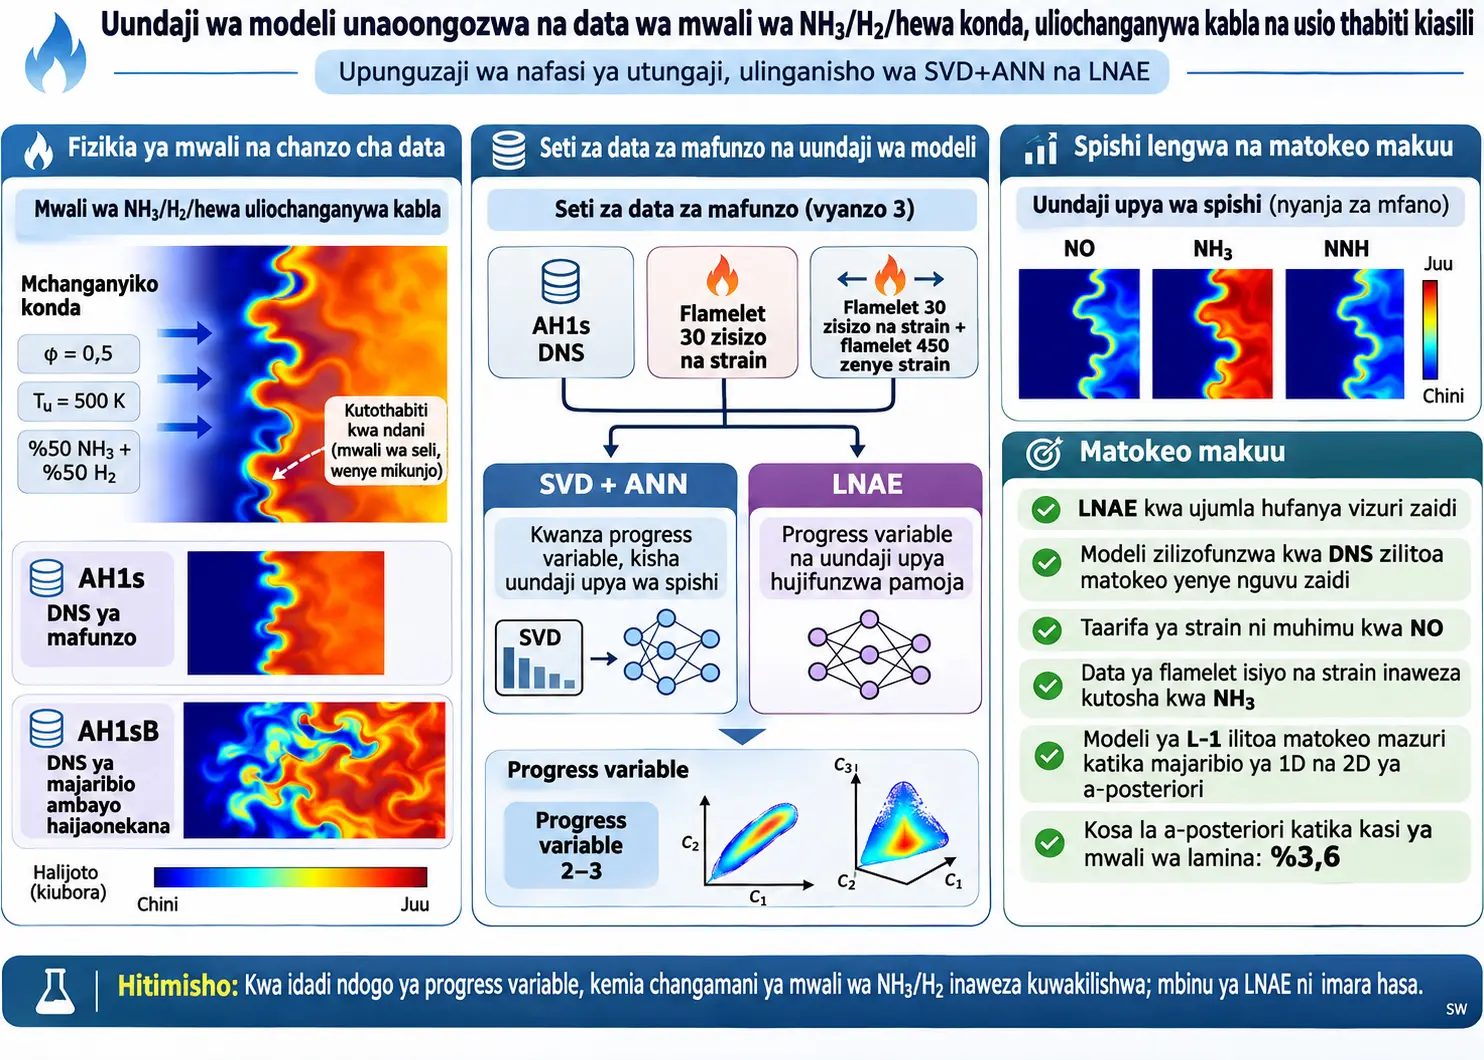
Modeli iliyopunguzwa ya muundo wa mwali inayoongozwa na data ni mbinu ya uundaji wa modeli inayojaribu kuwakilisha nafasi ya muundo yenye vipimo vingi, inayofafanuliwa na idadi kubwa ya spishi za kemikali katika kemia ya kina ya mwako, kwa kutumia idadi ndogo ya progress variable huru. Katika utafiti huu, mbinu mbili zimelinganishwa kwa mwali wa %50 NH3 + %50 H2/hewa ambao ni konda, umechanganywa kabla na una ukosefu wa uthabiti wa ndani wa thermodiffusive: Singular Value Decomposition + Artificial Neural Network (SVD+ANN) na Linear–Nonlinear Autoencoder (LNAE). Modeli zilifunzwa katika vyanzo vitatu tofauti vya data na kupimwa kwenye seti kubwa ya data ya Direct Numerical Simulation (DNS) ambayo haikuonekana wakati wa mafunzo.
Chanzo kina DNS mbili. DNS yenye eneo dogo zaidi, iitwayo AH1s, ina upana wa upande wa 10λc, huku upana wa AH1sB ukiwa 30λc; hapa urefu wa wimbi wa kukata ni λc = 2,63 mm. DNS zote mbili ziko katika hali za %50 NH3 na %50 H2 kwa ujazo, equivalence ratio φ = 0,5, joto la mchanganyiko usiochomwa Tu = 500 K na shinikizo la angahewa. Utaratibu wa kina wa kemia una spishi 25 za kemikali na miitikio 110. AH1s ya kiwango kidogo ilitumika kama data ya mafunzo, na AH1sB yenye nafasi pana zaidi ya hali za thermokemia ilitumika kama seti ya data ya majaribio ambayo haikuonekana.
Vyanzo vitatu vya data za mafunzo vililinganishwa: DNS ya AH1s; flamelet 30 za dimensheni moja zisizonyoshwa zilizoundwa katika safu ya φ = 0,45–0,60; na muunganiko wa flamelet 30 zisizonyoshwa na flamelet 450 za counter-flow zilizonyoshwa katika safu hiyo hiyo ya equivalence ratio. Mafanikio ya reconstruction ya modeli yalijadiliwa hasa kupitia spishi tatu wakilishi za kemikali: NO, inayowakilisha uundaji wa kichafuzi; NH3, inayowakilisha sehemu ya mafuta inayoingia kwenye mmenyuko; na spishi ya kati NNH, ambayo huwa na thamani kubwa tu katika eneo jembamba la mmenyuko.
Hitimisho kuu ni kwamba usanifu wa modeli na data za mafunzo kwa pamoja ni mambo ya kuamua. Modeli M-1 na L-1 zilizofunzwa kwenye DNS ndogo kwa ujumla zilitoa matokeo yenye nguvu zaidi. Data ileile ya mafunzo ya AH1s ilipolinganishwa, L-1 inayotegemea LNAE iliweza kureconstruct nafasi ya muundo wa spishi lengwa kwa progress variable chache zaidi na kwa ubora bora kuliko M-1 inayotegemea SVD+ANN. Flamelet zisizonyoshwa pekee hazikutosha kwa NO na NNH, lakini ziliweza kuwakilisha NH3 vizuri. Flamelet zilizonyoshwa zilipotumiwa pamoja na LNAE, reconstruction ya NO hasa iliboreshwa kwa wazi.
Matokeo ya chanzo hayamaanishi kwamba “variable nyingi zaidi daima hutoa modeli bora zaidi”. Thamani za makosa kwa kawaida hupungua wakati wa kutoka progress variable moja hadi tatu; katika hali nyingi faida ya ziada baada ya variable ya tatu huwa ndogo. Kwa baadhi ya spishi, modeli za variable nne hazikutoa matokeo bora kuliko modeli zenye dimensheni ndogo kwa sababu ya dimensheni ya manifold kuwa kubwa kupita kiasi.
Sehemu ya a-posteriori ya utafiti ni ya awali. Modeli ya L-1 yenye latent variable mbili, ambayo ilikuwa mojawapo ya modeli zenye nguvu zaidi katika uchanganuzi wa a-priori na ilifunzwa kwenye DNS ya AH1s, ilihamishwa katika mfumo wa tabulated chemistry. Katika jaribio la mwali wa dimensheni moja usionyoshwa, kosa la %3,6 katika kasi ya mwali wa lamina liliripotiwa. Katika uchanganuzi wa uthabiti wa mstari wa dimensheni mbili, modeli ilireproduce vizuri viwango vya ukuaji vya rejea katika wave number za chini, lakini ikatabiri mwali kuwa usio thabiti zaidi katika wave number za juu. Kwa hiyo, utafiti huu si uthibitishaji wa kiwango kamili wa turbine, burner au mfumo halisi wa viwandani wa mwako wa NH3/H2.
Tatizo ni nini katika miali ya amonia/hidrojeni?
Amonia ni mbebaji wa nishati usio na kaboni katika molekuli yake na unaovutia katika usafirishaji/uhifadhi wa hidrojeni. Hata hivyo, mwako wa moja kwa moja wa NH3 una changamoto muhimu kama reactivity ndogo na uundaji wa oksidi za nitrojeni. Kuongeza hidrojeni kwenye amonia kunaweza kuongeza reactivity ya mwako; lakini hasa katika michanganyiko konda kunaweza pia kuimarisha ukosefu wa uthabiti wa ndani wa mwali.
Chanzo kinajadili taratibu mbili kuu za ukosefu wa uthabiti wa ndani wa mwali. Ya kwanza ni utaratibu wa hydrodynamic Darrieus–Landau (DL). Ya pili ni utaratibu wa thermodiffusive (TD), unaohusiana na kutolingana kwa kasi za diffusion ya molekuli ya joto na spishi za kemikali.
Katika michanganyiko konda yenye hidrojeni, effective Lewis number ya reactant inayodhibiti inaposhuka chini ya thamani muhimu, utaratibu wa thermodiffusive unaweza kuwa na tabia ya kuleta ukosefu wa uthabiti. Ukosefu huu wa uthabiti unaweza kusababisha front ya mwali kukunjamana badala ya kusonga kama uso tambarare, miundo ya seli kuundwa, uwiano wa mchanganyiko wa ndani kubadilika na maeneo ya uundaji wa spishi kama NO kuwa changamano zaidi.
Kwa hiyo, tatizo si swali la “joto la mwali ni kiasi gani?” pekee. Katika kila nukta ya anga kuna mass fraction za spishi nyingi za kemikali, na hali hizi za kemikali zina mahusiano yenye nguvu na yasiyo ya mstari. Kutatua kemia ya kina moja kwa moja katika kila seli ya CFD huongeza gharama ya kompyuta kwa kiasi kikubwa.
Low-dimensional manifold ni nini?
Dhana ya msingi ya utafiti ni kwamba degrees of freedom zote za nafasi ya kina ya muundo wa kemikali yenye spishi 25 si huru. Ingawa hali za kemikali zipo katika nafasi yenye vipimo vingi, hali zinazofikiwa kimwili zinatarajiwa kujikusanya kwenye uso wenye vipimo vichache au low-dimensional manifold (LDM).
Katika hali hii, badala ya kubeba spishi zote kama control variable huru, idadi ndogo ya progress variable, yaani vigezo vya maendeleo, inaweza kutumiwa. Progress variable hufanya kazi kama coordinates zenye vipimo vichache za hali ya kemikali.
Swali la utafiti linaibuka hapa: ni progress variable ngapi zinahitajika ili kuwakilisha kwa usahihi wa kutosha nafasi ya hali ya kemikali ya mwali mkubwa na usio thabiti kwa thermodiffusion, na data za mafunzo zenye utajiri kiasi gani zinapaswa kutumiwa kujifunza variable hizi?
Progress Variable ni Nini na Kwa Nini Inatumiwa Katika Utafiti Huu?
Progress variable ni variable iliyopunguzwa inayoundwa kwa kuchanganya mass fraction za spishi nyingi za kemikali kwa uzito maalumu na inayotumiwa kueleza nafasi yenye vipimo vingi ya muundo wa mwako kwa coordinates chache zaidi; katika utafiti huu lengo ni kuweza kureconstruct tabia ya spishi 23 zinazomodeliwa kutoka progress variable 1–4.
Seti za data za DNS za AH1s na AH1sB
Katika utafiti zilitumiwa DNS mbili za dimensheni mbili za lamina ambazo ni tambarare kitakwimu lakini zina ukosefu wa uthabiti wa ndani. Katika zote mbili:
- mafuta ni %50 NH3 + %50 H2 kwa ujazo,
- yamechanganywa kabla na hewa,
- equivalence ratio ni φ = 0,5,
- joto la gesi isiyochomwa ni Tu = 500 K,
- shinikizo ni shinikizo la angahewa,
- utaratibu wa kina wa kinetic wa Gotama na wenzake wenye spishi 25 / miitikio 110 umetumiwa.
Tofauti kuu kati ya simulation hizi mbili ni upana wa eneo la upande. Kwa AH1s, Lx = 10λc, na kwa AH1sB, Lx = 30λc. Kwa kuwa urefu wa wimbi wa kukata ni λc = 2,63 mm, upana halisi wa upande ni takribani 26,3 mm na 78,9 mm. Thamani hizi mbili za mwisho ni zao rahisi la kuzidisha parameters za chanzo; si matokeo ya simulation mpya.
Chanzo kinajadili kwamba katika maeneo ya takribani 25λc na mapana zaidi, spectrum ya tabia ya kukunjamana kwa front ya mwali inaweza kukua kwa uhuru zaidi. Kwa hiyo, AH1sB ilichaguliwa kama nafasi ya jaribio yenye miundo mikubwa zaidi ya ukosefu wa uthabiti na hali za thermokemia zenye utajiri zaidi.
DNS ilihesabiwaje?
DNS zilihesabiwa kwa solver ya Nek5000 iliyorekebishwa na kundi la utafiti. Kwa reacting flows, mbinu ya splitting ya order ya juu ilitumika, na mfumo mgumu wa ordinary differential equations za kemikali uliintegratewa kwa njia implicit kwa CVODE.
Chanzo kinatoa spectral element order kuwa N = 10. Resolution hii ilitoa takribani nukta 20 za grid ndani ya unene wa thermal flame wa lamina. Taarifa hii ni muhimu; lebo ya DNS haitokani tu na jina la modeli, bali na kutatuliwa moja kwa moja kwa scales ndogo za muundo wa mwali.
Maktaba za mafunzo za flamelet
Nje ya DNS, vikundi viwili tofauti vya mafunzo ya flamelet za dimensheni moja viliundwa:
| Chanzo cha data za mafunzo | Yaliyomo | Jina la SVD+ANN | Jina la LNAE | Jaribio |
|---|---|---|---|---|
| DNS ya kiwango kidogo | AH1s, 10λc | M-1 | L-1 | AH1sB |
| Flamelet zisizonyoshwa | 30 za 1D, φ = 0,45–0,60 | M-2 | L-2 | AH1sB |
| Flamelet zilizonyoshwa + zisizonyoshwa | 30 zisizonyoshwa + 450 flamelet za counter-flow zilizonyoshwa | M-3 | L-3 | AH1sB |
Flamelet zilitengenezwa kwa Cantera. Flamelet zilizonyoshwa zina geometry ya premixed counterflow flame. Sababu ya kuchagua safu ya equivalence ratio ya 0,45–0,60 ni kwamba ndani ya DNS, equivalence ratio ya ndani hubadilika katika safu pana kwa sababu ya preferential diffusion ya H2 na curvature ya mwali.
Chanzo kinaonyesha kwamba katika baadhi ya maeneo DNS hushuka kidogo chini ya φ = 0,45. Hata hivyo, ilibainika kuwa kupanua maktaba ya flamelet kuelekea thamani konda zaidi hakukuleta uboreshaji dhahiri katika matokeo ya majaribio, na kikomo cha chini kilihifadhiwa kuwa 0,45.
Joto lisilo na dimension θ
Fomula inahesabu nini? Inafanya joto la ndani kuwa dimensionless kati ya hali isiyochomwa na iliyochomwa ya mwali wa rejea wa dimensheni moja unaoenea kwa uhuru katika hali zilezile.
- T: joto la ndani linalochunguzwa.
- Tu1D: joto la gesi isiyochomwa la mwali wa rejea wa dimensheni moja.
- Tb1D: joto la gesi iliyochomwa la mwali wa rejea wa dimensheni moja.
- θ: joto lisilo na dimension.
Denominator ni ongezeko lote la joto kati ya hali iliyochomwa na isiyochomwa katika mwali wa rejea wa 1D. Numerator inaonyesha hali ya ndani imepanda kiasi gani juu ya joto lisilochomwa. Hivyo hali mbalimbali za ndani zinaweza kulinganishwa kwenye coordinate moja ya joto lililonormalizewa.
Pipeline ya modeli
SVD ni nini?
Singular Value Decomposition (SVD) ni mbinu ya algebra ya mstari inayogawanya matrix ya data kuwa directions za orthonormal na singular values zinazowakilisha uzito wake. Katika utafiti imetumiwa kutambua muundo wa linear correlation katika matrix ya data ya mass fraction za spishi za kemikali na kupanga progress variable kwa mpangilio wa kihierarkia.
Fomula inaeleza nini? Katika chanzo, X ni matrix ya data ya muundo wa kemikali; U na V ni unitary matrices zenye columns za orthonormal. Σ ni muundo wa diagonal wenye singular values zisizo hasi. Alama ya nyota inaonyesha complex conjugate transpose; kwa data halisi ni sawa na transpose ya kawaida.
Mass fraction za spishi za kemikali huwekwa kwenye matrix X kwa namna ambayo directions za row/column huwakilisha hali za data na spishi. SVD hupata directions zenye nguvu zaidi za linear correlation katika nafasi ya muundo. Uzito wa directions hizi hutumiwa katika ufafanuzi wa progress variable.
- Cj: progress variable ya j.
- Yi: mass fraction ya spishi ya kemikali ya i.
- ai,j: uzito wa spishi unaopatikana kutoka SVD.
Katika mbinu ya SVD+ANN mchakato huu una hatua mbili: kwanza progress variable huamuliwa na SVD; kisha ANN hujifunza kureconstruct mass fraction za spishi kutoka coordinates hizi zenye vipimo vichache.
Mtandao wa SVD+ANN ulioptimishwaje?
Chanzo kinasema usanifu wa ANN ulioptimishwa kwa Random Search kwa kila hali ya mafunzo. Safu za hyperparameter zilizotafutwa ni hizi:
| Hyperparameter | Safu ya utafutaji |
|---|---|
| Idadi ya hidden layers | 1–10 |
| Neuroni kwa layer | 5–505 |
| Learning rate | 10−4 – 10−2 |
| Activation ya hidden layer | Sigmoid |
| Output layer | Linear activation |
ANN hureconstruct spishi 23 za kemikali; chanzo kiliondoa He na Ar katika output ya modeli. PDF kuu haitoi kwa uwazi idadi kamili ya layers na neuroni zilizochaguliwa kwa kila mtandao wa M-1/M-2/M-3 baada ya Random Search.
Sampling na scaling ya data
Ili kuharakisha mafunzo, sampuli zilichaguliwa kutoka seti kamili ya data za mafunzo. Sampling ilipangwa ili kupunguza tofauti ya Kullback–Leibler divergence kati ya data iliyosampuliwa na data kamili ya mafunzo. KL divergence ni kipimo cha information theory kinachopima tofauti kati ya probability distributions mbili.
Chanzo hakiripoti kwa uwazi katika PDF kuu ni data point ngapi zilihifadhiwa katika kila seti ya mafunzo baada ya sampling. Kwa hiyo Verianla haitengenezi idadi mpya ya sampuli.
Kabla ya mafunzo ya ANN, kila variable iliwekwa kwenye safu ya [0,1]:
Fomula inahesabu nini? Inaweka thamani ya kila spishi ya kemikali au progress variable kwenye safu ya 0 hadi 1 kulingana na thamani zake za minimum na maximum katika seti ya data za mafunzo.
- Xi,j: thamani asilia ya variable ya i kwenye data point ya j.
- min(Xi): minimum ya variable ya i katika seti ya mafunzo.
- max(Xi): maximum ya variable ya i katika seti ya mafunzo.
- Xi,j*: thamani iliyoscale.
Seti ya data ya majaribio haikuscaleiwa kwa kujitegemea kwa minimum na maximum zake yenyewe. Data ya jaribio ya AH1sB iliscailewa kwa kutumia thamani za min/max za seti ya mafunzo husika. Tofauti hii ni muhimu kwa tathmini halisi ya generalization; parameter za scaling hazikujifunzwa kutoka data ya jaribio.
LNAE ni nini?
Linear–Nonlinear Autoencoder (LNAE) ni usanifu wa artificial neural network unaobana spishi za kemikali za input kwenye bottleneck layer yenye vipimo vichache na kisha kureconstruct muundo lengwa wa kemikali kwa decoder isiyo ya mstari.
Bottleneck layer katika utafiti huu ina neuroni 1–4. Kila neuroni inalingana na progress variable moja. Activation ya bottleneck layer ni ya mstari na thamani ya bias imewekwa sifuri. Chaguo hili huwezesha progress variable kubaki kama linear combination ya spishi za input na kulinganishwa moja kwa moja zaidi kimwili/kihisabati na progress variable za SVD.
Sehemu ya decoder inaweza kuwa na hidden layers 1–10; sigmoid imetumiwa katika hidden layers na linear activation katika output layer ya mwisho. Mpangilio bora wa neuroni za decoder pia ulichaguliwa kwa Random Search.
Tofauti kuu ya LNAE na SVD+ANN ni kwamba haifungi ufafanuzi wa progress variable katika hatua tofauti ya linear algebra. Uzito wa bottleneck na decoder inayoreconstruct spishi huoptimishwa pamoja ndani ya lengo moja la mafunzo.
Kwa Nini LNAE Ilifanya Vizuri Zaidi Kuliko SVD+ANN?
Kwa sababu LNAE huoptimisha progress variable pamoja na decoder ili kupunguza reconstruction error ya spishi lengwa, badala ya kuzichagua tu ili kuwakilisha linear correlations zenye nguvu zaidi kati ya spishi zote za kemikali, katika utafiti huu ilionyesha kwa ujumla reconstruction error ndogo na required manifold dimension ndogo kuliko SVD+ANN wakati seti ileile ya data za mafunzo ilitumika.
Kwa nini progress variable moja hadi nne zilijaribiwa?
Chanzo kiliweka kikomo cha juu kuwa progress variable nne. Kuna sababu mbili: tafiti za awali zinazoonyesha kwamba progress variable tatu zinaweza kutosha katika miali isiyo thabiti inayofanana, na kwamba idadi kubwa zaidi ya control variable kwa kawaida si ya vitendo katika matumizi ya tabulated chemistry.
Manifold dimension inapoongezeka, kila variable ya ziada inaweza kubeba taarifa mpya; lakini katika CFD, transport equation au dimension ya table lazima iongezwe kwa kila progress variable. Kwa hiyo, lengo la uundaji wa modeli si reconstruction error ndogo zaidi pekee, bali kupata usahihi wa kutosha katika dimension ndogo iwezekanavyo.
Uhusiano na tabulated chemistry
Hata kama modeli za a-priori za utafiti hazitumiwi moja kwa moja katika CFD, ufafanuzi wa progress variable unazifanya zifae kuhamishwa kwenye mifumo ya tabulated chemistry kama Flamelet Generated Manifold.
Kwa progress variable Cj, chanzo kinatoa transport equation kwa namna ifuatayo:
- ρ: density.
- Cj: progress variable ya j.
- u: velocity field.
- JCj: diffusive flux ya progress variable.
- SCj: chemical source term.
- NC: idadi ya progress variable zinazosafirishwa.
Upande wa kushoto wa equation unawakilisha mabadiliko ya muda na convective transport; upande wa kulia unawakilisha diffusion na athari za uzalishaji/matumizi ya kemikali.
Kwa kuwa progress variable ni linear combination za mass fraction za spishi za kemikali, source term zake zinaweza pia kuandikwa kwa kuchanganya source term za spishi kwa uzito uleule:
Hapa \(\dot{\omega}_i\) ni reaction source term ya spishi ya kemikali ya i. Hivyo, badala ya kutatua equations zote za spishi moja moja wakati wa CFD, idadi ndogo zaidi ya progress-variable equations inaweza kusafirishwa.
Mass fraction za spishi kisha hureconstructiwa kutoka progress variable kupitia function au table:
Equation hii haimaanishi kwamba kemia ya kina imeondolewa kabisa. Uhusiano uliojifunzwa kutoka kemia ya kina huhifadhiwa katika umbo lililobanwa kwenye nafasi ya progress-variable yenye vipimo vichache, na wakati wa utekelezaji thamani za spishi hurudishwa kupitia representation hii yenye vipimo vichache.
Mbinu na Matokeo ya Utafiti
Uteuzi wa majina ya modeli sita
| Modeli | Mbinu | Data za mafunzo | Data za jaribio |
|---|---|---|---|
| M-1 | SVD+ANN | AH1s DNS | AH1sB DNS |
| M-2 | SVD+ANN | Flamelet 30 zisizonyoshwa | AH1sB DNS |
| M-3 | SVD+ANN | 30 zisizonyoshwa + 450 flamelet zilizonyoshwa | AH1sB DNS |
| L-1 | LNAE | AH1s DNS | AH1sB DNS |
| L-2 | LNAE | Flamelet 30 zisizonyoshwa | AH1sB DNS |
| L-3 | LNAE | 30 zisizonyoshwa + 450 flamelet zilizonyoshwa | AH1sB DNS |
Kwa nini NO, NH₃ na NNH zilichaguliwa?
Output ya mitandao si spishi tatu tu; modeli hureconstruct spishi nyingi katika utaratibu wa kinetic. Makala ililenga uwasilishaji wa matokeo kwenye spishi tatu wakilishi.
- NO: spishi muhimu ya kichafuzi katika mwako wa amonia/hidrojeni na inawakilisha tabia ya bidhaa ya kemikali inayoundwa polepole.
- NH3: ni mojawapo ya reactant kuu na inawakilisha tabia ya matumizi katika eneo la mmenyuko.
- NNH: ni spishi ya kati ya kemikali ambayo huwa muhimu tu katika reaction layer nyembamba sana na hutoa jaribio gumu kwa reconstruction.
Kwa kuwa NNH ni sifuri au karibu na sifuri katika sehemu kubwa ya nafasi, interpretation ya performance metrics huwa ngumu. Hata kama average error inaonekana ndogo, error kubwa katika eneo jembamba la mmenyuko inaweza kuwa muhimu kimwili.
Metric ya error
Fomula inahesabu nini? Katika kila grid point ya jaribio, inahesabu tofauti kati ya modeli na rejea kwa namna mbili na kuchagua ndogo kama thamani ya error.
Term ya kwanza hubadilisha absolute difference kwenye values zilizoscale kwa [0,1] kuwa asilimia. Term ya pili ni relative percentage error ya kawaida.
Lengo la kuchagua minimum ya terms hizi mbili ni kuzuia error bandia za mamia au maelfu ya asilimia wakati true values ni ndogo sana na denominator ya relative error inakuwa ndogo. Design hii ni muhimu hasa kwa spishi kama NNH ambazo ziko karibu na sifuri katika sehemu kubwa ya mwali.
QoI ni quantity of interest, yaani quantity inayomodeliwa. Katika uwasilishaji wa matokeo ya utafiti, quantity hii mara nyingi ni scaled mass fraction ya NO, NH3 au NNH.
Kwa nini R² pekee haitoshi?
Coefficient of determination R² ilihesabiwa katika predicted-versus-true scatter plots. Hata hivyo, chanzo kinaeleza kuwa sehemu kubwa ya values za spishi za kemikali inaweza kujikusanya karibu na value moja katika hali zisizochomwa au zilizochomwa kabisa.
Katika usambazaji wa data kama huu, modeli inaweza kutabiri kwa usahihi idadi kubwa ya nukta rahisi katika nafasi pana lakini ikatabiri vibaya idadi ndogo ya nukta muhimu kwenye reaction front. R² bado inaweza kuwa kubwa sana. Kwa hiyo, utafiti unatafsiri R² pamoja na error fields, average error na maximum error.
M-1: SVD+ANN + AH1s DNS
Katika modeli M-1, seti za data za mafunzo na majaribio ni DNS mbili tofauti kutoka darasa moja la tatizo la kimwili. Progress variable moja haitoshi hasa kwa NO. NH3 hureconstructiwa vizuri zaidi kwa manifold ya dimensheni mbili, huku kwa NO matumizi ya variable tatu yakileta uboreshaji dhahiri.
NNH ni mojawapo ya spishi ngumu zaidi kwa sababu ipo katika eneo jembamba la mmenyuko. Average error inaweza kuwa ndogo, lakini maximum error inaweza kubaki muhimu.
Kwa ujumla chanzo kinaonyesha kwamba katika M-1, progress variable angalau tatu zinapotumiwa, spishi zote tatu lengwa zinaweza kuwakilishwa kwa nguvu.
M-2: SVD+ANN + flamelet zisizonyoshwa pekee
Tatizo kuu la M-2 ni kutokuwepo kwa strain effects katika data za mafunzo. Katika mwali wa jaribio wa AH1sB, ukosefu wa uthabiti wa ndani hukunjamana front ya mwali; mikunjo hii huleta strain ya ndani, curvature na preferential diffusion.
Kwa sababu NO huathiriwa sana na athari hizi, nafasi ya hali za kemikali iliyojifunzwa kutoka miali ya dimensheni moja isiyonyoshwa pekee haikuweza kufunika vya kutosha tabia ya NO katika DNS ya jaribio.
Matokeo ya NH3 ni bora zaidi. Chanzo kinaeleza kuwa strain effect ni ya daraja la pili zaidi katika tabia ya NH3 na kwamba seti ya data ya flamelet zisizonyoshwa pekee inaweza kutosha kumodeli spishi hii ya reactant.
M-3: SVD+ANN + flamelet zilizonyoshwa
Seti ya data ya M-3 ni tajiri zaidi kuliko M-2; flamelet 450 zilizonyoshwa zimeongezwa. Hata hivyo, matokeo ya SVD+ANN hayakuonyesha uboreshaji uliotarajiwa na chanzo kinaripoti kuwa M-2 ilikuwa bora kuliko M-3 katika baadhi ya matokeo.
Uchunguzi huu ni muhimu sana: unaonyesha kwamba data tajiri zaidi za mafunzo hazitoi moja kwa moja modeli bora zaidi. Waandishi wanajadili kwamba katika hali hii limitation haipo kwenye data pekee, bali pia kwenye namna mbinu ya SVD+ANN inavyofafanua progress variable.
L-1: LNAE + AH1s DNS
L-1 ni counterpart ya kimetodolojia ya M-1; modeli zote mbili hutumia data zilezile za mafunzo za AH1s. Kwa hiyo tofauti inaonyesha zaidi athari ya model architecture.
LNAE iliweza kureconstruct spishi zote tatu lengwa kwa nguvu kwa progress variable mbili. Ikizingatiwa kwamba katika M-1 baadhi ya spishi zilihitaji progress variable tatu kwa ubora unaofanana, inaonekana kwamba LNAE huunda manifold iliyo compact zaidi.
Chanzo kinatafsiri matokeo ya L-1 kama ushahidi wa generalization kwamba DNS ya kiwango kidogo ina taarifa ya msingi ya kutosha kuwakilisha nafasi kubwa ya hali ya AH1sB.
L-2: LNAE + flamelet zisizonyoshwa
L-2 kwa ujumla ina mafanikio zaidi kuliko M-2 inayotumia seti ileile ya data ya flamelet zisizonyoshwa. Uboreshaji dhahiri kwa NNH unaonyesha athari ya model architecture.
Kwa NO, matokeo ni yenye mipaka zaidi. Sababu si modeli pekee bali kutokuwepo kwa strain effects katika data za mafunzo. Kwa hiyo chanzo kimeainisha matokeo ya NO kwa L-2 kuwa “mixed”.
NH3 ndiyo spishi rahisi zaidi na hureconstructiwa vizuri kwa latent variable mbili au zaidi.
L-3: LNAE + flamelet zilizonyoshwa na zisizonyoshwa
Kwa kuwa data za mafunzo katika L-3 zina strain effects, reconstruction ya NO hasa imeboreshwa ikilinganishwa na L-2. Modeli za L-3 zenye dimensheni ya juu zimekaribia performance ya modeli L-1 zilizofunzwa kwenye DNS ya AH1s.
Matokeo haya ni mojawapo ya ujumbe muhimu wa vitendo wa utafiti: badala ya seti ya gharama kubwa ya data za mafunzo ya DNS, maktaba ya flamelet zilizonyoshwa iliyoandaliwa ipasavyo inaweza, LNAE inapotumiwa, kuwakilisha kwa usahihi mkubwa nafasi ya muundo wa DNS kubwa kwa baadhi ya spishi lengwa.
Hata hivyo, matokeo haya hayajathibitishwa kwa ujumla kwa spishi zote za kemikali, michanganyiko yote ya NH3/H2 na hali zote za uendeshaji. Jaribio lilifanywa kwenye DNS ya AH1sB kwa mchanganyiko mmoja wa nominal fuel na hali maalumu za thermokemia.
Muhtasari wa ubora wa matokeo ya Jedwali 2 la chanzo
| Spishi | M-1 | M-2 | M-3 | L-1 | L-2 | L-3 |
|---|---|---|---|---|---|---|
| NO | ✓ | ✘ | ✘ | ✓ | ✓✘ | ✓ |
| NH3 | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| NNH | ✓ | ✘ | ✘ | ✓ | ✓ | ✓ |
Nini hutokea dimension ya modeli inapoongezeka?
Katika mjadala wa Fig. 19 na Fig. 20 wa chanzo, trend iliyo wazi zaidi ni kwamba average reconstruction error hupungua haraka mwanzoni kadiri idadi ya progress-variable inavyoongezeka. Hata hivyo, karibu na variable tatu, modeli nyingi hukaribia error floor.
Variable ya nne katika hali nyingi huleta uboreshaji mdogo wa ziada au inaweza kuharibu performance kwa baadhi ya spishi. Waandishi wanaeleza hili kwa sababu mbili zinazowezekana:
- Katika modeli zilizofunzwa kwa DNS, correlation mpya inayobebwa na progress variable za ziada kuhusu hali ya kemikali inaweza kupungua hatua kwa hatua.
- Katika modeli zilizofunzwa kwa flamelet ambazo training error tayari ni ndogo sana, dimension inayoongezeka inaweza kuchangia overfitting badala ya kuboresha test generalization.
Kwa hiyo, optimum manifold dimension si nambari moja ya universal. Inategemea tabia ya anga na kemikali ya spishi pamoja na muundo wa data za mafunzo.
Tofauti Kati ya Jaribio la A-Priori na A-Posteriori ni Nini?
Jaribio la a-priori hupima jinsi modeli iliyojifunza inavyoweza kureconstruct kwa usahihi hali za DNS ya AH1sB zilizohesabiwa awali, huku jaribio la a-posteriori likiweka modeli ndani ya mtiririko halisi wa solver pamoja na transport equations na tabulated chemistry; sehemu ya a-posteriori ya utafiti huu ina majaribio ya awali tu ya mwali wa 1D na uthabiti wa mstari wa 2D kwa modeli iliyochaguliwa ya L-1 yenye latent variable mbili.
L-1 ilibadilishwaje kwa matumizi ya a-posteriori?
Kwa kuwa L-1 ilionyesha performance yenye nguvu katika matokeo ya a-priori, modeli hii ilichaguliwa kwa jaribio la a-posteriori. LNAE mpya yenye latent variable mbili ilifunzwa.
LNAE hii mpya ilipanuliwa kutabiri si mass fraction za spishi pekee, bali pia source term za spishi na molecular diffusivities zinazohitajika wakati wa CFD.
Pia, badala ya kuipa encoder spishi zote za kemikali, subset ifuatayo ilitumika:
O2, H2O, NH3, NO, NO2 na H2.
Chanzo kinaeleza kwamba uteuzi huu ulikusudia kuunda spatial gradient ndogo zaidi katika progress-variable fields kote kwenye mwali na kupata variable zinazofaa zaidi kwa transport equations.
2D lookup table iliundwaje?
Katika nafasi ya \(R^2\) iliyoundwa na latent variable mbili, grid ya kawaida iliwekwa na LNAE mpya ikatathminiwa kwenye grid points hizi. Hivyo spishi na thermochemical quantities zinazohitajika ziliwekwa kwenye table kama function ya progress variable mbili.
Table hii inafanya iwezekane kufikia taarifa ya kemikali iliyoandaliwa mapema kutoka kwa values zilizohesabiwa za C1 na C2 badala ya kuendesha ANN tena katika kila seli ya CFD.
Solver ya a-posteriori inayotegemea OpenFOAM
Modeli ya tabulated L-1 ilitumika katika solver ya ndani ya kundi la utafiti inayotegemea OpenFOAM, ambayo ilikuwa imethibitishwa hapo awali katika contexts tofauti.
Kwa jaribio la dimensheni moja, hali za nominal zilihifadhiwa kuwa:
- φ = 0,5,
- Tu = 500 K,
- %50 H2 + %50 NH3 kwa ujazo
. Computational mesh ilichaguliwa ili iwe na angalau finite volume 20 katika unene wa mwali.
Matokeo ya 1D a-posteriori
Profiles za joto, NH3, NO na NNH za modeli ya tabulated L-1 zililinganishwa na finite-rate solution ya Cantera. Profiles kwa ujumla zilikubaliana vizuri, huku tofauti ndogo zikionekana katika post-flame region ya NO.
Chanzo kinaripoti total a-posteriori error ya %3,6 katika kasi ya mwali wa lamina.
Nambari hii si full-field reconstruction error ya DNS kubwa ya dimensheni mbili ya AH1sB. Ni metric tofauti ya a-posteriori performance ya kasi ya nominal laminar flame ya dimensheni moja.
Jaribio la uthabiti wa mstari wa 2D
Katika miali yenye ukosefu wa uthabiti wa ndani, kureconstruct profile tambarare ya mwali wa 1D pekee haitoshi. Pia lazima itabiriwe kwa usahihi kama perturbation ndogo za front ya mwali zitakua au la.
Kwa kusudi hili, harmonic perturbations zenye amplitude ndogo zilitumika kwenye front tambarare ya mwali na growth rate ya kila wave number ikafuatiliwa. Matokeo huwasilishwa kama dispersion relation, yaani uhusiano wa dispersion \(\omega(k)\).
- k: wave number ya perturbation.
- ω: growth rate ya wave number husika.
ω ikiwa chanya, perturbation husika hukua; growth rate kubwa zaidi inaonyesha tendency yenye nguvu zaidi ya linear instability.
Modeli L-1 ilifuatilia vizuri reference dispersion relation katika wave number za chini, lakini ikatoa growth rate za juu zaidi katika wave number za juu. Kwa maneno mengine, modeli ilitabiri perturbation za wavelength fupi kuwa zisizo thabiti zaidi kuliko reference DNS.
Waandishi wanaeleza kwamba tabia hii pia imeonekana katika modeli nyingine za juu za tabulated chemistry na kwamba overall dispersion relation ni ya kuridhisha katika muktadha wa tabulated chemistry.
Matokeo ambayo utafiti unaunga mkono na usiyounga mkono
| Utafiti unaunga mkono | Utafiti hauungi mkono |
|---|---|
| LNAE kwa ujumla ilionyesha reconstruction performance yenye nguvu zaidi kuliko SVD+ANN kwa seti hizi za data na spishi lengwa. | LNAE ni bora kuliko mbinu zote za reduced modeling katika matatizo yote ya mwako. |
| Modeli zilizofunzwa kwenye AH1s ziliweza kureconstruct sehemu kubwa ya AH1sB kwa progress variable 2–3. | Kila mwali wa NH₃/H₂ usio thabiti kwa thermodiffusion unaweza kuwakilishwa kwa uhakika kwa variable mbili. |
| Flamelet zisizonyoshwa pekee zinaweza kutosha kwa NH₃. | Strain effect si muhimu kwa spishi zote za kemikali. |
| Taarifa ya strain ni muhimu katika reconstruction ya NO. | Uundaji wa NO unadhibitiwa na flame stretch pekee. |
| Mchanganyiko wa flamelet zilizonyoshwa + LNAE uliweza kufanya generalization yenye nguvu kwenye nafasi ya hali ya DNS kubwa. | Mafunzo ya flamelet ni bora kuliko mafunzo ya DNS halisi katika kila hali. |
| Baada ya progress variable tatu, faida ya ziada ilionekana kupungua katika hali nyingi. | Tatu ni optimum manifold dimension ya universal kwa kila tatizo. |
| Modeli ya tabulated L-1 yenye latent variable mbili ilitoa matokeo mazuri katika majaribio ya awali ya 1D na 2D a-posteriori. | Modeli imethibitishwa katika mwako wa turbulent wa kiwango kamili au hali halisi za gas turbine. |
| Kosa la a-posteriori la %3,6 liliripotiwa katika kasi ya mwali wa lamina wa 1D. | Fields zote za spishi za kemikali zimetabiriwa kwa kosa la %3,6 katika hali za dunia halisi. |
| Katika uthabiti wa mstari wa 2D, eneo la k ya chini lilikamatwa vizuri. | Dynamics za ukosefu wa uthabiti katika wave number za juu zimereproduceiwa kikamilifu. |
Nguvu za utafiti
- Paradigm mbili tofauti za modeli zimelinganishwa kwenye seti ileile kubwa ya data ya jaribio ya AH1sB.
- Athari za model architecture na chanzo cha data za mafunzo zinaweza kutenganishwa kwa kiasi.
- Jozi ya M-1/L-1 inayotumia data ileile ya AH1s ni muhimu hasa kwa ulinganisho wa mbinu.
- Si average error pekee, bali scatter, spatial error field, R² na maximum error behavior zimejadiliwa pamoja.
- NO, NH₃ na NNH zimechaguliwa kama spishi wakilishi zenye tabia tofauti za kemikali/anga.
- Tofauti ya generalization kati ya data za mafunzo za flamelet zilizonyoshwa na zisizonyoshwa imechunguzwa pia.
- Tathmini ya a-priori ya modeli imekamilishwa kwa jaribio la awali la a-posteriori la CFD/tabulation.
- Matumizi ya latent variable mbili katika transport equations halisi yameonyeshwa.
Vikwazo vya utafiti
- Utafiti mkuu unategemea kabisa numerical modeling na data za simulation; hakuna kipimo cha majaribio cha mwali.
- Hali ya jaribio ni mchanganyiko mmoja wa nominal NH₃/H₂ na familia maalumu ya tatizo karibu na hali ya kati ya φ = 0,5.
- Uwasilishaji mkuu wa matokeo ya waandishi unalenga NO, NH₃ na NNH badala ya spishi zote 25.
- Maktaba ya flamelet imewekewa kikomo cha φ = 0,45–0,60.
- Idadi ya flamelet zilizonyoshwa ni 450 na flamelet zisizonyoshwa ni 30; density nyingine za maktaba hazijalinganishwa kwa utaratibu.
- PDF kuu hairipoti idadi kamili ya data point za mafunzo zilizohifadhiwa baada ya KL-divergence sampling.
- PDF kuu haitoi mpangilio kamili wa hidden layer/neuroni uliochaguliwa kwa kila modeli baada ya Random Search.
- PDF kuu haitaji wazi namna ya kihisabati ya loss function iliyotumiwa katika mafunzo.
- Detailed numerical error tables za graphs za matokeo zimeachwa kwenye Supplementary Material.
- R² inaweza kupotosha wakati values za spishi zinakusanyika karibu na hali moja.
- Katika localized intermediate species kama NNH, average error inaweza kuficha maximum error muhimu kimwili.
- Sehemu ya a-posteriori imetumika kwa modeli L-1 pekee; performance ya modeli nyingine tano ndani ya CFD haijajaribiwa.
- Tathmini ya a-posteriori ni ya awali.
- Jaribio la 2D a-posteriori si simulation kamili isiyo ya mstari ya propagation kubwa ya AH1sB, bali ni linear stability analysis.
- L-1 hutabiri growth rate kubwa zaidi na ukosefu mkubwa wa uthabiti kuliko reference katika wave number za juu.
- Turbulence–chemistry interaction haijajumuishwa katika upeo wa a-posteriori wa utafiti huu.
Mwelekeo wa kazi za baadaye
Waandishi wanapendekeza kuchunguza a-posteriori errors kwa utaratibu zaidi baadaye na kuunganisha modeli na turbulence–chemistry interaction modeling ndani ya Large Eddy Simulation (LES).
Lengo hili la kazi ya baadaye halimaanishi kwamba mwako wa turbulent wa viwandani umefanikiwa kusimuliwa katika utafiti wa sasa. Makala ya sasa kwanza inaonyesha uwezekano wa kuunda low-dimensional chemical manifold na matumizi yake ya a-posteriori yenye mipaka.
Hitimisho kuu la kisayansi la utafiti
Hitimisho muhimu zaidi la utafiti halipaswi kupunguzwa kuwa kauli ya jumla kama “artificial intelligence ilitabiri mwali kwa usahihi”. Mchango halisi wa utafiti ni kuonyesha kwa kulinganisha ni data gani za mafunzo, zinapounganishwa na architecture gani ya reduced model, zinaweza kufanya generalization kwenye nafasi ya hali za kemikali ya mwali wa NH₃/H₂ usio thabiti kwa thermodiffusion.
DNS ya kiwango kidogo ilikuwa data yenye nguvu zaidi ya mafunzo. Hata hivyo, LNAE ilipojifunza kutoka flamelet zilizonyoshwa iliweza kureconstruct kwa nguvu tabia ya spishi kuu za kemikali katika DNS kubwa hata bila mafunzo ya gharama kubwa ya DNS.
Uchunguzi huu ni muhimu kwa kuwakilisha kemia ya kina yenye gharama kubwa ya kompyuta kwa tabulated chemistry kupitia idadi ndogo ya progress variable. Lakini mbinu bado inategemea data halisi za mafunzo, nafasi sahihi ya hali ya flamelet, ufafanuzi unaofaa wa progress-variable na uthibitishaji wa a-posteriori.
Maelezo ya Chanzo na Mbinu
Kichwa asilia: Data-driven modeling of the flame composition space of an intrinsically unstable lean premixed ammonia/hydrogen/air flame
Waandishi: S. Bottari; F. D’Alessio; C. Matteucci; P.E. Lapenna; F. Creta.
Mwandishi wa mawasiliano: S. Bottari. Chanzo kinatoa anwani ya barua pepe ya corresponding-author kuwa stefano.bottari@uniroma1.it.
Mchango sawa: Chanzo hakijaonyesha taarifa ya uandishi wa kwanza wa pamoja au mchango sawa.
Taasisi: Mechanical and Aerospace Engineering, Sapienza University of Rome, Via Eudossiana 18, Rome 00186, Italy.
Jarida: Fuel.
Mchapishaji: Elsevier Ltd.
Aina ya chanzo: Full length article; uundaji wa modeli ya kemia iliyopunguzwa ya mwako inayoongozwa na data na utafiti wa numerical unaotegemea DNS/flamelet.
Rekodi ya bibliografia: Fuel 405, Part D (2026), Article 136805.
DOI: 10.1016/j.fuel.2025.136805
Kiungo rasmi: https://doi.org/10.1016/j.fuel.2025.136805
Tarehe za uchapishaji: Received: 23 Mei 2025; revised: 7 Agosti 2025; accepted: 8 Septemba 2025; available online: 12 Septemba 2025. Rekodi ya juzuu ya ScienceDirect kwa Volume 405, Part D inaonyesha tarehe 1 Februari 2026.
Hali ya peer review: Ni full-length scientific article iliyokubaliwa na kuchapishwa katika Fuel.
Leseni: Creative Commons Attribution–NonCommercial–NoDerivatives 4.0 International, CC BY-NC-ND 4.0.
Maelezo ya hakimiliki/picha: Kwa sababu ya sharti la ND, mpangilio wa visual wa Fig. 1–22 wa chanzo haujazalishwa tena kwa kuubadilisha. Mchoro wa mbinu ndani ya makala umeundwa kama composition huru ya Verianla kwa kutumia tu data za ukweli na mahusiano yaliyotolewa wazi katika chanzo.
Hali ya preprint: Chanzo kilichochunguzwa ni makala ya jarida iliyochapishwa; hakuna preprint identifier tofauti iliyoonyeshwa katika chanzo.
Hali kuu za DNS: mchanganyiko wa mafuta kwa ujazo %50 NH₃ + %50 H₂; φ = 0,5; Tu = 500 K; shinikizo la angahewa; kinetic mechanism ya spishi 25 / miitikio 110; AH1s = 10λc; AH1sB = 30λc; λc = 2,63 mm.
Programu ya DNS: Nek5000 ya ndani iliyorekebishwa; splitting ya order ya juu kwa reacting flow; CVODE kwa mfumo mdogo wa stiff chemistry.
Uzalishaji wa flamelet: Cantera; flamelet 30 za 1D zisizonyoshwa na flamelet 450 za premixed counterflow zilizonyoshwa.
Programu ya machine learning: utekelezaji wa Python unaotegemea Keras na TensorFlow.
Familia za modeli: M-1/M-2/M-3 kwa SVD+ANN; L-1/L-2/L-3 kwa LNAE.
Utafutaji wa hyperparameter: Random Search; chanzo kinataja safu za hidden layers 1–10, neuroni 5–505 kwa layer na learning rate 10−4–10−2.
Sampling: Sampling ya data za mafunzo inategemea kupunguza tofauti ya Kullback–Leibler divergence kati ya seti ya data iliyosampuliwa na seti kamili. PDF kuu hairipoti wazi idadi ya mwisho ya data point za sampuli.
Scaling: Variables ziliwekwa kwenye safu ya [0,1] kwa kutumia minimum na maximum za data za mafunzo; data za jaribio zilitumia pia min/max zilezile za mafunzo.
Aina kuu za tathmini: predicted-versus-true scatter plots na R², spatial error fields, average error, maximum error na metric ya pamoja ya absolute/relative percentage error katika Equation 6.
Modeli ya a-posteriori: L-1 yenye latent variable mbili. Modeli imetumika katika solver ya ndani ya tabulated chemistry inayotegemea OpenFOAM.
Matokeo ya 1D a-posteriori: Kosa la %3,6 katika kasi ya mwali wa lamina limeripotiwa.
Kikomo cha 2D a-posteriori: Jaribio ni linear stability na dispersion relation analysis; si a-posteriori reconstruction kamili ya large-scale nonlinear AH1sB flame propagation.
Michango ya CRediT: S. Bottari: Writing – original draft, Software, Methodology, Investigation. F. D’Alessio: Writing – original draft, Methodology, Software. C. Matteucci: Software. P.E. Lapenna: Writing – review & editing, Conceptualization, Methodology. F. Creta: Writing – review & editing, Funding acquisition, Conceptualization.
Ufadhili: Clean Hydrogen Partnership, grant agreement No. 101137955 — ACHIEVE; programu inapokea ufadhili wa European Union Horizon Europe, Hydrogen Europe na Hydrogen Europe Research. Utafiti pia umeungwa mkono na ICSC, Centro Nazionale di Ricerca in High-Performance Computing, Big Data and Quantum Computing, inayofadhiliwa na European Union – NextGenerationEU.
Mgongano wa maslahi: Waandishi wametangaza kwamba hakuna maslahi ya kifedha yanayoshindana au mahusiano binafsi yanayojulikana ambayo yangeweza kuathiri utafiti.
Upatikanaji wa data: Chanzo kinatoa kauli “Data will be made available upon request”.
Kikomo cha reproducibility: Ingawa PDF kuu inaeleza safu za Random Search, haitoi final network architecture iliyochaguliwa kwa kila modeli, maelezo ya epoch/batch ya mafunzo, idadi kamili ya data point baada ya KL sampling, wala definition ya kihisabati iliyo wazi ya training loss function. Sehemu muhimu ya numerical error tables imeelekezwa kwenye Supplementary Material.
Kikomo kikuu cha interpretation: Utafiti huu ni kazi ya data-driven chemistry reduction na simulation. Matokeo si uthibitishaji wa emissions, safety au performance ya gas turbine, engine, burner au mfumo halisi wa viwandani wa mwako wa NH₃/H₂.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *