

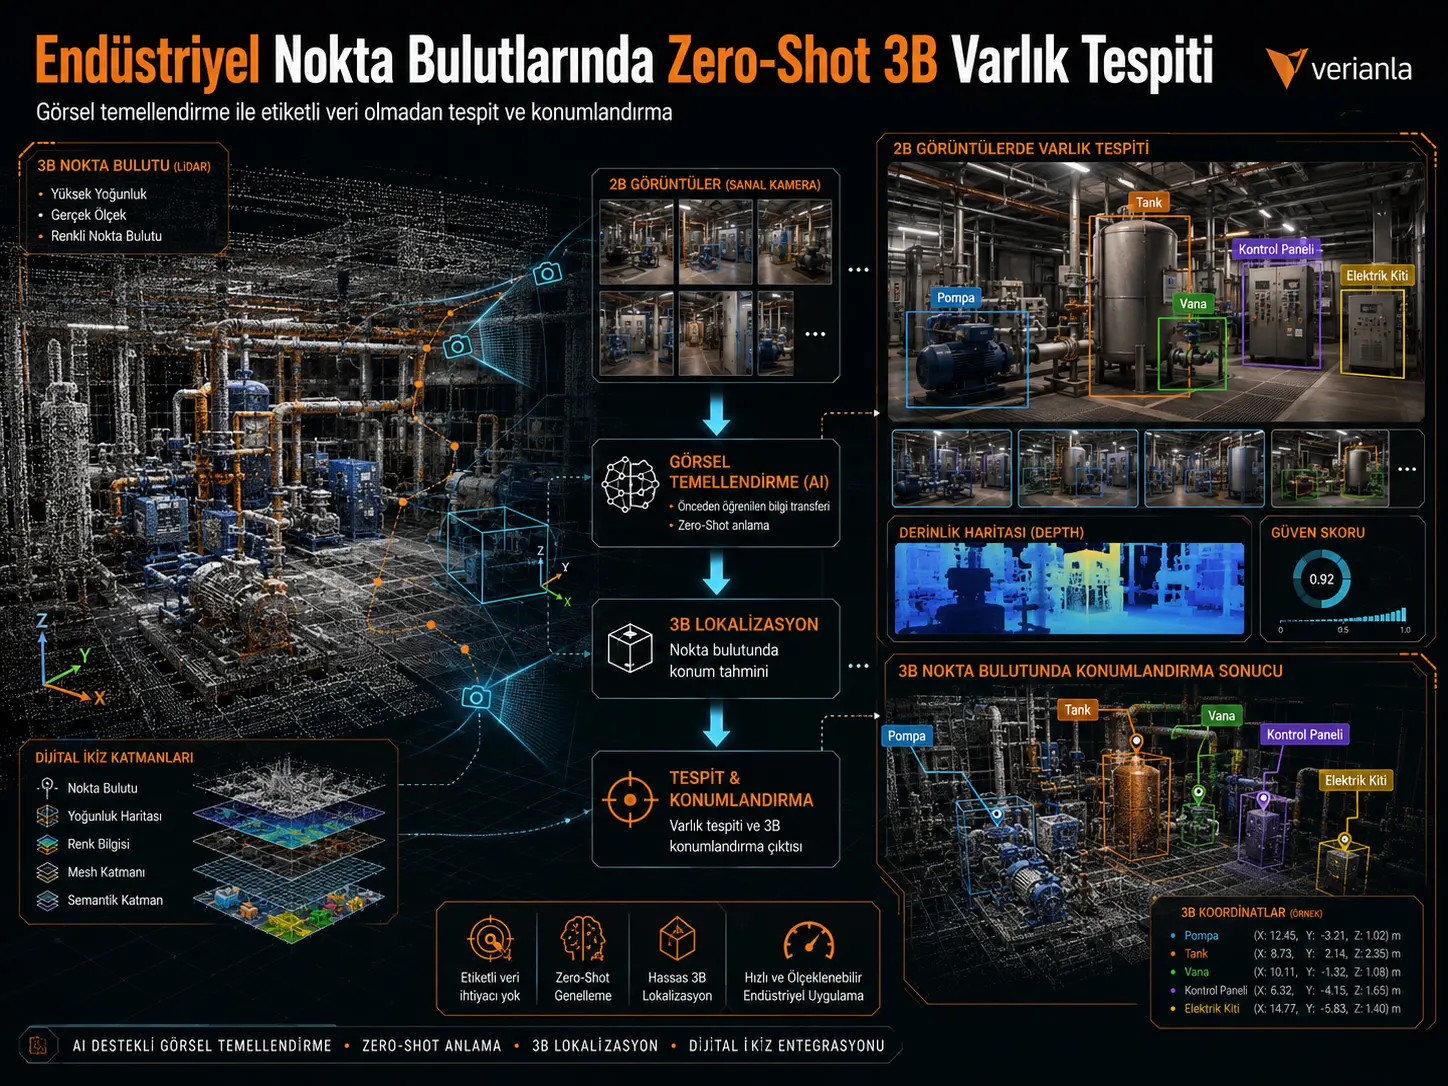
Utafiti huu unapendekeza mfumo wa zero-shot unaolenga kutambua vifaa na kubainisha takriban maeneo yake ya anga kutoka kwenye wingu moja tu la pointi za 3B katika mitambo iliyopo isiyo na modeli ya CAD iliyosasishwa au seti kubwa za data za mafunzo zenye lebo za mali za viwandani. Badala ya kuingiza wingu la pointi moja kwa moja katika kitambua vitu cha 3B, mfumo kwanza hutengeneza picha za eneo kwa kutumia kamera pepe katika viwango tofauti vya urefu na ukuzaji. Picha hufasiriwa kisemantiki kwa GPT-4o, maelezo ya vitu yanayotengenezwa hupelekwa kwa Grounding DINO, bounding box za 2B hutambuliwa, na matokeo hurudishwa katika mfumo wa kuratibu wa ndani wa 3B kwa kutumia depth na vigezo vya kamera. Pale ambapo maeneo ya kutazama yaliyowekwa hayatoshi, mfumo hutumia vigezo kama ukubwa wa kitu kwenye picha, kutoka nje ya fremu na kuingiliana na vitu vingine ili kuweka upya kamera na kutengeneza picha tena.
Katika data yenye pointi 271.348.287 iliyopatikana kwa skana ya leza Leica BLK360 kutoka plant room tata huko Melbourne, mbinu iliyopendekezwa iliongeza thamani ya AP25 kutoka 35,84 hadi 48,13 na thamani ya AP50 kutoka 26,89 hadi 34,98 ikilinganishwa na msingi wa OpenIns3D uliotathminiwa kwa miundombinu hiyo hiyo ya uwekaji msingi wa kuonekana. Hasa, darasa la gas/oil burner ambalo mfumo wa awali haukuweza kulitambua kabisa katika AP25 lilifikia 41,3 AP25 katika mfumo uliopendekezwa; ongezeko dhahiri pia liliripotiwa kwa electrical kit, control panel, fire extinguisher na baadhi ya madarasa mengine. Katika jedwali la ujanibishaji wa 3B, makosa binafsi ya eneo ya Euclidean kwa mali 11 yanatofautiana kati ya 0,105 na 0,312 mita. Hata hivyo, matokeo yalipatikana katika mazingira moja tu ya viwandani, na mbinu haikutathminiwa kama mfumo wa ujenzi upya wa kijiometria wa usahihi wa juu, bali kwa matukio ya matumizi ambapo taarifa ya takriban ya anga inatosha, kama orodha ya mali, safu ya awali ya digital twin, ufuatiliaji wa mbali na upangaji wa ukaguzi.
Kwa nini utambuzi wa mali za 3B katika mitambo ya viwandani ni mgumu?
Tatizo kuu si tu “kutafuta kitu katika wingu la pointi”. Katika mitambo ya viwandani, pampu, vali, matangi, paneli za umeme, mifumo ya duct, ngazi, burner na mitandao minene ya mabomba huwekwa katika ukubwa na urefu tofauti na mara nyingi kwa namna inayofunika vitu vingine. Wakati uso wa mbele wa kifaa unaonekana, upande mwingine unaweza kufunikwa na mabomba au ukuta; vali ndogo inaweza kupungua hadi saizi ya pikseli chache katika picha ya eneo yenye pembe pana.
Mbinu za kawaida za usimamizi wa utambuzi wa vitu vya 3B hujaribu kutatua tatizo hili kwa seti kubwa za data zenye lebo. Hata hivyo, kutokana na utofauti wa vifaa maalumu kwa kila mtambo wa viwandani, kutengeneza seti kama hizo za data ni ghali na huchukua muda. Wakati seti za data za kawaida za kuendesha magari kiotomatiki au mazingira ya ndani huwa na madarasa kama gari, mtembea kwa miguu, kiti na meza, mara nyingi hazina uwakilishi wa vifaa kama gas/oil burner au electrical kit maalumu katika plant room.
Kwa hiyo swali kuu la utafiti ni hili: je, inawezekana kutambua mali za viwandani kutoka kwenye wingu la pointi lililopo pekee na kuziweka tena katika nafasi ya 3B bila kufundisha modeli yenye lebo maalumu kwa mtambo huo?
“Zero-shot” hapa inamaanisha nini hasa?
Katika utafiti huu, zero-shot inamaanisha kuwa hakuna seti mpya ya data ya mafunzo yenye lebo maalumu kwa mtambo mpya wa viwandani iliyoandaliwa kwa mfumo uliopendekezwa. Foundation models zilizofundishwa awali kama GPT-4o na Grounding DINO hutumiwa.
Kwa hiyo, mfumo si kwamba “haujajifunza chochote”. Unatumia modeli zilizofundishwa awali kwa data kubwa; kilicho sifuri ni mchakato wa domain-specific supervised training uliotekelezwa kwa lengo la kutambua vifaa katika plant room hii.
Zaidi ya hayo, GPT-4o hutafuta vitu katika picha kutoka kwenye kamusi ya mali za viwandani iliyobainishwa mapema katika utafiti. Kwa hiyo uwezo wa zero-shot katika kiwango cha matumizi unapaswa kueleweka kama mchanganyiko wa madarasa ya viwandani yaliyobainishwa mapema na maarifa ya foundation model.
Kwa nini mbinu haijaainishi wingu la pointi moja kwa moja?
Mbinu ya watafiti ni kubadilisha wingu la pointi za 3B kuwa picha za eneo za 2B kutoka kamera pepe tofauti ili kutumia uwezo wa kuelewa picha wa modeli zenye nguvu za 2B vision–language.
Mantiki ya muundo huu ni kama ifuatavyo:
- Kamera pepe huwekwa katika wingu la pointi.
- Picha za eneo za 2B na depth map hutolewa kutoka kamera hizi.
- Foundation models hubainisha ni mali zipi za viwandani zilizopo kwenye picha.
- Utambuzi wa 2B huprojektiwa tena kwenye eneo la 3B kwa kutumia taarifa ya depth ya picha na vigezo vya kamera.
Kwa hiyo utafiti hauchagui kati ya “2B au 3B”; unaunganisha data ya kijiometria ya 3B na uelewa wa kuona wa 2B foundation-model katika pipeline moja.
Mfumo wa hatua tano unafanyaje kazi?
Mbinu kuu ya makala ina hatua tano kuu:
- Virtual Camera Positioning: Kuweka kamera pepe katika maeneo yanayofaa ya eneo la viwandani na katika urefu tofauti.
- Image Generation: Kutengeneza picha za eneo kutoka kwenye wingu la pointi katika mitazamo na viwango tofauti vya zoom.
- Visual Grounding: Utambuzi wa kisemantiki kwa GPT-4o na uzalishaji wa bounding box za 2B kwa Grounding DINO.
- Recognition-Aware Refinement: Kurekebisha kiotomatiki vigezo vya kamera kwa vitu vinavyoonekana vibaya na kurudia render ya picha.
- Asset Localisation: Kurudisha utambuzi wa 2B kwenye kuratibu za ndani za 3B kwa kutumia depth, intrinsics na extrinsics.
Sifa muhimu katika mpangilio wa mbinu ni kwamba hatua ya nne si mchakato wa upande mmoja. Ikiwa ubora wa utambuzi ni mdogo, kamera hupangwa upya na picha mpya hutengenezwa. Kwa njia hii, badala ya kitambua vitu kutegemea tu picha iliyopewa, mfumo hujaribu kutengeneza mtazamo mpya ambao kitu kitaonekana vizuri zaidi.
Kwa nini kamera pepe huwekwa katika urefu tofauti?
Mitazamo mipana na iliyowekwa ya OpenIns3D inaweza kutosha katika mazingira rahisi ya ndani; hata hivyo, katika plant room ya viwandani, mabomba mengi karibu na dari yanaweza kufunika vifaa vilivyo katika viwango vya chini. Vivyo hivyo, kifaa kirefu kinaweza kuonekana bila kukamilika ikiwa kinatazamwa kutoka kamera za chini pekee.
Kwa hiyo mbinu iliyopendekezwa haiweki kamera katika urefu mmoja tu. Kwa kuongeza kikomo cha juu cha urefu, mwonekano wa vifaa virefu huongezwa, na kwa kubadilisha kikomo cha chini, mwonekano wa vifaa vya kiwango cha sakafu kutoka pembe tofauti huongezwa.
Hata hivyo, utafiti haupimi mchango wa mkakati huu wa urefu unaobadilika kwa ablation experiment tofauti. Kwa hiyo hakuna namba katika chanzo ya aina “multi-height camera positioning peke yake iliongeza X AP”.
Kwa nini normal, medium na close-up zoom hutumiwa pamoja?
Katika eneo la viwandani, tanki na vali ndogo hazina kiwango sawa cha kimwili. Ukubwa mmoja tu wa zoom ukitumiwa, ama muktadha wa eneo lote hupotea au maelezo ya kuona ya vifaa vidogo hayatoshi.
Utafiti unashughulikia tatizo hili kwa mfumo wa zoom wa viwango vitatu:
- normal,
- medium,
- close-up
. Kwa hiyo muktadha wa mazingira ya eneo hilo na maelezo ya vifaa vidogo vinaweza kuonyeshwa kwa foundation model.
Kuondoa ukuta kunamaanisha nini?
Hapa hakuna kufuta ukuta halisi wa mtambo. Wakati wingu la pointi linaporenderiwa, kuta za mipaka ya nje huondolewa kwenye uzalishaji wa picha kwa kutumia threshold fulani. Lengo ni kuruhusu kamera pepe kuona mali zilizo nyuma au karibu na ukuta wa nje.
Ulinganisho wa kabla/baada ya kuondoa ukuta katika makala unaonyesha kuwa vifaa kama pump na tank vilivyofunikwa na ukuta vinaweza kuwa vinavyoonekana zaidi katika picha pepe.
Inaamuliwaje ni picha ipi ya eneo ni “nzuri”?
Picha za awali zilizorenderiwa hazichukuliwi kuwa sawa. Vipimo viwili huhesabiwa kwa kila picha:
- Edge density: Uwiano wa pikseli za kingo kwenye picha baada ya Canny edge detection.
- Texture variance: Tofauti ya viwango vya ukali wa pikseli za kijivu.
Katika chanzo, alama ya picha imefafanuliwa kama:
\[ score_i= 0.6\times\text{edge density} + 0.4\times\text{texture variance} \]
.
Vigezo vya intrinsic vya kamera vya picha yenye alama ya juu zaidi hutumiwa tena katika uzalishaji wa mitazamo inayofuata. Wazo hapa ni kuchagua mpangilio wa picha ulio tajiri zaidi kwa taarifa ya kijiometria na texture.
Depth-based filtering inafanya nini?
Hata ikiwa picha imetengenezwa kwa kuonekana, sehemu kubwa inaweza kuwa tupu, occluded au kutokuwa na taarifa halali ya uso wa 3B. Kwa hiyo depth map ya kila render hutathminiwa.
Uwiano wa mwonekano:
\[ V= \frac{|D_{\mathrm{valid}}|}{|D|} \]
hufafanuliwa. \(D_{\mathrm{valid}}\) huwakilisha pikseli zenye thamani halali ya depth; \(D\) huwakilisha pikseli zote za picha.
Ni picha tu zinazotimiza:
\[ V\geq\sigma \]
ndizo huhifadhiwa.
Katika mifano ya mwonekano mdogo na mkubwa ya utafiti, depth map za mitazamo ya ubora wa chini zinaonyesha maeneo madogo na yaliyokatika ya rangi, wakati katika mwonekano mkubwa ramani ya depth ni nzito na endelevu zaidi. Uchujo huu unalenga kupunguza athari ya jiometri isiyokamilika kwenye uprojectishaji wa nyuma wa 3B unaofuata.
Kwa nini GPT-4o na Grounding DINO hutumiwa pamoja?
Majukumu ya modeli hizi mbili katika pipeline ni tofauti.
GPT-4o huchanganua kisemantiki picha ya eneo iliyorenderiwa na kubainisha vitu vinavyoonekana kutoka kwenye kamusi ya mali za viwandani iliyobainishwa mapema katika utafiti. Kwa kila mfano, huzalisha:
- kategoria ya mali,
- idadi ya mifano,
- eneo la jumla kwenye picha,
- ukubwa wa kulinganisha,
- maelezo ya mwonekano na muktadha
.
Katika hatua hii bado hakuna bounding box sahihi.
Grounding DINO hubadilisha maelezo ya lugha ya kawaida yaliyotengenezwa na GPT-4o kuwa visual grounding prompt na kutoa axis-aligned 2B bounding box kwa kitu husika.
Wakati kuna vitu vingi vya darasa moja, taarifa ya eneo na ukubwa huongezwa kwenye prompt ili kutofautisha mifano hiyo.
Kwa nini Grounding DINO peke yake haikuchukuliwa kuwa ya kutosha?
Katika ulinganisho wa ubora wa utafiti, ODISE na YOLO-World zilikosa sehemu kubwa ya mali tata za viwandani. Ingawa Grounding DINO ilitoa ujanibishaji bora, ilibaki na mipaka ilipotumiwa pekee katika baadhi ya madarasa maalumu ya vifaa.
Katika Kielelezo 2, hasa gas oil burner na control panel katika mfano wa tatu zilitambuliwa na mchanganyiko wa GPT-4o + Grounding DINO, wakati modeli nyingine zilizolinganishwa zilizikosa. Kutambuliwa tena kwa darasa la Pump katika mitazamo tofauti pia ni mfano mmoja wa jinsi mchanganyiko uliopendekezwa ulivyoweza kutumia muktadha wa eneo.
Kwa nini Recognition-aware viewpoint refinement ni muhimu?
Hata kutengeneza kamera nyingi na viwango vingi vya zoom hakuhakikishi kwamba kila kitu kitaonekana vizuri. Kitu kinaweza:
- kubaki kidogo sana kwenye picha,
- kukatwa kwenye ukingo,
- kufunikwa na vitu vingine,
- kuonekana kutoka pembe isiyofaa.
Tofauti ya utafiti ni kwamba hushughulikia kushindwa huku kwa kupima na kurudisha taarifa hiyo kwa kamera.
Ukubwa wa kitu kwenye picha hupimwaje?
Katika chanzo, usemi ufuatao umechapishwa kwa projected area ratio:
\[ A_i= \frac{ (x_2-x_1)-(y_2-y_1) }{ W\cdot H }. \]
\((x_1,y_1,x_2,y_2)\) huwakilisha kuratibu za bounding box, na \(W,H\) huwakilisha upana na urefu wa picha.
Dokezo la uaminifu kwa chanzo: Ingawa makala inaita hii “projected area ratio”, imechapisha alama ya kutoa kati ya upana na urefu badala ya kuzidisha. Maandishi ya Verianla hayabadilishi kimya kimya fomula hii kuwa fomula ya kawaida ya eneo la mstatili; uandishi wa chanzo umehifadhiwa kama ulivyo.
Kuondoka kwa kitu nje ya fremu hudhibitiwaje?
Truncation indicator:
\[ T_i= \begin{cases} 1, & x_1\leq\delta \ \text{veya}\ y_1\leq\delta \ \text{veya}\ x_2\geq W-\delta \ \text{veya}\ y_2\geq H-\delta,\\ 0, & \text{aksi durumda} \end{cases} \]
hufafanuliwa.
Ikiwa bounding box ya kitu inakaribia kingo za picha zaidi ya margin iliyowekwa ya \(\delta\), mtazamo huwekwa alama kama “truncated”.
Alama ya view suitability huhesabiwaje?
Kiwango cha kitu na truncation kwa pamoja hubadilishwa kuwa:
\[ J_{\mathrm{view},i} = \beta\ln(1+A_i)-\gamma T_i \]
.
Kitu kikubwa na kinachotoshea kikamilifu ndani ya picha hutoa alama ya juu ya ufaafu, wakati kitu kinachotoka nje ya fremu huadhibiwa.
Bounding box zinazoingiliana katika maeneo yenye msongamano huhesabiwaje?
Thamani za IoU za jozi za bounding box katika mtazamo mmoja huhesabiwa kwa threshold fulani ya:
\[ \tau_{\mathrm{IoU}} \]
, na clutter score \(C_v\) hupatikana kutokana na uwiano wa jozi zinazopita threshold hiyo.
\(C_v\) kubwa inaonyesha kuwa vitu vingi vinaingiliana kwenye picha na kwamba mtazamo unaweza usifae kwa grounding.
Ni lini urekebishaji wa kamera huanzishwa?
Kulingana na chanzo:
- \(A_i<\tau_A\): kitu ni kidogo sana → zoom-in au punguza umbali wa kamera.
- \(T_i=1\): kitu kinatoka nje ya fremu → panua field of view au sogeza kamera.
- \(J_{\mathrm{view},i}<\tau_J\): pembe ya kutazama haitoshi → badilisha yaw/pitch.
- \(C_v>\tau_C\): eneo lina msongamano mkubwa → badilisha urefu au mwelekeo wa kamera.
Kipaumbele pia hubainishwa kwa:
\[ S_i= w_1\max(0,\tau_A-A_i) + w_2\max(0,\tau_J-J_{\mathrm{view},i}) + w_3T_i \]
severity score.
Field of view na pozi ya kamera hubadilishwaje?
Katika chanzo, sasisho la urefu wa focal limechapishwa kama:
\[ f'_x= f_z \left( 1-\frac{\Delta FOV}{100} \right), \qquad f'_y= f_y \left( 1-\frac{\Delta FOV}{100} \right) \]
.
Hata hivyo, mara baada ya hapo maandishi yanafafanua focal length za awali kama:
\[ f_x,\;f_y \]
na hayafafanui \(f_z\). Kwa hiyo mlinganyo wa \(f'_x\) unaotumia \(f_z\) unaweza kuwa na kutokulingana kwa notation ndani ya chanzo au kosa la uchapaji. Hakuna marekebisho ambayo hayapo katika chanzo yaliyofanywa.
Mwelekeo wa kamera hubadilishwa kwa:
\[ P'= P\cdot R_{\mathrm{yaw}}(\theta) \cdot R_{\mathrm{pitch}}(\phi) \]
, huku mwendo wa radial wa kamera ukipewa kama:
\[ p'_{\mathrm{cam}} = p_{\mathrm{scene}} + (1+\Delta r) \frac{ p_{\mathrm{cam}}-p_{\mathrm{scene}} }{ \|p_{\mathrm{cam}}-p_{\mathrm{scene}}\| } \]
.
Bounding box ya 2B hurudishwaje kuwa eneo la 3B?
Visual grounding hupata kitu kwenye picha; hata hivyo, kwa digital twin ni lazima kujua kitu kiko wapi katika kuratibu za kiwanda.
Ikiwa pikseli ya picha:
\[ (u,v) \]
na depth inayolingana:
\[ d \]
zinajulikana, kuratibu ya kamera huhesabiwa kwa:
\[ P_C= K^{-1} [u,v,1]^T d \]
.
Kisha kwa kutumia vigezo vya extrinsic vya kamera:
\[ P_L= R P_C+t \]
hubadilishwa.
Hapa \(P_L\) ni eneo la 3B la kitu ndani ya local plant coordinate system.
Je, mbinu hii inachukua nafasi ya modeli ya 3B CAD kikamilifu?
Hapana. Sehemu ya majadiliano ya utafiti inaweka kikomo hiki wazi. Mbinu iliyopendekezwa haikuundwa kwa lengo la high-precision geometric reconstruction.
Mifano ya matumizi yaliyolengwa ni:
- kutengeneza asset inventory,
- kutengeneza safu ya msingi ya anga kwa kuanzisha brownfield digital twin,
- inspection planning,
- remote monitoring,
- kubainisha uhusiano wa takriban wa anga kati ya mali
.
Kwa hiyo, kutafsiri kuratibu zilizopatikana kama tolerance ya uzalishaji au kipimo sahihi cha reverse engineering hakuungwi mkono na chanzo.
Hii ina maana gani kwa Uturuki?
Kwa kuwa mbinu inalenga hasa brownfield facilities ambazo hazina modeli ya BIM/CAD iliyosasishwa, inaweza kuwa njia yenye thamani ya kufanyiwa utafiti kwa mitambo ya uzalishaji iliyotumika kwa muda mrefu, vituo vya nishati au vyumba tata vya mitambo nchini Uturuki. Hata hivyo, utafiti ulifanyika kwenye plant room moja tu huko Melbourne.
Haiwezi kusemwa kuwa AP au thamani zilezile za kosa la eneo zitapatikana katika mtambo wa Uturuki. Katika uthibitishaji wa eneo husika, msongamano wa wingu la pointi, ubora wa skanning, madarasa ya mali ya mtambo, msongamano wa mabomba, ukubwa wa vipengele vidogo na kama foundation model inatambua istilahi husika za vifaa vinapaswa kupimwa kando.
Matokeo yanayoungwa mkono na utafiti
- Katika mazingira haya ya majaribio, unaonyesha kuwa utambuzi wa mali za 3B na ujanibishaji wa takriban unaweza kufanywa kutoka kwenye wingu moja la pointi za viwandani bila kuandaa seti ya data ya mafunzo yenye lebo maalumu kwa mtambo.
- Pipeline kamili iliyopendekezwa ilitoa AP25 na AP50 za juu kuliko msingi wa OpenIns3D katika ulinganisho huo huo.
- Kuongezwa kwa hatua za kuondoa ukuta, multiple zoom na recognition-aware refinement kwa namna ya jumla kuliongeza utendaji hatua kwa hatua.
- Mchanganyiko wa GPT-4o + Grounding DINO ulionyesha utambuzi bora wa ubora katika picha za viwandani zilizochunguzwa kuliko chaguo nyingine za visual grounding zilizojaribiwa.
- Kuongezwa kwa recognition-aware refinement kulisababisha ongezeko kubwa zaidi la mwisho la AP katika Jedwali 2.
- Kwa mali 11, uprojectishaji wa nyuma kwenye mfumo wa kuratibu wa ndani ulitoa makosa binafsi ya ujanibishaji wa 3B kati ya 0,105–0,312 m.
- Katika uchanganuzi wa unyeti wa vigezo wa ±%10, perturbation zote zilizotumiwa zilipunguza AP25; hasa threshold ya \(\tau_J\) ilionyesha unyeti mkubwa zaidi.
Matokeo ambayo utafiti hauungi mkono au haukuyapima
- Haijajaribiwa kwamba mfumo utaonyesha utendaji huo huo katika mitambo yote ya viwandani.
- Hakuna cross-site generalisation experiment iliyofanywa katika nchi tofauti, sekta za viwanda tofauti au mifumo tofauti ya skana.
- Hakuna ujenzi upya wa kijiometria wa ubora wa juu wa CAD/reverse-engineering ulioonyeshwa.
- Matokeo ya “zero-shot” hayakupatikana bila foundation models; hakuna supervised training mpya maalumu kwa mtambo iliyofanywa.
- Haijaonyeshwa kwamba kategoria yoyote isiyojulikana kabisa ya mali inaweza kugunduliwa bila kikomo; hatua ya GPT-4o hutumia kamusi ya mali za viwandani iliyobainishwa mapema.
- Hakuna majaribio yaliyokaririwa, confidence interval au hypothesis test iliyoripotiwa kwa umuhimu wa kitakwimu wa tofauti za AP.
- Athari ya Variable-height camera positioning haikupimwa katika mstari huru wa ablation tofauti na maboresho mengine.
- Athari ya Point-cloud downsampling haikujaribiwa kwa kiasi.
- Athari ya tofauti za prompt kwenye utendaji haikupimwa kwa robustness experiment ya kimfumo.
Mbinu na Matokeo ya Utafiti
Mazingira ya majaribio
Tathmini ilifanywa kwenye plant room tata iliyopo ndani ya jengo huko Melbourne.
| Kipengele cha majaribio | Taarifa iliyotolewa katika chanzo |
|---|---|
| Skana ya 3B | Leica BLK360 |
| Jumla ya pointi | 271.348.287 |
| Uchakataji wa wingu la pointi | CloudCompare v2.13.2 |
| GPU | 2 × NVIDIA L40, kila moja 48 GB VRAM |
| Rasilimali ya CPU | 16 vCPU |
| Kumbukumbu ya mfumo | 241 GB |
| Mfumo wa uendeshaji | Ubuntu 20.04 |
| Foundation model | GPT-4o, gpt-4o-2024-11-20 |
| 2B grounding | Grounding DINO |
Matokeo ya mfumo kamili dhidi ya OpenIns3D
| Mali | OpenIns3D AP25 | AP25 iliyopendekezwa | OpenIns3D AP50 | AP50 iliyopendekezwa |
|---|---|---|---|---|
| Wastani | 35,84 | 48,13 | 26,89 | 34,98 |
| Cabinet | 44,6 | 58,3 | 40,2 | 42,8 |
| Control Panel | 52,3 | 65,4 | 43,3 | 49,2 |
| Electrical Kit | 18,3 | 35,1 | 7,8 | 20,3 |
| Gas/Oil Burner | 0 | 41,3 | 0 | 24,4 |
| Ladder | 74,3 | 76,1 | 50,9 | 51,2 |
| Pump | 16,1 | 21,3 | 6,4 | 15,9 |
| Tank | 78,8 | 80,4 | 68,1 | 69,8 |
| Valve | 33,4 | 36,4 | 27,6 | 29,1 |
| Duct | 7,3 | 10,7 | 0 | 6,2 |
| Fire Extinguisher | 33,3 | 56,3 | 24,6 | 40,9 |
Tofauti kubwa zaidi inaonekana katika darasa la gas/oil burner. Msingi wa OpenIns3D ulitoa 0 katika AP25 na AP50, wakati framework iliyopendekezwa ilifikia 41,3 na 24,4 mtawalia.
Kwa electrical kit, AP25 iliongezeka kutoka 18,3 hadi 35,1 na AP50 kutoka 7,8 hadi 20,3; kwa fire extinguisher, AP25 iliongezeka kutoka 33,3 hadi 56,3 na AP50 kutoka 24,6 hadi 40,9.
Hata hivyo, ongezeko la ukubwa sawa halionekani katika kila darasa. Kwa mfano, tank na ladder tayari yalikuwa madarasa yenye nguvu katika mbinu ya awali na ongezeko lake ni dogo zaidi. Hali hii inaonyesha kuwa faida kuu ya mfumo inaweza kujitokeza hasa kwa mali tata, ndogo, zilizofichwa au ambazo ni ngumu zaidi kwa foundation model; hata hivyo, tafsiri hii inahusu eneo hili la majaribio pekee.
Athari ya maboresho ya hatua kwa hatua
Kuondoa ukuta kuliongeza AP25 ya awali kutoka 35,84 hadi 38,22, wakati AP50 iliongezeka tu kutoka 26,89 hadi 27,10.
Multiple zoom ilipoongezwa, AP25 ilikuwa 42,63 na AP50 28,82.
Kwa hatua ya mwisho ya recognition-aware refinement, AP25:
\[ 42{,}63\rightarrow48{,}13 \]
na AP50:
\[ 28{,}82\rightarrow34{,}98 \]
zilifikia viwango hivyo.
Jedwali 2 linatoa tofauti ya jumla kutoka mwanzo hadi mwisho kama 12,29 kwa AP25 na 8,09 kwa AP50. Hizi ni tofauti za kihesabu kati ya thamani za mwanzo na mwisho za AP.
Vigezo vya recognition-aware refinement vina unyeti kiasi gani?
Seti ya msingi ya vigezo katika chanzo ni:
| Kigezo | Thamani chaguomsingi |
|---|---|
| \(\delta\) | 10 px |
| \(\beta\) | 1,0 |
| \(\gamma\) | 0,3 |
| \(\tau_A\) | 0,01 |
| \(\tau_J\) | 0,1 |
| \(\tau_{\mathrm{IoU}}\) | 0,3 |
| \(\tau_C\) | 0,15 |
Kila kigezo kilipobadilishwa kivyake kwa ±%10, tofauti za AP25 zilizoripotiwa zilikuwa:
| Kigezo | ΔAP25 kwa −%10 | ΔAP25 kwa +%10 |
|---|---|---|
| Image boundary margin \(\delta\) | −0,09 | −0,11 |
| Area contribution weight \(\beta\) | −0,10 | −0,14 |
| Truncation penalty \(\gamma\) | −0,09 | −0,12 |
| Minimum projected area \(\tau_A\) | −0,10 | −0,11 |
| View suitability threshold \(\tau_J\) | −0,65 | −0,55 |
| IoU overlap threshold \(\tau_{\mathrm{IoU}}\) | −0,06 | −0,08 |
| View clutter threshold \(\tau_C\) | −0,05 | −0,06 |
Ukweli kwamba perturbation zote ni hasi unaonyesha kuwa usanidi wa msingi uliochaguliwa na waandishi ulikuwa sehemu bora zaidi iliyojaribiwa katika eneo hilo la karibu. Unyeti mkubwa zaidi unaonekana kwa:
\[ \tau_J \]
view suitability threshold. Kwa upande mwingine, mabadiliko ya \(\tau_{\mathrm{IoU}}\) na \(\tau_C\), yanayobainisha clutter model, yalionyesha athari ndogo zaidi.
Makosa ya ujanibishaji wa 3B yako katika kiwango gani?
Utafiti unaripoti mmoja mmoja umbali wa 3B wa Euclidean kati ya kuratibu ya ground-truth na eneo lililotambuliwa kwa mali 11 zilizowekwa:
| ID ya mali | Kosa kamili la ujanibishaji wa 3B (m) |
|---|---|
| 1 | 0,180 |
| 2 | 0,121 |
| 3 | 0,122 |
| 4 | 0,202 |
| 5 | 0,162 |
| 6 | 0,227 |
| 7 | 0,312 |
| 8 | 0,135 |
| 9 | 0,114 |
| 10 | 0,105 |
| 11 | 0,174 |
Kosa la chini zaidi lililoripotiwa ni 0,105 m na la juu zaidi ni 0,312 m. Chanzo hakiripoti metrika tofauti ya wastani wa kosa la ujanibishaji kwa jedwali hili; kinaonyesha matokeo kwa kila mali binafsi.
Waandishi wanaona kiwango hiki cha usahihi kuwa cha kutosha si kwa reverse engineering ya kijiometria yenye usahihi mkubwa, bali kwa matumizi makubwa ya uendeshaji na matengenezo ambapo uwepo wa mali, ukubwa wake wa takriban wa kijiometria na uhusiano wa anga vinahitaji kubainishwa.
Kwa nini msongamano wa point cloud bado ni muhimu?
Matumizi ya zero-shot foundation model hayafanyi ubora wa jiometri ya kuingiza kutokuwa muhimu. Chanzo kinaeleza kuwa point-cloud fidelity inaweza kuathiri moja kwa moja utendaji wa utambuzi.
Kuna uchunguzi wa ubora kwamba moderate down-sampling inaweza kupunguza gharama ya hesabu, lakini point reduction kubwa sana inaweza kuondoa jiometri nyembamba ya vitu vidogo kama valve na duct.
Hata hivyo, utafiti hautoi jaribio la kiasi kati ya uwiano wa down-sampling na AP au kosa la ujanibishaji.
Gharama ya hesabu ni muhimu kiasi gani?
Kutengeneza idadi kubwa ya picha pepe zenye ubora wa juu kutoka kwenye maeneo makubwa yenye pointi zaidi ya milioni 271 ni ghali kihesabu. Watafiti wanapendekeza kugawanya point cloud kubwa katika maeneo madogo ili kupunguza mzigo.
Hili pia lina gharama yake: muktadha wa kijiometria na taarifa ya anga katika mipaka ya mgawanyiko vinaweza kupotea. Kwa hiyo scalability si kuongeza GPU pekee; pia inahitaji kutatua namna ya kugawa eneo.
Kwa nini prompt engineering ni kikwazo?
Uchaguzi wa maneno, kiwango cha maelezo na namna ya uandishi katika prompt inayotumwa kwa GPT-4o na Grounding DINO inaweza kubadilisha matokeo. Chanzo kinataja prompt engineering waziwazi kama kikwazo.
Moja ya mapendekezo ya kazi ya baadaye ni kutumia retrieval-augmented generation kuchukua maarifa ya mali kutoka knowledge base ya nje na kuimarisha prompt kiotomatiki kulingana na muktadha.
Mwelekeo wa utafiti wa baadaye
Makala inaangazia maeneo matatu makuu:
- Spatial zoning: Kugawa mawingu makubwa ya pointi za viwandani katika maeneo ya anga yenye maana kwa kutumia modeli za data za IFC na knowledge graph.
- Adaptive image rendering: Kutumia rendering ya ubora wa juu kwa mali ndogo kama valve/flange na rendering yenye gharama ndogo zaidi kwa mali kubwa.
- RAG-supported prompt engineering: Kuingiza maarifa ya mali za viwandani kwa njia ya retrieval moja kwa moja katika prompt.
Vikwazo muhimu zaidi vya kimetodolojia
- Tathmini ilifanywa katika plant room moja tu ya viwandani.
- Uhamishikaji wa utofauti wa mali na mazingira kwenda mitambo tofauti haujaonyeshwa kwa majaribio.
- Hali tofauti za eneo kama vumbi, unyevu, mwangaza, sensor noise na occlusion zinaweza kubadilisha ubora wa point-cloud.
- Rendering ya point cloud kubwa ina gharama kubwa ya hesabu.
- Segmentation ya point-cloud inaweza kusababisha kupotea kwa taarifa katika mipaka ya maeneo.
- Utambuzi wa vifaa vidogo na maalumu vya viwandani bado ni mgumu.
- Prompt engineering ina athari muhimu kwenye matokeo.
- Athari ya down-sampling haijapimwa kwa kiasi.
- Hakuna uchanganuzi wa uncertainty au umuhimu wa kitakwimu kwa tofauti za AP uliotolewa.
Maelezo ya Chanzo na Mbinu
Jina kamili la utafiti asili: Zero-Shot 3D Asset Detection and Localisation Through Visual Grounding in Industrial Point Clouds
Waandishi: Masoud Kamali; Behnam Atazadeh; Abbas Rajabifard; Yiqun Chen.
Mwandishi wa kwanza sawa/mchango sawa: Hakuna tamko la mwandishi wa kwanza sawa au mchango sawa katika chanzo.
Mwandishi anayewajibika: Behnam Atazadeh.
Taasisi: The Centre for Spatial Data Infrastructures and Land Administration, Department of Infrastructure Engineering, The University of Melbourne, Melbourne, Victoria, Australia.
Aina ya chanzo: Makala asili ya utafiti iliyopitiwa na rika; utafiti wa computer vision, uelewa wa eneo la 3B na ujanibishaji wa mali za viwandani.
Jarida: AI.
Mchapishaji: MDPI, Basel, Uswisi.
Kumbukumbu ya bibliografia: AI, 2026, Juzuu 7, Toleo 6, Makala 205.
DOI: 10.3390/ai7060205.
Imepokelewa / marekebisho / imekubaliwa / imechapishwa: 2 Machi 2026 / 18 Mei 2026 / 26 Mei 2026 / 5 Juni 2026.
Hali ya mapitio: Ni chapisho la jarida lililopitiwa na rika.
Leseni: Creative Commons Attribution (CC BY).
Academic Editors: Miguel Angel Cazorla; Emanuele Frontoni.
Tatizo kuu la utafiti: Utambuzi wa zero-shot wa mali na ujanibishaji wa takriban wa 3B kutoka point cloud pekee katika mazingira tata ya viwandani yasiyo na seti ya data ya mafunzo yenye lebo au modeli ya CAD iliyosasishwa.
Data ya kuingiza: Point cloud ya viwandani yenye pointi 271.348.287 iliyopatikana kwa Leica BLK360.
Mbinu kuu: Virtual camera positioning → image generation → GPT-4o semantic interpretation → Grounding DINO visual grounding → recognition-aware camera refinement → 3B asset localisation inayotegemea depth/intrinsic/extrinsic.
Foundation model: GPT-4o, iliyotajwa katika chanzo kwa lebo ya toleo `gpt-4o-2024-11-20`.
Modeli ya visual grounding: Grounding DINO.
Baseline: OpenIns3D; katika ulinganisho uliodhibitiwa, usanidi wa GPT-4o + Grounding DINO visual grounding ulitumiwa kwa uthabiti katika baseline na mbinu iliyopendekezwa.
Matokeo makuu ya detection: Wastani wa AP25 uliongezeka kutoka 35,84 hadi 48,13 na AP50 kutoka 26,89 hadi 34,98.
Matokeo ya incremental: OpenIns3D → wall removal → multiple zoom + wall removal → recognition-aware refinement kwa mpangilio wa AP25 35,84 → 38,22 → 42,63 → 48,13 na AP50 26,89 → 27,10 → 28,82 → 34,98.
Tathmini ya ujanibishaji: Makosa ya eneo ya Euclidean ya 3B ya mali 11 dhidi ya ground-truth yalitolewa mmoja mmoja na yalikuwa katika masafa ya 0,105–0,312 m.
Unyeti wa vigezo: Vigezo vya recognition-aware refinement vilibadilishwa kwa ±%10; perturbation zote zilisababisha kupungua kwa AP25 na kigezo nyeti zaidi kilikuwa \(\tau_J\) view suitability threshold.
Vifaa: 2 × NVIDIA L40 48 GB VRAM; 16 vCPU; 241 GB RAM.
Mfumo wa uendeshaji: Ubuntu 20.04.
Programu ya point-cloud: CloudCompare v2.13.2.
Ufadhili: Australian Research Council, ruzuku namba IH210100048 na DE220100094.
Upatikanaji wa data: Imeripotiwa kuwa data zilizotumiwa katika utafiti zinaweza kupatikana kutoka kwa mwandishi anayewajibika kwa ombi lenye sababu, kutokana na mradi mpana na unaoendelea wa utafiti/maendeleo.
Kamati ya maadili: Haitumiki.
Ridhaa iliyoarifiwa: Haitumiki.
Mgongano wa maslahi: Waandishi wametangaza kuwa hakuna mgongano wa maslahi.
Shukrani: Mbali na msaada wa University of Melbourne Research Computing Services na Petascale Campus Initiative, msaada wa washirika wa sekta Emerson na Rockfield umetajwa; waandishi pia wanasema kwamba maoni katika makala ni yao wenyewe.
Michango ya waandishi: Uundaji wa dhana M.K. na B.A.; metodolojia M.K., B.A. na Y.C.; programu M.K.; uthibitishaji M.K. na B.A.; uchanganuzi rasmi M.K.; utafiti M.K., B.A. na Y.C.; rasilimali M.K., B.A. na Y.C.; usimamizi wa data M.K.; rasimu ya kwanza M.K.; mapitio na uhariri waandishi wote; uonyeshaji M.K.; usimamizi B.A., A.R. na Y.C.; usimamizi wa mradi A.R. na Y.C.; upatikanaji wa ufadhili B.A. na A.R.
Maelezo ya fomula na uripoti ndani ya chanzo
Fomula ya projected-area katika sehemu ya recognition-aware refinement imeandikwa katika chanzo kama:
\[ A_i= \frac{(x_2-x_1)-(y_2-y_1)}{W H} \]
. Kuna uwezekano wa kutokulingana kati ya maelezo ya “uwiano wa eneo” na usemi wa kihisabati; katika maandishi ya Verianla haijabadilishwa kimya kimya kuwa fomula ya kawaida ya eneo la bounding-box.
Vivyo hivyo, katika sasisho la field-of-view, kwa \(f'_x\) imetumiwa \(f_z\), lakini maelezo yanafafanua \(f_x,f_y\) kama focal length za mwanzo. Chanzo hakifafanui \(f_z\) katika muktadha huu.
Jedwali 2 linaonyesha tofauti ya AP25 kati ya mbinu ya mwanzo na ya mwisho kuwa 12,29. Kauli “%12,29” katika sehemu ya matokeo inaandika tofauti hii ya kihesabu ya AP kwa alama ya asilimia. Kwa hiyo hapa “pointi 12,29 za AP” na “uboreshaji wa jamaa wa %12,29” hazijatumika kama kitu kimoja.
Licha ya kauli “significantly outperforming” katika muhtasari wa chanzo, hakuna kutokuwa na uhakika kwa tathmini inayorudiwa, confidence interval au formal statistical significance test iliyoripotiwa kwa ulinganisho. Maelezo ya Verianla yanatoa tofauti ya utendaji kwa thamani zake za namba; hayaongezi hitimisho la umuhimu wa kitakwimu.
Mpaka wa tafsiri ya kisayansi
Mafanikio makuu ya utafiti huu ni kuunganisha data ya point cloud kutoka plant room moja tata na foundation models pamoja na uzalishaji wa kamera pepe unaobadilika ili kuonyesha utambuzi bora na ujanibishaji wa takriban wa 3B unaoweza kutumika bila kuhitaji domain-specific training yenye lebo.
Hata hivyo, matokeo yanategemea uthibitishaji wa mtambo mmoja. Jiometri ya mali za viwandani, kelele ya sensa, msongamano wa skanning, muundo wa occlusion na uwezo wa foundation model kutambua istilahi za mali zitatofautiana katika mazingira mengine.
Kwa hiyo thamani za AP25 48,13 na AP50 34,98 hazipaswi kusomwa kama “asilimia ya jumla ya mafanikio katika mitambo ya viwandani”, bali kama utendaji wa modeli unaohusiana na eneo la majaribio, madarasa ya mali, point cloud na itifaki ya tathmini iliyobainishwa katika utafiti huu.
Vivyo hivyo, makosa ya ujanibishaji ya 0,105–0,312 m si dhamana ya usahihi wa juu wa survey/CAD. Chanzo kinaweka wazi mbinu hii kwa matumizi kama asset inventory, digital-twin initialisation na inspection planning ambapo eneo la takriban la anga lina thamani ya kiutendaji.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *