

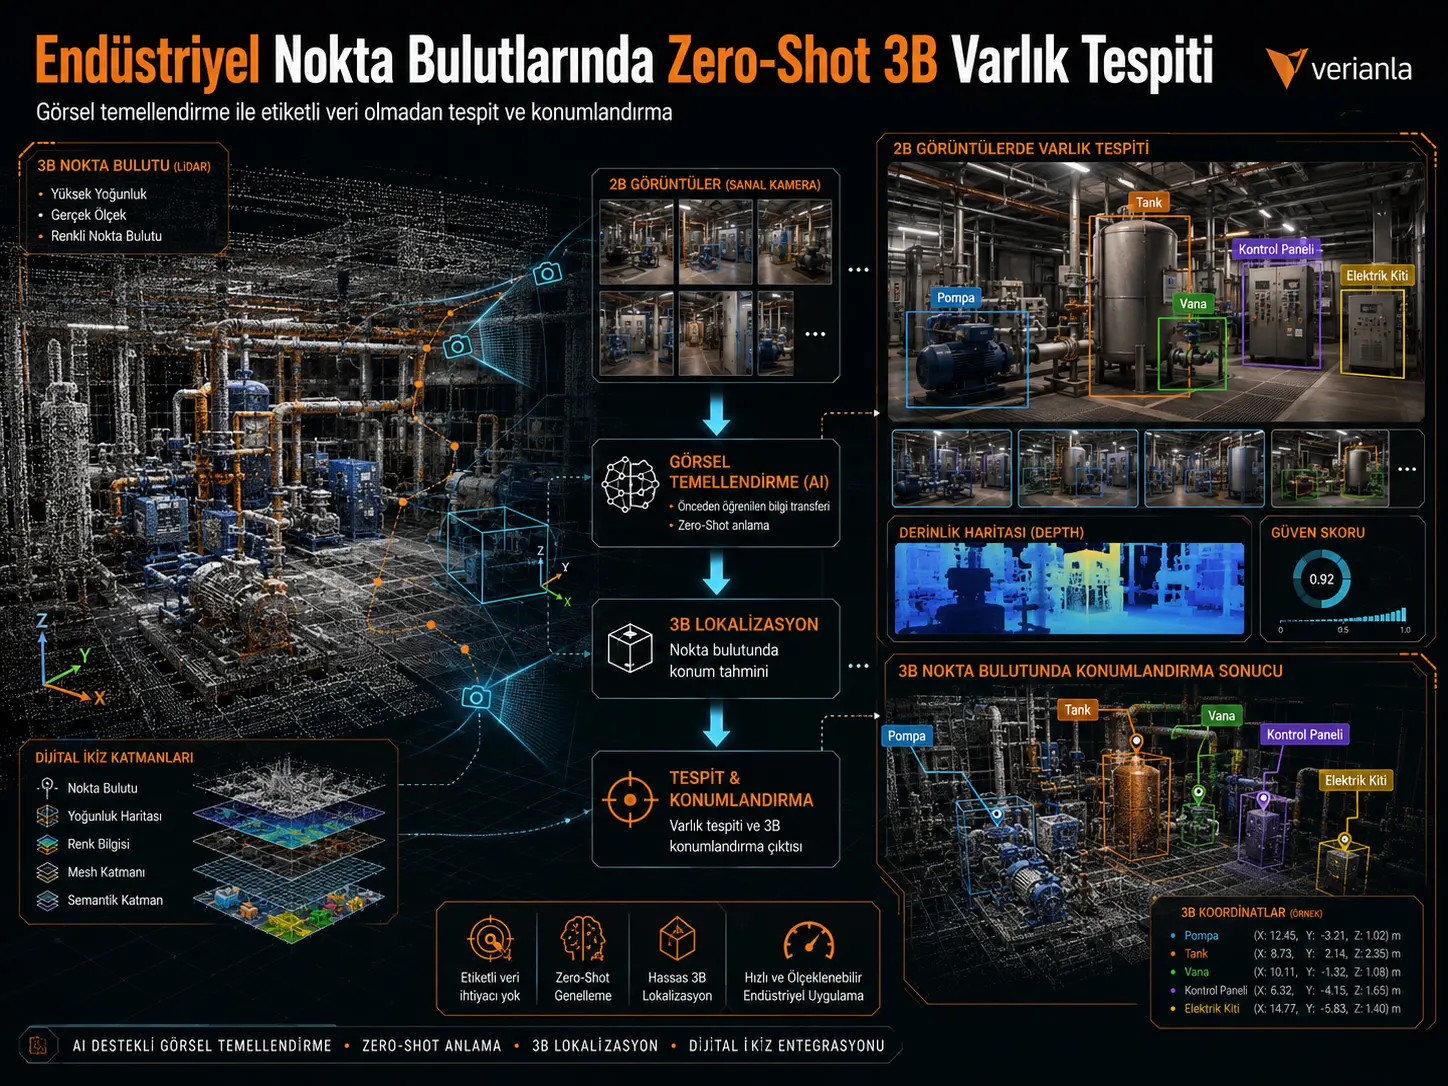
Bu tədqiqat aktual CAD modeli və ya sənaye aktivlərinə aid böyük etiketlənmiş təlim verilənlər dəsti olmayan mövcud obyektlərdə yalnız bir 3B nöqtə buludundan avadanlıqları aşkarlayıb onların təxmini məkan mövqelərini müəyyənləşdirməyi hədəfləyən zero-shot çərçivə təklif edir. Sistem nöqtə buludunu birbaşa 3B obyekt detektoruna vermək əvəzinə əvvəlcə virtual kameralarla müxtəlif hündürlük və yaxınlaşdırma səviyyələrində səhnə görüntüləri yaradır. Görüntülər GPT-4o ilə semantik baxımdan şərh edilir, yaradılan obyekt təsvirləri Grounding DINO-ya ötürülür, 2B bounding box-lar aşkarlanır və dərinlik ilə kamera parametrlərindən istifadə etməklə nəticələr yenidən 3B lokal koordinat sisteminə daşınır. Sabit baxış nöqtələrinin kifayət etmədiyi hallarda sistem obyektin görüntüdəki ölçüsü, kadrdan çıxması və digər obyektlərlə üst-üstə düşməsi kimi meyarlardan istifadə edərək kameranı yenidən mövqeləndirir və görüntünü təkrar yaradır.
Melburndakı mürəkkəb bir plant room-dan Leica BLK360 lazer skaneri ilə əldə edilən 271.348.287 nöqtəlik verilənlər üzərində təklif olunan metod, eyni vizual əsaslandırma infrastrukturu ilə qiymətləndirilən OpenIns3D başlanğıcındakı AP25 dəyərini 35,84-dən 48,13-ə, AP50 dəyərini 26,89-dan 34,98-ə yüksəltdi. Xüsusilə başlanğıc sisteminin AP25-də ümumiyyətlə aşkarlaya bilmədiyi gas/oil burner sinfi təklif olunan sistemdə 41,3 AP25-ə çatdı; electrical kit, control panel, fire extinguisher və bəzi digər siniflərdə də nəzərəçarpan artımlar bildirildi. 3B lokallaşdırma cədvəlində 11 aktiv üçün fərdi Evklid mövqe xətaları 0,105 ilə 0,312 metr arasında dəyişir. Lakin nəticələr yalnız bir sənaye mühitində əldə edilmişdir və metod yüksək dəqiqlikli həndəsi yenidənqurma sistemi kimi deyil, aktiv inventarı, rəqəmsal əkizin başlanğıc qatı, uzaqdan monitorinq və inspeksiya planlaşdırılması kimi təxmini məkan məlumatının kifayət etdiyi istifadə ssenariləri üçün qiymətləndirilmişdir.
Sənaye obyektlərində 3B aktiv aşkarlanması niyə çətindir?
Əsas problem yalnız “nöqtə buludunda obyekt tapmaq” deyil. Sənaye obyektlərində nasoslar, klapanlar, çənlər, elektrik panelləri, duct sistemləri, pilləkənlər, burner-lar və sıx boru xətləri müxtəlif ölçülərdə, müxtəlif hündürlüklərdə və çox vaxt bir-birini örtəcək şəkildə yerləşir. Bir avadanlığın ön tərəfi görünərkən digər tərəfi borular və ya divar tərəfindən örtülə bilər; kiçik bir klapan genişbucaqlı səhnə görüntüsündə bir neçə pikselə qədər kiçilə bilər.
Klassik nəzarətli 3B obyekt aşkarlama metodları bu problemi böyük və etiketlənmiş verilənlər dəstləri ilə həll etməyə çalışır. Lakin konkret sənaye obyektinə məxsus avadanlıq müxtəlifliyi səbəbindən belə verilənlər dəstlərini yaratmaq bahalı və vaxt aparandır. Standart avtonom sürücülük və ya qapalı məkan verilənlər dəstlərində avtomobil, piyada, stul və masa kimi siniflər olduğu halda, bir plant room-dakı gas/oil burner və ya xüsusi electrical kit kimi avadanlıqların təmsili adətən yoxdur.
Tədqiqatın əsas sualı buna görə belədir: yalnız mövcud nöqtə buludundan, obyektə xüsusi etiketlənmiş model öyrətmədən, sənaye aktivlərini aşkarlayıb onları yenidən 3B mövqeyə yerləşdirmək mümkündürmü?
“Zero-shot” burada dəqiq olaraq nə deməkdir?
Tədqiqatda zero-shot ifadəsi təklif olunan sistem üçün yeni sənaye obyektinə xüsusi etiketlənmiş təlim verilənlər dəstinin hazırlanmadığını bildirir. GPT-4o və Grounding DINO kimi əvvəlcədən öyrədilmiş foundation modellərindən istifadə olunur.
Deməli, sistem “heç nə öyrənməyib” demək deyil. Əvvəlcədən böyük verilənlər üzərində öyrədilmiş modellərdən yararlanır; sıfır olan, bu plant room-dakı avadanlıqları aşkarlamaq üçün həyata keçirilən domain-specific supervised training prosesidir.
Bundan əlavə, GPT-4o görüntülərdəki obyektləri tədqiqatda müəyyən edilmiş əvvəlcədən müəyyənləşdirilmiş sənaye aktivləri lüğətindən axtarır. Buna görə tətbiq səviyyəsində zero-shot qabiliyyəti əvvəlcədən müəyyən edilmiş sənaye sinifləri ilə foundation model biliyinin kombinasiyası kimi başa düşülməlidir.
Metod niyə nöqtə buludunu birbaşa təsnif etmir?
Tədqiqatçıların yanaşması güclü 2B vision–language modellərinin vizual anlama qabiliyyətindən yararlanmaq üçün 3B nöqtə buludunu müxtəlif virtual kameralardan 2B səhnə görüntülərinə çevirməkdir.
Bu dizaynın məntiqi belədir:
- Nöqtə buludunda virtual kameralar yerləşdirilir.
- Bu kameralardan 2B səhnə görüntüləri və depth map-lər render edilir.
- Foundation modellər görüntülərdə hansı sənaye aktivlərinin olduğunu müəyyən edir.
- 2B aşkarlamalar görüntünün depth məlumatı və kamera parametrlərindən istifadə etməklə yenidən 3B səhnəyə proyeksiya edilir.
Buna görə tədqiqat “2B və ya 3B” arasında seçim etmir; 3B həndəsi verilənləri 2B foundation-model vizual anlayışı ilə eyni pipeline-da birləşdirir.
Beşmərhələli sistem necə işləyir?
Məqalənin əsas metodu beş əsas mərhələdən ibarətdir:
- Virtual Camera Positioning: Virtual kameraların sənaye səhnəsinin uyğun bölgələrinə və müxtəlif hündürlüklərə yerləşdirilməsi.
- Image Generation: Nöqtə buludundan müxtəlif baxış və zoom səviyyələrində səhnə görüntülərinin yaradılması.
- Visual Grounding: GPT-4o ilə semantik müəyyənləşdirmə və Grounding DINO ilə 2B bounding box yaradılması.
- Recognition-Aware Refinement: Qeyri-kafi görünən obyektlər üçün kamera parametrlərinin avtomatik yenidən tənzimlənməsi və görüntünün təkrar render edilməsi.
- Asset Localisation: 2B aşkarlamaların depth, intrinsics və extrinsics istifadə edilməklə lokal 3B koordinatlara geri daşınması.
Tədqiqatın metod sxemində mühüm xüsusiyyət dördüncü mərhələnin birtərəfli proses olmamasıdır. Tanıma keyfiyyəti aşağıdırsa kamera yenidən tənzimlənir və yeni görüntülər yaradılır. Beləliklə, obyekt detektoru yalnız ona verilən görüntü ilə kifayətlənmək əvəzinə sistem obyektin daha yaxşı görünəcəyi yeni baxış yaratmağa çalışır.
Virtual kameraların yerləşdirilməsi niyə müxtəlif hündürlüklərdə aparılır?
OpenIns3D-nin genişbucaqlı sabit səhnə baxışları daha sadə qapalı məkanlarda kifayət edə bilər; lakin sənaye plant room-da tavana yaxın çoxlu boru xətti aşağı səviyyədəki avadanlıqları örtə bilər. Eyni şəkildə, hündür avadanlıq yalnız alçaq kameralardan baxıldıqda natamam görünə bilər.
Təklif olunan yanaşma buna görə kameraları tək bir hündürlükdə saxlamır. Yuxarı hündürlük sərhədi artırılaraq hündür avadanlıqların, aşağı sərhəd dəyişdirilərək döşəmə səviyyəsindəki avadanlıqların müxtəlif bucaqlardan görünməsi yaxşılaşdırılır.
Lakin tədqiqat bu dəyişən hündürlük strategiyasının töhfəsini ayrıca bir ablation eksperimenti ilə ölçmür. Buna görə “multi-height kamera yerləşdirilməsi təkbaşına X AP qazandırdı” formasında mənbədə rəqəm yoxdur.
Normal, orta və yaxın zoom niyə birlikdə istifadə olunur?
Sənaye səhnəsində çən ilə kiçik klapan eyni fiziki miqyasda deyil. Tək bir sabit zoom səviyyəsi istifadə edildikdə ya ümumi səhnə konteksti itir, ya da kiçik avadanlıqların vizual detalları qeyri-kafi qalır.
Tədqiqat bu problemi:
- normal,
- medium,
- close-up
olmaqla üçmiqyaslı zoom mexanizmi ilə həll edir. Beləliklə, eyni səhnənin həm ətraf konteksti, həm də kiçik avadanlıq detalları foundation modelə göstərilə bilir.
Divarın çıxarılması nə deməkdir?
Burada fiziki obyektdəki divarın silinməsi nəzərdə tutulmur. Nöqtə buludu render edilərkən xarici sərhəd divarları müəyyən bir həddən istifadə etməklə görüntü yaradılmasından çıxarılır. Məqsəd xarici divarın arxasında və ya yaxınlığında yerləşən aktivlərin virtual kameralar tərəfindən görülməsini təmin etməkdir.
Məqalənin divar çıxarılmasından əvvəl/sonra müqayisələri divar tərəfindən örtülən pump və tank kimi avadanlıqların virtual görüntülərdə daha görünən hala gələ bildiyini göstərir.
Hansı səhnə görüntüsünün “yaxşı” olduğuna necə qərar verilir?
İlk render edilmiş namizəd görüntülər bərabər qəbul edilmir. Hər görüntü üçün iki meyar hesablanır:
- Edge density: Canny edge detection-dan sonra görüntüdəki kənar piksel nisbəti.
- Texture variance: boz səviyyəli piksel intensivliklərinin dispersiyası.
Mənbədə görüntü skoru:
\[ score_i= 0.6\times\text{edge density} + 0.4\times\text{texture variance} \]
kimi müəyyən edilir.
Ən yüksək skoru alan namizəd görüntünün intrinsic kamera parametrləri sonrakı baxışların yaradılmasında yenidən istifadə olunur. Buradakı fikir həndəsi və tekstura məlumatı baxımından daha zəngin görüntü parametrini seçməkdir.
Depth-based filtering nə edir?
Görüntü vizual olaraq yaradılmış olsa belə, onun böyük hissəsi boş, occluded və ya etibarlı 3B səth məlumatı daşımaya bilər. Buna görə hər render-in depth map-i qiymətləndirilir.
Görünürlük nisbəti:
\[ V= \frac{|D_{\mathrm{valid}}|}{|D|} \]
kimi müəyyən olunur. \(D_{\mathrm{valid}}\), etibarlı depth dəyərinə malik pikselləri; \(D\) isə bütün görüntü piksellərini təmsil edir.
Yalnız:
\[ V\geq\sigma \]
şərtini ödəyən görüntülər saxlanılır.
Tədqiqatın aşağı və yüksək görünürlüklü nümunələrində aşağı keyfiyyətli baxışların depth map-lərində yalnız kiçik və qırıq rəngli sahələr görünərkən, yüksək görünürlükdə depth xəritəsi daha sıx və davamlıdır. Bu filtrasiya sonrakı 3B geri proyeksiyanın natamam həndəsədən təsirlənməsini azaltmağı hədəfləyir.
GPT-4o ilə Grounding DINO niyə birlikdə istifadə olunur?
Pipeline-ın iki modelinin vəzifələri fərqlidir.
GPT-4o, render edilmiş səhnə görüntüsünü semantik baxımdan təhlil edir və tədqiqatın əvvəlcədən müəyyən etdiyi sənaye aktivləri lüğətindən görünən obyektləri müəyyənləşdirir. Hər nümunə üçün:
- aktiv kateqoriyası,
- nümunə sayı,
- görüntüdəki təxmini mövqe,
- nisbi ölçü,
- görünüş və kontekst təsviri
yaradır.
Bu mərhələdə hələ dəqiq bounding box yoxdur.
Grounding DINO isə GPT-4o-nun yaratdığı təbii dil təsvirini visual grounding prompt-una çevirərək müvafiq obyekt üçün axis-aligned 2B bounding box yaradır.
Eyni sinfə aid birdən çox obyekt olduqda prompt-a mövqe və ölçü məlumatı əlavə edilərək nümunələrin bir-birindən ayrılması hədəflənir.
Niyə Grounding DINO təkbaşına kifayət hesab edilmədi?
Tədqiqatın keyfiyyət müqayisəsində ODISE və YOLO-World mürəkkəb sənaye aktivlərinin mühüm hissəsini qaçırmışdır. Grounding DINO daha yaxşı lokallaşdırma təmin etsə də, müəyyən xüsusi avadanlıq siniflərində təkbaşına məhdud qalmışdır.
Şəkil 2-də xüsusilə üçüncü nümunədəki gas oil burner və control panel, GPT-4o + Grounding DINO kombinasiyası tərəfindən aşkarlanarkən digər müqayisə edilən modellər tərəfindən qaçırılmışdır. Pump sinfinin müxtəlif baxışlarda təkrar aşkarlanması da təklif olunan kombinasiyanın səhnə kontekstindən yararlana bildiyi nümunələrdən biridir.
Recognition-aware viewpoint refinement niyə lazımdır?
Çox sayda kamera və zoom səviyyəsi yaratmaq belə hər obyektin yaxşı görüntülənəcəyinə zəmanət vermir. Obyekt:
- görüntüdə çox kiçik qala bilər,
- kənarda kəsilə bilər,
- başqa obyektlərlə örtüşə bilər,
- uyğunsuz bucaqdan görüntülənə bilər.
Tədqiqatın fərqi bu uğursuzluqları ölçüb kameraya geri əlaqə kimi ötürməsidir.
Obyektin görüntüdəki ölçüsü necə hesablanır?
Mənbədə projected area ratio üçün aşağıdakı ifadə çap edilmişdir:
\[ A_i= \frac{ (x_2-x_1)-(y_2-y_1) }{ W\cdot H }. \]
\((x_1,y_1,x_2,y_2)\) bounding box koordinatlarını, \(W,H\) görüntünün enini və hündürlüyünü təmsil edir.
Mənbəyə sədaqət qeydi: Məqalə bunu “projected area ratio” kimi müəyyən etsə də, eni və hündürlüyü vurmaq əvəzinə onların arasında çıxma işarəsi çap edir. Verianla mətni formulu standart düzbucaqlı sahə formuluna səssizcə çevirmir; mənbədəki göstərim olduğu kimi qorunur.
Obyektin kadrdan çıxması necə yoxlanılır?
Truncation indicator:
\[ T_i= \begin{cases} 1, & x_1\leq\delta \ \text{veya}\ y_1\leq\delta \ \text{veya}\ x_2\geq W-\delta \ \text{veya}\ y_2\geq H-\delta,\\ 0, & \text{aksi durumda} \end{cases} \]
kimi müəyyən edilir.
Obyektin bounding box-ı görüntünün kənarlarına müəyyən edilmiş \(\delta\) marjından daha çox yaxınlaşırsa baxış “truncated” kimi işarələnir.
View suitability skoru necə hesablanır?
Obyekt miqyası və truncation birlikdə:
\[ J_{\mathrm{view},i} = \beta\ln(1+A_i)-\gamma T_i \]
ifadəsinə çevrilir.
Daha böyük və tamamilə görüntü daxilinə sığmış obyekt daha yüksək uyğunluq skoru yaradır, kadrdan çıxan obyekt isə cərimələnir.
Sıx səhnələrdə üst-üstə düşən qutular necə nəzərə alınır?
Bir baxışdakı bounding box cütlərinin IoU dəyərləri hesablanaraq müəyyən:
\[ \tau_{\mathrm{IoU}} \]
həddini keçən cütlərin nisbətindən clutter score \(C_v\) əldə edilir.
Yüksək \(C_v\), çoxsaylı obyektin görüntüdə üst-üstə düşdüyünü və baxışın grounding üçün uyğun olmaya biləcəyini göstərir.
Kameranın yenidən tənzimlənməsi nə vaxt işə düşür?
Mənbəyə görə:
- \(A_i<\tau_A\): obyekt çox kiçik → zoom-in et və ya kamera məsafəsini azalt.
- \(T_i=1\): obyekt kadrdan çıxır → field of view-u genişləndir və ya kameranı sürüşdür.
- \(J_{\mathrm{view},i}<\tau_J\): baxış bucağı qeyri-kafidir → yaw/pitch dəyişdir.
- \(C_v>\tau_C\): səhnə həddən artıq sıxdır → hündürlüyü və ya kamera istiqamətini dəyişdir.
Prioritet həmçinin:
\[ S_i= w_1\max(0,\tau_A-A_i) + w_2\max(0,\tau_J-J_{\mathrm{view},i}) + w_3T_i \]
severity score-u ilə müəyyən edilir.
Field of view və kamera pozası necə dəyişdirilir?
Mənbədə fokus məsafəsinin yenilənməsi:
\[ f'_x= f_z \left( 1-\frac{\Delta FOV}{100} \right), \qquad f'_y= f_y \left( 1-\frac{\Delta FOV}{100} \right) \]
kimi çap edilmişdir.
Lakin dərhal ardınca mətn başlanğıc focal length-ləri:
\[ f_x,\;f_y \]
kimi müəyyən edir və \(f_z\)-ni izah etmir. Buna görə \(f'_x\) tənliyindəki \(f_z\) mənbədaxili notasiya uyğunsuzluğu və ya tipoqrafik xəta namizədidir. Mənbədə olmayan düzəliş edilməmişdir.
Kamera yönümü:
\[ P'= P\cdot R_{\mathrm{yaw}}(\theta) \cdot R_{\mathrm{pitch}}(\phi) \]
ilə dəyişdirilərkən radial kamera hərəkəti:
\[ p'_{\mathrm{cam}} = p_{\mathrm{scene}} + (1+\Delta r) \frac{ p_{\mathrm{cam}}-p_{\mathrm{scene}} }{ \|p_{\mathrm{cam}}-p_{\mathrm{scene}}\| } \]
şəklində verilir.
2B bounding box yenidən 3B mövqeyə necə çevrilir?
Visual grounding obyekti görüntüdə tapır; lakin rəqəmsal əkiz üçün obyektin zavod koordinatında harada yerləşdiyini bilmək lazımdır.
Görüntü pikseli:
\[ (u,v) \]
və ona uyğun depth:
\[ d \]
məlum olduqda kamera koordinatı:
\[ P_C= K^{-1} [u,v,1]^T d \]
ilə hesablanır.
Daha sonra kamera extrinsic parametrlərindən istifadə etməklə:
\[ P_L= R P_C+t \]
çevrilməsi tətbiq edilir.
Burada \(P_L\), obyektin lokal plant coordinate system daxilindəki 3B mövqeyidir.
Bu yanaşma 3B CAD modelini tamamilə əvəz edirmi?
Xeyr. Tədqiqatın müzakirə bölməsi bunu açıq şəkildə məhdudlaşdırır. Təklif olunan metod high-precision geometric reconstruction məqsədi üçün nəzərdə tutulmayıb.
Hədəflənən istifadə nümunələri:
- asset inventory yaratmaq,
- brownfield rəqəmsal əkizini başlatmaq üçün əsas məkan qatı yaratmaq,
- inspection planning,
- remote monitoring,
- aktivlərin təxmini məkan münasibətlərini müəyyənləşdirmək
kimi tapşırıqlardır.
Deməli, əldə olunan koordinatların istehsal toleransı və ya dəqiq reverse engineering ölçüsü kimi şərh edilməsi mənbə tərəfindən dəstəklənmir.
Türkiyə baxımından nə ifadə edir?
Metod xüsusilə aktual BIM/CAD modeli çatışmayan brownfield obyektlərini hədəflədiyi üçün Türkiyədə uzun müddətdir istismarda olan istehsal müəssisələri, enerji obyektləri və ya mürəkkəb mexaniki otaqlar baxımından tədqiqata dəyər yanaşma təqdim edə bilər. Lakin tədqiqat Melburnda yalnız bir plant room üzərində aparılmışdır.
Türkiyədəki bir obyekt üçün eyni AP və ya mövqe xəta dəyərlərinin əldə ediləcəyini söyləmək olmaz. Lokal doğrulamada nöqtə buludunun sıxlığı, skan keyfiyyəti, obyektin aktiv sinifləri, borulama sıxlığı, kiçik komponentlərin ölçüsü və foundation modelin müvafiq avadanlıq terminologiyasını tanıyıb-tanımadığı ayrıca yoxlanmalıdır.
Tədqiqatın dəstəklədiyi nəticələr
- Bir sənaye nöqtə buludundan, obyektə xüsusi etiketlənmiş təlim verilənlər dəsti hazırlanmadan 3B aktiv aşkarlanması və təxmini lokallaşdırmanın bu eksperimental mühitdə mümkün olduğunu göstərir.
- Təklif olunan tam pipeline eyni müqayisədə OpenIns3D başlanğıcından daha yüksək AP25 və AP50 vermişdir.
- Divar çıxarılması, çoxlu zoom və recognition-aware refinement mərhələlərinin kumulyativ əlavə edilməsi performansı addım-addım artırmışdır.
- GPT-4o + Grounding DINO kombinasiyası tədqiq olunan sənaye görüntülərində digər sınaqdan keçirilmiş visual grounding seçimlərindən daha yaxşı keyfiyyətli aşkarlamalar göstərmişdir.
- Recognition-aware refinement-ın əlavə edilməsi Cədvəl 2-dəki ən böyük son AP artımını yaratmışdır.
- 11 aktiv üçün lokal koordinat sisteminə geri proyeksiya nəticəsində 0,105–0,312 m arasında fərdi 3B lokallaşdırma xətaları bildirilmişdir.
- ±%10 parametr həssaslığı analizində istifadə olunan bütün perturbation-lar AP25-i azaltmış; xüsusilə \(\tau_J\) həddi ən yüksək həssaslığı göstərmişdir.
Tədqiqatın dəstəkləmədiyi və ya sınaqdan keçirmədiyi nəticələr
- Bütün sənaye obyektlərində eyni performansı göstərəcəyi sınaqdan keçirilməmişdir.
- Müxtəlif ölkələr, sənaye sektorları və ya skaner sistemləri üzərində cross-site generalisation eksperimenti aparılmamışdır.
- Yüksək dəqiqlikli CAD/reverse-engineering keyfiyyətində həndəsi yenidənqurma göstərilməmişdir.
- “Zero-shot” nəticələr foundation models olmadan əldə edilməmişdir; obyektə xüsusi yeni supervised training aparılmamışdır.
- İstənilən tamamilə naməlum aktiv kateqoriyasının məhdudiyyətsiz şəkildə kəşf ediləcəyi göstərilməmişdir; GPT-4o mərhələsində əvvəlcədən müəyyən edilmiş sənaye aktivləri lüğətindən istifadə olunur.
- AP fərqlərinin statistik əhəmiyyətliliyi üçün təkrarlı eksperiment, confidence interval və ya hipotez testi bildirilməmişdir.
- Variable-height camera positioning təsiri digər təkmilləşdirmələrdən müstəqil ablation sətrində ölçülməmişdir.
- Point-cloud downsampling təsiri kəmiyyət baxımından sınaqdan keçirilməmişdir.
- Prompt variasiyalarının performansa təsiri sistematik robustness eksperimenti ilə ölçülməmişdir.
Tədqiqatın Metodu və Nəticələri
Eksperimental mühit
Qiymətləndirmə Melburnda bir binanın daxilində yerləşən mürəkkəb plant room üzərində aparılmışdır.
| Eksperiment komponenti | Mənbədə verilən məlumat |
|---|---|
| 3B skaner | Leica BLK360 |
| Ümumi nöqtə sayı | 271.348.287 |
| Nöqtə buludunun işlənməsi | CloudCompare v2.13.2 |
| GPU | 2 × NVIDIA L40, hər biri 48 GB VRAM |
| CPU resursu | 16 vCPU |
| Sistem yaddaşı | 241 GB |
| Əməliyyat sistemi | Ubuntu 20.04 |
| Foundation model | GPT-4o, gpt-4o-2024-11-20 |
| 2B grounding | Grounding DINO |
OpenIns3D ilə tam sistemin nəticələri
| Aktiv | OpenIns3D AP25 | Təklif olunan AP25 | OpenIns3D AP50 | Təklif olunan AP50 |
|---|---|---|---|---|
| Orta | 35,84 | 48,13 | 26,89 | 34,98 |
| Cabinet | 44,6 | 58,3 | 40,2 | 42,8 |
| Control Panel | 52,3 | 65,4 | 43,3 | 49,2 |
| Electrical Kit | 18,3 | 35,1 | 7,8 | 20,3 |
| Gas/Oil Burner | 0 | 41,3 | 0 | 24,4 |
| Ladder | 74,3 | 76,1 | 50,9 | 51,2 |
| Pump | 16,1 | 21,3 | 6,4 | 15,9 |
| Tank | 78,8 | 80,4 | 68,1 | 69,8 |
| Valve | 33,4 | 36,4 | 27,6 | 29,1 |
| Duct | 7,3 | 10,7 | 0 | 6,2 |
| Fire Extinguisher | 33,3 | 56,3 | 24,6 | 40,9 |
Ən diqqətçəkən fərq gas/oil burner sinfində görünür. OpenIns3D başlanğıcı həm AP25, həm də AP50-də 0 verdiyi halda, təklif olunan framework müvafiq olaraq 41,3 və 24,4 dəyərlərinə çatmışdır.
Electrical kit üçün AP25 18,3-dən 35,1-ə, AP50 7,8-dən 20,3-ə; fire extinguisher üçün AP25 33,3-dən 56,3-ə və AP50 24,6-dan 40,9-a yüksəlmişdir.
Bunun əksinə, hər sinifdə eyni böyüklükdə artım müşahidə olunmur. Məsələn, tank və ladder artıq başlanğıc metodunda güclü siniflərdir və artımları daha məhduddur. Bu vəziyyət sistemin əsas üstünlüyünün xüsusilə mürəkkəb, kiçik, gizlənən və ya foundation model üçün daha çətin aktivlərdə üzə çıxa bildiyini göstərir; lakin bu şərh yalnız bu test sahəsinə aiddir.
Mərhələli təkmilləşdirmələrin təsiri
Divarın çıxarılması başlanğıc AP25 dəyərini 35,84-dən 38,22-yə yüksəldərkən AP50 yalnız 26,89-dan 27,10-a qalxmışdır.
Çoxlu zoom əlavə edildikdə AP25 42,63, AP50 28,82 olmuşdur.
Son recognition-aware refinement mərhələsi ilə AP25:
\[ 42{,}63\rightarrow48{,}13 \]
və AP50:
\[ 28{,}82\rightarrow34{,}98 \]
səviyyəsinə yüksəlmişdir.
Cədvəl 2 başlanğıcdan finala ümumi fərqi AP25 üçün 12,29, AP50 üçün 8,09 kimi verir. Bunlar başlanğıc və son AP dəyərlərinin arifmetik fərqləridir.
Recognition-aware refinement parametrləri nə qədər həssasdır?
Mənbənin əsas parametr dəsti:
| Parametr | Standart dəyər |
|---|---|
| \(\delta\) | 10 px |
| \(\beta\) | 1,0 |
| \(\gamma\) | 0,3 |
| \(\tau_A\) | 0,01 |
| \(\tau_J\) | 0,1 |
| \(\tau_{\mathrm{IoU}}\) | 0,3 |
| \(\tau_C\) | 0,15 |
Hər parametr ayrıca ±%10 dəyişdirildikdə bildirilən AP25 fərqləri belədir:
| Parametr | −%10 üçün ΔAP25 | +%10 üçün ΔAP25 |
|---|---|---|
| Image boundary margin \(\delta\) | −0,09 | −0,11 |
| Area contribution weight \(\beta\) | −0,10 | −0,14 |
| Truncation penalty \(\gamma\) | −0,09 | −0,12 |
| Minimum projected area \(\tau_A\) | −0,10 | −0,11 |
| View suitability threshold \(\tau_J\) | −0,65 | −0,55 |
| IoU overlap threshold \(\tau_{\mathrm{IoU}}\) | −0,06 | −0,08 |
| View clutter threshold \(\tau_C\) | −0,05 | −0,06 |
Bütün perturbation-ların mənfi olması müəlliflərin seçdiyi əsas konfiqurasiyanın bu lokal intervalda sınaqdan keçirilən ən yaxşı nöqtə olduğunu göstərir. Ən nəzərəçarpan həssaslıq:
\[ \tau_J \]
view suitability threshold-da müşahidə olunur. Bunun əksinə, clutter modelini müəyyən edən \(\tau_{\mathrm{IoU}}\) və \(\tau_C\) dəyişiklikləri daha kiçik təsir göstərmişdir.
3B lokallaşdırma xətaları hansı səviyyədədir?
Tədqiqat lokallaşdırılmış 11 aktiv üçün ground-truth koordinatı ilə aşkarlanan mövqe arasındakı 3B Evklid məsafəsini ayrı-ayrılıqda bildirir:
| Aktiv ID | 3B mütləq lokallaşdırma xətası (m) |
|---|---|
| 1 | 0,180 |
| 2 | 0,121 |
| 3 | 0,122 |
| 4 | 0,202 |
| 5 | 0,162 |
| 6 | 0,227 |
| 7 | 0,312 |
| 8 | 0,135 |
| 9 | 0,114 |
| 10 | 0,105 |
| 11 | 0,174 |
Bildirilən ən aşağı xəta 0,105 m, ən yüksək xəta 0,312 m-dir. Mənbə bu cədvəl üçün ayrıca orta lokallaşdırma xəta metriyi bildirmir; nəticələri fərdi aktiv bazasında göstərir.
Müəlliflər bu dəqiqlik səviyyəsini dəqiq həndəsi reverse engineering üçün deyil, genişmiqyaslı əməliyyat və texniki xidmət tətbiqlərində aktivin mövcudluğunu, təxmini həndəsi əhatəsini və məkan münasibətlərini müəyyənləşdirmək baxımından kifayət hesab edirlər.
Point cloud sıxlığı niyə hələ də kritikdir?
Zero-shot foundation model istifadəsi giriş həndəsəsinin keyfiyyətini əhəmiyyətsiz etmir. Mənbə point-cloud fidelity-nin aşkarlama performansına birbaşa təsir edə biləcəyini bildirir.
Moderate down-sampling-in hesablama xərcini azalda biləcəyinə dair keyfiyyət müşahidələri mövcuddur, lakin həddindən artıq point reduction kiçik valve və duct kimi obyektlərin incə həndəsəsini itirə bilər.
Lakin tədqiqat down-sampling nisbəti ilə AP və ya lokallaşdırma xətası arasında kəmiyyət eksperimenti təqdim etmir.
Hesablama xərci nə qədər əhəmiyyətlidir?
271 milyondan çox nöqtəsi olan böyük səhnələrdən yüksək ayırdetməli çoxsaylı virtual görüntülər yaratmaq hesablama baxımından bahadır. Tədqiqatçılar böyük point cloud-ları daha kiçik bölgələrə bölərək yükü azaltmağı təklif edirlər.
Bunun da bir qiyməti var: bölmə sərhədlərində yerləşən həndəsi kontekst və məkan məlumatı itə bilər. Buna görə miqyaslana bilmə yalnız GPU əlavə etmək deyil, səhnənin necə parçalanacağını da həll etməyi tələb edir.
Prompt engineering niyə məhdudiyyətdir?
GPT-4o və Grounding DINO-ya göndərilən prompt-un söz seçimi, təfərrüat səviyyəsi və ifadə forması nəticələri dəyişə bilər. Mənbə prompt engineering-i açıq məhdudiyyət kimi göstərir.
Gələcək tədqiqat təkliflərindən biri retrieval-augmented generation istifadə edərək aktiv məlumatını xarici knowledge base-dən götürmək və prompt-u kontekstə uyğun avtomatik zənginləşdirməkdir.
Tədqiqatın gələcək araşdırma istiqamətləri
Məqalə üç əsas sahəni önə çıxarır:
- Spatial zoning: IFC verilənlər modelləri və knowledge graph istifadə etməklə böyük sənaye nöqtə buludlarının mənalı məkan zonalarına bölünməsi.
- Adaptive image rendering: Kiçik valve/flange kimi aktivlərdə daha yüksək keyfiyyətli, böyük aktivlərdə isə daha qənaətli rendering istifadə edilməsi.
- RAG dəstəkli prompt engineering: Sənaye aktivləri haqqında məlumatın retrieval vasitəsilə prompt-a dinamik şəkildə daxil edilməsi.
Ən mühüm metodoloji məhdudiyyətlər
- Qiymətləndirmə yalnız bir sənaye plant room-da aparılmışdır.
- Aktiv və mühit müxtəlifliyinin fərqli obyektlərə ötürülə bilməsi eksperimental şəkildə göstərilməmişdir.
- Toz, rütubət, işıqlandırma, sensor noise və occlusion kimi müxtəlif sahə şəraitləri point-cloud keyfiyyətini dəyişə bilər.
- Böyük point cloud rendering yüksək hesablama xərcinə malikdir.
- Point-cloud seqmentasiyası zona sərhədlərində məlumat itkisinə səbəb ola bilər.
- Kiçik və xüsusi sənaye avadanlıqlarının aşkarlanması hələ də çətindir.
- Prompt engineering nəticəyə əhəmiyyətli təsir göstərir.
- Down-sampling təsiri kəmiyyət baxımından ölçülməmişdir.
- AP fərqləri üçün uncertainty və ya statistik əhəmiyyətlilik təhlili verilməmişdir.
Mənbə və Metod Qeydi
Tam orijinal tədqiqat adı: Zero-Shot 3D Asset Detection and Localisation Through Visual Grounding in Industrial Point Clouds
Müəlliflər: Masoud Kamali; Behnam Atazadeh; Abbas Rajabifard; Yiqun Chen.
Bərabər birinci/bərabər töhfə: Mənbədə bərabər birinci müəllif və ya bərabər töhfə bəyanatı yoxdur.
Məsul müəllif: Behnam Atazadeh.
Qurum: The Centre for Spatial Data Infrastructures and Land Administration, Department of Infrastructure Engineering, The University of Melbourne, Melbourne, Victoria, Australia.
Mənbə növü: Resenziyalı orijinal tədqiqat məqaləsi; kompüter görməsi, 3B səhnə anlayışı və sənaye aktivlərinin lokallaşdırılması tədqiqatı.
Jurnal: AI.
Nəşriyyat: MDPI, Basel, İsveçrə.
Biblioqrafik qeyd: AI, 2026, Cild 7, Say 6, Məqalə 205.
DOI: 10.3390/ai7060205.
Qəbul / reviziya / qəbul olunma / nəşr: 2 Mart 2026 / 18 May 2026 / 26 May 2026 / 5 İyun 2026.
Resenziya statusu: Resenziyalı jurnal nəşridir.
Lisenziya: Creative Commons Attribution (CC BY).
Academic Editors: Miguel Angel Cazorla; Emanuele Frontoni.
Əsas tədqiqat problemi: Etiketlənmiş sənaye təlim verilənlər dəsti və ya aktual CAD modeli olmayan mürəkkəb sənaye mühitlərində yalnız point cloud verilənlərindən zero-shot aktiv aşkarlanması və təxmini 3B lokallaşdırma.
Giriş veriləni: Leica BLK360 ilə əldə edilmiş 271.348.287 nöqtəlik sənaye point cloud-u.
Əsas metod: Virtual camera positioning → image generation → GPT-4o semantic interpretation → Grounding DINO visual grounding → recognition-aware camera refinement → depth/intrinsic/extrinsic əsaslı 3B asset localisation.
Foundation model: GPT-4o, mənbədə `gpt-4o-2024-11-20` versiya etiketi ilə göstərilmişdir.
Visual grounding modeli: Grounding DINO.
Baseline: OpenIns3D; nəzarətli müqayisədə GPT-4o + Grounding DINO visual grounding konfiqurasiyası baseline və təklif olunan metodda ardıcıl şəkildə istifadə edilmişdir.
Əsas detection nəticəsi: Orta AP25 35,84-dən 48,13-ə, AP50 26,89-dan 34,98-ə yüksəlmişdir.
Incremental nəticə: OpenIns3D → wall removal → multiple zoom + wall removal → recognition-aware refinement ardıcıllığında AP25 35,84 → 38,22 → 42,63 → 48,13 və AP50 26,89 → 27,10 → 28,82 → 34,98.
Lokallaşdırma qiymətləndirilməsi: Ground-truth-a qarşı 11 aktivin 3B Evklid mövqe xətaları ayrı-ayrılıqda verilmiş və 0,105–0,312 m intervalında olmuşdur.
Parametr həssaslığı: Recognition-aware refinement parametrləri ±%10 dəyişdirilmiş; bütün perturbation-lar AP25-də azalma yaratmış və ən həssas parametr \(\tau_J\) view suitability threshold olmuşdur.
Avadanlıq: 2 × NVIDIA L40 48 GB VRAM; 16 vCPU; 241 GB RAM.
Əməliyyat sistemi: Ubuntu 20.04.
Point-cloud proqramı: CloudCompare v2.13.2.
Maliyyələşdirmə: Australian Research Council, IH210100048 və DE220100094 nömrəli qrantlar.
Verilənlərə əlçatanlıq: Tədqiqatda istifadə edilən verilənlərin daha geniş və davam edən tədqiqat/inkişaf layihəsi səbəbindən məsul müəllifdən əsaslandırılmış sorğu əsasında əldə edilə biləcəyi bildirilmişdir.
Etik komitə: Tətbiq olunmur.
Məlumatlandırılmış razılıq: Tətbiq olunmur.
Maraqların toqquşması: Müəlliflər maraqların toqquşmasının olmadığını bəyan etmişlər.
Təşəkkür: University of Melbourne Research Computing Services və Petascale Campus Initiative dəstəyi ilə yanaşı Emerson və Rockfield sənaye tərəfdaşlarının dəstəyi göstərilmişdir; müəlliflər məqalədəki baxışların özlərinə aid olduğunu ayrıca bildirirlər.
Müəllif töhfələri: Konseptuallaşdırma M.K. və B.A.; metodologiya M.K., B.A. və Y.C.; proqram təminatı M.K.; doğrulama M.K. və B.A.; formal analiz M.K.; tədqiqat M.K., B.A. və Y.C.; resurslar M.K., B.A. və Y.C.; verilənlərin kurasiyası M.K.; ilkin layihə M.K.; nəzərdən keçirmə və redaktə bütün müəlliflər; vizuallaşdırma M.K.; elmi rəhbərlik B.A., A.R. və Y.C.; layihə idarəetməsi A.R. və Y.C.; maliyyələşdirmənin əldə edilməsi B.A. və A.R. tərəfindən həyata keçirilmişdir.
Mənbədaxili formul və hesabat qeydləri
Recognition-aware refinement bölməsindəki projected-area formulu mənbədə:
\[ A_i= \frac{(x_2-x_1)-(y_2-y_1)}{W H} \]
kimi yazılmışdır. “Sahə nisbəti” izahı ilə riyazi ifadə arasında mümkün uyğunsuzluq vardır; Verianla mətnində standart bounding-box sahə formuluna səssizcə dəyişdirilməmişdir.
Eyni şəkildə field-of-view yenilənməsində \(f'_x\) üçün \(f_z\) istifadə olunmuş, lakin izah \(f_x,f_y\)-ni başlanğıc focal length-lər kimi müəyyən etmişdir. Mənbə \(f_z\)-ni bu kontekstdə izah etmir.
Cədvəl 2 başlanğıc ilə yekun metod arasındakı AP25 fərqini 12,29 kimi göstərir. Nəticə bölməsindəki “%12,29” ifadəsi bu arifmetik AP fərqini faiz işarəsi ilə yazır. Buna görə burada “12,29 AP balı” ilə “%12,29 nisbi yaxşılaşma” eyni şey kimi işlədilməmişdir.
Mənbənin xülasəsindəki “significantly outperforming” ifadəsinə baxmayaraq müqayisə üçün təkrarlı qiymətləndirmə qeyri-müəyyənliyi, confidence interval və ya formal statistik significance testi bildirilmir. Verianla izahı performans fərqini rəqəmsal dəyərləri ilə verir; statistik əhəmiyyətlilik nəticəsi əlavə etmir.
Elmi şərhin sərhədi
Bu tədqiqatın əsas uğuru tək bir mürəkkəb plant room-dakı point cloud verilənlərini foundation models və adaptiv virtual kamera yaradılması ilə birləşdirərək etiketlənmiş domain-specific təlim tələb etmədən daha yüksək aşkarlama uğuru və istifadəyə yararlı təxmini 3B lokallaşdırma göstərməsidir.
Bununla belə, nəticə bir obyekt üzrə doğrulamaya əsaslanır. Sənaye aktivlərinin həndəsəsi, sensor səs-küyü, skan sıxlığı, occlusion quruluşu və foundation modelin aktiv terminologiyasını tanıma qabiliyyəti başqa mühitlərdə fərqli olacaq.
Buna görə AP25 48,13 və AP50 34,98 dəyərləri “sənaye obyektlərində ümumi uğur faizi” kimi deyil, bu tədqiqatın müəyyən etdiyi test sahəsi, aktiv sinifləri, point cloud və qiymətləndirmə protokoluna aid model performansı kimi oxunmalıdır.
Eyni şəkildə 0,105–0,312 m lokallaşdırma xətaları da yüksək dəqiqlikli survey/CAD dəqiqliyi zəmanəti deyil. Mənbə metodu açıq şəkildə asset inventory, digital-twin initialisation və inspection planning kimi təxmini məkan mövqeyinin əməliyyat dəyəri daşıdığı tətbiqlərə yönəldir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib