

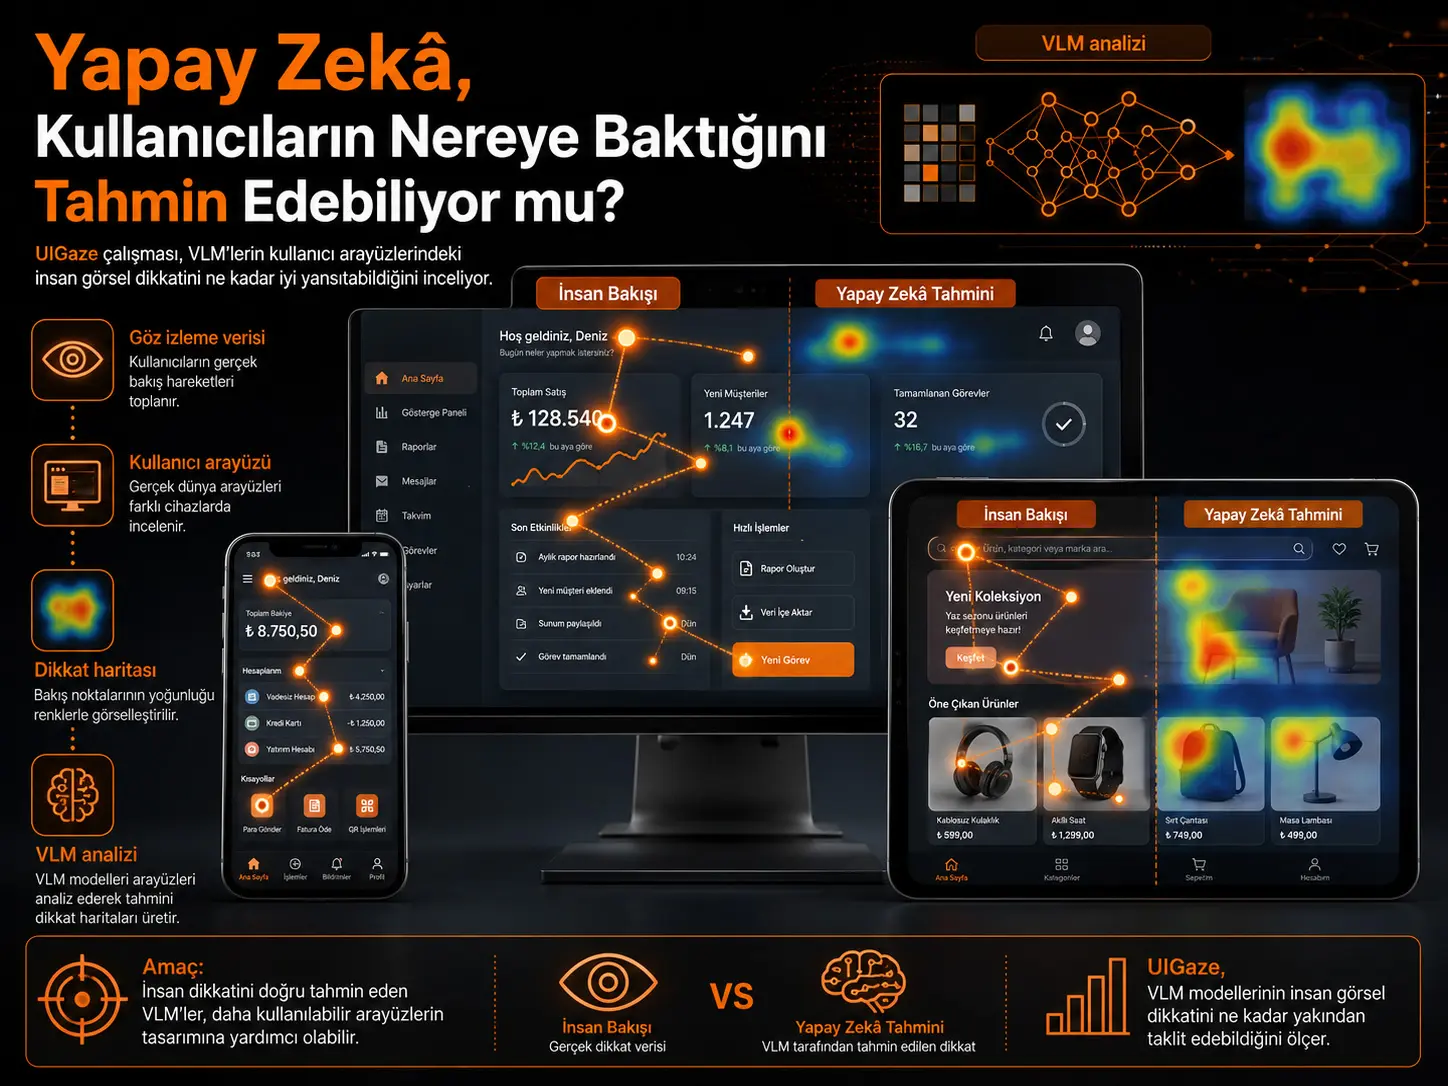
Utafiti wa UIGaze uliotengenezwa na Min Song, Yoonseong Lee na Yeonhu Seo unachunguza kwa kiwango gani miundo ya kuona-lugha (Vision Language Models, VLM) inaweza kukadiria mgawanyo wa umakini wa kuona wa binadamu kwenye kiolesura cha mtumiaji kwa kufanana na data halisi ya ufuatiliaji wa macho. Utafiti unatumia picha 1.980 za violesura vya watumiaji kutoka mkusanyiko wa data wa UEyes unaojumuisha data za ufuatiliaji wa macho kutoka kwa washiriki 62; makundi manne yanatathminiwa—ukurasa wa wavuti, kiolesura cha kompyuta ya mezani, kiolesura cha simu ya mkononi na bango—kila moja likiwa na picha 495. VLM tisa, bila kufunzwa kwa data yoyote ya ufuatiliaji wa macho, zinatabiri pointi 30–50 za kutazama katika kazi ya zero-shot. Pointi hizi zinabadilishwa kuwa ramani za saliency kwa kutumia Gaussian blur na kisha kulinganishwa na ramani za macho za binadamu kwa kutumia vipimo vya CC, SIM na KL. Matokeo bora zaidi kwa ujumla yanapatikana na GPT-5.4 katika muda wa kutazama wa sekunde 7: CC=0,408, SIM=0,503 na KL=1,345. Matokeo yanaonyesha kuwa utabiri wa VLM unafanana zaidi na tabia ya umakini wa uchunguzi inayojitokeza baada ya binadamu kuchunguza kiolesura kwa sekunde kadhaa kuliko na fixation za mwanzo za macho. Hata hivyo, ulinganifu na ufuatiliaji wa macho unabaki katika kiwango cha wastani, na haijaonyeshwa kuwa miundo hiyo ina usahihi unaoweza kuchukua nafasi ya tafiti halisi za watumiaji.
Muda wa kutazama ni mojawapo ya viashiria vilivyo wazi zaidi vya tofauti hii. Mgawo wa korelasyon wa GPT-5.4 dhidi ya ramani ya macho ya binadamu ya sekunde 1 ni 0,217, unaongezeka hadi 0,326 kwa sekunde 3 na hadi 0,408 kwa sekunde 7. Mwelekeo unaofanana unaonekana katika miundo mingi. Watafiti wanaeleza hili kwa uwezo wa VLM kuchambua picha nzima na kutambua maeneo muhimu kisemantiki: tabia hii inafanana zaidi na uchunguzi wa makusudi na wa kiutafiti unaoendelea kwa muda kuliko na mwitikio wa haraka wa kuelekeza macho wa binadamu katika muda wa kwanza.
Aina ya kiolesura pia hubadilisha matokeo kwa kiasi kikubwa. Katika ulinganisho wa sekunde 7, GPT-5.4 inafikia korelasyon ya juu zaidi kati ya michanganyiko yote ya model-kategoria katika utafiti, ikiwa na CC=0,506 kwenye violesura vya kompyuta ya mezani. Model hiyo hiyo inatoa 0,369 kwenye violesura vya simu, 0,388 kwenye mabango na 0,371 kwenye violesura vya wavuti. Kwa upande mwingine, UI-TARS 1.5, iliyoundwa kufanya vitendo vya kiotomatiki kwenye violesura vya watumiaji, ina CC ya jumla ya sekunde 7 ya 0,086 tu; kwenye violesura vya simu CC=-0,008. Kwa hiyo, mojawapo ya hitimisho muhimu la utafiti ni kwamba uwezo wa kuamua kipengele gani cha kubofya au kitendo gani cha kufanya katika kiolesura si uwezo sawa na kuiga mahali ambako binadamu hutazama.
Kwa mtazamo wa Uturuki: Ingawa utafiti ulifanywa na watafiti wanaoishi Korea Kusini, tathmini iliyofanywa kupitia mkusanyiko wa UEyes haipimi tabia mahususi ya watumiaji wa Uturuki. Matokeo hayapaswi kuchukuliwa kuwa data ya moja kwa moja ya tabia ya watumiaji kwa tovuti za biashara mtandaoni nchini Uturuki, violesura vya wavuti vya mashirika, programu za simu au skrini za huduma za umma. Hata hivyo, utabiri wa umakini unaotegemea VLM katika hali ya zero-shot unaweza kuwa zana inayostahili kuchunguzwa kwa ukaguzi wa awali wa maeneo yanayoweza kuvutia umakini kabla ya kufanya jaribio halisi la ufuatiliaji wa macho katika hatua za mwanzo za usanifu. Uhalali wake kwa watumiaji wa Kituruki unahitaji uthibitisho wa ziada kwa data za ndani za ufuatiliaji wa macho zinazojumuisha lugha, mwelekeo wa kusoma, umri, uzoefu, usuli wa kitamaduni na mazoea ya kutumia kiolesura.
Swali kuu la utafiti ni lipi?
Katika usanifu wa kiolesura cha mtumiaji, si tu vipengele vilivyopo kwenye skrini vinavyohusika, bali pia ni vipengele gani watu hutazama na jinsi wanavyosambaza umakini wao kwenye skrini nzima. Ramani za saliency zinazotokana na tafiti za ufuatiliaji wa macho zinaweza kuonyesha kiwango ambacho vichwa, vitufe, menyu, picha na vipengele vingine vya kiolesura vinavuta umakini. Hata hivyo, jaribio halisi la ufuatiliaji wa macho linahitaji washiriki, vifaa maalumu, muda na miundombinu ya ukusanyaji wa data.
Swali la utafiti wa UIGaze linatokea hapa: Je, VLM za kisasa zinazoweza kutafsiri picha na maana katika maudhui ya kuona zinaweza kutabiri maeneo ambayo watu wana uwezekano wa kutazama katika kiolesura cha mtumiaji bila kufunzwa mahsusi kwa data za ufuatiliaji wa macho?
Watafiti hawachukulii hili kama kazi ya kutafuta kipengele cha kiolesura cha mtumiaji, bali kama tatizo la kutabiri mgawanyo wa macho ya binadamu kwenye skrini nzima. Tofauti hii ni muhimu. Kwa mfano, pale model inapopewa agizo “tafuta kitufe cha utafutaji”, kupata koordinati ya kitu mahususi si tatizo sawa na kutabiri jinsi msongamano wa umakini unavyosambaa kwenye picha nzima wakati watu wanatazama skrini kwa uhuru.
Kwa nini mkusanyiko wa data wa UEyes ulitumika?
Mkusanyiko wa data wa ufuatiliaji wa macho wa UEyes umetumika kama ground truth. Mkusanyiko huu una jumla ya picha za skrini za violesura vya watumiaji 1.980 na makundi manne yanawakilishwa kwa usawa:
| Kategoria ya kiolesura | Idadi ya picha |
|---|---|
| Ukurasa wa wavuti | 495 |
| Kiolesura cha kompyuta ya mezani | 495 |
| Kiolesura cha simu ya mkononi | 495 |
| Bango | 495 |
| Jumla | 1.980 |
Data za UEyes zinajumuisha vipimo vya macho vya washiriki 62 vilivyokusanywa katika mazingira ya maabara kwa kutumia kifuatiliaji macho cha usahihi wa juu. Kila mshiriki hutazama picha kwa sekunde 7. Mkusanyiko wa data una ramani za saliency kwa madirisha matatu tofauti ya muda yanayolingana na sekunde 1, 3 na 7.
Muda huu mitatu ni sehemu muhimu ya utafiti. Ramani ya sekunde moja iko karibu zaidi na tabia ya umakini wakati wa kukutana na picha kwa mara ya kwanza, wakati ramani ya sekunde 7 inawakilisha tabia ya uchunguzi wa kuona wakati mtumiaji amepewa muda zaidi wa kuchunguza skrini. Hivyo UIGaze inaweza kuchunguza si tu swali “je, model inafanana na binadamu?” bali pia inafanana zaidi na hatua gani ya muda ya umakini wa binadamu.
Pointi za macho zilipatikana vipi kutoka kwa VLM?
Watafiti hutuma kila picha ya skrini kwa VLM kwa prompt moja ya zero-shot. Model inaombwa kutoa pointi 30–50 ambazo watu wana uwezekano wa kutazama, zikiwa na koordinati za x na y zilizosanifishwa na thamani ya intensity kwa kila pointi.
Mchakato una hatua kuu tatu:
- Picha ya kiolesura hutumwa kwa VLM na model huombwa kutoa koordinati za macho.
- Koordinati zilizosanifishwa huhamishwa kwenye vipimo vya pikseli vya picha asilia ya skrini.
- Gaussian blur yenye uzito wa thamani ya intensity hutumika kwa kila pointi ili kuunda ramani endelevu ya saliency.
Mkengeuko wa kawaida wa Gaussian blur umewekwa kuwa \(\sigma=40\) pikseli. Watafiti hutumia thamani hii ili kulinganisha na vigezo vya kutengeneza heatmap za UEyes na kudumisha makadirio ya pembe ya kuona ya takriban digrii 1.
Pia kuna sababu ya kimbinu ya kutoiomba model ichore moja kwa moja picha mpya ya heatmap. Model ya kuzalisha picha inaweza kubadilisha pikseli za kiolesura asilia cha mtumiaji. Katika hali hiyo, ulinganisho wa kuaminika kwa kiwango cha pikseli kati ya matokeo ya model na ground truth ya ufuatiliaji wa macho hauwezi kufanywa. Mbinu ya kuzalisha koordinati inaruhusu tathmini bila kubadilisha jiometri asilia ya kiolesura.
Ni miundo gani iliyolinganishwa?
Utafiti unalinganisha VLM tisa kutoka kwa watoa huduma watano katika mfumo mmoja wa tathmini. Matoleo ya model na tarehe za snapshot zilizotumiwa katika utafiti ni kama ifuatavyo:
| Mtoa huduma | Model | Snapshot iliyotumiwa katika utafiti |
|---|---|---|
| OpenAI | GPT-5.4 | 2026-03-05 |
| OpenAI | GPT-5.4-mini | 2026-03-17 |
| Gemini 3.1 Pro | 2026-02-19 | |
| Gemini 3.1 Flash Lite | 2026-03-03 | |
| Anthropic | Claude Opus 4.6 | 2026-02-05 |
| Anthropic | Claude Sonnet 4.6 | 2026-02-17 |
| Qwen | Qwen 3.5 Plus | 2026-02-16 |
| Qwen | Qwen 3.5 Flash | 2026-02-24 |
| ByteDance | UI-TARS 1.5 | Tarehe haijaonyeshwa katika kitambulishi cha model |
Miundo yote iliendeshwa kupitia OpenRouter API kwa kiolesura cha pamoja katika utafiti. Maelezo haya ni muhimu kwa sababu jaribio linaweka watoa huduma tofauti wa model katika mfumo mmoja wa kuzalisha koordinati na tathmini.
CC, SIM na KL hupima nini?
Ramani ya saliency iliyoundwa na VLM ililinganishwa na ramani halisi ya ufuatiliaji wa macho ya binadamu kwa vipimo vitatu vya kawaida.
CC (Correlation Coefficient): Hupima korelasyon ya mstari kati ya mifumo ya anga ya ramani iliyotabiriwa na ramani halisi. Thamani inayokaribia 1 humaanisha ufanano wa juu zaidi.
SIM (Similarity): Huchukulia ramani mbili kama migawanyo ya uwezekano na kupima kiwango cha kuingiliana kwao. Thamani ya 1 inaonyesha mgawanyo unaofanana kabisa.
KL divergence: Hupima upotevu wa taarifa unaotokea wakati mgawanyo halisi wa umakini unawakilishwa na mgawanyo uliotabiriwa. Hapa thamani ya chini ni bora zaidi.
Kwa hiyo, thamani za juu kwa CC na SIM na thamani za chini kwa KL ndizo zinazopendelewa.
Jaribio lilirudiwaje?
Kila moja ya picha 1.980 ilitathminiwa kwa miundo tisa, na ili kuzingatia utofauti katika matokeo ya model, majaribio matatu huru yalifanywa kwa kila jozi ya model-picha. Kila utabiri pia ulilinganishwa na ramani zote tatu za macho ya binadamu za sekunde 1, 3 na 7.
Ili kubaini kama marudio matatu yalitosha, watafiti walifanya jaribio la awali lenye marudio 10 kwenye sehemu ndogo ya picha 40. Kwa kuwa tofauti kati ya vipimo vya wastani kutoka kwa marudio matatu na 10 ilikuwa ndogo sana, marudio matatu yalitumiwa katika jaribio kamili. Imeelezwa kuwa majaribio yalifanywa mwezi April 2026.
Utendaji wa jumla katika sekunde 7 unaonyesha nini?
Ulinganifu wa juu zaidi dhidi ya ramani za macho ya binadamu za sekunde saba ulipatikana na GPT-5.4. Hata hivyo, thamani ya CC=0,408 haionyeshi ulinganifu kamili au wa juu sana na binadamu, bali ulinganifu wa kitabia wa kiwango cha kati kama watafiti wenyewe wanavyoeleza.
| Model | CC ↑ | SIM ↑ | KL ↓ |
|---|---|---|---|
| GPT-5.4 | 0,408 ± 0,169 | 0,503 ± 0,085 | 1,345 ± 0,793 |
| Claude Opus 4.6 | 0,344 ± 0,200 | 0,468 ± 0,102 | 1,670 ± 0,957 |
| Qwen 3.5 Plus | 0,337 ± 0,167 | 0,466 ± 0,085 | 1,612 ± 0,869 |
| Qwen 3.5 Flash | 0,295 ± 0,171 | 0,424 ± 0,102 | 2,214 ± 1,372 |
| GPT-5.4-mini | 0,289 ± 0,171 | 0,453 ± 0,084 | 1,600 ± 0,918 |
| Claude Sonnet 4.6 | 0,279 ± 0,195 | 0,436 ± 0,110 | 1,924 ± 1,247 |
| Gemini 3.1 Pro | 0,144 ± 0,228 | 0,255 ± 0,196 | 5,457 ± 3,385 |
| Gemini 3.1 Flash Lite | 0,105 ± 0,242 | 0,234 ± 0,216 | 5,823 ± 3,871 |
| UI-TARS 1.5 | 0,086 ± 0,171 | 0,142 ± 0,143 | 7,448 ± 2,580 |
Kwa sababu Qwen 3.5 Plus na Qwen 3.5 Flash zilishindwa kutoa majibu kwa uthabiti kwenye picha mbili, vipimo vya miundo hii miwili vilihesabiwa kwa picha 1.978 zilizobaki badala ya 1.980.
Kwa nini ufanano na macho ya binadamu huongezeka kadiri muda unavyopita?
Mojawapo ya matokeo yanayovutia ya utafiti ni kwamba karibu katika miundo yote, ulinganifu na mgawanyo wa macho wa sekunde 7 ni wa juu kuliko ule wa sekunde 1.
| Model | CC ya sekunde 1 | CC ya sekunde 3 | CC ya sekunde 7 |
|---|---|---|---|
| GPT-5.4 | 0,217 ± 0,143 | 0,326 ± 0,163 | 0,408 ± 0,169 |
| Claude Opus 4.6 | 0,227 ± 0,157 | 0,303 ± 0,181 | 0,344 ± 0,200 |
| Qwen 3.5 Plus | 0,161 ± 0,131 | 0,245 ± 0,162 | 0,337 ± 0,167 |
| Qwen 3.5 Flash | 0,135 ± 0,137 | 0,210 ± 0,162 | 0,295 ± 0,171 |
| GPT-5.4-mini | 0,154 ± 0,133 | 0,220 ± 0,161 | 0,289 ± 0,171 |
| Claude Sonnet 4.6 | 0,142 ± 0,149 | 0,213 ± 0,178 | 0,279 ± 0,195 |
| Gemini 3.1 Pro | 0,059 ± 0,140 | 0,103 ± 0,189 | 0,144 ± 0,228 |
| Gemini 3.1 Flash Lite | 0,038 ± 0,147 | 0,070 ± 0,196 | 0,105 ± 0,242 |
| UI-TARS 1.5 | 0,078 ± 0,153 | 0,101 ± 0,180 | 0,086 ± 0,171 |
Kwa GPT-5.4, ongezeko la CC kutoka sekunde 1 hadi sekunde 7 ni %88 kwa kulinganisha. Hata hivyo, katika kipimo cha sekunde 1, CC ya juu zaidi si ya GPT-5.4 bali Claude Opus 4.6: 0,227 dhidi ya 0,217. GPT-5.4 baadaye inaongoza katika tathmini za sekunde 3 na 7.
Watafiti wanaona matokeo haya kama ishara kwamba miundo tofauti inaweza kukamata vipengele tofauti vya muda vya umakini wa kuona wa binadamu kwa viwango tofauti. Mwelekeo wa jumla ni kwamba VLM zinakaribia zaidi macho ya uchunguzi yanayoongozwa kisemantiki kuliko fixation ya kwanza ya haraka.
Muundo wa kiolesura hubadilisha matokeo kwa kiwango gani?
Matokeo ya CC ya sekunde saba yanapotenganishwa kulingana na kategoria za kiolesura, tabia ya model inaonekana kwa uwazi zaidi:
| Model | Kompyuta ya mezani | Simu | Bango | Wavuti |
|---|---|---|---|---|
| GPT-5.4 | 0,506 ± 0,156 | 0,369 ± 0,165 | 0,388 ± 0,169 | 0,371 ± 0,145 |
| Claude Opus 4.6 | 0,404 ± 0,193 | 0,275 ± 0,210 | 0,371 ± 0,183 | 0,325 ± 0,191 |
| Qwen 3.5 Plus | 0,402 ± 0,162 | 0,325 ± 0,158 | 0,323 ± 0,182 | 0,298 ± 0,146 |
| GPT-5.4-mini | 0,399 ± 0,168 | 0,230 ± 0,148 | 0,255 ± 0,177 | 0,272 ± 0,134 |
| Claude Sonnet 4.6 | 0,393 ± 0,180 | 0,187 ± 0,203 | 0,270 ± 0,167 | 0,265 ± 0,167 |
| Qwen 3.5 Flash | 0,359 ± 0,185 | 0,312 ± 0,163 | 0,246 ± 0,168 | 0,263 ± 0,145 |
| Gemini 3.1 Pro | 0,220 ± 0,258 | 0,134 ± 0,213 | 0,129 ± 0,208 | 0,093 ± 0,211 |
| Gemini 3.1 Flash Lite | 0,113 ± 0,258 | 0,112 ± 0,250 | 0,186 ± 0,240 | 0,007 ± 0,179 |
| UI-TARS 1.5 | 0,108 ± 0,171 | -0,008 ± 0,111 | 0,169 ± 0,173 | 0,076 ± 0,171 |
Thamani ya CC ya 0,506 ya GPT-5.4 kwenye violesura vya kompyuta ya mezani ndiyo matokeo ya juu zaidi ya model-kategoria katika utafiti. Watafiti wanajadili kwamba violesura vya kompyuta ya mezani kwa kawaida huunda mpangilio wa kuona ulio wazi zaidi kati ya menyu, eneo la maudhui, upau wa pembeni na maeneo mengine ya kiutendaji, jambo ambalo linaweza kuzipa VLM vidokezo imara vya anga.
Hata hivyo, matokeo hayawezi kufasiriwa kama “skrini rahisi daima ni rahisi zaidi”. Kwa mfano, katika mabango vipengele vya mapambo vinaweza kuathiri umakini wa binadamu kwa njia tofauti na umuhimu wa kisemantiki. Katika violesura vya simu, vipengele vingi vya mwingiliano vinavyoshindana katika eneo dogo la kutazama vinaweza kuongeza tofauti kati ya utabiri wa model na macho ya binadamu.
Kielelezo 1 kinaonyesha nini?
Kielelezo 1 katika ukurasa wa 5 wa utafiti kinaonyesha kwa kulinganisha mifano ya uwakilishi bora zaidi na mbaya zaidi ya GPT-5.4 katika tathmini ya sekunde 7. Katika kila mstari, upande wa kushoto kuna kiolesura asilia cha mtumiaji, katikati ramani ya saliency iliyotabiriwa na model, na upande wa kulia ramani halisi ya ufuatiliaji wa macho ya UEyes.
Katika mfano wa juu wenye mafanikio wa kompyuta ya mezani, eneo ambalo model imejikita linaingiliana kwa kiwango kikubwa na msongamano halisi wa macho ya binadamu. Watafiti wanafafanua mpangilio wa kuona ulio wazi na maeneo ya kiutendaji yaliyotenganishwa katika skrini hii kuwa faida kwa model.
Katika mfano wa chini wa simu, tofauti ni kubwa zaidi. GPT-5.4 inasambaza pointi za umakini kwenye vipengele vingi vya kiolesura ambavyo inaona kuwa muhimu kisemantiki, ilhali data halisi ya macho ya binadamu inajikusanya zaidi katika maeneo maalumu ya mwingiliano. Mfano huu unaonyesha kwa kuona tofauti kati ya jibu la VLM kwa swali “ni vipengele gani vina maana?” na mahali ambapo macho ya binadamu “yanatazama” kwa kweli.
Kwa nini matokeo ya UI-TARS ni muhimu?
Ingawa UI-TARS 1.5 ni model maalumu kwa mwingiliano na kiolesura cha mtumiaji, inashika nafasi ya mwisho kati ya miundo tisa katika utabiri wa macho ya binadamu. Katika matokeo ya jumla ya sekunde 7, inapata CC=0,086 na KL=7,448. Inaelezwa kwamba mkengeuko wa KL kwa kategoria ni kati ya 5,4 na 8,8; CC ya simu inashuka hadi -0,008.
Watafiti wanaeleza matokeo haya kwa ukweli kwamba kazi hizi mbili ni tofauti kimsingi. Wakala wa kiolesura anaweza kujifunza kupata kipengele kinachoweza kubofya au kutekelezwa ili kufuata maagizo. Umakini wa kuona wa binadamu haujumuishi kipengele kimoja cha lengo pekee; unatokana na mchanganyiko wa saliency ya kuona, msongamano wa mpangilio, maana ya kisemantiki na vidokezo vya mwingiliano kwenye skrini nzima.
VLM ya zero-shot si sawa na model maalumu ya umakini
Utafiti unataja kwamba model ya UMSI iliyofunzwa upya kwenye UEyes ilifikia AUC=0,878 katika utafiti wa awali. VLM yenye nguvu zaidi katika UIGaze, kwa upande mwingine, inapata CC=0,408 katika sekunde 7 chini ya hali ya zero-shot.
Si sahihi kulinganisha namba hizi mbili moja kwa moja kwa sababu AUC na CC ni vipimo tofauti. Watafiti pia hawawasilishi kama mashindano ya moja kwa moja ya utendaji. Tofauti ya kisayansi hapa ni kati ya model iliyofunzwa kwa data maalumu ya ufuatiliaji wa macho na VLM ya madhumuni ya jumla inayotumika moja kwa moja bila kufunzwa upya kwa data ya umakini.
Faida ya mbinu ya VLM haipo katika usahihi bali katika kizingiti cha chini cha matumizi: inaweza kutumika kwenye picha mpya ya skrini bila data ya mafunzo ya ufuatiliaji wa macho, mafunzo ya ziada ya model au fine-tuning. Kwa hiyo, watafiti wanaona ramani zinazotegemea VLM si kama mbadala wa jaribio rasmi la mtumiaji, bali kama ishara ya awali ya takriban inayoweza kutumika katika ukaguzi wa mwanzo wa usanifu.
Matokeo yanayoungwa mkono na utafiti
- VLM za kisasa zinaweza kuonyesha ulinganifu unaopimika lakini wa kiwango cha wastani na mgawanyo wa macho ya binadamu kwenye UI katika hali ya zero-shot.
- Ulinganifu na macho ya binadamu kwa ujumla huongezeka kutoka sekunde 1 hadi sekunde 7.
- Tabia hii ya muda inaunga mkono kwamba utabiri wa VLM unafanana zaidi na mgawanyo wa umakini wa uchunguzi na wa kisemantiki kuliko na mwitikio wa kwanza wa haraka wa macho.
- Utendaji wa model hubadilika kulingana na kategoria ya kiolesura.
- Katika baadhi ya violesura vya kompyuta ya mezani vyenye mpangilio wa kuona ulio wazi, ulinganifu wa juu zaidi hupatikana.
- Uwezo wa kufanya kitendo kwenye UI si sawa na uwezo wa kutabiri kwa usahihi mgawanyo wa macho ya binadamu.
- Mbinu inayotegemea VLM inaweza kutoa tathmini ya awali ya takriban ya umakini katika hatua za mwanzo za usanifu ambapo hakuna data halisi ya watumiaji.
Matokeo ambayo utafiti hauungi mkono au haujapima
- Haijaonyeshwa kuwa ramani za saliency za VLM zinaweza kuchukua nafasi ya tafiti halisi za ufuatiliaji wa macho.
- Thamani ya CC=0,408 haimaanishi kwamba macho ya binadamu yamenakiliwa kwa usahihi au kikamilifu.
- Uwezo wa jumla wa kuona-lugha wa model au utendaji wa wakala wa UI hauwezi kuamuliwa kutokana na jaribio hili; utafiti unapima tu ulinganifu wa kitabia na mgawanyo wa umakini wa binadamu.
- Utafiti hautabiri tabia ya macho ya mtumiaji mmoja mmoja; ground truth ni data iliyojumlishwa ya washiriki 62.
- Usahihi wa model haujapimwa kwa kuzingatia umri, utaalamu, utamaduni au sifa nyingine za kidemografia.
- Kwa kuwa prompt moja tu ya zero-shot ilitumika, haijabainishwa jinsi miundo tofauti ya prompt ingebadilisha matokeo.
- VLM na miundo maalumu ya saliency iliyofunzwa hazikulinganishwa katika jaribio la head-to-head lililodhibitiwa kwa vipimo sawa.
- Matokeo hayawezi kuhamishwa moja kwa moja kwa tabia ya umakini ya watumiaji nchini Uturuki.
Mbinu na Matokeo ya Utafiti
Muhtasari wa kiufundi wa muundo wa jaribio
| Kipengele cha jaribio | Thamani au mbinu iliyoripotiwa katika chanzo |
|---|---|
| Mkusanyiko wa data | UEyes |
| Jumla ya picha za UI | 1.980 |
| Idadi ya kategoria | 4 |
| Picha kwa kila kategoria | 495 |
| Washiriki wa ufuatiliaji wa macho | 62 |
| Muda wa jumla wa kutazama | Sekunde 7 |
| Muda wa macho ya binadamu uliotathminiwa | 1 s, 3 s, 7 s |
| Idadi ya VLM | 9 |
| Pointi za macho zilizoombwa kwa kila model | 30–50 |
| Koordinati | x, y na intensity zilizosanifishwa |
| Gaussian blur | \(\sigma=40\) pikseli |
| Marudio kwa kila jozi ya model-picha | 3 |
| Jaribio la awali | Marudio 10 kwenye picha 40 |
| Vipimo vya tathmini | CC, SIM, KL divergence |
| Ufikiaji wa model | OpenRouter API |
| Wakati wa jaribio | April 2026 |
Matokeo ya jumla yenye nguvu zaidi na dhaifu zaidi
Kulingana na ground truth ya sekunde saba, GPT-5.4 inatoa matokeo ya jumla yenye nguvu zaidi katika vipimo vyote vitatu: CC=0,408 ± 0,169, SIM=0,503 ± 0,085 na KL=1,345 ± 0,793.
UI-TARS 1.5, katika tathmini hiyo hiyo, inaonyesha ulinganifu wa chini zaidi kwa jumla ikiwa na CC=0,086 ± 0,171, SIM=0,142 ± 0,143 na KL=7,448 ± 2,580.
Katika ulinganisho huu, “yenye nguvu zaidi” humaanisha ufanano na ramani ya ufuatiliaji wa macho ya binadamu; haimaanishi nafasi ya jumla ya miundo katika kazi nyingine za kuona.
Ufafanuzi wa kiufundi wa matokeo ya muda
Kwa GPT-5.4, mfuatano wa CC ni
\[ 0{,}217\;(1\,s) \rightarrow 0{,}326\;(3\,s) \rightarrow 0{,}408\;(7\,s) \]
.
Kwa Claude Opus 4.6, mfuatano huo huo ni
\[ 0{,}227 \rightarrow 0{,}303 \rightarrow 0{,}344 \]
na kwa Qwen 3.5 Plus ni
\[ 0{,}161 \rightarrow 0{,}245 \rightarrow 0{,}337 \]
. Ongezeko hili la hatua kwa hatua katika miundo mingi linaonyesha kwamba umakini wa anga unaotabiriwa na VLM unazidi kuingiliana na uchunguzi wa muda mrefu wa binadamu.
UI-TARS 1.5 ni tofauti iliyo wazi na mwelekeo huu wa jumla. Kwa kuwa thamani za CC ni 0,078 → 0,101 → 0,086, hakuna maboresho endelevu yanayoonekana katika sekunde 7.
Athari ya kategoria ya kiolesura
Kwa GPT-5.4, thamani ya juu zaidi ya CC kwa kategoria ni 0,506 kwenye kompyuta ya mezani. Qwen 3.5 Plus pia inafikia 0,402 kwenye kompyuta ya mezani, na Claude Opus 4.6 inafikia 0,404. Matokeo haya yanaonyesha kwamba miundo yenye nguvu zaidi inaweza kunasa muundo wa pamoja wa anga na macho ya binadamu kwa kiwango kikubwa zaidi kwenye mipangilio ya kompyuta ya mezani yenye mpangilio wa wazi.
Kwa upande mwingine, athari ya kategoria si sawa katika miundo yote. Kwa mfano, Qwen 3.5 Flash inapata CC=0,312 kwenye violesura vya simu lakini inashuka hadi 0,246 kwenye mabango. Claude Opus 4.6 inaonyesha ulinganifu wa juu kwenye mabango kwa 0,371 kuliko thamani ya simu ya 0,275. Kwa hiyo, hitimisho kwamba kategoria fulani ya UI ni rahisi au ngumu kwa VLM zote halitaungwi mkono.
Kutokuwa na uhakika na mipaka ya majaribio
Majedwali yanaonyesha si wastani tu bali pia mikengeuko ya kawaida, na katika baadhi ya miundo yenye utendaji wa chini, mikengeuko hiyo ni mikubwa ikilinganishwa na ukubwa wa wastani wa CC. Hii inaonyesha kwamba tabia ya model inaweza kutofautiana kwa kiasi kikubwa kutoka picha moja hadi nyingine.
Zaidi ya hayo, utafiti unaeleza wazi mipaka ifuatayo ya kimbinu:
- Prompt moja tu ya zero-shot ilitumika.
- Kubadilisha idadi ya pointi 30–50 za macho zilizoombwa au maneno ya muda hakukujaribiwa.
- Data za UEyes hujumlisha mienendo ya macho ya washiriki 62 na hivyo kuficha tofauti za mtu binafsi.
- Hakuna tathmini tofauti iliyofanywa kulingana na vigezo vya kidemografia kama umri, utaalamu na usuli wa kitamaduni.
- Vipimo vya CC, SIM na KL pekee vilitumika.
- Imeelezwa kwamba vipimo vya ziada kama AUC-Judd na NSS vinaweza kuonyesha vipengele tofauti vya utendaji.
- VLM za zero-shot hazikulinganishwa kwa kudhibitiwa na miundo ya saliency inayotegemea CNN iliyofunzwa kwenye UEyes kwa kutumia vipimo sawa.
Hitimisho kwa matumizi ya vitendo ni lipi?
Watafiti wanaweka utabiri wa umakini unaotegemea VLM si kama mbadala wa majaribio ya ufuatiliaji wa macho, bali kama ishara ya awali yenye gharama ndogo ya kuanza, hasa kwa violesura ambavyo bado havina watumiaji halisi au vilivyo katika hatua ya prototipu ya awali.
Kwa mfano, utabiri wa model unaweza kutumika kubaini maeneo yanayoweza kuwa vipofu kwa umakini katika usanifu kabla ya kufanya jaribio la mtumiaji au kufanya ukaguzi wa haraka wa awali wa kiolesura kabla ya A/B test. Hata hivyo, kwa sababu ya thamani za korelasyon za kiwango cha wastani na udhaifu katika fixation za awali, maamuzi muhimu ya UX kutegemea heatmap ya VLM pekee hayajaungwa mkono na matokeo ya utafiti huu.
Maelezo ya Chanzo na Mbinu
Jina kamili la asili la utafiti: UIGaze: How Closely Can VLMs Approximate Human Visual Attention on User Interfaces?
Waandishi: Min Song, Yoonseong Lee, Yeonhu Seo.
Mpangilio wa waandishi: Min Song → Yoonseong Lee → Yeonhu Seo.
Mchango sawa/uandishi wa kwanza wa pamoja: Katika toleo lililochunguzwa hakuna taarifa ya waandishi wa kwanza wa pamoja au mchango sawa.
Mwandishi wa mawasiliano: Chanzo hakimtaji mwandishi maalumu wazi kama “corresponding author”. Anwani za barua pepe za taasisi za waandishi wote watatu zimetolewa katika sehemu ya kichwa; kwa hiyo, uteuzi usiothibitishwa wa mwandishi wa mawasiliano haujafanywa.
Taasisi: Xebec Inc., South Korea. Taasisi hiyo hiyo imeonyeshwa kwa waandishi wote watatu.
Aina ya chanzo: arXiv preprint.
Hali ya peer review: Kazi hii ni preprint ambayo haijapitia peer review; matokeo yake yanapaswa kutathminiwa kwa kuzingatia hatua hii ya uchapishaji. Kufikia 12 August 2026, ukaguzi huru wa bibliografia rasmi haukuthibitisha toleo la jarida au mkutano lililopitiwa na wataalamu.
arXiv: arXiv:2604.26352v1 [cs.HC].
arXiv DataCite DOI: 10.48550/arXiv.2604.26352. DOI hii ni DOI ya rekodi ya arXiv; haipaswi kufasiriwa kama DOI ya jarida lililopitiwa na wataalamu.
Tarehe ya kuwasilisha: 29 April 2026.
Eneo la mada: Computer Science — Human-Computer Interaction (cs.HC).
Jarida/mkutano: Katika toleo lililochunguzwa hakuna taarifa iliyothibitishwa ya jarida au mkutano uliopitiwa na wataalamu.
Mchapishaji: Hakuna mchapishaji aliyethibitishwa kwa chapisho lililopitiwa na wataalamu; chanzo ni preprint iliyochapishwa kwenye arXiv.
Kiungo rasmi: https://arxiv.org/abs/2604.26352
Leseni: CC BY 4.0 (Creative Commons Attribution 4.0 International). Ikiwa maudhui yatatumika tena au kubadilishwa, nukuu inayofaa na taarifa ya mabadiliko inapaswa kuhifadhiwa.
Upatikanaji wa data na msimbo: Watafiti wanaeleza kwamba wameweka msimbo, utabiri wa model na matokeo ya tathmini hadharani. Anwani ya mradi iliyotolewa katika utafiti: https://github.com/dunward/uigaze
Ufadhili: Katika toleo la kurasa sita lililochunguzwa hakuna sehemu tofauti ya ufadhili au shukrani; kwa kuwa taarifa ya ufadhili haikuthibitishwa, haijaongezwa.
Mgongano wa maslahi: Katika toleo lililochunguzwa hakuna taarifa tofauti ya mgongano wa maslahi. Kutokana na hili haijahitimishwa kwamba waandishi hawana mgongano wa maslahi.
Kizuizi kikuu cha kimbinu: Utafiti unapima ufanano wa anga kati ya data zilizojumlishwa za ufuatiliaji wa macho ya watumiaji halisi na utabiri wa VLM. Hautabiri tabia ya macho ya mtu binafsi. Miundo ilitathminiwa kwa prompt moja ya zero-shot na vipimo vya CC, SIM na KL pekee vilitumika. VLM na miundo ya saliency iliyofunzwa mahsusi kwenye UEyes hazikulinganishwa katika jaribio la head-to-head lililodhibitiwa kwa vipimo sawa.
Tathmini ya kuona: Kielelezo 1 katika ukurasa wa 5 wa utafiti kinaonyesha kwa kulinganisha mifano ya uwakilishi bora na mbaya zaidi ya GPT-5.4 katika tathmini ya sekunde 7 kama UI asilia, utabiri wa VLM na ground truth ya ufuatiliaji wa macho ya UEyes. Katika mfano uliofanikiwa, maeneo ya msongamano wa model na binadamu yanaingiliana zaidi, wakati katika mfano wa kiolesura cha simu chenye msongamano, model inasambaza umakini kwenye vipengele vingi vya kisemantiki na fixation halisi za binadamu zinajikusanya katika maeneo maalumu zaidi.
Chanzo cha data cha Verianla Live: Grafu ya Live katika makala inatumia tu thamani za wastani za CC za sekunde 7 zilizoripotiwa katika Jedwali 2 la utafiti. Hakuna pointi ya data isiyopo kwenye chanzo, interpolation au thamani ya kati iliyoundwa.
Upeo wa maudhui ya kisayansi: Mpangilio wa jaribio, miundo, thamani za nambari, tafsiri na mipaka katika makala hii ya Verianla zinategemea utafiti uliokaguliwa. Uthibitishaji wa nje ulitumika tu kwa vipengele vya bibliografia kama kichwa, waandishi, kitambulisho cha arXiv, DOI, tarehe, hali ya uchapishaji na leseni; hakuna matokeo mapya ya kisayansi yaliyoongezwa kutoka vyanzo vya nje.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *