

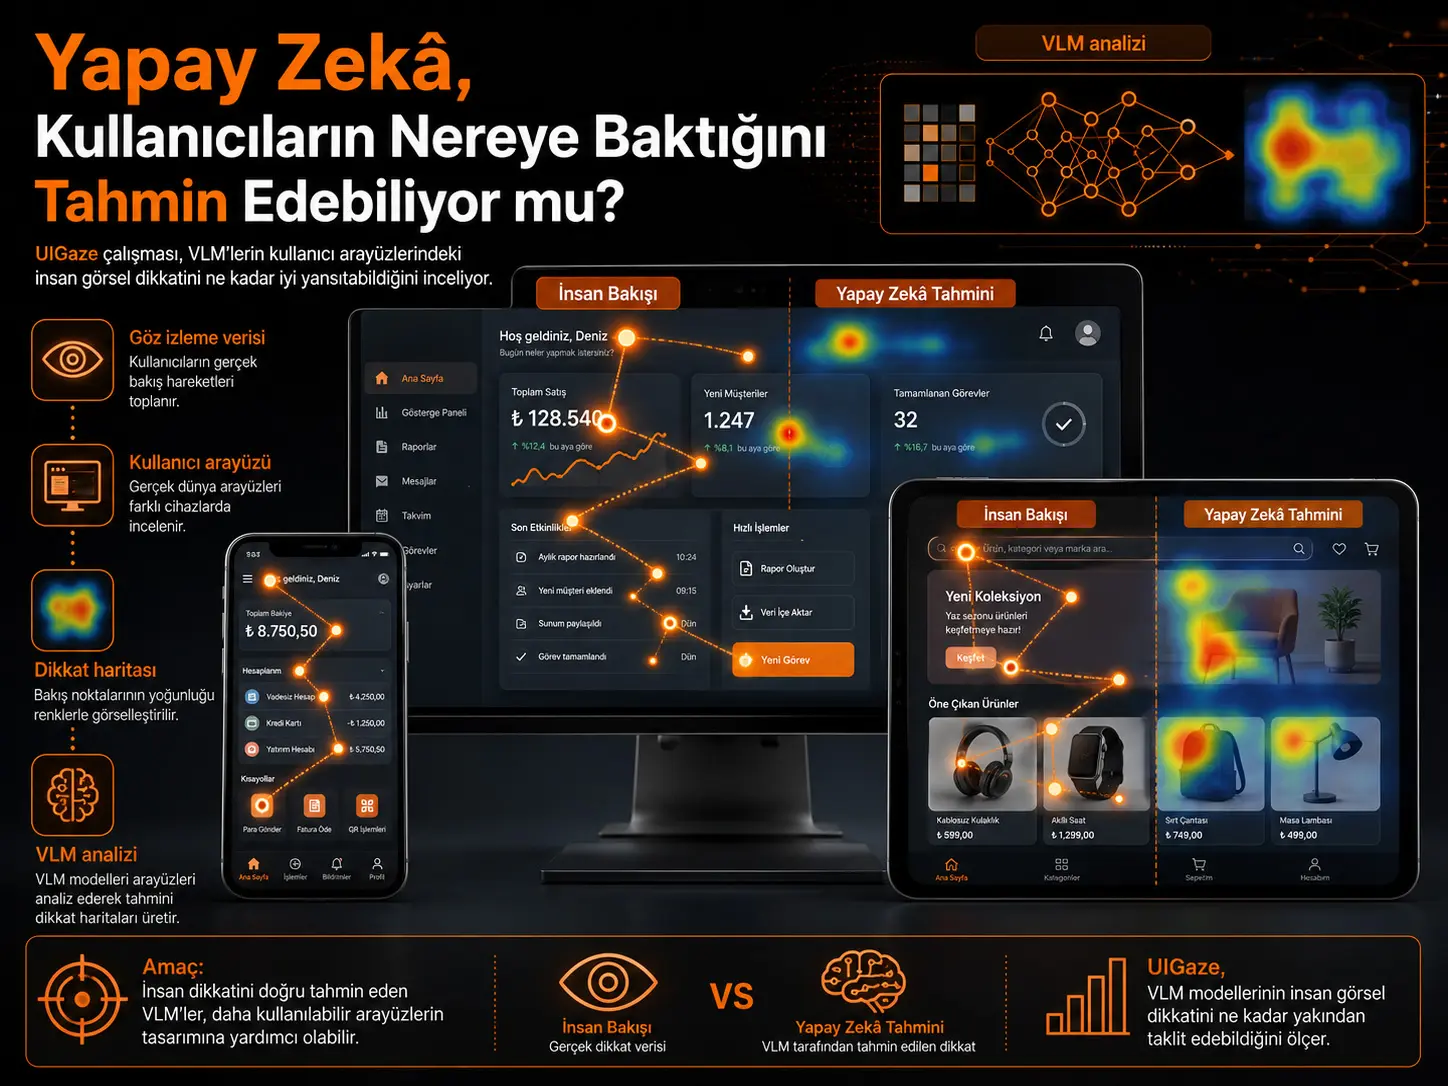
Min Song, Yoonseong Lee ve Yeonhu Seo tarafından geliştirilen UIGaze çalışması, görsel-dil modellerinin (Vision Language Models, VLM) bir kullanıcı arayüzüne bakan insanların görsel dikkat dağılımını gerçek göz izleme verilerine ne ölçüde yaklaştırabildiğini test ediyor. Araştırmada 62 katılımcıdan elde edilen göz izleme verilerini içeren UEyes veri kümesindeki 1.980 kullanıcı arayüzü görüntüsü kullanılıyor; her biri 495 görüntü içeren web sayfası, masaüstü arayüzü, mobil arayüz ve poster olmak üzere dört kategori değerlendiriliyor. Dokuz VLM, herhangi bir göz izleme verisiyle eğitilmeden sıfır-örnekli bir görevde 30–50 bakış noktası tahmin ediyor. Bu noktalar Gauss bulanıklaştırmasıyla belirginlik haritalarına dönüştürülüyor ve insan bakış haritalarıyla CC, SIM ve KL metrikleri üzerinden karşılaştırılıyor. En güçlü genel sonuç 7 saniyelik gözlem süresinde GPT-5.4 tarafından elde ediliyor: CC=0,408, SIM=0,503 ve KL=1,345. Sonuçlar, VLM tahminlerinin insanların ilk bakış sabitlemelerinden çok, arayüzü birkaç saniye inceledikten sonra oluşan keşifsel dikkat davranışına benzediğini gösteriyor. Bununla birlikte göz izleme ile uyum orta düzeyde kalıyor ve modeller gerçek kullanıcı çalışmalarının yerine geçecek doğrulukta gösterilmiyor.
İzleme süresi bu ayrımın en belirgin göstergelerinden biridir. GPT-5.4'ün korelasyon katsayısı 1 saniyelik insan bakış haritasına karşı 0,217 iken 3 saniyede 0,326'ya, 7 saniyede ise 0,408'e yükseliyor. Benzer eğilim modellerin çoğunda görülüyor. Araştırmacılar bunu VLM'lerin görüntünün bütününü analiz ederek semantik açıdan önemli bölgeleri belirlemesine bağlıyor: bu davranış, insan gözünün ilk anda verdiği hızlı yönelim tepkisinden çok zaman içinde gelişen bilinçli ve keşifsel taramaya benziyor.
Arayüz türü de sonuçları önemli ölçüde değiştiriyor. GPT-5.4, 7 saniyelik karşılaştırmada masaüstü arayüzlerinde CC=0,506 ile çalışmadaki tüm model-kategori kombinasyonlarının en yüksek korelasyonuna ulaşıyor. Aynı model mobil arayüzlerde 0,369, posterlerde 0,388 ve web arayüzlerinde 0,371 değerini veriyor. Buna karşılık kullanıcı arayüzlerinde otonom işlem yapmak üzere tasarlanmış UI-TARS 1.5'in genel 7 saniyelik CC değeri yalnızca 0,086; mobil arayüzlerde ise CC=-0,008. Çalışmanın önemli sonuçlarından biri bu nedenle, bir arayüzde hangi öğeye tıklanacağını veya hangi işlemin yapılacağını belirleyebilmenin, insanların nereye baktığını modellemekle aynı yetenek olmadığını göstermesidir.
Türkiye açısından: Çalışma Güney Kore merkezli araştırmacılar tarafından yürütülmüş olmakla birlikte kullanılan UEyes veri kümesi üzerinden yapılan değerlendirme Türkiye'ye özgü kullanıcı davranışını ölçmemektedir. Sonuçlar Türkiye'deki e-ticaret siteleri, kurumsal web arayüzleri, mobil uygulamalar veya kamu hizmeti ekranları için doğrudan kullanıcı davranışı verisi olarak kabul edilmemelidir. Bununla birlikte sıfır-örnekli VLM tabanlı dikkat tahmini, tasarımın erken aşamasında gerçek göz izleme testi yapılmadan önce potansiyel dikkat bölgelerinin ön kontrolünde araştırmaya değer bir araç olabilir. Türk kullanıcılar için geçerliliğin gösterilmesi; dil, okuma yönü, yaş, deneyim, kültürel arka plan ve arayüz alışkanlıklarını içeren yerel göz izleme verileriyle ayrıca doğrulama gerektirir.
Araştırmanın temel sorusu nedir?
Kullanıcı arayüzü tasarımında yalnızca ekranda hangi öğelerin bulunduğu değil, insanların bu öğelerden hangilerine baktığı ve dikkatlerini ekran boyunca nasıl dağıttığı da önemlidir. Göz izleme çalışmalarından elde edilen belirginlik haritaları, başlıkların, düğmelerin, menülerin, görsellerin ve diğer arayüz bileşenlerinin dikkat çekme düzeylerini gösterebilir. Ancak gerçek göz izleme deneyi katılımcı, özel donanım, zaman ve veri toplama altyapısı gerektirir.
UIGaze araştırmasının sorusu bu noktada ortaya çıkıyor: Görüntüleri ve görsel içerikteki anlamı yorumlayabilen güncel VLM'ler, özel olarak göz izleme verisi üzerinde eğitilmeden bir kullanıcı arayüzünde insanların bakması muhtemel bölgeleri tahmin edebilir mi?
Araştırmacılar bunu bir kullanıcı arayüzü öğesi bulma görevi olarak değil, tüm ekran üzerindeki insan bakış dağılımını tahmin etme problemi olarak ele alıyor. Bu ayrım önemlidir. Örneğin bir modele “arama düğmesini bul” denildiğinde belirli bir nesnenin koordinatını bulmak, insanların serbest biçimde baktıkları bir ekranda dikkat yoğunluğunun bütün görüntüye nasıl yayıldığını tahmin etmekle aynı problem değildir.
UEyes veri kümesi neden kullanıldı?
Yer gerçeği olarak UEyes göz izleme veri kümesi kullanılıyor. Veri kümesi toplam 1.980 kullanıcı arayüzü ekran görüntüsünden oluşuyor ve dört kategori eşit biçimde temsil ediliyor:
| Arayüz kategorisi | Görüntü sayısı |
|---|---|
| Web sayfası | 495 |
| Masaüstü kullanıcı arayüzü | 495 |
| Mobil kullanıcı arayüzü | 495 |
| Poster | 495 |
| Toplam | 1.980 |
UEyes verileri 62 katılımcının laboratuvar ortamında yüksek doğruluklu bir göz izleyici kullanılarak toplanmış bakış ölçümlerini içeriyor. Her katılımcı görüntüleri 7 saniye boyunca inceliyor. Veri kümesinde 1, 3 ve 7 saniyelik üç ayrı zaman penceresine karşılık gelen belirginlik haritaları bulunuyor.
Bu üç süre araştırmanın önemli bir parçasıdır. Bir saniyelik harita görüntüyle ilk karşılaşmadaki dikkat davranışına daha yakınken, 7 saniyelik harita kullanıcıya ekranı incelemek için daha fazla zaman tanınmış durumdaki keşifsel görsel davranışı temsil ediyor. UIGaze böylece yalnız “model insana benziyor mu?” sorusunu değil, insan dikkatinin hangi zaman aşamasına daha fazla benzediğini de inceleyebiliyor.
VLM'lerden bakış noktaları nasıl elde edildi?
Araştırmacılar her ekran görüntüsünü bir VLM'ye tek bir sıfır-örnekli istemle gönderiyor. Modelden, insanların bakmasının muhtemel olduğu 30–50 noktayı normalize edilmiş x ve y koordinatları ve her nokta için bir yoğunluk değeriyle üretmesi isteniyor.
İşlem üç temel aşamadan oluşuyor:
- Arayüz görüntüsü VLM'ye gönderiliyor ve modelden bakış koordinatları isteniyor.
- Normalize edilmiş koordinatlar özgün ekran görüntüsünün piksel boyutlarına yansıtılıyor.
- Her noktaya yoğunluk değeriyle ağırlıklandırılmış Gauss bulanıklaştırması uygulanarak sürekli bir belirginlik haritası oluşturuluyor.
Gauss bulanıklaştırmasının standart sapması \(\sigma=40\) piksel olarak belirlenmiştir. Araştırmacılar bu değeri UEyes ısı haritalarının oluşturulma parametreleriyle eşleştirmek ve yaklaşık 1 derecelik görsel açı yaklaşımını korumak amacıyla kullanıyor.
Modelden doğrudan yeni bir ısı haritası görüntüsü çizmesi istenmemesinin de yöntemsel bir nedeni vardır. Üretken görüntü modeli özgün kullanıcı arayüzündeki pikselleri değiştirebilir. Böyle bir durumda model çıktısı ile göz izleme yer gerçeği arasında piksel düzeyinde güvenilir karşılaştırma yapılamaz. Koordinat üretme yaklaşımı özgün arayüz geometrisini değiştirmeden değerlendirme yapılmasına olanak veriyor.
Hangi modeller karşılaştırıldı?
Araştırma, beş sağlayıcıdan dokuz VLM'yi aynı değerlendirme hattında karşılaştırıyor. Çalışmada kullanılan model sürümleri ve anlık görüntü tarihleri şöyledir:
| Sağlayıcı | Model | Çalışmada kullanılan anlık görüntü |
|---|---|---|
| OpenAI | GPT-5.4 | 2026-03-05 |
| OpenAI | GPT-5.4-mini | 2026-03-17 |
| Gemini 3.1 Pro | 2026-02-19 | |
| Gemini 3.1 Flash Lite | 2026-03-03 | |
| Anthropic | Claude Opus 4.6 | 2026-02-05 |
| Anthropic | Claude Sonnet 4.6 | 2026-02-17 |
| Qwen | Qwen 3.5 Plus | 2026-02-16 |
| Qwen | Qwen 3.5 Flash | 2026-02-24 |
| ByteDance | UI-TARS 1.5 | Model tanımlayıcısında tarih belirtilmemiş |
Tüm modeller çalışmada OpenRouter API üzerinden ortak bir arayüzle çalıştırılmıştır. Bu ayrıntı, deneyin farklı model sağlayıcılarını aynı koordinat üretim ve değerlendirme hattına sokması açısından önemlidir.
CC, SIM ve KL neyi ölçüyor?
VLM'nin oluşturduğu belirginlik haritasıyla gerçek insan göz izleme haritası üç standart ölçüt üzerinden karşılaştırılmıştır.
CC (Correlation Coefficient): Tahmin edilen harita ile gerçek haritanın uzamsal desenleri arasındaki doğrusal korelasyonu ölçer. Değerin 1'e yaklaşması daha yüksek benzerlik anlamına gelir.
SIM (Similarity): İki haritayı olasılık dağılımları gibi değerlendirerek ne kadar örtüştüklerini ölçer. 1 değeri aynı dağılımı ifade eder.
KL divergence: Gerçek dikkat dağılımının tahmin edilen dağılımla temsil edilmesi sırasında ortaya çıkan bilgi kaybını ölçer. Burada daha düşük değer daha iyi uyum anlamına gelir.
Bu nedenle CC ve SIM'de yüksek, KL'de düşük değerler tercih edilmektedir.
Deney nasıl tekrarlandı?
1.980 görüntünün her biri dokuz modelle değerlendirilmiş ve model çıktılarındaki değişkenliği hesaba katmak amacıyla her model-görüntü çifti için üç bağımsız çalışma yapılmıştır. Her tahmin ayrıca 1, 3 ve 7 saniyelik insan bakış haritalarının üçüyle karşılaştırılmıştır.
Araştırmacılar üç tekrarın yeterli olup olmadığını belirlemek için 40 görüntülük bir alt kümede 10 tekrarlı pilot deney gerçekleştirmiştir. Üç ve 10 tekrar üzerinden elde edilen ortalama metrikler arasında ihmal edilebilir fark bulunduğu için tam deneyde üç tekrar kullanılmıştır. Deneylerin Nisan 2026'da gerçekleştirildiği belirtilmektedir.
7 saniyede genel performans ne gösteriyor?
Yedi saniyelik insan bakış haritalarına karşı en yüksek uyum GPT-5.4 tarafından elde edilmiştir. Ancak CC=0,408 değeri tam veya çok yüksek bir insan eşleşmesini değil, araştırmacıların da tanımladığı biçimiyle orta düzey bir davranışsal uyumu göstermektedir.
| Model | CC ↑ | SIM ↑ | KL ↓ |
|---|---|---|---|
| GPT-5.4 | 0,408 ± 0,169 | 0,503 ± 0,085 | 1,345 ± 0,793 |
| Claude Opus 4.6 | 0,344 ± 0,200 | 0,468 ± 0,102 | 1,670 ± 0,957 |
| Qwen 3.5 Plus | 0,337 ± 0,167 | 0,466 ± 0,085 | 1,612 ± 0,869 |
| Qwen 3.5 Flash | 0,295 ± 0,171 | 0,424 ± 0,102 | 2,214 ± 1,372 |
| GPT-5.4-mini | 0,289 ± 0,171 | 0,453 ± 0,084 | 1,600 ± 0,918 |
| Claude Sonnet 4.6 | 0,279 ± 0,195 | 0,436 ± 0,110 | 1,924 ± 1,247 |
| Gemini 3.1 Pro | 0,144 ± 0,228 | 0,255 ± 0,196 | 5,457 ± 3,385 |
| Gemini 3.1 Flash Lite | 0,105 ± 0,242 | 0,234 ± 0,216 | 5,823 ± 3,871 |
| UI-TARS 1.5 | 0,086 ± 0,171 | 0,142 ± 0,143 | 7,448 ± 2,580 |
Qwen 3.5 Plus ve Qwen 3.5 Flash için iki görüntüde sürekli yanıt başarısızlığı oluştuğundan bu iki modelin metrikleri 1.980 yerine kalan 1.978 görüntü üzerinden hesaplanmıştır.
İnsan bakışıyla benzerlik neden zamanla artıyor?
Çalışmanın dikkat çekici sonuçlarından biri, hemen hemen bütün modellerde 7 saniyelik bakış dağılımına uyumun 1 saniyelik dağılımdan daha yüksek olmasıdır.
| Model | 1 saniye CC | 3 saniye CC | 7 saniye CC |
|---|---|---|---|
| GPT-5.4 | 0,217 ± 0,143 | 0,326 ± 0,163 | 0,408 ± 0,169 |
| Claude Opus 4.6 | 0,227 ± 0,157 | 0,303 ± 0,181 | 0,344 ± 0,200 |
| Qwen 3.5 Plus | 0,161 ± 0,131 | 0,245 ± 0,162 | 0,337 ± 0,167 |
| Qwen 3.5 Flash | 0,135 ± 0,137 | 0,210 ± 0,162 | 0,295 ± 0,171 |
| GPT-5.4-mini | 0,154 ± 0,133 | 0,220 ± 0,161 | 0,289 ± 0,171 |
| Claude Sonnet 4.6 | 0,142 ± 0,149 | 0,213 ± 0,178 | 0,279 ± 0,195 |
| Gemini 3.1 Pro | 0,059 ± 0,140 | 0,103 ± 0,189 | 0,144 ± 0,228 |
| Gemini 3.1 Flash Lite | 0,038 ± 0,147 | 0,070 ± 0,196 | 0,105 ± 0,242 |
| UI-TARS 1.5 | 0,078 ± 0,153 | 0,101 ± 0,180 | 0,086 ± 0,171 |
GPT-5.4 için 1 saniyeden 7 saniyeye CC artışı göreli olarak %88'dir. Ancak 1 saniyelik ölçümde en yüksek CC GPT-5.4'e değil Claude Opus 4.6'ya aittir: 0,227'ye karşı 0,217. GPT-5.4 daha sonra 3 ve 7 saniyelik değerlendirmelerde öne geçmektedir.
Araştırmacılar bu sonucu, farklı modellerin insan görsel dikkatinin farklı zamansal bileşenlerini değişen düzeylerde yakalayabileceğine ilişkin bir işaret olarak değerlendiriyor. Genel örüntü ise VLM'lerin hızlı ilk sabitlemeden ziyade semantik olarak yönlendirilen keşifsel bakışa yaklaşmasıdır.
Arayüz yapısı sonucu ne kadar değiştiriyor?
Yedi saniyelik CC sonuçları arayüz kategorilerine ayrıldığında model davranışı daha da belirginleşmektedir:
| Model | Masaüstü | Mobil | Poster | Web |
|---|---|---|---|---|
| GPT-5.4 | 0,506 ± 0,156 | 0,369 ± 0,165 | 0,388 ± 0,169 | 0,371 ± 0,145 |
| Claude Opus 4.6 | 0,404 ± 0,193 | 0,275 ± 0,210 | 0,371 ± 0,183 | 0,325 ± 0,191 |
| Qwen 3.5 Plus | 0,402 ± 0,162 | 0,325 ± 0,158 | 0,323 ± 0,182 | 0,298 ± 0,146 |
| GPT-5.4-mini | 0,399 ± 0,168 | 0,230 ± 0,148 | 0,255 ± 0,177 | 0,272 ± 0,134 |
| Claude Sonnet 4.6 | 0,393 ± 0,180 | 0,187 ± 0,203 | 0,270 ± 0,167 | 0,265 ± 0,167 |
| Qwen 3.5 Flash | 0,359 ± 0,185 | 0,312 ± 0,163 | 0,246 ± 0,168 | 0,263 ± 0,145 |
| Gemini 3.1 Pro | 0,220 ± 0,258 | 0,134 ± 0,213 | 0,129 ± 0,208 | 0,093 ± 0,211 |
| Gemini 3.1 Flash Lite | 0,113 ± 0,258 | 0,112 ± 0,250 | 0,186 ± 0,240 | 0,007 ± 0,179 |
| UI-TARS 1.5 | 0,108 ± 0,171 | -0,008 ± 0,111 | 0,169 ± 0,173 | 0,076 ± 0,171 |
GPT-5.4'ün masaüstü arayüzlerindeki 0,506 CC değeri araştırmanın en yüksek model-kategori sonucudur. Araştırmacılar masaüstü arayüzlerinin genellikle menü, içerik alanı, kenar çubuğu ve diğer işlevsel bölgeler arasında daha açık bir görsel hiyerarşi oluşturmasının VLM'lere güçlü uzamsal ipuçları sağlayabileceğini tartışmaktadır.
Bununla birlikte sonuçlar “daha basit ekran her zaman daha kolaydır” biçiminde yorumlanamaz. Örneğin posterlerde dekoratif öğeler semantik önemden farklı biçimde insan dikkatini etkileyebilir. Mobil arayüzlerde ise dar görüntü alanındaki yoğun ve birbirleriyle rekabet eden etkileşim öğeleri model tahminleriyle insan bakışı arasındaki farkı büyütebilir.
Şekil 1 ne gösteriyor?
Çalışmanın 5. sayfasındaki Şekil 1, GPT-5.4'ün 7 saniyelik değerlendirmedeki temsilî en iyi ve en kötü örneklerini yan yana gösteriyor. Her satırda solda özgün kullanıcı arayüzü, ortada model tarafından tahmin edilen belirginlik haritası ve sağda UEyes gerçek göz izleme haritası bulunuyor.
Üstteki başarılı masaüstü örneğinde modelin yoğunlaştırdığı dikkat bölgesi gerçek insan bakış yoğunluğuyla belirgin biçimde örtüşmektedir. Araştırmacılar bu ekranın açık görsel hiyerarşisini ve birbirinden ayrılmış işlevsel bölgelerini model açısından avantaj olarak yorumluyor.
Alttaki mobil örnekte ise fark çok daha büyüktür. GPT-5.4 semantik açıdan önemli gördüğü çok sayıda arayüz öğesine dağınık dikkat noktaları yerleştirirken, gerçek insan bakış verisi belirli etkileşim bölgelerinde daha yoğun kümelenmektedir. Bu örnek, VLM'nin “hangi öğeler anlamlı?” sorusuna verdiği yanıt ile insan gözünün gerçekten “nereye baktığı” arasındaki farkı görsel olarak ortaya koymaktadır.
UI-TARS sonucu neden önemli?
UI-TARS 1.5 kullanıcı arayüzü etkileşimine özel bir model olmasına rağmen insan bakışı tahmininde dokuz modelin son sırasında yer alıyor. Genel 7 saniyelik sonuçta CC=0,086 ve KL=7,448 elde ediyor. Kategorilere göre KL sapmasının 5,4 ile 8,8 arasında olduğu belirtiliyor; mobil CC ise -0,008'e düşüyor.
Araştırmacılar bu sonucu iki görevin temelde farklı olmasıyla açıklıyor. Arayüz ajanı bir talimatı yerine getirmek için tıklanabilir veya işlem yapılabilir öğeyi bulmayı öğrenebilir. İnsan görsel dikkati ise tek bir hedef öğeden ibaret değildir; görsel belirginlik, düzen yoğunluğu, semantik anlam ve etkileşim ipuçlarının tüm ekran üzerindeki bileşimiyle oluşur.
Sıfır-örnekli VLM ile özel dikkat modeli aynı şey değil
Çalışmada UEyes üzerinde yeniden eğitilmiş UMSI modelinin önceki araştırmada AUC=0,878'e ulaştığı aktarılmaktadır. UIGaze'deki en güçlü VLM ise sıfır-örnekli koşulda 7 saniyede CC=0,408 elde etmektedir.
Bu iki sayının doğrudan karşılaştırılması doğru değildir; çünkü AUC ve CC farklı metriklerdir. Araştırmacılar da bunları bire bir performans yarışı olarak sunmuyor. Buradaki bilimsel ayrım, alan-özel göz izleme verisiyle eğitilmiş bir model ile hiçbir dikkat verisiyle yeniden eğitilmeden doğrudan kullanılan genel amaçlı VLM arasındadır.
VLM yaklaşımının avantajı doğrulukta değil, kullanım eşiğinde ortaya çıkmaktadır: göz izleme eğitim verisi, ek model eğitimi veya ince ayar gerektirmeden yeni bir ekran görüntüsüne uygulanabilir. Bu nedenle araştırmacılar VLM tabanlı haritaları resmi kullanıcı testinin yerine değil, erken tasarım incelemesinde kullanılabilecek yaklaşık bir ön sinyal olarak değerlendiriyor.
Çalışmanın desteklediği sonuçlar
- Güncel VLM'ler sıfır-örnekli koşulda insan UI bakış dağılımıyla ölçülebilir fakat orta düzeyde bir uyum gösterebilmektedir.
- İnsan bakışıyla uyum genel olarak 1 saniyeden 7 saniyeye doğru artmaktadır.
- Bu zaman davranışı VLM tahminlerinin ilk refleksif bakıştan çok keşifsel ve semantik dikkat dağılımına benzediğini desteklemektedir.
- Model başarısı arayüz kategorisine göre değişmektedir.
- Açık görsel hiyerarşiye sahip bazı masaüstü arayüzlerinde daha yüksek uyum elde edilmektedir.
- UI'da eylem gerçekleştirme yeteneği insan bakış dağılımını doğru tahmin etme yeteneğiyle eşdeğer değildir.
- VLM tabanlı yaklaşım, gerçek kullanıcı verisi bulunmayan erken tasarım aşamalarında yaklaşık bir dikkat ön değerlendirmesi sağlayabilir.
Çalışmanın desteklemediği veya test etmediği sonuçlar
- VLM belirginlik haritalarının gerçek göz izleme çalışmalarının yerine geçebileceği gösterilmemiştir.
- CC=0,408 değeri insan bakışının doğru veya eksiksiz kopyalandığı anlamına gelmez.
- Bir modelin genel görsel-dil yeteneği veya UI ajanı performansı bu deneyden çıkarılamaz; çalışma yalnız insan dikkat dağılımıyla davranışsal uyumu ölçmektedir.
- Çalışma bireysel kullanıcıların bakış davranışını tahmin etmemektedir; yer gerçeği 62 katılımcının toplulaştırılmış verisidir.
- Yaş, uzmanlık, kültür veya diğer demografik özelliklere göre model doğruluğu test edilmemiştir.
- Tek bir sıfır-örnekli istem kullanıldığı için farklı istem tasarımlarının sonucu nasıl değiştireceği belirlenmemiştir.
- VLM ve özel eğitilmiş belirginlik modelleri aynı metriklerle kontrollü bir başa baş deneyde karşılaştırılmamıştır.
- Sonuçlar Türkiye'deki kullanıcıların dikkat davranışına doğrudan genellenemez.
Çalışmanın Yöntemi ve Bulguları
Deney tasarımının teknik özeti
| Deney bileşeni | Kaynakta verilen değer veya yöntem |
|---|---|
| Veri kümesi | UEyes |
| Toplam UI görüntüsü | 1.980 |
| Kategori sayısı | 4 |
| Kategori başına görüntü | 495 |
| Göz izleme katılımcısı | 62 |
| Toplam izleme süresi | 7 saniye |
| Değerlendirilen insan bakış süreleri | 1 s, 3 s, 7 s |
| VLM sayısı | 9 |
| Model başına istenen bakış noktası | 30–50 |
| Koordinatlar | Normalize edilmiş x, y ve yoğunluk |
| Gauss bulanıklaştırma | \(\sigma=40\) piksel |
| Her model-görüntü çifti için tekrar | 3 |
| Pilot deney | 40 görüntü üzerinde 10 tekrar |
| Değerlendirme metrikleri | CC, SIM, KL divergence |
| Model erişimi | OpenRouter API |
| Deney zamanı | Nisan 2026 |
En güçlü ve en zayıf genel sonuç
Yedi saniyelik yer gerçeğine göre GPT-5.4 üç metriğin tamamında en güçlü genel sonucu vermektedir: CC=0,408 ± 0,169, SIM=0,503 ± 0,085 ve KL=1,345 ± 0,793.
UI-TARS 1.5 ise aynı değerlendirmede CC=0,086 ± 0,171, SIM=0,142 ± 0,143 ve KL=7,448 ± 2,580 ile en düşük genel uyumu göstermektedir.
Bu karşılaştırmada “en güçlü” ifadesi insan göz izleme haritasıyla benzerliği ifade eder; modellerin başka görsel görevlerdeki genel performans sıralaması anlamına gelmez.
Zamansal sonuçların teknik yorumu
GPT-5.4 için CC sıralaması
\[ 0{,}217\;(1\,s) \rightarrow 0{,}326\;(3\,s) \rightarrow 0{,}408\;(7\,s) \]
şeklindedir.
Claude Opus 4.6 için aynı sıra
\[ 0{,}227 \rightarrow 0{,}303 \rightarrow 0{,}344 \]
ve Qwen 3.5 Plus için
\[ 0{,}161 \rightarrow 0{,}245 \rightarrow 0{,}337 \]
olarak verilmiştir. Çoğu modeldeki bu monoton artış, VLM'nin tahmin ettiği uzamsal dikkatin daha uzun süreli insan taramasıyla giderek daha fazla örtüştüğünü göstermektedir.
UI-TARS 1.5 bu genel örüntünün belirgin istisnasıdır. CC değerleri 0,078 → 0,101 → 0,086 olduğundan 7 saniyede sürekli bir iyileşme görülmemektedir.
Arayüz kategorisinin etkisi
GPT-5.4'te en yüksek kategori CC değeri masaüstünde 0,506'dır. Qwen 3.5 Plus da masaüstünde 0,402'ye, Claude Opus 4.6 ise 0,404'e ulaşmaktadır. Bu sonuç, en güçlü modellerin açık hiyerarşiye sahip masaüstü düzenlerinde insan bakışıyla daha yüksek ortak uzamsal yapı yakalayabildiğini göstermektedir.
Buna karşılık kategori etkisi bütün modellerde aynı değildir. Örneğin Qwen 3.5 Flash mobil arayüzlerde CC=0,312 elde ederken posterlerde 0,246'ya düşmektedir. Claude Opus 4.6 ise posterlerde 0,371 ile mobildeki 0,275 değerinden daha yüksek uyum göstermektedir. Dolayısıyla belirli bir UI kategorisinin tüm VLM'ler için evrensel olarak kolay veya zor olduğu sonucu desteklenmemektedir.
Belirsizlik ve deneysel sınırlamalar
Tablolarda yalnız ortalamalar değil standart sapmalar da verilmiştir ve bazı düşük performanslı modellerde standart sapmalar ortalama CC büyüklüğüne kıyasla oldukça yüksektir. Bu durum görüntüler arasında model davranışının önemli ölçüde değişebildiğini göstermektedir.
Ayrıca çalışma şu yöntemsel sınırlılıkları açıkça belirtmektedir:
- Yalnız bir sıfır-örnekli istem kullanılmıştır.
- İstenen 30–50 bakış noktası sayısının veya zamansal ifadelerin değiştirilmesi test edilmemiştir.
- UEyes verisi 62 katılımcının göz hareketlerini toplulaştırır ve bireysel farklılıkları görünmez hale getirir.
- Yaş, uzmanlık ve kültürel arka plan gibi demografik değişkenlere göre ayrı değerlendirme yapılmamıştır.
- Yalnız CC, SIM ve KL metrikleri kullanılmıştır.
- AUC-Judd ve NSS gibi ek metriklerin farklı performans boyutlarını gösterebileceği belirtilmektedir.
- Sıfır-örnekli VLM'lerle UEyes üzerinde eğitilmiş CNN tabanlı belirginlik modelleri aynı metrikler kullanılarak kontrollü biçimde karşılaştırılmamıştır.
Pratik kullanım açısından sonuç ne?
Araştırmacılar VLM tabanlı dikkat tahminini göz izleme deneylerinin alternatifi olarak değil, özellikle henüz gerçek kullanıcısı olmayan veya erken prototip aşamasındaki arayüzler için düşük giriş maliyetli bir ön sinyal olarak konumlandırmaktadır.
Örneğin model tahminleri, kullanıcı testi yapılmadan önce tasarımda olası dikkat kör noktalarının belirlenmesi veya A/B testinden önce arayüzün hızlı bir ön kontrolden geçirilmesi için kullanılabilir. Ancak orta düzeydeki korelasyon değerleri ve ilk sabitlemelerdeki zayıflık nedeniyle kritik UX kararlarının yalnız VLM ısı haritasına dayandırılması bu çalışmanın sonuçları tarafından desteklenmemektedir.
Kaynak ve Yöntem Notu
Tam özgün çalışma adı: UIGaze: How Closely Can VLMs Approximate Human Visual Attention on User Interfaces?
Yazarlar: Min Song, Yoonseong Lee, Yeonhu Seo.
Yazar sırası: Min Song → Yoonseong Lee → Yeonhu Seo.
Eş katkı/eş birinci yazar: İncelenen sürümde eş birinci yazar veya eş katkı beyanı yer almamaktadır.
Sorumlu yazar: Kaynak belirli bir yazarı açıkça “corresponding author” olarak tanımlamamaktadır. Üç yazarın da kurumsal e-posta adresleri başlık bölümünde verilmiştir; bu nedenle doğrulanmamış bir sorumlu yazar ataması yapılmamıştır.
Kurum: Xebec Inc., South Korea. Üç yazar için de aynı kurum gösterilmiştir.
Kaynak türü: arXiv preprint.
Hakemlik durumu: Bu çalışma hakem değerlendirmesinden geçmemiş bir preprinttir; sonuçları bu yayın aşaması dikkate alınarak değerlendirilmelidir. 12 Ağustos 2026 itibarıyla bağımsız resmî bibliyografik kontrolde hakemli dergi veya konferans sürümü doğrulanamamıştır.
arXiv: arXiv:2604.26352v1 [cs.HC].
arXiv DataCite DOI: 10.48550/arXiv.2604.26352. Bu DOI arXiv kaydının DOI'sidir; hakemli bir dergi DOI'si olarak yorumlanmamalıdır.
Gönderim tarihi: 29 Nisan 2026.
Konu alanı: Computer Science — Human-Computer Interaction (cs.HC).
Dergi/konferans: İncelenen sürümde doğrulanmış hakemli dergi veya konferans bilgisi bulunmamaktadır.
Yayınevi: Hakemli yayın için doğrulanmış bir yayınevi bulunmamaktadır; kaynak arXiv üzerinde yayımlanan ön baskıdır.
Resmî bağlantı: https://arxiv.org/abs/2604.26352
Lisans: CC BY 4.0 (Creative Commons Attribution 4.0 International). Yeniden kullanım ve uyarlama yapılması halinde uygun atıf ve değişiklik bilgisinin korunması gerekir.
Veri ve kod erişilebilirliği: Araştırmacılar kodu, model tahminlerini ve değerlendirme sonuçlarını herkese açık olarak sağladıklarını belirtmektedir. Çalışmada verilen proje adresi: https://github.com/dunward/uigaze
Finansman: İncelenen altı sayfalık sürümde ayrı bir finansman veya teşekkür bölümü bulunmamaktadır; finansman bilgisi doğrulanamadığı için eklenmemiştir.
Çıkar çatışması: İncelenen sürümde ayrı bir çıkar çatışması beyanı bulunmamaktadır. Bundan yazarların çıkar çatışmasının bulunmadığı sonucu çıkarılmamıştır.
Temel yöntemsel sınırlılık: Çalışma gerçek kullanıcıların toplulaştırılmış göz izleme verileriyle VLM tahminleri arasındaki uzamsal benzerliği ölçmektedir. Bireysel bakış davranışını tahmin etmez. Modeller tek bir sıfır-örnekli istemle değerlendirilmiştir ve yalnız CC, SIM ve KL metrikleri kullanılmıştır. VLM'ler ile özel olarak UEyes üzerinde eğitilmiş saliency modelleri aynı metriklerle kontrollü başa baş deneyde karşılaştırılmamıştır.
Görsel değerlendirme: Çalışmanın 5. sayfasındaki Şekil 1, GPT-5.4'ün 7 saniyelik değerlendirmede temsilî en iyi ve en kötü örneklerini özgün UI, VLM tahmini ve UEyes göz izleme yer gerçeği biçiminde yan yana göstermektedir. Başarılı örnekte model ile insan yoğunluk bölgeleri daha fazla örtüşürken, yoğun mobil arayüz örneğinde model çok sayıda semantik öğeye dağınık dikkat atamakta ve gerçek insan sabitlemeleri daha belirli bölgelerde yoğunlaşmaktadır.
Verianla Live veri kaynağı: Makaledeki Live grafik yalnız çalışmanın Tablo 2'sinde raporlanan 7 saniyelik ortalama CC değerlerini kullanmaktadır. Kaynakta olmayan veri noktası, interpolasyon veya ara değer oluşturulmamıştır.
Bilimsel içerik sınırı: Bu Verianla makalesindeki deney düzeni, modeller, sayısal değerler, yorumlar ve sınırlılıklar incelenen çalışmaya dayanmaktadır. Dış doğrulama yalnız başlık, yazarlar, arXiv kimliği, DOI, tarih, yayın durumu ve lisans gibi bibliyografik alanlar için kullanılmış; dış kaynaklardan yeni bilimsel bulgu eklenmemiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir