

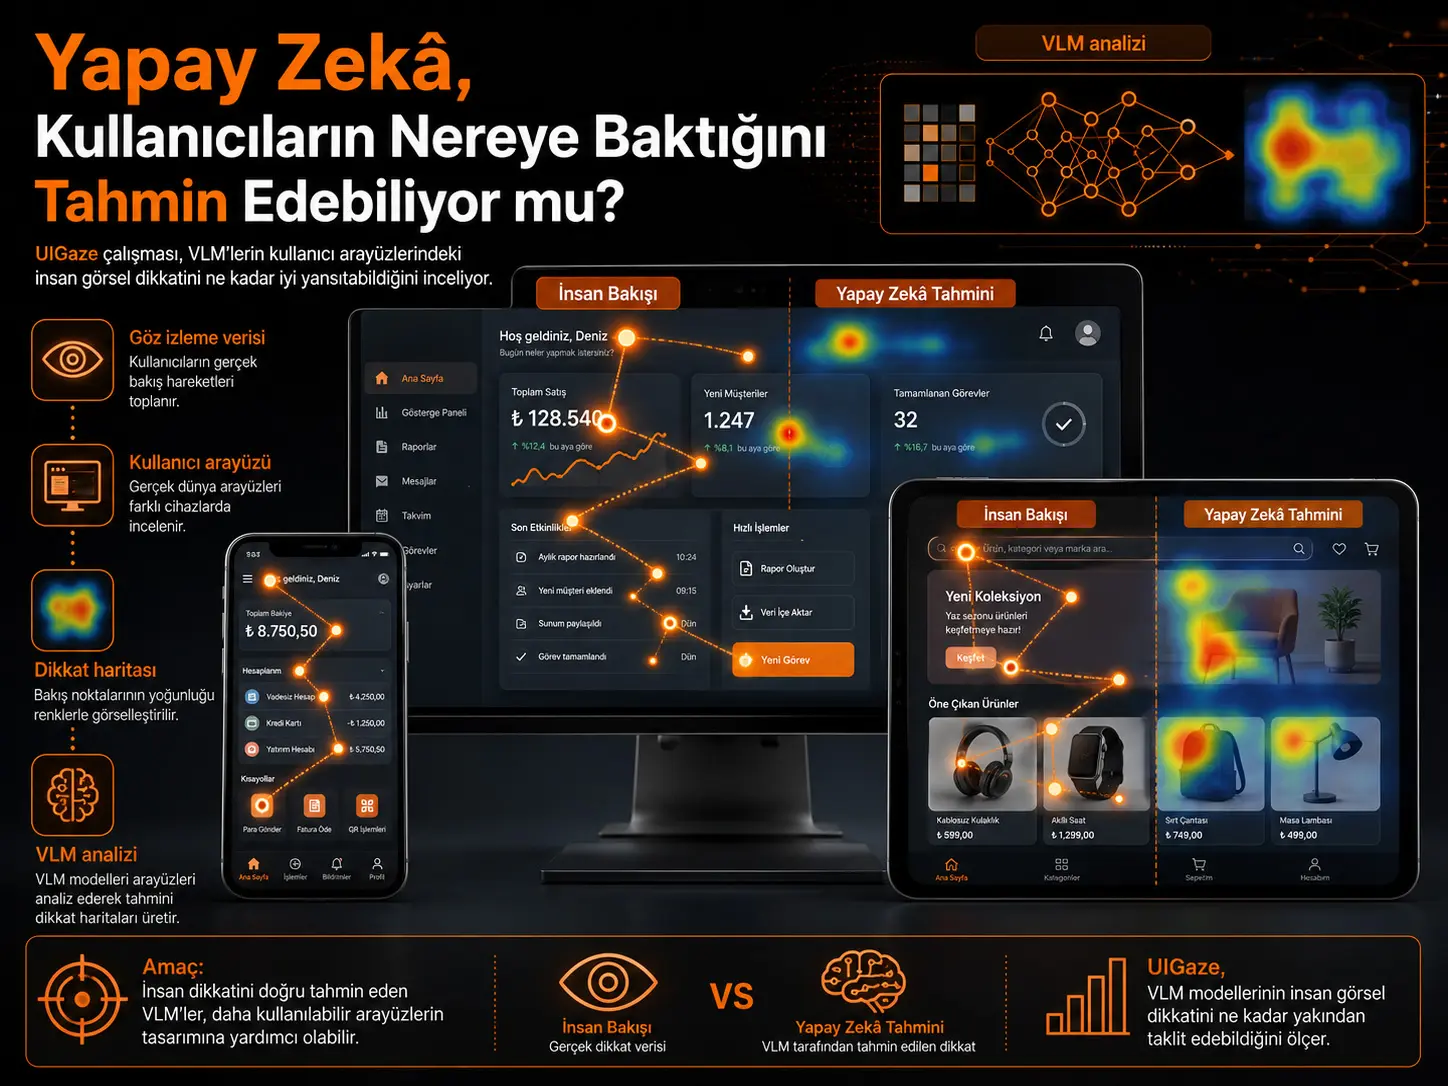
Min Song, Yoonseong Lee жана Yeonhu Seo тарабынан иштелип чыккан UIGaze изилдөөсү көрүү-тил моделдери (Vision Language Models, VLM) колдонуучу интерфейсин караган адамдардын визуалдык көңүл бөлүштүрүүсүн реалдуу көз кыймылын байкоо маалыматтарына канчалык жакын моделдей аларын текшерет. Изилдөөдө 62 катышуучудан алынган көз кыймылын байкоо маалыматтарын камтыган UEyes маалымат топтомундагы 1.980 колдонуучу интерфейсинин сүрөтү колдонулат; ар биринде 495 сүрөттөн турган веб-баракча, иш такта интерфейси, мобилдик интерфейс жана постер болуп төрт категория бааланат. Тогуз VLM көз кыймылын байкоо маалыматтары менен атайын үйрөтүлбөстөн нөл-нуска режиминдеги тапшырмада 30–50 көз караш чекитин болжолдойт. Бул чекиттер Гаусс бүдөмүктөтүүсү аркылуу салiency карталарына айландырылып, адамдын көз караш карталары менен CC, SIM жана KL метрикалары боюнча салыштырылат. Жалпы эң күчтүү натыйжа 7 секунддук байкоо мөөнөтүндө GPT-5.4 тарабынан алынат: CC=0,408, SIM=0,503 жана KL=1,345. Жыйынтыктар VLM болжолдоолору адамдардын алгачкы көз токтотууларынан көрө, интерфейсти бир нече секунд карап чыккандан кийин калыптанган изилдөөчү көңүл жүрүм-турумуна көбүрөөк окшош экенин көрсөтөт. Ошол эле учурда көз кыймылын байкоо менен дал келүү орточо деңгээлде калат жана моделдер реалдуу колдонуучу изилдөөлөрүн алмаштыра турган тактыкка жеткени көрсөтүлгөн эмес.
Байкоо мөөнөтү бул айырманын эң айкын көрсөткүчтөрүнүн бири. GPT-5.4 моделинин корреляция коэффициенти 1 секунддук адам көз караш картасына салыштырганда 0,217 болсо, 3 секундда 0,326-га, 7 секундда 0,408-ге көтөрүлөт. Окшош тенденция моделдердин көбүндө көрүнөт. Изилдөөчүлөр муну VLM сүрөттүн бүтүндөй мазмунун талдап, семантикалык жактан маанилүү аймактарды аныкташы менен байланыштырышат: мындай жүрүм-турум адам көзүнүн биринчи көз ирмемдеги тез багыт алуу реакциясынан көрө, убакыт өтүшү менен өнүккөн аң-сезимдүү жана изилдөөчү сканга көбүрөөк окшош.
Интерфейстин түрү да жыйынтыктарды олуттуу өзгөртөт. GPT-5.4, 7 секунддук салыштырууда иш такта интерфейстеринде CC=0,506 менен изилдөөдөгү бардык модель-категория айкалыштарынын эң жогорку корреляциясына жетет. Ошол эле модель мобилдик интерфейстерде 0,369, постерлерде 0,388 жана веб-интерфейстерде 0,371 натыйжа берет. Ал эми колдонуучу интерфейстеринде автономдуу аракет жасоо үчүн түзүлгөн UI-TARS 1.5 моделинин жалпы 7 секунддук CC мааниси болгону 0,086; мобилдик интерфейстерде болсо CC=-0,008. Ошондуктан изилдөөнүн маанилүү жыйынтыктарынын бири — интерфейсте кайсы элементти басуу же кайсы аракетти аткаруу керек экенин аныктоо жөндөмү адамдар кайда карай турганын моделдөө жөндөмү менен бирдей эмес экенин көрсөтүшү.
Түркия жагынан: Изилдөө Түштүк Кореядагы изилдөөчүлөр тарабынан жүргүзүлгөнү менен, колдонулган UEyes маалымат топтому аркылуу жасалган баалоо Түркияга мүнөздүү колдонуучу жүрүм-турумун өлчөбөйт. Жыйынтыктар Түркиядагы электрондук соода сайттары, корпоративдик веб-интерфейстер, мобилдик колдонмолор же мамлекеттик кызмат экрандары үчүн түз колдонуучу жүрүм-туруму маалыматтары катары кабыл алынбашы керек. Бирок нөл-нуска VLM негизиндеги көңүл болжолдоосу дизайн баштапкы этапта турганда, реалдуу көз кыймылын байкоо тести жүргүзүлө электе потенциалдуу көңүл аймактарын алдын ала текшерүүчү изилдөө куралы болушу мүмкүн. Түрк колдонуучулары үчүн жарактуулугун көрсөтүү тилди, окуу багытын, жашты, тажрыйбаны, маданий фонду жана интерфейс адаттарын камтыган жергиликтүү көз кыймылын байкоо маалыматтары менен өзүнчө текшерүүнү талап кылат.
Изилдөөнүн негизги суроосу эмне?
Колдонуучу интерфейсинин дизайнында экранда кайсы элементтер бар экени гана эмес, адамдар алардын кайсынысына карай турганы жана көңүлүн экран боюнча кандай бөлүштүрөрү да маанилүү. Көз кыймылын байкоо изилдөөлөрүнөн алынган saliency карталары аталыштардын, баскычтардын, менюлардын, сүрөттөрдүн жана башка интерфейс компоненттеринин көңүл тартуу деңгээлин көрсөтө алат. Бирок реалдуу көз кыймылын байкоо эксперименти катышуучуларды, атайын жабдууну, убакытты жана маалымат топтоо инфраструктурасын талап кылат.
UIGaze изилдөөсүнүн суроосу дал ушул жерден чыгат: сүрөттөрдү жана визуалдык мазмундагы маанини чечмелей алган заманбап VLM моделдери көз кыймылын байкоо маалыматтарында атайын үйрөтүлбөстөн колдонуучу интерфейсинде адамдар карашы мүмкүн болгон аймактарды болжолдой алабы?
Изилдөөчүлөр муну интерфейстеги бир элементти табуу тапшырмасы катары эмес, бүт экрандагы адам көз карашынын бөлүштүрүлүшүн болжолдоо көйгөйү катары карашат. Бул айырма маанилүү. Мисалы, моделге “издөө баскычын тап” деп айтканда белгилүү объекттин координатын табуу, адамдар эркин караган экранда көңүл тыгыздыгы бүт сүрөт боюнча кандай тарай турганын болжолдоо менен бир көйгөй эмес.
UEyes маалымат топтому эмне үчүн колдонулган?
Ground truth катары UEyes көз кыймылын байкоо маалымат топтому колдонулат. Маалымат топтому жалпы 1.980 колдонуучу интерфейсинин скриншотунан турат жана төрт категория тең өлчөмдө берилген:
| Интерфейс категориясы | Сүрөт саны |
|---|---|
| Веб-баракча | 495 |
| Иш такта колдонуучу интерфейси | 495 |
| Мобилдик колдонуучу интерфейси | 495 |
| Постер | 495 |
| Жалпы | 1.980 |
UEyes маалыматтары 62 катышуучунун лабораториялык шартта жогорку тактыктагы көз трекери менен топтолгон көз караш өлчөөлөрүн камтыйт. Ар бир катышуучу сүрөттөрдү 7 секунд карайт. Маалымат топтомунда 1, 3 жана 7 секунддук үч өзүнчө убакыт терезесине туура келген saliency карталары бар.
Бул үч мөөнөт изилдөөнүн маанилүү бөлүгү. Бир секунддук карта сүрөт менен биринчи жолу кездешкендеги көңүл жүрүм-турумуна жакыныраак болсо, 7 секунддук карта колдонуучуга экранды изилдөөгө көбүрөөк убакыт берилгендеги изилдөөчү визуалдык жүрүм-турумду чагылдырат. Ошентип UIGaze “модель адамга окшошпу?” деген суроону гана эмес, адам көңүлүнүн кайсы убакыт баскычына көбүрөөк окшош экенин да изилдей алат.
VLM моделдеринен көз караш чекиттери кантип алынган?
Изилдөөчүлөр ар бир скриншотту VLM моделине бир гана нөл-нуска prompt менен жөнөтүшөт. Моделден адамдар карашы ыктымал болгон 30–50 чекитти нормалдаштырылган x жана y координаттары жана ар бир чекит үчүн интенсивдүүлүк мааниси менен чыгаруу талап кылынат.
Процесс үч негизги баскычтан турат:
- Интерфейс сүрөтү VLM моделине берилет жана көз караш координаттары суралат.
- Нормалдаштырылган координаттар түпнуска скриншоттун пиксел өлчөмүнө которулат.
- Ар бир чекитке интенсивдүүлүк менен салмакталган Гаусс бүдөмүктөтүүсү колдонулуп, үзгүлтүксүз saliency картасы түзүлөт.
Гаусс бүдөмүктөтүүсүнүн стандарттык четтөөсү \(\sigma=40\) пиксел деп белгиленген. Изилдөөчүлөр бул маанини UEyes heatmap түзүү параметрлерине шайкеш келтирүү жана болжол менен 1 даражалык визуалдык бурч жакындашуусун сактоо үчүн колдонушат.
Моделден түз эле жаңы heatmap сүрөтүн тартууну сурабоонун методологиялык себеби да бар. Генеративдик сүрөт модели түпнуска интерфейстеги пикселдерди өзгөртүп жибериши мүмкүн. Андай учурда модель чыгышы менен көз кыймылын байкоонун ground truth картасын пиксел деңгээлинде ишенимдүү салыштыруу мүмкүн болбой калат. Координат чыгаруу ыкмасы түпнуска интерфейс геометриясын өзгөртпөстөн баалоого шарт түзөт.
Кайсы моделдер салыштырылган?
Изилдөө беш провайдерден тогуз VLM моделин бирдей баалоо pipeline ичинде салыштырат. Изилдөөдө колдонулган модель версиялары жана snapshot даталары төмөнкүдөй:
| Провайдер | Модель | Изилдөөдө колдонулган snapshot |
|---|---|---|
| OpenAI | GPT-5.4 | 2026-03-05 |
| OpenAI | GPT-5.4-mini | 2026-03-17 |
| Gemini 3.1 Pro | 2026-02-19 | |
| Gemini 3.1 Flash Lite | 2026-03-03 | |
| Anthropic | Claude Opus 4.6 | 2026-02-05 |
| Anthropic | Claude Sonnet 4.6 | 2026-02-17 |
| Qwen | Qwen 3.5 Plus | 2026-02-16 |
| Qwen | Qwen 3.5 Flash | 2026-02-24 |
| ByteDance | UI-TARS 1.5 | Модель идентификаторунда дата көрсөтүлгөн эмес |
Бардык моделдер изилдөөдө OpenRouter API аркылуу бирдиктүү интерфейсте иштетилген. Бул жагдай ар кайсы модель провайдерлерин бирдей координат чыгаруу жана баалоо pipeline ичине киргизүү жагынан маанилүү.
CC, SIM жана KL эмнени өлчөйт?
VLM түзгөн saliency картасы менен реалдуу адамдын көз кыймылын байкоо картасы үч стандарттуу өлчөм боюнча салыштырылган.
CC (Correlation Coefficient): Болжолдонгон карта менен реалдуу картанын мейкиндик үлгүлөрүнүн ортосундагы сызыктуу корреляцияны өлчөйт. Маани 1-ге жакындаган сайын окшоштук жогорулайт.
SIM (Similarity): Эки картаны ыктымалдык бөлүштүрүүлөрү катары карап, канчалык дал келерин өлчөйт. 1 мааниси бирдей бөлүштүрүүнү билдирет.
KL divergence: Реалдуу көңүл бөлүштүрүүсүн болжолдонгон бөлүштүрүү менен көрсөтүүдө пайда болгон маалымат жоготуусун өлчөйт. Бул жерде төмөнкү маани жакшыраак дал келүүнү билдирет.
Ошондуктан CC жана SIM үчүн жогору, KL үчүн төмөн маанилер артык.
Эксперимент кандай кайталанган?
1.980 сүрөттүн ар бири тогуз модель менен бааланып, модель чыгышындагы өзгөрмөлүүлүктү эске алуу үчүн ар бир модель-сүрөт жуптугуна үч көз карандысыз иштетүү жүргүзүлгөн. Ар бир болжол ошондой эле 1, 3 жана 7 секунддук адам көз караш карталарынын үчөөнө салыштырылган.
Изилдөөчүлөр үч кайталоо жетиштүүбү же жокпу аныктоо үчүн 40 сүрөттүк кичи топтомдо 10 кайталоолуу пилоттук эксперимент жүргүзүшкөн. Үч жана 10 кайталоо боюнча алынган орточо метрикалардын айырмасы өтө аз болгондуктан, толук экспериментте үч кайталоо колдонулган. Эксперименттер Апрель 2026 мезгилинде жүргүзүлгөнү айтылат.
7 секунддагы жалпы натыйжа эмнени көрсөтөт?
Жети секунддук адам көз караш карталарына салыштырганда эң жогорку дал келүү GPT-5.4 тарабынан алынган. Бирок CC=0,408 мааниси толук же өтө жогорку адамга окшоштукту эмес, изилдөөчүлөр сүрөттөгөндөй орточо деңгээлдеги жүрүм-турумдук дал келүүнү көрсөтөт.
| Модель | CC ↑ | SIM ↑ | KL ↓ |
|---|---|---|---|
| GPT-5.4 | 0,408 ± 0,169 | 0,503 ± 0,085 | 1,345 ± 0,793 |
| Claude Opus 4.6 | 0,344 ± 0,200 | 0,468 ± 0,102 | 1,670 ± 0,957 |
| Qwen 3.5 Plus | 0,337 ± 0,167 | 0,466 ± 0,085 | 1,612 ± 0,869 |
| Qwen 3.5 Flash | 0,295 ± 0,171 | 0,424 ± 0,102 | 2,214 ± 1,372 |
| GPT-5.4-mini | 0,289 ± 0,171 | 0,453 ± 0,084 | 1,600 ± 0,918 |
| Claude Sonnet 4.6 | 0,279 ± 0,195 | 0,436 ± 0,110 | 1,924 ± 1,247 |
| Gemini 3.1 Pro | 0,144 ± 0,228 | 0,255 ± 0,196 | 5,457 ± 3,385 |
| Gemini 3.1 Flash Lite | 0,105 ± 0,242 | 0,234 ± 0,216 | 5,823 ± 3,871 |
| UI-TARS 1.5 | 0,086 ± 0,171 | 0,142 ± 0,143 | 7,448 ± 2,580 |
Qwen 3.5 Plus жана Qwen 3.5 Flash үчүн эки сүрөттө туруктуу жооп бербей калуу болгондуктан, бул эки моделдин метрикалары 1.980 ордуна калган 1.978 сүрөт боюнча эсептелген.
Адамдын көз карашына окшоштук эмне үчүн убакыт өткөн сайын өсөт?
Изилдөөнүн кызыктуу жыйынтыктарынын бири — дээрлик бардык моделдерде 7 секунддук көз караш бөлүштүрүүсүнө дал келүү 1 секунддук бөлүштүрүүдөн жогору болушу.
| Модель | 1 секунд CC | 3 секунд CC | 7 секунд CC |
|---|---|---|---|
| GPT-5.4 | 0,217 ± 0,143 | 0,326 ± 0,163 | 0,408 ± 0,169 |
| Claude Opus 4.6 | 0,227 ± 0,157 | 0,303 ± 0,181 | 0,344 ± 0,200 |
| Qwen 3.5 Plus | 0,161 ± 0,131 | 0,245 ± 0,162 | 0,337 ± 0,167 |
| Qwen 3.5 Flash | 0,135 ± 0,137 | 0,210 ± 0,162 | 0,295 ± 0,171 |
| GPT-5.4-mini | 0,154 ± 0,133 | 0,220 ± 0,161 | 0,289 ± 0,171 |
| Claude Sonnet 4.6 | 0,142 ± 0,149 | 0,213 ± 0,178 | 0,279 ± 0,195 |
| Gemini 3.1 Pro | 0,059 ± 0,140 | 0,103 ± 0,189 | 0,144 ± 0,228 |
| Gemini 3.1 Flash Lite | 0,038 ± 0,147 | 0,070 ± 0,196 | 0,105 ± 0,242 |
| UI-TARS 1.5 | 0,078 ± 0,153 | 0,101 ± 0,180 | 0,086 ± 0,171 |
GPT-5.4 үчүн 1 секунддан 7 секундга CC өсүшү салыштырмалуу %88. Бирок 1 секунддук өлчөөдө эң жогорку CC GPT-5.4 эмес, Claude Opus 4.6 моделине таандык: 0,227 каршы 0,217. GPT-5.4 кийин 3 жана 7 секунддук баалоолордо алдыга чыгат.
Изилдөөчүлөр бул жыйынтыкты ар башка моделдер адамдын визуалдык көңүлүнүн ар башка убакыттык компоненттерин ар кандай деңгээлде кармай аларына белги катары карашат. Жалпы үлгү болсо VLM болжолдору тез биринчи фиксацияга караганда семантикалык багытталган изилдөөчү көз карашка көбүрөөк жакындаарын көрсөтөт.
Интерфейс түзүмү жыйынтыкты канчалык өзгөртөт?
Жети секунддук CC жыйынтыктары интерфейс категориялары боюнча бөлүнгөндө модель жүрүм-туруму андан да ачык көрүнөт:
| Модель | Иш такта | Мобилдик | Постер | Веб |
|---|---|---|---|---|
| GPT-5.4 | 0,506 ± 0,156 | 0,369 ± 0,165 | 0,388 ± 0,169 | 0,371 ± 0,145 |
| Claude Opus 4.6 | 0,404 ± 0,193 | 0,275 ± 0,210 | 0,371 ± 0,183 | 0,325 ± 0,191 |
| Qwen 3.5 Plus | 0,402 ± 0,162 | 0,325 ± 0,158 | 0,323 ± 0,182 | 0,298 ± 0,146 |
| GPT-5.4-mini | 0,399 ± 0,168 | 0,230 ± 0,148 | 0,255 ± 0,177 | 0,272 ± 0,134 |
| Claude Sonnet 4.6 | 0,393 ± 0,180 | 0,187 ± 0,203 | 0,270 ± 0,167 | 0,265 ± 0,167 |
| Qwen 3.5 Flash | 0,359 ± 0,185 | 0,312 ± 0,163 | 0,246 ± 0,168 | 0,263 ± 0,145 |
| Gemini 3.1 Pro | 0,220 ± 0,258 | 0,134 ± 0,213 | 0,129 ± 0,208 | 0,093 ± 0,211 |
| Gemini 3.1 Flash Lite | 0,113 ± 0,258 | 0,112 ± 0,250 | 0,186 ± 0,240 | 0,007 ± 0,179 |
| UI-TARS 1.5 | 0,108 ± 0,171 | -0,008 ± 0,111 | 0,169 ± 0,173 | 0,076 ± 0,171 |
GPT-5.4 моделинин иш такта интерфейстериндеги 0,506 CC мааниси изилдөөдөгү эң жогорку модель-категория натыйжасы. Изилдөөчүлөр иш такта интерфейстеринде меню, мазмун аймагы, каптал тилкеси жана башка функционалдык бөлүктөр арасында көбүнчө ачык визуалдык иерархия болору VLM моделдерине күчтүү мейкиндиктик белгилерди бере алат деп талкуулашат.
Бирок жыйынтыктарды “жөнөкөй экран дайыма оңой” деп чечмелөөгө болбойт. Мисалы, постерлерде декоративдик элементтер адам көңүлүнө семантикалык маанилүүлүктөн башкача таасир бериши мүмкүн. Мобилдик интерфейстерде болсо тар көрүү аймагындагы тыгыз жана бири-бири менен атаандашкан интерактивдүү элементтер модель болжолдоосу менен адамдын көз карашынын айырмасын көбөйтүшү мүмкүн.
Сүрөт 1 эмнени көрсөтөт?
Изилдөөнүн 5. бетиндеги Сүрөт 1, GPT-5.4 моделинин 7 секунддук баалоодогу репрезентативдүү эң жакшы жана эң жаман мисалдарын жанаша көрсөтөт. Ар бир сапта солдо түпнуска колдонуучу интерфейси, ортодо модель болжолдогон saliency картасы, оңдо UEyes реалдуу көз кыймылын байкоо картасы берилген.
Жогорудагы ийгиликтүү иш такта мисалында модель топтогон көңүл аймагы реалдуу адамдын көз караш тыгыздыгы менен айкын дал келет. Изилдөөчүлөр бул экрандын ачык визуалдык иерархиясын жана бири-биринен бөлүнгөн функционалдык аймактарын модель үчүн артыкчылык катары чечмелешет.
Төмөнкү мобилдик мисалда айырма кыйла чоң. GPT-5.4 семантикалык жактан маанилүү деп эсептеген көп интерфейс элементтерине чачыранды көңүл чекиттерин жайгаштырса, реалдуу адамдын көз караш маалыматтары белгилүү интерактивдүү аймактарда көбүрөөк топтолот. Бул мисал VLM берген “кайсы элементтер маанилүү?” деген жооп менен адамдын көзү чындап “кайда карайт?” дегендин ортосундагы айырманы визуалдык көрсөтөт.
UI-TARS жыйынтыгы эмне үчүн маанилүү?
UI-TARS 1.5 колдонуучу интерфейси менен аракеттенүүгө атайын модель болгонуна карабастан адамдын көз карашын болжолдоодо тогуз моделдин акыркы орунунда. Жалпы 7 секунддук жыйынтыкта CC=0,086 жана KL=7,448 алат. Категориялар боюнча KL айырмасы 5,4 менен 8,8 аралыгында экени айтылат; мобилдик CC болсо -0,008-ге түшөт.
Изилдөөчүлөр муну эки тапшырманын түпкү табияты ар башка болушу менен түшүндүрүшөт. Интерфейс агенти көрсөтмөнү аткаруу үчүн басылчу же аракет жасалчу элементти табууну үйрөнө алат. Адамдын визуалдык көңүлү болсо бир эле максаттуу элементтен турбайт; визуалдык көрүнүктүүлүк, жайгашуу тыгыздыгы, семантикалык маани жана интерактивдүү белгилердин бүт экран боюнча айкалышынан пайда болот.
Нөл-нуска VLM менен атайын көңүл модели бир эле нерсе эмес
Изилдөөдө UEyes маалыматында кайра үйрөтүлгөн UMSI модели мурдагы изилдөөдө AUC=0,878 көрсөткөнү айтылат. UIGaze изилдөөсүндөгү эң күчтүү VLM болсо нөл-нуска шартында 7 секундда CC=0,408 алат.
Бул эки санды түз салыштыруу туура эмес; анткени AUC жана CC ар башка метрикалар. Изилдөөчүлөр да муну түз атаандаштык катары бербейт. Бул жердеги илимий айырма — тармакка атайын көз кыймылын байкоо маалыматтары менен үйрөтүлгөн модель менен көңүл маалыматтарында кайра үйрөтүлбөстөн түз колдонулган жалпы максаттагы VLM ортосунда.
VLM ыкмасынын артыкчылыгы тактыкта эмес, колдонууга кирүү босогосунда: көз кыймылын байкоо үчүн тренинг маалыматтары, кошумча модель үйрөтүү же fine-tuning талап кылбастан жаңы скриншотко колдонулушу мүмкүн. Ошондуктан изилдөөчүлөр VLM негизиндеги карталарды расмий колдонуучу тестинин ордуна эмес, эрте дизайн баалоосунда колдонулуучу болжолдуу алдын ала сигнал катары карашат.
Изилдөө колдогон жыйынтыктар
- Азыркы VLM моделдери нөл-нуска шартында адамдын UI көз караш бөлүштүрүүсү менен өлчөнө турган, бирок орточо деңгээлдеги дал келүүнү көрсөтө алат.
- Адамдын көз карашы менен дал келүү жалпысынан 1 секунддан 7 секундга чейин өсөт.
- Бул убакыттык жүрүм-турум VLM болжолдоолору алгачкы рефлекстик көз караштан көрө изилдөөчү жана семантикалык көңүл бөлүштүрүүгө көбүрөөк окшош экенин колдойт.
- Модель ийгилиги интерфейс категориясына жараша өзгөрөт.
- Ачык визуалдык иерархиясы бар айрым иш такта интерфейстеринде жогору дал келүү алынат.
- UI ичинде аракет аткаруу жөндөмү адамдын көз караш бөлүштүрүүсүн туура болжолдоо жөндөмүнө тең эмес.
- VLM негизиндеги ыкма реалдуу колдонуучу маалыматы жок эрте дизайн баскычтарында болжолдуу көңүл баалоосун бере алат.
Изилдөө колдобогон же текшербеген жыйынтыктар
- VLM saliency карталары реалдуу көз кыймылын байкоо изилдөөлөрүн алмаштыра алары көрсөтүлгөн эмес.
- CC=0,408 мааниси адамдын көз карашы туура же толук көчүрүлгөнүн билдирбейт.
- Моделдин жалпы көрүү-тил жөндөмү же UI агенттик көрсөткүчү бул эксперименттен чыгарылбайт; изилдөө адамдын көңүл бөлүштүрүүсү менен жүрүм-турумдук дал келүүнү гана өлчөйт.
- Изилдөө жеке колдонуучунун көз караш жүрүм-турумун болжолдобойт; ground truth 62 катышуучунун бириктирилген маалыматтары.
- Жаш, адистик, маданият же башка демографиялык өзгөчөлүктөр боюнча модель тактыгы текшерилген эмес.
- Бир гана нөл-нуска prompt колдонулгандыктан, ар башка prompt дизайны жыйынтыкты кантип өзгөртөрү аныкталган эмес.
- VLM жана атайын үйрөтүлгөн saliency моделдери бирдей метрикалар менен көзөмөлдөнгөн түз салыштырууда текшерилген эмес.
- Жыйынтыктар Түркиядагы колдонуучулардын көңүл жүрүм-турумуна түз жалпыланбайт.
Изилдөөнүн Методу жана Жыйынтыктары
Эксперимент дизайнынын техникалык кыскача мазмуну
| Эксперимент компоненти | Булакта берилген маани же ыкма |
|---|---|
| Маалымат топтому | UEyes |
| Жалпы UI сүрөтү | 1.980 |
| Категория саны | 4 |
| Категорияга сүрөт саны | 495 |
| Көз кыймылын байкоо катышуучусу | 62 |
| Жалпы байкоо мөөнөтү | 7 секунд |
| Бааланган адам көз караш мөөнөттөрү | 1 s, 3 s, 7 s |
| VLM саны | 9 |
| Модель үчүн суралган көз караш чекити | 30–50 |
| Координаттар | Нормалдаштырылган x, y жана интенсивдүүлүк |
| Гаусс бүдөмүктөтүүсү | \(\sigma=40\) пиксел |
| Ар бир модель-сүрөт жуптугуна кайталоо | 3 |
| Пилоттук эксперимент | 40 сүрөттө 10 кайталоо |
| Баалоо метрикалары | CC, SIM, KL divergence |
| Модель жеткиликтүүлүгү | OpenRouter API |
| Эксперимент убактысы | Апрель 2026 |
Эң күчтүү жана эң алсыз жалпы натыйжа
Жети секунддук ground truth боюнча GPT-5.4 үч метриканын баарында эң күчтүү жалпы натыйжаны берет: CC=0,408 ± 0,169, SIM=0,503 ± 0,085 жана KL=1,345 ± 0,793.
UI-TARS 1.5 ошол эле баалоодо CC=0,086 ± 0,171, SIM=0,142 ± 0,143 жана KL=7,448 ± 2,580 менен эң төмөн жалпы дал келүүнү көрсөтөт.
Бул салыштырууда “эң күчтүү” деген сөз адамдын көз кыймылын байкоо картасына окшоштукту билдирет; моделдердин башка визуалдык тапшырмалардагы жалпы рейтингин билдирбейт.
Убакыттык жыйынтыктардын техникалык чечмелөөсү
GPT-5.4 үчүн CC тартиби
\[ 0{,}217\;(1\,s) \rightarrow 0{,}326\;(3\,s) \rightarrow 0{,}408\;(7\,s) \]
түрүндө.
Claude Opus 4.6 үчүн ошол эле катар
\[ 0{,}227 \rightarrow 0{,}303 \rightarrow 0{,}344 \]
жана Qwen 3.5 Plus үчүн
\[ 0{,}161 \rightarrow 0{,}245 \rightarrow 0{,}337 \]
деп берилген. Моделдердин көбүндөгү бул монотондуу өсүү VLM болжолдогон мейкиндик көңүлү адамдын узагыраак сканы менен бара-бара көбүрөөк дал келерин көрсөтөт.
UI-TARS 1.5 бул жалпы үлгүнүн айкын өзгөчө учурларынын бири. CC маанилери 0,078 → 0,101 → 0,086 болгондуктан, 7 секундга чейин туруктуу жакшыртуу жок.
Интерфейс категориясынын таасири
GPT-5.4 моделинде эң жогорку категория CC мааниси иш тактада 0,506. Qwen 3.5 Plus да иш тактада 0,402-ге, Claude Opus 4.6 болсо 0,404-ке жетет. Бул жыйынтык күчтүү моделдер ачык иерархиясы бар иш такта макеттеринде адамдын көз карашы менен көбүрөөк жалпы мейкиндик түзүмүн кармай аларын көрсөтөт.
Бирок категориянын таасири бардык моделдерде бирдей эмес. Мисалы, Qwen 3.5 Flash мобилдик интерфейстерде CC=0,312 алса, постерлерде 0,246-га түшөт. Claude Opus 4.6 болсо постерлерде 0,371 менен мобилдик 0,275 маанисинен жогору дал келет. Демек белгилүү бир UI категориясы бардык VLM үчүн универсалдуу оңой же кыйын деген жыйынтык колдоого алынбайт.
Белгисиздик жана эксперименттик чектөөлөр
Таблицаларда орточо маанилер гана эмес, стандарттык четтөөлөр да берилет жана айрым төмөн көрсөткүчтүү моделдерде стандарттык четтөөлөр орточо CC маанисине салыштырмалуу абдан жогору. Бул сүрөттөр арасында модель жүрүм-туруму олуттуу өзгөрүшү мүмкүн экенин көрсөтөт.
Мындан тышкары изилдөө төмөнкү методологиялык чектөөлөрдү ачык айтат:
- Бир гана нөл-нуска prompt колдонулган.
- Суралган 30–50 көз караш чекитинин санын же убакыттык билдирүүлөрдү өзгөртүү текшерилген эмес.
- UEyes маалыматтары 62 катышуучунун көз кыймылын бириктирет жана жеке айырмачылыктарды көрүнбөй калтырат.
- Жаш, адистик жана маданий фон сыяктуу демографиялык өзгөрмөлөр боюнча өзүнчө баалоо жасалган эмес.
- CC, SIM жана KL метрикалары гана колдонулган.
- AUC-Judd жана NSS сыяктуу кошумча метрикалар башка көрсөткүч өлчөмдөрүн көрсөтө алары айтылат.
- Нөл-нуска VLM моделдери менен UEyes маалыматында үйрөтүлгөн CNN негизиндеги saliency моделдери бирдей метрикалар менен көзөмөлдөнгөн түрдө салыштырылган эмес.
Практикалык колдонуу жагынан жыйынтык кандай?
Изилдөөчүлөр VLM негизиндеги көңүл болжолдоосун көз кыймылын байкоо эксперименттеринин альтернативасы эмес, өзгөчө реалдуу колдонуучусу али жок же прототиптин эрте баскычындагы интерфейстер үчүн кирүү баасы төмөн алдын ала сигнал катары карашат.
Мисалы, модель болжолдоолору колдонуучу тести жүргүзүлө электе дизайндагы мүмкүн болгон көңүл сокур зоналарын аныктоо же A/B тесттен мурда интерфейсти тез алдын ала текшерүү үчүн колдонулушу мүмкүн. Бирок орточо корреляция маанилери жана алгачкы фиксациялардагы алсыздык себептүү маанилүү UX чечимдерин VLM heatmap картасына гана негиздөө бул изилдөөнүн жыйынтыктары тарабынан колдоого алынбайт.
Булак жана Метод Эскертүүсү
Толук түпнуска эмгектин аталышы: UIGaze: How Closely Can VLMs Approximate Human Visual Attention on User Interfaces?
Авторлор: Min Song, Yoonseong Lee, Yeonhu Seo.
Авторлордун тартиби: Min Song → Yoonseong Lee → Yeonhu Seo.
Тең салым/тең биринчи автор: Каралган версияда тең биринчи автор же тең салым жөнүндө билдирүү жок.
Жооптуу автор: Булак белгилүү бир авторду ачык “corresponding author” деп көрсөтпөйт. Үч автордун тең корпоративдик e-mail даректери башкы бөлүктө берилген; ошондуктан текшерилбеген жооптуу автор дайындалышы жасалган эмес.
Мекеме: Xebec Inc., South Korea. Үч автор үчүн тең ошол эле мекеме көрсөтүлгөн.
Булак түрү: arXiv preprint.
Рецензия абалы: Бул изилдөө рецензиядан өтпөгөн preprint; жыйынтыктар ушул жарыялоо баскычы эске алынып бааланышы керек. 12 Август 2026 абалы боюнча көз карандысыз расмий библиографиялык текшерүүдө рецензияланган журнал же конференция версиясы ырасталган эмес.
arXiv: arXiv:2604.26352v1 [cs.HC].
arXiv DataCite DOI: 10.48550/arXiv.2604.26352. Бул DOI arXiv жазуусунун DOI-син билдирет; рецензияланган журнал DOI-си катары чечмеленбеши керек.
Жөнөтүлгөн дата: 29 Апрель 2026.
Тема аймагы: Computer Science — Human-Computer Interaction (cs.HC).
Журнал/конференция: Каралган версияда текшерилген рецензияланган журнал же конференция тууралуу маалымат жок.
Басма: Рецензияланган жарыя үчүн текшерилген басма жок; булак arXiv платформасында жарыяланган preprint.
Расмий шилтеме: https://arxiv.org/abs/2604.26352
Лицензия: CC BY 4.0 (Creative Commons Attribution 4.0 International). Кайра колдонуу жана адаптация жасалса, туура шилтеме жана өзгөртүү тууралуу маалымат сакталышы керек.
Маалымат жана код жеткиликтүүлүгү: Изилдөөчүлөр кодду, модель болжолдорун жана баалоо жыйынтыктарын ачык жеткиликтүү кылганын билдиришет. Изилдөөдө берилген долбоор дареги: https://github.com/dunward/uigaze
Каржылоо: Каралган алты беттик версияда өзүнчө каржылоо же ыраазычылык бөлүмү жок; каржылоо маалыматы ырасталбагандыктан кошулган эмес.
Кызыкчылыктардын кагылышы: Каралган версияда өзүнчө кызыкчылыктардын кагылышы жөнүндө билдирүү жок. Мындан авторлордо кызыкчылыктардын кагылышы жок деген жыйынтык чыгарылган эмес.
Негизги методологиялык чектөө: Изилдөө реалдуу колдонуучулардын бириктирилген көз кыймылын байкоо маалыматтары менен VLM болжолдорунун мейкиндик окшоштугун өлчөйт. Жеке көз караш жүрүм-турумун болжолдобойт. Моделдер бир гана нөл-нуска prompt менен бааланып, CC, SIM жана KL метрикалары гана колдонулган. VLM моделдери менен UEyes маалыматында атайын үйрөтүлгөн saliency моделдери бирдей метрикалар менен көзөмөлдөнгөн түз салыштырууда текшерилген эмес.
Визуалдык баалоо: Изилдөөнүн 5. бетиндеги Сүрөт 1, GPT-5.4 моделинин 7 секунддук баалоодогу репрезентативдүү эң жакшы жана эң начар мисалдарын түпнуска UI, VLM болжолу жана UEyes көз кыймылын байкоо ground truth картасы катары жанаша көрсөтөт. Ийгиликтүү мисалда модель жана адамдын тыгыздык аймактары көбүрөөк дал келсе, тыгыз мобилдик интерфейс мисалында модель көп семантикалык элементтерге чачыранды көңүл бөлүп, реалдуу адам фиксациялары белгилүү аймактарда топтолот.
Verianla Live маалымат булагы: Макаладагы Live график изилдөөнүн Таблица 2 бөлүгүндө жарыяланган 7 секунддук орточо CC маанилерин гана колдонот. Булакта жок маалымат чекити, интерполяция же аралык маани түзүлгөн эмес.
Илимий мазмун чеги: Бул Verianla макаласындагы эксперимент түзүлүшү, моделдер, сандык маанилер, чечмелөөлөр жана чектөөлөр каралган изилдөөгө негизделет. Тышкы текшерүү аталыш, авторлор, arXiv идентификатору, DOI, дата, жарыялоо абалы жана лицензия сыяктуу библиографиялык талаалар үчүн гана колдонулуп, тышкы булактардан жаңы илимий натыйжа кошулган эмес.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген