

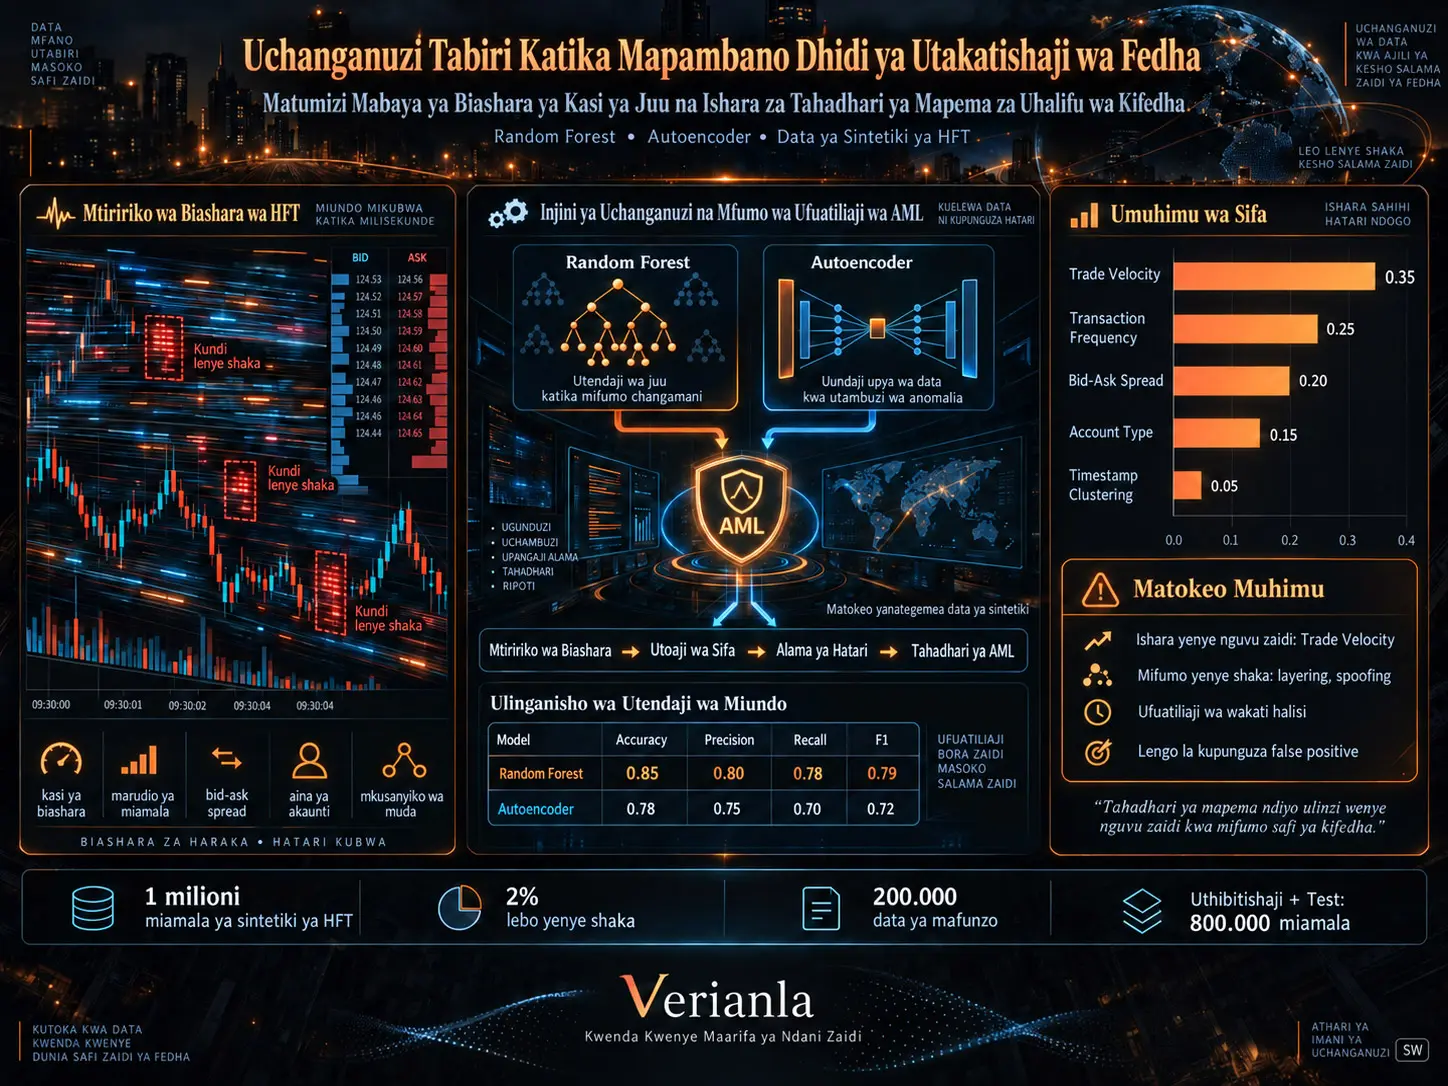
Utafiti huu unapendekeza mfumo wa anti-money laundering (AML) unaolenga kugundua mifumo ya miamala inayotia shaka inayoweza kujitokeza katika mazingira ya high-frequency trading (HFT) kwa kutumia uchanganuzi tabiri na ujifunzaji wa mashine. Katika utafiti unaolinganisha mbinu za ujifunzaji unaosimamiwa kama random forest na ugunduzi wa anomali unaotegemea autoencoder; vipengele kama kasi ya miamala, marudio ya miamala, bid-ask spread, aina ya akaunti na mkusanyiko wa mihuri ya muda vinawekwa katika modeli kama ishara za onyo la mapema za uhalifu wa kifedha.
Data iliyotumiwa katika utafiti huu haitokani na rekodi halisi za uchunguzi wa soko la hisa. Mtafiti aliunda seti ya data ya sintetiki ya HFT ya hisa za kimataifa yenye miamala 1 million ambayo ni ya kinadharia lakini inachukuliwa kuwa ya uhalisia ili kuwakilisha kipindi cha Januari 2017–Desemba 2018. %2'si ya miamala iliwekewa lebo ya kutiliwa shaka kulingana na mifumo inayofanana na layering au spoofing, miamala 200.000 ilitumika kwa mafunzo, na miamala 800.000 iliyobaki iligawanywa kwa usawa kati ya seti za uthibitishaji na majaribio.
Katika chanzo, modeli ya random forest ilipata %85 accuracy, %80 precision, %78 recall na %79 F1-score, huku modeli ya autoencoder ikifikia %78, %75, %70 na %72 mtawalia. Katika modeli ya random forest, umuhimu mkubwa zaidi wa kigezo ulipewa trade velocity, yaani msongamano wa miamala kwa sekunde, kwa thamani ya 0,35.
Haiwezi kuhitimishwa kuwa takwimu hizi za utendaji zimethibitishwa katika operesheni halisi ya AML. Data ya sintetiki huenda isiwakilishe kikamilifu matatizo kama data zinazokosekana katika masoko halisi, lebo zisizo sahihi, hali tofauti za soko, kughairiwa kwa maagizo, venue fragmentation na mabadiliko ya makusudi katika tabia ya uhalifu. Utafiti pia unatambua wazi kikomo hiki.
Kwa nini high-frequency trading inachunguzwa kwa mtazamo wa AML?
High-frequency trading inaweza kuzalisha kiotomatiki idadi kubwa ya maagizo na miamala ndani ya vipindi vifupi sana vya muda. Kasi na ujazo huu huleta tatizo kubwa la uchakataji data kwa mifumo ya jadi ya AML inayotumia vizingiti visivyobadilika. Kwa kuwa hata mkakati wa kawaida wa HFT unaweza kutoa maelfu ya ujumbe ndani ya sekunde au milisekunde, sheria rahisi zinazotegemea idadi ya miamala pekee zinaweza kuzalisha idadi kubwa ya tahadhari za uongo.
Mbinu kuu ya utafiti ni kutumia modeli zinazojifunza mifumo yenye vigezo vingi ndani ya data badala ya sheria zisizobadilika za AML. Kwa hivyo, badala ya “kizingiti kimoja cha idadi ya miamala”, msongamano wa miamala, marudio, tabia ya spread, aina ya akaunti na mkusanyiko kwa muda hutathminiwa kwa pamoja.
Uchanganuzi Tabiri Unatofautianaje na Sheria za Jadi za AML?
Mifumo ya AML inayotegemea sheria huzalisha tahadhari kupitia vizingiti na matukio yaliyofafanuliwa mapema, ilhali uchanganuzi tabiri hujifunza mahusiano ya kitakwimu kutoka kwa mifumo ya zamani au ya sintetiki iliyowekewa lebo. Modeli inayosimamiwa hujaribu kuainisha mifumo inayotia shaka inayojulikana, huku modeli isiyosimamiwa ikiweza kuweka alama tabia zisizo za kawaida ambazo hazikuwahi kuwekewa lebo kama anomali.
Kwa sababu hiyo, utafiti unalinganisha mbinu mbili tofauti:
| Modeli | Aina ya ujifunzaji | Jukumu katika utafiti |
|---|---|---|
| Random Forest | Ujifunzaji unaosimamiwa | Kuainisha miamala ya kawaida na inayotia shaka iliyowekewa lebo |
| Autoencoder | Mbinu isiyosimamiwa / inayotegemea anomali | Kugundua mikengeuko kutoka kwa muundo wa kawaida |
Random forest inaonyesha utendaji wa juu zaidi katika mifumo inayojulikana na iliyowekewa lebo. Autoencoder, licha ya kuwa na utendaji wa jumla wa chini zaidi, inajadiliwa kama utaratibu wa nyongeza unaoweza kusaidia kugundua anomali ambazo hazikufafanuliwa hapo awali.
Data ya sintetiki inaundwaje?
Chanzo kinazalisha miamala 1 million ya HFT inayowakilisha soko la hisa la kimataifa. Muundo wa data umeundwa kwa kuongozwa na data za masoko ya umma zinazofanana na NASDAQ, ripoti za udhibiti za SEC na tipolojia za FATF. Ili kuongeza utofauti, chanzo kinataja uzalishaji wa data ya sintetiki unaotegemea Monte Carlo.
Vigezo vikuu vinavyotumiwa katika kila muamala ni:
- ujazo wa muamala,
- marudio ya muamala,
- bid-ask spread,
- aina ya akaunti,
- timestamp,
- trade velocity iliyotokana,
- viashiria vinavyohusiana na mkusanyiko wa muda.
Chanzo kinasema kuwa takriban %2'si ya miamala iliwekewa lebo ili ibebe mifumo inayotia shaka inayofanana na layering au spoofing.
Kwa Nini Data ya Sintetiki ni Kikomo Muhimu?
Data ya sintetiki ni muhimu kwa kuunda modeli na kufanya ulinganisho unaodhibitiwa; hata hivyo, haijumuishi ugumu wote wa tabia katika masoko halisi. Data halisi ya HFT inaweza kuwa na rekodi zinazokosekana, venue routing, tabia za market-maker, kughairiwa kwa maagizo, hali tofauti za likwiditi, matukio ya habari, uhusiano kati ya akaunti na lebo za AML zisizo sahihi au zisizokamilika.
Kwa sababu hiyo, thamani ya %85 accuracy katika utafiti haipaswi kutumiwa kama utendaji unaotarajiwa katika mfumo hai wa AML wa taasisi halisi ya kifedha. Namba hii ni utendaji wa majaribio wa modeli ya random forest ndani ya mfumo wa data ya sintetiki na uwekaji lebo ulioundwa na mtafiti.
Uchukuaji sampuli na mgawanyo wa data
Katika utafiti, stratified sampling inatumika kwa mafunzo. Kati ya jumla ya miamala 1 million, miamala 200.000 huchaguliwa kwa mafunzo ya modeli. Utabakishaji unafanywa kulingana na aina ya akaunti na ujazo wa muamala.
Miamala 800.000 iliyobaki hugawanywa kwa usawa katika sehemu mbili na kutumika kama:
- uchunguzi 400.000 wa uthibitishaji,
- uchunguzi 400.000 wa majaribio
.
Mtafiti anasema kwamba kwa ajili ya kurudiwa kwa matokeo, thamani ya random seed iliwekwa kuwa 42.
Zana za ukokotoaji zilizotumiwa
Inaelezwa kuwa scikit-learn ilitumika kwa modeli zinazosimamiwa, TensorFlow kwa utekelezaji wa autoencoder na Apache Spark kwa uchakataji wa data kwa kiwango kikubwa. Utendaji wa modeli unatathminiwa kwa accuracy, precision, recall na F1-score.
Kutumiwa kwa zana hizi pekee hakuonyeshi kuwa modeli iko tayari kwa mazingira ya uzalishaji ya wakati halisi. Ufuatiliaji wa HFT wa wakati halisi una mahitaji ya ziada kama ucheleweshaji, throughput, uadilifu wa data, model drift'i na uelezekaji.
Mbinu na Matokeo ya Utafiti
Utendaji wa random forest na autoencoder
| Modeli | Accuracy | Precision | Recall | F1-Score |
|---|---|---|---|---|
| Random Forest | 0,85 | 0,80 | 0,78 | 0,79 |
| Autoencoder | 0,78 | 0,75 | 0,70 | 0,72 |
Katika matokeo ya Jedwali 1 la chanzo, random forest iko juu ya autoencoder katika vipimo vyote vinne vya utendaji. Tofauti ya accuracy ni pointi 7 za asilimia, tofauti ya recall ni pointi 8 za asilimia na tofauti ya F1 ni pointi 7 za asilimia.
Hapa accuracy pekee si kipimo cha kutosha cha tathmini. Inaelezwa kuwa ni %2'si tu ya seti ya data iliyowekewa lebo ya kutiliwa shaka; kwa hivyo, katika tatizo la AML lenye kutokuwiana kwa madarasa kwa kiwango kikubwa, precision, recall, F1 na mgawanyo wa makosa kwa kila darasa ni muhimu hasa.
Ni Viashiria Gani Muhimu Zaidi vya Onyo la Mapema katika Modeli ya AML?
Thamani za feature importance za modeli ya random forest zilizoripotiwa katika chanzo ni hizi:
| Kipengele | Importance |
|---|---|
| Trade Velocity | 0,35 |
| Transaction Frequency | 0,25 |
| Bid-Ask Spread | 0,20 |
| Account Type | 0,15 |
| Timestamp Clustering | 0,05 |
Kipengele chenye nguvu zaidi cha modeli kimeripotiwa kuwa trade velocity. Kigezo hiki kinawakilisha msongamano wa miamala unaotokea katika kitengo fulani cha muda. Kinachofuata ni transaction frequency na bid-ask spread.
Thamani ya feature importance haimaanishi kuwa kigezo chenyewe ndicho chanzo cha uhalifu au kwamba kasi fulani ya muamala inapaswa kuhesabiwa moja kwa moja kuwa ya kutiliwa shaka. Vipimo vya umuhimu vya random forest huonyesha mchango katika utabiri ndani ya modeli, na tafsiri za kiuchumi zinapaswa kufanywa kwa uangalifu inapokuwa na uhusiano kati ya vigezo.
Accuracy wakati wa mafunzo ya modeli
Katika grafu ya Figure 1 ya chanzo, accuracy ya modeli ya random forest inaongezeka kutoka takriban %75 hadi %85 katika iteresheni tano za mafunzo. Autoencoder nayo inaongezeka kutoka takriban %70 hadi %78.
Mchoro huu unaonyesha kwamba modeli ya random forest ilifikia kiwango cha juu zaidi cha utendaji kwa kasi zaidi katika senario ya sintetiki iliyotolewa. Hata hivyo, namna ambavyo dhana ya “training iteration” iliundwa kialgorithimu haijaelezwa kwa kina katika chanzo; kwa hiyo grafu haipaswi kulinganishwa moja kwa moja na epoch-based learning curve ya kawaida.
Ni nini kinachoripotiwa kuhusu false positives?
Katika sehemu ya matokeo, inaelezwa kwamba mbinu iliyopendekezwa ilipunguza false positives kwa %25 ikilinganishwa na mifumo ya jadi ya rule-based. Hata hivyo, chanzo hakionyeshi jedwali tofauti, confusion matrix au ulinganisho wa moja kwa moja wa majaribio kwa matokeo haya.
Kwa hiyo, namba ya %25 inaweza kutajwa kama kauli ya mwandishi katika sehemu ya matokeo ya utafiti; haipaswi kuwasilishwa kama matokeo yaliyohesabiwa upya kwa kujitegemea au yaliyothibitishwa kwa jedwali la kina la majaribio.
Muda wa ugunduzi wa wakati halisi
Chanzo pia kinasema katika sehemu ya matokeo kwamba detection delay inaweza kupunguzwa kwa %40. Hata hivyo, aya hiyo hiyo inaunganisha matokeo hayo na matokeo ya awali ya Wang na wenzake, na katika utafiti huu hakuna jedwali huru la benchmark ya ucheleweshaji linalowasilishwa kwa hili.
Kwa sababu hiyo, thamani ya kupunguza ucheleweshaji kwa %40 pia haipaswi kutathminiwa kama mojawapo ya matokeo makuu yaliyopimwa moja kwa moja katika jaribio hili la sintetiki.
Je, Layering na Spoofing ni Sawa na Utakatishaji Fedha?
Hapana. Layering na spoofing kwa kawaida ni tabia za udanganyifu wa soko zinazohusishwa na kuathiri kitabu cha maagizo kwa maagizo ya kupotosha au kuelekeza washiriki wa soko kwa ishara zisizo sahihi za bei/likwiditi. Utakatishaji fedha, kwa upande mwingine, ni mchakato wa kuficha chanzo na umiliki wa mapato ya uhalifu.
Chanzo kinashughulikia tabia hizi pamoja ndani ya mfumo mpana wa “financial crime” na onyo la mapema la AML. Hata hivyo, tahadhari ya spoofing au layering peke yake si ushahidi wa money laundering. Katika mfumo wa AML, tabia kama hizi zinapaswa kutathminiwa tu pamoja na mtiririko wa fedha kati ya akaunti, beneficial ownership, wasifu wa mteja na miktadha mingine ya miamala.
Je, modeli zinazosimamiwa na zisizosimamiwa zinaweza kutumiwa pamoja?
Katika sehemu ya majadiliano ya utafiti, mfumo mseto unapendekezwa. Random forest inaweza kutoa utendaji wa juu wa uainishaji katika mifumo inayojulikana na iliyowekewa lebo hapo awali, huku autoencoder ikitumika kugundua tabia zisizo za kawaida ambazo hazijawahi kuonekana.
Muundo wa jumla uliopendekezwa unaweza kufikiriwa kama ifuatavyo:
Mtiririko hai wa miamala → uchimbaji wa vipengele → skani ya anomali → supervised risk score → ukaguzi wa mchambuzi wa AML
Hata hivyo, chanzo hakijengi mfumo huu mseto kwa majaribio wala kuupima kwa vipimo tofauti vya utendaji. Kwa hiyo, mbinu mseto ni pendekezo la utafiti kwa siku zijazo.
Tatizo la uelezekaji
Maamuzi ya AML yanahitaji kuwa yanaweza kuelezwa kwa wasimamizi wa udhibiti na timu za uzingatiaji. Modeli kama random forest zinaweza kuunda mahusiano changamano zaidi ya maamuzi kuliko sheria rahisi zinazotegemea vizingiti.
Chanzo kinapendekeza kwamba mbinu za akili bandia zinazoelezeka kama SHAP zitumike katika siku zijazo. Hivyo, wachambuzi wanaweza kuonyeshwa ni vipengele gani vya muamala vilivyoathiri tahadhari na kwa kiwango gani.
Matokeo yanayoungwa mkono na utafiti
- Katika seti ya data ya sintetiki ya HFT, random forest ilipata accuracy, precision, recall na F1-score za juu kuliko autoencoder.
- Accuracy ya random forest imeripotiwa kuwa 0,85.
- Trade velocity ina thamani ya juu zaidi ya feature importance ya 0,35 katika modeli ya random forest.
- Transaction frequency na bid-ask spread ni vigezo muhimu vinavyofuata.
- Ugunduzi wa anomali usiosimamiwa unajadiliwa kama mbinu ya nyongeza kwa mifumo isiyowekewa lebo.
- Inaelezwa kuwa miundombinu ya data kubwa na uchimbaji wa vipengele kwa kasi ya juu ni muhimu katika ufuatiliaji wa AML wa wakati halisi.
Matokeo ambayo utafiti hauungi mkono
- %85 accuracy si kiwango cha mafanikio kilichothibitishwa katika mifumo halisi ya HFT AML.
- Utafiti hautumii miamala milioni moja halisi ya soko la hisa; data ni ya sintetiki.
- Kila thamani ya juu ya trade velocity si kiashiria cha utakatishaji fedha.
- Ugunduzi wa layering au spoofing peke yake haumaanishi ugunduzi wa utakatishaji fedha.
- Chanzo hakitoi benchmark halisi ya latency ya soko hai.
- Upunguzaji wa %25 wa false-positive na upunguzaji wa %40 wa detection-delay haujaonyeshwa kwa kujitegemea kwa jedwali la kina la majaribio.
- Matokeo hayawezi kuenezwa moja kwa moja kwa masoko ya crypto, derivatives, FX au masoko mengine; muundo wa data umeelekezwa kwa mazingira ya HFT ya hisa.
Vikwazo vya kimetodolojia
Kikomo cha kwanza: Data ni ya sintetiki. Kwa kuwa miamala ya sintetiki inaakisi dhana za mtafiti, modeli inaweza kujifunza dhana hizo hizo na utendaji unaweza kushuka katika soko halisi.
Kikomo cha pili: Ingawa lebo za kutiliwa shaka zinachukuliwa kuwa zimeundwa kwa kuongozwa na uchunguzi wa AML wa zamani, data halisi ya uchunguzi iliyowekewa lebo haitumiki.
Kikomo cha tatu: Darasa la kutiliwa shaka la %2 pekee katika seti ya data linasababisha class imbalance kubwa. Pamoja na hayo, chanzo hakiripoti ROC-AUC, PR-AUC, confusion matrix au athari za class-weight.
Kikomo cha nne: Dhana za HFT, udanganyifu wa soko na money laundering zinatumika kwa ukaribu mkubwa katika baadhi ya sehemu. Tabia hizi zinaweza kuhitaji aina tofauti za uchunguzi kisheria na kiutendaji katika AML.
Kikomo cha tano: Ingawa miundombinu ya ukokotoaji ya utekelezaji wa wakati halisi inajadiliwa kupitia Apache Spark, hakuna jaribio la end-to-end la ucheleweshaji, throughput au peak-load linalowasilishwa.
Kikomo cha sita: Kutolingana kikamilifu kwa baadhi ya rekodi katika orodha ya marejeo na nukuu katika sehemu ya fasihi, pamoja na baadhi ya rekodi za kibibliografia zinazohitaji tahadhari ya ziada kuhusu tarehe/mada, kunafanya iwe lazima kuthibitisha kando madai ya fasihi ya nje katika makala.
Maelezo ya Chanzo na Mbinu
Kichwa asilia: Predictive Analytics in Anti-Money Laundering for Detecting High-Frequency Trading Abuses and Identifying Early Warning Signs of Financial Crime
Mwandishi: Bharat Bhanushali.
Uhusiano uliotajwa katika PDF: BNP Paribas, Vice President, Jersey City, New Jersey, USA.
Chapisho: International Journal of Research in Electronics and Computer Engineering (IJRECE).
Juzuu / Toleo: Vol. 7, Issue 1.
Kipindi: January–March 2019.
ISSN: 2393-9028 (Print), 2348-2281 (Online).
Kurasa: 1273–1279.
Aina ya utafiti: Utafiti wa mbinu za AML/HFT unaotegemea ujifunzaji wa mashine kwenye data ya sintetiki.
Data: Miamala 1 million ya sintetiki ya HFT; iliundwa kuwakilisha kipindi cha Januari 2017–Desemba 2018.
Uwiano wa miamala inayotia shaka: %2.
Mafunzo: Miamala 200.000.
Uthibitishaji: Takriban miamala 400.000.
Jaribio: Takriban miamala 400.000.
Modeli kuu: Random forest na autoencoder.
Programu / ukokotoaji: scikit-learn, TensorFlow na Apache Spark.
Random seed: 42.
Utendaji mkuu: Random forest accuracy 0,85; precision 0,80; recall 0,78; F1 0,79. Autoencoder accuracy 0,78; precision 0,75; recall 0,70; F1 0,72.
Feature muhimu zaidi: Trade Velocity — 0,35 importance.
Upatikanaji wa data: Makala inasema kuwa msimbo na violezo vya data ya sintetiki vinaweza kutolewa kwa ombi.
Hakimiliki / leseni: PDF iliyochunguzwa haitaji wazi Creative Commons au leseni nyingine ya matumizi tena. Kwa hiyo, ruhusa ya kutumia moja kwa moja majedwali na grafu za chanzo haipaswi kudhaniwa.
Kikomo kikuu cha tafsiri: Matokeo yalitolewa kwa data ya sintetiki na hayapaswi kuenezwa kama ufanisi halisi wa AML katika soko.
Dokezo la ubora wa kibibliografia: Kuna rekodi katika orodha ya marejeo ambazo hazilingani na baadhi ya nukuu katika sehemu ya fasihi au ambazo zinahitaji kuthibitishwa kando kwa upande wa mada/tarehe. Kwa hiyo, maandishi ya Verianla hayathibitishi usahihi wa marejeo ya nje, bali yanawasilisha tu mbinu na matokeo ya PDF yenyewe.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *