

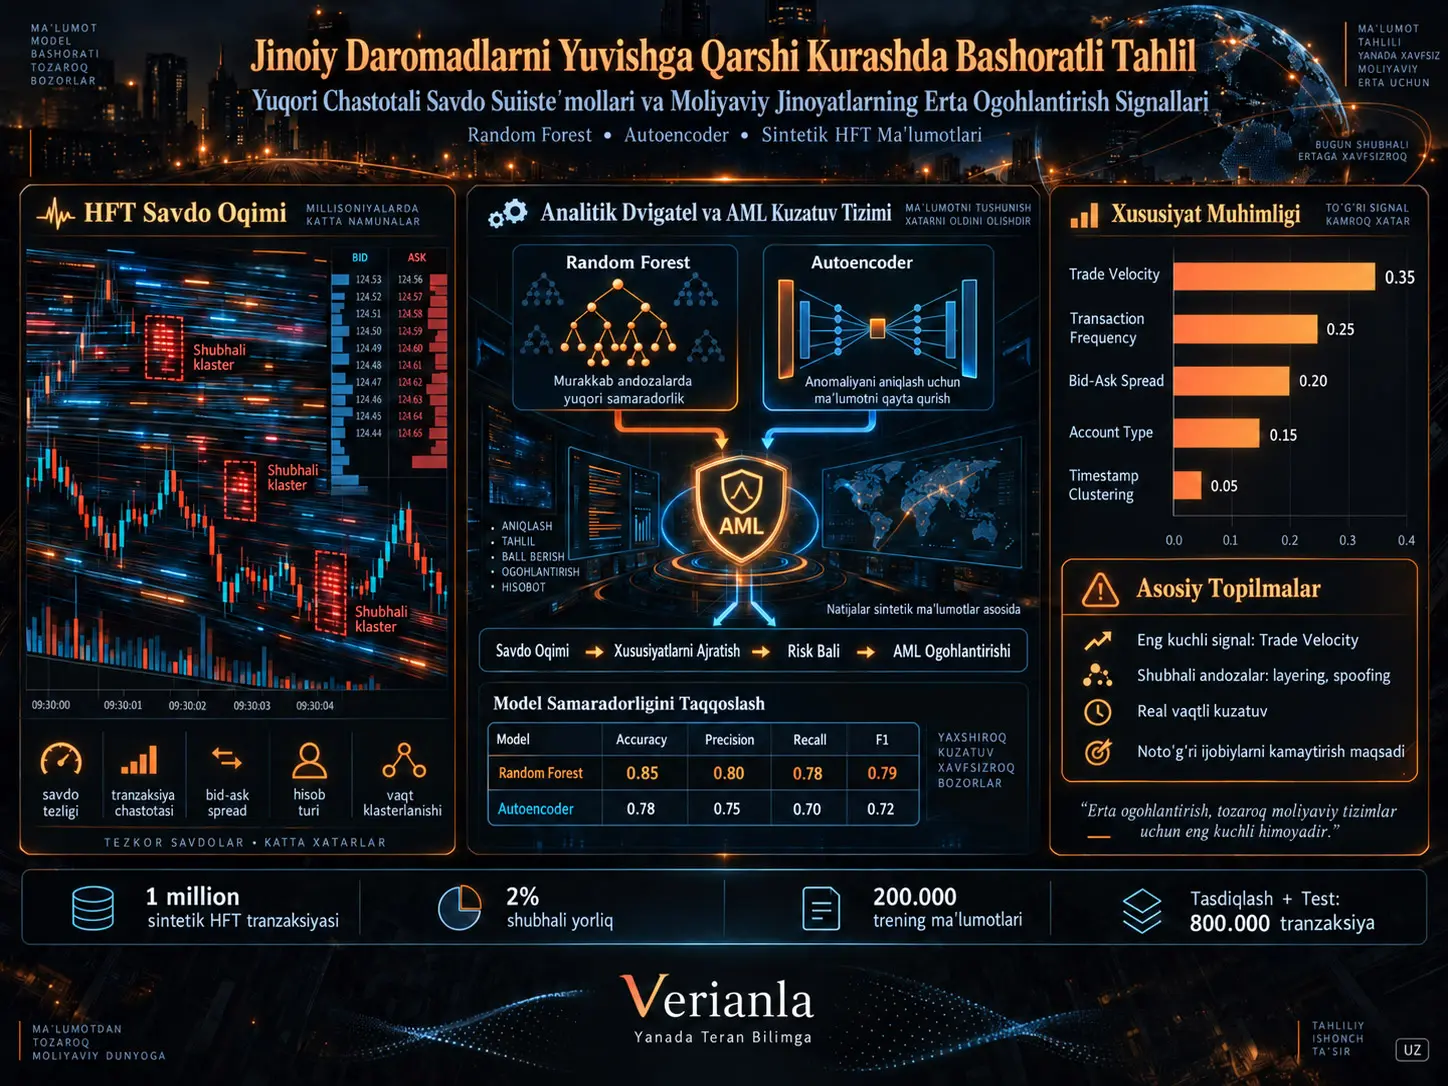
Ushbu tadqiqot yuqori chastotali savdo (HFT) muhitlarida yuzaga kelishi mumkin bo‘lgan shubhali operatsiya naqshlarini prediktiv tahlil va mashinaviy o‘rganish yordamida aniqlashga qaratilgan anti-money laundering (AML) doirasini taklif etadi. Random forest kabi nazoratli o‘rganish usullari bilan autoencoder asosidagi anomaliyani aniqlash taqqoslangan tadqiqotda; operatsiya tezligi, operatsiya chastotasi, bid-ask spread, hisob turi va vaqt tamg‘asi bo‘yicha klasterlash kabi xususiyatlar moliyaviy jinoyat nuqtayi nazaridan erta ogohlantirish signallari sifatida modellashtiriladi.
Tadqiqotda foydalanilgan ma’lumotlar haqiqiy birja tekshiruv yozuvlaridan iborat emas. Tadqiqotchi Yanvar 2017–Dekabr 2018 davrini ifodalash uchun 1 million operatsiyadan iborat gipotetik, biroq realistik deb qabul qilingan sintetik global aksiyalar HFT ma’lumotlar to‘plamini yaratgan. Operatsiyalarning %2'si layering yoki spoofingga o‘xshash naqshlarga ko‘ra shubhali deb belgilangan, 200.000 operatsiya o‘qitish uchun ishlatilgan, qolgan 800.000 operatsiya validatsiya va test to‘plamlariga teng taqsimlangan.
Manbada random forest modeli %85 accuracy, %80 precision, %78 recall va %79 F1-scorega erishgan, autoencoder modeli esa mos ravishda %78, %75, %70 va %72 qiymatlariga yetgan. Random forest modelida eng yuqori o‘zgaruvchi ahamiyati 0,35 bilan trade velocity, ya’ni soniyasiga operatsiya zichligiga berilgan.
Ushbu natijalar haqiqiy AML operatsiyasida tasdiqlangan, degan xulosaga kelib bo‘lmaydi. Sintetik ma’lumot real bozorlardagi yetishmaydigan ma’lumotlar, noto‘g‘ri yorliqlar, turli bozor rejimlari, buyurtma bekor qilinishi, venue fragmentation va jinoiy xatti-harakatlarning ataylab o‘zgarishi kabi muammolarni to‘liq aks ettirmasligi mumkin. Tadqiqot ham bu cheklovni ochiq tan oladi.
Yuqori chastotali savdo AML nuqtayi nazaridan nega o‘rganiladi?
Yuqori chastotali savdo juda qisqa vaqt oralig‘ida avtomatik ravishda katta miqdorda buyurtma va operatsiya yaratishi mumkin. Bu tezlik va hajm an’anaviy qat’iy chegarali AML tizimlari uchun muhim ma’lumotlarni qayta ishlash muammosini tug‘diradi. Oddiy HFT strategiyasi ham soniyalar yoki millisoniyalar ichida minglab xabarlarni yaratishi mumkinligi sababli, faqat operatsiyalar soniga asoslangan sodda qoidalar ko‘p miqdorda noto‘g‘ri ogohlantirish hosil qilishi mumkin.
Tadqiqotning asosiy yondashuvi qat’iy AML qoidalari o‘rniga ma’lumot ichidagi ko‘p o‘zgaruvchili naqshlarni o‘rganadigan modellardan foydalanishdir. Shunday qilib, bitta “operatsiyalar soni chegarasi” o‘rniga operatsiya zichligi, chastota, spread xatti-harakati, hisob turi va vaqt bo‘yicha klasterlash birgalikda baholanadi.
Prediktiv Tahlil An’anaviy AML Qoidalaridan Qanday Farq Qiladi?
Qoidalarga asoslangan AML tizimlari oldindan belgilangan chegaralar va ssenariylar orqali ogohlantirish yaratadi, prediktiv tahlil esa o‘tmishda yoki sintetik ravishda belgilangan naqshlardan statistik munosabatlarni o‘rganadi. Nazoratli model ma’lum shubhali naqshlarni tasniflashga urinadi, nazoratsiz model esa ilgari belgilanmagan noodatiy xatti-harakatlarni anomaliya sifatida belgilashi mumkin.
Shu sababli tadqiqot ikki xil yondashuvni taqqoslaydi:
| Model | O‘rganish turi | Tadqiqotdagi roli |
|---|---|---|
| Random Forest | Nazoratli o‘rganish | Belgilangan normal va shubhali operatsiyalarni tasniflash |
| Autoencoder | Nazoratsiz / anomaliyaga asoslangan yondashuv | Normal naqshdan og‘ishlarni aniqlash |
Random forest ma’lum va belgilangan naqshlarda yuqoriroq natija ko‘rsatadi. Autoencoder esa umumiy natijasi pastroq bo‘lsa-da, ilgari ta’riflanmagan anomaliyalarni aniqlashga yordam beruvchi qo‘shimcha mexanizm sifatida muhokama qilinadi.
Sintetik ma’lumot qanday yaratiladi?
Manba global aksiyalar bozorini ifodalovchi 1 million HFT operatsiyasini yaratadi. Ma’lumot tuzilmasi NASDAQga o‘xshash ommaviy bozor ma’lumotlari, SEC tartibga soluvchi hisobotlari va FATF tipologiyalaridan ilhomlangan holda ishlab chiqilgan. Turli-tumanlikni ta’minlash maqsadida Monte Carlo asosidagi sintetik ma’lumot yaratish haqida so‘z yuritiladi.
Har bir operatsiyada ishlatiladigan asosiy o‘zgaruvchilar quyidagilar:
- operatsiya hajmi,
- operatsiya chastotasi,
- bid-ask spread,
- hisob turi,
- timestamp,
- hosil qilingan trade velocity,
- vaqt bo‘yicha klasterlash bilan bog‘liq ko‘rsatkichlar.
Manbada operatsiyalarning taxminan %2'si layering yoki spoofingga o‘xshash shubhali naqshlarga ega bo‘ladigan tarzda belgilanganligi aytiladi.
Sintetik Ma’lumot Nega Muhim Cheklovdir?
Sintetik ma’lumot model ishlab chiqish va nazorat qilinadigan taqqoslashlarni amalga oshirish uchun foydalidir; biroq haqiqiy bozorlardagi xatti-harakatlarning barcha murakkabligini qamrab olmaydi. Haqiqiy HFT ma’lumotlarida yetishmaydigan yozuvlar, venue routing, market-maker xatti-harakatlari, buyurtmalarni bekor qilish, turli likvidlik rejimlari, yangilik voqealari, hisoblar o‘rtasidagi munosabatlar va noto‘g‘ri yoki to‘liq bo‘lmagan AML yorliqlari bo‘lishi mumkin.
Shu sababli tadqiqotdagi %85 accuracy qiymati haqiqiy moliya institutining jonli AML tizimida kutiladigan natija sifatida qo‘llanmasligi kerak. Bu raqam tadqiqotchi tuzgan sintetik ma’lumot va yorliqlash doirasi ichida random forest modelining test natijasidir.
Namuna olish va ma’lumotlarni bo‘lish
Tadqiqotda o‘qitish uchun stratified sampling qo‘llanadi. Jami 1 million operatsiyadan 200.000 operatsiya modelni o‘qitish uchun tanlanadi. Qatlamlash hisob turi va operatsiya hajmiga ko‘ra amalga oshiriladi.
Qolgan 800.000 operatsiya teng ravishda ikki qismga bo‘linib:
- 400.000 validatsiya kuzatuvi,
- 400.000 test kuzatuvi
sifatida ishlatiladi.
Tadqiqotchi takrorlanuvchanlik uchun random seed qiymati 42 qilib belgilanganini bildiradi.
Foydalanilgan hisoblash vositalari
Nazoratli modellar uchun scikit-learn, autoencoder ilovasi uchun TensorFlow va katta hajmdagi ma’lumotlarni qayta ishlash uchun Apache Spark ishlatilgani ko‘rsatiladi. Model natijasi accuracy, precision, recall va F1-score orqali baholanadi.
Bu vositalardan foydalanilganining o‘zi model real vaqt ishlab chiqarish muhitiga tayyorligini anglatmaydi. Real vaqt HFT nazorati kechikish, throughput, ma’lumot yaxlitligi, model drift'i va tushuntiriluvchanlik kabi qo‘shimcha talablarni keltirib chiqaradi.
Tadqiqot Usuli va Natijalari
Random forest va autoencoder natijasi
| Model | Accuracy | Precision | Recall | F1-Score |
|---|---|---|---|---|
| Random Forest | 0,85 | 0,80 | 0,78 | 0,79 |
| Autoencoder | 0,78 | 0,75 | 0,70 | 0,72 |
Manbaning 1-jadval natijalarida random forest barcha to‘rtta natija o‘lchovi bo‘yicha autoencoderdan yuqori turadi. Accuracy farqi 7 foiz punkti, recall farqi 8 foiz punkti va F1 farqi 7 foiz punktidir.
Bu yerda accuracyning o‘zi yetarli baholash mezoni emas. Ma’lumotlar to‘plamining faqat %2'si shubhali deb belgilanganligi aytiladi; shu bois jiddiy sinf nomutanosibligi mavjud AML muammosida precision, recall, F1 va sinflar bo‘yicha xatolar taqsimoti ayniqsa muhimdir.
AML Modelidagi Eng Muhim Erta Ogohlantirish Ko‘rsatkichlari Qaysilar?
Random forest modelining manbada qayd etilgan feature importance qiymatlari quyidagicha:
| Xususiyat | Importance |
|---|---|
| Trade Velocity | 0,35 |
| Transaction Frequency | 0,25 |
| Bid-Ask Spread | 0,20 |
| Account Type | 0,15 |
| Timestamp Clustering | 0,05 |
Modelning eng kuchli xususiyati trade velocity sifatida qayd etilgan. Bu o‘zgaruvchi ma’lum vaqt birligida sodir bo‘ladigan operatsiya zichligini ifodalaydi. Undan keyin transaction frequency va bid-ask spread keladi.
Feature importance qiymati o‘zgaruvchining o‘zi jinoyat sababi ekanini yoki ma’lum operatsiya tezligi avtomatik ravishda shubhali deb hisoblanishi kerakligini ko‘rsatmaydi. Random forest ahamiyat o‘lchovlari model ichidagi prognoz hissasini ko‘rsatadi va o‘zgaruvchilar o‘rtasida korrelyatsiya mavjud bo‘lsa, iqtisodiy talqinlar ehtiyotkorlik bilan amalga oshirilishi kerak.
Modelni o‘qitish davomida aniqlik
Manbaning Figure 1 grafigida random forest modelining accuracy qiymati beshta o‘qitish iteratsiyasida taxminan %75 dan %85 gacha ko‘tariladi. Autoencoder esa taxminan %70 dan %78 gacha oshadi.
Ushbu tasvir random forest modelining berilgan sintetik ssenariyda tezroq va yuqoriroq natija darajasiga erishganini ko‘rsatadi. Biroq “training iteration” tushunchasi algoritmik jihatdan qanday yaratilgani manbada batafsil tushuntirilmagan; shu sababli grafikni klassik epoch-based learning curve bilan aynan tenglashtirmaslik kerak.
Noto‘g‘ri pozitivlar haqida nima qayd etilgan?
Natijalar bo‘limida taklif etilgan yondashuv an’anaviy rule-based tizimlarga nisbatan noto‘g‘ri pozitivlarni %25 kamaytirgani aytiladi. Biroq bu natija uchun alohida jadval, confusion matrix yoki bevosita eksperimental taqqoslash manbada ko‘rsatilmagan.
Shu sababli %25 raqami tadqiqotning natijalar bo‘limidagi muallif bayonoti sifatida keltirilishi mumkin; u mustaqil qayta hisoblangan yoki batafsil tajriba jadvali bilan tasdiqlangan topilma sifatida taqdim etilmasligi kerak.
Real vaqtda aniqlash muddati
Manba natijalar bo‘limida detection delayni %40 kamaytirish mumkinligini ham bildiradi. Biroq ayni paragraf bu natijani Wang va hamkasblarining avvalgi topilmalari bilan bog‘laydi va ushbu tadqiqotda bunga oid mustaqil kechikish benchmark jadvali berilmaydi.
Shu sababli %40 kechikishni kamaytirish qiymati ham ushbu sintetik tajribaning bevosita o‘lchangan asosiy natijalaridan biri deb baholanmasligi kerak.
Layering va Spoofing Pul Yuvish bilan Bir Xil Narsami?
Yo‘q. Layering va spoofing odatda buyurtmalar kitobiga chalg‘ituvchi buyurtmalar bilan ta’sir ko‘rsatish yoki bozor ishtirokchilarini noto‘g‘ri narx/likvidlik signallari bilan yo‘naltirishga bog‘liq bozor manipulyatsiyasi xatti-harakatlaridir. Pul yuvish esa jinoyat daromadining manbai va egaligini yashirish jarayonidir.
Manba bu xatti-harakatlarni kengroq “financial crime” va AML erta ogohlantirish doirasi ichida birgalikda ko‘rib chiqadi. Biroq spoofing yoki layering ogohlantirishi o‘z-o‘zidan money laundering isboti emas. AML tizimida bunday xatti-harakatlar faqat hisoblararo mablag‘ oqimi, beneficial ownership, mijoz profili va boshqa operatsion kontekstlar bilan birga baholanishi kerak.
Nazoratli va nazoratsiz modellarni birgalikda ishlatish mumkinmi?
Tadqiqotning muhokama bo‘limida gibrid tizim taklif qilinadi. Random forest avval belgilangan ma’lum naqshlarda yuqori tasniflash natijasini ta’minlashi mumkin, autoencoder esa ilgari ko‘rilmagan anomal xatti-harakatlarni aniqlash uchun ishlatilishi mumkin.
Taklif etilgan umumiy arxitekturani quyidagicha tasavvur qilish mumkin:
Jonli operatsiya oqimi → xususiyatlarni ajratish → anomaliyani skanerlash → supervised risk skori → AML tahlilchisi ko‘rigi
Biroq manba bu gibrid tizimni eksperimental ravishda qurib, alohida natija metrikalari bilan sinamaydi. Shu sababli gibrid yondashuv tadqiqotning kelajakka qaratilgan taklifidir.
Tushuntiriluvchanlik muammosi
AML qarorlari tartibga soluvchilar va komplayens jamoalari tomonidan tushuntiriladigan bo‘lishi kerak. Random forest kabi modellar sodda chegara asosidagi qoidalarga nisbatan murakkabroq qaror munosabatlarini yaratishi mumkin.
Manba kelajakda SHAP kabi tushuntiriladigan sun’iy intellekt usullaridan foydalanishni taklif etadi. Shu tariqa ogohlantirishga qaysi operatsiya xususiyatlari qay darajada ta’sir qilgani tahlilchilarga ko‘rsatilishi mumkin.
Tadqiqot qo‘llab-quvvatlaydigan xulosalar
- Sintetik HFT ma’lumotlar to‘plamida random forest autoencoderdan yuqoriroq accuracy, precision, recall va F1-scorega erishgan.
- Random forest accuracy qiymati 0,85 deb qayd etilgan.
- Trade velocity random forest modelida 0,35 bilan eng yuqori feature importance qiymatiga ega.
- Transaction frequency va bid-ask spread keyingi eng muhim o‘zgaruvchilardir.
- Nazoratsiz anomaliyani aniqlash belgilab qo‘yilmagan naqshlar uchun qo‘shimcha yondashuv sifatida muhokama qilinadi.
- Real vaqt AML nazoratida katta ma’lumotlar infratuzilmasi va yuqori tezlikdagi xususiyat ajratish muhim ekani ta’kidlanadi.
Tadqiqot qo‘llab-quvvatlamaydigan xulosalar
- %85 accuracy haqiqiy dunyo HFT AML tizimlarida tasdiqlangan muvaffaqiyat darajasi emas.
- Tadqiqot haqiqiy bir million birja operatsiyasidan foydalanmaydi; ma’lumot sintetikdir.
- Har bir yuqori trade velocity qiymati pul yuvish ko‘rsatkichi emas.
- Layering yoki spoofingni aniqlash o‘z-o‘zidan pul yuvishni aniqlash degani emas.
- Manbada haqiqiy jonli-birja latency benchmarki keltirilmagan.
- %25 false-positive kamayishi va %40 detection-delay kamayishi batafsil tajriba jadvali bilan mustaqil ravishda ko‘rsatilmagan.
- Natijalarni kripto, derivativ, FX yoki boshqa bozorlarga to‘g‘ridan-to‘g‘ri umumlashtirib bo‘lmaydi; ma’lumot dizayni aksiyalar HFT muhitiga yo‘naltirilgan.
Metodologik cheklovlar
Birinchi cheklov: Ma’lumot sintetikdir. Sintetik operatsiyalar tadqiqotchining farazlarini aks ettirgani uchun model ayni farazlarni o‘rganishi va haqiqiy bozorda natija pasayishi mumkin.
Ikkinchi cheklov: Shubhali yorliqlar avvalgi AML tekshiruvlaridan ilhomlanib yaratilgan deb qabul qilinsa-da, haqiqiy yorliqlangan tekshiruv ma’lumotlaridan foydalanilmaydi.
Uchinchi cheklov: Ma’lumotlar to‘plamidagi faqat %2-lik shubhali sinf jiddiy class imbalance hosil qiladi. Shunga qaramay, manba ROC-AUC, PR-AUC, confusion matrix yoki class-weight ta’sirlarini qayd etmaydi.
To‘rtinchi cheklov: HFT bilan bozor manipulyatsiyasi va money laundering tushunchalari ayrim bo‘limlarda bir-biriga juda yaqin qo‘llanadi. Bu xatti-harakatlar huquqiy va operatsion AML nuqtayi nazaridan turli tekshiruv turlarini talab qilishi mumkin.
Beshinchi cheklov: Real vaqt ilovasining hisoblash infratuzilmasi Apache Spark orqali muhokama qilinsa-da, end-to-end kechikish, throughput va peak-load testi taqdim etilmaydi.
Oltinchi cheklov: Manbalar ro‘yxatidagi ayrim yozuvlarning adabiyot bo‘limidagi iqtiboslar bilan to‘liq mos kelmasligi va ayrim bibliografik yozuvlarning sana/mavzu jihatidan e’tibor talab qilishi maqoladagi tashqi adabiyotga oid da’volarni alohida tekshirish zaruratini tug‘diradi.
Manba va Usul Haqida Izoh
Asl sarlavha: Predictive Analytics in Anti-Money Laundering for Detecting High-Frequency Trading Abuses and Identifying Early Warning Signs of Financial Crime
Muallif: Bharat Bhanushali.
PDFdagi affiliatsiya: BNP Paribas, Vice President, Jersey City, New Jersey, USA.
Nashr: International Journal of Research in Electronics and Computer Engineering (IJRECE).
Jild / Son: Vol. 7, Issue 1.
Davr: January–March 2019.
ISSN: 2393-9028 (Print), 2348-2281 (Online).
Sahifalar: 1273–1279.
Tadqiqot turi: Sintetik ma’lumotlar ustida mashinaviy o‘rganishga asoslangan AML/HFT usul tadqiqoti.
Ma’lumot: 1 million sintetik HFT operatsiyasi; Yanvar 2017–Dekabr 2018 davrini ifodalash uchun yaratilgan.
Shubhali operatsiyalar ulushi: %2.
O‘qitish: 200.000 operatsiya.
Validatsiya: Taxminan 400.000 operatsiya.
Test: Taxminan 400.000 operatsiya.
Asosiy modellar: Random forest va autoencoder.
Dasturlash / hisoblash: scikit-learn, TensorFlow va Apache Spark.
Random seed: 42.
Asosiy natija: Random forest accuracy 0,85; precision 0,80; recall 0,78; F1 0,79. Autoencoder accuracy 0,78; precision 0,75; recall 0,70; F1 0,72.
Eng muhim feature: Trade Velocity — 0,35 importance.
Ma’lumotlarning mavjudligi: Maqola kod va sintetik ma’lumot shablonlari so‘rov bo‘yicha taqdim etilishi mumkinligini bildiradi.
Mualliflik huquqi / litsenziya: Ko‘rib chiqilgan PDFda ochiq Creative Commons yoki boshqa qayta foydalanish litsenziyasi ko‘rsatilmagan. Shu sababli manba jadval va grafiklarini bevosita qayta ishlatishga ruxsat bor deb faraz qilinmasligi kerak.
Asosiy talqin chegarasi: Natijalar sintetik ma’lumotlar asosida olingan va haqiqiy bozor AML samaradorligi sifatida umumlashtirilmasligi kerak.
Bibliografik sifat qaydi: Manbalar ro‘yxatida adabiyot bo‘limidagi ayrim iqtiboslarga mos kelmaydigan yoki mavzu/sana jihatidan alohida tekshirilishi kerak bo‘lgan yozuvlar mavjud. Shu sababli Verianla matni tashqi manbalarning to‘g‘riligini tasdiqlamaydi, faqat PDFning o‘z usuli va natijalarini bayon qiladi.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan