

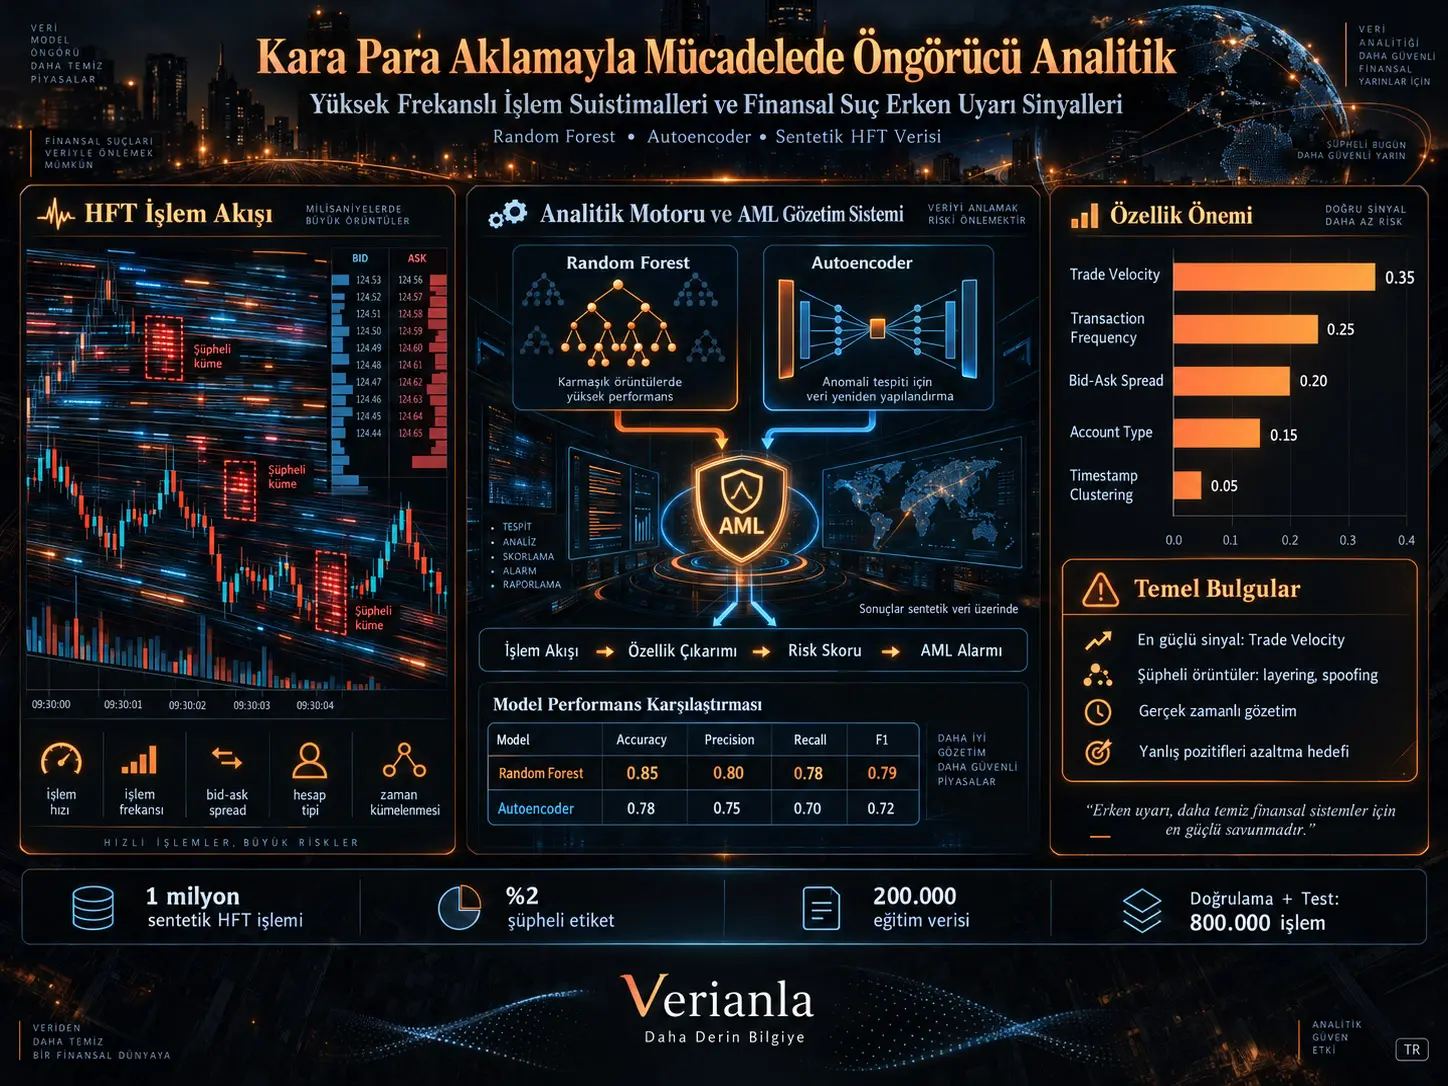
Bu çalışma, yüksek frekanslı işlem (HFT) ortamlarında ortaya çıkabilecek şüpheli işlem örüntülerini öngörücü analitik ve makine öğrenmesi kullanarak tespit etmeye yönelik bir anti-money laundering (AML) çerçevesi önermektedir. Random forest gibi denetimli öğrenme yöntemleri ile autoencoder tabanlı anomali tespitinin karşılaştırıldığı çalışmada; işlem hızı, işlem frekansı, bid-ask spread, hesap tipi ve zaman damgası kümelenmesi gibi özellikler finansal suç açısından erken uyarı sinyalleri olarak modellenmektedir.
Çalışmada kullanılan veri gerçek borsa soruşturma kayıtlarından oluşmamaktadır. Araştırmacı, Ocak 2017–Aralık 2018 dönemini temsil edecek biçimde 1 milyon işlemlik hipotetik fakat gerçekçi kabul edilen sentetik bir küresel hisse senedi HFT veri seti oluşturmuştur. İşlemlerin %2'si layering veya spoofing benzeri örüntülere göre şüpheli olarak etiketlenmiş, 200.000 işlem eğitim için kullanılmış, kalan 800.000 işlem doğrulama ve test kümelerine eşit olarak ayrılmıştır.
Kaynakta random forest modeli %85 accuracy, %80 precision, %78 recall ve %79 F1-score elde ederken autoencoder modeli sırasıyla %78, %75, %70 ve %72 değerlerine ulaşmaktadır. Random forest modelinde en yüksek değişken önemi 0,35 ile trade velocity yani saniye başına işlem yoğunluğuna verilmiştir.
Bu performans rakamlarının gerçek bir AML operasyonunda doğrulandığı sonucuna varılamaz. Sentetik veri, gerçek piyasalardaki eksik veriler, yanlış etiketler, farklı piyasa rejimleri, emir iptalleri, venue fragmentation ve suç davranışının kasıtlı biçimde değişmesi gibi sorunları tam olarak temsil etmeyebilir. Çalışma da bu sınırlılığı açık biçimde kabul etmektedir.
Yüksek frekanslı işlem AML açısından neden inceleniyor?
Yüksek frekanslı işlem, çok kısa zaman aralıklarında otomatik olarak büyük miktarda emir ve işlem üretebilir. Bu hız ve hacim, geleneksel sabit eşikli AML sistemleri açısından önemli bir veri işleme problemi yaratır. Normal bir HFT stratejisi dahi saniyeler veya milisaniyeler içinde binlerce mesaj üretebildiği için yalnız işlem sayısına dayalı basit kurallar yüksek miktarda yanlış alarm oluşturabilir.
Çalışmanın temel yaklaşımı, sabit AML kuralları yerine veri içerisindeki çok değişkenli örüntüleri öğrenen modeller kullanmaktır. Böylece tek bir “işlem sayısı eşiği” yerine işlem yoğunluğu, frekans, spread davranışı, hesap türü ve zaman içindeki kümelenme birlikte değerlendirilir.
Öngörücü Analitik Geleneksel AML Kurallarından Nasıl Ayrılıyor?
Kural tabanlı AML sistemleri önceden tanımlanmış eşikler ve senaryolar üzerinden alarm üretirken öngörücü analitik, geçmiş veya sentetik olarak etiketlenmiş örüntülerden istatistiksel ilişkiler öğrenir. Denetimli model bilinen şüpheli örüntüleri sınıflandırmaya çalışırken denetimsiz model, daha önce etiketlenmemiş olağandışı davranışları anomali olarak işaretleyebilir.
Çalışma bu nedenle iki farklı yaklaşımı karşılaştırmaktadır:
| Model | Öğrenme türü | Çalışmadaki rol |
|---|---|---|
| Random Forest | Denetimli öğrenme | Etiketlenmiş normal ve şüpheli işlemleri sınıflandırma |
| Autoencoder | Denetimsiz / anomali temelli yaklaşım | Normal örüntüden sapmaları tespit etme |
Random forest bilinen ve etiketlenmiş örüntülerde daha yüksek performans göstermektedir. Autoencoder ise daha düşük genel performansa rağmen daha önce tanımlanmamış anomalilerin yakalanabileceği tamamlayıcı bir mekanizma olarak tartışılmaktadır.
Sentetik veri nasıl oluşturuluyor?
Kaynak, bir küresel hisse senedi piyasasını temsil eden 1 milyon HFT işlemi üretmektedir. Veri yapısı NASDAQ benzeri halka açık piyasa verilerinden, SEC düzenleyici raporlarından ve FATF tipolojilerinden esinlenerek tasarlanmıştır. Çeşitlilik sağlamak amacıyla Monte Carlo tabanlı sentetik veri üretiminden söz edilmektedir.
Her işlemde kullanılan başlıca değişkenler şunlardır:
- işlem hacmi,
- işlem frekansı,
- bid-ask spread,
- hesap tipi,
- timestamp,
- türetilmiş trade velocity,
- zaman kümelenmesiyle ilişkili göstergeler.
Kaynakta işlemlerin yaklaşık %2'sinin layering veya spoofing benzeri şüpheli örüntüler taşıyacak şekilde etiketlendiği belirtilmektedir.
Sentetik Veri Neden Önemli Bir Sınırlılıktır?
Sentetik veri model geliştirmek ve kontrollü karşılaştırmalar yapmak için yararlıdır; ancak gerçek piyasalardaki davranışların bütün karmaşıklığını içermez. Gerçek HFT verisinde eksik kayıtlar, venue routing, market-maker davranışları, emir iptalleri, farklı likidite rejimleri, haber olayları, hesaplar arası ilişkiler ve yanlış ya da eksik AML etiketleri bulunabilir.
Bu nedenle çalışmadaki %85 accuracy değeri gerçek bir finansal kurumun canlı AML sisteminde beklenen performans olarak kullanılmamalıdır. Bu rakam, araştırmacının kurduğu sentetik veri ve etiketleme çerçevesi içinde random forest modelinin test performansıdır.
Örnekleme ve veri bölme
Çalışmada eğitim için stratified sampling kullanılmaktadır. Toplam 1 milyon işlemden 200.000 işlem model eğitimi için seçilir. Tabakalaştırma hesap türü ve işlem hacmine göre yapılmaktadır.
Kalan 800.000 işlem eşit biçimde iki parçaya ayrılarak:
- 400.000 doğrulama gözlemi,
- 400.000 test gözlemi
olarak kullanılmaktadır.
Araştırmacı tekrarlanabilirlik için random seed değerinin 42 olarak sabitlendiğini belirtmektedir.
Kullanılan hesaplama araçları
Denetimli modeller için scikit-learn, autoencoder uygulaması için TensorFlow ve büyük ölçekli veri işleme için Apache Spark kullanıldığı belirtilmektedir. Model performansı accuracy, precision, recall ve F1-score üzerinden değerlendirilmektedir.
Bu araçların kullanılmış olması tek başına modelin gerçek zamanlı üretim ortamına hazır olduğunu göstermez. Gerçek zamanlı HFT gözetimi gecikme, throughput, veri bütünlüğü, model drift'i ve açıklanabilirlik gibi ek gereksinimler taşır.
Çalışmanın Yöntemi ve Bulguları
Random forest ve autoencoder performansı
| Model | Accuracy | Precision | Recall | F1-Score |
|---|---|---|---|---|
| Random Forest | 0,85 | 0,80 | 0,78 | 0,79 |
| Autoencoder | 0,78 | 0,75 | 0,70 | 0,72 |
Kaynağın Tablo 1 sonuçlarında random forest bütün dört performans ölçüsünde autoencoder'ın üzerinde yer almaktadır. Accuracy farkı 7 yüzde puanı, recall farkı 8 yüzde puanı ve F1 farkı 7 yüzde puanıdır.
Burada accuracy tek başına yeterli bir değerlendirme ölçüsü değildir. Veri setinin yalnız %2'sinin şüpheli olarak etiketlendiği belirtilmektedir; dolayısıyla ciddi sınıf dengesizliğinin bulunduğu bir AML probleminde precision, recall, F1 ve sınıf bazlı hata dağılımı özellikle önemlidir.
AML Modelinde En Önemli Erken Uyarı Göstergeleri Hangileri?
Random forest modelinin kaynakta raporlanan feature importance değerleri şöyledir:
| Özellik | Importance |
|---|---|
| Trade Velocity | 0,35 |
| Transaction Frequency | 0,25 |
| Bid-Ask Spread | 0,20 |
| Account Type | 0,15 |
| Timestamp Clustering | 0,05 |
Modelin en güçlü özelliği trade velocity olarak raporlanmıştır. Bu değişken, belirli bir zaman biriminde gerçekleşen işlem yoğunluğunu temsil eder. Ardından transaction frequency ve bid-ask spread gelmektedir.
Feature importance değeri, değişkenin tek başına suçun nedeni olduğunu veya belirli bir işlem hızının otomatik olarak şüpheli sayılması gerektiğini göstermez. Random forest önem ölçütleri model içindeki tahmin katkısını gösterir ve değişkenler arasında korelasyon bulunduğunda ekonomik yorumları dikkatle yapılmalıdır.
Model eğitimi boyunca doğruluk
Kaynağın Figure 1 grafiğinde random forest modelinin accuracy değeri beş eğitim iterasyonunda yaklaşık %75'ten %85'e yükselmektedir. Autoencoder ise yaklaşık %70'ten %78'e çıkmaktadır.
Bu görsel, random forest modelinin verilen sentetik senaryoda daha hızlı ve daha yüksek bir performans seviyesine ulaştığını göstermektedir. Bununla birlikte “training iteration” tanımının algoritmik olarak nasıl oluşturulduğu kaynakta ayrıntılı biçimde açıklanmamaktadır; dolayısıyla grafik klasik bir epoch-based learning curve ile bire bir eşitlenmemelidir.
Yanlış pozitifler hakkında ne raporlanıyor?
Sonuç bölümünde önerilen yaklaşımın geleneksel rule-based sistemlere göre yanlış pozitifleri %25 azalttığı ifade edilmektedir. Ancak bu sonuç için ayrı bir tablo, confusion matrix veya doğrudan deneysel karşılaştırma kaynakta gösterilmemektedir.
Bu nedenle %25 rakamı çalışmanın sonuç bölümündeki bir yazar beyanı olarak aktarılabilir; bağımsız biçimde yeniden hesaplanmış veya ayrıntılı deney tablosuyla doğrulanmış bir bulgu şeklinde sunulmamalıdır.
Gerçek zamanlı tespit süresi
Kaynak sonuç bölümünde detection delay'in %40 azaltılabildiğini de belirtmektedir. Ancak aynı paragraf bu sonucu Wang ve çalışma arkadaşlarının önceki bulgularıyla ilişkilendirmektedir ve mevcut çalışmada buna ait bağımsız bir gecikme benchmark tablosu sunulmamaktadır.
Bu nedenle %40 gecikme azaltma değeri de mevcut sentetik deneyin doğrudan ölçülmüş ana çıktılarından biri olarak değerlendirilmemelidir.
Layering ve Spoofing Kara Para Aklama ile Aynı Şey midir?
Hayır. Layering ve spoofing tipik olarak emir defterinin yanıltıcı emirlerle etkilenmesi veya piyasa katılımcılarının yanlış fiyat/likidite sinyalleriyle yönlendirilmesiyle ilişkili piyasa manipülasyonu davranışlarıdır. Kara para aklama ise suç gelirinin kaynağını ve sahipliğini gizleme sürecidir.
Kaynak bu davranışları daha geniş “financial crime” ve AML erken uyarı çerçevesi içinde birlikte ele almaktadır. Ancak bir spoofing veya layering alarmı tek başına money laundering kanıtı değildir. AML sisteminde bu tür davranışlar ancak hesaplar arası fon akışı, beneficial ownership, müşteri profili ve diğer işlem bağlamlarıyla birlikte değerlendirilmelidir.
Denetimli ve denetimsiz modeller birlikte kullanılabilir mi?
Çalışmanın tartışma bölümünde hibrit bir sistem önerilmektedir. Random forest geçmişte etiketlenmiş bilinen örüntülerde yüksek sınıflandırma performansı sağlayabilirken autoencoder daha önce görülmemiş anormal davranışları tespit etmek için kullanılabilir.
Önerilen genel mimari şu biçimde düşünülebilir:
Canlı işlem akışı → özellik çıkarımı → anomali taraması → supervised risk skoru → AML analist incelemesi
Ancak kaynak bu hibrit sistemi deneysel olarak kurup ayrı performans metrikleriyle sınamamaktadır. Bu nedenle hibrit yaklaşım çalışmanın geleceğe dönük önerisidir.
Açıklanabilirlik problemi
AML kararlarının düzenleyiciler ve uyum ekipleri tarafından açıklanabilir olması gerekir. Random forest gibi modeller, basit eşik tabanlı kurallara göre daha karmaşık karar ilişkileri oluşturabilir.
Kaynak gelecekte SHAP gibi açıklanabilir yapay zekâ yöntemlerinin kullanılmasını önermektedir. Böylece bir alarmın hangi işlem özelliklerinden ne ölçüde etkilendiği analistlere gösterilebilir.
Çalışmanın desteklediği sonuçlar
- Sentetik HFT veri setinde random forest, autoencoder'dan daha yüksek accuracy, precision, recall ve F1-score elde etmiştir.
- Random forest accuracy değeri 0,85 olarak raporlanmıştır.
- Trade velocity, random forest modelinde 0,35 ile en yüksek feature importance değerine sahiptir.
- Transaction frequency ve bid-ask spread sonraki en önemli değişkenlerdir.
- Denetimsiz anomali tespiti, etiketlenmemiş örüntüler için tamamlayıcı bir yaklaşım olarak tartışılmaktadır.
- Gerçek zamanlı AML gözetiminde büyük veri altyapısı ve yüksek hızlı özellik çıkarımının önemli olduğu savunulmaktadır.
Çalışmanın desteklemediği sonuçlar
- %85 accuracy gerçek dünya HFT AML sistemlerinde doğrulanmış bir başarı oranı değildir.
- Çalışma gerçek bir milyon borsa işlemini kullanmamaktadır; veri sentetiktir.
- Her yüksek trade velocity değeri kara para aklama göstergesi değildir.
- Layering veya spoofing tespiti tek başına kara para aklama tespiti anlamına gelmez.
- Kaynakta gerçek bir canlı-borsa latency benchmark'ı sunulmamaktadır.
- %25 false-positive azalması ve %40 detection-delay azalması ayrıntılı deney tablosuyla bağımsız olarak gösterilmemektedir.
- Sonuçlar kripto, türev, FX veya başka piyasalara doğrudan genellenemez; veri tasarımı hisse senedi HFT ortamına yöneliktir.
Metodolojik sınırlılıklar
Birinci sınırlılık: Veri sentetiktir. Sentetik işlemler araştırmacının varsayımlarını yansıttığı için model aynı varsayımları öğrenebilir ve gerçek piyasada performans düşebilir.
İkinci sınırlılık: Şüpheli etiketler geçmiş AML soruşturmalarından esinlenerek oluşturulmuş kabul edilse de gerçek etiketli soruşturma verisi kullanılmamaktadır.
Üçüncü sınırlılık: Veri setindeki yalnız %2'lik şüpheli sınıf ciddi class imbalance oluşturur. Buna rağmen kaynak ROC-AUC, PR-AUC, confusion matrix veya class-weight etkilerini raporlamamaktadır.
Dördüncü sınırlılık: HFT ile piyasa manipülasyonu ve money laundering kavramları bazı bölümlerde birbirine oldukça yakın kullanılmaktadır. Bu davranışlar hukuken ve operasyonel AML açısından farklı inceleme türleri gerektirebilir.
Beşinci sınırlılık: Gerçek zamanlı uygulamanın hesaplama altyapısı Apache Spark üzerinden tartışılsa da end-to-end gecikme, throughput ve peak-load testi sunulmamaktadır.
Altıncı sınırlılık: Kaynakçadaki bazı kayıtların literatür bölümündeki atıflarla tam eşleşmemesi ve bazı bibliyografik kayıtların tarih/konu açısından dikkat gerektirmesi, makaledeki dış-literatür iddialarının ayrıca doğrulanmasını gerekli kılar.
Kaynak ve Yöntem Notu
Özgün başlık: Predictive Analytics in Anti-Money Laundering for Detecting High-Frequency Trading Abuses and Identifying Early Warning Signs of Financial Crime
Yazar: Bharat Bhanushali.
PDF'deki afiliyasyon: BNP Paribas, Vice President, Jersey City, New Jersey, USA.
Yayın: International Journal of Research in Electronics and Computer Engineering (IJRECE).
Cilt / Sayı: Vol. 7, Issue 1.
Dönem: January–March 2019.
ISSN: 2393-9028 (Print), 2348-2281 (Online).
Sayfalar: 1273–1279.
Çalışma türü: Sentetik veri üzerinde makine öğrenmesi temelli AML/HFT yöntem araştırması.
Veri: 1 milyon sentetik HFT işlemi; Ocak 2017–Aralık 2018 dönemini temsil edecek biçimde oluşturulmuştur.
Şüpheli işlem oranı: %2.
Eğitim: 200.000 işlem.
Doğrulama: Yaklaşık 400.000 işlem.
Test: Yaklaşık 400.000 işlem.
Ana modeller: Random forest ve autoencoder.
Programlama / hesaplama: scikit-learn, TensorFlow ve Apache Spark.
Random seed: 42.
Ana performans: Random forest accuracy 0,85; precision 0,80; recall 0,78; F1 0,79. Autoencoder accuracy 0,78; precision 0,75; recall 0,70; F1 0,72.
En önemli feature: Trade Velocity — 0,35 importance.
Veri erişilebilirliği: Makale, kod ve sentetik veri şablonlarının talep üzerine sağlanabileceğini belirtmektedir.
Telif / lisans: İncelenen PDF'de açık bir Creative Commons veya başka yeniden kullanım lisansı belirtilmemektedir. Bu nedenle kaynak tablo ve grafiklerinin doğrudan yeniden kullanımında izin varsayılmamalıdır.
Temel yorum sınırı: Sonuçlar sentetik veri üzerinde üretilmiştir ve gerçek piyasa AML etkinliği olarak genellenmemelidir.
Bibliyografik kalite notu: Kaynakçada literatür bölümündeki bazı atıflarla uyuşmayan veya konu/tarih açısından ayrıca doğrulanması gereken kayıtlar bulunmaktadır. Bu nedenle Verianla metni dış referansların doğruluğunu onaylamamakta, yalnızca PDF'nin kendi yöntem ve sonuçlarını aktarmaktadır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir