

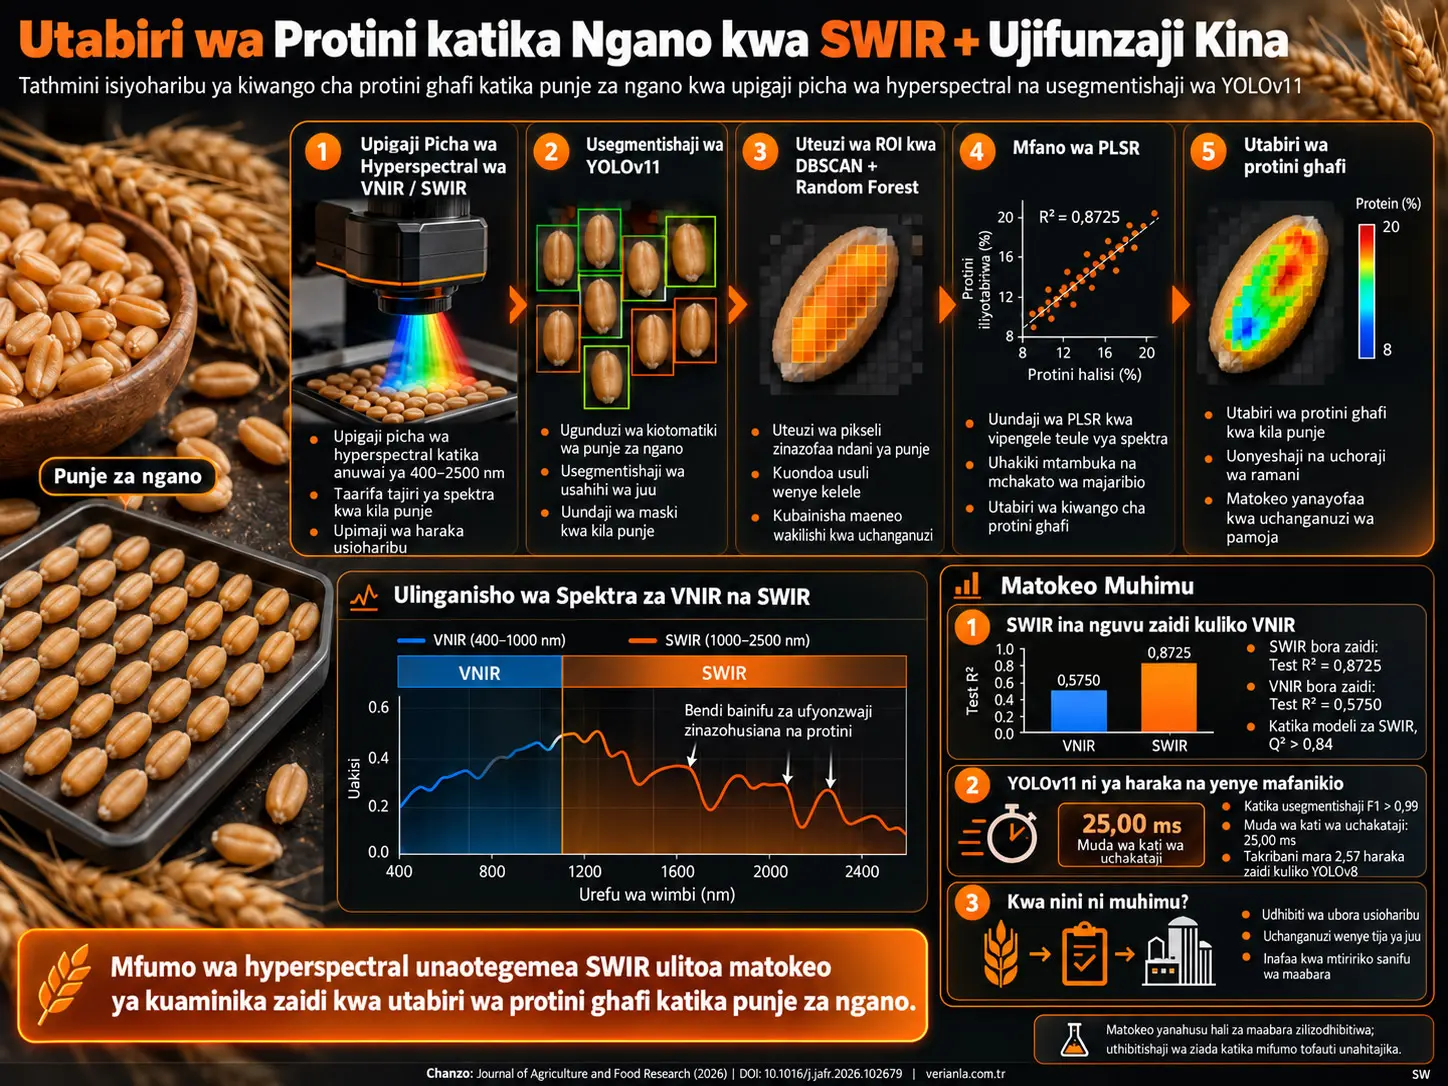
Upigaji picha wa hipaspektramu wa SWIR ni mbinu isiyoharibu sampuli ambayo hurekodi ndani ya picha moja taarifa za uakisi wa kitu katika idadi kubwa ya urefu mwembamba wa mawimbi katika eneo la infrared ya mawimbi mafupi. Utafiti huu uliunganisha upigaji picha wa hipaspektramu wa SWIR na VNIR na ugawaji wa punje unaotegemea YOLOv11, uteuzi wa eneo la kuvutiwa unaotegemea DBSCAN na Random Forest, pamoja na Urejeleaji wa Viwango Vidogo vya Mraba (Partial Least Squares Regression, PLSR), kwa lengo la kukadiria kwa haraka na bila kuharibu punje maudhui ya protini ghafi katika punje za ngano. Jumla ya punje halisi 4200 kutoka aina 45 za ngano zilizopatikana katika miaka ya 2023 na 2024 zilipigwa picha kwa mifumo miwili tofauti ya spektramu, na thamani rejea za protini ghafi zilibainishwa kwa uchambuzi wa nitrojeni wa Dumas. Hitimisho kuu la utafiti ni kwamba, chini ya hali za upigaji picha zilizodhibitiwa, spektramu ya SWIR ilitoa utendaji wa jumla wa utabiri wa protini ghafi ulio juu zaidi na thabiti zaidi kwa kiwango kinachoonekana ikilinganishwa na VNIR.
Utendaji wa juu zaidi wa jaribio la SWIR ulipatikana kwa uchakataji awali wa Multiplicative Scatter Correction (MSC), ukiwa Test R² = 0,8725 na RMSE = 0,7479. Hata hivyo, uchakataji awali wa Savitzky–Golay ulipunguza idadi ya vipengele vya PLS kutoka 10 katika data ghafi hadi 3 huku ukidumisha thamani za Test R² = 0,8449 na Q² = 0,8487, hivyo kutoa modeli rahisi zaidi. Katika modeli za SWIR, thamani ya Q² ya mbinu zote zilizojaribiwa za uchakataji awali ilibaki juu ya 0,84, wakati modeli bora ya VNIR ilikuwa katika kiwango cha Test R² = 0,5750 na Q² = 0,5793.
Ugawaji wa YOLOv11 uliweza kudumisha thamani ya F1 juu ya 0,99 katika picha zilizokuwa cropped wakati ongezeko la data lilipotumika. Muda wa kati wa uchakataji wa modeli ulipimwa kuwa 25,00 ms na ulikuwa takriban mara 2,57 haraka kuliko YOLOv8 katika ulinganisho wa utafiti huohuo. Hata hivyo, matokeo yalipatikana kwa kamera zilezile, mwanga uliodhibitiwa na itifaki sanifu ya upigaji picha. Utafiti huu haujathibitisha kwamba utendaji huo huo utadumishwa katika vifaa tofauti, mazingira tofauti na seti za data za taasisi huru.
Kwa nini maudhui ya protini ghafi ya ngano hupimwa?
Muundo wa protini wa ngano, hasa kutokana na protini za gliadin na glutenin zinazounda mtandao wa gluten, unahusiana kwa karibu na sifa za uchakataji wa unga. Katika uamuzi wa kawaida wa protini ghafi, mbinu za kikemia kama Kjeldahl au Dumas zinaweza kutumika. Ingawa mbinu hizi zinaweza kutoa usahihi wa juu, zinahitaji maandalizi ya sampuli, usagaji na uchambuzi wa kikemia au unaotegemea uchomaji. Katika hali ya uzalishaji au udhibiti wa ubora ambapo idadi kubwa ya punje inahitaji kuainishwa kwa haraka, kuchunguza kila punje kando kwa mbinu hizi huweka kikomo katika uchunguzi wenye uwezo mkubwa.
Spektroskopia ya infrared ya karibu huruhusu uchambuzi usioharibu sampuli; hata hivyo, spektrofotoma za kawaida mara nyingi hupata spektramu kutoka sehemu ndogo ya sampuli. Upigaji picha wa hipaspektramu, kwa upande mwingine, huunganisha taarifa za uakisi za urefu mwingi wa mawimbi katika kila nukta ya anga ya picha, hivyo kuruhusu maswali ya “wapi?” na “kwa sifa gani ya spektramu?” kushughulikiwa ndani ya seti moja ya data.
Kwa Nini SWIR Ilitoa Matokeo Yenye Nguvu Zaidi Kuliko VNIR katika Utabiri wa Protini ya Ngano?
Kwa kuwa eneo la SWIR linajumuisha taarifa za spektramu zinazohusiana na overtones za mtetemo na bendi za mchanganyiko za vifungo vya N–H, C=O na C–N vilivyopo katika protini, katika utafiti huu lilibeba ishara za kikemia zilizo za moja kwa moja zaidi kuhusu maudhui ya protini ghafi. Kinyume chake, eneo la VNIR lililotumika halikujumuisha sehemu muhimu ya maeneo haya bayana ya ufyonzaji yanayohusiana na protini; badala yake liliathiriwa zaidi na sifa za kimaumbile zenye uhusiano dhaifu na protini, kama rangi ya ganda la punje. Kwa hiyo, modeli za PLSR zinazotegemea SWIR zilibaki katika kiwango cha Q² > 0,84 kwa chaguo zote za uchakataji awali, huku utendaji wa jumla wa modeli za VNIR ukiwa chini kwa kiwango kinachoonekana.
Katika utafiti, eneo la VNIR lilikuwa 397,32–1003,58 nm, huku eneo la SWIR likiwa 982,08–2576,58 nm. Spektramu za wastani za makundi yenye protini ghafi ya juu na ya chini zilipolinganishwa, katika VNIR iligunduliwa nukta moja tu ya mgeuko iliyo wazi, ilhali katika spektramu ya SWIR zilibainishwa nukta nane za mgeuko:
- 992,0 nm,
- 1200,5 nm,
- 1473,9 nm,
- 1779,3 nm,
- 1934,4 nm,
- 2283,0 nm,
- 2316,2 nm,
- 2487,8 nm.
Waandishi wanatafsiri nukta ya 1473,9 nm kuwa karibu na eneo la takriban 1500–1530 nm linalohusishwa na mitetemo ya N–H; na nukta za 2283,0 na 2316,2 nm kuwa sifa za spektramu zilizo karibu na bendi za mchanganyiko zinazohusiana na mitetemo ya C=O na N–H katika muundo wa protini. Tafsiri hii inaashiria kwamba nukta za mgeuko zilizozingatiwa zinaweza kutokana na mitetemo inayohusiana na protini; utafiti haukufanya uthibitisho huru wa kimolekuli kwa kila moja ya nukta hizi.
Nukta ya mgeuko ya takriban 1000,5 nm iliyogunduliwa katika VNIR iko kwenye mpaka wa mwisho wa eneo la sensa. Watafiti wanaelekeza umakini kwa uwezekano kwamba mabadiliko haya ya ghafla ya spektramu yanawakilisha kelele katika mpaka wa kipimo cha kifaa zaidi kuliko ishara halisi ya kibayokemia.
YOLOv11 Inafanya Nini katika Utafiti Huu?
YOLOv11 katika utafiti huu si modeli inayokadiria moja kwa moja kiasi cha protini ghafi; ni kipengele cha ujifunzaji wa kina kinachogawa kiotomatiki punje moja moja za ngano na maeneo meupe ya rejea katika picha za hipaspektramu, na hivyo kuamua mpaka wa anga ambamo taarifa za spektramu za kila punje zitatolewa. Utabiri wa protini hufanywa katika hatua inayofuata kwa kuingiza katika modeli ya PLSR sifa za spektramu zilizotolewa kutoka katika sehemu hizo.
Tofauti hii ni muhimu kwa kuelewa mfumo. Katika utafiti, kazi tatu tofauti za uchanganuzi zimeunganishwa:
- Kutambua kitu: YOLOv11 huamua ni eneo gani katika picha ni punje ya ngano.
- Kuboresha ROI ya spektramu: Kwa kutumia UMAP, DBSCAN na Random Forest Classifier, pikseli ndani ya kisanduku cha YOLO ambazo kwa kweli ni za punje hutenganishwa.
- Kutabiri sifa ya kikemia: Spektramu inayotolewa kutoka pikseli zilizochaguliwa huingizwa katika modeli ya PLSR na maudhui ya protini ghafi hukadiriwa.
Kwa nini ugawaji wa YOLO pekee haukuonekana kuwa wa kutosha?
Ingawa YOLO inaweza kubainisha eneo la punje, bounding box inayopatikana inaweza kujumuisha si punje pekee bali pia pikseli za mandharinyuma zinazoizunguka. Kwa kuwa katika utabiri wa hipaspektramu hata pikseli chache zisizo sahihi zinaweza kubadilisha spektramu ya wastani ya uakisi, watafiti waliainisha kando eneo halisi la spektramu la punje.
Kwa kusudi hili, data za spektramu kwanza ziliwekwa katika masafa ya 0–1 kwa Min-Max scaling, upunguzaji wa vipimo ukatumika kwa kutumia UMAP, na kisha makundi ya DBSCAN yakaundwa. Lebo za madarasa zilizoundwa na DBSCAN zilitumika kwa mafunzo ya Random Forest Classifier. Katika tathmini ya majaribio, eps = 0,46 ilichaguliwa kwa DBSCAN; na kina cha juu = 2 kwa Random Forest.
Katika utoaji wa mwisho wa ROI, maeneo yenye uakisi wa chini sana pia yaliondolewa. Maeneo yenye uakisi zaidi ya %30 chini ya uakisi wa kati wa jumla yaliondolewa, na non-maximum suppression inayotegemea Intersection over Union (IoU) ikatumika kwa visanduku vya ugunduzi vinavyopishana.
Maudhui ya Protini Ghafi Yalipimwaje Kihalisi katika Utafiti Huu?
Thamani rejea ya protini ghafi ambayo modeli ilipaswa kujifunza haikutolewa na kamera ya hipaspektramu; baada ya upigaji picha kukamilika, sampuli za ngano zilisagwa, kiasi cha jumla cha nitrojeni kilipimwa kwa kichanganuzi cha Dumas, na maudhui ya protini ghafi yakahesabiwa kwa kuzidisha thamani ya nitrojeni kwa mgawo wa ubadilishaji 5,7. Kwa njia hii, modeli inayotegemea picha ilijifunza kutabiri kipimo rejea cha kikemia.
Sampuli zilisawazishwa katika kifaa cha Automill kwa 140 rpm kwa sekunde 60 mara mbili, jumla ya sekunde 120. Uchambuzi wa jumla wa nitrojeni ulifanywa kwa kichanganuzi cha FlashSmart CHNS/O Dumas.
Jumla ya vipimo 306 vya rejea vya protini ghafi vilifanywa:
- Mavuno ya 2023: aina 45 × marudio 3 ya kiufundi = vipimo 135,
- Ngano ya majira ya baridi ya 2024: aina 45 × marudio 3 ya kiufundi = vipimo 135,
- Aina 6 wakilishi zilizochaguliwa mwaka 2024: aina 6 × marudio 6 ya kiufundi = vipimo 36.
PLSR Inatabiri Nini katika Mfumo Huu?
PLSR ni modeli ya urejeleaji inayowakilisha mamia ya urefu wa mawimbi ya spektramu yenye uhusiano mkubwa katika idadi ndogo ya vipengele fiche, na kutumia taarifa hiyo ya spektramu kutabiri thamani rejea ya protini ghafi. Sifa hii ni muhimu hasa kwa data za hipaspektramu ambako urefu wa mawimbi jirani unahusiana kwa nguvu.
Katika modeli ya VNIR, bendi zote 204 zilitumika, na katika modeli ya SWIR bendi zote 288 zilitumika. Kabla ya uundaji wa modeli, pamoja na spektramu ghafi, mbinu tatu tofauti za uchakataji awali wa spektramu zilitathminiwa:
- SNV — Standard Normal Variate: mbinu ya usanifishaji inayolenga kupunguza tofauti za utawanyiko na kipimo.
- MSC — Multiplicative Scatter Correction: mbinu inayolenga kurekebisha utawanyiko wa mwanga wa kuzidisha na athari zinazofanana.
- Savitzky–Golay: mbinu ya kulainisha/derivative inayolenga kupunguza kelele ya spektramu na kuhifadhi umbo la spektramu.
Kwa Savitzky–Golay, urefu wa dirisha wa 5, 7, 9 na 11; daraja za polinomu za 2 na 3; daraja za derivative za 1 na 2; na idadi ya vipengele vya PLS kati ya 1–30 vilitathminiwa kwa grid search.
Vipimo vya utendaji wa modeli
Katika utafiti, vipimo vitatu vikuu vya utendaji vilitumika.
\[ R^2 = 1 - \frac{\sum_i (y_i-\hat{y}_i)^2} {\sum_i (y_i-\bar{y})^2} \]
Hapa \(y_i\) ni thamani iliyozingatiwa ya protini ghafi, \(\hat{y}_i\) ni utabiri wa modeli na \(\bar{y}\) ni wastani wa thamani zilizozingatiwa. \(R^2\) huonyesha kiwango ambacho modeli inaeleza utofauti wa data.
\[ RMSE = \sqrt{ \frac{\sum_i (y_i-\hat{y}_i)^2}{n} } \]
RMSE ni mzizi wa mraba wa wastani wa miraba ya makosa ya utabiri. Kwa hiyo, RMSE ya chini huonyesha kwamba utabiri kwa ujumla uko karibu zaidi na thamani rejea.
\[ Q^2 = 1-\frac{PRESS}{SS_{tot}} \]
\[ PRESS=\sum_i (y_i-\hat{y}_{i,-i})^2 \]
\(Q^2\) ni kiashiria cha ufaafu wa utabiri kinachotumika kutathmini kiwango ambacho utabiri kwa sampuli ambazo hazikuonekana wakati wa cross-validation una maana. Katika utafiti, hasa ukweli kwamba thamani za Q² za modeli za SWIR zilikuwa juu ya 0,84 katika mbinu zote za uchakataji awali ulitumiwa kama mojawapo ya ushahidi mkuu wa uthabiti wa modeli.
Mbinu na Matokeo ya Utafiti
Nyenzo za mimea na muundo wa sampuli
Katika utafiti, aina 45 za ngano zilizolimwa Korea zilitumika. Katika mavuno ya 2023, punje 20 kwa kila aina na marudio matatu ya kiufundi zilitumika na jumla ya punje 2700 zilipigwa picha. Katika mavuno ya 2024, punje 900 kutoka aina hizo hizo 45 zilitumika, pamoja na punje 600 za ziada kutoka aina sita wakilishi zinazolimwa sana Korea, kwa punje 100 kwa kila aina. Hivyo, jumla ya mwaka 2024 ilikuwa 1500 na jumla ya utafiti mzima ilifikia punje halisi 4200 za ngano.
Kwa kuwa kila punje halisi ilipigwa picha kando katika mifumo ya VNIR na SWIR, jumla ya picha 84 za hipaspektramu ziliundwa, zikiwa 42 VNIR na 42 SWIR, na mwisho wa uchambuzi zikapatikana profaili binafsi 4200 × 2 = 8400 za spektramu za punje.
Mifumo miwili ya upigaji picha wa hipaspektramu
| Sifa | VNIR | SWIR |
|---|---|---|
| Kamera | Specim IQ | Specim SWIR |
| Eneo la spektramu | 397,32–1003,58 nm | 982,08–2576,58 nm |
| Idadi ya bendi | 204 | 288 |
| Azimio la spektramu lililoripotiwa katika mbinu | 7 nm | 12 nm FWHM |
| Umbali wa takriban wa kamera | 1 m | 1 m |
| Mwangaza | Vyanzo viwili vya mwanga wa halojeni | Vyanzo viwili vya mwanga wa halojeni |
| Rejea nyeupe | Bariamu sulfati yenye uakisi wa %99,9 | Paneli sanifu ya rejea nyeupe ya kifaa |
Katika upigaji picha wa SWIR, conveyor inayosonga ilitumika. Katika mifumo yote miwili, thamani ghafi za ukali zilibadilishwa kuwa uakisi kwa kutumia rejea nyeupe na nyeusi:
\[ R=\frac{I-D}{W-D} \]
Hapa \(R\) ni uakisi uliokalibrishwa, \(I\) ni ukali ghafi uliopimwa, \(D\) ni ukali wa mkondo wa giza na \(W\) ni ukali wa rejea nyeupe. Mlinganyo hurekebisha kipimo katika eneo la rejea nyeupe baada ya kuondoa ishara ya giza ya sensa.
Seti ya data ya mafunzo ya YOLOv11 iliundwaje?
Kati ya jumla ya picha 84, 10 — 5 VNIR na 5 SWIR — zilichaguliwa bila mpangilio na kuwekewa lebo kwa mkono kwa kutumia Labelme. Punje zilifafanuliwa kama darasa 0 na rejea nyeupe kama darasa 1, na mwanzoni ziliundwa lebo 1000 za punje na lebo 10 za rejea nyeupe.
Kebo za hipaspektramu zilibadilishwa kuwa picha za pseudo-RGB kutoka bendi tatu kwa mafunzo ya YOLO. Kwa VNIR zilitumika bendi za 634,11 nm, 560,30 nm na 452,25 nm; na kwa SWIR zilitumika bendi za 1133,52 nm, 1335,78 nm na 1662,69 nm.
Katika ongezeko la data, random cropping na image concatenation zilitumika na, kwa mujibu wa ripoti ya utafiti chanzo, seti ya data ya mafunzo iliongezwa mara 110 ikilinganishwa na seti ya awali.
Vigezo vya mafunzo ya YOLOv11
| Kigezo | Thamani |
|---|---|
| Epoch | 100 |
| Ukubwa wa picha | 640 × 640 pikseli |
| Batch size | 4–6 |
| Kiwango cha awali cha ujifunzaji | 0,01 |
| Momentum | 0,937 |
| Weight decay | 0,0005 |
| Kizingiti cha uthibitishaji wa IoU | 0,7 |
| Horizontal flip | 0,5 |
| Scale | 0,5 |
| Translation | 0,1 |
| HSV hue | 0,015 |
| HSV saturation | 0,7 |
| HSV value | 0,4 |
| Mosaic | 1,0 |
| Random erasing | 0,4 |
Kituo cha kazi cha mafunzo kilitumia kichakataji AMD Ryzen 5 3600, 32 GB RAM na NVIDIA RTX 3060 GPU. Mixed-precision training (AMP) iliwashwa.
Ongezeko la Data Liliathirije Ujumlishaji wa YOLO?
Ongezeko la data liliongeza kwa kiwango kinachoonekana uwezo wa modeli kustahimili mabadiliko ya nafasi, kipimo na upunguzaji katika picha za punje zilezile za ngano. Ingawa modeli zilizofunzwa kwa picha ghafi ziliweza kufikia thamani za juu sana za F1 katika picha zote za ukubwa kamili, recall na F1 zilishuka katika picha za uthibitishaji zilizokuwa cropped; seti za mafunzo zilizoongezwa zilipotumiwa, thamani za F1 katika picha cropped ziliongezeka tena hadi takriban 0,99–1,00.
| Modeli | Precision | Recall | F1 |
|---|---|---|---|
| IA2 | 0,9735 | 1,0000 | 0,9866 |
| IA4 | 1,0000 | 1,0000 | 1,0000 |
| IA6 | 0,9932 | 1,0000 | 0,9966 |
| IA8 | 0,9932 | 1,0000 | 0,9966 |
| IA10 | 0,9932 | 0,9932 | 0,9932 |
Jedwali hili linawakilisha tu hali ya uthibitishaji iliyoundwa na utafiti kutoka picha cropped. Halipaswi kutafsiriwa kama utendaji wa jumla katika kamera, taasisi au mazingira tofauti.
Kasi ya uchakataji
Muda wa kati wa jumla wa uchakataji wa ugawaji wa YOLOv11 ulipimwa kuwa 25,00 ms. Katika ulinganisho huo huo, 64,30 ms iliripotiwa kwa YOLOv8. Thamani ya 25 ms/picha kinadharia inalingana na kasi ya takriban 40 picha/sekunde, na watafiti waliitathmini kama faida muhimu kwa uchakataji wa data wenye uwezo mkubwa.
Mkakati wa mafunzo/uthibitishaji/test wa PLSR
Data za spektramu za 2023 na 2024 ziliunganishwa na %10 ya data yote ilitengwa bila mpangilio kuwa seti huru ya test. Cross-validation ya mikunjo mitano ilitumika kwa %90 iliyobaki; ndani ya kila fold, data ilitumika kama %80 mafunzo na %20 uthibitishaji.
Matokeo ya utabiri wa VNIR na SWIR
| Uchakataji awali | Spektramu | Kipengele cha PLS | Test R² | Test RMSE | Q² / tafsiri |
|---|---|---|---|---|---|
| Data ghafi | VNIR | 10 | 0,0641 | 2,0260 | Ujumlishaji mdogo |
| Data ghafi | SWIR | 10 | 0,8693 | 0,7571 | Kundi la SWIR Q² > 0,84 |
| SNV | VNIR | 9 | 0,5205 | 1,4501 | VNIR ina kikomo |
| SNV | SWIR | 7 | 0,8547 | 0,7984 | Kundi la SWIR Q² > 0,84 |
| MSC | VNIR | 9 | -0,0495 | 2,1455 | Q² = -0,0296 |
| MSC | SWIR | 9 | 0,8725 | 0,7479 | Q² = 0,8738 |
| Savitzky–Golay | VNIR | 8 | 0,5750 | 1,3653 | Q² = 0,5793 |
| Savitzky–Golay | SWIR | 3 | 0,8449 | 0,8247 | Q² = 0,8487 |
Jedwali linahitaji kutofautisha dhana mbili tofauti za “modeli nzuri”. Ikiwa kinachotafutwa ni Test R² ya juu zaidi pekee, mchanganyiko wa MSC–SWIR unaonekana mbele. Hata hivyo, ikiwa ugumu wa modeli pia unazingatiwa, modeli ya Savitzky–Golay–SWIR ilidumisha uwezo mkubwa wa utabiri kwa vipengele vitatu tu vya PLS. Kwa hiyo, katika utafiti, usahihi wa juu zaidi na modeli rahisi zaidi si usanidi mmoja.
Utabiri katika makundi ya protini ya juu na ya chini
Katika makundi ya juu na ya chini ya %10 ya protini, modeli za PLSR zilizochakatwa awali kwa Savitzky–Golay zililinganishwa kando. Katika kundi la protini ya juu, thamani iliyopimwa ilikuwa 15,030 ± 0,908 %, utabiri wa SWIR 14,988 ± 1,588 %, na utabiri wa VNIR 15,176 ± 2,664 %. Katika kundi la protini ya chini, thamani iliyopimwa ilikuwa 11,838 ± 1,02 %, huku VNIR ikitabiri 12,254 ± 2,538 % na SWIR 10,845 ± 2,156 %.
Wastani huu wa kundi moja haupaswi kutumika badala ya utendaji wa modeli nzima. Tafsiri ya watafiti kuhusu ubora wa SWIR haitokani tu na wastani wa makundi haya mawili, bali na jumla ya matokeo ya Test R², RMSE, Q² na cross-validation.
Hitimisho zinazoungwa mkono na utafiti
- YOLOv11 iliweza kutoa utendaji wa juu katika ugawaji wa kiotomatiki wa punje moja moja za ngano katika picha za hipaspektramu.
- Ongezeko la data liliboresha kwa kiwango kinachoonekana ujumlishaji wa ugawaji katika picha cropped.
- Mbinu ya DBSCAN na Random Forest iliendesha kiotomatiki uteuzi wa ROI ya spektramu kutoka ndani ya visanduku vya YOLO.
- PLSR inayotegemea SWIR ilitoa katika seti hii ya data utabiri wa protini ulio juu na thabiti zaidi kuliko modeli zinazotegemea VNIR.
- MSC–SWIR ilitoa thamani ya juu zaidi ya Test R².
- Savitzky–Golay–SWIR iliunda modeli rahisi zaidi lakini yenye nguvu kwa vipengele vitatu tu vya PLS.
- YOLOv11 ilionyesha muda mfupi zaidi wa uchakataji katika ulinganisho wa YOLOv8 katika utafiti.
Hitimisho zisizoungwa mkono na utafiti
- Haijaonyeshwa kwamba modeli itatoa usahihi huo huo kwa aina zote za ngano na katika nchi zote.
- Utendaji katika kamera tofauti za SWIR/VNIR haujathibitishwa.
- Haijathibitishwa kwamba matokeo hayo hayo yatadumishwa katika hali zisizodhibitiwa za kiwanda au shambani.
- Modeli “haioni” moja kwa moja molekuli ya protini; inajifunza uhusiano wa kitakwimu kati ya uakisi wa spektramu na thamani rejea ya Dumas.
- Thamani ya juu ya F1 ya YOLO haimaanishi kwamba urejeleaji wa protini una usahihi huo huo.
- Haiwezi kuhitimishwa kwamba VNIR kwa ujumla haitoshi kwa kazi zote za utabiri wa kikemia.
- Ubora wa SWIR lazima utathminiwe katika muktadha wa utafiti huu, sensa hizi, sampuli hizi na utabiri huu wa protini.
Vikwazo vikuu
Picha zote za hipaspektramu zilipatikana kwa kamera zilezile za Specim SWIR na Specim IQ, chini ya mwanga uliodhibitiwa na uwekaji sanifu. Watafiti wanasema wazi kwamba tathmini ya utendaji katika picha zote 84 ilijumuisha pia picha zilizotumika kwa mafunzo. Ingawa tathmini tofauti ilifanywa kwenye maeneo cropped, kwa ujumlishaji halisi kati ya mifumo zinahitajika seti huru za data kutoka taasisi nyingine, vifaa vingine na mazingira tofauti.
Kutokuwepo kwa seti kubwa na sanifu za data za umma kwa picha za hipaspektramu za nafaka pia kumezuia utafiti kufanya ulinganisho mpana zaidi wa benchmark.
Maelezo kuhusu ripoti ya namba ndani ya chanzo
Katika sehemu ya matokeo ya chanzo, kwa YOLO hutumika kauli “maksimum F1 = 0,9989”; hata hivyo, katika majedwali ya utafiti kuna thamani za R10 = 0,9995, IA10 = 0,9996 na cropped IA4 = 1,0000 kwa data na hali tofauti za tathmini. Kwa hiyo, thamani za utendaji zinapaswa kufasiriwa kwa kubainisha zinahusiana na jedwali gani na hali gani ya tathmini.
Zaidi ya hayo, katika sehemu ya mbinu inaripotiwa azimio la spektramu la 7 nm kwa VNIR na 12 nm FWHM kwa SWIR, huku katika sehemu ya mjadala thamani za takriban 3,0 nm na 5,2 nm zikitumika tena chini ya kauli “spectral resolution”. Kwa kuwa chanzo hakifafanui wazi tofauti kati ya azimio la macho na nafasi ya sampuli ya spektramu kwa makundi haya mawili ya thamani, hakuna mojawapo iliyosahihishwa kwa kutumia nyingine hapa.
Maelezo ya Chanzo na Mbinu
Utafiti asili:Assessment of crude protein in wheat kernels using SWIR hyperspectral imaging combined with deep learning-based segmentation
Waandishi: Jae Gyeong Jung; Jin-Hyun Kim; Changsoo Kim; Donghwan Shim.
Mwandishi anayewajibika: Donghwan Shim.
Taasisi: Department of Biological Sciences, Chungnam National University; Genomics Division, Department of Agricultural Biotechnology, National Institute of Agricultural Sciences, Rural Development Administration; Department of Crop Science, Chungnam National University, Republic of Korea.
Jarida: Journal of Agriculture and Food Research.
Juzuu / namba ya makala: 26 (2026), 102679.
DOI: 10.1016/j.jafr.2026.102679
Mchapishaji: Elsevier B.V.
Tarehe ya kupokelewa: 20 Agosti 2025.
Marekebisho: 8 Januari 2026.
Tarehe ya kukubaliwa: 14 Januari 2026.
Kuchapishwa mtandaoni: 17 Januari 2026.
Leseni: Creative Commons Attribution–NonCommercial 4.0 International (CC BY-NC 4.0).
Ufadhili: Rural Development Administration, Republic of Korea, Cooperative Research Program for Agricultural Science and Technology Development No. RS-2025-00512183; pamoja na Institute of Information & Communications Technology Planning & Evaluation (IITP), Korea government (MSIT), No. RS-2022-00155857, Artificial Intelligence Convergence Innovation Human Resources Development, Chungnam National University.
Mgongano wa maslahi: Waandishi hawakuripoti maslahi ya kifedha yanayojulikana au uhusiano binafsi unaoweza kuathiri utafiti.
Upatikanaji wa data: Imeelezwa kwamba data zitatolewa kwa ombi.
Mpaka wa kisayansi: Matokeo yanahusu hali za maabara zilizodhibitiwa za upigaji picha wa hipaspektramu. Uthibitishaji wa nje haujafanywa kwa sensa tofauti, seti za data za taasisi huru na mazingira yanayobadilika. Hitimisho lenye nguvu la utafiti ni kwamba ndani ya mpangilio uliopo uliosanifishwa usanifu wa SWIR + YOLOv11 + ROI ya spektramu + PLSR unaweza kutumika kwa utabiri wa protini ghafi wenye uwezo mkubwa; si utendaji wa universal wa vifaa tofauti katika mazingira ya uwanja.
Kanuni ya uwasilishaji ya Verianla: Maudhui haya si tafsiri kamili ya maandishi ya makala asili ya kitaaluma. Muundo wa jaribio, vipimo vya kihisabati, hali za vifaa, thamani za utendaji zilizoripotiwa na vikwazo vya kimbinu vimedumishwa kwa uaminifu kwa chanzo; uwasilishaji umeundwa upya katika muundo huru wa kujifunza kisayansi. Kwa nukuu ya kitaaluma na muktadha asili wa michoro ya chanzo, utafiti uliochapishwa unapaswa kuchunguzwa kupitia DOI.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *